Flink Doris Connector
Flink Doris Connector は、Flink を介して Doris クラスターのデータを読み書きします。また、Flink CDC と連携し、MySQL などの上流データベース全体を Doris に同期できます。
主な機能は次のとおりです。
- Doris データの読み取り: BE からの並列読み取りにより、読み取り効率を高めます。
- Doris データの書き込み: Flink 内でデータをバッチ化し、Stream Load で一括取り込みします。
- Lookup Join によるディメンションテーブル結合: バッチ処理と非同期クエリによって結合を高速化します。
- データベース全体の同期: Flink CDC を使用して MySQL、Oracle、PostgreSQL などのデータベース全体を同期します。テーブルの自動作成と DDL の同期にも対応します。
バージョン対応表
| Connector のバージョン | Flink のバージョン | Doris のバージョン | Java のバージョン | Scala のバージョン |
|---|---|---|---|---|
| 1.0.3 | 1.11,1.12,1.13,1.14 | 0.15+ | 8 | 2.11,2.12 |
| 1.1.1 | 1.14 | 1.0+ | 8 | 2.11,2.12 |
| 1.2.1 | 1.15 | 1.0+ | 8 | - |
| 1.3.0 | 1.16 | 1.0+ | 8 | - |
| 1.4.0 | 1.15 - 1.17 | 1.0+ | 8 | - |
| 1.5.2 | 1.15 - 1.18 | 1.0+ | 8 | - |
| 1.6.1 | 1.15 - 1.19 | 1.0+ | 8 | - |
| 24.0.1 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 24.1.0 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 25.0.0 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 25.1.0 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 26.0.0 | 1.15 - 1.20,2.0 - 2.2 | 1.0+ | 8(1.x),17(2.x) | - |
| 26.1.1 | 1.15 - 1.20,2.0 - 2.2 | 1.0+ | 8(1.x),17(2.x) | - |
インストール
Jar パッケージと Maven 依存関係のどちらでも導入できます。
Jar パッケージを使用する方法
対応するバージョンの Flink Doris Connector の Jar パッケージを Doris ダウンロードページ からダウンロードし、Flink の classpath にコピーします。
- Standalone モード: Jar ファイルを
lib/ディレクトリに配置します。 - Yarn クラスターモード: Jar ファイルを事前デプロイ用パッケージに配置します。
Maven 依存関係を使用する方法
プロジェクトの pom.xml に次の依存関係を追加します。
<dependency>
    <groupId>org.apache.doris</groupId>
    <artifactId>flink-doris-connector-${flink.version}</artifactId>
    <version>${connector.version}</version>
</dependency>
例:
<dependency>
    <groupId>org.apache.doris</groupId>
    <artifactId>flink-doris-connector-1.16</artifactId>
    <version>25.1.0</version>
</dependency>
動作の仕組み
読み取りの仕組み
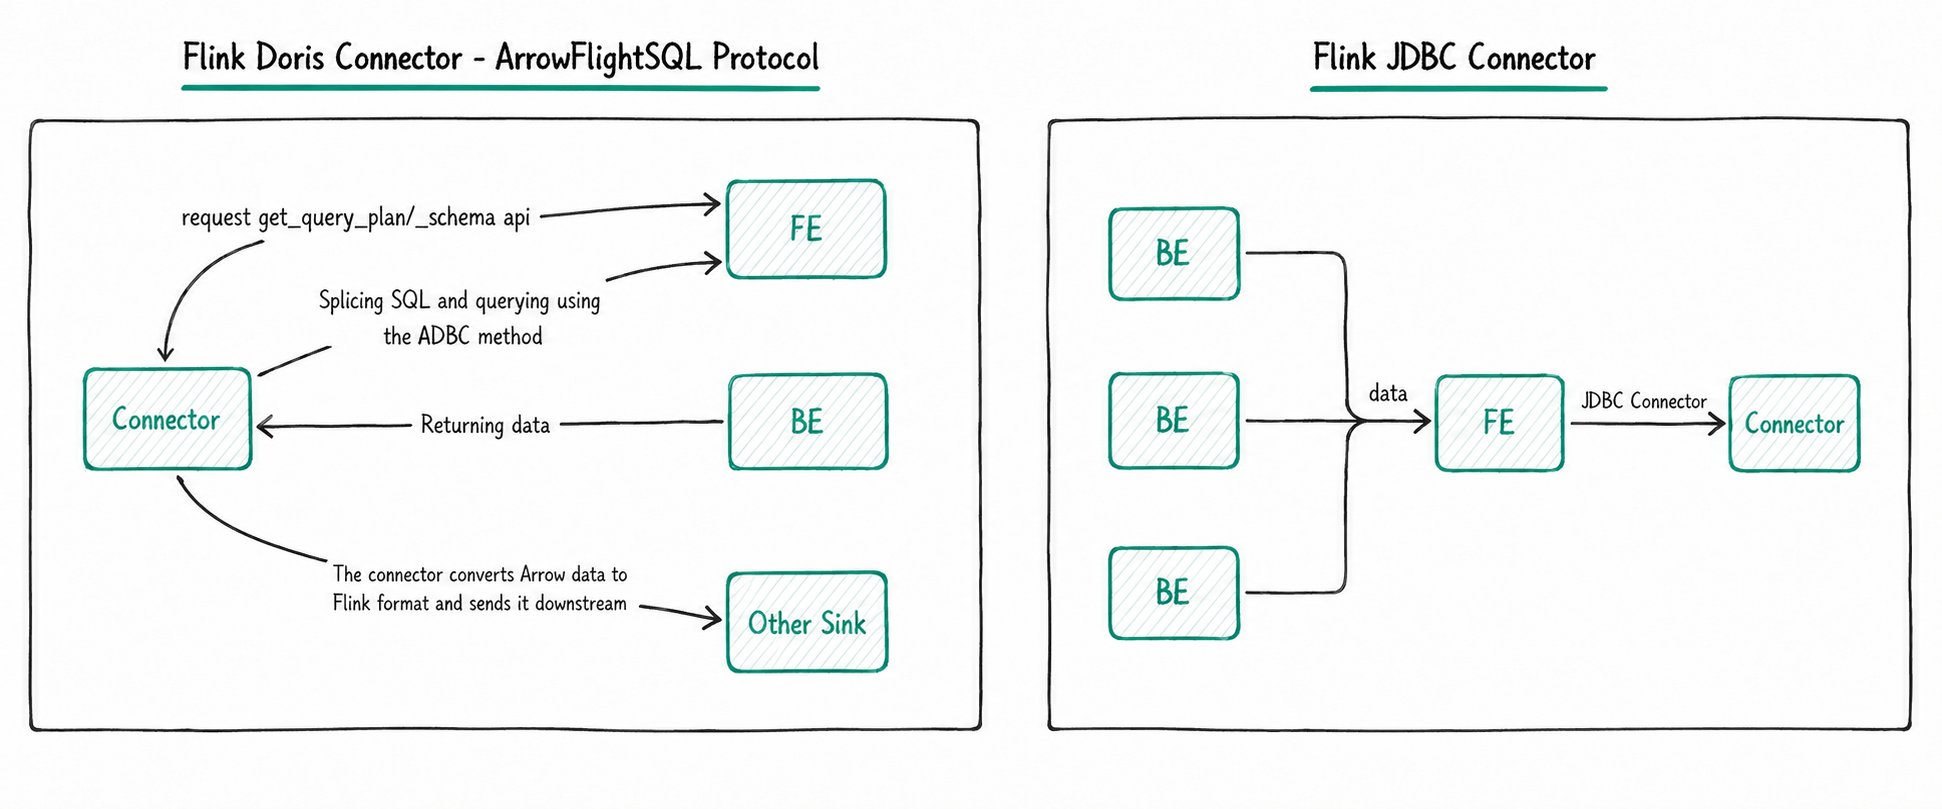
データ読み取り時の性能は Flink JDBC Connector より Flink Doris Connector の方が高いため、後者を推奨します。
- Flink JDBC Connector: Doris は MySQL プロトコルと互換性がありますが、JDBC 経由の読み書きは単一の FE ノードで直列に処理されるため、性能上のボトルネックになります。使用は推奨しません。
- Flink Doris Connector: Doris 2.1 以降、デフォルトの読み取りプロトコルは ADBC です。読み取りは次の手順で行われます。
- Flink Doris Connector が FE からクエリプラン内の Tablet ID 情報を取得します。
- クエリ文
SELECT * FROM tbs TABLET(id1, id2, id3)を生成します。 - FE の ADBC ポートを介してクエリを実行します。
- BE がデータを直接返します。これにより、データが FE を経由せず、単一 FE のボトルネックを回避できます。
書き込みの仕組み
Flink Doris Connector は、書き込みデータを Flink のメモリ内でバッチ化し、Stream Load で Doris に一括取り込みします。バッチ化には次の二つのモードがあり、デフォルトは Flink Checkpoint に基づくストリーミング書き込みです。
| 比較項目 | ストリーミング書き込み | バッチ書き込み |
|---|---|---|
| トリガー条件 | Flink Checkpoint に依存し、Checkpoint のたびに Doris に書き込む | Connector 内で時間とデータ量のしきい値に基づいて定期的にコミットする |
| 一貫性 | Exactly-Once | At-Least-Once。主キーモデルを使用すると Exactly-Once を保証できる |
| レイテンシー | Checkpoint 間隔に制限され、通常は高め | 独立したバッチ処理機構があり、柔軟に調整できる |
| 障害耐性と復旧 | Flink の状態復旧と完全に整合する | 外部の重複排除ロジック(Doris の主キーによる重複排除など)に依存する |
クイックスタート
このセクションでは、Flink クラスターのデプロイから FlinkSQL を使用した Doris データの読み書きまで、一連の手順を示します。
1. Flink クラスターをデプロイする
Standalone クラスターを例に説明します。
- Flink 1.18.1 のインストールパッケージをダウンロードします。
- 展開後、Flink Doris Connector の Jar パッケージを
<FLINK_HOME>/libに配置します。 <FLINK_HOME>ディレクトリに移動し、bin/start-cluster.shを実行して Flink クラスターを起動します。jpsコマンドで Flink クラスターが正常に起動したことを確認します。
2. Doris テーブルを初期化する
次の SQL を実行して Doris テーブルを作成し、テストデータを書き込みます。
CREATE DATABASE test;

CREATE TABLE test.student (
    `id` INT,
    `name` VARCHAR(256),
    `age` INT
)
UNIQUE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_allocation" = "tag.location.default: 3"
);

INSERT INTO test.student values(1, "James", 18);
INSERT INTO test.student values(2, "Emily", 28);

CREATE TABLE test.student_trans (
    `id` INT,
    `name` VARCHAR(256),
    `age` INT
)
UNIQUE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_allocation" = "tag.location.default: 3"
);
3. FlinkSQL ジョブを実行する
FlinkSQL Client を起動します。
bin/sql-client.sh
次の FlinkSQL を実行します。
CREATE TABLE Student (
    id STRING,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'test.student',
    'username' = 'root',
    'password' = ''
);

CREATE TABLE StudentTrans (
    id STRING,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'test.student_trans',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'doris_label'
);

INSERT INTO StudentTrans SELECT id, concat('prefix_', name), age + 1 FROM Student;
4. 結果を確認する
mysql> select * from test.student_trans;
+------+--------------+------+
| id   | name         | age  |
+------+--------------+------+
|    1 | prefix_James |   19 |
|    2 | prefix_Emily |   29 |
+------+--------------+------+
2 rows in set (0.02 sec)
ユースケース
ケース 1: Doris データを読み取る
Flink が Doris データを読み取る場合、Doris Source は有限ストリームとなり、CDC による継続的な読み取りには対応しません。次の二つの読み取りプロトコルを使用できます。
| プロトコル | 説明 | 推奨バージョン |
|---|---|---|
| Thrift | BE の Thrift インターフェースを呼び出してデータを読み取る | すべてのバージョンと互換 |
| ArrowFlightSQL | Doris 2.1 を基盤とする Arrow Flight SQL プロトコルを介して大量のデータを高速に読み取る | Connector 24.0.0+ |
- Thrift の処理フローについては、Thrift インターフェースによるデータ読み取り を参照してください。
- ArrowFlightSQL の使い方については、Arrow Flight SQL に基づく高速データ転送 を参照してください。Doris 2.1 以降では ArrowFlightSQL の使用を推奨します。
FlinkSQL で読み取る(Thrift 方式)
CREATE TABLE student (
    id INT,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',  -- FE host:HttpPort
    'table.identifier' = 'test.student',
    'username' = 'root',
    'password' = ''
);

SELECT * FROM student;
FlinkSQL で読み取る(ArrowFlightSQL 方式)
CREATE TABLE student (
    id INT,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '{fe.conf:http_port}',
    'table.identifier' = 'test.student',
    'source.use-flight-sql' = 'true',
    'source.flight-sql-port' = '{fe.conf:arrow_flight_sql_port}',
    'username' = 'root',
    'password' = ''
);

SELECT * FROM student;
DataStream API で読み取る
DataStream API で読み取る場合は、あらかじめプロジェクトの POM ファイルに依存関係を追加する必要があります。インストール を参照してください。
final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
DorisOptions option = DorisOptions.builder()
        .setFenodes("127.0.0.1:8030")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("")
        .build();

DorisReadOptions readOptions = DorisReadOptions.builder().build();
DorisSource<List<?>> dorisSource = DorisSource.<List<?>>builder()
        .setDorisOptions(option)
        .setDorisReadOptions(readOptions)
        .setDeserializer(new SimpleListDeserializationSchema())
        .build();

env.fromSource(dorisSource, WatermarkStrategy.noWatermarks(), "doris source").print();
env.execute("Doris Source Test");
ケース 2: Doris データを書き込む
Flink は Stream Load を介して Doris に書き込みます。ストリーミング書き込みとバッチ書き込みの二つのモードに対応します。
バッチ書き込みは Connector 1.5.0 以降でサポートされます。バッチ書き込みは Checkpoint に依存せず、データをメモリにキャッシュし、バッチ化パラメーターに基づいて書き込みタイミングを制御します。ストリーミング書き込みでは Checkpoint を有効にする必要があり、Checkpoint の期間を通して上流データを Doris に継続的に書き込みます。データを常時メモリにキャッシュすることはありません。
FlinkSQL で書き込む
Flink の Datagen を使用し、上流から継続的に生成されるデータをシミュレートします。
-- Enable checkpoint
SET 'execution.checkpointing.interval' = '30s';

CREATE TABLE student_source (
    id INT,
    name STRING,
    age INT
) WITH (
    'connector' = 'datagen',
    'rows-per-second' = '1',
    'fields.name.length' = '20',
    'fields.id.min' = '1',
    'fields.id.max' = '100000',
    'fields.age.min' = '3',
    'fields.age.max' = '30'
);

-- doris sink
CREATE TABLE student_sink (
    id INT,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '10.16.10.6:28737',
    'table.identifier' = 'test.student',
    'username' = 'root',
    'password' = 'password',
    'sink.label-prefix' = 'doris_label'
    -- 'sink.enable.batch-mode' = 'true'  Add this configuration to use batch write
);

INSERT INTO student_sink SELECT * FROM student_source;
DataStream API で書き込む
DataStream API で書き込む場合は、上流データを Doris テーブルに書き込むために、さまざまなシリアライズ方式を使用できます。
Connector には HttpClient バージョン 4.5.13 が組み込まれています。プロジェクトで HttpClient を別途参照する場合は、バージョンを一致させてください。
プレーン文字列形式
上流データが csv または json 形式の場合は、SimpleStringSerializer を直接使用してシリアライズできます。
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.enableCheckpointing(30000);
DorisSink.Builder<String> builder = DorisSink.builder();

DorisOptions dorisOptions = DorisOptions.builder()
        .setFenodes("10.16.10.6:28737")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("")
        .build();

Properties properties = new Properties();
// When upstream is json data, the following configuration is required
properties.setProperty("read_json_by_line", "true");
properties.setProperty("format", "json");

// When upstream is csv, the following configuration is required
// properties.setProperty("format", "csv");
// properties.setProperty("column_separator", ",");

DorisExecutionOptions executionOptions = DorisExecutionOptions.builder()
        .setLabelPrefix("label-doris")
        .setDeletable(false)
        // .setBatchMode(true)  Enable batch write
        .setStreamLoadProp(properties)
        .build();

builder.setDorisReadOptions(DorisReadOptions.builder().build())
        .setDorisExecutionOptions(executionOptions)
        .setSerializer(new SimpleStringSerializer())
        .setDorisOptions(dorisOptions);

List<String> data = new ArrayList<>();
data.add("{\"id\":3,\"name\":\"Michael\",\"age\":28}");
data.add("{\"id\":4,\"name\":\"David\",\"age\":38}");

env.fromCollection(data).sinkTo(builder.build());
env.execute("doris test");
RowData 形式
RowData は Flink の内部形式です。上流データが RowData 形式で渡される場合は、RowDataSerializer を使用してシリアライズする必要があります。
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.enableCheckpointing(10000);
env.setParallelism(1);

DorisSink.Builder<RowData> builder = DorisSink.builder();

Properties properties = new Properties();
properties.setProperty("column_separator", ",");
properties.setProperty("line_delimiter", "\n");
properties.setProperty("format", "csv");
// When upstream is json, the following configuration is required
// properties.setProperty("read_json_by_line", "true");
// properties.setProperty("format", "json");
DorisOptions.Builder dorisBuilder = DorisOptions.builder();
dorisBuilder
        .setFenodes("10.16.10.6:28737")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("");
DorisExecutionOptions.Builder executionBuilder = DorisExecutionOptions.builder();
executionBuilder.setLabelPrefix(UUID.randomUUID().toString()).setDeletable(false).setStreamLoadProp(properties);

// flink rowdata's schema
String[] fields = {"id", "name", "age"};
DataType[] types = {DataTypes.INT(), DataTypes.VARCHAR(256), DataTypes.INT()};

builder.setDorisExecutionOptions(executionBuilder.build())
        .setSerializer(
                RowDataSerializer.builder() // serialize according to rowdata
                        .setType(LoadConstants.CSV)
                        .setFieldDelimiter(",")
                        .setFieldNames(fields)
                        .setFieldType(types)
                        .build())
        .setDorisOptions(dorisBuilder.build());

// mock rowdata source
DataStream<RowData> source =
        env.fromElements("")
                .flatMap(
                        new FlatMapFunction<String, RowData>() {
                            @Override
                            public void flatMap(String s, Collector<RowData> out)
                                    throws Exception {
                                GenericRowData genericRowData = new GenericRowData(3);
                                genericRowData.setField(0, 1);
                                genericRowData.setField(1, StringData.fromString("Michael"));
                                genericRowData.setField(2, 18);
                                out.collect(genericRowData);

                                GenericRowData genericRowData2 = new GenericRowData(3);
                                genericRowData2.setField(0, 2);
                                genericRowData2.setField(1, StringData.fromString("David"));
                                genericRowData2.setField(2, 38);
                                out.collect(genericRowData2);
                            }
                        });

source.sinkTo(builder.build());
env.execute("doris test");
Debezium 形式
上流からのデータが Debezium 形式の場合(Flink CDC や Kafka 内の Debezium 形式のデータなど)、JsonDebeziumSchemaSerializer を使用してシリアライズします。
// Enable checkpoint
env.enableCheckpointing(10000);

Properties props = new Properties();
props.setProperty("format", "json");
props.setProperty("read_json_by_line", "true");
DorisOptions dorisOptions = DorisOptions.builder()
        .setFenodes("127.0.0.1:8030")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("").build();

DorisExecutionOptions.Builder executionBuilder = DorisExecutionOptions.builder();
executionBuilder.setLabelPrefix("label-prefix")
        .setStreamLoadProp(props)
        .setDeletable(true);

DorisSink.Builder<String> builder = DorisSink.builder();
builder.setDorisReadOptions(DorisReadOptions.builder().build())
        .setDorisExecutionOptions(executionBuilder.build())
        .setDorisOptions(dorisOptions)
        .setSerializer(JsonDebeziumSchemaSerializer.builder().setDorisOptions(dorisOptions).build());

env.fromSource(mySqlSource, WatermarkStrategy.noWatermarks(), "MySQL Source")
        .sinkTo(builder.build());
複数テーブルへの書き込み形式
DorisSink は、一つの Sink で複数テーブルを同期できます。データをデータベース名とテーブル名の情報とともに Sink に渡し、RecordWithMetaSerializer を使用してシリアライズする必要があります。
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.setParallelism(1);
DorisSink.Builder<RecordWithMeta> builder = DorisSink.builder();
Properties properties = new Properties();
properties.setProperty("column_separator", ",");
properties.setProperty("line_delimiter", "\n");
properties.setProperty("format", "csv");
DorisOptions.Builder dorisBuilder = DorisOptions.builder();
dorisBuilder
        .setFenodes("10.16.10.6:28737")
        .setTableIdentifier("")
        .setUsername("root")
        .setPassword("");

DorisExecutionOptions.Builder executionBuilder = DorisExecutionOptions.builder();

executionBuilder
        .setLabelPrefix("label-doris")
        .setStreamLoadProp(properties)
        .setDeletable(false)
        .setBatchMode(true);

builder.setDorisReadOptions(DorisReadOptions.builder().build())
        .setDorisExecutionOptions(executionBuilder.build())
        .setDorisOptions(dorisBuilder.build())
        .setSerializer(new RecordWithMetaSerializer());

RecordWithMeta record = new RecordWithMeta("test", "student_1", "1,David,18");
RecordWithMeta record1 = new RecordWithMeta("test", "student_2", "1,Jack,28");
env.fromCollection(Arrays.asList(record, record1)).sinkTo(builder.build());
ケース 3: Lookup Join によるディメンションテーブル結合
Lookup Join は、Flink でのディメンションテーブル結合の性能を改善できます。ディメンションテーブル結合に Flink JDBC Connector を使用すると、次の問題が生じる可能性があります。
- Flink JDBC Connector は同期クエリ方式を使用します。上流(Kafka など)からレコードが届くたびに Doris のディメンションテーブルを即座にクエリするため、同時実行数が多いとクエリのレイテンシーが高くなります。
- JDBC 経由のクエリは通常、レコードを一件ずつ検索しますが、Doris では効率を高めるためにバッチクエリを推奨しています。
Flink Doris Connector の Lookup Join には次の利点があります。
- 上流データをバッチ単位でキャッシュし、レコード単位のクエリによる高いレイテンシーとデータベースへの負荷を抑えます。
- 結合クエリを非同期に実行し、データのスループットを高めながら Doris のクエリ負荷を軽減します。
CREATE TABLE fact_table (
    `id` BIGINT,
    `name` STRING,
    `city` STRING,
    `process_time` as proctime()
) WITH (
    'connector' = 'kafka',
    ...
);

create table dim_city(
    `city` STRING,
    `level` INT,
    `province` STRING,
    `country` STRING
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'jdbc-url' = 'jdbc:mysql://127.0.0.1:9030',
    'table.identifier' = 'dim.dim_city',
    'username' = 'root',
    'password' = '',
    'lookup.cache.max-rows' = '100000',
    'lookup.cache.ttl' = '300s'
);

SELECT a.id, a.name, a.city, c.province, c.country, c.level
FROM fact_table a
LEFT JOIN dim_city FOR SYSTEM_TIME AS OF a.process_time AS c
ON a.city = c.city
ケース 4: CDC によるデータベース全体の同期
Flink Doris Connector は Flink CDC と連携し、MySQL などのリレーショナルデータベースを Doris に同期できます。テーブルの自動作成や Schema Change にも対応します。現在サポートされるデータベースは MySQL、Oracle、PostgreSQL、SQLServer、MongoDB、DB2 です。
- データベース全体を同期する場合は、対応する Flink CDC の依存関係(Fat Jar)を
$FLINK_HOME/libに追加する必要があります。たとえば、flink-sql-connector-mysql-cdc-${version}.jarやflink-sql-connector-oracle-cdc-${version}.jarです。Flink CDC 3.1 以降は、それ以前のバージョンと互換性がありません。ダウンロード先: Flink CDC 3.x、Flink CDC 2.x。 - Connector 24.0.0 以降では、依存する Flink CDC のバージョンは 3.1 以上である必要があります。ダウンロード先。Flink CDC で MySQL と Oracle を同期する場合は、対応する JDBC ドライバーも
$FLINK_HOME/libに追加する必要があります。
Flink クラスターを起動したら、データソースの種類に応じたコマンドを実行します。
MySQL データベース全体の同期
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.16-24.0.1.jar \
    mysql-sync-database \
    --database test_db \
    --mysql-conf hostname=127.0.0.1 \
    --mysql-conf port=3306 \
    --mysql-conf username=root \
    --mysql-conf password=123456 \
    --mysql-conf database-name=mysql_db \
    --including-tables "tbl1|test.*" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=123456 \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
Oracle データベース全体の同期
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.16-24.0.1.jar \
    oracle-sync-database \
    --database test_db \
    --oracle-conf hostname=127.0.0.1 \
    --oracle-conf port=1521 \
    --oracle-conf username=admin \
    --oracle-conf password="password" \
    --oracle-conf database-name=XE \
    --oracle-conf schema-name=ADMIN \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=\
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
PostgreSQL データベース全体の同期
<FLINK_HOME>/bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.16-24.0.1.jar \
    postgres-sync-database \
    --database db1 \
    --postgres-conf hostname=127.0.0.1 \
    --postgres-conf port=5432 \
    --postgres-conf username=postgres \
    --postgres-conf password="123456" \
    --postgres-conf database-name=postgres \
    --postgres-conf schema-name=public \
    --postgres-conf slot.name=test \
    --postgres-conf decoding.plugin.name=pgoutput \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=\
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
SQLServer データベース全体の同期
<FLINK_HOME>/bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.16-24.0.1.jar \
    sqlserver-sync-database \
    --database db1 \
    --sqlserver-conf hostname=127.0.0.1 \
    --sqlserver-conf port=1433 \
    --sqlserver-conf username=sa \
    --sqlserver-conf password="123456" \
    --sqlserver-conf database-name=CDC_DB \
    --sqlserver-conf schema-name=dbo \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=\
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
DB2 データベース全体の同期
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.16-24.0.1.jar \
    db2-sync-database \
    --database db2_test \
    --db2-conf hostname=127.0.0.1 \
    --db2-conf port=50000 \
    --db2-conf username=db2inst1 \
    --db2-conf password=doris123456 \
    --db2-conf database-name=testdb \
    --db2-conf schema-name=DB2INST1 \
    --including-tables "FULL_TYPES|CUSTOMERS" \
    --single-sink true \
    --use-new-schema-change true \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=123456 \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
MongoDB データベース全体の同期
<FLINK_HOME>/bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.18-24.0.1.jar \
    mongodb-sync-database \
    --database doris_db \
    --schema-change-mode debezium_structure \
    --mongodb-conf hosts=127.0.0.1:27017 \
    --mongodb-conf username=flinkuser \
    --mongodb-conf password=flinkpwd \
    --mongodb-conf database=test \
    --mongodb-conf scan.startup.mode=initial \
    --mongodb-conf schema.sample-percent=0.2 \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password= \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --sink-conf sink.enable-2pc=false \
    --table-conf replication_num=1
AWS Aurora MySQL データベース全体の同期
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.18-25.0.0.jar \
    mysql-sync-database \
    --database testwd \
    --mysql-conf hostname=xxx.us-east-1.rds.amazonaws.com \
    --mysql-conf port=3306 \
    --mysql-conf username=admin \
    --mysql-conf password=123456 \
    --mysql-conf database-name=test \
    --mysql-conf server-time-zone=UTC \
    --including-tables "student" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password= \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
AWS RDS MySQL データベース全体の同期
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.18-25.0.0.jar \
    mysql-sync-database \
    --database testwd \
    --mysql-conf hostname=xxx.ap-southeast-1.rds.amazonaws.com \
    --mysql-conf port=3306 \
    --mysql-conf username=admin \
    --mysql-conf password=123456 \
    --mysql-conf database-name=test \
    --mysql-conf server-time-zone=UTC \
    --including-tables "student" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password= \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
設定リファレンス
共通設定
| キー | デフォルト値 | 必須 | 説明 |
|---|---|---|---|
| fenodes | -- | Y | Doris FE の HTTP アドレス。複数のアドレスをカンマ区切りで指定できます。 |
| benodes | -- | N | Doris BE の HTTP アドレス。複数のアドレスをカンマ区切りで指定できます。 |
| jdbc-url | -- | N | JDBC 接続情報。例: jdbc:mysql://127.0.0.1:9030。 |
| table.identifier | -- | Y | Doris のテーブル名。例: db.tbl。 |
| username | -- | Y | Doris にアクセスするためのユーザー名。 |
| password | -- | Y | Doris にアクセスするためのパスワード。 |
| auto-redirect | TRUE | N | Stream Load リクエストをリダイレクトするかどうか。有効な場合、BE 情報を明示的に取得せず、FE を介して Stream Load で書き込みます。 |
| doris.request.retries | 3 | N | Doris へのリクエスト送信時の再試行回数。 |
| doris.request.connect.timeout | 30s | N | Doris へのリクエスト送信時の接続タイムアウト。 |
| doris.request.read.timeout | 30s | N | Doris へのリクエスト送信時の読み取りタイムアウト。 |
Source の設定
| キー | デフォルト値 | 必須 | 説明 |
|---|---|---|---|
| doris.request.query.timeout | 21600s | N | Doris へのクエリのタイムアウト。デフォルトは 6 時間です。 |
| doris.request.tablet.size | 1 | N | 一つの Partition に対応する Doris Tablet の数。値を小さくすると Partition が増えて Flink 側の並列度が上がりますが、Doris への負荷も増えます。 |
| doris.batch.size | 4064 | N | BE から一度に読み取る最大行数。値を大きくすると Flink と Doris の間で確立する接続の数を減らせるため、ネットワーク遅延による追加の時間コストを抑えられます。 |
| doris.exec.mem.limit | 8192mb | N | 一つのクエリのメモリ上限。デフォルトは 8GB で、単位はバイトです。 |
| source.use-flight-sql | TRUE | N | 読み取りに Arrow Flight SQL を使用するかどうか。 |
| source.flight-sql-port | - | N | Arrow Flight SQL で読み取る場合の FE の arrow_flight_sql_port。 |
DataStream 固有の設定
| キー | デフォルト値 | 必須 | 説明 |
|---|---|---|---|
| doris.read.field | -- | N | Doris テーブルから読み取る列名のリスト。カンマで区切ります。 |
| doris.filter.query | -- | N | 読み取りデータを絞り込む式。この式は Doris にそのまま渡され、Doris が読み取り元でデータをフィルタリングします。例: age=18。 |
Sink の設定
| キー | デフォルト値 | 必須 | 説明 |
|---|---|---|---|
| sink.label-prefix | -- | Y | Stream Load による取り込みで使用するラベルのプレフィックス。2pc を使用する場合、Flink の EOS セマンティクスを保証するために、全体で一意である必要があります。 |
| sink.properties.* | -- | N | Stream Load の取り込みパラメーター。例: 'sink.properties.column_separator' = ', ' は列区切り文字を定義します。'sink.properties.escape_delimiters' = 'true' は特殊文字を区切り文字に使用することを示し、\x01 はバイナリの 0x01 に変換されます。JSON 形式の取り込みには 'sink.properties.format' = 'json' と 'sink.properties.read_json_by_line' = 'true' を使用します。詳細は Stream Load を参照してください。Group Commit モードでは 'sink.properties.group_commit' = 'sync_mode' により同期モードを設定します。Flink Connector は 1.6.2 以降で取り込み時の Group Commit 設定に対応します。使い方と制限事項は Group Commit を参照してください。26.1.0 以降では Stream Load の gz 圧縮がデフォルトで有効です。'sink.properties.compress_type' = '' で無効にできます。 |
| sink.enable-delete | TRUE | N | 削除を有効にするかどうか。このオプションを使用するには、Doris テーブルでバッチ削除が有効になっている必要があります(Doris 0.15+ ではデフォルトで有効)。Unique モデルのみをサポートします。 |
| sink.enable-2pc | TRUE | N | 二相コミット(2pc)を有効にするかどうか。デフォルトは true で、Exactly-Once セマンティクスを保証します。詳細は Stream Load 2PC を参照してください。 |
| sink.buffer-size | 1MB | N | 書き込みデータのキャッシュに使用するバッファーのサイズ。単位はバイトです。デフォルト設定で十分なため、変更は推奨しません。 |
| sink.buffer-count | 3 | N | 書き込みデータのキャッシュバッファーの数。デフォルト設定で十分なため、変更は推奨しません。 |
| sink.max-retries | 3 | N | Commit が失敗した後の最大再試行回数。デフォルトは 3 です。 |
| sink.enable.batch-mode | FALSE | N | バッチモードで Doris に書き込むかどうか。有効な場合、書き込みタイミングは Checkpoint に依存せず、sink.buffer-flush.max-rows、sink.buffer-flush.max-bytes、sink.buffer-flush.interval で制御されます。有効にすると Exactly-Once セマンティクスは保証されません。Unique モデルを使用すると冪等性を実現できます。 |
| sink.flush.queue-size | 2 | N | バッチモードでのキャッシュキューのサイズ。 |
| sink.buffer-flush.max-rows | 500000 | N | バッチモードで一回のバッチに書き込む最大行数。 |
| sink.buffer-flush.max-bytes | 100MB | N | バッチモードで一回のバッチに書き込む最大バイト数。 |
| sink.buffer-flush.interval | 10s | N | バッチモードでキャッシュを非同期にフラッシュする間隔。 |
| sink.ignore.update-before | TRUE | N | update-before イベントを無視するかどうか。デフォルトでは無視します。 |
Lookup Join の設定
| キー | デフォルト値 | 必須 | 説明 |
|---|---|---|---|
| lookup.cache.max-rows | -1 | N | lookup がキャッシュする最大行数。デフォルトの -1 はキャッシュを無効にすることを示します。 |
| lookup.cache.ttl | 10s | N | lookup キャッシュの最大保持時間。デフォルトは 10s です。 |
| lookup.max-retries | 1 | N | lookup クエリが失敗した後の再試行回数。 |
| lookup.jdbc.async | FALSE | N | 非同期 lookup を有効にするかどうか。デフォルトは false です。 |
| lookup.jdbc.read.batch.size | 128 | N | 非同期 lookup でのクエリ一回あたりの最大バッチサイズ。 |
| lookup.jdbc.read.batch.queue-size | 256 | N | 非同期 lookup で使用する中間バッファーキューのサイズ。 |
| lookup.jdbc.read.thread-size | 3 | N | 各タスクで lookup に使用する JDBC スレッドの数。 |
データベース全体の同期設定
構文
<FLINK_HOME>bin/flink run \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.16-1.6.1.jar \
    <mysql-sync-database|oracle-sync-database|postgres-sync-database|sqlserver-sync-database|mongodb-sync-database> \
    --database <doris-database-name> \
    [--job-name <flink-job-name>] \
    [--table-prefix <doris-table-prefix>] \
    [--table-suffix <doris-table-suffix>] \
    [--including-tables <mysql-table-name|name-regular-expr>] \
    [--excluding-tables <mysql-table-name|name-regular-expr>] \
    --mysql-conf <mysql-cdc-source-conf> [--mysql-conf <mysql-cdc-source-conf> ...] \
    --oracle-conf <oracle-cdc-source-conf> [--oracle-conf <oracle-cdc-source-conf> ...] \
    --postgres-conf <postgres-cdc-source-conf> [--postgres-conf <postgres-cdc-source-conf> ...] \
    --sqlserver-conf <sqlserver-cdc-source-conf> [--sqlserver-conf <sqlserver-cdc-source-conf> ...] \
    --sink-conf <doris-sink-conf> [--table-conf <doris-sink-conf> ...] \
    [--table-conf <doris-table-conf> [--table-conf <doris-table-conf> ...]]
設定項目
| キー | 説明 |
|---|---|
| --job-name | Flink ジョブ名。省略可能です。 |
| --database | Doris への同期先データベース名。 |
| --table-prefix | Doris テーブル名のプレフィックス。例: --table-prefix ods_。 |
| --table-suffix | Doris テーブル名のサフィックス。 |
| --including-tables | 同期する MySQL テーブル。複数のテーブルを | で区切って指定できます。正規表現にも対応します。例: --including-tables table1。 |
| --excluding-tables | 同期しないテーブル。指定方法は上記と同じです。 |
| --mysql-conf | MySQL CDCSource の設定。例: --mysql-conf hostname=127.0.0.1。すべての設定項目は MySQL CDC を参照してください。hostname/username/password/database-name は必須です。同期対象のデータベースまたはテーブルに主キーのないテーブルが含まれる場合は、scan.incremental.snapshot.chunk.key-column を設定する必要があり、単一の非 NULL フィールドのみを選択できます。例: scan.incremental.snapshot.chunk.key-column=database.table:column,database.table1:column...。異なるデータベースやテーブルの列はカンマで区切ります。 |
| --oracle-conf | Oracle CDCSource の設定。例: --oracle-conf hostname=127.0.0.1。すべての設定項目は Oracle CDC を参照してください。hostname/username/password/database-name/schema-name は必須です。 |
| --postgres-conf | Postgres CDCSource の設定。例: --postgres-conf hostname=127.0.0.1。すべての設定項目は Postgres CDC を参照してください。hostname/username/password/database-name/schema-name/slot.name は必須です。 |
| --sqlserver-conf | SQLServer CDCSource の設定。例: --sqlserver-conf hostname=127.0.0.1。すべての設定項目は SQLServer CDC を参照してください。hostname/username/password/database-name/schema-name は必須です。 |
| --db2-conf | DB2 CDCSource の設定。例: --db2-conf hostname=127.0.0.1。すべての設定項目は DB2 CDC を参照してください。hostname/username/password/database-name/schema-name は必須です。 |
| --mongodb-conf | MongoDB CDCSource の設定。例: --mongodb-conf hosts=127.0.0.1:27017。すべての設定項目は Mongo CDC を参照してください。hosts/username/password/database は必須です。--mongodb-conf schema.sample-percent は MongoDB データを自動サンプリングして Doris テーブルを作成するための設定で、デフォルトは 0.2 です。 |
| --sink-conf | Doris Sink のすべての設定項目。完全な一覧は Sink の設定 を参照してください。 |
| --table-conf | Doris テーブルの設定項目。properties 内の内容を指定します(properties 属性ではない table-buckets を除きます)。例: --table-conf replication_num=1。--table-conf table-buckets="tbl1:10,tbl2:20,a.*:30,b.*:40,.*:50" では、正規表現の順序に従って各テーブルのバケット数を指定します。一致しない場合は BUCKETS AUTO を使用してテーブルを作成します。 |
| --schema-change-mode | スキーマ変更の解析モード。debezium_structure と sql_parser の二つに対応し、デフォルトは debezium_structure です。debezium_structure は、上流の CDC データを同期するときに使用されるデータ構造を解析し、DDL 変更操作を判定します。sql_parser は、上流の CDC データを同期するときに DDL 文を解析して変更操作を判定するため、より正確です。使用例: --schema-change-mode debezium_structure。Connector 24.0.0 以降でサポートされます。 |
| --single-sink | すべてのテーブルを一つの Sink で同期するかどうか。有効にすると、上流で新規作成されたテーブルも自動検出され、テーブルが自動作成されます。 |
| --multi-to-one-origin | 複数の上流テーブルを同じテーブルに書き込む場合の、ソーステーブルの設定。例: --multi-to-one-origin "a_.*|b_.*"。詳細は #208 を参照してください。 |
| --multi-to-one-target | --multi-to-one-origin と併用する、ターゲットテーブルの設定。例: --multi-to-one-target "a|b"。 |
| --create-table-only | テーブル構造のみを同期するかどうか。 |
データ型の対応関係
Doris から Flink へ
| Doris の型 | Flink の型 |
|---|---|
| NULL_TYPE | NULL |
| BOOLEAN | BOOLEAN |
| TINYINT | TINYINT |
| SMALLINT | SMALLINT |
| INT | INT |
| BIGINT | BIGINT |
| FLOAT | FLOAT |
| DOUBLE | DOUBLE |
| DATE | DATE |
| DATETIME | TIMESTAMP |
| DECIMAL | DECIMAL |
| CHAR | STRING |
| LARGEINT | STRING |
| VARCHAR | STRING |
| STRING | STRING |
| DECIMALV2 | DECIMAL |
| ARRAY | ARRAY |
| MAP | STRING |
| JSON | STRING |
| VARIANT | STRING |
| IPV4 | STRING |
| IPV6 | STRING |
Flink から Doris へ
| Flink の型 | Doris の型 |
|---|---|
| BOOLEAN | BOOLEAN |
| TINYINT | TINYINT |
| SMALLINT | SMALLINT |
| INTEGER | INTEGER |
| BIGINT | BIGINT |
| FLOAT | FLOAT |
| DOUBLE | DOUBLE |
| DECIMAL | DECIMAL |
| CHAR | CHAR |
| VARCHAR | VARCHAR/STRING |
| STRING | STRING |
| DATE | DATE |
| TIMESTAMP | DATETIME |
| TIMESTAMP_LTZ | DATETIME |
| ARRAY | ARRAY |
| MAP | MAP/JSON |
| ROW | STRUCT/JSON |
モニタリングメトリクス
Flink は、クラスターの状態を監視するためのさまざまな Metrics を提供します。Flink Doris Connector が追加するモニタリングメトリクスは次のとおりです。
| 名前 | メトリクスの種類 | 説明 |
|---|---|---|
| totalFlushLoadBytes | Counter | フラッシュして取り込んだ合計バイト数。 |
| flushTotalNumberRows | Counter | 取り込んで処理した合計行数。 |
| totalFlushLoadedRows | Counter | 正常に取り込んだ合計行数。 |
| totalFlushTimeMs | Counter | 取り込みが正常に完了するまでにかかった合計時間。 |
| totalFlushSucceededNumber | Counter | 取り込みが成功した回数。 |
| totalFlushFailedNumber | Counter | 取り込みが失敗した回数。 |
| totalFlushFilteredRows | Counter | データ品質の要件を満たさなかった行の合計数。 |
| totalFlushUnselectedRows | Counter | where 条件によって除外された行の合計数。 |
| beginTxnTimeMs | Histogram | FE にトランザクション開始を要求するのにかかった時間(ミリ秒)。 |
| putDataTimeMs | Histogram | FE に取り込みデータの実行プランの取得を要求するのにかかった時間。 |
| readDataTimeMs | Histogram | データの読み取りにかかった時間。 |
| writeDataTimeMs | Histogram | データの書き込み処理にかかった時間。 |
| commitAndPublishTimeMs | Histogram | FE にトランザクションのコミットと公開を要求するのにかかった時間。 |
| loadTimeMs | Histogram | 取り込みの完了にかかった時間。 |
ベストプラクティス
FlinkSQL で CDC を使用して MySQL データをすばやく取り込む
-- Enable checkpoint
SET 'execution.checkpointing.interval' = '10s';

CREATE TABLE cdc_mysql_source (
    id int,
    name VARCHAR,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'root',
    'password' = 'password',
    'database-name' = 'database',
    'table-name' = 'table'
);

-- Supports synchronizing insert/update/delete events
CREATE TABLE doris_sink (
    id INT,
    name STRING
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'database.table',
    'username' = 'root',
    'password' = '',
    'sink.properties.format' = 'json',
    'sink.properties.read_json_by_line' = 'true',
    'sink.enable-delete' = 'true',  -- Synchronize delete events
    'sink.label-prefix' = 'doris_label'
);

insert into doris_sink select id, name from cdc_mysql_source;
Flink で列を部分更新する
CREATE TABLE doris_sink (
    id INT,
    name STRING,
    bank STRING,
    age int
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'database.table',
    'username' = 'root',
    'password' = '',
    'sink.properties.format' = 'json',
    'sink.properties.read_json_by_line' = 'true',
    'sink.properties.columns' = 'id,name,bank,age', -- Columns to update
    'sink.properties.partial_columns' = 'true' -- Enable partial column update
);
Flink で Bitmap データを取り込む
CREATE TABLE bitmap_sink (
    dt int,
    page string,
    user_id int
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'test.bitmap_test',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'doris_label',
    'sink.properties.columns' = 'dt,page,user_id,user_id=to_bitmap(user_id)'
)
Flink CDC でキー列を更新する
業務データベースでは通常、ID をテーブルの主キーとして使用します。たとえば Student テーブルでは ID(id)が主キーです。ただし、業務の変化に伴って、あるデータに対応する ID が変わることがあります。この場合、Flink CDC と Doris Connector を使用してデータを同期すると、Doris の主キー列のデータが自動的に更新されます。
仕組み
Flink CDC の基盤となる収集ツールは Debezium です。Debezium は内部で op フィールドを使用して操作を識別します。op の値 c、u、d、r は、それぞれ作成、更新、削除、読み取りを表します。主キー列の更新時には、Flink CDC が下流に DELETE イベントと INSERT イベントを送信します。Doris にデータが同期されると、主キー列のデータが自動的に更新されます。
使い方
Flink プログラムは、上記の CDC 同期の例を参照してください。ジョブの送信が成功したら、MySQL 側で主キー列に対して Update 文(例: update student set id = '1002' where id = '1001')を実行すると、Doris のデータを変更できます。
Flink で指定列の値に基づいてデータを削除する
Kafka のメッセージでは、{"op_type":"delete",data:{...}} のように、特定のフィールドで操作の種類を示すことがよくあります。このようなデータでは、op_type=delete のレコードを削除したい場合があります。
デフォルトでは、DorisSink は RowKind に基づいてイベントの種類を判別します。CDC ではイベントの種類を直接取得でき、隠し列 __DORIS_DELETE_SIGN__ に値を割り当てることで削除を実行できます。Kafka の場合は、アプリケーションロジックで値を判断し、隠し列に明示的に渡す必要があります。
-- For example, upstream data: {"op_type":"delete",data:{"id":1,"name":"zhangsan"}}
CREATE TABLE KAFKA_SOURCE(
    data STRING,
    op_type STRING
) WITH (
    'connector' = 'kafka',
    ...
);

CREATE TABLE DORIS_SINK(
    id INT,
    name STRING,
    __DORIS_DELETE_SIGN__ INT
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'db.table',
    'username' = 'root',
    'password' = '',
    'sink.enable-delete' = 'false',        -- false means do not get the event type from RowKind
    'sink.properties.columns' = 'id, name, __DORIS_DELETE_SIGN__'  -- Explicitly specify the import columns of Stream Load
);

INSERT INTO DORIS_SINK
SELECT json_value(data, '$.id') as id,
    json_value(data, '$.name') as name,
    if(op_type = 'delete', 1, 0) as __DORIS_DELETE_SIGN__
from KAFKA_SOURCE;
Flink CDC で DDL 文を同期する
MySQL などの上流データソースを同期する場合、上流でフィールドが追加または削除されたら、Doris でも同期して Schema Change 操作を行う必要があります。
この場合、通常は DataStream API プログラムを作成し、DorisSink が提供する JsonDebeziumSchemaSerializer を使用してシリアライズします。その後、Schema Change が自動的に実行されます。
Connector が提供するデータベース全体の同期ツールでは、追加設定なしで上流の DDL が自動同期され、Doris で Schema Change 操作が実行されます。
よくある質問(FAQ)
1. errCode = 2, detailMessage = Label [label_0_1] has already been used, relate to txn [19650]
Exactly-Once を使用する場合、Flink ジョブの再起動時には最新の Checkpoint/Savepoint から開始する必要があります。そうしないと、上記のエラーが発生します。Exactly-Once が不要な場合は、2PC コミットを無効化する(sink.enable-2pc=false)か、別の sink.label-prefix を使用して解決することもできます。
2. errCode = 2, detailMessage = transaction [19650] not found
このエラーは Commit フェーズで発生します。Checkpoint に記録されたトランザクション ID が FE 側で期限切れになっているため、この時点で再度コミットすると上記のエラーが発生します。この場合、その Checkpoint から開始することはできません。streaming_label_keep_max_second の設定を fe.conf で変更すると、有効期間(デフォルトは 12 時間)を延長できます。Doris 2.0 以降では、label_num_threshold の設定による制限も fe.conf で適用されます(デフォルトは 2000)。この値を増やすか、-1 に設定できます(-1 は時間の制限のみを適用することを意味します)。
3. errCode = 2, detailMessage = current running txns on db 10006 is 100, larger than limit 100
このエラーは、同じデータベースへの同時取り込みが 100 件を超えると発生します。max_running_txn_num_per_db パラメーターを fe.conf で調整して解決できます。詳細は max_running_txn_num_per_db を参照してください。また、ラベルを頻繁に変更してジョブを再起動した場合も発生することがあります。2pc を使用する場合(Duplicate/Aggregate モデル)、各ジョブのラベルは一意である必要があります。Flink ジョブが、以前にプリコミットに成功したものの未コミットのトランザクションを自動的に中止するのは、Checkpoint から再起動した場合だけです。ラベルを頻繁に変更して再起動すると、プリコミット済みトランザクションが大量に残って中止できず、トランザクション枠を占有します。Unique モデルでは 2pc を無効にして冪等書き込みを実現することもできます。
4. tablet writer write failed, tablet_id=190958, txn_id=3505530, err=-235
通常、この問題は Connector 1.1.0 より前で発生します。書き込み頻度が高すぎてバージョン数が増えすぎることが原因です。sink.batch.size と sink.batch.interval パラメーターを設定し、Stream Load の実行頻度を下げられます。Connector 1.1.0 以降では、デフォルトの書き込みタイミングが Checkpoint によって制御されるため、Checkpoint 間隔を長くすることで書き込み頻度を下げられます。
5. Flink の取り込みデータに不正なデータがある場合、どのようにスキップしますか?
Flink でデータを取り込む際、フィールドの形式や長さの問題などによる不正なデータがあると、Stream Load がエラーを報告し、Flink は再試行を続けます。スキップするには、Stream Load の厳格モードを無効にする(strict_mode=false、max_filter_ratio=1)か、Sink オペレーターの前にデータをフィルタリングします。
6. Flink マシンと BE マシンがネットワークで接続できない場合は、どう設定しますか?
Flink が Doris への書き込みを開始すると、Doris は書き込み先を BE にリダイレクトします。このとき返されるアドレスは BE の内部 IP(show backends で確認できる IP)です。Flink と Doris が通信できない場合はエラーになります。この場合、benodes に BE の外部 IP を設定できます。
7. stream load error: HTTP/1.1 307 Temporary Redirect
Flink は最初に FE へリクエストを送信し、307 応答を受け取るとリダイレクト先の BE にリクエストを送信します。FE が FullGC 中、高負荷状態、またはネットワーク遅延がある場合、デフォルトでは HttpClient は一定時間(3 秒)応答を受信しないとデータを送信します。リクエスト本文はデフォルトで InputStream のため、307 応答を受け取ってもデータを再送できず、そのままエラーになります。対処方法は次の三つです。
- Connector 25.1.0 以降にアップグレードします。このバージョンではデフォルトの待機時間が延長されています。
auto-redirect=falseを設定して BE に直接リクエストを送信します(一部のクラウド環境では使用できません)。- 主キーモデルではバッチモードを有効にできます。