Snowflake
Snowflake のデータを Apache Doris に移行する際は、通常、オブジェクトストレージを中間媒体として使用します。全体の手順は次の二段階です。
- Snowflake の COPY INTO ステートメントで、データをオブジェクトストレージ(AWS S3、GCS、Azure Blob など)にエクスポートします。
- Doris の S3 Load 機能でオブジェクトストレージからデータを読み込み、Doris にインポートします。パラメータの詳細は、S3 Load を参照してください。
移行前の準備
移行前に、Snowflake のテーブル構造に基づいて、Doris 側のテーブル構造とインポート方法を計画します。
- 適切なデータモデル(Detail モデル/Unique Key モデル/Aggregate モデル)を選択します。
- パーティション分割とバケット分割の方針を設計します。
- ロードのベストプラクティスを参考に、バッチサイズと並行処理数を計画します。
データ型の対応関係
次の表に Snowflake と Doris のデータ型の対応関係を示します。Doris に対応するテーブル構造を作成する際に参照してください。
| Snowflake | Doris | 備考 |
|---|---|---|
| NUMBER(p, s) / DECIMAL(p, s) / NUMERIC(p, s) | DECIMAL(p, s) | |
| INT / INTEGER | INT | |
| TINYINT / BYTEINT | TINYINT | |
| SMALLINT | SMALLINT | |
| BIGINT | BIGINT | |
| FLOAT / FLOAT4 / FLOAT8 / DOUBLE / DOUBLE PRECISION / REAL | DOUBLE | |
| VARCHAR / STRING / TEXT | VARCHAR / STRING | VARCHAR の最大長は 65535 |
| CHAR / CHARACTER / NCHAR | CHAR | |
| BINARY / VARBINARY | STRING | |
| BOOLEAN | BOOLEAN | |
| DATE | DATE | |
| DATETIME / TIMESTAMP / TIMESTAMP_NTZ | DATETIME | TIMESTAMP はユーザーが設定できる別名で、デフォルトでは TIMESTAMP_NTZ を指す |
| TIME | STRING | Snowflake からエクスポートする際に String 型にキャストする必要がある |
| VARIANT | VARIANT | |
| ARRAY | ARRAY<T> | |
| OBJECT | JSON | |
| GEOGRAPHY / GEOMETRY | STRING |
移行手順
移行は、Doris に対象テーブルを作成する → Snowflake からオブジェクトストレージにデータをエクスポートする → S3 Load で Doris にインポートする、という三段階で行います。
ステップ 1: Doris に対象テーブルを作成する
Snowflake に次のテーブルとデータがすでに存在するとします。
CREATE OR REPLACE TABLE sales_data (
    order_id      INT PRIMARY KEY,
    customer_name VARCHAR(128),
    order_date    DATE,
    amount        DECIMAL(10,2),
    country       VARCHAR(48)
)
CLUSTER BY (order_date);

INSERT INTO sales_data VALUES
(1, 'Alice',   '2025-04-08',  99.99, 'USA'),
(2, 'Bob',     '2025-04-08', 149.50, 'Canada'),
(3, 'Charlie', '2025-04-09',  75.00, 'UK'),
(4, 'Diana',   '2025-04-10', 200.00, 'Australia');
このテーブル構造に基づいて、Doris に Unique Key のパーティションテーブルを作成します。パーティション列には Snowflake のクラスタリングキーと同じ列を使用し、日単位の動的パーティション分割を有効にします。
CREATE TABLE `sales_data` (
    order_id      INT,
    order_date    DATE NOT NULL,
    customer_name VARCHAR(128),
    amount        DECIMAL(10,2),
    country       VARCHAR(48)
) ENGINE=OLAP
UNIQUE KEY(`order_id`, `order_date`)
PARTITION BY RANGE(`order_date`) (
    PARTITION p20250408 VALUES [('2025-04-08'), ('2025-04-09')),
    PARTITION p20250409 VALUES [('2025-04-09'), ('2025-04-10')),
    PARTITION p20250410 VALUES [('2025-04-10'), ('2025-04-11'))
)
DISTRIBUTED BY HASH(`order_id`) BUCKETS 16
PROPERTIES (
    "dynamic_partition.enable" = "true",
    "dynamic_partition.time_unit" = "DAY",
    "dynamic_partition.end" = "5",
    "dynamic_partition.prefix" = "p",
    "dynamic_partition.buckets" = "16",
    "replication_num" = "1"
);
ステップ 2: Snowflake からオブジェクトストレージにデータをエクスポートする
Snowflake は、複数のオブジェクトストレージサービスへのデータのエクスポートに対応しています。
後続のインポートをパーティション単位でバッチ処理できるように、Doris のパーティション列でエクスポートデータを分割することを推奨します。
2.1 COPY INTO で Parquet ファイルにエクスポートする
次の例では、Snowflake のデータを order_date で分割し、Parquet 形式で AWS S3 にエクスポートします。
CREATE FILE FORMAT my_parquet_format TYPE = parquet;

CREATE OR REPLACE STAGE external_stage
URL='s3://mybucket/sales_data'
CREDENTIALS=(AWS_KEY_ID='<ak>' AWS_SECRET_KEY='<sk>')
FILE_FORMAT = my_parquet_format;

COPY INTO @external_stage FROM sales_data
PARTITION BY (CAST(order_date AS VARCHAR))
HEADER=TRUE;
2.2 S3 にエクスポートされたファイルを確認する
エクスポートが完了すると、S3 にパーティションごとのサブディレクトリが生成されます。各パーティションに一つのディレクトリが対応します。
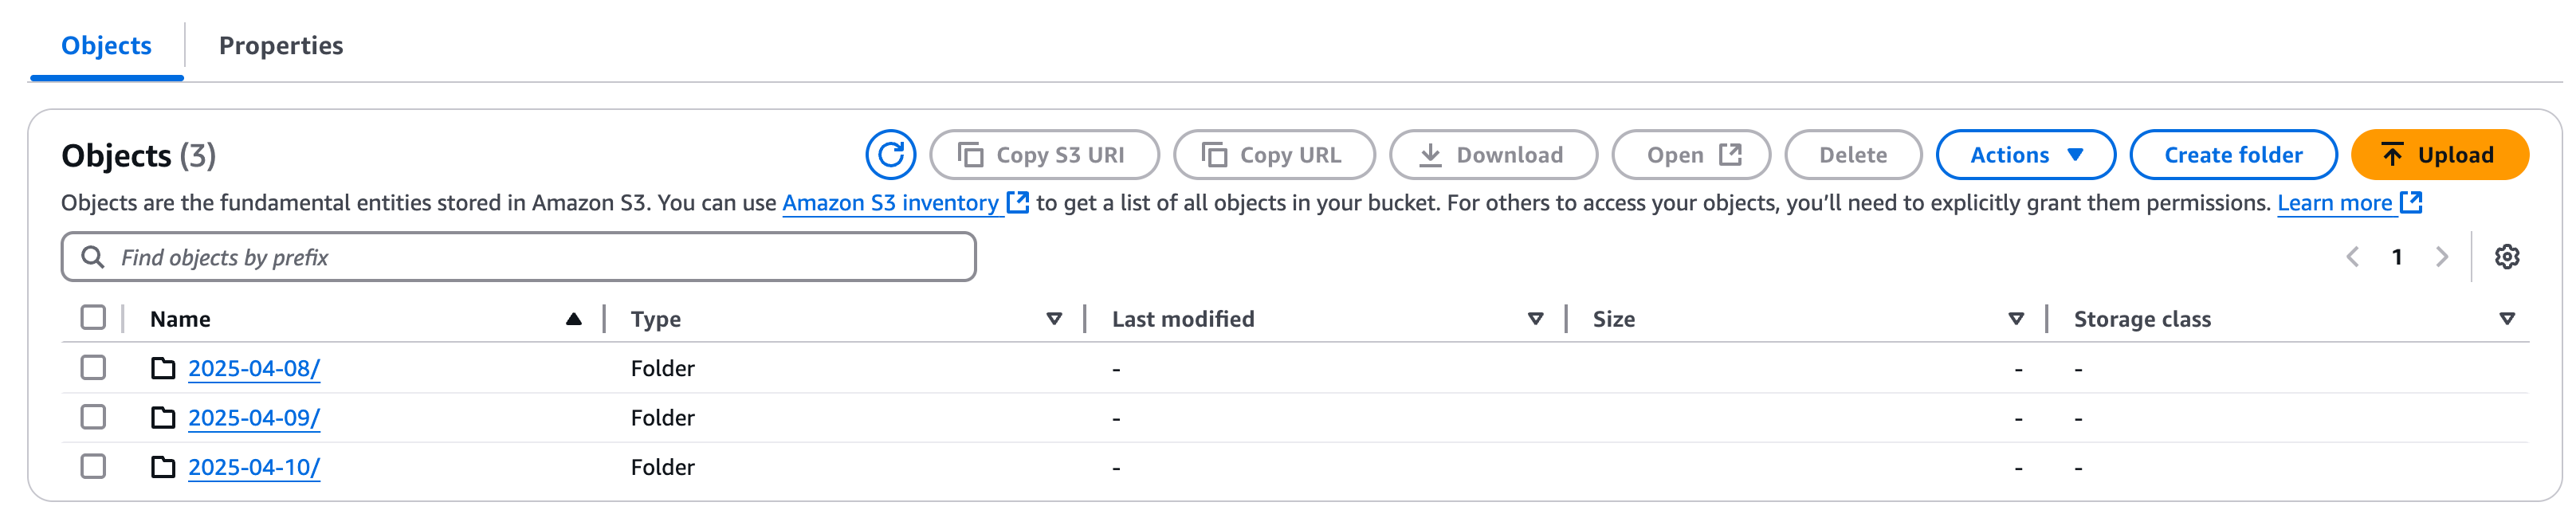
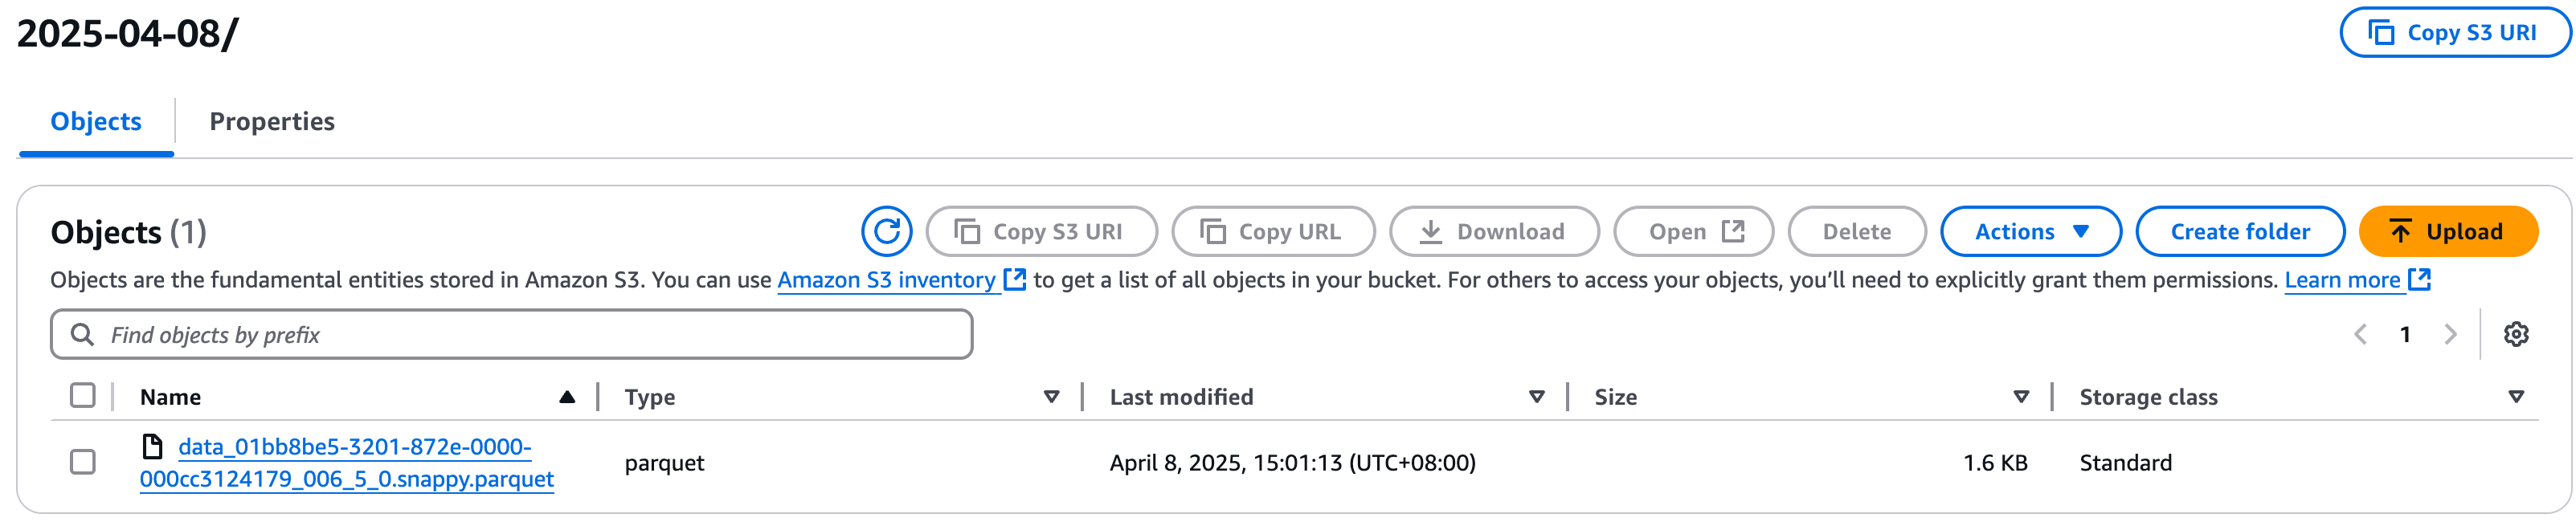
ステップ 3: S3 Load で Doris にインポートする
S3 Load は非同期のデータインポート方法です。コマンドの実行後、Doris がデータソースからデータを取得します。AWS S3、GCS、Azure など、S3 プロトコルと互換性のあるオブジェクトストレージに対応しています。
S3 Load は、大量のデータをバックグラウンドで非同期処理する必要がある場合に適しています。少量のデータを同期処理する場合は、TVF Load を使用できます。
複雑な型(Struct/Array/Map)を含む Parquet/ORC ファイルには、現時点では TVF Load を使用する必要があります。
3.1 単一パーティションのデータをインポートする
次の例では、S3 上の 2025_04_08 パーティションディレクトリ内にあるすべての Parquet ファイルを、Doris の sales_data テーブルにインポートします。
LOAD LABEL sales_data_2025_04_08
(
    DATA INFILE("s3://mybucket/sales_data/2025_04_08/*")
    INTO TABLE sales_data
    FORMAT AS "parquet"
    (order_id, order_date, customer_name, amount, country)
)
WITH S3
(
    "provider" = "S3",
    "s3.endpoint" = "https://s3.ap-southeast-1.amazonaws.com",
    "s3.access_key" = "<ak>",
    "s3.secret_key" = "<sk>",
    "s3.region" = "ap-southeast-1"
);
3.2 SHOW LOAD でジョブの状態を確認する
S3 Load は非同期で送信されるため、SHOW LOAD で特定の Label のインポート状態を確認する必要があります。
mysql> show load where label = "sales_data_2025_04_08"\G
*************************** 1. row ***************************
        JobId: 17956078
        Label: sales_data_2025_04_08
        State: FINISHED
     Progress: 100.00% (1/1)
         Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=2
     TaskInfo: cluster:s3.ap-southeast-1.amazonaws.com; timeout(s):3600; max_filter_ratio:0.0; priority:NORMAL
     ErrorMsg: NULL
   CreateTime: 2025-04-10 17:50:53
 EtlStartTime: 2025-04-10 17:50:54
EtlFinishTime: 2025-04-10 17:50:54
LoadStartTime: 2025-04-10 17:50:54
LoadFinishTime: 2025-04-10 17:50:54
          URL: NULL
   JobDetails: {"Unfinished backends":{"5eec1be8612d4872-91040ff1e7208a4f":[]},"ScannedRows":2,"TaskNumber":1,"LoadBytes":91,"All   backends":{"5eec1be8612d4872-91040ff1e7208a4f":[10022]},"FileNumber":1,"FileSize":1620}
TransactionId: 766228
 ErrorTablets: {}
         User: root
      Comment:
1 row in set (0.00 sec)
3.3 インポート中のエラーに対処する
複数のインポートジョブがある場合は、次のステートメントで失敗したジョブとその理由をまとめて確認できます。
mysql> show load where state='CANCELLED' and label like "label_test%"\G
*************************** 1. row ***************************
        JobId: 18312384
        Label: label_test123
        State: CANCELLED
     Progress: 100.00% (3/3)
         Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=4; dpp.norm.ALL=0
     TaskInfo: cluster:s3.ap-southeast-1.amazonaws.com; timeout(s):14400; max_filter_ratio:0.0; priority:NORMAL
     ErrorMsg: type:ETL_QUALITY_UNSATISFIED; msg:quality not good enough to cancel
   CreateTime: 2025-04-15 17:32:59
 EtlStartTime: 2025-04-15 17:33:02
EtlFinishTime: 2025-04-15 17:33:02
LoadStartTime: 2025-04-15 17:33:02
LoadFinishTime: 2025-04-15 17:33:02
          URL: http://10.16.10.6:28747/api/_load_error_log?file=__shard_2   error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342
   JobDetails: {"Unfinished backends":{"7602ccd7c3a4854-95307efca7bfe341":[]},"ScannedRows":4,"TaskNumber":1,"LoadBytes":188,"All   backends":{"7602ccd7c3a4854-95307efca7bfe341":[10022]},"FileNumber":3,"FileSize":4839}
TransactionId: 769213
 ErrorTablets: {}
         User: root
      Comment:
上の例はデータ品質エラー(ETL_QUALITY_UNSATISFIED)です。エラーの詳細を確認するには、URL フィールドに返されたリンクにアクセスします。次のエラーは、データの country 列の実際の長さが、テーブルスキーマで定義された長さを超えていることを示しています。
[root@VM-10-6-centos ~]$ curl "http://10.16.10.6:28747/api/_load_error_log?file=__shard_2   error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342"
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [USA] schema length: 1; actual   length: 3; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Canada] schema length: 1; actual   length: 6; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [UK] schema length: 1; actual   length: 2; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Australia] schema length: 1;   actual length: 9; . src line [];
データ品質エラーが発生しても一部の誤ったデータをスキップしてよい場合は、S3 Load ジョブの PROPERTIES でエラー許容率を設定できます。詳細は、インポート設定パラメータを参照してください。
3.4 複数パーティションをバッチでインポートする
大量の既存データを移行する場合は、バッチ単位のインポートを推奨します。
- 各バッチを、Doris の一つまたは少数のパーティションに対応させます。
- バッチあたりの推奨サイズは 100 GB 以下です。
- これによりシステムへの負荷を抑え、インポート失敗時の再試行コストを下げられます。
s3_load_demo.sh スクリプトを参考にできます。このスクリプトは S3 上のパーティションディレクトリをポーリングし、Doris に S3 Load ジョブを自動送信して、バッチ単位でインポートします。
よくある質問
Q1: インポートジョブで ETL_QUALITY_UNSATISFIED エラーが報告された場合、どのように調査しますか?
これはデータ品質エラーです。一般的な原因には、フィールド長がスキーマ定義を超えていること、型が一致しないこと、必須フィールドが NULL であることなどがあります。次の手順で調査します。
- ジョブの
URLフィールドをSHOW LOADで確認します。 curlでその URL にアクセスし、詳細なエラーログを取得します。- エラーメッセージに基づいて、ソースデータを修正するか、Doris のテーブルスキーマを調整します。
- 少量の不正なデータを許容できる場合は、エラー許容率
max_filter_ratioをジョブのPROPERTIESで設定します。
Q2: 複雑な型を含む Parquet ファイルをインポートするにはどうすればよいですか?
Struct/Array/Map などの複雑な型を含む Parquet/ORC ファイルには、現時点では S3 Load は対応していません。TVF Load を使用する必要があります。
Q3: Snowflake の TIME 型を String に変換する必要があるのはなぜですか?
Doris には Snowflake の TIME に完全に対応する型がありません。そのため、Snowflake から COPY INTO でエクスポートする際は、CAST を使って TIME フィールドを STRING 型に変換する必要があります。Doris にインポートした後は STRING として保存されます。
Q4: 大きなテーブルの移行を高速化するにはどうすればよいですか?
- Snowflake 側では、並列インポートしやすいように Doris のパーティション列でデータを分割してエクスポートします。
- Doris 側ではバッチ単位でインポートし、各バッチを 100 GB 以下にします。
- s3_load_demo.sh スクリプトで、複数の S3 Load ジョブを並行して送信します。
Q5: Snowflake の OBJECT 型と VARIANT 型はどの型に対応しますか?
VARIANTは Doris のVARIANT型に直接対応します。OBJECTは Doris のJSON型に対応します。