Routine Load
Routine Load は、Apache Doris が提供するストリーミングデータロードジョブです。Kafka トピックからデータを継続的に読み取り、Doris のテーブルに書き込みます。Routine Load ジョブを送信すると、Doris はジョブを継続して実行し、Kafka クラスター内の指定されたトピックからメッセージを読み取るデータロードタスクをリアルタイムで生成します。また、Exactly-Once セマンティクスにより、データの欠落や重複を防ぎます。
クイックナビゲーション
目的に応じて、該当するセクションに進んでください。
| 目的 | セクション |
|---|---|
| 最小限の例をすぐに実行する | クイックスタート |
| 仕組み、状態遷移、自動復旧の仕組みを理解する | 基本原理 |
| 設定可能なパラメータ(FE/BE/ジョブ/Kafka)を調べる | リファレンスマニュアル |
| シナリオ別の例(障害許容、フィルタリング、JSON、Kerberos など)を探す | データロードの例 |
ジョブが PAUSED になる、out of range が報告される、または SSL エラーが発生する | よくある質問(FAQ) |
ユースケース
Routine Load は、次のシナリオに適しています。
- Kafka トピックから Doris にリアルタイムデータを継続的に同期する。
- データの欠落や重複を避けるため、Exactly-Once セマンティクスが必要な場合。
- 取り込むデータに列のマッピング、フィルタリング、派生列の計算などの変換を適用する。
- 単一の Kafka トピックから複数の Doris テーブルにデータを動的に振り分ける(単一ストリーム、複数テーブル)。
対応するデータソースと形式
Routine Load が読み取り元としてサポートするのは Kafka クラスターのみで、次のメッセージ形式に対応します。
| 形式 | 説明 |
|---|---|
| CSV | 各メッセージは単一行で、行末に改行文字を含めません。 |
| JSON | 単一の JSON オブジェクト、または複数のオブジェクトを含む JSON 配列。 |
CSV 形式でデータを取り込む場合は、NULL 値と空文字列を明確に区別してください。
- NULL 値は
\nで表します。たとえば、a,\n,bは中央の列が NULL 値であることを示します。 - 空文字列は、そのまま空のデータとして設定されます。たとえば、
a,,bは中央の列が空文字列('')であることを示します。
制限事項
Routine Load で Kafka からデータを読み取る場合、次の制限があります。
| 制限 | 説明 |
|---|---|
| メッセージ形式 | CSV と JSON のテキスト形式のみをサポートします。各 CSV メッセージは単一行で、行末に改行文字を含めません。 |
| Kafka のバージョン | デフォルトでは Kafka 0.10.0.0 以降をサポートします。0.10.0.0 より前の Kafka バージョン(0.9.0、0.8.2、0.8.1、0.8.0)を使用するには、BE 設定の kafka_broker_version_fallback を互換性が必要な旧バージョンに変更するか、ジョブ作成時に property.broker.version.fallback を直接設定します。旧バージョンを使用すると、時刻による Kafka パーティションオフセットの設定など、Routine Load の一部の新機能を利用できない場合があります。 |
基本原理
Routine Load は Kafka トピックからデータを継続的に読み取り、Doris に書き込みます。Doris で Routine Load ジョブを作成すると、複数のデータロードタスクを含む、長時間実行されるデータロードジョブが生成されます。
- データロードジョブ: Routine Load Job は、データソースからデータを継続的に読み取る、長時間実行されるデータロードジョブです。
- データロードタスク: 実際の読み取り処理のため、データロードジョブは複数のタスクに分割されます。各タスクは独立したトランザクションです。
Routine Load の詳細な流れを次の図に示します。
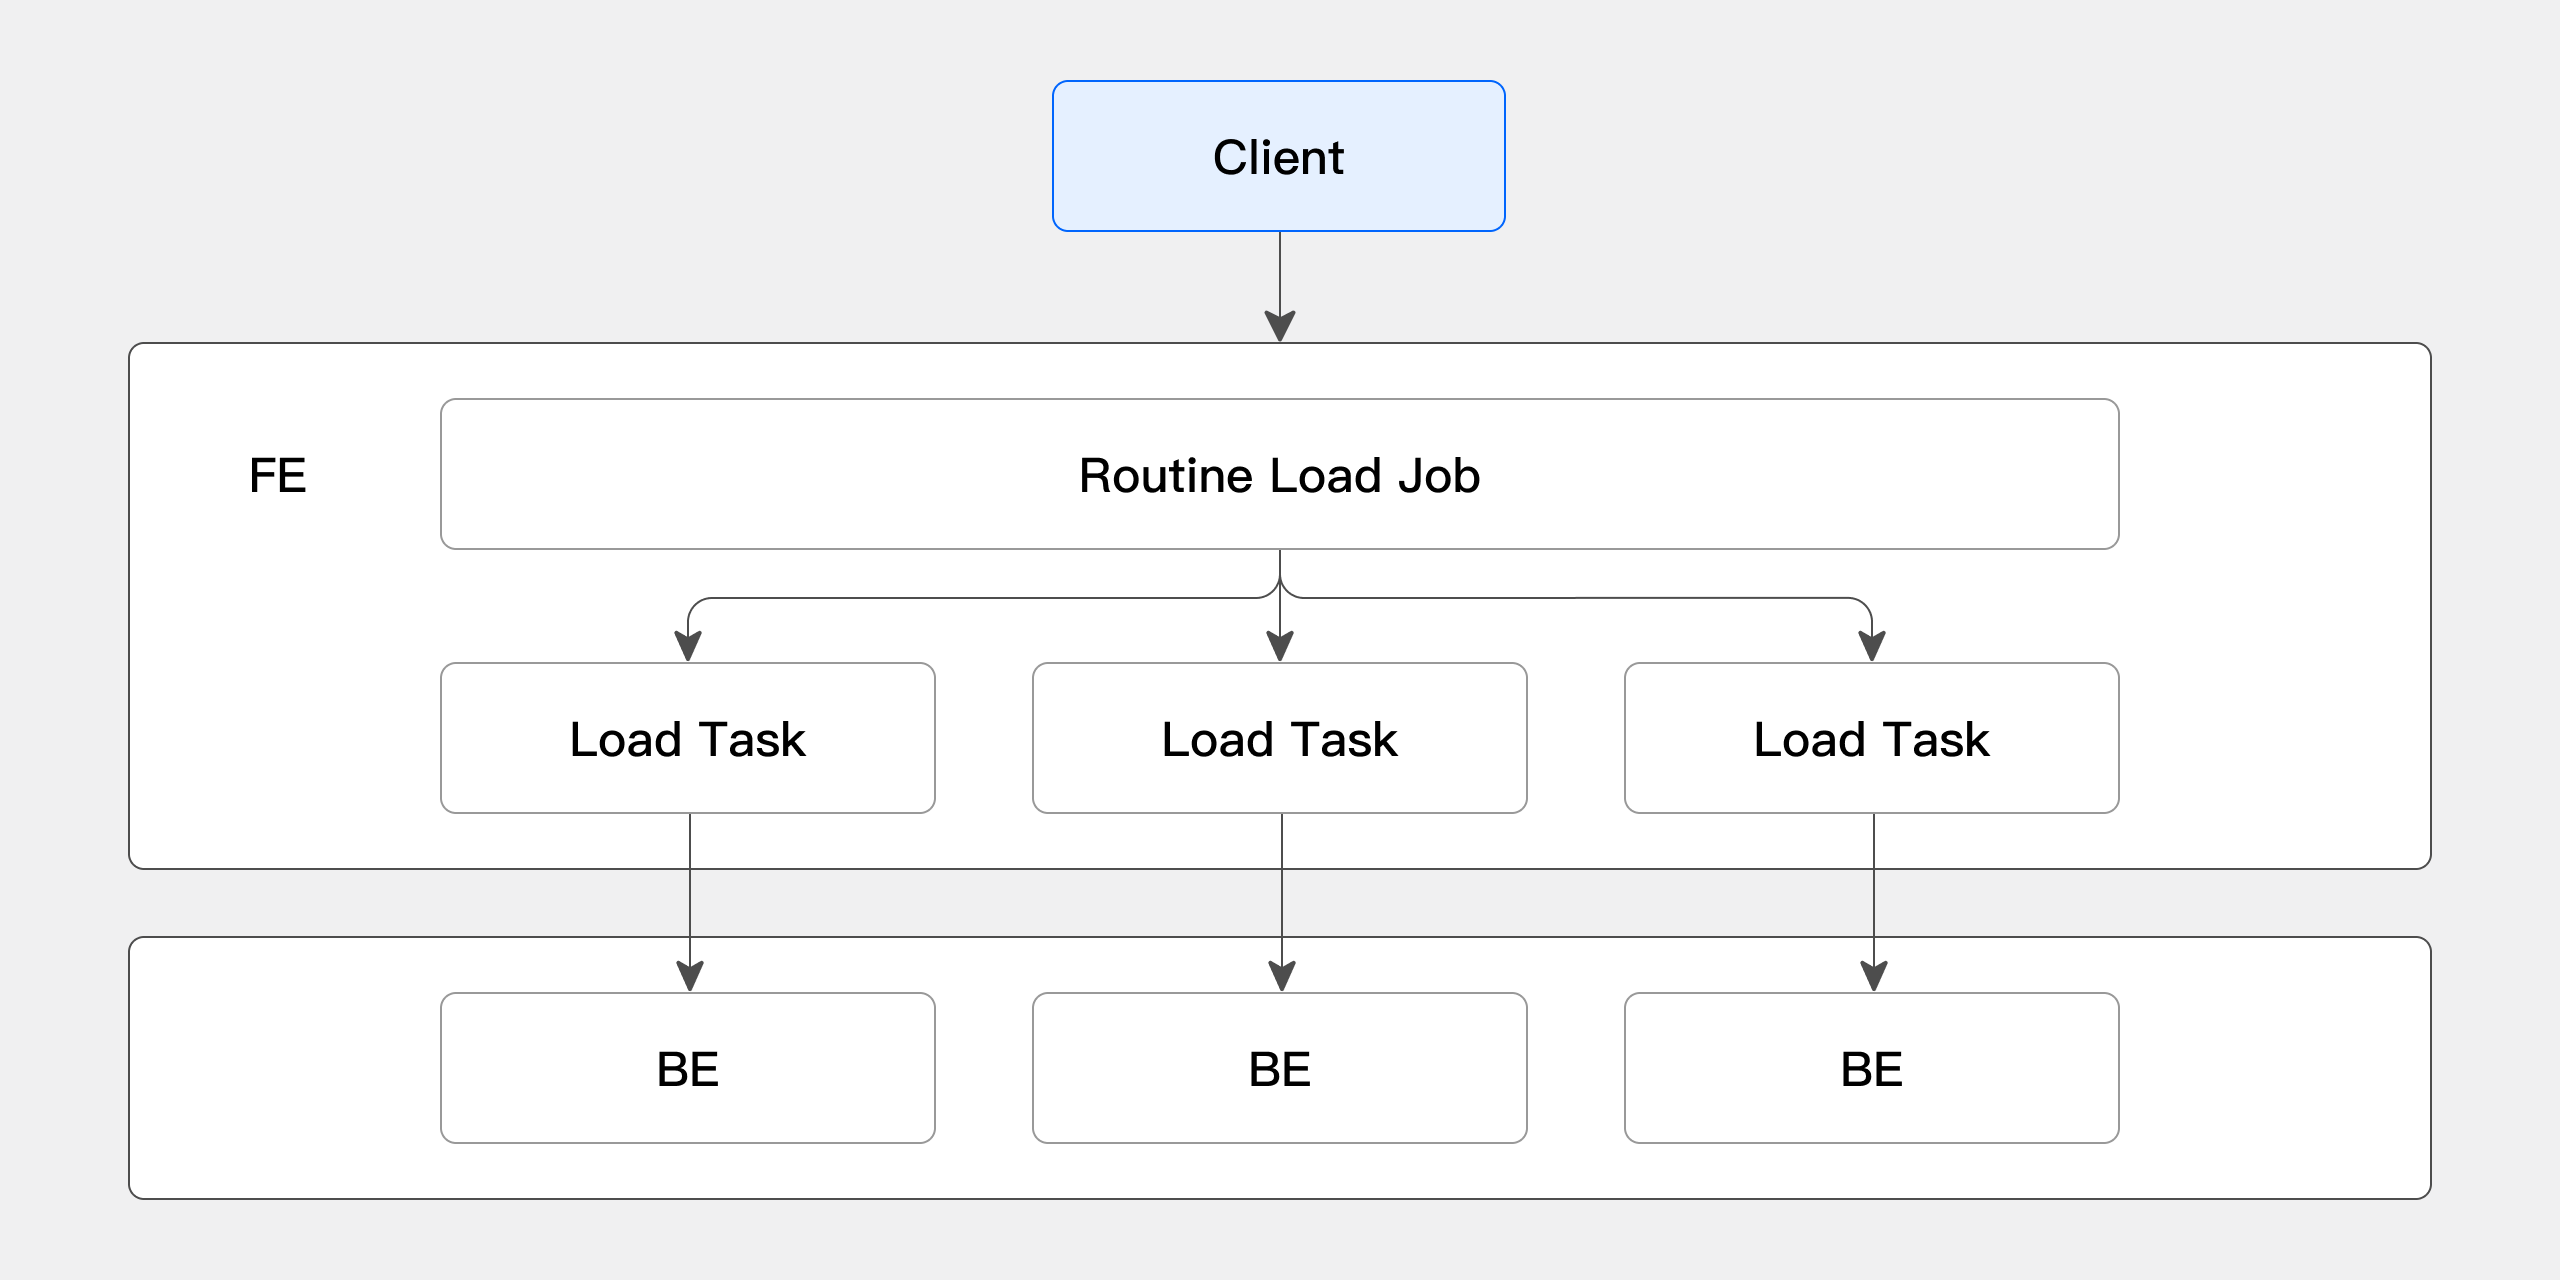
全体の流れは次のとおりです。
- クライアントが FE に Routine Load ジョブの作成リクエストを送信します。FE は Routine Load Manager を通じて、長時間実行されるデータロードジョブ(Routine Load Job)を生成します。
- FE は Job Scheduler を通じて Routine Load Job を複数の Routine Load Task に分割します。その後、Task Scheduler がタスクを BE ノードに割り当てます。
- BE で Routine Load Task のデータロードが完了すると、FE にトランザクションをコミットし、ジョブのメタデータを更新します。
- Routine Load Task がコミットされると、新しいタスクが生成されるか、タイムアウトしたタスクが再試行されます。
- 新しく生成された Routine Load Task は、Task Scheduler によって継続的にスケジュールされます。
自動復旧の仕組み
ジョブの高可用性を確保するため、Routine Load には自動復旧の仕組みがあります。ジョブが予期せず一時停止すると、Routine Load Scheduler スレッドが自動復旧を試みます。Kafka 側の予期しない停止などで処理を続行できなくなっても、Kafka が復旧すれば、手動操作なしでデータロードジョブを正常に再開できます。
自動復旧されるケースと、手動操作が必要なケースを次に示します。
| 一時停止の原因 | 自動復旧 | 推奨される対応 |
|---|---|---|
| Kafka broker に一時的に接続できない、ネットワークが不安定 | あり | Scheduler が period_of_auto_resume_min の間隔で自動的に再試行します。 |
ユーザーが PAUSE ROUTINE LOAD を手動で実行した | なし | RESUME ROUTINE LOAD を手動で実行します。 |
データ品質の問題(max_filter_ratio または max_error_number の超過) | なし | ErrorLogUrls を調査し、データまたはパラメータを調整してから RESUME します。 |
| データベースやテーブルの削除など、復旧できないメタデータの例外 | なし | テーブルを再作成するか、ジョブを作り直します。 |
クイックスタート
このセクションでは、Kafka から Routine Load ジョブを作成する最小限の実行例と、ジョブの表示、一時停止、再開、変更、停止の基本操作を説明します。
データロードジョブを作成する
CREATE ROUTINE LOAD コマンドを使用すると、長時間実行される Routine Load データロードタスクを作成できます。Routine Load は CSV と JSON のデータを読み取れます。
CSV データを取り込む
-
Kafka のサンプルデータを用意します。
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test-routine-load-csv --from-beginning
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64 -
データロード先のテーブルを作成します。
CREATE TABLE testdb.test_routineload_tbl(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
Routine Load ジョブを作成します。
CREATE ROUTINE LOAD testdb.example_routine_load_csv ON test_routineload_tbl
COLUMNS TERMINATED BY ",",
COLUMNS(user_id, name, age)
FROM KAFKA(
    "kafka_broker_list" = "192.168.88.62:9092",
    "kafka_topic" = "test-routine-load-csv",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
JSON データを取り込む
-
Kafka のサンプルデータを用意します。
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test-routine-load-json --from-beginning
{"user_id":1,"name":"Emily","age":25}
{"user_id":2,"name":"Benjamin","age":35}
{"user_id":3,"name":"Olivia","age":28}
{"user_id":4,"name":"Alexander","age":60}
{"user_id":5,"name":"Ava","age":17}
{"user_id":6,"name":"William","age":69}
{"user_id":7,"name":"Sophia","age":32}
{"user_id":8,"name":"James","age":64}
{"user_id":9,"name":"Emma","age":37}
{"user_id":10,"name":"Liam","age":64} -
データロード先のテーブルを作成します。
CREATE TABLE testdb.test_routineload_tbl(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
Routine Load ジョブを作成します。
CREATE ROUTINE LOAD testdb.example_routine_load_json ON test_routineload_tbl
COLUMNS(user_id,name,age)
PROPERTIES(
    "format"="json",
    "jsonpaths"="[\"$.user_id\",\"$.name\",\"$.age\"]"
)
FROM KAFKA(
    "kafka_broker_list" = "192.168.88.62:9092",
    "kafka_topic" = "test-routine-load-json",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
JSON ファイルのルートにある JSON オブジェクトを取り込むには、jsonpaths を $. に設定します。例: PROPERTIES("jsonpaths"="$. ")。
データロードの状態を確認する
Routine Load の状態は、次の観点から確認できます。
- データロードジョブ: データロード先のテーブル、サブタスク数、取り込み遅延の状態、設定、結果を確認します。
- データロードタスク: サブタスクの状態、読み取りの進行状況、タスクが割り当てられた BE ノードを確認します。
データロードジョブを確認する
SHOW ROUTINE LOAD コマンドでデータロードジョブを確認します。このコマンドには、データロード先のテーブル、遅延の状態、設定、エラー情報など、現在のジョブの基本状態が表示されます。
次のコマンドは、testdb.example_routine_load_csv のジョブ状態を表示します。
mysql> SHOW ROUTINE LOAD FOR testdb.example_routine_load\G
*************************** 1. row ***************************
                  Id: 12025
                Name: example_routine_load
          CreateTime: 2024-01-15 08:12:42
           PauseTime: NULL
             EndTime: NULL
              DbName: default_cluster:testdb
           TableName: test_routineload_tbl
        IsMultiTable: false
               State: RUNNING
      DataSourceType: KAFKA
      CurrentTaskNum: 1
       JobProperties: {"max_batch_rows":"200000","timezone":"America/New_York","send_batch_parallelism":"1","load_to_single_tablet":"false","column_separator":"','","line_delimiter":"\n","current_concurrent_number":"1","delete":"*","partial_columns":"false","merge_type":"APPEND","exec_mem_limit":"2147483648","strict_mode":"false","jsonpaths":"","max_batch_interval":"10","max_batch_size":"104857600","fuzzy_parse":"false","partitions":"*","columnToColumnExpr":"user_id,name,age","whereExpr":"*","desired_concurrent_number":"5","precedingFilter":"*","format":"csv","max_error_number":"0","max_filter_ratio":"1.0","json_root":"","strip_outer_array":"false","num_as_string":"false"}
DataSourceProperties: {"topic":"test-topic","currentKafkaPartitions":"0","brokerList":"192.168.88.62:9092"}
    CustomProperties: {"kafka_default_offsets":"OFFSET_BEGINNING","group.id":"example_routine_load_73daf600-884e-46c0-a02b-4e49fdf3b4dc"}
           Statistic: {"receivedBytes":28,"runningTxns":[],"errorRows":0,"committedTaskNum":3,"loadedRows":3,"loadRowsRate":0,"abortedTaskNum":0,"errorRowsAfterResumed":0,"totalRows":3,"unselectedRows":0,"receivedBytesRate":0,"taskExecuteTimeMs":30069}
            Progress: {"0":"2"}
                 Lag: {"0":0}
ReasonOfStateChanged:
        ErrorLogUrls:
            OtherMsg:
                User: root
             Comment:
1 row in set (0.00 sec)
データロードのサブタスクを確認する
SHOW ROUTINE LOAD TASK コマンドでサブタスクを確認します。このコマンドには、サブタスクの状態や割り当て先の BE id など、現在のジョブに属するサブタスクの情報が表示されます。
次のコマンドは、testdb.example_routine_load_csv のサブタスク情報を表示します。
mysql> SHOW ROUTINE LOAD TASK WHERE jobname = 'example_routine_load_csv';
+-----------------------------------+-------+-----------+-------+---------------------+---------------------+---------+-------+----------------------+
| TaskId                            | TxnId | TxnStatus | JobId | CreateTime          | ExecuteStartTime    | Timeout | BeId  | DataSourceProperties |
+-----------------------------------+-------+-----------+-------+---------------------+---------------------+---------+-------+----------------------+
| 8cf47e6a68ed4da3-8f45b431db50e466 | 195   | PREPARE   | 12177 | 2024-01-15 12:20:41 | 2024-01-15 12:21:01 | 20      | 10429 | {"4":1231,"9":2603}  |
| f2d4525c54074aa2-b6478cf8daaeb393 | 196   | PREPARE   | 12177 | 2024-01-15 12:20:41 | 2024-01-15 12:21:01 | 20      | 12109 | {"1":1225,"6":1216}  |
| cb870f1553864250-975279875a25fab6 | -1    | NULL      | 12177 | 2024-01-15 12:20:52 | NULL                | 20      | -1    | {"2":7234,"7":4865}  |
| 68771fd8a1824637-90a9dac2a7a0075e | -1    | NULL      | 12177 | 2024-01-15 12:20:52 | NULL                | 20      | -1    | {"3":1769,"8":2982}  |
| 77112dfea5e54b0a-a10eab3d5b19e565 | 197   | PREPARE   | 12177 | 2024-01-15 12:21:02 | 2024-01-15 12:21:02 | 20      | 12098 | {"0":3000,"5":2622}  |
+-----------------------------------+-------+-----------+-------+---------------------+---------------------+---------+-------+----------------------+
データロードジョブを一時停止する
PAUSE ROUTINE LOAD コマンドでデータロードジョブを一時停止できます。一時停止したジョブは PAUSED 状態になりますが、終了はしません。RESUME ROUTINE LOAD コマンドで再開できます。
PAUSE ROUTINE LOAD FOR testdb.example_routine_load_csv;
データロードジョブを再開する
RESUME ROUTINE LOAD コマンドで、PAUSED 状態のデータロードジョブを再開できます。
RESUME ROUTINE LOAD FOR testdb.example_routine_load_csv;
データロードジョブを変更する
ALTER ROUTINE LOAD コマンドで、作成済みのデータロードジョブを変更できます。変更前に PAUSE ROUTINE LOAD でジョブを一時停止し、変更後に RESUME ROUTINE LOAD で再開します。
たとえば、目標並列数のパラメータ desired_concurrent_number と Kafka トピック情報を変更するには、次のようにします。
ALTER ROUTINE LOAD FOR testdb.example_routine_load_csv
PROPERTIES(
    "desired_concurrent_number" = "3"
)
FROM KAFKA(
    "kafka_broker_list" = "192.168.88.60:9092",
    "kafka_topic" = "test-topic"
);
データロードジョブを取り消す
STOP ROUTINE LOAD コマンドで Routine Load ジョブを停止し、削除できます。削除したデータロードジョブは復元できず、SHOW ROUTINE LOAD コマンドでも表示できません。
STOP ROUTINE LOAD FOR testdb.example_routine_load_csv;
Compute Group をバインドする
ストレージとコンピューティングを分離したモードでは、Routine Load が使用する Compute Group は次の優先順位で選択されます。
- 4.1.5 以降では、ジョブプロパティ
"compute_group" = "<compute_group_name>"で明示的にバインドされた Compute Group を優先します。 - このプロパティを省略した場合は、
use db@clusterで指定された Compute Group を選択します。 - ユーザープロパティ
default_compute_groupで指定された Compute Group を選択します。 - 現在のユーザーにアクセス権限がある Compute Group を選択します。
compute_group は、デフォルトのバインド先を持たない任意の文字列プロパティです。コンピューティングとストレージを分離したモードでのみサポートされます。グループが存在し、作成者がそのグループに対する USAGE 権限を持っている必要があります。DEFAULT は大文字と小文字を区別せずに予約されており、バインドできません。明示的なバインドはセッションでの選択より優先されます。各タスクは実行前に、グループの存在とジョブ所有者の権限を再確認します。グループが存在しない場合、復旧までジョブが一時停止することがあります。権限が取り消された場合は、権限を復元してからジョブを手動で再開してください。
以下の CREATE ROUTINE LOAD の例では、PROPERTIES にこのプロパティを追加します。
PROPERTIES (
    "compute_group" = "cg_ingest",
    "desired_concurrent_number" = "3"
)
ストレージとコンピューティングが統合されたモードでは、ユーザープロパティ resource_tags.location で指定された Compute Group を選択します。ユーザープロパティで Compute Group が指定されていない場合は、default という名前の Compute Group を使用します。
Routine Load ジョブの Compute Group は、作成時にのみ指定できます。ジョブの作成後、バインドされた Compute Group は変更できません。
リファレンスマニュアル
データロードコマンドの構文
長時間実行される Routine Load ジョブの作成構文は次のとおりです。
CREATE ROUTINE LOAD [<db_name>.]<job_name> [ON <tbl_name>]
[merge_type]
[load_properties]
[job_properties]
FROM KAFKA [data_source_properties]
[COMMENT "<comment>"]
各要素の説明は次のとおりです。
| 要素 | 説明 |
|---|---|
| db_name | データロードタスクを作成するデータベースを指定します。 |
| job_name | 作成するデータロードタスクの名前を指定します。同じデータベース内に同名のタスクは存在できません。 |
| tbl_name | データロード先のテーブル名を指定します。省略可能です。指定しない場合は動的テーブル方式が使用され、Kafka のデータにテーブル名を含める必要があります。 |
| merge_type | データのマージ方式です。デフォルト値は APPEND です。 次の方式があります。 - APPEND: 追加して取り込みます。 - MERGE: マージして取り込みます。 - DELETE: 取り込んだデータをすべて削除対象とします。 |
| load_properties | データロードの指定項目です。次の要素が含まれます。 - column_separator 句 - columns_mapping 句 - preceding_filter 句 - where_predicates 句 - partitions 句 - delete_on 句 - order_by 句 |
| job_properties | Routine Load 共通のデータロードパラメータを指定します。 |
| data_source_properties | Kafka データソースのプロパティを指定します。 |
| comment | データロードジョブのコメントを指定します。 |
データロードパラメータの説明
FE 設定パラメータ
| パラメータ | デフォルト値 | 動的変更 | FE Master のみ | 説明 |
|---|---|---|---|---|
| max_routine_load_task_concurrent_num | 256 | 可 | はい | Routine Load ジョブのサブタスクの最大並列数を制限します。デフォルト値の維持を推奨します。大きすぎる値を設定すると、同時実行タスクが増えすぎてクラスターのリソースを消費する可能性があります。 |
| max_routine_load_task_num_per_be | 1024 | 可 | はい | 各 BE で同時実行できる Routine Load タスクの最大数です。max_routine_load_task_num_per_be は routine_load_thread_pool_size より小さくする必要があります。 |
| max_routine_load_job_num | 100 | 可 | はい | NEED_SCHEDULED、RUNNING、PAUSE 状態のジョブを含めた、Routine Load ジョブの最大数を制限します。 |
| max_tolerable_backend_down_num | 0 | 可 | はい | BE が停止している場合の自動復旧条件を設定します。BE が停止していると、Routine Load は自動復旧できません。条件が満たされると、Doris は PAUSED タスクを再スケジュールし、RUNNING 状態に切り替えられます。値が 0 の場合、すべての BE ノードが稼働しているときにのみ再スケジュールできます。 |
| period_of_auto_resume_min | 5(分) | 可 | はい | Routine Load の自動復旧を実行する間隔です。 |
BE 設定パラメータ
| パラメータ | デフォルト値 | 動的変更 | 説明 |
|---|---|---|---|
| max_consumer_num_per_group | 3 | 可 | 単一のサブタスクが読み取りのために起動できる consumer の最大数です。 |
データロード設定パラメータ
Routine Load ジョブの作成時に、CREATE ROUTINE LOAD コマンドで各要素の設定パラメータを指定できます。
tbl_name 句
データロード先のテーブル名を指定します。省略可能です。
指定しない場合は動的テーブル方式が使用され、Kafka のデータにテーブル名を含める必要があります。現在、動的テーブル名は Kafka Value から抽出する方法のみがサポートされており、データは所定の形式に従う必要があります。JSON の場合は table_name|{"col1": "val1", "col2": "val2"} で、tbl_name がテーブル名、| がテーブル名とテーブルデータの区切り文字です。CSV 形式のデータも同様で、たとえば table_name|val1,val2,val3 とします。
ここでの table_name は Doris のテーブル名と完全に一致する必要があります。一致しない場合、データロードは失敗します。動的テーブルは column_mapping をサポートしません。
merge_type 句
merge_type でデータのマージ方式を指定できます。次の方式があります。
- APPEND: 追加して取り込みます。
- MERGE: マージして取り込みます。Unique Key モデルにのみ適用できます。Delete Flag 列を指定するため、
[DELETE ON]と併用する必要があります。 - DELETE: 取り込んだデータをすべて削除対象とします。
load_properties 句
load_properties で取り込むデータのプロパティを指定できます。構文は次のとおりです。
[COLUMNS TERMINATED BY <column_separator>,]
[COLUMNS (<column1_name>[, <column2_name>, <column_mapping>, ...]),]
[WHERE <where_expr>,]
[PARTITION(<partition1_name>, [<partition2_name>, <partition3_name>, ...]),]
[DELETE ON <delete_expr>,]
[ORDER BY <order_by_column1>[, <order_by_column2>, <order_by_column3>, ...]]
各要素のパラメータは次のとおりです。
| 要素 | パラメータ | 説明 |
|---|---|---|
| COLUMNS TERMINATED BY | <column_separator> | 列の区切り文字を指定します。デフォルトは \t です。たとえば、カンマを区切り文字にするには COLUMN TERMINATED BY "," と指定します。NULL 値の扱いには注意してください。- NULL 値は - 空文字列はそのまま空のデータとして設定されます。 |
| COLUMNS | <column_name> | 対応する列名を指定します。たとえば、取り込み列 (k1, k2, k3) を指定するには COLUMNS(k1, k2, k3) とします。次の場合、COLUMNS 句は省略できます。- CSV の列とテーブルの列が対応している。 - JSON のキー名とテーブルの列名が一致している。 |
<column_mapping> | データロード時に列のマッピングによるフィルタリングや変換を行えます。たとえば、取り込み先の列 k4 を k3+1 という式で k3 列から計算するには、COLUMNS(k1, k2, k3, k4 = k3 + 1) とします。詳細はデータ変換を参照してください。 | |
| WHERE | <where_expr> | 条件に基づいて取り込むデータをフィルタリングします。たとえば、age > 30 のデータのみを取り込むには WHERE age > 30 とします。 |
| PARTITION | <partition_name> | データロード先テーブルの対象パーティションを指定します。指定しない場合、データは対応するパーティションに自動的に取り込まれます。たとえば、p1 と p2 に取り込むには PARTITION(p1, p2) とします。 |
| DELETE ON | <delete_expr> | MERGE 方式では、delete_expr で削除対象を指定します。たとえば、MERGE 時に age > 30 の行を削除するには DELETE ON age > 30 とします。 |
| ORDER BY | <order_by_column> | Unique Key モデルでのみ有効です。データの順序を保証するため、取り込むデータの Sequence Column を指定します。たとえば、create_time を Sequence Column にするには ORDER BY create_time とします。詳細はデータ更新 / Sequence Columnを参照してください。 |
job_properties 句
Routine Load ジョブの作成時に、job_properties 句でジョブのプロパティを指定できます。構文は次のとおりです。
PROPERTIES ("<key1>" = "<value1>"[, "<key2>" = "<value2>" ...])
job_properties 句で指定できるパラメータは次のとおりです。
| パラメータ | 説明 |
|---|---|
| desired_concurrent_number | デフォルト値: 256 単一のデータロードタスクに対して希望する並列数です。データロード時には、希望するサブタスクの並列数と実際の並列数が異なることがあります。実際の並列数は次のように計算されます。
- - - |
| max_batch_interval | 各サブタスクの最大実行時間です。単位は秒で、0 より大きい値を指定する必要があります。デフォルト値は 60 です。max_batch_interval、max_batch_rows、max_batch_size がサブタスクの実行しきい値を構成します。いずれかに達すると、現在のサブタスクが終了し、新しいサブタスクが生成されます。 |
| max_batch_rows | 各サブタスクが読み取れる最大行数です。200000 以上にする必要があります。デフォルト値は 20000000 です。max_batch_interval、max_batch_rows、max_batch_size がサブタスクの実行しきい値を構成します。いずれかに達すると、現在のサブタスクが終了し、新しいサブタスクが生成されます。 |
| max_batch_size | 各サブタスクが読み取れる最大バイト数です。単位はバイト、範囲は 100 MB から 1 GB、デフォルト値は 1 GB です。max_batch_interval、max_batch_rows、max_batch_size がサブタスクの実行しきい値を構成します。いずれかに達すると、現在のサブタスクが終了し、新しいサブタスクが生成されます。 |
| max_error_number | サンプリングウィンドウ内で許容されるエラー行の最大数です。0 以上にする必要があります。デフォルト値は 0 で、エラー行は許容されません。サンプリングウィンドウは max_batch_rows * 10 です。ウィンドウ内のエラー行数が max_error_number を超えると、Routine Load ジョブは一時停止します。データ品質の問題を確認するには手動操作が必要です。SHOW ROUTINE LOAD コマンドの ErrorLogUrls フィールドで問題を確認できます。where 条件によって除外された行は、エラー行に数えません。 |
| strict_mode | strict mode を有効にするかどうかを指定します。デフォルトでは無効です。strict mode では、データロード時の列の型変換を厳格に判定します。有効な場合、元の値が NULL ではないのに型変換後に NULL になった行は除外されます。 フィルタリングの方針: - Strict Mode は派生列(関数による変換で生成された列)には影響しません。 - 列の型変換が必要な場合、型が不正なデータは除外されます。SHOW ROUTINE LOAD の - 取り込み先の列の型に範囲制限があり、元のデータが型変換には成功しても範囲制限を満たさない場合、strict mode は影響しません。たとえば、型が |
| timezone | データロードジョブで使用するタイムゾーンを指定します。デフォルトはセッションのタイムゾーンパラメータです。このパラメータは、データロードに関係するすべてのタイムゾーン関連関数の結果に影響します。 |
| format | 取り込むデータの形式を指定します。デフォルトは CSV です。JSON 形式もサポートします。 |
| compute_group | 4.1.5 以降でサポートします。省略可能な文字列で、デフォルトでは指定されません。コンピューティングとストレージを分離したモードでのみサポートされ、実行に使用する Compute Group を明示的にバインドします。対象グループの USAGE 権限が必要で、予約値 DEFAULT は指定できません。 |
| jsonpaths | データ形式が JSON の場合、jsonpaths で JSON データから抽出するフィールドを指定できます。例: "jsonpaths" = "[\"$.userid\",\"$.username\",\"$.age\",\"$.city\"]" |
| json_root | データ形式が JSON の場合、json_root で JSON データのルートノードを指定できます。Doris は json_root で指定されたルートノードから要素を抽出して解析します。デフォルトは空です。例: "json_root" = "$.RECORDS" |
| strip_outer_array | データ形式が JSON の場合、strip_outer_array を true にすると、JSON データを配列として扱い、各要素を行として処理します。デフォルトは false です。Kafka の JSON データは、最外層が角括弧 [] で囲まれた配列であることがよくあります。その場合は "strip_outer_array" = "true" と指定できます。たとえば、次のデータは別々の行として解析されます: [{"user_id":1,"name":"Emily","age":25},{"user_id":2,"name":"Benjamin","age":35}] |
| send_batch_parallelism | バッチデータ送信時の並列数を設定します。この値が BE 設定の max_send_batch_parallelism_per_job を超える場合、coordinator として動作する BE は max_send_batch_parallelism_per_job の値を使用します。 |
| load_to_single_tablet | タスクのデータを、対応するパーティション内の単一の tablet のみに取り込めるようにします。デフォルトは false です。このパラメータは、ランダムバケットを使用する OLAP テーブルに取り込む場合にのみ設定できます。 |
| partial_columns | 列の部分更新を有効にするかどうかを指定します。デフォルトは false です。テーブルモデルが Unique で、Merge on Write を使用する場合にのみ設定できます。単一ストリームから複数テーブルへのデータロードでは、このパラメータをサポートしません。詳細は列の部分更新を参照してください。 |
| unique_key_update_mode | Unique Key テーブルの更新モードを指定します。選択肢:
|
| partial_update_new_key_behavior | Unique Merge on Write テーブルで列の部分更新を行う際、新規行をどう扱うかを指定します。APPEND と ERROR があります。- APPEND: 新規行の挿入を許可します。- ERROR: 新規行を挿入しようとするとデータロードが失敗し、エラーが報告されます。 |
| max_filter_ratio | サンプリングウィンドウ内で許容する最大フィルタリング比率です。0 以上、1 以下にする必要があります。デフォルト値は 1.0 で、エラー行をすべて許容します。サンプリングウィンドウは max_batch_rows * 10 です。ウィンドウ内のエラー行数を総行数で割った値が max_filter_ratio を超えると、Routine Load ジョブは一時停止します。データ品質の問題を確認するには手動操作が必要です。where 条件によって除外された行は、エラー行に数えません。 |
| enclose | 囲み文字を指定します。CSV データのフィールドに行区切り文字や列区切り文字が含まれる場合、意図しない分割を防ぐため、単一バイトの文字を囲み文字として指定できます。たとえば、列区切り文字が ,、囲み文字が ' の場合、データ a,'b,c' の b,c は単一フィールドとして解析されます。 |
| escape | エスケープ文字を指定します。フィールド内に囲み文字と同じ文字がある場合、その文字をエスケープするために使用します。たとえば、囲み文字が ' でデータが a,'b,'c' の場合、b,'c を単一フィールドとして解析するには、単一バイトのエスケープ文字(\ など)を指定し、データを a,'b,\'c' に変更する必要があります。 |
data_source_properties 句
Routine Load ジョブの作成時に、data_source_properties 句で Kafka データソースのプロパティを指定できます。構文は次のとおりです。
FROM KAFKA ("<key1>" = "<value1>"[, "<key2>" = "<value2>" ...])
data_source_properties 句で指定できるパラメータは次のとおりです。
| パラメータ | 説明 |
|---|---|
| kafka_broker_list | Kafka broker の接続情報を指定します。形式は <kafka_broker_ip>:<kafka port> です。複数の broker はカンマで区切ります。例: "kafka_broker_list" = "<broker1_ip>:9092,<broker2_ip>:9092" |
| kafka_topic | 購読する Kafka トピックを指定します。単一のデータロードジョブが読み取れる Kafka トピックは単一です。 |
| kafka_partitions | 購読する Kafka パーティションを指定します。指定しない場合、デフォルトですべてのパーティションを読み取ります。 |
| kafka_offsets | 読み取る Kafka パーティションの開始オフセットです。時刻を指定した場合、その時刻以降の最も近いオフセットから読み取りを開始します。オフセットには、0 以上の具体的な値、または次の形式を指定できます。 - - - 時刻形式。例: 指定しない場合、デフォルトでトピックの全パーティションを 注意: 時刻形式と OFFSET 形式は混在できません。 |
| property | Kafka のカスタムパラメータを指定します。kafka shell の --property パラメータに相当します。パラメータの値がファイルの場合は、値の先頭に FILE: を付けます。ファイルの作成方法については CREATE FILE コマンドを参照してください。その他の対応するカスタムパラメータについては、公式の librdkafka CONFIGURATION 文書にあるクライアント側の設定を参照してください。例: "property.client.id" = "12345"、"property.group.id" = "group_id_0"、"property.ssl.ca.location" = "FILE:ca.pem"。 |
data_source_properties の Kafka property パラメータを設定すると、安全なアクセスのためのオプションを指定できます。Doris は現在、plaintext(デフォルト)、SSL、PLAIN、Kerberos などの Kafka セキュリティプロトコルをサポートしています。
データロードの状態
SHOW ROUTINE LOAD コマンドでデータロードジョブの状態を確認できます。
SHOW [ALL] ROUTINE LOAD [FOR jobName];
結果の例:
mysql> SHOW ROUTINE LOAD FOR testdb.example_routine_load\G
*************************** 1. row ***************************
                  Id: 12025
                Name: example_routine_load
          CreateTime: 2024-01-15 08:12:42
           PauseTime: NULL
             EndTime: NULL
              DbName: default_cluster:testdb
           TableName: test_routineload_tbl
        IsMultiTable: false
               State: RUNNING
      DataSourceType: KAFKA
      CurrentTaskNum: 1
       JobProperties: {"max_batch_rows":"200000","timezone":"America/New_York","send_batch_parallelism":"1","load_to_single_tablet":"false","column_separator":"','","line_delimiter":"\n","current_concurrent_number":"1","delete":"*","partial_columns":"false","merge_type":"APPEND","exec_mem_limit":"2147483648","strict_mode":"false","jsonpaths":"","max_batch_interval":"10","max_batch_size":"104857600","fuzzy_parse":"false","partitions":"*","columnToColumnExpr":"user_id,name,age","whereExpr":"*","desired_concurrent_number":"5","precedingFilter":"*","format":"csv","max_error_number":"0","max_filter_ratio":"1.0","json_root":"","strip_outer_array":"false","num_as_string":"false"}
DataSourceProperties: {"topic":"test-topic","currentKafkaPartitions":"0","brokerList":"192.168.88.62:9092"}
    CustomProperties: {"kafka_default_offsets":"OFFSET_BEGINNING","group.id":"example_routine_load_73daf600-884e-46c0-a02b-4e49fdf3b4dc"}
           Statistic: {"receivedBytes":28,"runningTxns":[],"errorRows":0,"committedTaskNum":3,"loadedRows":3,"loadRowsRate":0,"abortedTaskNum":0,"errorRowsAfterResumed":0,"totalRows":3,"unselectedRows":0,"receivedBytesRate":0,"taskExecuteTimeMs":30069}
            Progress: {"0":"2"}
                 Lag: {"0":0}
ReasonOfStateChanged:
        ErrorLogUrls:
            OtherMsg:
                User: root
             Comment:
1 row in set (0.00 sec)
結果の各列の説明は次のとおりです。
| 結果の列 | 説明 |
|---|---|
| Id | Doris が自動生成したジョブ ID。 |
| Name | ジョブ名。 |
| CreateTime | ジョブの作成時刻。 |
| PauseTime | ジョブが最後に一時停止した時刻。 |
| EndTime | ジョブの終了時刻。 |
| DbName | 対応するデータベース名。 |
| TableName | 対応するテーブル名。複数テーブルのジョブ(動的テーブル)の場合、個別のテーブル名ではなく multi-table が表示されます。 |
| IsMultiTable | ジョブが複数テーブルを対象とするかどうか(単一ストリーム、複数テーブル)。 |
| State | ジョブの実行状態。状態の詳細については、以下のジョブの状態遷移を参照してください。 |
| DataSourceType | データソースの種類: KAFKA。 |
| CurrentTaskNum | 現在のサブタスク数。 |
| JobProperties | ジョブ設定の詳細。 |
| DataSourceProperties | データソース設定の詳細。 |
| CustomProperties | カスタム設定。 |
| Statistic | ジョブの実行状態に関する統計情報。 |
| Progress | ジョブの進行状況。Kafka データソースの場合、各パーティションで現在読み取り済みのオフセットを表示します。たとえば {"0":"2"} は、Kafka パーティション 0 の読み取り進行位置が 2 であることを示します。 |
| Lag | ジョブの遅延状態。Kafka データソースの場合、各パーティションの読み取り遅延を表示します。たとえば {"0":10} は、Kafka パーティション 0 の読み取り遅延が 10 であることを示します。 |
| ReasonOfStateChanged | ジョブの状態が変わった理由。 |
| ErrorLogUrls | フィルタリングされた低品質データを確認できる URL。 |
| OtherMsg | その他のエラー情報。 |
ジョブの状態遷移
Routine Load ジョブの状態遷移は次のとおりです。
| 状態 | 意味 | 契機 | 遷移先の候補 |
|---|---|---|---|
NEED_SCHEDULE | ジョブがスケジュールを待っています。 | CREATE ROUTINE LOAD または RESUME ROUTINE LOAD の後の初期状態。 | RUNNING |
RUNNING | ジョブが実行中で、Kafka から継続的にデータを読み取っています。 | スケジュールに成功すると遷移します。 | PAUSED / STOPPED |
PAUSED | ジョブは一時停止していますが、終了していません。 | 手動の PAUSE ROUTINE LOAD、または例外による自動的な一時停止。 | NEED_SCHEDULE(手動の RESUME または自動復旧)/ CANCELLED |
STOPPED | ジョブは停止され、再起動できません。 | STOP ROUTINE LOAD。 | 終了状態。 |
CANCELLED | ジョブは取り消されました。 | データベースやテーブルの削除、またはその他の例外。 | 終了状態。 |
データロードの例
このセクションの代表的な例を、用途別に次の表にまとめます。
| カテゴリー | シナリオ | 対象となる課題 |
|---|---|---|
| データ品質とフィルタリング | データロード時の最大障害許容値を設定する | 品質が不安定なデータに含まれる不正データを許容する。 |
| データ品質とフィルタリング | データロードのフィルタリング条件を設定する | 条件を満たすデータのみを取り込む。 |
| データ品質とフィルタリング | Strict Mode で取り込む | 型変換エラーを厳格に除外する。 |
| 読み取り制御 | 指定したオフセットからデータを読み取る | Kafka オフセットを正確に制御する。 |
| 読み取り制御 | Consumer Group の group.id と client.id を指定する | Kafka consumer の ID をカスタマイズする。 |
| 書き込み制御 | 指定したパーティションにデータを取り込む | データロード先テーブルの指定パーティションのみに書き込む。 |
| 書き込み制御 | データロード時のタイムゾーンを設定する | タイムゾーンをまたぐ時刻フィールドを扱う。 |
| 書き込み制御 | merge_type を設定する | Unique Key テーブルで削除またはマージして書き込む。 |
| データ変換 | データロード時に列のマッピングと派生列の計算を行う | データロード時にフィールドを計算する。 |
| データ変換 | 囲み文字を使用してデータを取り込む | CSV フィールドに区切り文字が含まれる。 |
| 複雑な形式 | JSON 形式で取り込む | Kafka データが JSON 形式である。 |
| 複雑な形式 | 複合型を取り込む | Array、Map、Bitmap、HLL などの型を扱う。 |
| セキュリティと複数テーブル | Kafka のセキュリティ認証 | SSL/Kerberos/PLAIN などの認証を使用する。 |
| セキュリティと複数テーブル | 単一ストリームから複数テーブルに取り込む | 単一のトピックから複数の Doris テーブルに書き込む。 |
データロード時の最大障害許容値を設定する
-
取り込むサンプルデータ:
1,Benjamin,18
2,Emily,20
3,Alexander,dirty_data -
テーブル定義:
CREATE TABLE demo.routine_test01 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job01 ON routine_test01
        COLUMNS TERMINATED BY ","
        PROPERTIES
        (
            "max_filter_ratio"="0.5",
            "max_error_number" = "100",
            "strict_mode" = "true"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad01",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test01;
+------+------------+------+
| id   | name       | age  |
+------+------------+------+
|    1 | Benjamin   |   18 |
|    2 | Emily      |   20 |
+------+------------+------+
2 rows in set (0.01 sec)
指定したオフセットからデータを読み取る
-
取り込むサンプルデータ:
1,Benjamin,18
2,Emily,20
3,Alexander,22
4,Sophia,24
5,William,26
6,Charlotte,28 -
テーブル定義:
CREATE TABLE demo.routine_test02 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job02 ON routine_test02
        COLUMNS TERMINATED BY ","
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad02",
            "kafka_partitions" = "0",
            "kafka_offsets" = "3"
); -
データロード結果:
mysql> select * from routine_test02;
+------+--------------+------+
| id   | name         | age  |
+------+--------------+------+
|    4 | Sophia       |   24 |
|    5 | William      |   26 |
|    6 | Charlotte    |   28 |
+------+--------------+------+
3 rows in set (0.01 sec)
Consumer Group の group.id と client.id を指定する
-
取り込むサンプルデータ:
1,Benjamin,18
2,Emily,20
3,Alexander,22 -
テーブル定義:
CREATE TABLE demo.routine_test03 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job03 ON routine_test03
        COLUMNS TERMINATED BY ","
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad01",
            "property.group.id" = "kafka_job03",
            "property.client.id" = "kafka_client_03",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test03;
+------+------------+------+
| id   | name       | age  |
+------+------------+------+
|    1 | Benjamin   |   18 |
|    2 | Emily      |   20 |
|    3 | Alexander  |   22 |
+------+------------+------+
3 rows in set (0.01 sec)
データロードのフィルタリング条件を設定する
-
取り込むサンプルデータ:
1,Benjamin,18
2,Emily,20
3,Alexander,22
4,Sophia,24
5,William,26
6,Charlotte,28 -
テーブル定義:
CREATE TABLE demo.routine_test04 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job04 ON routine_test04
        COLUMNS TERMINATED BY ",",
        WHERE id >= 3
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad04",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test04;
+------+--------------+------+
| id   | name         | age  |
+------+--------------+------+
|    4 | Sophia       |   24 |
|    5 | William      |   26 |
|    6 | Charlotte    |   28 |
+------+--------------+------+
3 rows in set (0.01 sec)
指定したパーティションにデータを取り込む
-
取り込むサンプルデータ:
1,Benjamin,18,2024-02-04 10:00:00
2,Emily,20,2024-02-05 11:00:00
3,Alexander,22,2024-02-06 12:00:00 -
テーブル定義:
CREATE TABLE demo.routine_test05 (
    id      INT            NOT NULL  COMMENT "ID",
    name    VARCHAR(30)    NOT NULL  COMMENT "Name",
    age     INT                      COMMENT "Age",
    date    DATETIME                 COMMENT "Date"
)
DUPLICATE KEY(`id`)
PARTITION BY RANGE(`id`)
(PARTITION partition_a VALUES [("0"), ("1")),
PARTITION partition_b VALUES [("1"), ("2")),
PARTITION partition_c VALUES [("2"), ("3")))
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job05 ON routine_test05
        COLUMNS TERMINATED BY ",",
        PARTITION(partition_b)
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad05",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test05;
+------+----------+------+---------------------+
| id   | name     | age  | date                |
+------+----------+------+---------------------+
|    1 | Benjamin |   18 | 2024-02-04 10:00:00 |
+------+----------+------+---------------------+
1 rows in set (0.01 sec)
データロード時のタイムゾーンを設定する
-
取り込むサンプルデータ:
1,Benjamin,18,2024-02-04 10:00:00
2,Emily,20,2024-02-05 11:00:00
3,Alexander,22,2024-02-06 12:00:00 -
テーブル定義:
CREATE TABLE demo.routine_test06 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    date    DATETIME                 COMMENT "date"
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job06 ON routine_test06
        COLUMNS TERMINATED BY ","
        PROPERTIES
        (
            "timezone" = "Asia/Shanghai"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad06",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test06;
+------+-------------+------+---------------------+
| id   | name        | age  | date                |
+------+-------------+------+---------------------+
|    1 | Benjamin    |   18 | 2024-02-04 10:00:00 |
|    2 | Emily       |   20 | 2024-02-05 11:00:00 |
|    3 | Alexander   |   22 | 2024-02-06 12:00:00 |
+------+-------------+------+---------------------+
3 rows in set (0.00 sec)
merge_type を設定する
merge_type を指定して削除する
-
取り込むサンプルデータ:
3,Alexander,22
5,William,26
データロード前のテーブル内のデータ:
mysql> SELECT * FROM routine_test07;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
|    4 | Sophia         |   24 |
|    5 | William        |   26 |
|    6 | Charlotte      |   28 |
+------+----------------+------+ -
テーブル定義:
CREATE TABLE demo.routine_test07 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job07 ON routine_test07
        WITH DELETE
        COLUMNS TERMINATED BY ","
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad07",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> SELECT * FROM routine_test07;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    4 | Sophia         |   24 |
|    6 | Charlotte      |   28 |
+------+----------------+------+
merge_type を指定してマージする
-
取り込むサンプルデータ:
1,xiaoxiaoli,28
2,xiaoxiaowang,30
3,xiaoxiaoliu,32
4,dadali,34
5,dadawang,36
6,dadaliu,38
データロード前のテーブル内のデータ:
mysql> SELECT * FROM routine_test08;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
|    4 | Sophia         |   24 |
|    5 | William        |   26 |
|    6 | Charlotte      |   28 |
+------+----------------+------+
6 rows in set (0.01 sec) -
テーブル定義:
CREATE TABLE demo.routine_test08 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job08 ON routine_test08
        WITH MERGE
        COLUMNS TERMINATED BY ",",
        DELETE ON id = 2
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad08",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> SELECT * FROM routine_test08;
+------+-------------+------+
| id   | name        | age  |
+------+-------------+------+
|    1 | xiaoxiaoli  |   28 |
|    3 | xiaoxiaoliu |   32 |
|    4 | dadali      |   34 |
|    5 | dadawang    |   36 |
|    6 | dadaliu     |   38 |
+------+-------------+------+
5 rows in set (0.00 sec)
マージデータロードで Sequence Column を指定する
-
取り込むサンプルデータ:
1,xiaoxiaoli,28
2,xiaoxiaowang,30
3,xiaoxiaoliu,32
4,dadali,34
5,dadawang,36
6,dadaliu,38
データロード前のテーブル内のデータ:
mysql> SELECT * FROM routine_test09;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
|    4 | Sophia         |   24 |
|    5 | William        |   26 |
|    6 | Charlotte      |   28 |
+------+----------------+------+
6 rows in set (0.01 sec) -
テーブル定義:
CREATE TABLE demo.routine_test08 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "function_column.sequence_col" = "age"
); -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job09 ON routine_test09
        WITH MERGE
        COLUMNS TERMINATED BY ",",
        COLUMNS(id, name, age),
        DELETE ON id = 2,
        ORDER BY age
        PROPERTIES
        (
            "desired_concurrent_number"="1",
            "strict_mode" = "false"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad09",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> SELECT * FROM routine_test09;
+------+-------------+------+
| id   | name        | age  |
+------+-------------+------+
|    1 | xiaoxiaoli  |   28 |
|    3 | xiaoxiaoliu |   32 |
|    4 | dadali      |   34 |
|    5 | dadawang    |   36 |
|    6 | dadaliu     |   38 |
+------+-------------+------+
5 rows in set (0.00 sec)
データロード時に列のマッピングと派生列の計算を行う
-
取り込むサンプルデータ:
1,Benjamin,18
2,Emily,20
3,Alexander,22 -
テーブル定義:
CREATE TABLE demo.routine_test10 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "number"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job10 ON routine_test10
        COLUMNS TERMINATED BY ",",
        COLUMNS(id, name, age, num=age*10)
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad10",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> SELECT * FROM routine_test10;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.01 sec)
囲み文字を使用してデータを取り込む
-
取り込むサンプルデータ:
1,"Benjamin",18
2,"Emily",20
3,"Alexander",22 -
テーブル定義:
CREATE TABLE demo.routine_test11 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "number"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job11 ON routine_test11
        COLUMNS TERMINATED BY ","
        PROPERTIES
        (
            "desired_concurrent_number"="1",
            "enclose" = "\""
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad12",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> SELECT * FROM routine_test11;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.02 sec)
JSON 形式で取り込む
シンプルモードで JSON データを取り込む
-
取り込むサンプルデータ:
{ "id" : 1, "name" : "Benjamin", "age":18 }
{ "id" : 2, "name" : "Emily", "age":20 }
{ "id" : 3, "name" : "Alexander", "age":22 } -
テーブル定義:
CREATE TABLE demo.routine_test12 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job12 ON routine_test12
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad12",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test12;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
+------+----------------+------+
3 rows in set (0.02 sec)
マッチモードで複雑な JSON データを取り込む
-
取り込むサンプルデータ:
{ "name" : "Benjamin", "id" : 1, "num":180 , "age":18 }
{ "name" : "Emily", "id" : 2, "num":200 , "age":20 }
{ "name" : "Alexander", "id" : 3, "num":220 , "age":22 } -
テーブル定義:
CREATE TABLE demo.routine_test13 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "num"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job13 ON routine_test13
        COLUMNS(name, id, num, age)
        PROPERTIES
        (
            "format" = "json",
            "jsonpaths" = "[\"$.name\",\"$.id\",\"$.num\",\"$.age\"]"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad13",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test13;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.01 sec)
JSON のルートノードを指定してデータを取り込む
-
取り込むサンプルデータ:
{"id": 1231, "source" :{ "id" : 1, "name" : "Benjamin", "age":18 }}
{"id": 1232, "source" :{ "id" : 2, "name" : "Emily", "age":20 }}
{"id": 1233, "source" :{ "id" : 3, "name" : "Alexander", "age":22 }} -
テーブル定義:
CREATE TABLE demo.routine_test14 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job14 ON routine_test14
        PROPERTIES
        (
            "format" = "json",
            "json_root" = "$.source"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad14",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test14;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
+------+----------------+------+
3 rows in set (0.01 sec)
データロード時に列のマッピングと派生列の計算を行う(JSON)
-
取り込むサンプルデータ:
{ "id" : 1, "name" : "Benjamin", "age":18 }
{ "id" : 2, "name" : "Emily", "age":20 }
{ "id" : 3, "name" : "Alexander", "age":22 } -
テーブル定義:
CREATE TABLE demo.routine_test15 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "num"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job15 ON routine_test15
        COLUMNS(id, name, age, num=age*10)
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad15",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test15;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.01 sec)
柔軟な列の部分更新
この例では、行ごとに異なる列を更新できる柔軟な列の部分更新を示します。変更レコードに含まれるフィールドが異なる場合があるため、CDC シナリオで特に役立ちます。
-
取り込むサンプルデータ(各 JSON レコードで異なる列を更新):
{"id": 1, "balance": 150.00, "last_active": "2024-01-15 10:30:00"}
{"id": 2, "city": "Shanghai", "age": 28}
{"id": 3, "name": "Alice", "balance": 500.00, "city": "Beijing"}
{"id": 1, "age": 30}
{"id": 4, "__DORIS_DELETE_SIGN__": 1} -
テーブルを作成します(Merge-on-Write と skip bitmap 列を有効にする必要があります)。
CREATE TABLE demo.routine_test_flexible (
    id           INT            NOT NULL  COMMENT "id",
    name         VARCHAR(30)              COMMENT "name",
    age          INT                      COMMENT "age",
    city         VARCHAR(50)              COMMENT "city",
    balance      DECIMAL(10,2)            COMMENT "balance",
    last_active  DATETIME                 COMMENT "last active time"
)
UNIQUE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "enable_unique_key_skip_bitmap_column" = "true"
); -
初期データを挿入します。
INSERT INTO demo.routine_test_flexible VALUES
(1, 'John', 25, 'Shenzhen', 100.00, '2024-01-01 08:00:00'),
(2, 'Jane', 30, 'Guangzhou', 200.00, '2024-01-02 09:00:00'),
(3, 'Bob', 35, 'Hangzhou', 300.00, '2024-01-03 10:00:00'),
(4, 'Tom', 40, 'Nanjing', 400.00, '2024-01-04 11:00:00'); -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job_flexible ON routine_test_flexible
        PROPERTIES
        (
            "format" = "json",
            "unique_key_update_mode" = "UPDATE_FLEXIBLE_COLUMNS"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoadFlexible",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> SELECT * FROM demo.routine_test_flexible ORDER BY id;
+------+-------+------+-----------+---------+---------------------+
| id   | name  | age  | city      | balance | last_active         |
+------+-------+------+-----------+---------+---------------------+
|    1 | John  |   30 | Shenzhen  |  150.00 | 2024-01-15 10:30:00 |
|    2 | Jane  |   28 | Shanghai  |  200.00 | 2024-01-02 09:00:00 |
|    3 | Alice |   35 | Beijing   |  500.00 | 2024-01-03 10:00:00 |
+------+-------+------+-----------+---------+---------------------+
3 rows in set (0.01 sec)注id=4の行は__DORIS_DELETE_SIGN__によって削除されます。各行で更新されるのは、対応する JSON レコードに含まれる列のみです。
複合型を取り込む
Array 型を取り込む
-
取り込むサンプルデータ:
{ "id" : 1, "name" : "Benjamin", "age":18, "array":[1,2,3,4,5]}
{ "id" : 2, "name" : "Emily", "age":20, "array":[6,7,8,9,10]}
{ "id" : 3, "name" : "Alexander", "age":22, "array":[11,12,13,14,15]} -
テーブル定義:
CREATE TABLE demo.routine_test16
(
    id      INT             NOT NULL  COMMENT "id",
    name    VARCHAR(30)     NOT NULL  COMMENT "name",
    age     INT                       COMMENT "age",
    array   ARRAY<int(11)>  NULL      COMMENT "test array column"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job16 ON routine_test16
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad16",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test16;
+------+----------------+------+----------------------+
| id   | name           | age  | array                |
+------+----------------+------+----------------------+
|    1 | Benjamin       |   18 | [1, 2, 3, 4, 5]      |
|    2 | Emily          |   20 | [6, 7, 8, 9, 10]     |
|    3 | Alexander      |   22 | [11, 12, 13, 14, 15] |
+------+----------------+------+----------------------+
3 rows in set (0.00 sec)
Map 型を取り込む
-
取り込むサンプルデータ:
{ "id" : 1, "name" : "Benjamin", "age":18, "map":{"a": 100, "b": 200}}
{ "id" : 2, "name" : "Emily", "age":20, "map":{"c": 300, "d": 400}}
{ "id" : 3, "name" : "Alexander", "age":22, "map":{"e": 500, "f": 600}} -
テーブル定義:
CREATE TABLE demo.routine_test17 (
    id      INT                 NOT NULL  COMMENT "id",
    name    VARCHAR(30)         NOT NULL  COMMENT "name",
    age     INT                           COMMENT "age",
    map     Map<STRING, INT>    NULL      COMMENT "test column"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job17 ON routine_test17
    PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad17",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test17;
+------+----------------+------+--------------------+
| id   | name           | age  | map                |
+------+----------------+------+--------------------+
|    1 | Benjamin       |   18 | {"a":100, "b":200} |
|    2 | Emily          |   20 | {"c":300, "d":400} |
|    3 | Alexander      |   22 | {"e":500, "f":600} |
+------+----------------+------+--------------------+
3 rows in set (0.01 sec)
Bitmap 型を取り込む
-
取り込むサンプルデータ:
{ "id" : 1, "name" : "Benjamin", "age":18, "bitmap_id":243}
{ "id" : 2, "name" : "Emily", "age":20, "bitmap_id":28574}
{ "id" : 3, "name" : "Alexander", "age":22, "bitmap_id":8573} -
テーブル定義:
CREATE TABLE demo.routine_test18 (
    id        INT            NOT NULL      COMMENT "id",
    name      VARCHAR(30)    NOT NULL      COMMENT "name",
    age       INT                          COMMENT "age",
    bitmap_id INT                          COMMENT "test",
    device_id BITMAP         BITMAP_UNION  COMMENT "test column"
)
AGGREGATE KEY (`id`,`name`,`age`,`bitmap_id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job18 ON routine_test18
        COLUMNS(id, name, age, bitmap_id, device_id=to_bitmap(bitmap_id))
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad18",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select id, BITMAP_UNION_COUNT(pv) over(order by id) uv from(
    ->    select id, BITMAP_UNION(device_id) as pv
    ->    from routine_test18
    -> group by id
    -> ) final;
+------+------+
| id   | uv   |
+------+------+
|    1 |    1 |
|    2 |    2 |
|    3 |    3 |
+------+------+
3 rows in set (0.00 sec)
HLL 型を取り込む
-
取り込むサンプルデータ:
2022-05-05,10001,Test01,Beijing,windows
2022-05-05,10002,Test01,Beijing,linux
2022-05-05,10003,Test01,Beijing,macos
2022-05-05,10004,Test01,Hebei,windows
2022-05-06,10001,Test01,Shanghai,windows
2022-05-06,10002,Test01,Shanghai,linux
2022-05-06,10003,Test01,Jiangsu,macos
2022-05-06,10004,Test01,Shaanxi,windows -
テーブル定義:
create table demo.routine_test19 (
    dt        DATE,
    id        INT,
    name      VARCHAR(10),
    province  VARCHAR(10),
    os        VARCHAR(10),
    pv        hll hll_union
)
Aggregate KEY (dt,id,name,province,os)
distributed by hash(id) buckets 10; -
データロードコマンド:
CREATE ROUTINE LOAD demo.kafka_job19 ON routine_test19
        COLUMNS TERMINATED BY ",",
        COLUMNS(dt, id, name, province, os, pv=hll_hash(id))
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad19",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
データロード結果:
mysql> select * from routine_test19;
+------------+-------+----------+----------+---------+------+
| dt         | id    | name     | province | os      | pv   |
+------------+-------+----------+----------+---------+------+
| 2022-05-05 | 10001 | Test01   | Beijing     | windows | NULL |
| 2022-05-06 | 10001 | Test01   | Shanghai    | windows | NULL |
| 2022-05-05 | 10002 | Test01   | Beijing     | linux   | NULL |
| 2022-05-06 | 10002 | Test01   | Shanghai    | linux   | NULL |
| 2022-05-05 | 10004 | Test01   | Heibei      | windows | NULL |
| 2022-05-06 | 10004 | Test01   | Shanxi      | windows | NULL |
| 2022-05-05 | 10003 | Test01   | Beijing     | macos   | NULL |
| 2022-05-06 | 10003 | Test01   | Jiangsu     | macos   | NULL |
+------------+-------+----------+----------+---------+------+
8 rows in set (0.01 sec)

mysql> SELECT HLL_UNION_AGG(pv) FROM routine_test19;
+-------------------+
| hll_union_agg(pv) |
+-------------------+
|                 4 |
+-------------------+
1 row in set (0.01 sec)
Kafka のセキュリティ認証
Doris は、以下の Kafka セキュリティプロトコルによるアクセスをサポートします。データロードの例とパラメータの説明を示します。
SSL 認証を使用して Kafka データを取り込む
データロードコマンドの例:
CREATE ROUTINE LOAD demo.kafka_job20 ON routine_test20
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "192.168.100.129:9092",
            "kafka_topic" = "routineLoad21",
            "property.security.protocol" = "ssl",
            "property.ssl.ca.location" = "FILE:ca.pem",
            "property.ssl.certificate.location" = "FILE:client.pem",
            "property.ssl.key.location" = "FILE:client.key",
            "property.ssl.key.password" = "ssl_passwd"
        );
パラメータの説明:
| パラメータ | 説明 |
|---|---|
| property.security.protocol | 使用するセキュリティプロトコル。上記の例では SSL を使用します。 |
| property.ssl.ca.location | CA(認証局)証明書の場所。 |
| property.ssl.certificate.location | Kafka サーバーでクライアント認証が有効な場合にのみ必要です。クライアントの公開鍵の場所。 |
| property.ssl.key.location | Kafka サーバーでクライアント認証が有効な場合にのみ必要です。クライアントの秘密鍵の場所。 |
| property.ssl.key.password | Kafka サーバーでクライアント認証が有効な場合にのみ必要です。クライアントの秘密鍵のパスワード。 |
Kerberos 認証を使用して Kafka データを取り込む
データロードコマンドの例:
CREATE ROUTINE LOAD demo.kafka_job21 ON routine_test21
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "192.168.100.129:9092",
            "kafka_topic" = "routineLoad21",
            "property.security.protocol" = "SASL_PLAINTEXT",
            "property.sasl.kerberos.service.name" = "kafka",
            "property.sasl.kerberos.keytab"="/opt/third/kafka/kerberos/kafka_client.keytab",
            "property.sasl.kerberos.principal" = "clients/stream.dt.local@EXAMPLE.COM"
        );
パラメータの説明:
| パラメータ | 説明 |
|---|---|
| property.security.protocol | 使用するセキュリティプロトコル。上記の例では SASL_PLAINTEXT を使用します。 |
| property.sasl.kerberos.service.name | broker のサービス名を指定します。デフォルトは Kafka です。 |
| property.sasl.kerberos.keytab | keytab ファイルの場所。 |
| property.sasl.kerberos.principal | Kerberos principal を指定します。 |
krb5.conf で rdnbs=true を設定することを推奨します。設定しない場合、Server kafka/15.5.4.68@EXAMPLE.COM not found in Kerberos database というエラーが発生する可能性があります。
PLAIN 認証を使用して Kafka クラスターから取り込む
データロードコマンドの例:
CREATE ROUTINE LOAD demo.kafka_job22 ON routine_test22
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "192.168.100.129:9092",
            "kafka_topic" = "routineLoad22",
            "property.security.protocol"="SASL_PLAINTEXT",
            "property.sasl.mechanism"="PLAIN",
            "property.sasl.username"="admin",
            "property.sasl.password"="admin"
        );
パラメータの説明:
| パラメータ | 説明 |
|---|---|
| property.security.protocol | 使用するセキュリティプロトコル。上記の例では SASL_PLAINTEXT を使用します。 |
| property.sasl.mechanism | SASL 認証方式として PLAIN を指定します。 |
| property.sasl.username | SASL のユーザー名。 |
| property.sasl.password | SASL のパスワード。 |
暗号化認証を使用して Kafka サービスに接続する(StreamNative の例)
StreamNative メッセージングサービスにアクセスする場合の例です。
CREATE ROUTINE LOAD example_db.test1 ON example_tbl
COLUMNS(user_id, name, age)
FROM KAFKA (
    "kafka_broker_list" = "pc-xxxx.aws-mec1-test-xwiqv.aws.snio.cloud:9093",
    "kafka_topic" = "my_topic",
    "property.security.protocol" = "SASL_SSL",
    "property.sasl.mechanism" = "PLAIN",
    "property.sasl.username" = "user",
    "property.sasl.password" = "token:eyJhbxxx",
    "property.group.id" = "my_group_id_1",
    "property.client.id" = "my_client_id_1",
    "property.enable.ssl.certificate.verification" = "false"
);
- BE 側に信頼できる CA 証明書のパスが設定されていない場合、
"property.enable.ssl.certificate.verification" = "false"と指定してサーバー証明書の検証を省略します。 - それ以外の場合は、信頼できる CA 証明書のパス
"property.ssl.ca.location" = "/path/to/ca-cert.pem"を設定します。
単一ストリームから複数テーブルに取り込む
example_db に対して、test1 という名前の Kafka Routine Load 動的複数テーブルタスクを作成します。group.id と client.id を指定し、デフォルトですべてのパーティションを自動的に読み取り、データが存在する位置(OFFSET_BEGINNING)から購読します。
Kafka から example_db の tbl1 テーブルと tbl2 テーブルにデータを取り込む場合を考えます。test1 という Routine Load タスクを作成し、Kafka トピック my_topic のデータを両方のテーブルに取り込めます。
CREATE ROUTINE LOAD example_db.test1
FROM KAFKA
(
    "kafka_broker_list" = "broker1:9092,broker2:9092,broker3:9092",
    "kafka_topic" = "my_topic",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
この場合、Kafka のデータにテーブル名を含める必要があります。現在、動的テーブル名は Kafka Value から抽出する方法のみがサポートされており、データは所定の形式に従う必要があります。JSON の場合は table_name|{"col1": "val1", "col2": "val2"} で、tbl_name がテーブル名、| がテーブル名とテーブルデータの区切り文字です。CSV 形式のデータも同様で、たとえば table_name|val1,val2,val3 とします。
ここでの table_name は Doris のテーブル名と完全に一致する必要があります。一致しない場合、データロードは失敗します。動的テーブルは column_mapping をサポートしません。
Strict Mode で取り込む
example_db の example_tbl に対して、strict mode を有効にした test1 という名前の Kafka Routine Load タスクを作成します。
CREATE ROUTINE LOAD example_db.test1 ON example_tbl
COLUMNS(k1, k2, k3, v1, v2, v3 = k1 * 100),
PRECEDING FILTER k1 = 1,
WHERE k1 < 100 and k2 like "%doris%"
PROPERTIES
(
    "strict_mode" = "true"
)
FROM KAFKA
(
    "kafka_broker_list" = "broker1:9092,broker2:9092,broker3:9092",
    "kafka_topic" = "my_topic"
);
よくある質問(FAQ)
Routine Load ジョブが自動的に PAUSED 状態になった場合はどうすればよいですか?
通常は、データ品質の問題または Kafka 側の例外が原因です。
SHOW ROUTINE LOAD FOR <job_name>を実行し、ReasonOfStateChangedとErrorLogUrlsを確認します。- 不正データが原因の場合は、必要に応じて
max_filter_ratioとmax_error_numberを増やします。 - Kafka 側の例外が原因の場合は、broker とトピックに接続できることを確認してから、
RESUME ROUTINE LOADを実行して復旧します。
Offset out of range または out of range エラーにはどう対処しますか?
通常は、記録されているオフセットが Kafka の保持期間によってすでに削除されていることを意味します。
- ジョブを一時停止します:
PAUSE ROUTINE LOAD FOR <job_name>。 ALTER ROUTINE LOADを使用して、kafka_offsetsを有効な位置(OFFSET_BEGINNINGや具体的なオフセットなど)に設定し直します。RESUME ROUTINE LOADを実行してジョブを復旧します。
Server kafka/xxx@EXAMPLE.COM not found in Kerberos database と表示された場合は?
Kerberos 認証を使用する場合は、krb5.conf に rdnbs=true を設定します。
Server certificate verification failed などの SSL エラーが発生した場合は?
BE 側に信頼できる CA 証明書が設定されていない場合は、"property.enable.ssl.certificate.verification" = "false" を設定するか、"property.ssl.ca.location" = "/path/to/ca-cert.pem" を明示的に指定します。
希望する並列数(desired_concurrent_number)が反映されない場合は?
実際の並列数は、次の値の最小値で決まります。
min(topic_partition_num, desired_concurrent_number, max_routine_load_task_concurrent_num)
Kafka トピックのパーティション数と FE 設定の max_routine_load_task_concurrent_num を確認してください。
古い Kafka バージョン(< 0.10.0.0)を使用するには?
BE 設定で kafka_broker_version_fallback を設定するか、ジョブ作成時に property.broker.version.fallback で互換バージョンを指定します。
単一ストリームから複数テーブルへのデータロードで、取り込み先テーブルを指定するには?
Kafka メッセージの Value に table_name|<data> の形式でテーブル名を含める必要があります。テーブル名は Doris のテーブル名と厳密に一致させてください。動的テーブルは column_mapping をサポートしません。
データロードに失敗した不正データを確認するには?
SHOW ROUTINE LOAD FOR <job_name> を実行し、結果の ErrorLogUrls フィールドを確認します。ブラウザーまたは wget でその URL にアクセスすると、除外されたエラーデータのサンプルとエラーの原因を取得できます。
Routine Load ジョブを変更する前に一時停止する必要がありますか?
はい。ALTER ROUTINE LOAD コマンドを実行するには、ジョブが PAUSED 状態である必要があります。変更手順は PAUSE ROUTINE LOAD → ALTER ROUTINE LOAD → RESUME ROUTINE LOAD です。
その他のヘルプ
- SQL マニュアルのリファレンス: CREATE ROUTINE LOAD
- クライアントのコマンドラインで
HELP ROUTINE LOADを実行すると、詳細なヘルプを確認できます。