データインポート時の変換
Doris はインポート時にデータを変換する機能を備えています。これにより、データ処理パイプラインの一部を簡素化し、追加の ETL ツールへの依存を減らせます。組み込みの変換機能を使うことで、インポート効率を高め、データ処理ロジックの一貫性を保てます。
データ変換機能の概要
Doris はインポート時に、次の四種類のデータ変換をサポートします。
| 変換方法 | 目的 | 実行タイミング |
|---|---|---|
| 列マッピング | ソースデータの列を対象テーブルの列に対応付ける | データの解析後 |
| 列変換 | 関数や式を使ってソースデータを変換する | 列マッピング後 |
| 事前フィルタリング | 列マッピングと列変換の前に不要な生データを除外する | データの解析後、列マッピング前 |
| 事後フィルタリング | 列マッピングと列変換後の最終結果を絞り込む | 列変換後 |
各インポート方法でサポートされる変換機能は次のとおりです。
| インポート方法 | 列マッピング | 列変換 | 事前フィルタリング | 事後フィルタリング |
|---|---|---|---|---|
| Stream Load | サポート | サポート | 非サポート | サポート |
| Broker Load | サポート | サポート | サポート | サポート |
| Routine Load | サポート | サポート | サポート | サポート |
| Insert Into | SELECT で実現 | SELECT で実現 | WHERE で実現 | WHERE で実現 |
インポート構文
インポート方法によって、データ変換ロジックを指定するパラメータや句は異なります。以下にそれぞれの対応を示します。
Stream Load
HTTP ヘッダーに次のパラメータを設定して、データ変換を指定します。
| パラメータ | 説明 |
|---|---|
columns | 列マッピングと列変換を指定する |
where | 事後フィルタリングを指定する |
注: Stream Load は事前フィルタリングをサポートしていません。
例:
curl --location-trusted -u user:passwd \
    -H "columns: k1, k2, tmp_k3, k3 = tmp_k3 + 1" \
    -H "where: k1 > 1" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
Broker Load
SQL 文の次の句を使用して、データ変換を指定します。
| 句 | 説明 |
|---|---|
column list | (k1, k2, tmp_k3) の形式で列マッピングを指定する |
SET | 列変換を指定する |
PRECEDING FILTER | 事前フィルタリングを指定する |
WHERE | 事後フィルタリングを指定する |
例:
LOAD LABEL test_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE `test_tbl`
    (k1, k2, tmp_k3)
    PRECEDING FILTER k1 = 1
    SET (
        k3 = tmp_k3 + 1
    )
    WHERE k1 > 1
)
WITH S3 (...);
Routine Load
SQL 文の次の句を使用して、データ変換を指定します。
| 句 | 説明 |
|---|---|
COLUMNS | 列マッピングと列変換を指定する |
PRECEDING FILTER | 事前フィルタリングを指定する |
WHERE | 事後フィルタリングを指定する |
例:
CREATE ROUTINE LOAD test_db.label1 ON test_tbl
    COLUMNS(k1, k2, tmp_k3, k3 = tmp_k3 + 1),
    PRECEDING FILTER k1 = 1,
    WHERE k1 > 1
    ...
Insert Into
Insert Into では、SELECT 文でデータを直接変換し、WHERE 句でデータを絞り込めます。
列マッピング
列マッピングでは、ソースデータの列と対象テーブルの列の対応関係を定義します。次のような場合に使用できます。
- ソースデータと対象テーブルで列の順序が異なる場合
- ソースデータと対象テーブルで列数が異なる場合
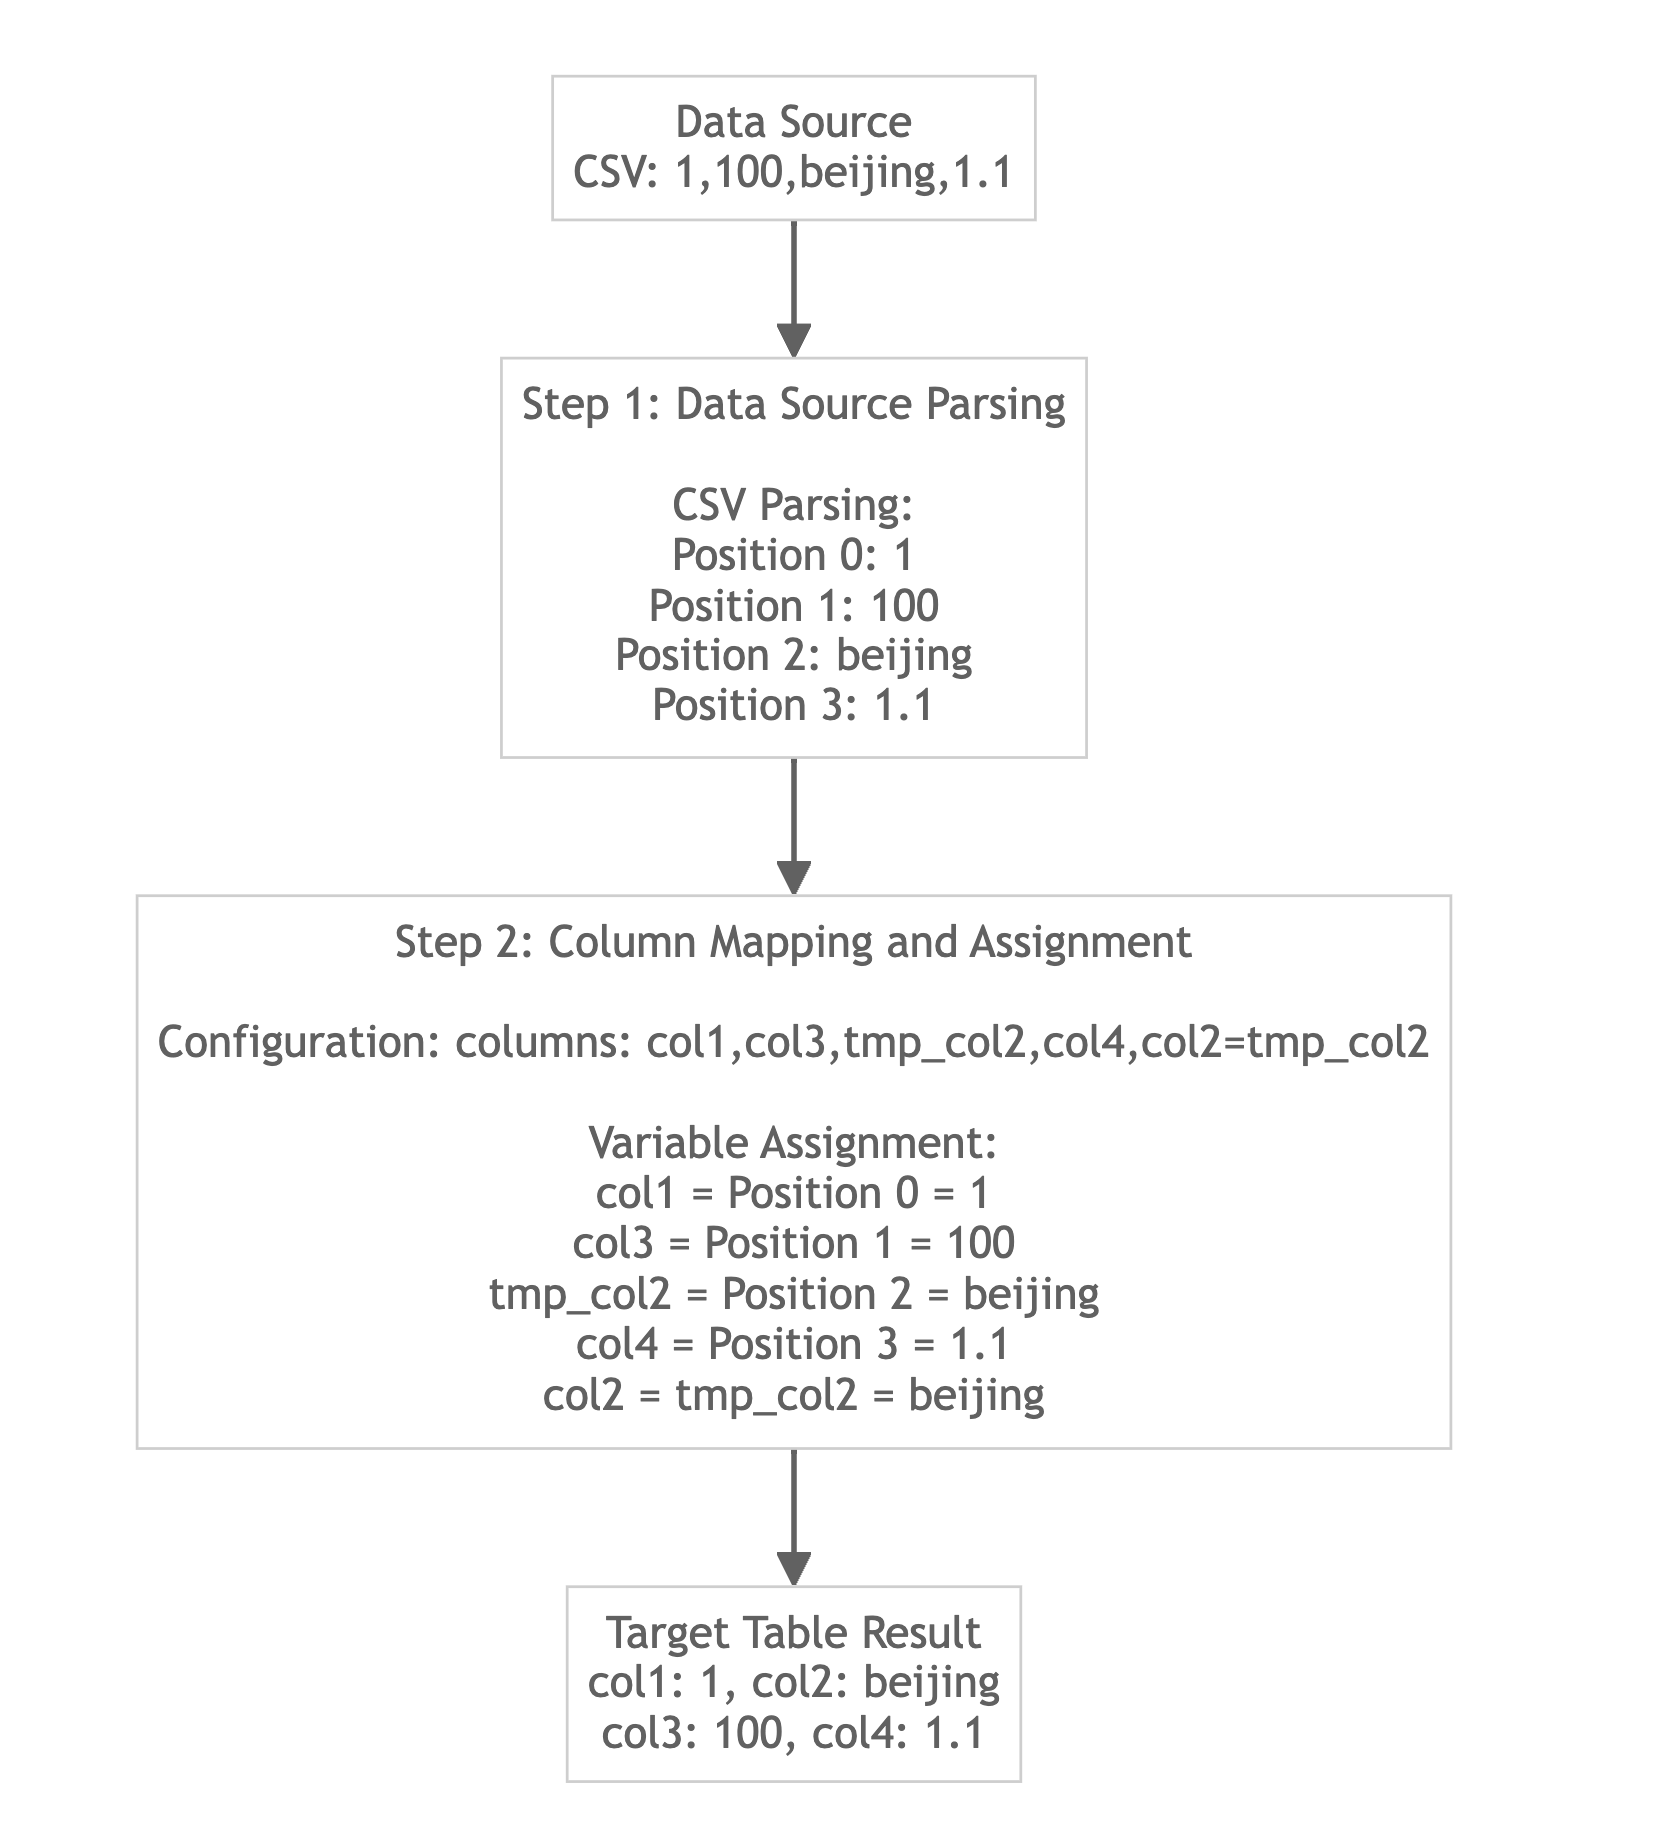
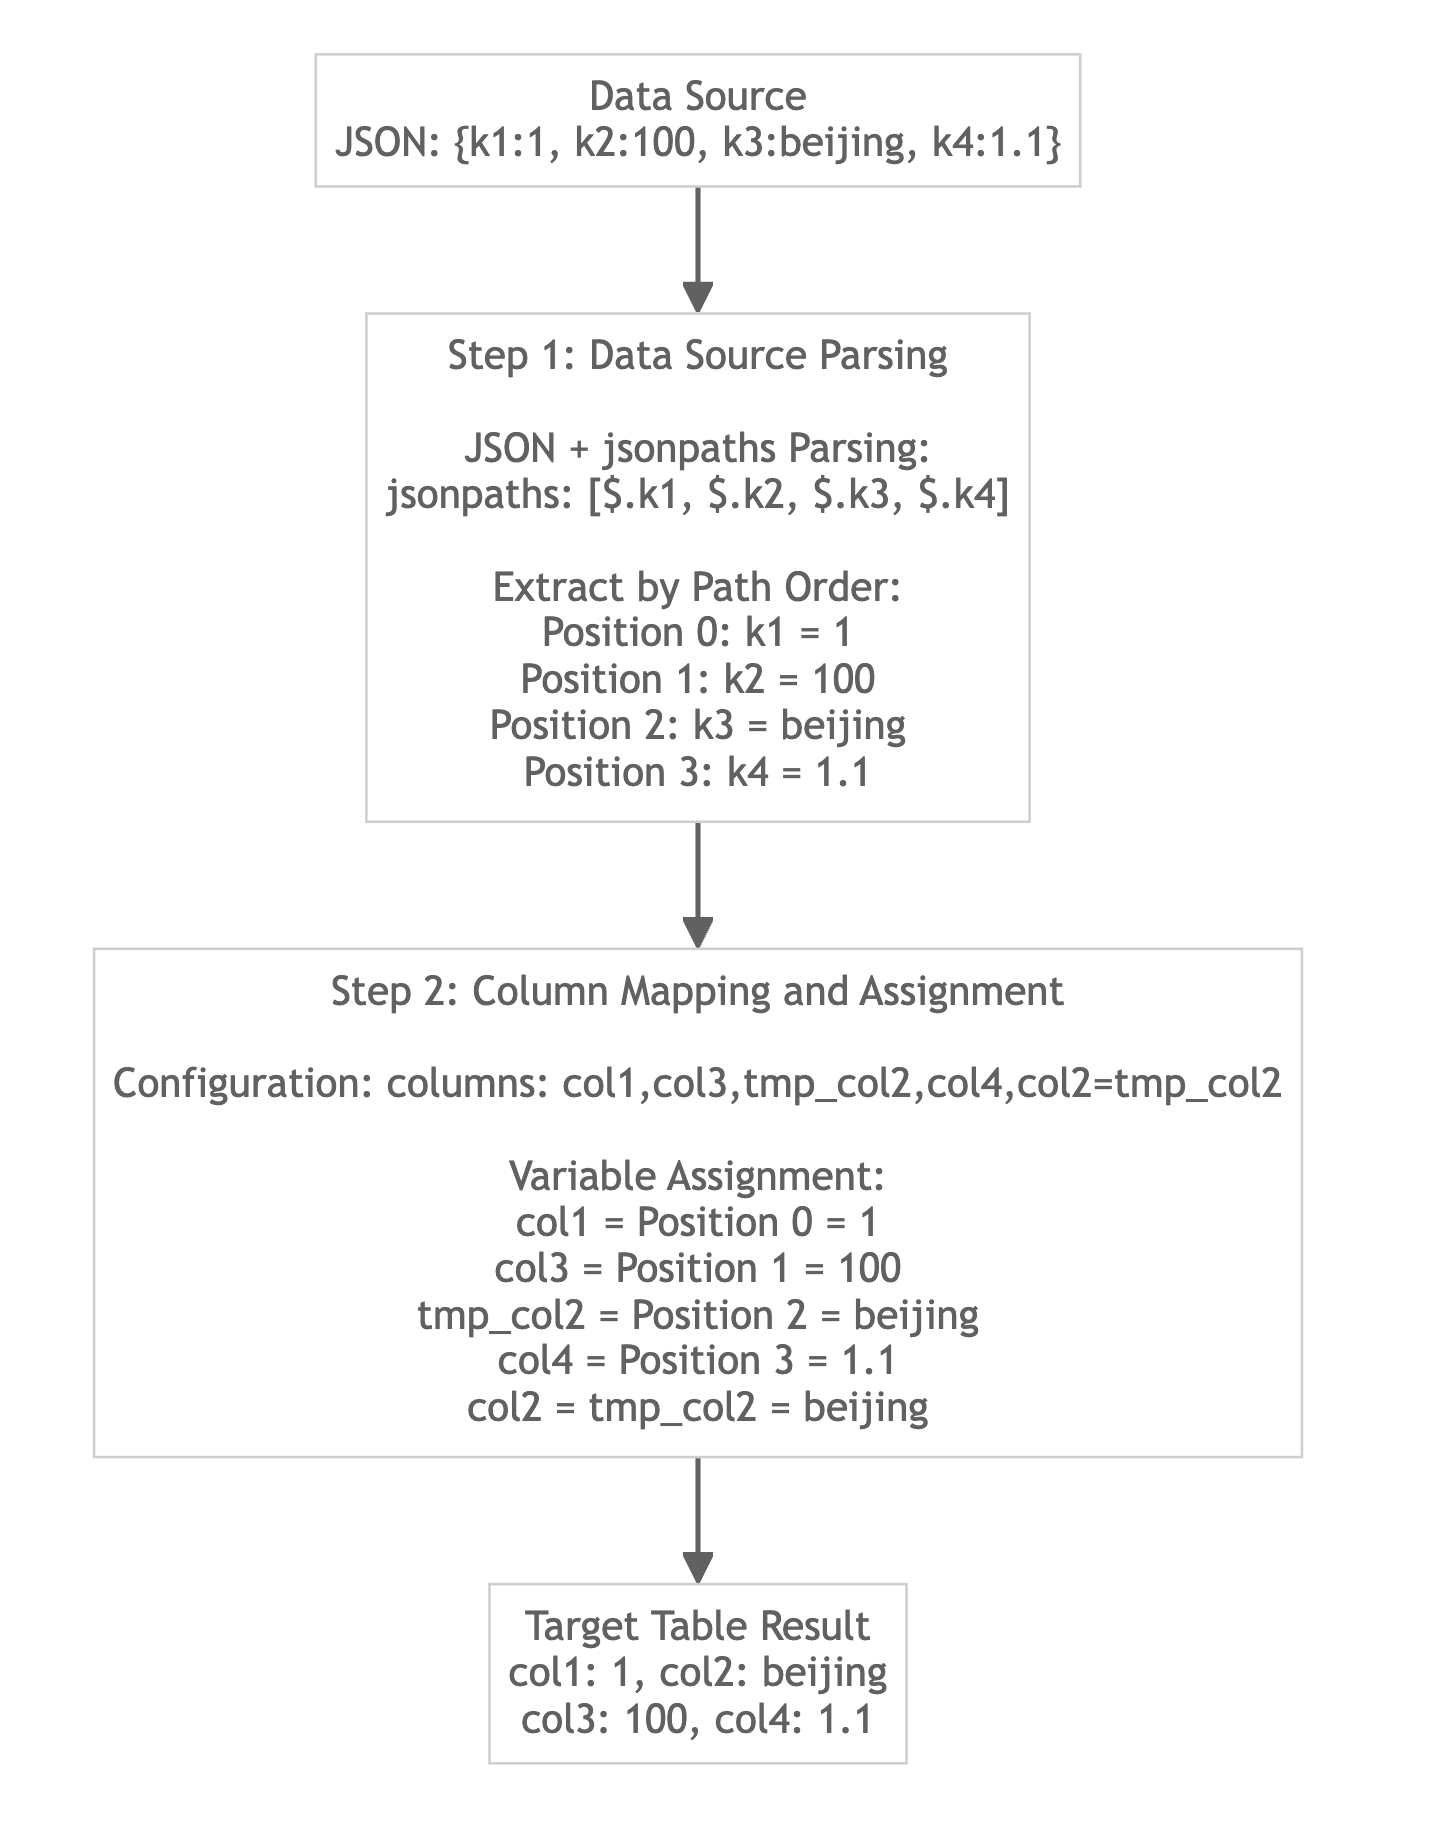
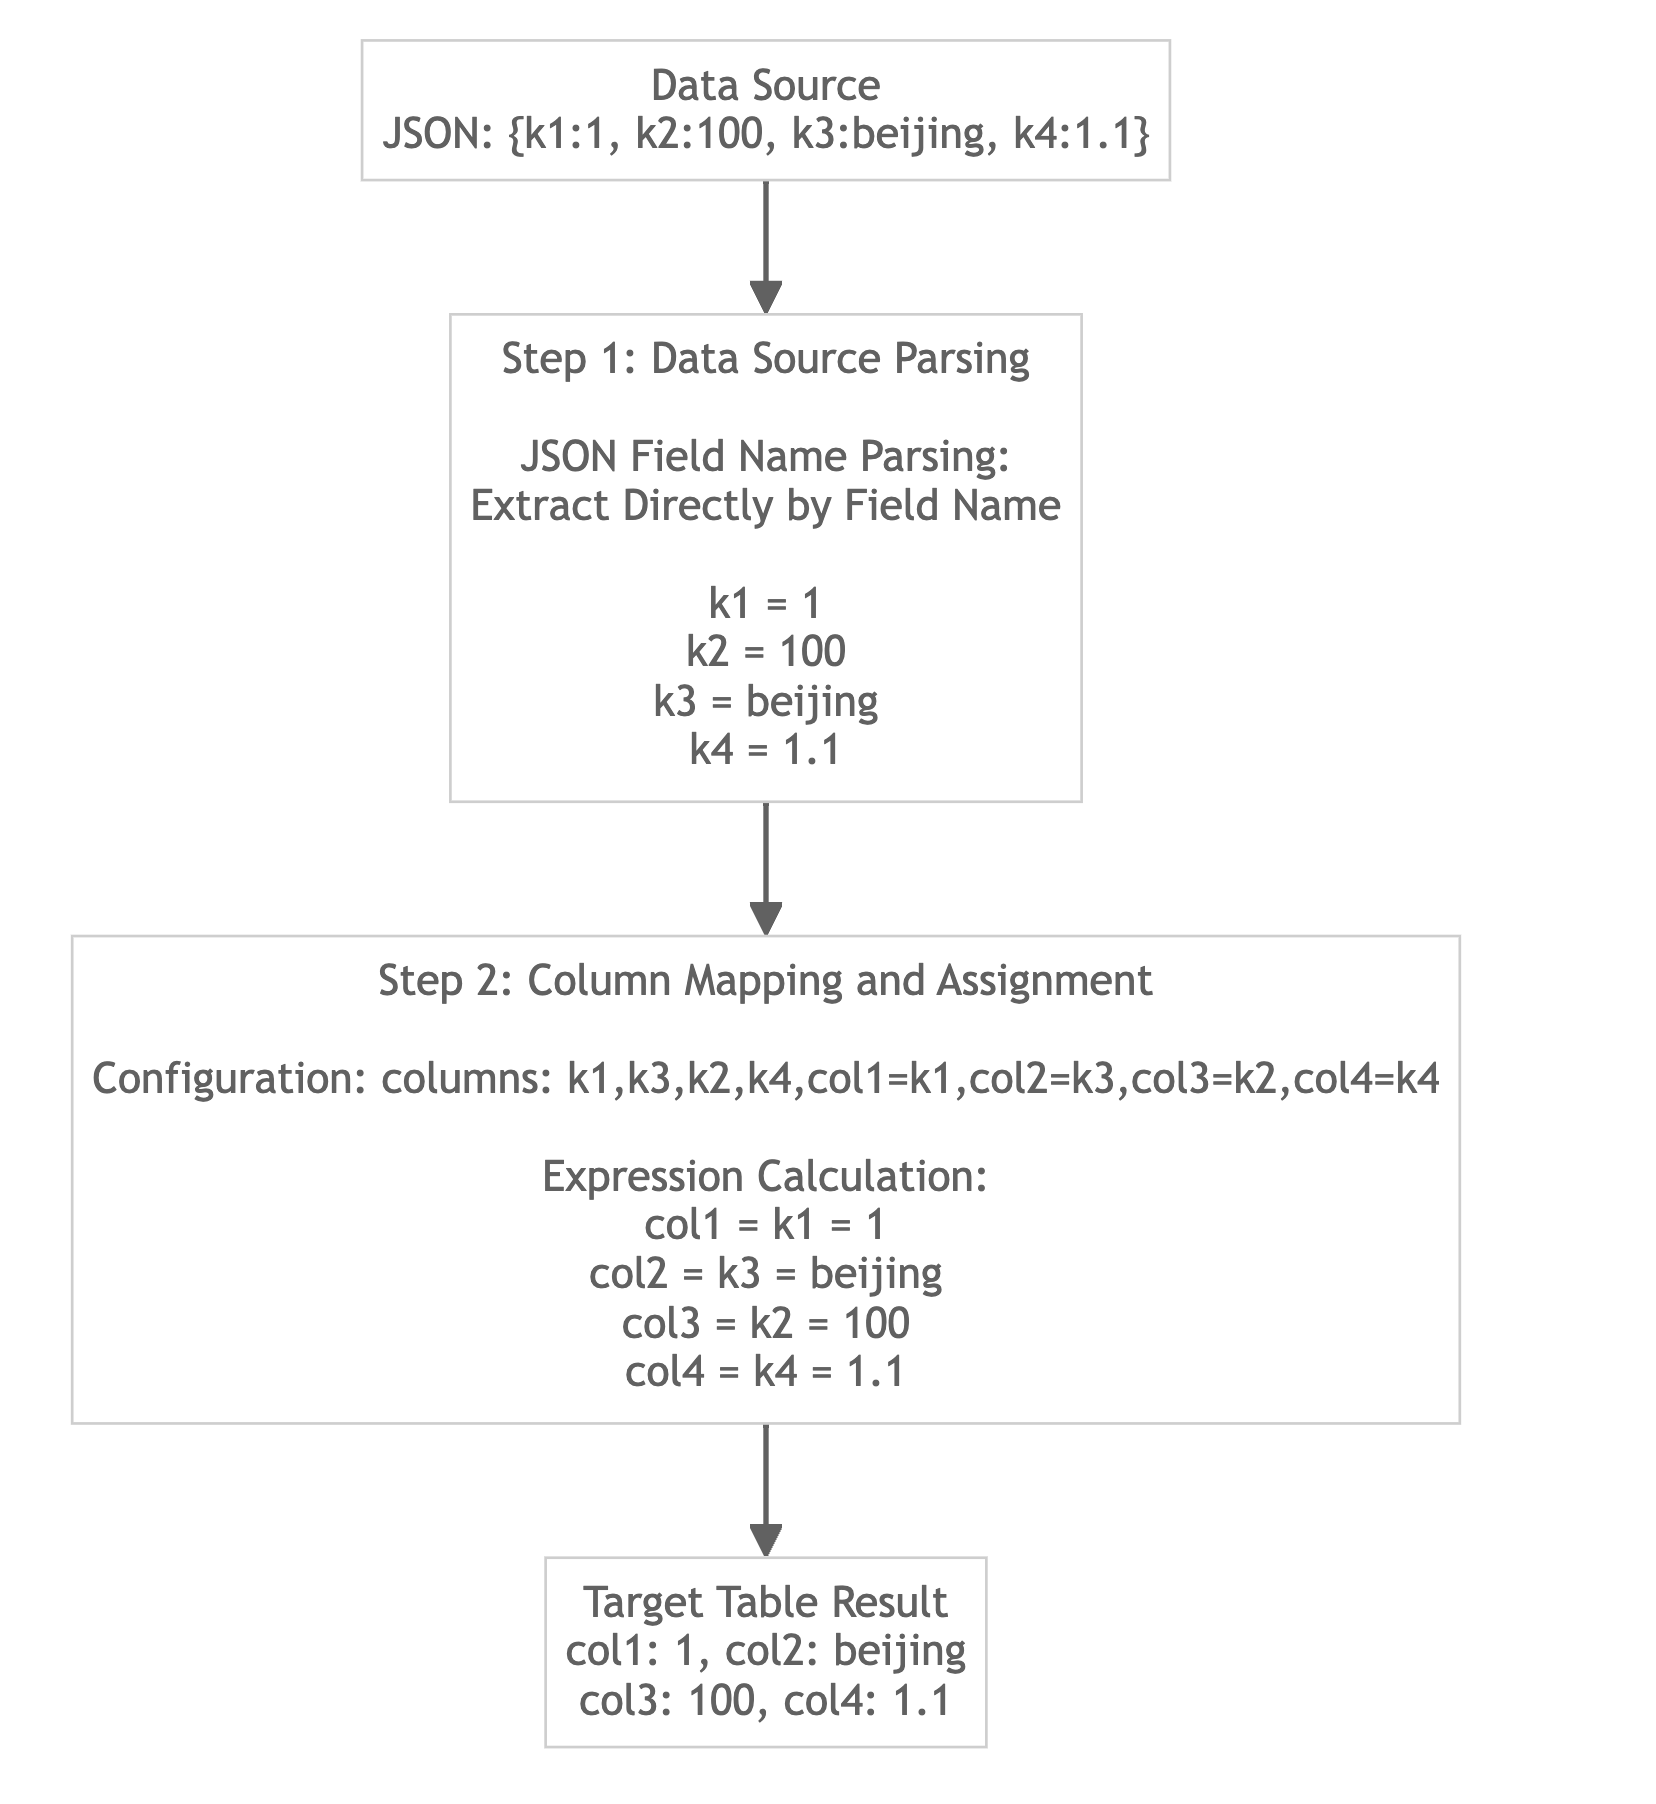
動作の仕組み
列マッピングは、主に次の二段階で処理されます。
- ソースデータの解析:データ形式に応じて、生データを中間変数に解析します。
- 列マッピングによる割り当て:列名に基づいて中間変数を対象テーブルのフィールドに対応付けます。
以下に、三種類のデータ形式の処理フローを示します。
CSV 形式のデータをインポートする場合
jsonpaths を指定して JSON 形式のデータをインポートする場合
jsonpaths を指定せずに JSON 形式のデータをインポートする場合
シナリオ 1:jsonpaths を指定して JSON データをインポートする
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
{"k1":1,"k2":"100","k3":"beijing","k4":1.1}
{"k1":2,"k2":"200","k3":"shanghai","k4":1.2}
{"k1":3,"k2":"300","k3":"guangzhou","k4":1.3}
{"k1":4,"k2":"\\N","k3":"chongqing","k4":1.4}
対象テーブルを作成する
CREATE TABLE example_table
(
    col1 INT,
    col2 STRING,
    col3 INT,
    col4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(col1)
DISTRIBUTED BY HASH(col1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "columns:col1, col3, col2, col4" \
    -H "jsonpaths:[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]" \
    -H "format:json" \
    -H "read_json_by_line:true" \
    -T data.json \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.json")
    INTO TABLE example_table
    FORMAT AS "json"
    (col1, col3, col2, col4)
    PROPERTIES
    (
        "jsonpaths" = "[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]"
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(col1, col3, col2, col4)
PROPERTIES
(
    "format" = "json",
    "jsonpaths" = "[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]",
    "read_json_by_line" = "true"
)
FROM KAFKA (...);
クエリ結果
mysql> SELECT * FROM example_table;
+------+-----------+------+------+
| col1 | col2      | col3 | col4 |
+------+-----------+------+------+
|    1 | beijing   |  100 |  1.1 |
|    2 | shanghai  |  200 |  1.2 |
|    3 | guangzhou |  300 |  1.3 |
|    4 | chongqing | NULL |  1.4 |
+------+-----------+------+------+
シナリオ 2:jsonpaths を指定せずに JSON データをインポートする
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
{"k1":1,"k2":"100","k3":"beijing","k4":1.1}
{"k1":2,"k2":"200","k3":"shanghai","k4":1.2}
{"k1":3,"k2":"300","k3":"guangzhou","k4":1.3}
{"k1":4,"k2":"\\N","k3":"chongqing","k4":1.4}
対象テーブルを作成する
CREATE TABLE example_table
(
    col1 INT,
    col2 STRING,
    col3 INT,
    col4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(col1)
DISTRIBUTED BY HASH(col1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "columns:k1, k3, k2, k4,col1 = k1, col2 = k3, col3 = k2, col4 = k4" \
    -H "format:json" \
    -H "read_json_by_line:true" \
    -T data.json \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.json")
    INTO TABLE example_table
    FORMAT AS "json"
    (k1, k3, k2, k4)
    SET (
        col1 = k1,
        col2 = k3,
        col3 = k2,
        col4 = k4
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4, col1 = k1, col2 = k3, col3 = k2, col4 = k4),
PROPERTIES
(
    "format" = "json",
    "read_json_by_line" = "true"
)
FROM KAFKA (...);
クエリ結果
mysql> SELECT * FROM example_table;
+------+-----------+------+------+
| col1 | col2      | col3 | col4 |
+------+-----------+------+------+
|    1 | beijing   |  100 |  1.1 |
|    2 | shanghai  |  200 |  1.2 |
|    3 | guangzhou |  300 |  1.3 |
|    4 | chongqing | NULL |  1.4 |
+------+-----------+------+------+
シナリオ 3:列の順序を調整する
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
対象テーブルには k1、k2、k3、k4 の四列があります。列の対応関係は次のとおりです。
column 1 -> k1
column 2 -> k3
column 3 -> k2
column 4 -> k4
対象テーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1,k3,k2,k4" \
    -T data.csv \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k3, k2, k4)
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
クエリ結果
mysql> select * from example_table;
+------+-----------+------+------+
| k1   | k2        | k3   | k4   |
+------+-----------+------+------+
|    2 | shanghai  |  200 |  1.2 |
|    4 | chongqing | NULL |  1.4 |
|    3 | guangzhou |  300 |  1.3 |
|    1 | beijing   |  100 |  1.1 |
+------+-----------+------+------+
シナリオ 4:ソースファイルの列数がテーブルより多い場合
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
対象テーブルには k1、k2、k3 の三列があり、ソースファイルには四列あります。ソースファイルの 1 列目、2 列目、4 列目のみを使用し、次のように対応付けます。
column 1 -> k1
column 2 -> k2
column 4 -> k3
ソースファイルの列を読み飛ばすには、列マッピングで対象テーブルに存在しない列名を指定します。この列名は任意に設定でき、対応する列のデータはインポート時に自動的に無視されます。
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:password \
    -H "column_separator:," \
    -H "columns: k1,k2,tmp_skip,k3" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (tmp_k1, tmp_k2, tmp_skip, tmp_k3)
    SET (
        k1 = tmp_k1,
        k2 = tmp_k2,
        k3 = tmp_k3
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_skip, k3),
PROPERTIES
(
    "format" = "csv",
    "column_separator" = ","
)
FROM KAFKA (...);
注:例の
tmp_skipは、対象テーブルの列定義に含まれていない名前であれば、任意の名前に置き換えられます。
クエリ結果
mysql> select * from example_table;
+------+------+------+
| k1   | k2   | k3   |
+------+------+------+
|    1 | 100  |  1.1 |
|    2 | 200  |  1.2 |
|    3 | 300  |  1.3 |
|    4 | NULL |  1.4 |
+------+------+------+
シナリオ 5:ソースファイルの列数がテーブルより少ない場合
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
対象テーブルには k1、k2、k3、k4、k5 の五列があり、ソースファイルには四列あります。ソースファイルの 1 列目、2 列目、3 列目、4 列目を使用し、次のように対応付けます。
column 1 -> k1
column 2 -> k3
column 3 -> k2
column 4 -> k4
k5 uses the default value
ソースデータに対応する列がない場合、対象テーブルの列は次の規則で処理されます。
- 列にデフォルト値がある場合は、その値を使用します。
- 列が NULL を許容し、デフォルト値がない場合は、NULL を使用します。
- 列が NULL を許容せず、デフォルト値もない場合は、インポートに失敗します。
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE,
    k5 INT DEFAULT 2
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1,k3,k2,k4" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (tmp_k1, tmp_k3, tmp_k2, tmp_k4)
    SET (
        k1 = tmp_k1,
        k3 = tmp_k3,
        k2 = tmp_k2,
        k4 = tmp_k4
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
クエリ結果
mysql> select * from example_table;
+------+-----------+------+------+------+
| k1   | k2        | k3   | k4   | k5   |
+------+-----------+------+------+------+
|    1 | beijing   |  100 |  1.1 |    2 |
|    2 | shanghai  |  200 |  1.2 |    2 |
|    3 | guangzhou |  300 |  1.3 |    2 |
|    4 | chongqing | NULL |  1.4 |    2 |
+------+-----------+------+------+------+
列変換
列変換では、ソースファイルの列値を変換できます。ほとんどの組み込み関数を使用できます。通常、列変換は列マッピングと組み合わせて定義し、列を対応付けてから変換します。
シナリオ 1:ソース列の値を算術演算で変換する
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
テーブルには k1、k2、k3、k4 の四列があります。インポート時の列マッピングと変換は次のとおりです。
column 1       -> k1
column 2 * 100 -> k3
column 3       -> k2
column 4       -> k4
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, tmp_k3, k2, k4, k3 = tmp_k3 * 100" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp_k3, k2, k4)
    SET (
        k3 = tmp_k3 * 100
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp_k3, k2, k4, k3 = tmp_k3 * 100),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
クエリ結果
mysql> select * from example_table;
+------+-----------+-------+------+
| k1   | k2        | k3    | k4   |
+------+-----------+-------+------+
|    1 | beijing   | 10000 |  1.1 |
|    2 | shanghai  | 20000 |  1.2 |
|    3 | guangzhou | 30000 |  1.3 |
|    4 | chongqing |  NULL |  1.4 |
+------+-----------+-------+------+
シナリオ 2:CASE WHEN 関数を使用して列を条件付きで変換する
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
テーブルには k1、k2、k3、k4 の四列があります。ソースデータの beijing、shanghai、guangzhou、chongqing を、それぞれに対応する地域 ID に変換してからインポートします。
column 1                                 -> k1
column 2                                 -> k2
column 3 (after region ID conversion)    -> k3
column 4                                 -> k4
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, tmp_k3, k4, k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, tmp_k3, k4)
    SET (
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_k3, k4, k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
クエリ結果
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    3 |  300 |    3 |  1.3 |
|    4 | NULL |    4 |  1.4 |
+------+------+------+------+
シナリオ 3:ソースファイルの NULL 値を処理する
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
テーブルには k1、k2、k3、k4 の四列があります。地域 ID を変換する際、ソースデータの k2 列の NULL 値をインポート時に 0 に変換します。
column 1                                  -> k1
column 2 (convert null to 0 if null)      -> k2
column 3                                  -> k3
column 4                                  -> k4
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, tmp_k2, tmp_k3, k4, k2 = ifnull(tmp_k2, 0), k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp_k2, tmp_k3, k4)
    SET (
        k2 = ifnull(tmp_k2, 0),
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp_k2, tmp_k3, k4, k2 = ifnull(tmp_k2, 0), k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
クエリ結果
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    3 |  300 |    3 |  1.3 |
|    4 |    0 |    4 |  1.4 |
+------+------+------+------+
事前フィルタリング
事前フィルタリングは、変換前の生データを絞り込みます。処理が不要なデータを先に除外することで、後続の処理量を減らし、インポート効率を高められます。この機能をサポートするのは Broker Load と Routine Load のみです。
ユースケース
- 変換前にデータを除外する:列マッピングと列変換の前に、不要なデータを除外できます。
- 対象テーブルにない列をフィルター用の目印として使う:たとえば、ソースデータに複数のテーブルの行が含まれている場合や、複数のテーブルの行が同じ Kafka メッセージキューに書き込まれている場合を考えます。各行に、その行が属するテーブル名を示す列があれば、事前フィルタリングの条件で対象テーブルに対応する行を選んでインポートできます。
制限事項
| 制限事項 | 説明 |
|---|---|
| フィルター対象の列 | 事前フィルタリングでは、列リスト内の独立した単純な列のみを条件に使用でき、式によって生成された列は使用できません。たとえば、列マッピングが (a, tmp, b = tmp + 1) の場合、列 b はフィルター条件に使用できません。 |
| データ処理 | 事前フィルタリングはデータ変換前に行われ、生データの値を比較します。生データは文字列型として扱われます。たとえば、\N は比較前に NULL に変換されず、文字列 \N のまま比較されます。 |
例 1:数値条件による事前フィルタリング
この例では、単純な数値比較条件でソースデータを絞り込みます。フィルター条件を k1 > 1 に設定すると、不要なレコードがデータ変換前に除外されます。
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
事前フィルタリングの条件は次のとおりです。
column 1 > 1, that is, only data with column 1 > 1 is imported, and the rest is filtered out.
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    PRECEDING FILTER k1 > 1
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
PRECEDING FILTER k1 > 1
FROM KAFKA (...)
クエリ結果
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    2 |  200 | shanghai  |  1.2 |
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
例 2:中間列を使って無効なデータを除外する
この例では、無効なデータを含むソースをインポートする場合の処理を示します。
ソースデータは次のとおりです。
1,1
2,abc
3,3
テーブル作成文
CREATE TABLE example_table
(
    k1 INT,
    k2 INT NOT NULL
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
INT 型の k2 列に対して abc は無効なデータです。これを除外するには、フィルタリング用の中間列を導入します。
インポート文
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp, k2 = tmp)
    PRECEDING FILTER tmp != "abc"
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp, k2 = tmp),
COLUMNS TERMINATED BY ","
PRECEDING FILTER tmp != "abc"
FROM KAFKA (...);
インポート結果
mysql> select * from example_table;
+------+----+
| k1   | k2 |
+------+----+
|    1 |  1 |
|    3 |  3 |
+------+----+
事後フィルタリング
事後フィルタリングはデータ変換後に行われ、変換結果を条件にデータを絞り込みます。
シナリオ 1:列マッピングや列変換を行わずに直接絞り込む
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
テーブルには k1、k2、k3、k4 の四列があります。列マッピングや変換を行わず、ソースファイルの 4 列目の値が 1.2 より大きい行だけをインポートします。
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, k3, k4" \
    -H "where: k4 > 1.2" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    where k4 > 1.2
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
WHERE k4 > 1.2;
FROM KAFKA (...)
クエリ結果
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
シナリオ 2:列変換後のデータを絞り込む
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
テーブルには k1、k2、k3、k4 の四列があります。列変換の例では省名を ID に変換します。ここでは、ID が 3 の行を除外します。
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, tmp_k3, k4, k3 = case tmp_k3 when 'beijing' then 1 when 'shanghai' then 2 when 'guangzhou' then 3 when 'chongqing' then 4 else null end" \
    -H "where: k3 != 3" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, tmp_k3, k4)
    SET (
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
    WHERE k3 != 3
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_k3, k4),
COLUMNS TERMINATED BY ","
SET (
    k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
)
WHERE k3 != 3;
FROM KAFKA (...)
クエリ結果
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    4 | NULL |    4 |  1.4 |
+------+------+------+------+
シナリオ 3:複数条件によるフィルタリング
次のソースデータを使用します(説明のために列名のヘッダーを示していますが、実際のデータにはヘッダーはありません)。
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
テーブルには k1、k2、k3、k4 の四列があります。k1 列が NULL の行と、k4 列が 1.2 未満の行を除外します。
サンプルテーブルを作成する
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
データをインポートする
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, k3, k4" \
    -H "where: k1 is not null and k4 > 1.2" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    where k1 is not null and k4 > 1.2
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
WHERE k1 is not null and k4 > 1.2
FROM KAFKA (...);
クエリ結果
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
よくある質問
1. Stream Load に PRECEDING FILTER がないのはなぜですか?
Stream Load は事前フィルタリングをサポートしていません。where パラメータによる事後フィルタリングのみを実行できます。事前フィルタリングが必要な場合は、Broker Load または Routine Load を使用してください。
2. 事前フィルタリングで \N が NULL として扱われないのはなぜですか?
事前フィルタリングはデータ変換前に行われ、生データの値を比較します。生データは文字列型として扱われます。\N は先に NULL に変換されず、文字列 \N のまま比較されます。NULL を条件に絞り込むには、事後フィルタリング(WHERE)を使用してください。
3. 列マッピングでソースファイルの列を読み飛ばすにはどうすればよいですか?
列マッピングのリストで、不要な列に対象テーブルに存在しない列名(tmp_skip など)を割り当てます。これらの一時的な列名はプレースホルダーであり、インポート時に自動的に無視されます。
4. ソースファイルに対応する列がない対象テーブルの列は、どのように処理されますか?
次の規則に従って値が設定されます。
- 列にデフォルト値がある場合は、その値を使用します。
- 列が NULL を許容し、デフォルト値がない場合は、NULL を使用します。
- 列が NULL を許容せず、デフォルト値もない場合は、インポートに失敗します。
5. 列変換にはどの関数を使用できますか?
列変換では、ifnull、CASE WHEN、文字列関数、日付関数、算術演算など、ほとんどの組み込み関数を使用できます。これらは columns または SET 句で使用できます。
6. 事前フィルタリングで式によって値が割り当てられた列を参照できないのはなぜですか?
事前フィルタリングでは独立した単純な列のみを条件に使用でき、式によって生成された列(b = tmp + 1 など)は使用できません。そのような列を条件に使う場合は、事後フィルタリング(WHERE)を使用してください。