製品の基本概念
このドキュメントでは、Apache Doris の製品に関する基本概念を紹介します。ほかのドキュメントを理解するための基礎となる内容です。データの編成、ストレージモデル、クエリ実行、クエリ最適化などの主要な側面を扱います。
対象となる場面: 概念の把握、ドキュメントを読むための準備、技術的な予習
データの編成
Catalog / Database / Table
Apache Doris は、データの管理に Catalog → Database → Table という三階層の構造を採用しています。
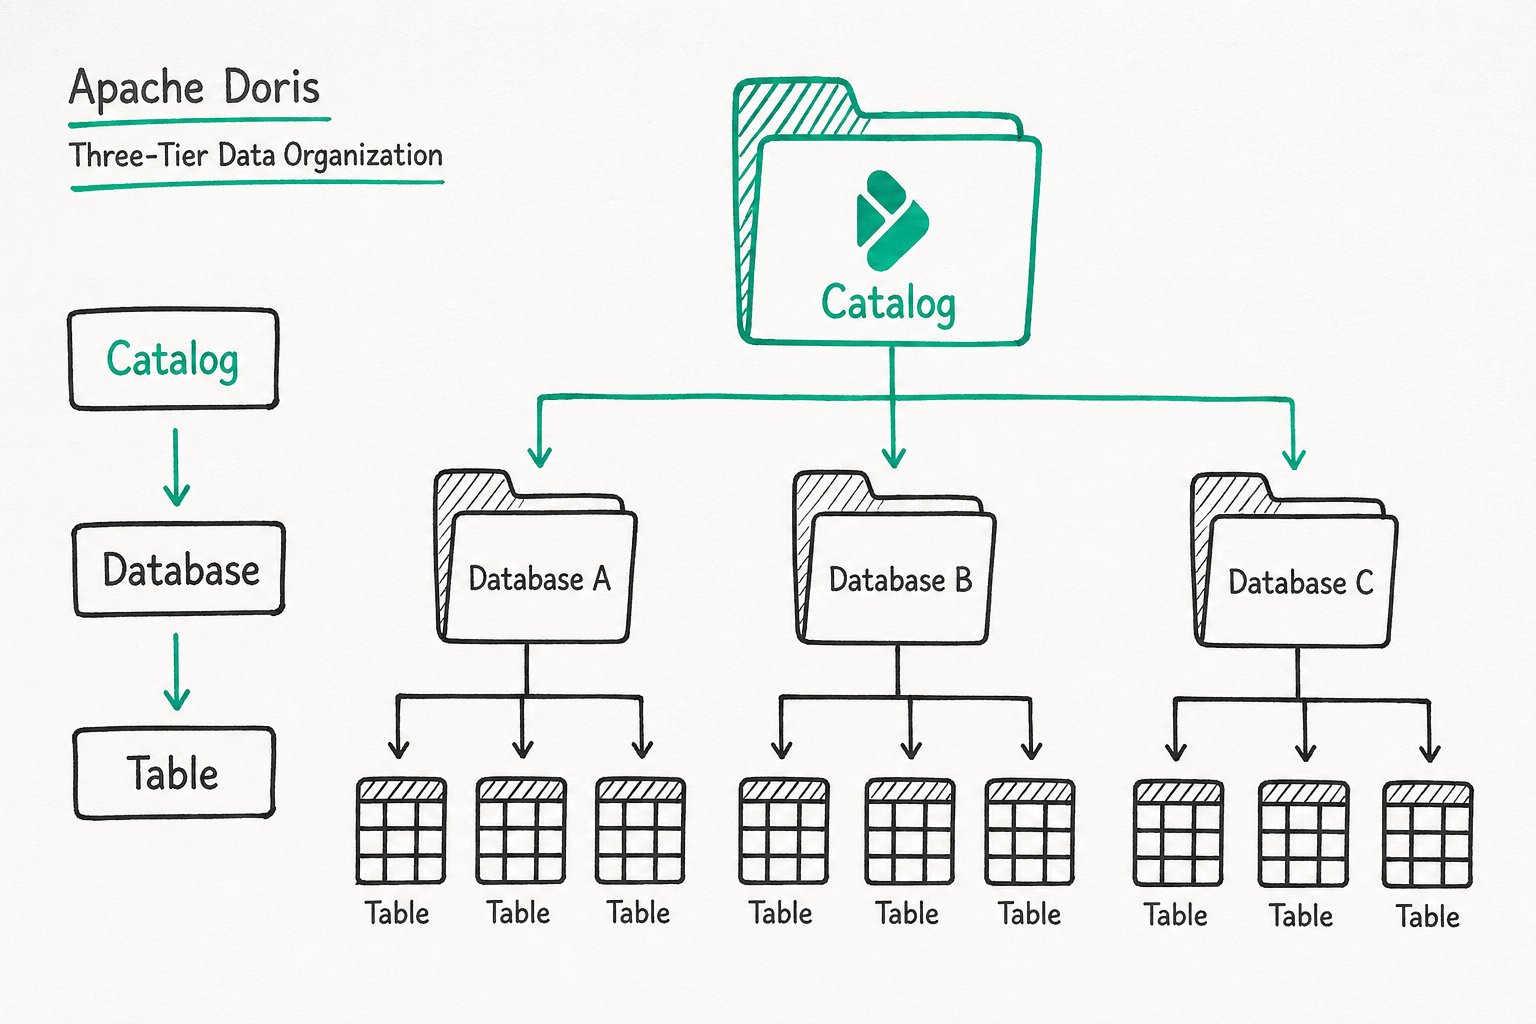
| 階層 | 説明 |
|---|---|
| Catalog | 異なるデータソースを区別するための論理的な名前空間です。Doris のデフォルトの internal Catalog は内部ストレージを表し、ユーザーが作成した Database と Table を保持します。外部 Catalog を使うと、Hive、Iceberg、MySQL などのデータソースに接続し、データを移行せずにソースをまたいだクエリを実行できます。 |
| Database | 異なる業務やプロジェクトのデータを分離するためのデータベース単位です。文字セットや照合順序などの属性を設定できます。 |
| Table | 列構造(スキーマ)とテーブルのプロパティ(バケット化ルール、ライフサイクルなど)を定義する二次元のリレーショナルテーブルです。データの保存とクエリの基本単位です。Doris でクエリ可能なオブジェクトは、すべて Table として表されます。 |
なぜ三階層なのか?
階層構造によって、論理的な分離と複数のソースへの統一的なアクセスを両立できます。業務チームは独立した Database を所有し、プラットフォームチームは外部 Catalog を通じてほかのデータソースを直接クエリできます。
内部 Catalog
内部 Catalog は、Doris に組み込まれたデフォルトの Catalog です。名前は internal に固定されており、Doris の内部形式で保存されたテーブルとデータを管理します。
主な役割:
- ユーザーが作成したすべての Database(
CREATE DATABASE)を保存する - ユーザーが作成したすべての Table(
CREATE TABLE)を保存する - 内部データのインポート、圧縮、バージョンのマージ(Compaction)を管理する
ユーザーが SHOW DATABASES や USE my_db を実行すると、デフォルトでは内部 Catalog のコンテキストで処理されます。
外部 Catalog
外部 Catalog は外部データソースに接続する論理コンポーネントで、データを移行せずに外部データを直接クエリできます。
| 外部データソース | 説明 |
|---|---|
| Hive | Hive Metastore または HMS 互換のデータレイクに接続します |
| Iceberg | Iceberg テーブルに接続します |
| Paimon | Paimon テーブルに接続します |
| JDBC | MySQL、PostgreSQL、OceanBase などのリレーショナルデータベースに接続します |
Iceberg と Paimon に関する特記事項:
これら二つのデータソースでは、クエリだけでなく、DDL 操作(CREATE/DROP/ALTER TABLE)や DML 操作(INSERT/UPDATE/DELETE)を含む包括的なデータ管理機能を利用できます。Doris から Iceberg/Paimon テーブルのスキーマを直接管理し、データを書き込めます。
ユースケース:
- データレイク分析:ETL を行わずに Hive/Iceberg/Paimon のデータを直接分析する
- ソースをまたいだクエリ:一つの SQL 文で Iceberg データソースと Doris のデータをクエリする
使い方: 外部 Catalog の作成後、SELECT * FROM catalog.database.table で直接クエリできます。SWITCH catalog で対応する Catalog に切り替えることもできます。
内部 Catalog と外部 Catalog の比較
| 比較項目 | 内部 Catalog | 外部 Catalog |
|---|---|---|
| 名前 | internal に固定 | ユーザーが定義 |
| データ形式 | Doris の内部形式(列指向ストレージ) | 外部データソースの形式(Parquet、ORC など) |
| データの保存場所 | BE ノードのローカルディスクまたはオブジェクトストレージ | 外部システム(HDFS、S3、Hive Metastore など) |
| 作成方法 | CREATE DATABASE / CREATE TABLE | CREATE EXTERNAL CATALOG |
| クエリ性能 | 高い(データがローカルにあるため) | 外部データソースに依存します。Doris には複数の組み込み高速化機能もあります |
| DDL/DML のサポート | 完全にサポート | Iceberg/Paimon は完全にサポート。Hive/JDBC はクエリのみサポート |
| データの書き込み | サポート(Stream Load など) | Iceberg/Paimon のみサポート |
パーティションとバケット
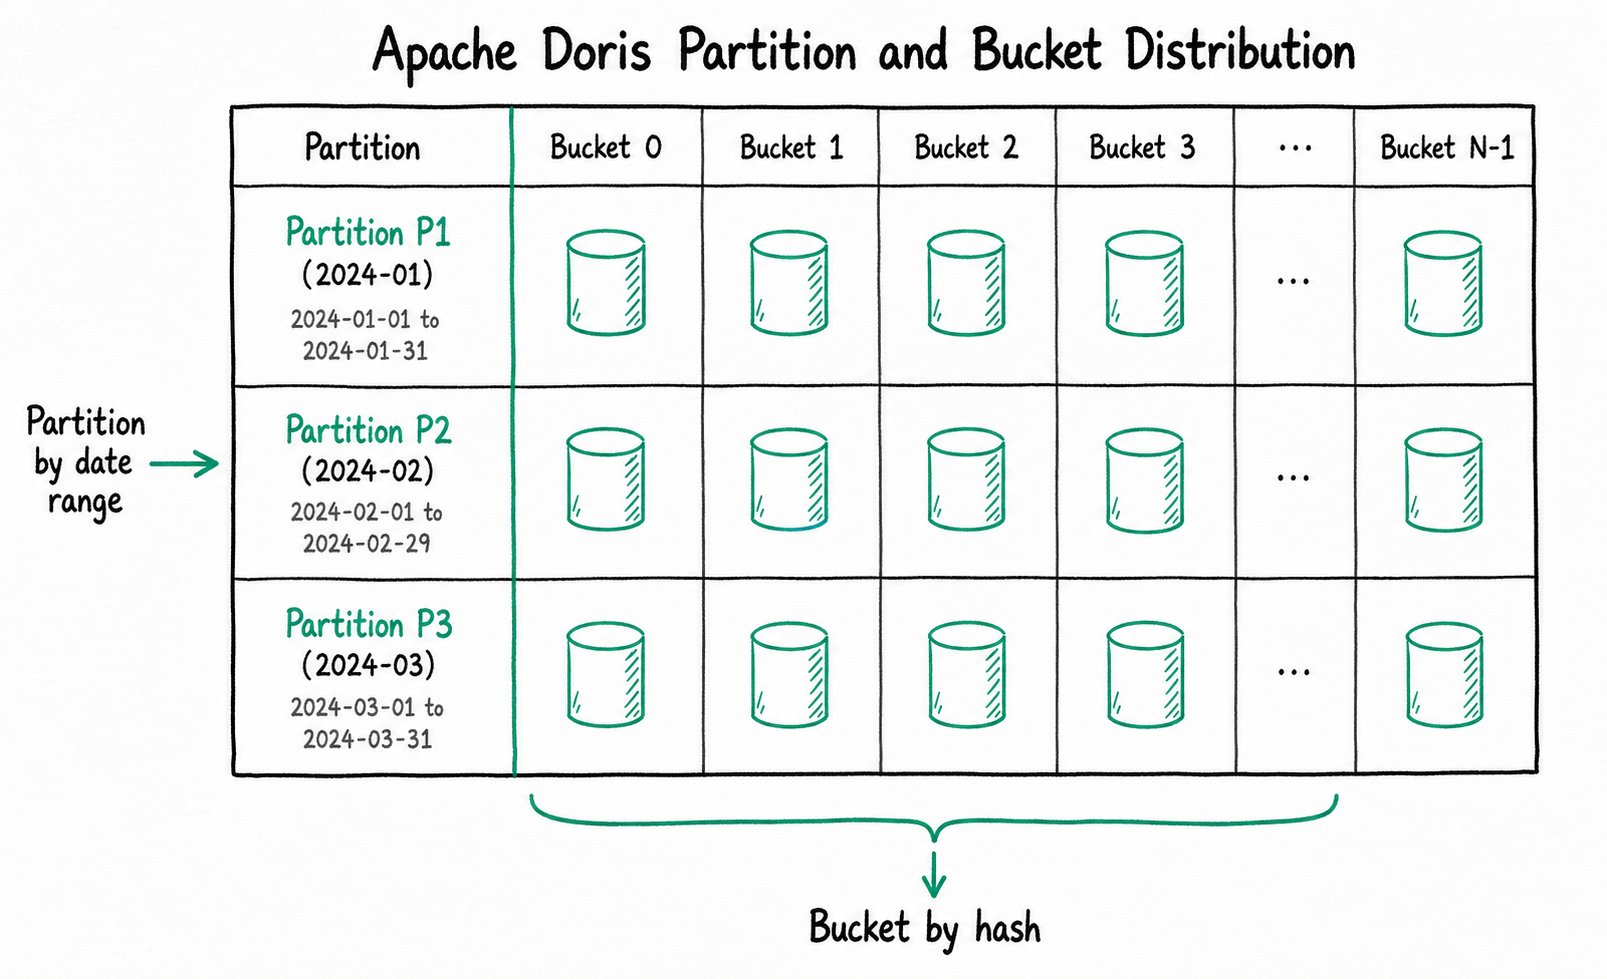
パーティションは、特定の列の値の範囲に基づいてテーブル内のデータを水平方向に分割します。テーブルには一つ以上のパーティションを設けることができ、各パーティションは連続したデータ範囲に対応します。
代表的な用途:
- 日単位、月単位、年単位の時間による分割。パーティションプルーニングと履歴データの管理に役立ちます
- 地域や事業分野による分割。データの分離に役立ちます
例: ログテーブルを date 列で日ごとにパーティション分割します。
Partition p20240101: data where date = '2024-01-01'
Partition p20240102: data where date = '2024-01-02'
Partition p20240103: data where date = '2024-01-03'
WHERE date = '2024-01-02' を実行すると、Doris は p20240102 パーティションだけをスキャンしてほかのパーティションを省くため、I/O を大幅に削減できます。
バケットは、特定の列のハッシュ値またはバケット数に基づいてテーブル内のデータを水平方向に分割し、クラスタ内でのデータの物理的な分散を決めます。
バケットに対応する物理ストレージは Tablet と呼ばれ、ストレージの最小論理単位です。
| 概念 | 説明 |
|---|---|
| Distribution Key | 行が属するバケットを計算するために使用する列です。主キーの ID など、カーディナリティの高い列を選びます。 |
| Bucket Num | パーティション内の物理バケット数です。データの並列度を決めます。 |
バケットとパーティションの違い:
| 観点 | パーティション | バケット |
|---|---|---|
| 分割の基準 | 列の値の範囲 | ハッシュ計算 |
| 目的 | データのライフサイクル管理、パーティションプルーニング | データの並列分散、JOIN の最適化 |
| 階層関係 | パーティションにはバケットが含まれる | バケットはパーティションに属する |
パーティションは時間範囲などのデータの論理的な境界を定義し、バケットはクラスタのノード間でデータをどう分散するかといったデータの物理的な分布を定義します。
ストレージモデル
列指向ストレージ
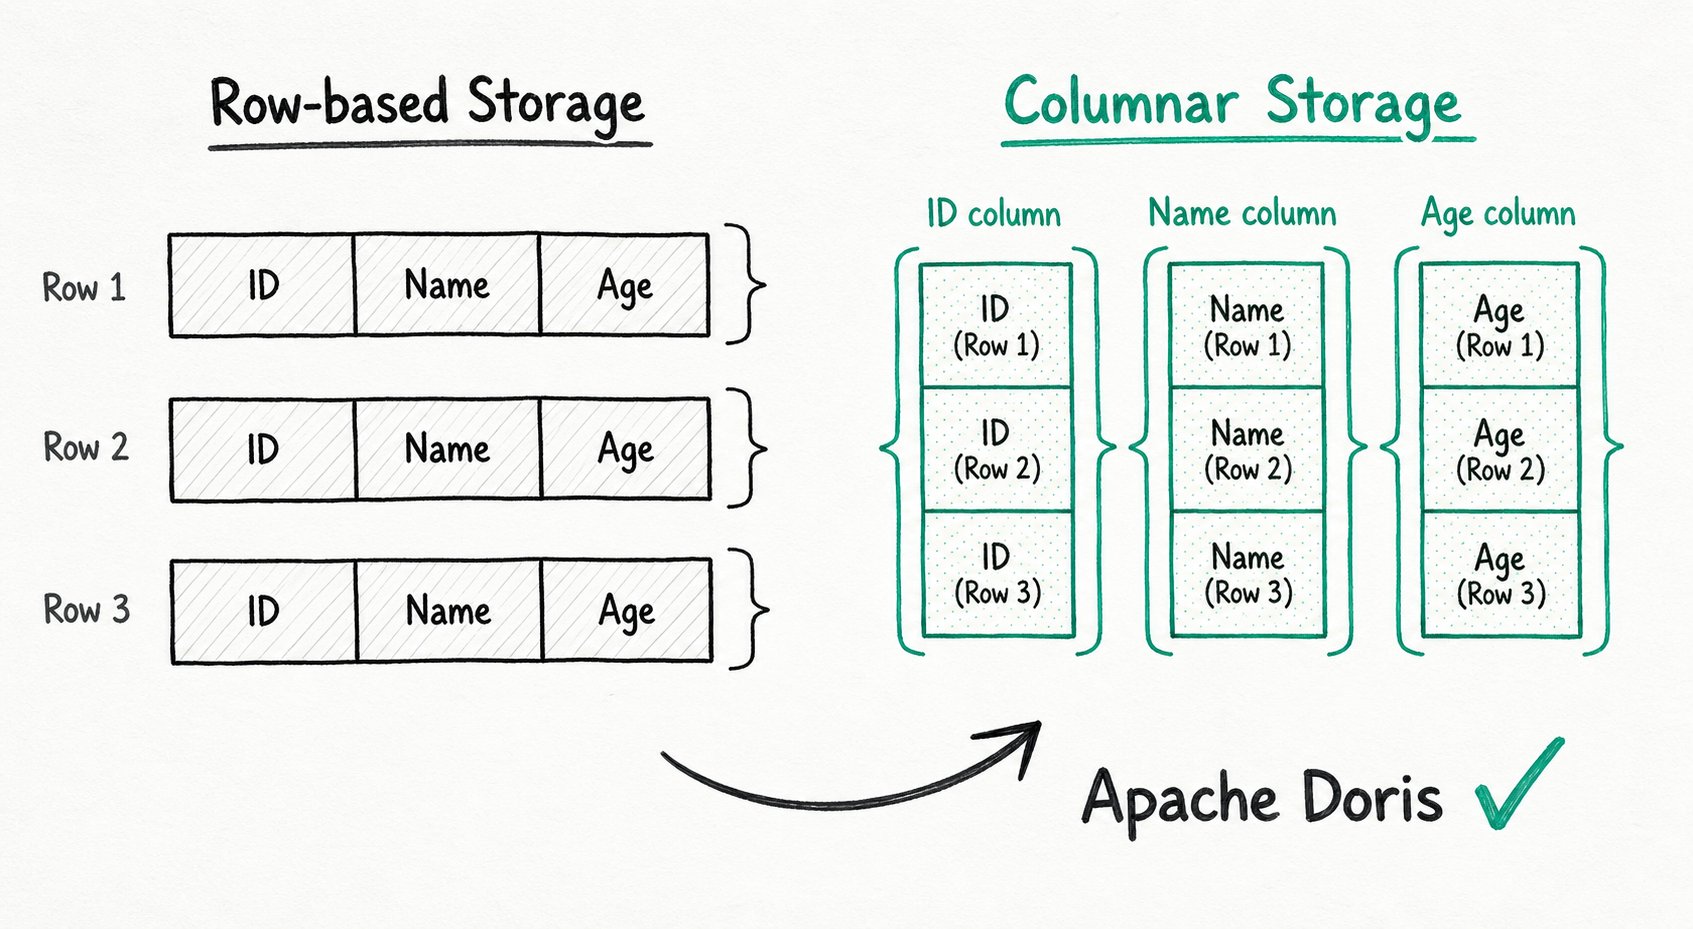
列指向ストレージは、データを行ではなく列ごとに編成する形式です。
行指向ストレージと列指向ストレージの比較:
Row-based storage (each row is stored contiguously):
[row1: id=1, name=alice, age=30] [row2: id=2, name=bob, age=25] ...

Columnar storage (each column is stored contiguously):
[id column: 1, 2, 3, ...] [name column: alice, bob, carol, ...] [age column: 30, 25, 28, ...]
列指向ストレージの利点:
| 利点 | 説明 |
|---|---|
| 高い I/O 効率 | クエリに必要な列だけを読み込むため、テーブル全体のスキャンを避けられます。少数の列だけを使うレポートクエリでは、I/O を数十倍削減できる場合があります。 |
| 高い圧縮率 | 同じ列のデータは型が共通しているため、辞書エンコーディング、ビットマップ圧縮、RLE などのアルゴリズムに適しています。これにより、ストレージ使用量を大幅に削減できます。 |
| ベクトル化に適している | 同じ列のデータがメモリ上に連続して格納されるため、CPU キャッシュのヒット率が高くなり、SIMD 命令による高速な計算が可能です。 |
データモデル
Doris は、ビジネスシナリオごとに異なるデータのマージ要件に対応する三つのデータモデルをサポートしています。
| モデル | 説明 | ユースケース |
|---|---|---|
| Duplicate | 元のデータをすべて保持します。同じキーを持つ複数のレコードも保持されます。 | ファクトテーブルの明細保存、ログ分析 |
| Aggregate | 同じキーを持つレコードを、集約関数(SUM、MAX、MIN など)に従ってマージします。 | 指標の集計、レポート向けの事前集約 |
| Primary Key | キーは一意で、同じキーを持つレコードは以前のレコードを上書きします(行単位の更新に対応)。 | リアルタイム更新、CDC データの取り込み |
例:
次の元データがあるとします(主キーは user_id です)。
| user_id | visit_date | pv |
|---|---|---|
| 1 | 2024-01-01 | 5 |
| 1 | 2024-01-01 | 3 |
| 2 | 2024-01-01 | 10 |
- Duplicate モデル:3 件のレコードがすべて保持されます。
- Aggregate モデル(SUM 集約を使用):同じキーの
pv値がマージされ、user_id=1 は pv=8、user_id=2 は pv=10 になります。 - Primary Key モデル:同じキーのレコードはタイムスタンプに従って上書きされ、最新のレコードだけが残ります(たとえば、
pv=3がpv=5を上書きします)。
クエリ実行
MPP(Massively Parallel Processing)
MPP は、複雑なクエリを実行するための超並列処理アーキテクチャです。
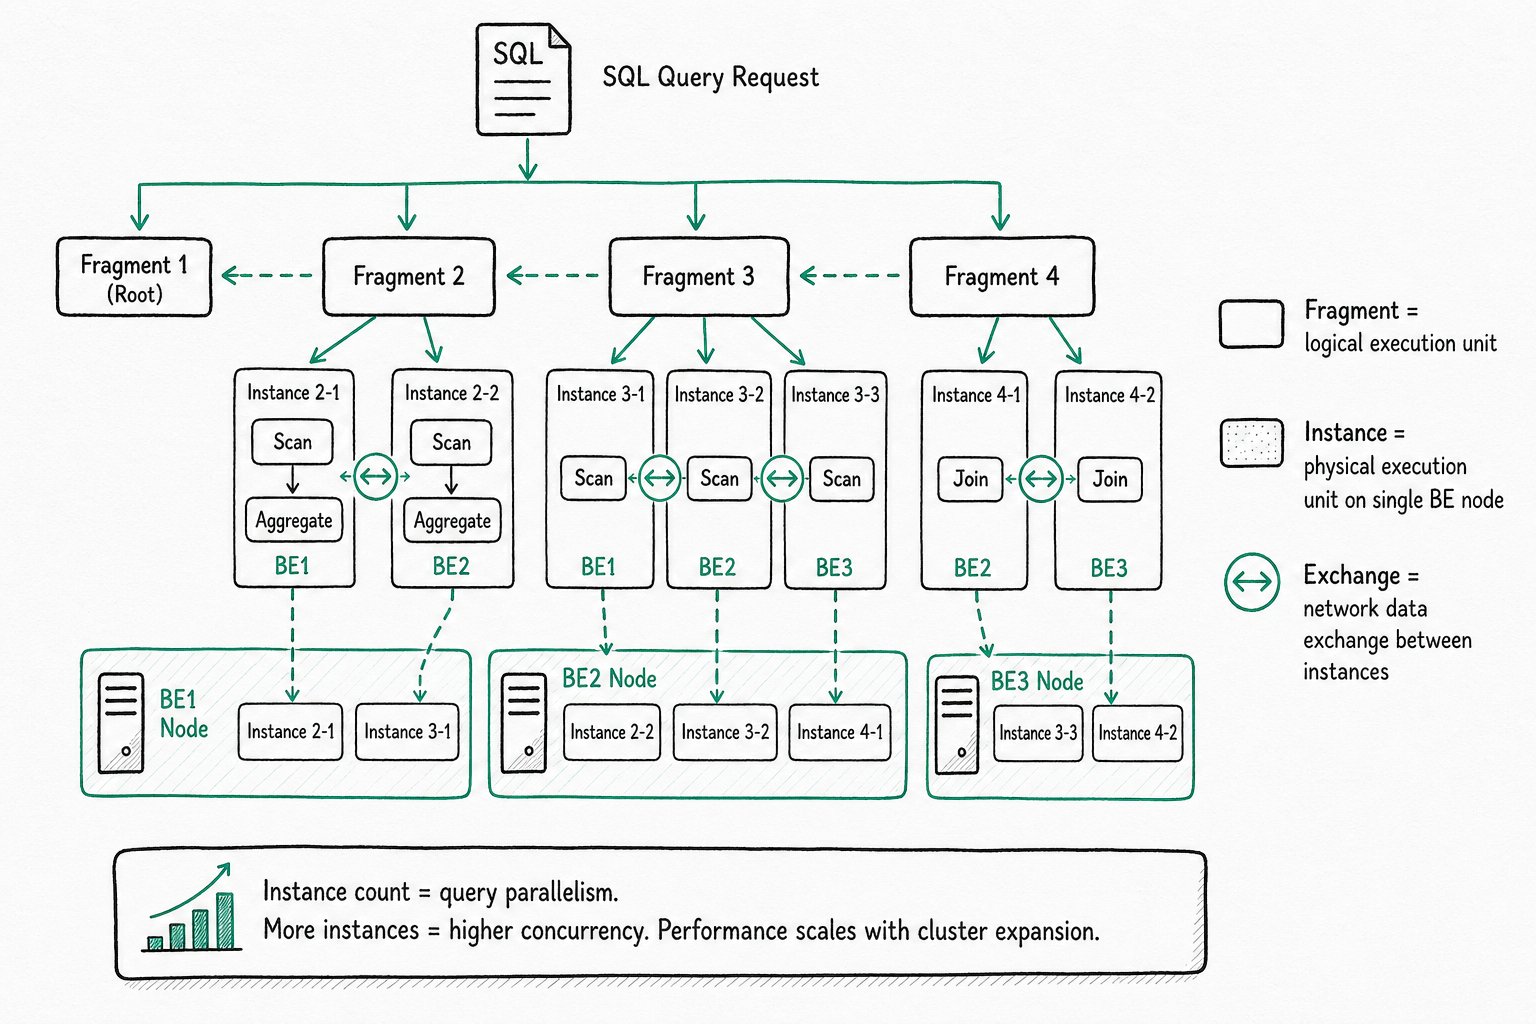
基本概念:
| 概念 | 説明 |
|---|---|
| Fragment | 論理的な実行単位です。クエリプランは複数の Fragment で構成されます。 |
| Instance | 単一の BE ノードで実行できる、Scan、Agg、Join などの演算子のグループからなる物理的な実行単位です。 |
| Exchange | Instance 間でネットワークを介してデータを交換する演算子です。 |
処理の流れ:
- FE が SQL を解析して論理実行プランを生成します。
- プランを複数の Fragment(論理的な実行単位)に分割します。
- 各 Fragment を一つ以上の Instance として具体化し、複数の BE ノードに割り当てて並列実行します。
- 異なる Instance は Exchange 演算子を介してネットワーク上でデータを交換します。
- 各ノードの実行が完了すると、FE で結果を集約します。
Instance と並列度:
Instance はクエリの物理的な実行単位で、単一の BE ノード上で動作し、Scan → Agg → Join などの演算子のグループを含みます。Instance の数はクエリの並列度に等しく、Instance が多いほど並列度が高くなります。各実行ノードには専用のリソース(CPU とメモリ)があり、単一のクエリリクエストで全実行ノードのリソースを最大限に活用できます。その結果、クラスタを水平に拡張するとクエリ性能も向上します。
ユースケース: 大規模テーブルの JOIN、GROUP BY、ORDER BY など、ノード間でデータ交換が必要な処理。
ベクトル化実行エンジン
ベクトル化実行は、データを列単位のバッチで処理し、SIMD 命令を使って計算を高速化する実行方式です。
従来の行単位の実行とベクトル化実行の比較:
| 観点 | 行単位の実行 | ベクトル化実行 |
|---|---|---|
| 処理単位 | 一度に一行 | 一度に一列(一バッチ) |
| CPU キャッシュ | ランダムアクセスで、ヒット率が低い | 連続アクセスで、ヒット率が高い |
| SIMD 命令 | 活用しにくい | 十分に活用できる |
| 集約性能 | 基準値 | 5-10 倍に向上 |
基本的な考え方: 演算子の内部ループを「一行ずつ処理する」方式から「一列(データのバッチ)ずつ処理する」方式に変え、関数呼び出しのオーバーヘッドを減らして CPU 使用効率を高めます。
Pipeline 実行エンジン
Pipeline は、パイプラインによる並列処理を通じてマルチコアのリソースを最大限に活用する、マルチコア並列実行モデルです。
解決する課題:
- スレッド数の急増:従来のモデルではクエリごとに固定数のスレッドを割り当てるため、クエリが急増するとスレッド数を制御できなくなります。
- リソースの競合:固定サイズのスレッドプールでは、クエリ間でリソースの競合が発生します。
Pipeline の特性:
| 特性 | 説明 |
|---|---|
| スレッド数の制限 | 並列度はクエリ数ではなく CPU コア数によって制限されます。 |
| 演算子チェーンのスケジューリング | 上流と下流の演算子がパイプラインを形成し、データが継続的に流れます。 |
| ブロッキングの削減 | スレッドの切り替えやロック競合を減らし、スループットを向上させます。 |
単一のクエリ内では、複数の演算子が並列パイプラインを形成します。クラスタ全体では、複数のクエリが CPU リソースを共有するため、効率的なマルチテナントスケジューリングが可能になります。
クエリ最適化
マテリアライズドビュー
マテリアライズドビューは、クエリ結果を物理テーブルとして保存し、データのロードに合わせて自動更新する事前計算技術です。
主な利点:
| 機能 | 説明 |
|---|---|
| クエリの書き換え | ユーザーが元のテーブルをクエリすると、オプティマイザはマテリアライズドビューを読み込むようにクエリを透過的に書き換えられるか自動判定します。ユーザーは SQL を変更する必要がありません。 |
| 自動同期 | ソーステーブルが変更されるとマテリアライズドビューも自動更新され、手動で保守する必要がありません。 |
| ETL の代替 | 従来の定期実行型 ETL パイプラインの代わりとなり、リアルタイムの高速化を実現できます。 |
ユースケース:
- 大規模テーブルでの集約クエリ(レポート用のロールアップなど)
- データウェアハウスでの階層的なモデリング(ファクトテーブル → サマリーテーブル)
- 複雑な JOIN 結果の事前計算
CBO(Cost-Based Optimizer)
CBO はコストベースのクエリオプティマイザです。候補となる各実行プランのリソース消費量(I/O、CPU、ネットワーク)を推定し、コストが最も低いプランを選択します。
CBO による代表的な最適化:
| 最適化 | 説明 |
|---|---|
| Join 順序 | 複数テーブルの JOIN について、異なる順序のコストを評価し、最適なものを選びます。 |
| Join アルゴリズム | データ量に応じて Hash Join、Nest Loop Join、Broadcast Join を選びます。 |
| 分散実行 | どのノードで実行するか、Shuffle が必要かどうかを判断します。 |
なぜ CBO が必要なのか? SQL は「何をするか」だけを記述し、「どう実行するか」は記述しません。同じクエリでも、データ量によって最適な実行経路は大きく変わります。CBO は統計情報(行数、列のカーディナリティ、NDV など)を使ってコストを推定し、最も効率的な実行経路を選びます。
RBO(Rule-Based Optimizer)
RBO はルールベースのオプティマイザです。実際のデータ特性を考慮せず、事前定義されたルールに従って論理プランを書き換えます。
代表的な最適化ルール:
| ルール | 説明 |
|---|---|
| 定数畳み込み | 1 + 2 → 3 |
| 述語プッシュダウン | JOIN の前にフィルタ条件を適用し、中間結果を削減します。 |
| サブクエリの書き換え | ネストしたサブクエリを JOIN に展開します。 |
| 共通式の再利用 | 複数回現れる式を一度だけ計算します。 |
CBO と RBO の比較: RBO は決定的でルールに従って動作するため、固定のルールが適用できる場面に適しています。CBO はデータ特性に応じてより高度な最適化ができますが、正確な統計情報に依存します。Doris は両方を使用し、RBO が決定的な最適化を、CBO が複雑なプランの選択を担当します。
Runtime Filter
Runtime Filter は、クエリ実行中に動的に生成され、スキャンノードにプッシュダウンされるフィルタ条件です。データの読み込み時にフィルタリングできます。
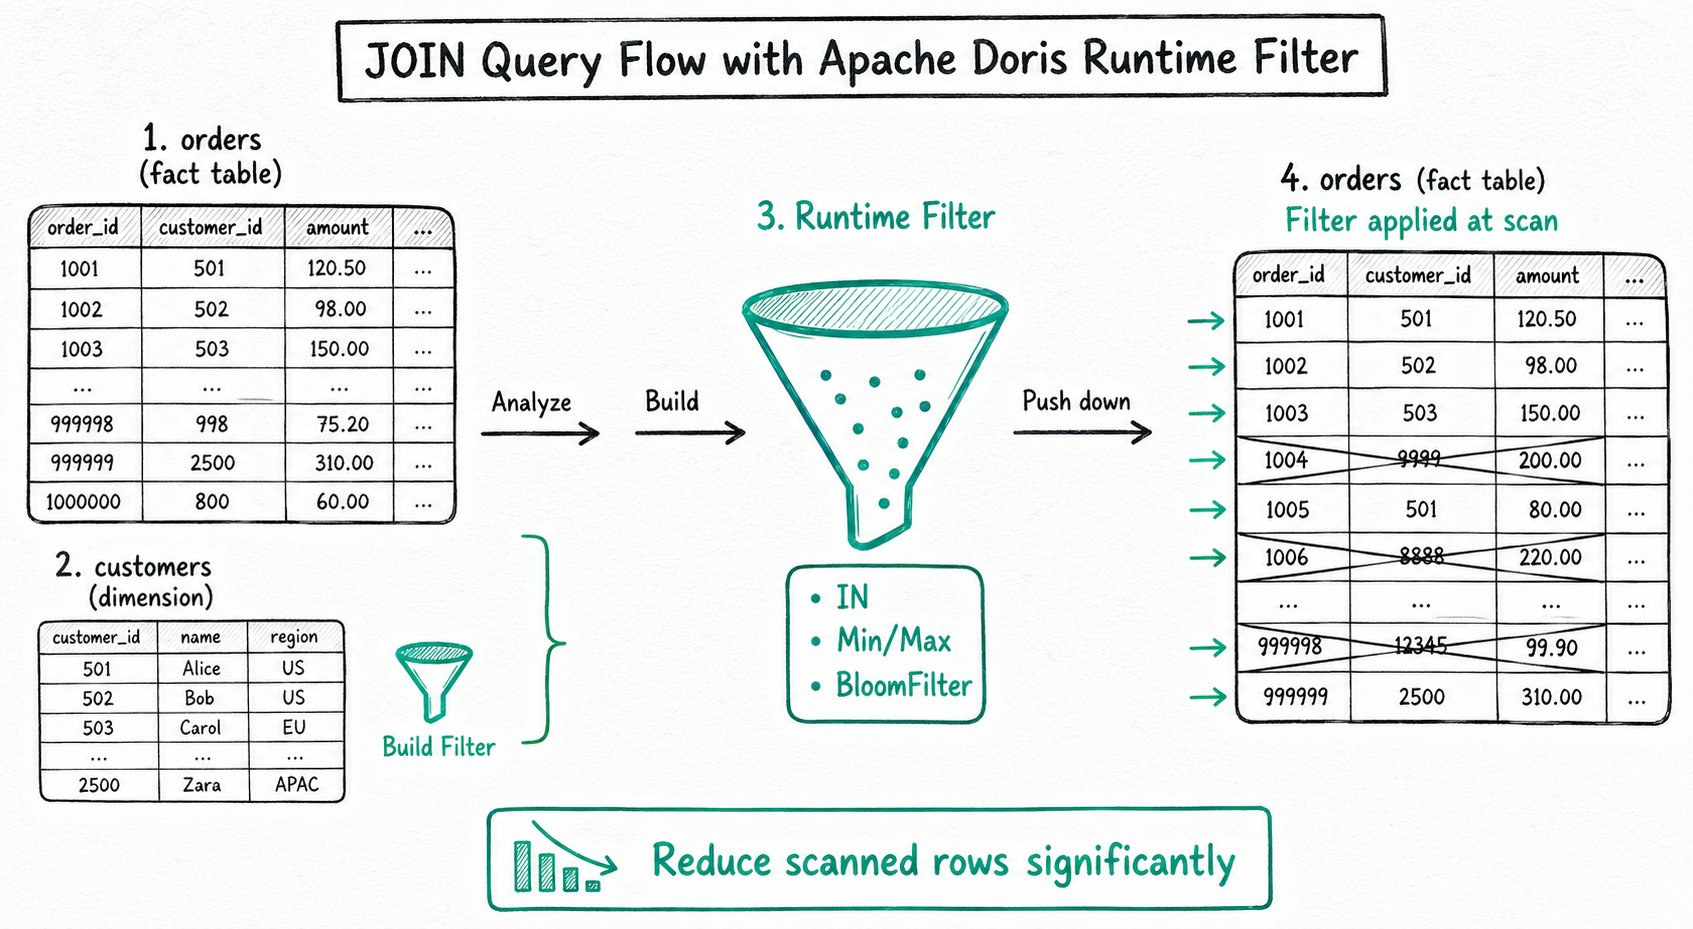
処理の流れ:
Suppose a JOIN is performed between the large table orders and the small table customers on customer_id:

1. The FE analyzes the small table and builds a Filter (such as customer_id IN {1, 5, 9}).
2. The Filter is pushed down to the nodes that scan the large table.
3. While the large table is being read, rows that do not match are filtered out immediately and skipped.
4. This reduces I/O and the workload of subsequent operators.
Runtime Filter の種類:
| 種類 | ユースケース |
|---|---|
| IN | 小規模テーブルと大規模テーブルの等価 JOIN |
| Min/Max | 範囲 JOIN、連続したデータ分布 |
| BloomFilter | カーディナリティの高い列での等価 JOIN |
効果: スタースキーマでは、大きな fact テーブルと小さな dimension テーブルを JOIN する際に、Runtime Filter によって大きなテーブルのスキャン量を数分の一から数十分の一に減らせる場合があります。
FAQ
Q: パーティションとバケットの違いは何ですか?
パーティションは列の値の範囲に基づいてデータを分割します。日単位のパーティションを削除するなどのデータのライフサイクル管理や、クエリに関係するパーティションだけをスキャンするパーティションプルーニングに使います。バケットはハッシュに基づいてデータを分散し、並列処理や JOIN の最適化に役立ちます。パーティションは論理的な概念で、バケットは物理的な概念です(データがどの BE ノードに分散されるかを決めます)。
Q: Duplicate モデルではなく Primary Key モデルを選ぶべきなのはどのような場合ですか?
リアルタイムのデータ取り込みや CDC 同期などで行単位の更新が必要な場合、または同じキーを持つレコードをマージしたい場合は、Primary Key モデルを選びます。Duplicate モデルは元のデータをすべて保持し、ログ分析や全明細のクエリに適しています。
Q: MPP と Pipeline はどのような関係にありますか?
これらは異なる二つの側面で並列処理を実現します。MPP はノード間の並列計算を扱う分散並列処理です。Pipeline はマルチコアのリソース活用を扱うノード内の並列処理です。両者を組み合わせることで、「ノード間の並列処理とノード内のパイプライン処理」による一貫した並列処理が可能になります。
Q: CBO と RBO が使用する統計情報はどこから得られますか?
Doris は ANALYZE コマンドで、テーブルの行数、列のカーディナリティ(NDV)、NULL の比率など、テーブルと列の統計情報を収集します。CBO はこれらの統計情報をコスト推定に使用します。統計情報が正確なほど、最適化の結果も向上します。データ量が大きく変化した後は ANALYZE を再実行してください。
Q: 外部 Catalog と通常の Database の違いは何ですか?
通常の Database は Doris 内にデータを保存します。一方、外部 Catalog は論理的なマッピングにすぎず、実際のデータは外部データソースに保存されたままです。Doris は外部 Catalog を通じて外部データを直接読み込むため、ETL による移行は不要です。代表的な用途には、データレイク(Hive/Iceberg/Hudi)のクエリや、MySQL、PostgreSQL などとのソースをまたいだクエリがあります。
Q: マテリアライズドビューと通常のビューの違いは何ですか?
通常のビューは SQL のクエリロジックのみを保存し、クエリのたびに結果を計算するため、性能上の利点はありません。マテリアライズドビューはクエリ結果を物理的に保存し、データを同期させながらユーザーのクエリを透過的に高速化します。クエリパターンが安定している集約レポートに適しています。
関連資料
- [TODO] - 統合型およびストレージとコンピューティングの分離型アーキテクチャについて学ぶ
- [TODO] - CBO と実行プランについて詳しく学ぶ