ダッシュボード
概要
このドキュメントでは、Grafana で DOG Stack の可観測性データを利用する方法を説明します。
DOG Stack は Doris を統合ストレージバックエンドとして使用します。Doris は MySQL プロトコルと互換性があるため、Grafana に単一の MySQL データソースを設定するだけで、ログ、トレース、メトリクスをすべてクエリできます。データの流れは次のとおりです。
Apps / Infrastructure → OpenTelemetry Collector → Doris Exporter → Doris → Grafana (MySQL DataSource)
このドキュメントでは、以下を扱います。
- 構築済みダッシュボードのインポート: 提供されているダッシュボードを利用します。
- データモデルの理解: OTel データが Doris にどのように保存されるかを説明します。
- カスタムダッシュボードの作成: パネル、クエリ、変数を一から作成します。
- リファレンス: スキーマと構文の早見表です。
前提条件
始める前に、以下を確認してください。
- DOG Stack がデプロイされ、Grafana と Doris の両方が稼働していること。
- Doris に接続する MySQL タイプのデータソースが Grafana に設定されていること(DOG Stack に付属する Grafana には、Doris データソースがあらかじめ設定されています)。
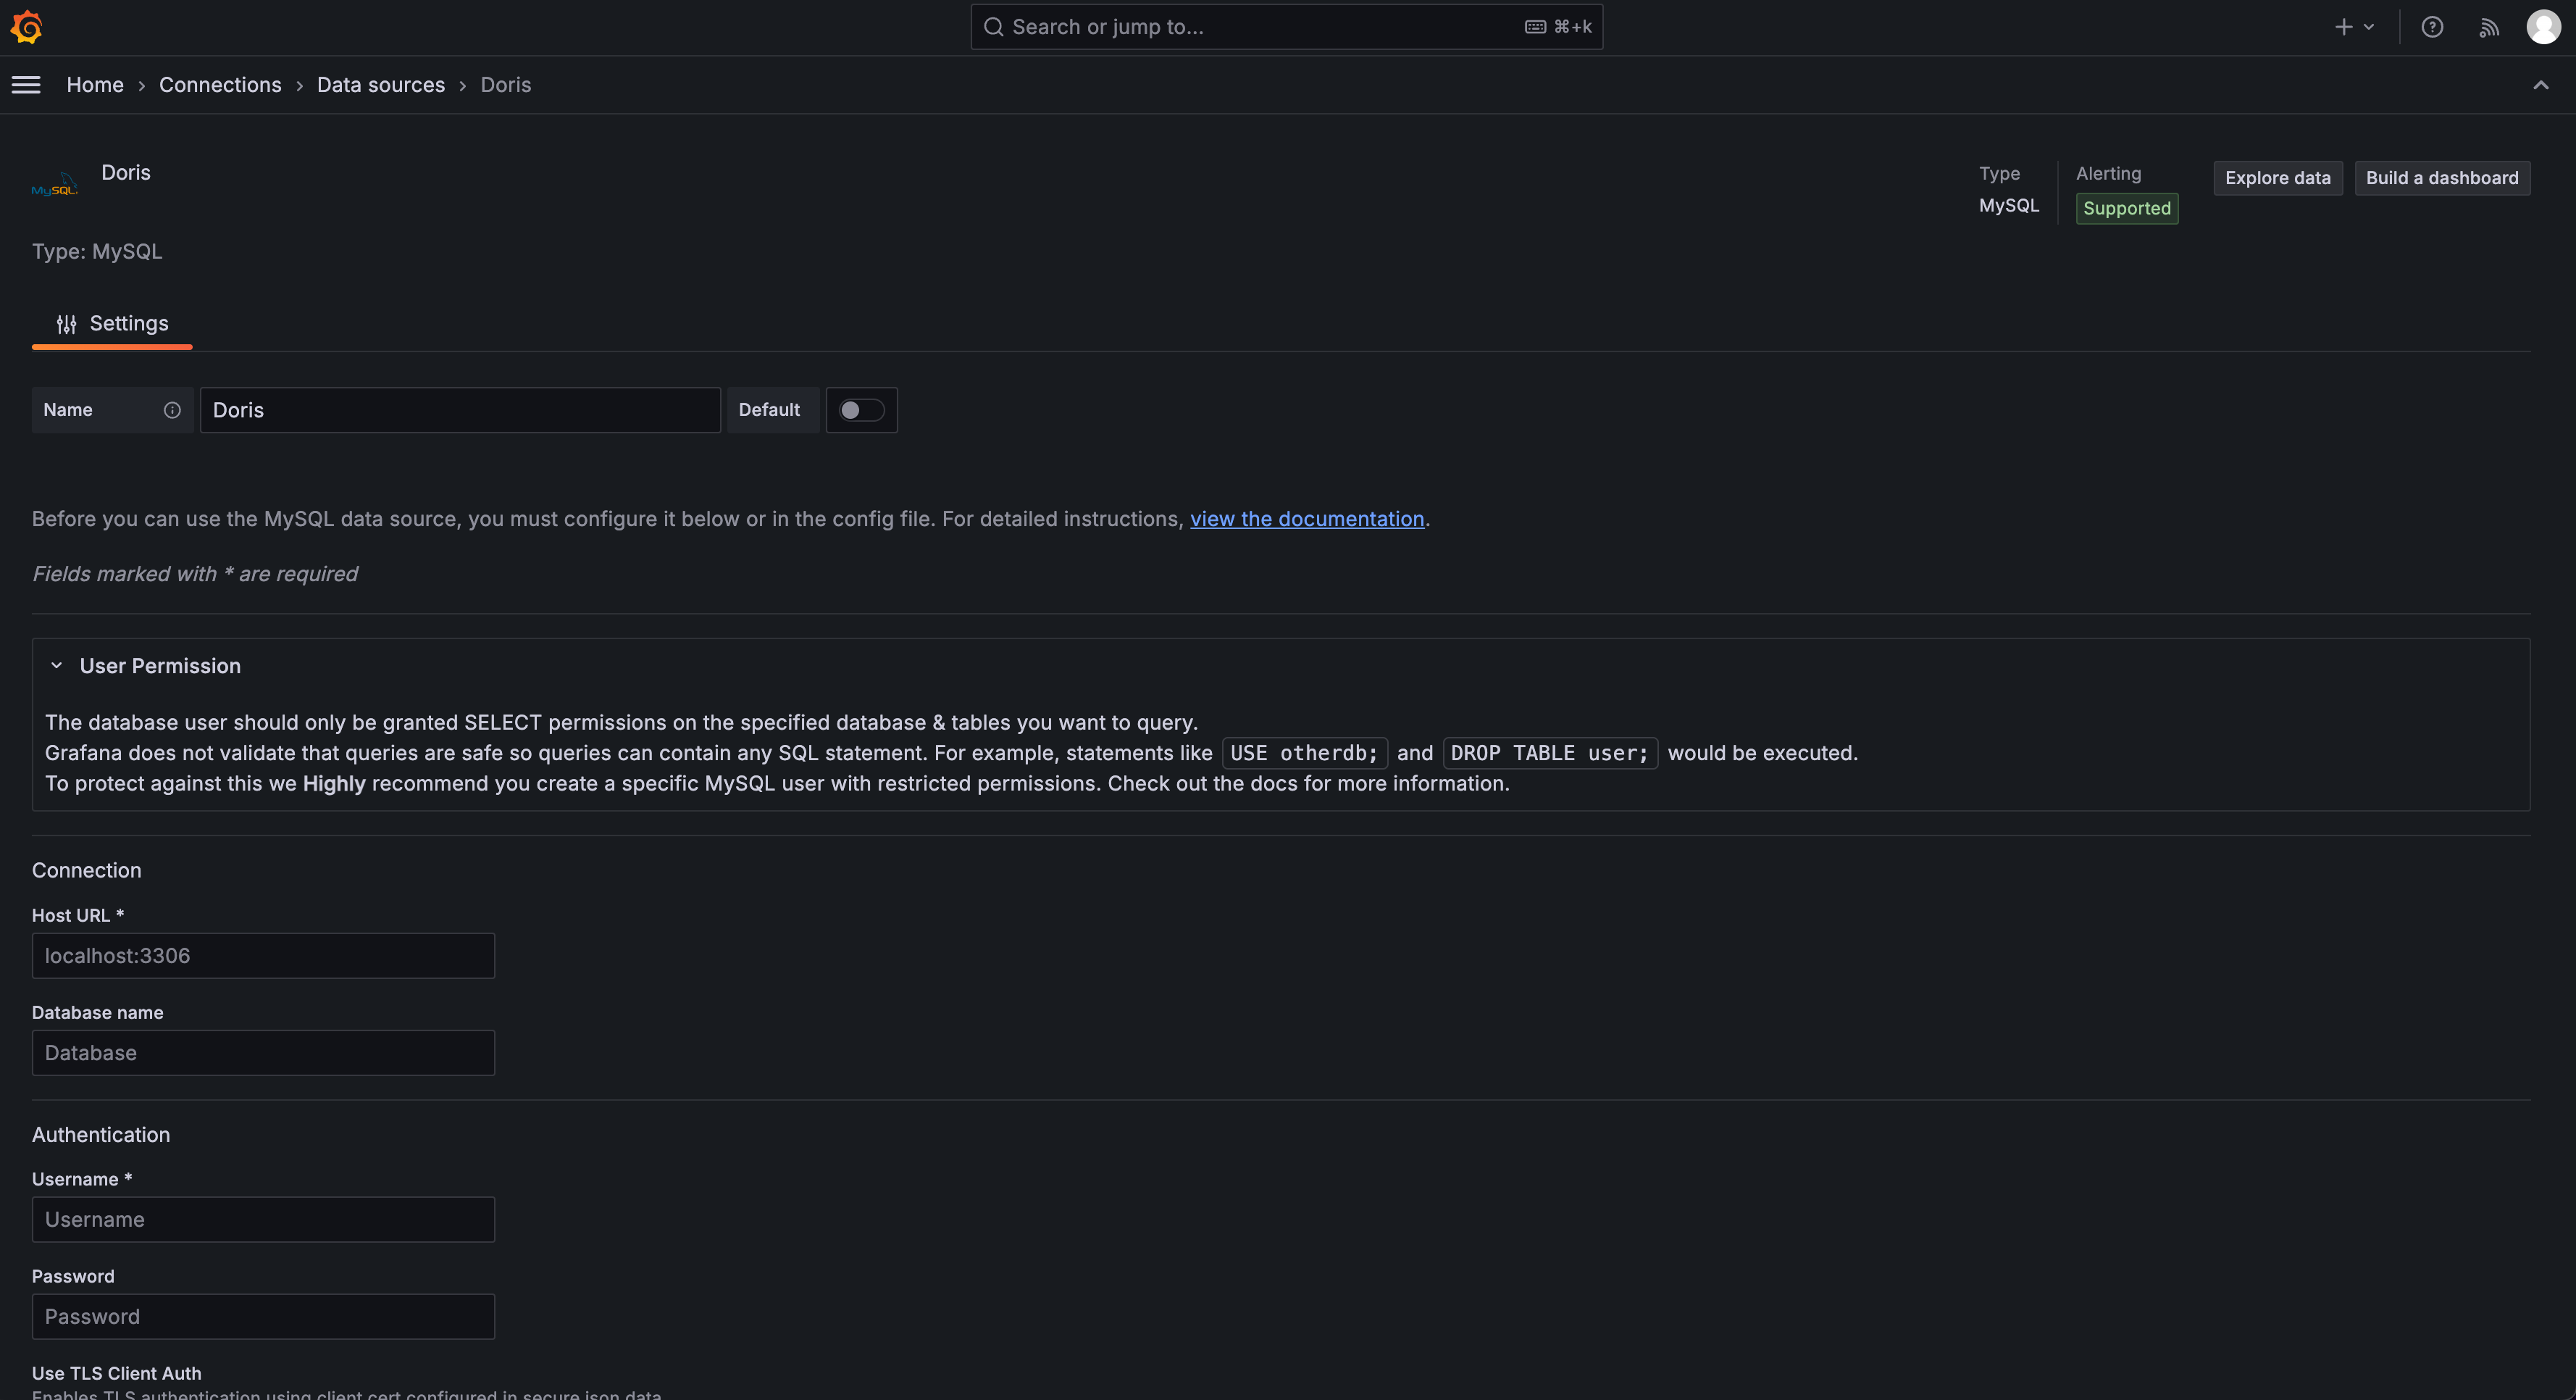
データソースが未設定の場合は、以下の手順で設定します。
-
Grafana の左側のメニューで、Connections > Data sources > Add data source をクリックします。
-
MySQL を選択します。
-
接続情報を入力します。
- Host:
<Doris-fe-host>:9030- Database:
otel- User:
root(または設定済みのユーザー)- Password: 空欄のままにします(パスワードを設定していない場合)。
-
Save & test をクリックして、接続を確認します。
構築済みダッシュボードのインポート
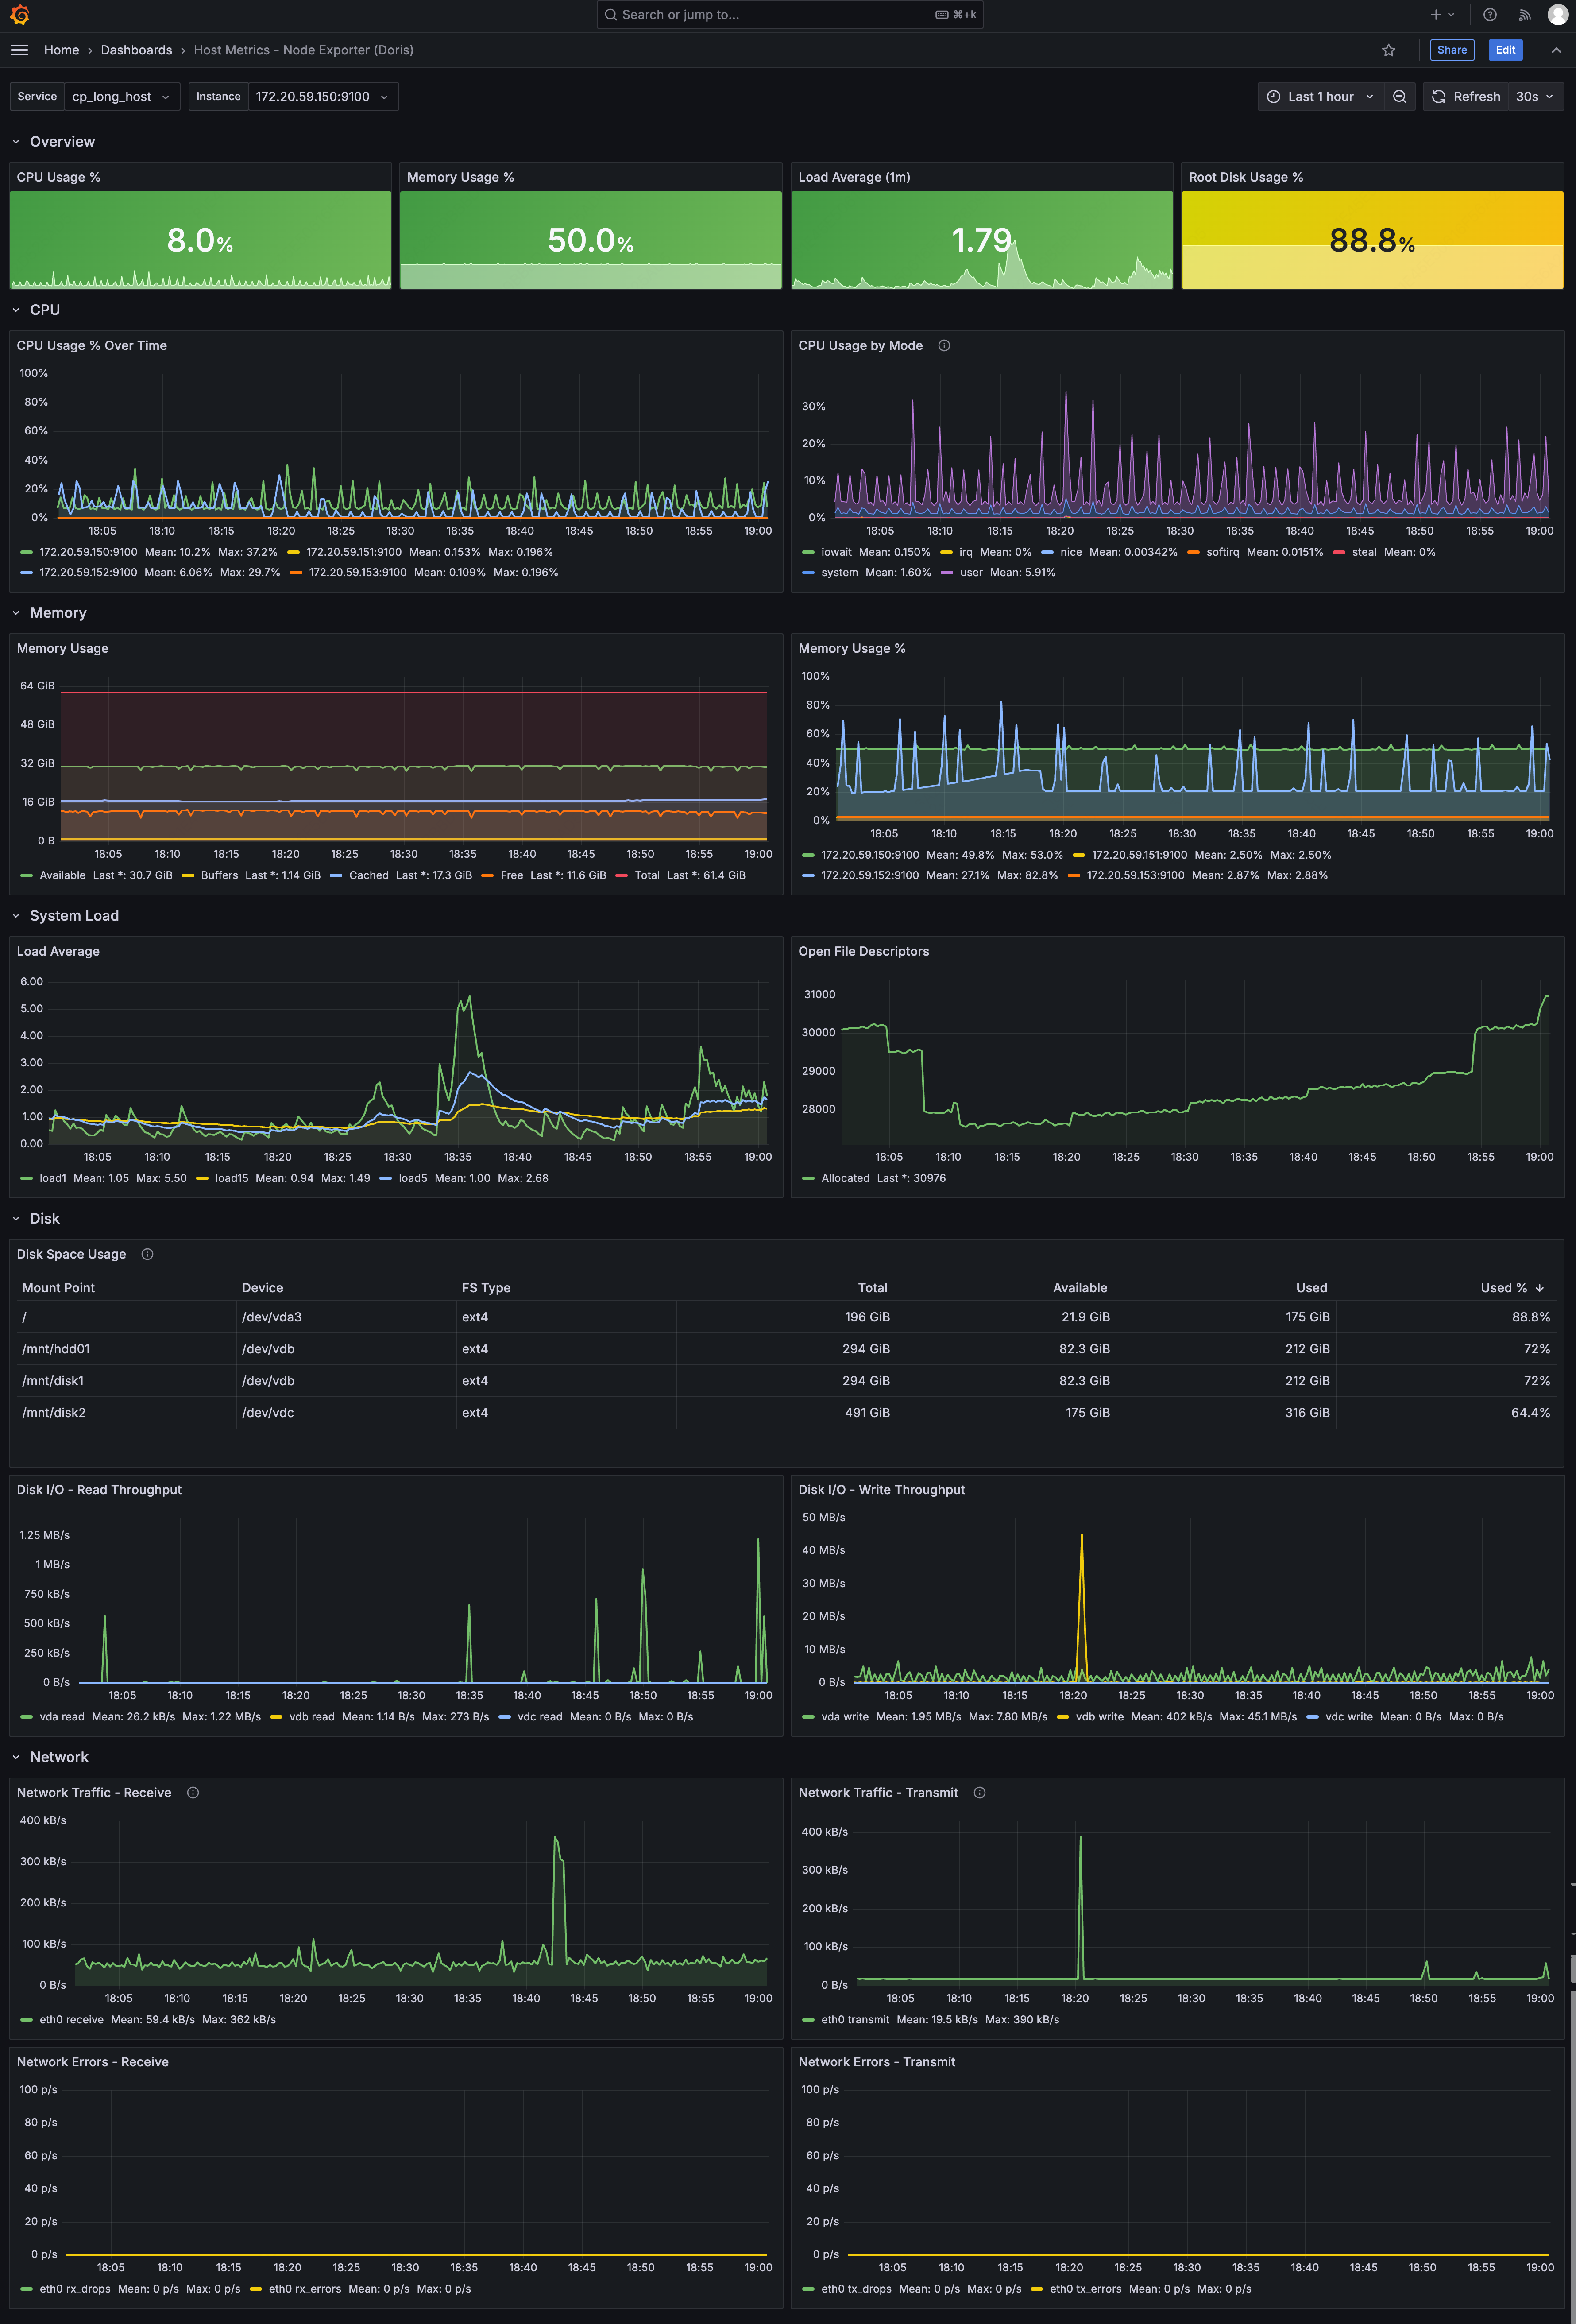
一般的な可観測性の用途向けに、4 つの構築済みダッシュボードを提供しています。
| ダッシュボード | ファイル | 監視対象 |
|---|---|---|
| ホストメトリクス | host_metrics_dashboard.json | CPU、メモリ、ディスク、ネットワーク、システム負荷 |
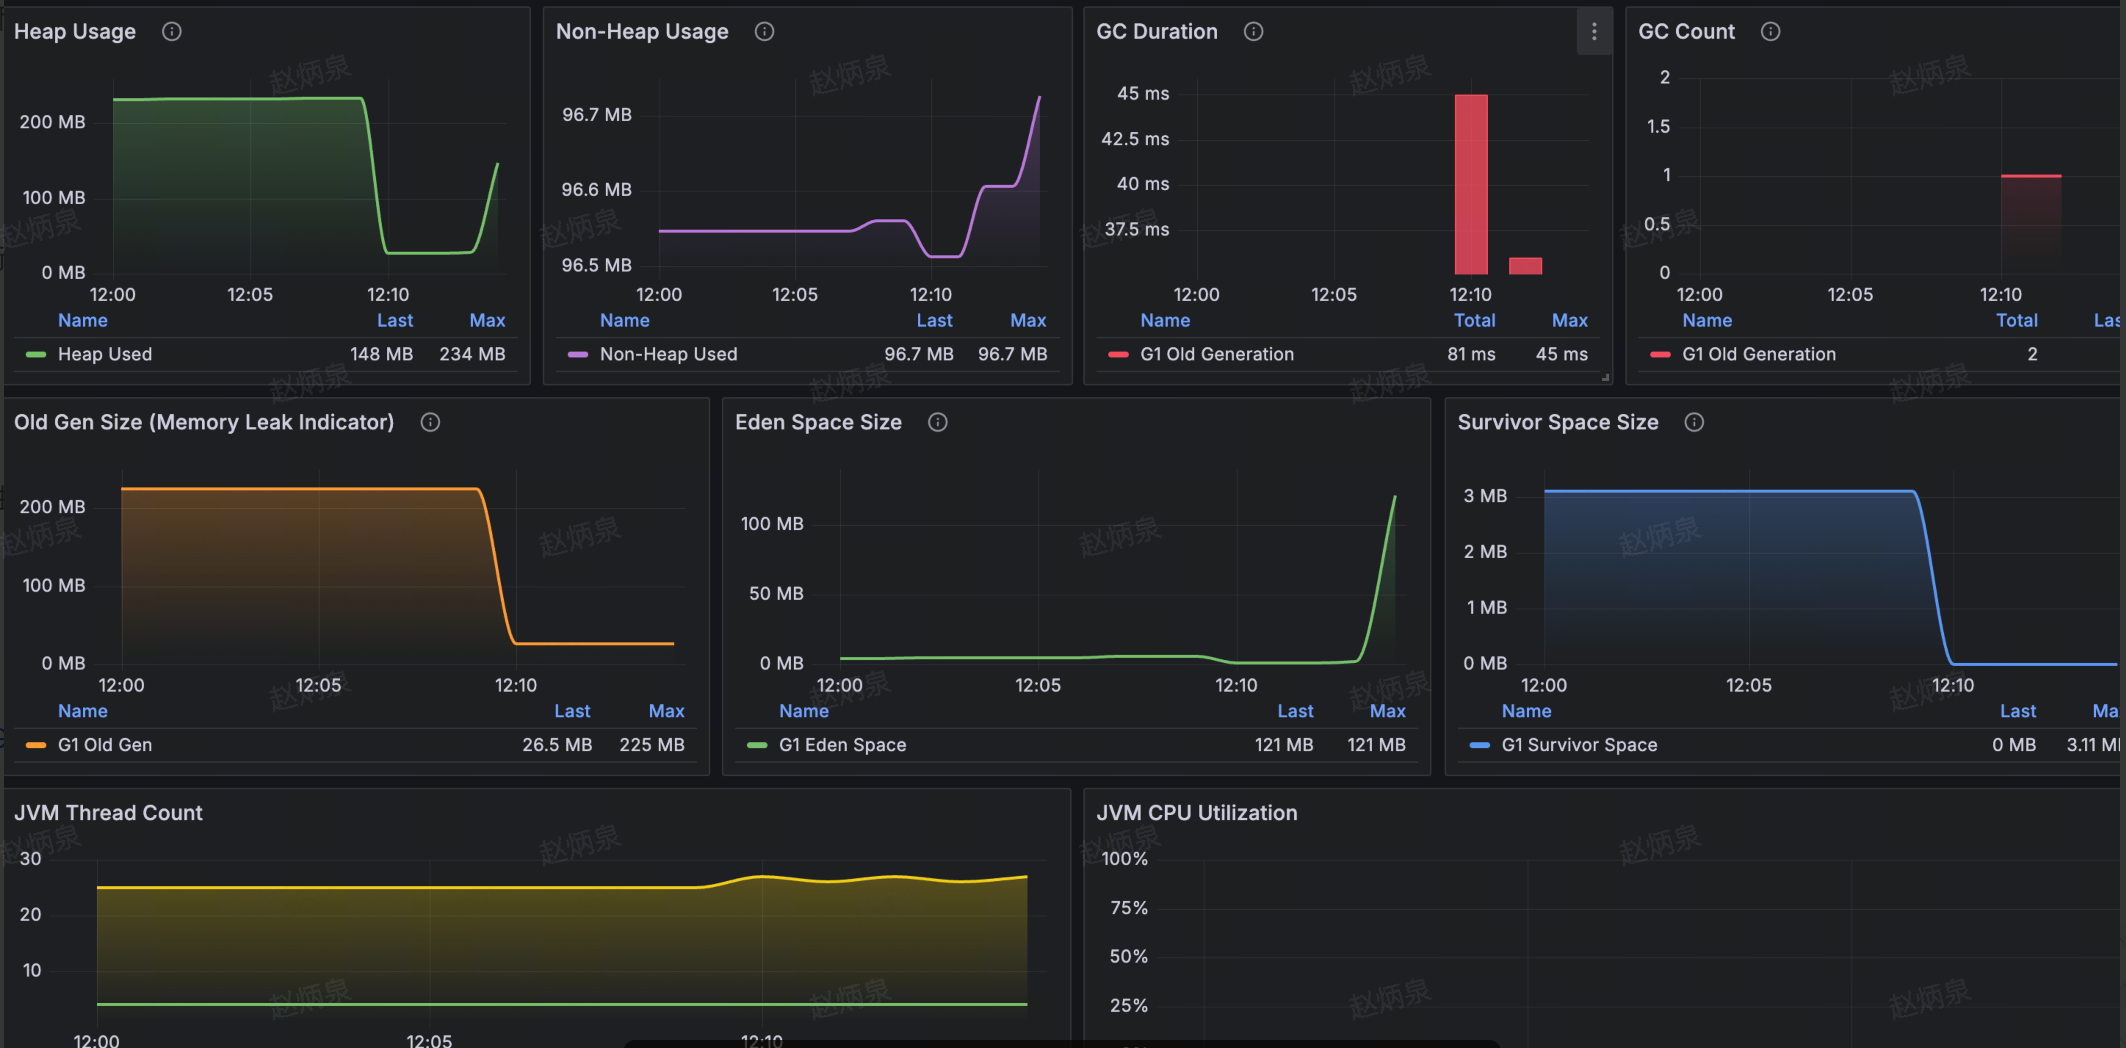
| JVM モニタリング | jvm_metrics_dashboard.json | ヒープメモリ、GC、スレッド、CPU 使用率 |
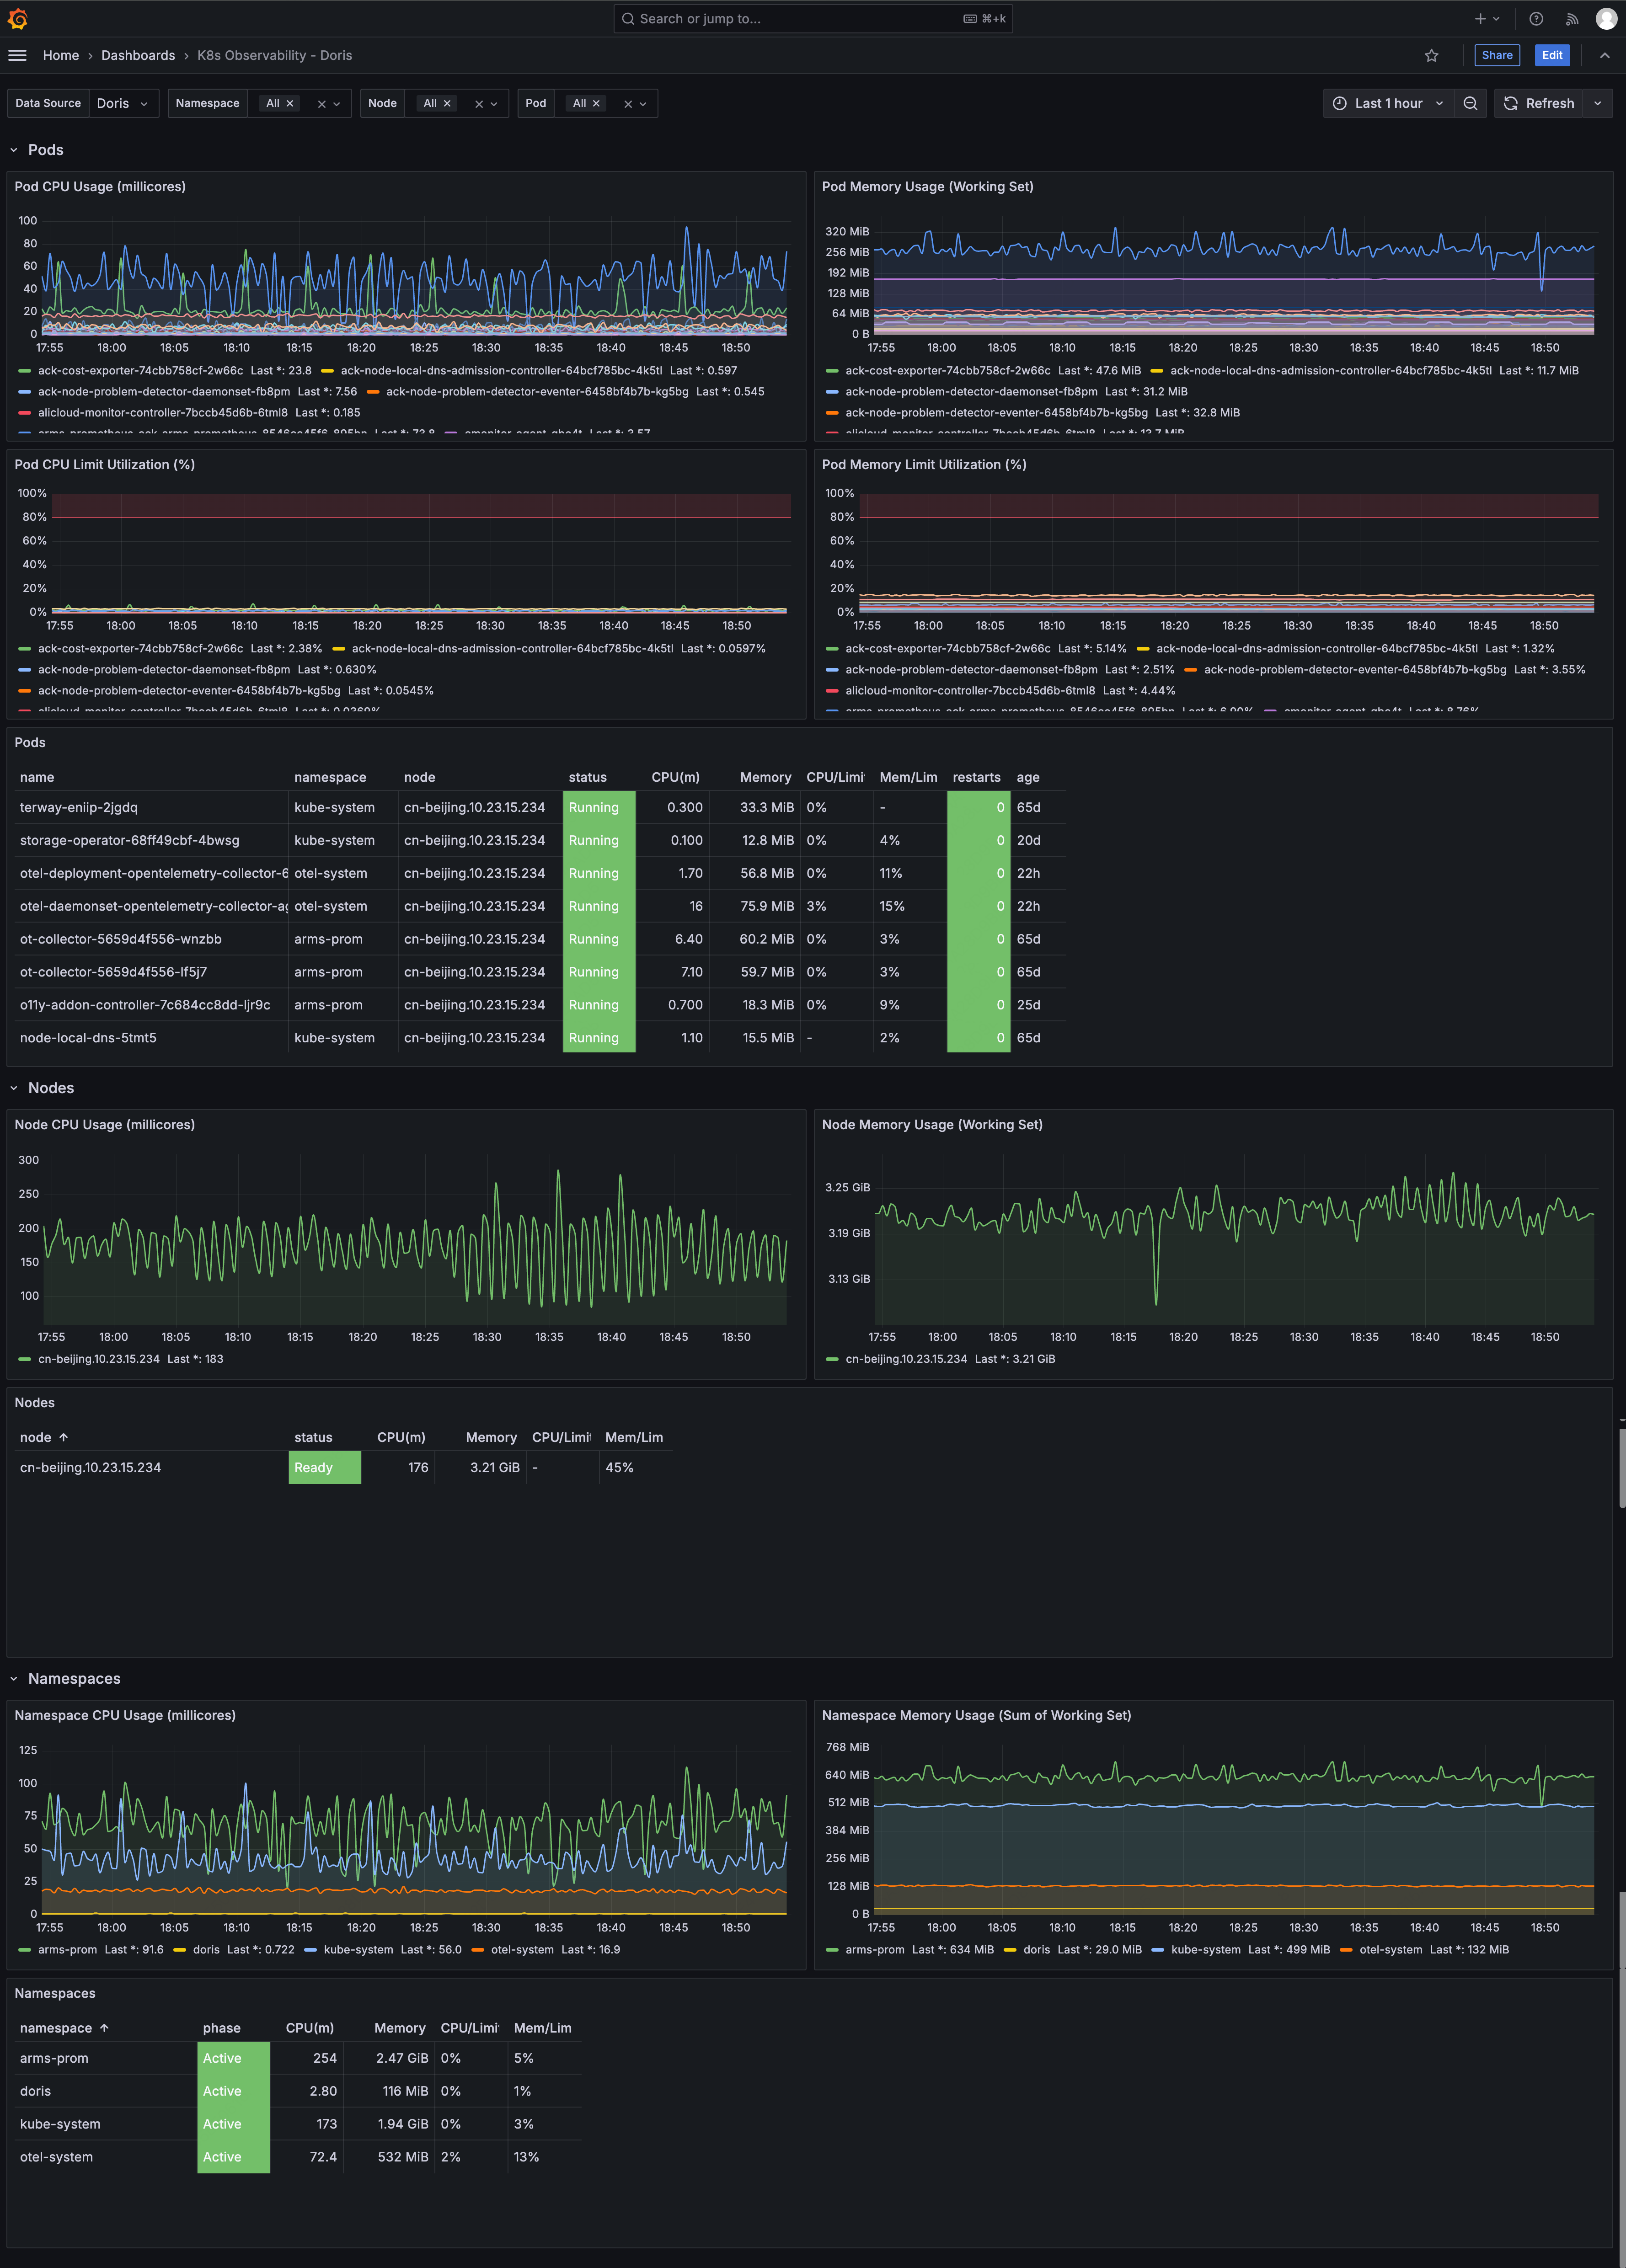
| K8s 可観測性 | k8s_kubelet_dashboard.json | Pod / Node / Namespace のリソース使用量 |
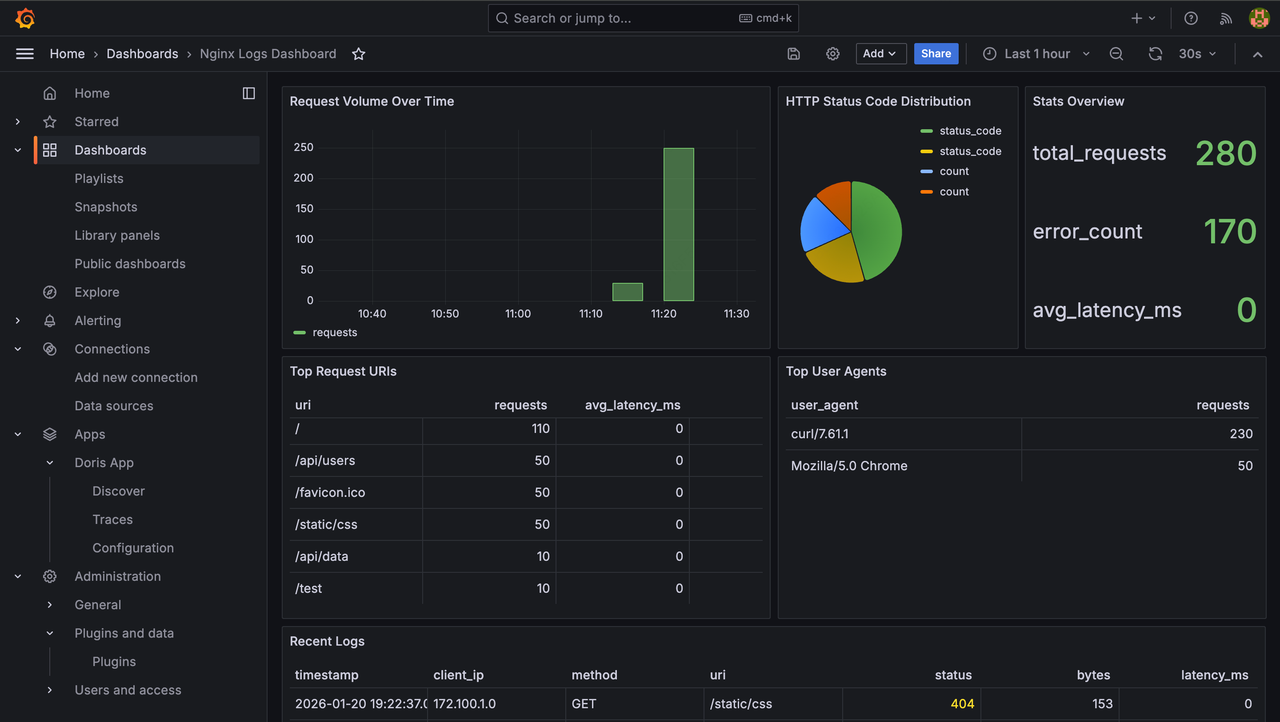
| Nginx ログ | nginx_logs_dashboard.json | リクエスト、ステータスコード、上位 URL、エラーログ |
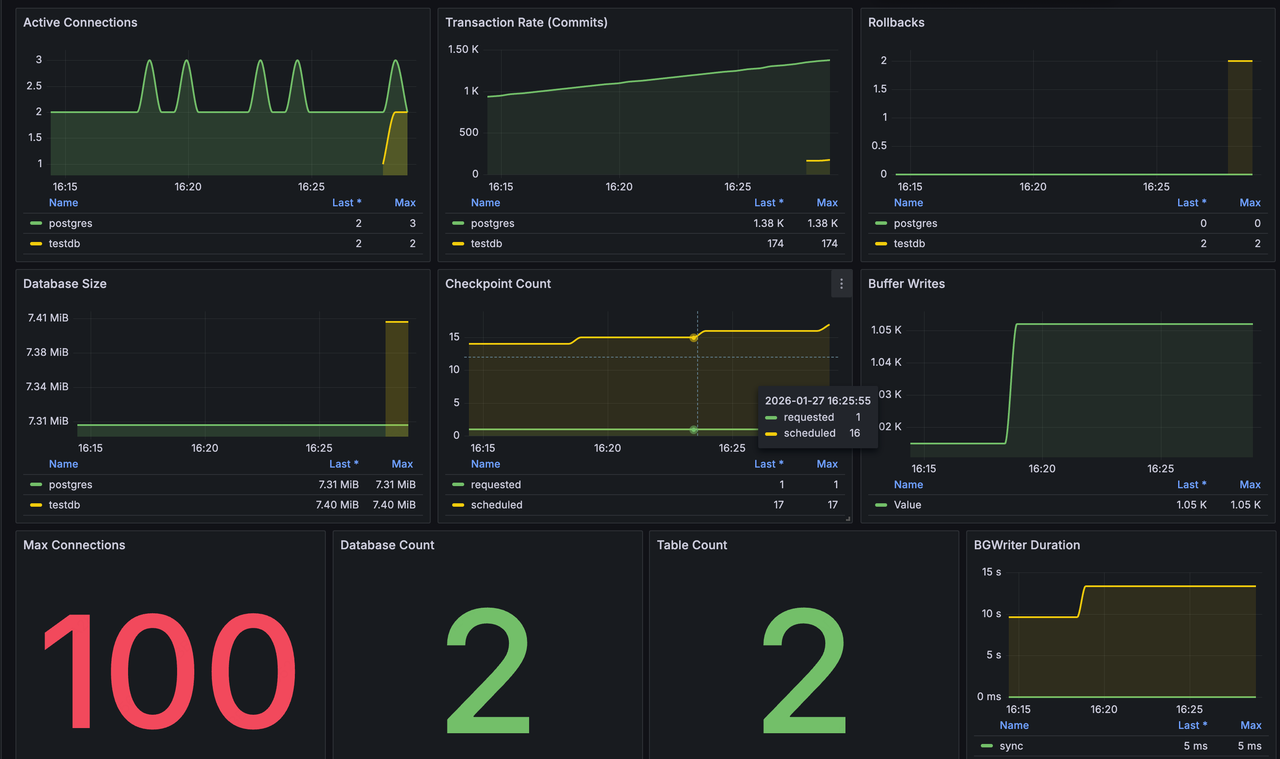
| PostgreSQL メトリクス | postgresql-metrics-dashboard.json | 接続、トランザクション、DB サイズ、Checkpoint、BGWriter |
構築済みダッシュボードをインポートするには、次の操作を行います。
-
Grafana の左側のメニューで、Dashboards > New > Import をクリックします。
-
Upload dashboard JSON file をクリックし、
grafana-dashboard/内の JSON ファイルを選択します。 -
インポート画面で、設定済みの Doris(MySQL)データソースを選択します。
-
Import をクリックします。
-
残りの JSON ファイルについても、上記の手順を繰り返します。
インポート後は、ダッシュボード上部にある変数の選択欄(Service や Namespace など)の候補値が Doris から自動的に取得されます。
各ダッシュボードのパネル詳細
ホストメトリクスダッシュボード
- 概要: CPU 使用率、メモリ使用率、1 分間の負荷、ルートディスク使用率
- CPU: 使用率の推移、Mode 別の使用率
- メモリ: メモリの内訳(Total / Available / Free / Cached / Buffers)、使用率の推移
- システム負荷: 1 / 5 / 15 分間の負荷、開いているファイルディスクリプタ数
- ディスク: ディスク容量使用量の表、読み取り・書き込みスループット
- ネットワーク: 受信・送信トラフィック、エラー、パケットドロップ
JVM モニタリングダッシュボード
- 概要: ヒープ使用量、Full GC 回数、CPU 使用率、スレッド数
- メモリ: ヒープ・非ヒープの推移、Old Gen / Eden / Survivor プールの詳細
- GC: Young / Old の所要時間と回数
- スレッドと CPU: スレッド数の推移、CPU 使用率
K8s 可観測性ダッシュボード
- Pod: CPU(ミリコア)、メモリ、Limit 使用率、ステータス表(再起動回数と稼働時間を含む)
- Node: CPU・メモリの推移、ステータス表
- Namespace: CPU・メモリの集計値、ステータス表
Nginx ログダッシュボード
- 概要: リクエスト、エラー、5xx / 4xx の統計、ステータスコードの円グラフ
- 推移: リクエスト数・エラーログの推移
- 分析: 上位 URL、上位 IP、HTTP メソッドの分布、頻出するエラーメッセージ
- 最近のログ: アクセスログ・エラーログの詳細
PostgreSQL メトリクスダッシュボード
- 接続: アクティブな接続数(データベース別)、最大接続数
- トランザクション: コミット率、ロールバック回数
- ストレージ: データベースサイズ(データベース別)、データベース数、テーブル数
- BGWriter: チェックポイント数(スケジュール実行 / 要求による実行)、バッファ書き込み数、BGWriter の処理時間
データモデルの理解
カスタムダッシュボードを作成する前に、OTel データが Doris にどのように保存されるかを把握する必要があります。
テーブル
Prometheus とは異なり、Doris ではメトリクス名だけではクエリできません。クエリ先のテーブルも指定する必要があります。OTel データは、シグナルとメトリクスの種類に応じて複数のテーブルに保存されます。
| テーブル | 内容 | 値のフィールド | クエリ方法 |
|---|---|---|---|
otel_metrics_gauge | 瞬間値のメトリクス | value | AVG(value) などで直接集計する |
otel_metrics_sum | 累積カウンター | value(単調増加) | LAG() でレートを計算する |
otel_metrics_histogram | ヒストグラム | count、sum、bucket_counts | LAG() で差分を計算する |
otel_logs | ログ | body、severity_text | COUNT による集計または詳細クエリ |
otel_traces | トレース | duration、span_name | 所要時間でソートまたは集計する |
特定のメトリクスがどのテーブルにあるかを調べるには、次のクエリを実行します。
SELECT 'gauge' AS type, metric_name FROM otel.otel_metrics_gauge WHERE metric_name = 'your_metric_name' LIMIT 1
UNION ALL
SELECT 'sum', metric_name FROM otel.otel_metrics_sum WHERE metric_name = 'your_metric_name' LIMIT 1
UNION ALL
SELECT 'histogram', metric_name FROM otel.otel_metrics_histogram WHERE metric_name = 'your_metric_name' LIMIT 1;
利用可能なメトリクスを一覧表示するには、各テーブルで次のクエリを実行します。
SELECT DISTINCT metric_name FROM otel.otel_metrics_gauge ORDER BY metric_name;
属性フィールド
Prometheus ではすべてのラベルに {key="value"} の形式でアクセスできます。Doris では属性が複数の variant(JSON)カラムに分かれており、角括弧を使ってアクセスします。
| テーブル | フィールド | 内容 | 例 |
|---|---|---|---|
| metrics | attributes | メトリクスのディメンション(Prometheus のラベル) | attributes['mode'] |
| metrics | resource_attributes | リソース情報(K8s の Pod / Node など) | resource_attributes['k8s.pod.name'] |
| logs | log_attributes | ログのフィールド | log_attributes['status'] |
| traces | span_attributes | スパンのフィールド | span_attributes['http.method'] |
注: service_name と service_instance_id はトップレベルのカラムであり、attributes には含まれません。WHERE service_name = '...' のように直接使用してください。
SELECT、GROUP BY、PARTITION BY、LIKE で属性を使用するときは、CAST で型を変換する必要があります。
-- Extract a value in SELECT
CAST(attributes['device'] AS VARCHAR) AS device

-- Pattern match in WHERE
CAST(attributes['device'] AS VARCHAR) NOT LIKE 'veth%'

-- Numeric comparison in WHERE
CAST(log_attributes['status'] AS INT) >= 500

-- Use in GROUP BY
GROUP BY CAST(resource_attributes['k8s.pod.name'] AS VARCHAR)
WHERE で単純な等価比較を行う場合、通常は CAST は不要です。
WHERE attributes['mode'] = 'idle'
注意: 誤った属性フィールド名を使用しても(たとえば、メトリクステーブルで log_attributes を使用しても)エラーにはなりません。結果が暗黙に NULL となり、クエリ結果が空になります。
Counter メトリクスとレートの計算
Gauge メトリクスでは、value が現在の値を直接表し、AVG や MAX で集計できます。
Counter / Sum メトリクスでは、value は単調増加する累積値です(CPU の合計秒数やネットワークの合計バイト数など)。レートを求めるには、隣接するデータポイントの差分を計算する必要があります。Prometheus の rate() に相当する処理は、Doris では LAG() ウィンドウ関数で実装します。
以下は汎用的なレート計算テンプレートです。
SELECT
  t.timestamp AS time,
  t.<dimension_field> AS metric,
  CASE
    WHEN UNIX_TIMESTAMP(t.timestamp) > UNIX_TIMESTAMP(t.prev_ts)
         AND t.value >= t.prev_value
    THEN (t.value - t.prev_value) / (UNIX_TIMESTAMP(t.timestamp) - UNIX_TIMESTAMP(t.prev_ts))
    ELSE NULL
  END AS value
FROM (
  SELECT timestamp, value, <dimension_field>,
    LAG(value) OVER (PARTITION BY <dimension_field> ORDER BY timestamp) AS prev_value,
    LAG(timestamp) OVER (PARTITION BY <dimension_field> ORDER BY timestamp) AS prev_ts
  FROM otel.otel_metrics_sum
  WHERE metric_name = '<metric_name>'
    AND $__timeFilter(timestamp)
) t
WHERE t.prev_ts IS NOT NULL
ORDER BY time
このテンプレートを使用するには、以下のプレースホルダーを置き換えます。
<dimension_field>: 系列を分けるフィールド。例:CAST(attributes['device'] AS VARCHAR)。<metric_name>: メトリクス名。例:node_network_receive_bytes_total。
このテンプレートには、次の安全対策が含まれています。
| 条件 | 目的 |
|---|---|
WHERE t.prev_ts IS NOT NULL | 各パーティションの最初の行を除外する(LAG は NULL を返す) |
UNIX_TIMESTAMP(t.timestamp) > UNIX_TIMESTAMP(t.prev_ts) | タイムスタンプの重複によるゼロ除算を防ぐ |
t.value >= t.prev_value | カウンターのリセットによる負の差分を防ぐ |
PARTITION BY の選択は、レート計算の正しさに直接影響します。誤ったフィールドを選ぶと、異なるディメンションのデータが混ざります。構築済みダッシュボードでは、次のように指定しています。
| 用途 | PARTITION BY |
|---|---|
| CPU 使用率(複数コアの集計) | service_instance_id, CAST(attributes['cpu'] AS VARCHAR) |
| ディスク I/O | CAST(attributes['device'] AS VARCHAR) |
| ネットワークトラフィック | CAST(attributes['device'] AS VARCHAR) |
| GC 時間 | CAST(attributes['jvm.gc.name'] AS VARCHAR) |
カスタムダッシュボードの作成
このセクションでは、複数のパネルと変数を持つダッシュボードを一から作成する手順を説明します。
ダッシュボードと Time Series パネルの作成
K8s Pod の CPU 使用率の推移を表示する Time Series パネルを作成します。この例では Gauge メトリクスを使用し、SQL を組み立てる過程を順に示します。
-
Grafana の左側のメニューで、Dashboards > New > New dashboard をクリックします。
-
Add visualization をクリックします。
-
データソースのドロップダウンから、設定済みの MySQL(Doris)データソースを選択します。
-
クエリエディターの右上で Code モードに切り替えます。
以下の手順で SQL クエリを組み立てます。
基本クエリを作成します。 監視対象は Pod の CPU で、メトリクス名は k8s.pod.cpu.usage です。これは otel_metrics_gauge に保存される Gauge メトリクスで、value を直接集計できます。
SELECT timestamp, value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.cpu.usage'
時間フィルターを追加します。 Grafana の MySQL データソースでは、時間をフィルターする方法が二つあります。
-- Option A: use the $__timeFilter macro (recommended)
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND $__timeFilter(timestamp)

-- Option B: use $__from and $__to (more flexible inside subqueries or JOINs)
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND timestamp >= FROM_UNIXTIME($__from/1000)
  AND timestamp < FROM_UNIXTIME($__to/1000)
注: $__from と $__to はミリ秒単位のタイムスタンプです。FROM_UNIXTIME() で使用する前に 1000 で割ってください。
時間をバケットに分けます。 生データのポイント数が多すぎるため、一定間隔で集計します。FLOOR(UNIX_TIMESTAMP(timestamp) / N) * N を使用すると、時刻を N 秒単位のバケットに丸められます。
SELECT
  FLOOR(UNIX_TIMESTAMP(timestamp) / 20) * 20 AS time,
  AVG(value) AS value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND timestamp >= FROM_UNIXTIME($__from/1000)
  AND timestamp < FROM_UNIXTIME($__to/1000)
GROUP BY time
ORDER BY time
ディメンションごとに複数の系列へ分けます。 Time Series 形式では、Grafana の MySQL データソースに次の三つのカラムが必要です。
| カラム | 役割 |
|---|---|
time または time_sec | X 軸の時刻。datetime 値、または秒単位の UNIX タイムスタンプ。 |
metric | 系列名。このカラムの値ごとに、Grafana が別々の線を描画します。 |
value | Y 軸の値。 |
Pod 名を metric カラムとして追加すると、完全なクエリは次のようになります。
SELECT
  FLOOR(UNIX_TIMESTAMP(timestamp) / 20) * 20 AS time,
  CAST(resource_attributes['k8s.pod.name'] AS VARCHAR) AS metric,
  AVG(value) AS value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND timestamp >= FROM_UNIXTIME($__from/1000)
  AND timestamp < FROM_UNIXTIME($__to/1000)
GROUP BY time, metric
ORDER BY time
別の Gauge メトリクスを監視する場合は、以下を変更します。
metric_name: 対象のメトリクス名。metricカラム:attributesまたはresource_attributesから選ぶ、系列を分けるディメンション。
-
完成した SQL をクエリエディターに貼り付けます。
-
エディターの下で Format を Time series に設定します。
-
パネルのタイトルをクリックして名前を設定します。
-
右側のパネル設定で Standard options > Unit を開き、適切な単位を選択します。
-
右上の Apply をクリックします。
Counter メトリクスのパネルの追加
ここでは、Counter メトリクスのレートを表示する Time Series パネルを作成します。Counter の value は単調増加する累積値なので、汎用的なレート計算テンプレートを使ってレートを計算します。
- ダッシュボードで Add > Visualization をクリックします。
- データソースを選択し、Code モードに切り替えます。
レート計算テンプレートのプレースホルダーを具体的な値に置き換えます。次の例では、ネットワークデバイスごとに分けて、ネットワーク受信バイト数のレートを計算します。
SELECT
  t.timestamp AS time,
  t.device AS metric,
  CASE
    WHEN UNIX_TIMESTAMP(t.timestamp) > UNIX_TIMESTAMP(t.prev_ts)
         AND t.value >= t.prev_value
    THEN (t.value - t.prev_value) / (UNIX_TIMESTAMP(t.timestamp) - UNIX_TIMESTAMP(t.prev_ts))
    ELSE NULL
  END AS value
FROM (
  SELECT timestamp, CAST(attributes['device'] AS VARCHAR) AS device, value,
    LAG(value) OVER (PARTITION BY CAST(attributes['device'] AS VARCHAR) ORDER BY timestamp) AS prev_value,
    LAG(timestamp) OVER (PARTITION BY CAST(attributes['device'] AS VARCHAR) ORDER BY timestamp) AS prev_ts
  FROM otel.otel_metrics_sum
  WHERE metric_name = 'node_network_receive_bytes_total'
    AND $__timeFilter(timestamp)
) t
WHERE t.prev_ts IS NOT NULL
ORDER BY time
別の Counter メトリクスを使用する場合は、次の二点を変更します。
metric_name: 対象のメトリクス名。PARTITION BYとSELECTのディメンションフィールド: そのメトリクスを分けるディメンション(attributes['cpu']、attributes['gc_name']など)。- SQL を貼り付け、Format を Time series に設定します。
- Standard options > Unit で適切な単位を選択します。
- Apply をクリックします。
Stat パネルの追加
Stat パネルは、現在の使用率や最新のカウントなど、単一の値を表示します。SQL は単一の値を返すだけで構いません。
- Add > Visualization をクリックし、Code モードに切り替えます。
次のクエリは、指定した時間範囲内で最新のメトリクス値を取得します。
SELECT value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'node_memory_MemAvailable_bytes'
  AND $__timeFilter(timestamp)
ORDER BY timestamp DESC
LIMIT 1
複数のメトリクスを使って計算する場合(比率の計算など)は、最適化のヒントにある「単一の SQL で複数のメトリクスをクエリする」を参照してください。
- SQL を貼り付け、Format を Table に設定します(Stat パネルでは Table 形式を使用します)。
- 右側のパネル設定で、パネルの種類を Stat に変更します。
- Standard options > Unit で適切な単位を選択します。
- Apply をクリックします。
Table パネルの追加
Table パネルは、複数行・複数列のデータに適しています。SQL の各カラムのエイリアスが列見出しになります。
- Add > Visualization をクリックし、Code モードに切り替えます。
次のクエリは、最近のログの詳細を表示します。
SELECT
  timestamp,
  service_name,
  severity_text,
  body,
  CAST(log_attributes['your_key'] AS VARCHAR) AS your_key
FROM otel.otel_logs
WHERE $__timeFilter(timestamp)
ORDER BY timestamp DESC
LIMIT 100
your_key を実際のログ属性のフィールド名に置き換えてください。利用可能な属性を確認するには、次のクエリを実行します。
SELECT log_attributes FROM otel.otel_logs LIMIT 1;
- SQL を貼り付け、Format を Table に設定します。
- Apply をクリックします。
テンプレート変数の追加
テンプレート変数を使用すると、ダッシュボードに対話的なドロップダウンフィルターを追加できます。ユーザーは SQL を変更せずにデータを絞り込めます。
単一選択の変数:
-
ダッシュボード右上の歯車アイコンをクリックし、Settings > Variables > New variable を開きます。
-
以下の設定を入力します。
- Name:
service_name- Type: Query
- Data source: Doris データソースを選択します。
- Query:
sql SELECT DISTINCT service_name FROM otel.otel_metrics_gauge WHERE service_name != '' AND service_name IS NOT NULL AND $__timeFilter(timestamp) ORDER BY service_name
- Apply をクリックします。
パネルの SQL では、$variable 構文で単一選択の変数を参照します。
AND service_name = '$service_name'
複数選択の変数:
-
以下の設定で新しい変数を作成します。
- Name:
namespace- Type: Query
- Multi-value: チェックを入れます。
- Include All option: チェックを入れます。
- Query:
sql SELECT DISTINCT CAST(resource_attributes['k8s.namespace.name'] AS VARCHAR) AS __text FROM otel.otel_metrics_gauge WHERE metric_name = 'k8s.pod.phase' AND timestamp >= NOW() - INTERVAL 1 HOUR ORDER BY 1
- Apply をクリックします。
注: __text カラムのエイリアスは、ドロップダウンに表示するテキストを指定するための Grafana の慣例です。
パネルの SQL では、${variable:sqlstring} 構文と IN() を組み合わせて複数選択の変数を参照します。
AND CAST(resource_attributes['k8s.namespace.name'] AS VARCHAR) IN (${namespace:sqlstring})
注意: 複数選択の変数で :sqlstring を省略すると、SQL の構文エラーになります。
連動する変数:
ある変数の候補値を別の変数の選択値に応じて変えることができます。たとえば、次の Pod 変数は、現在選択されている Namespace に応じて候補を絞り込みます。
SELECT DISTINCT CAST(resource_attributes['k8s.pod.name'] AS VARCHAR) AS __text
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.phase'
  AND timestamp >= NOW() - INTERVAL 1 HOUR
  AND CAST(resource_attributes['k8s.namespace.name'] AS VARCHAR) IN (${namespace:sqlstring})
ORDER BY 1
最適化のヒント
以下は、構築済みダッシュボードで使用されている一般的な最適化手法です。
時間バケットの間隔を調整します。 時間範囲に合ったバケットサイズを選びます。FLOOR(UNIX_TIMESTAMP(timestamp) / N) * N の N を変更してください。
- 20 秒: 短い時間範囲のリアルタイム監視に適しています。
- 60 秒: 時間単位の概要表示に適しています。
- 300 秒: 日単位の推移に適しています。
わかりやすい系列名を設定します。 CONCAT() を使用して複数のフィールドを結合します。
CONCAT(device, ' read') AS metric
CASE WHEN を使用すると、数値を読みやすいテキストに変換できます。
CASE WHEN value = 2 THEN 'Running'
     WHEN value = 1 THEN 'Pending'
     WHEN value = 3 THEN 'Succeeded'
     WHEN value = 4 THEN 'Failed'
     ELSE 'Unknown'
END AS status
ゼロ除算と NULL を処理します。 NULLIF でゼロ除算を防ぎ、COALESCE でデフォルト値を指定します。
/ NULLIF(SUM(...), 0)
COALESCE(restarts, 0)
単一の SQL で複数のメトリクスをクエリします。 JOIN の代わりに CASE WHEN metric_name を使用します。
SELECT timestamp AS time,
  SUM(CASE WHEN metric_name = 'node_memory_MemAvailable_bytes' THEN value END) AS available,
  SUM(CASE WHEN metric_name = 'node_memory_MemTotal_bytes' THEN value END) AS total
FROM otel.otel_metrics_gauge
WHERE metric_name IN ('node_memory_MemTotal_bytes', 'node_memory_MemAvailable_bytes')
GROUP BY timestamp
ノイズとなるデータを除外します。 仮想ネットワークインターフェイスを除外します。
AND CAST(attributes['device'] AS VARCHAR) NOT LIKE 'veth%'
AND CAST(attributes['device'] AS VARCHAR) NOT LIKE 'br-%'
AND CAST(attributes['device'] AS VARCHAR) != 'lo'
実際のファイルシステムのみを残します。
AND CAST(attributes['fstype'] AS VARCHAR) IN ('ext4', 'xfs', 'btrfs')
リファレンス
OTel テーブルスキーマ
メトリクステーブル(gauge / sum / histogram に共通のフィールド)
| フィールド | 型 | 説明 |
|---|---|---|
service_name | varchar(200) | サービス名 |
timestamp | datetime(6) | データのタイムスタンプ |
service_instance_id | varchar(200) | サービスインスタンス ID |
metric_name | varchar(200) | メトリクス名 |
metric_description | text | メトリクスの説明 |
metric_unit | text | メトリクスの単位 |
attributes | variant (JSON) | メトリクスのディメンション |
resource_attributes | variant (JSON) | リソース属性 |
scope_name | text | Collector 名 |
gauge 固有のフィールド: value (double)
sum の追加フィールド: value (double)、aggregation_temporality (text)、is_monotonic (boolean)
histogram の追加フィールド: count (bigint)、sum (double)、bucket_counts (array<bigint>)、explicit_bounds (array<double>)、min (double)、max (double)
ログテーブル
| フィールド | 型 | 説明 |
|---|---|---|
timestamp | datetime(6) | ログのタイムスタンプ |
service_name | varchar(200) | サービス名 |
service_instance_id | varchar(200) | サービスインスタンス ID |
trace_id | varchar(200) | 関連するトレース ID |
span_id | text | 関連するスパン ID |
severity_number | int | 重大度の数値 |
severity_text | text | 重大度のテキスト(INFO / WARN / ERROR) |
body | text | ログ本文 |
resource_attributes | variant (JSON) | リソース属性 |
log_attributes | variant (JSON) | ログ属性 |
トレーステーブル
| フィールド | 型 | 説明 |
|---|---|---|
timestamp | datetime(6) | スパンの開始時刻 |
service_name | varchar(200) | サービス名 |
trace_id | varchar(200) | トレース ID |
span_id | text | スパン ID |
parent_span_id | text | 親スパン ID |
span_name | text | スパン名 |
span_kind | text | スパンの種類(CLIENT / SERVER / INTERNAL) |
end_time | datetime(6) | スパンの終了時刻 |
duration | bigint | 所要時間(ナノ秒) |
span_attributes | variant (JSON) | スパン属性 |
events | array | スパンイベント |
links | array | スパンリンク |
status_code | text | ステータスコード(OK / ERROR / UNSET) |
status_message | text | ステータスメッセージ |
resource_attributes | variant (JSON) | リソース属性 |
構文の早見表
| 用途 | 構文 |
|---|---|
| 時間フィルター(マクロ) | $__timeFilter(timestamp) |
| 時間フィルター(手動) | timestamp >= FROM_UNIXTIME($__from/1000) |
| 時間バケット(20 秒) | FLOOR(UNIX_TIMESTAMP(timestamp) / 20) * 20 AS time |
| 時間バケット(1 分) | UNIX_TIMESTAMP(DATE_FORMAT(timestamp, '%Y-%m-%d %H:%i:00')) * 1000 AS time |
| 属性へのアクセス | attributes['key'] |
| 属性の CAST | CAST(attributes['key'] AS VARCHAR) |
| 単一選択の変数 | service_name = '$service_name' |
| 複数選択の変数 | IN (${namespace:sqlstring}) |
| ゼロ除算の防止 | / NULLIF(..., 0) |
| デフォルト値 | COALESCE(..., 0) |
| 系列名の設定 | CONCAT(device, ' read') AS metric |
| ステータスの変換 | CASE WHEN value = 2 THEN 'Running' ... END |
| URL のクエリ文字列の除去 | SUBSTRING_INDEX(url, '?', 1) |
| 仮想ネットワークカードの除外 | NOT LIKE 'veth%' + NOT LIKE 'br-%' + != 'lo' |