Runtime Filter の動作原理とチューニング
Runtime Filter は、クエリ実行中に Doris が実行時データから動的に生成するフィルター条件です。スキャンするデータ量とネットワーク転送量を削減します。Doris は Join Runtime Filter(JRF) と TopN Runtime Filter の二種類をサポートします。
事前確認
- Doris の Join 実行フローと Scan ノードを理解しているか。
- Hash Join と Shuffle Join の実行方式を区別できるか。
EXPLAIN、EXPLAIN SHAPE PLAN、Profile の確認方法を知っているか。- 対象のケースが Join のフィルタリングと TopN の早期絞り込みのどちらに当たるかを把握しているか。
Join Runtime Filter
Join Runtime Filter(以下 JRF)は実行時の最適化技術です。Doris は Join ノードで右側テーブルのデータからフィルターを動的に生成し、左側テーブルの Scan にプッシュダウンして、Probe のデータ量、IO、ネットワーク転送量を削減します。
動作原理
以下では、TPC-H に似たスキーマの Join を使って JRF の仕組みを説明します。
データベースに次の二つのテーブルがあるとします。
- 注文テーブル(orders):100 million 行。注文番号
o_orderkey、顧客 IDo_custkeyなどを含みます。 - 顧客テーブル(customer):100,000 行。顧客 ID
c_custkey、顧客の国籍c_nationなどを含みます。国は全部で 25 か国あり、各国の顧客は約 4,000 人です。
中国の顧客による注文数を数えます。
select count(*)
from orders join customer on o_custkey = c_custkey
where c_nation = "china"
実行プランは基本的に Join になります。
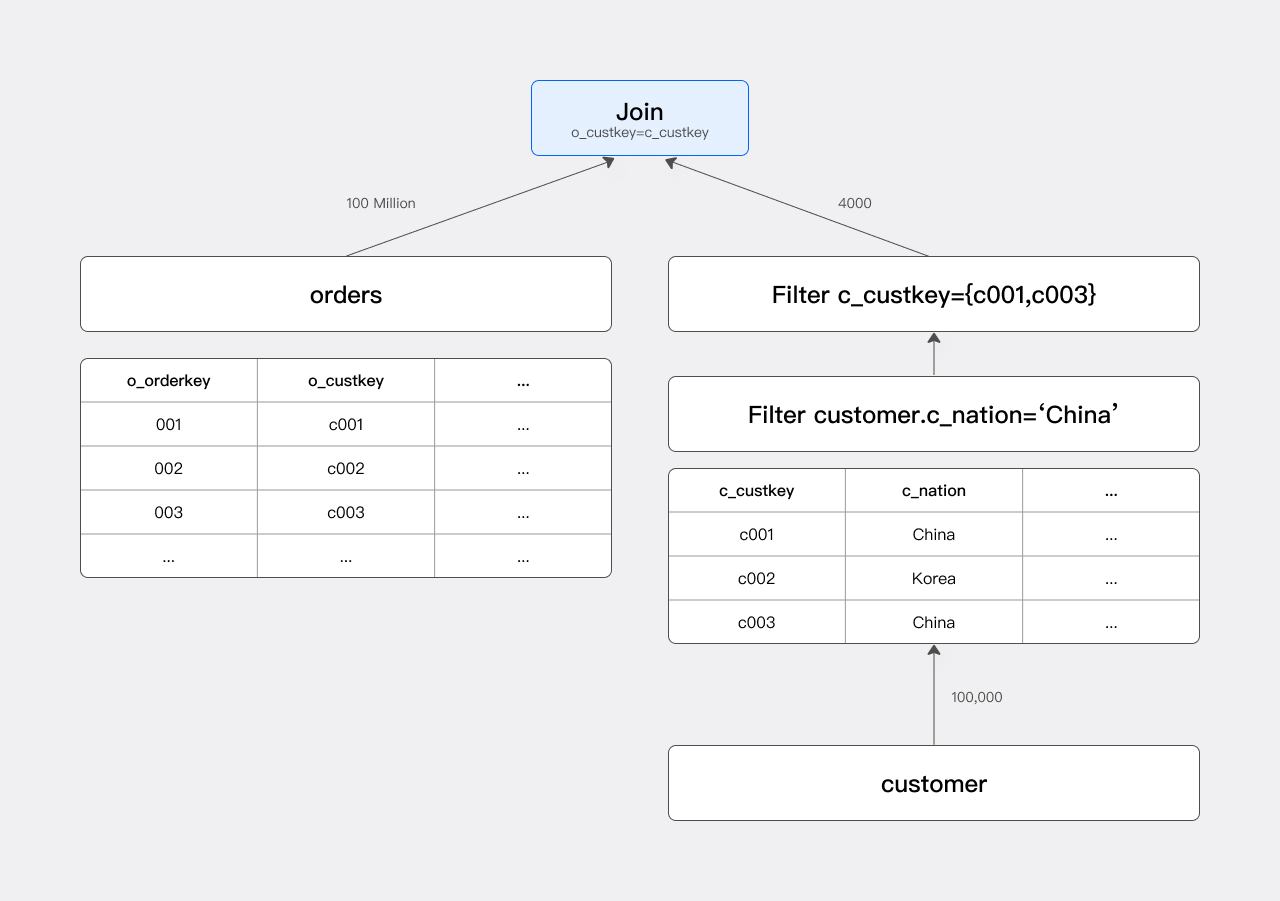
JRF がない場合、Scan ノードは注文テーブルの 100 million 行すべてをスキャンし、Join ノードがそれらに対して Hash Probe を実行して結果を生成します。
1. 最適化の考え方
フィルター条件 c_nation = "china" により、中国以外の顧客は除外されます。そのため、Join に参加する顧客は顧客テーブルの一部(約 1/25)だけです。Join 条件は o_custkey = c_custkey なので、フィルターを通過した c_custkey の値の集合だけを考えればよく、これを集合 A とします。
集合 A は、具体的には Join に参加する
c_custkeyの値の集合です。
集合 A を IN 条件として注文テーブルにプッシュダウンすると、Scan ノードは注文を事前にフィルタリングできます。これは c_custkey in (c001, c003) を追加することに相当します。
select count(*)
from orders join customer on o_custkey = c_custkey
where c_nation = "china" and o_custkey in (c001, c003)
最適化後の実行プランは次のとおりです。
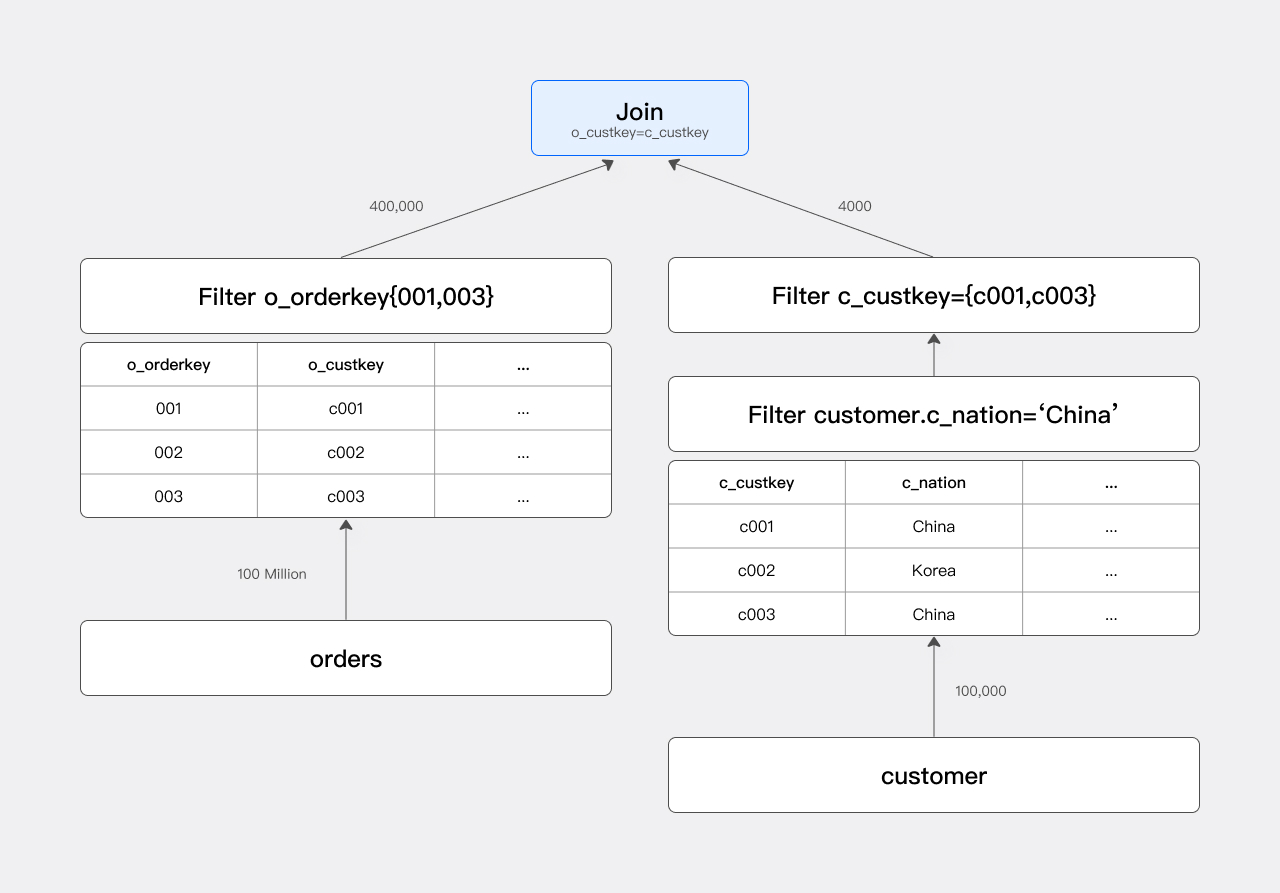
Join に参加する注文テーブルの行数が 100 million 行から 400,000 行に減り、クエリ速度が大幅に向上します。
2. 実装方法
オプティマイザーは静的解析時に集合 A の内容を知ることができません。そのため Doris は、Join ノードで右側のデータを収集した後、実行時に集合 A を生成し、注文テーブルの Scan ノードにプッシュダウンします。この JRF は通常、RF(c_custkey -> [o_custkey]) と表記します。
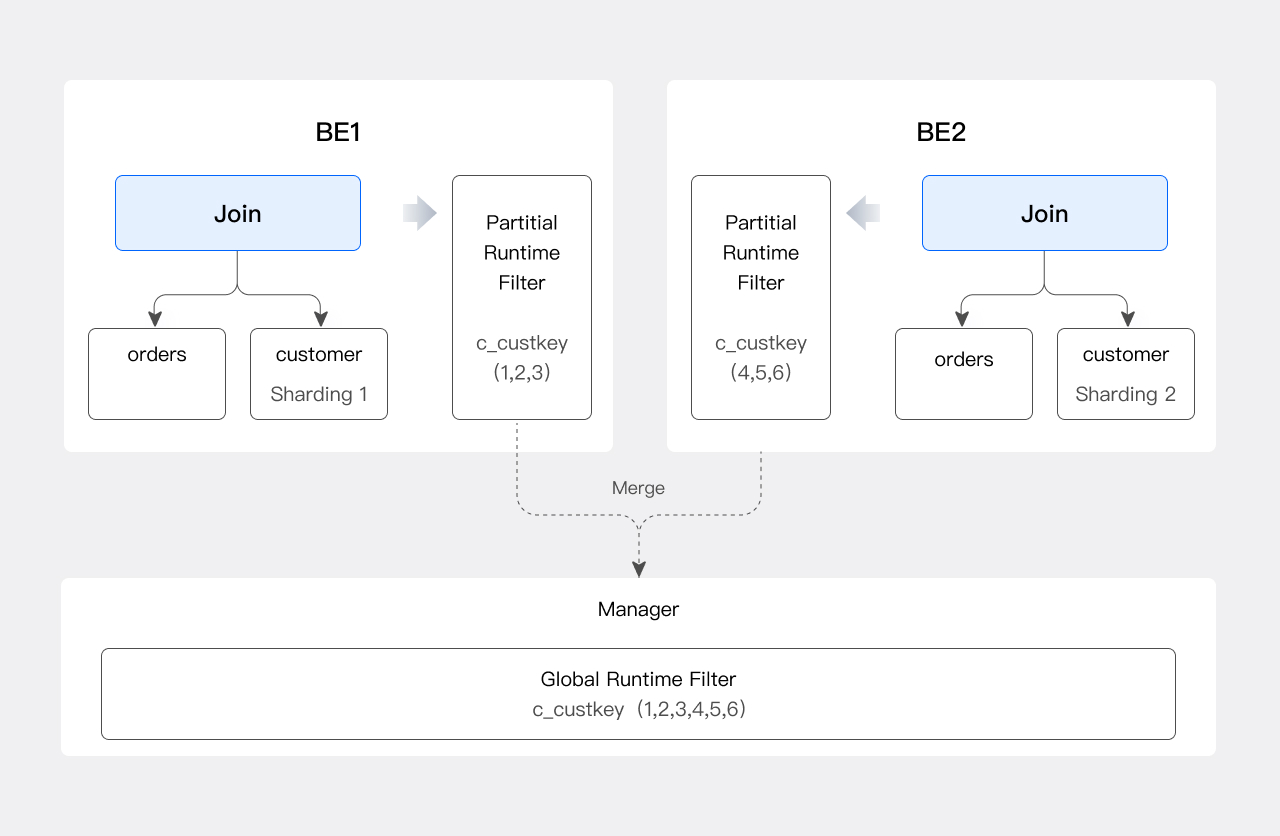
Doris は分散データベースなので、JRF のマージ処理も必要です。
| ステップ | 担当 | 処理 |
|---|---|---|
| 1 | 各 Join Instance | ローカルシャードの c_custkey に基づいて Partial JRF を生成 |
| 2 | Runtime Filter Manager(選択されたノード) | すべての Partial JRF を収集 |
| 3 | Manager | それらを Global JRF にマージ |
| 4 | Manager | Global JRF を orders の Scan Instance に配布 |
Global JRF の生成フローは次のとおりです。
フィルターの種類
JRF には複数の実装があり、生成、マージ、転送、適用にかかるコストが異なります。
| 種類 | 適用場面 | フィルタリングの精度 | コスト |
|---|---|---|---|
| In Filter | 集合 A の要素が少ない等価 Join | 正確 | 要素が多い場合、重複排除、転送、Probe のコストが高い |
| Bloom Filter | 集合 A の要素が多い等価 Join | 近似的(ハッシュ衝突がある) | 中程度。バケット数に左右される |
| Min-Max Filter | ソート済みデータ、または非等価 Join | 近似的 | 最も低い |
1. In Filter
JRF の最も単純な実装です。先ほどの例では、実行エンジンが左側テーブルに述語 o_custkey in (...list of elements in A...) を生成してフィルタリングします。集合 A が小さい場合は効率的です。
集合 A が大きい場合、In Filter には次の性能上の問題があります。
- 生成コストが高い:マージ時には各シャードから収集した
c_custkeyの値を重複排除する必要があります(c_custkeyが主キーでなければ重複する値が多数存在します)。これには時間がかかります。 - 転送コストが高い:Join ノードと Scan ノードの間で多数の要素を転送するにはコストがかかります。
- 実行コストが高い:Scan ノードで IN 述語を実行すること自体に時間がかかります。
これに対処するため、Doris は Bloom Filter を導入しています。
2. Bloom Filter
Bloom Filter は、ハッシュテーブルを複数重ね合わせたものと考えることができます。次の性質を利用してフィルタリングします。
- 集合 A からハッシュテーブル T を生成します。ある要素が T に存在しなければ、A にも存在しません。逆は成り立ちません。
- したがって、Bloom Filter によって除外された
o_orderkeyには、Join の右側に等しいc_custkeyが存在しないことが確実です。ただし、ハッシュ衝突により、一致しないo_custkeyの値がフィルターを通過することもあります。 - ハッシュバケットの数がフィルタリングの精度を決めます。バケットが多いほど精度は高くなりますが、生成、転送、計算のコストも増加します。
Bloom Filter のサイズは、フィルタリングの効果とコストのバランスを考えて設定する必要があります。次のパラメータで最小値と最大値を制限できます。
| パラメータ | 説明 |
|---|---|
RUNTIME_BLOOM_FILTER_MIN_SIZE | Bloom Filter の最小バイト数 |
RUNTIME_BLOOM_FILTER_MAX_SIZE | Bloom Filter の最大バイト数 |
3. Min/Max Filter
Min-Max Filter も近似的なフィルタリングに使用します。データ列がソートされている場合に効果的で、生成、マージ、適用のコストは In Filter や Bloom Filter よりはるかに低くなります。
非等価 Join では In Filter も Bloom Filter も機能しませんが、Min-Max Filter は有効です。
select count(*)
from orders join customer on o_custkey > c_custkey
where c_name = "China"
フィルタリング後の c_custkey の最大値を n として取り出し、orders の Scan ノードに渡します。Scan ノードは o_custkey > n を満たす行だけを出力します。
Join Runtime Filter の確認
JRF は次の三つの方法で確認できます。
| 方法 | コマンド | 説明 |
|---|---|---|
| テキスト形式の実行プラン | EXPLAIN | Join 側での生成と Scan 側での適用を確認 |
| 形状を示す実行プラン | EXPLAIN SHAPE PLAN | Nereids Planner が計画した RF を確認 |
| 実際の実行 Profile | SET enable_profile=true を実行してからクエリを実行 | 実際にフィルタリングされた行数と状態を確認 |
次の例は TPC-H スキーマに基づきます。
select count(*) from orders join customer on o_custkey=c_custkey;
1. EXPLAIN
JRF の情報は Join ノードと Scan ノードに分かれて表示されます。
4: VHASH JOIN(258)
| join op: INNER JOIN(PARTITIONED)[]
|  equal join conjunct: (o_custkey[#10] = c_custkey[#0])
|  runtime filters: RF000[bloom] <- c_custkey[#0] (150000000/134217728/16777216)
|  cardinality=1,500,000,000
|  vec output tuple id: 3
|  output tuple id: 3
|  vIntermediate tuple ids: 2
|  hash output slot ids: 10
|  final projections: o_custkey[#17]
|  final project output tuple id: 3
|  distribute expr lists: o_custkey[#10]
|  distribute expr lists: c_custkey[#0]
|
|---1: VEXCHANGE
|      offset: 0
|      distribute expr lists: c_custkey[#0]
3: VEXCHANGE
|  offset: 0
|  distribute expr lists:

PLAN FRAGMENT 2
| PARTITION: HASH_PARTITIONED: o_orderkey[#8]
| HAS_COLO_PLAN_NODE: false
| STREAM DATA SINK
|   EXCHANGE ID: 03
|   HASH_PARTITIONED: o_custkey[#10]

2: VOlapScanNode(242)
|  TABLE: regression_test_nereids_tpch_shape_sf1000_p0.orders(orders)
|  PREAGGREGATION: ON
|  runtime filters: RF000[bloom] -> o_custkey[#10]
|  partitions=1/1 (orders)
|  tablets=96/96, tabletList=54990,54992,54994 ...
|  cardinality=0, avgRowSize=0.0, numNodes=1
|  pushAggOp=NONE
主なフィールドの説明は次のとおりです。
- Join 側:
runtime filters: RF000[bloom] <- c_custkey[#0] (150000000/134217728/16777216)番号 000 の Bloom Filter が生成され、c_custkeyフィールドが入力に使われることを示します。括弧内の三つの数値は Bloom Filter のサイズ計算に関係しますが、ここでは無視してかまいません。 - Scan 側:
runtime filters: RF000[bloom] -> o_custkey[#10]RF000 が注文テーブルの Scan ノードに適用され、o_custkeyフィールドでフィルタリングすることを示します。
2. EXPLAIN SHAPE PLAN
mysql> explain shape plan select count(*) from orders join customer on o_custkey=c_custkey where c_nationkey=5;
+--------------------------------------------------------------------------------------------------------------------------+
Explain String(Nereids Planner)                                                                                            |
+--------------------------------------------------------------------------------------------------------------------------+
PhysicalResultSink                                                                                                         |
--hashAgg[GLOBAL]                                                                                                          |
----PhysicalDistribute[DistributionSpecGather]                                                                             |
------hashAgg[LOCAL]                                                                                                       |
--------PhysicalProject                                                                                                    |
----------hashJoin[INNER_JOIN shuffle]                                                                                     |
------------hashCondition=((orders.o_custkey=customer.c_custkey)) otherCondition=() buildRFs:RF0 c_custkey->[o_custkey]    |
--------------PhysicalProject                                                                                              |
----------------Physical0lapScan[orders] apply RFs: RF0                                                                    |
--------------PhysicalProject                                                                                              |
----------------filter((customer.c_nationkey=5))                                                                           |
------------------Physical0lapScan[customer]                                                                               |
+--------------------------------------------------------------------------------------------------------------------------+
11 rows in set (0.02 sec)
主なフィールドは次のとおりです。
- Join 側:
buildRFs: RF0 c_custkey -> [o_custkey]は、番号 0 の JRF がc_custkeyを入力として生成され、o_custkeyに適用されることを示します。 - Scan 側:
PhysicalOlapScan[orders] apply RFs: RF0は、注文テーブルが RF0 によってフィルタリングされることを示します。
3. Profile
実行中、BE は JRF の使用状況を Profile に出力します(set enable_profile=true が必要です)。
Join 側の Profile:
HASH_JOIN_SINK_OPERATOR  (id=3  ,  nereids_id=367):(ExecTime:  703.905us)
    -  JoinType:  INNER_JOIN
    ...
    -  BuildRows:  617
    ...
    -  RuntimeFilterComputeTime:  70.741us
    -  RuntimeFilterInitTime:  10.882us
この例では、入力行数 617 行に対して JRF の生成に 70.741us かかっています。JRF のサイズと種類は Scan 側に表示されます。
Scan 側の Profile:
OLAP_SCAN_OPERATOR  (id=2.  nereids_id=351.  table  name  =  orders(orders)):(ExecTime:  13.32ms)
              -  RuntimeFilters:  :  RuntimeFilter:  (id  =  0,  type  =  bloomfilter,  need_local_merge:  false,  is_broadcast:  true,  build_bf_cardinality:  false,
              ...
              -  RuntimeFilterInfo:
                  -  filter  id  =  0  filtered:  714.761K  (714761)
                  -  filter  id  =  0  input:  747.862K  (747862)
              ...
              -  WaitForRuntimeFilter:  6.317ms
            RuntimeFilter:  (id  =  0,  type  =  bloomfilter):
                  -  Info:  [IsPushDown  =  true,  RuntimeFilterState  =  READY,  HasRemoteTarget  =  false,  HasLocalTarget  =  true,  Ignored  =  false]
                  -  RealRuntimeFilterType:  bloomfilter
                  -  BloomFilterSize:  1024
次の情報に注目してください。
| 確認事項 | フィールド | 意味 |
|---|---|---|
| フィルタリングの効果 | filter id = 0 filtered / input | Filtered の値が大きいほど、フィルタリングの効果が高い |
| ストレージ層へのプッシュダウンの有無 | IsPushDown = true | プッシュダウン後は遅延マテリアライズが可能になり、IO を削減できる |
| フィルターが有効かどうか | RuntimeFilterState = READY | READY 以外の状態は、Scan が JRF を待たなかったことを示す |
| フィルターのサイズ | BloomFilterSize: 1024 | Bloom Filter のバイト数 |
チューニング
ほとんどの場合、JRF は適応的に動作するため、手動でのチューニングは不要です。調整が必要な場合は、次のセッション変数を使用できます。
| 変数 | デフォルト値 | 機能 |
|---|---|---|
runtime_filter_mode | GLOBAL | JRF を有効にするかどうか(GLOBAL で有効、OFF で無効) |
runtime_filter_type | バージョン 2.1 ではデフォルト値 12 | JRF の種類を表す列挙値の合計を制御 |
runtime_filter_wait_time_ms | 1000 | Scan が JRF を待つ最大時間(ミリ秒) |
enable_runtime_filter_prune | true | 選択性のない JRF を除去するかどうか |
runtime_filter_broadcast_join_producer_num | 3 | Broadcast Join で各 JRF を生成する BE の最大数。0 以下は無制限を意味する。バージョン 4.1.4 以降でサポート |
runtime_filter_tree_publish_max_send_bytes | 268435456 (256 MB) | Global JRF の配布時に一回の RPC で送信する最大バイト数。このしきい値を超えると、マージノードが大きなフィルターを各 Scan ノードに繰り返し送らずに済むよう、ツリー状の多段階配布を使用する。0 にするとツリー状の配布を無効にして直接配布に戻る。値は 0 以上でなければならない。バージョン 4.1.4 以降でサポート |
runtime_filter_broadcast_join_producer_num:Broadcast Join の JRF は、Build 側の各 BE によって同じ内容で生成・送信されます。この変数は実際に生成を行う BE の数を制限し(デフォルトは 3)、大規模クラスターでの RPC オーバーヘッドを大幅に削減します。Nereids の分散プランナーを使用する場合にのみ有効です。従来の Coordinator を使用する場合の動作は変わりません。runtime_filter_tree_publish_max_send_bytes:従来、大きな Global JRF はマージノードから各 Scan ノードへ直接配布され、サイズの大きい RPC 添付データが繰り返し送信されていました。ツリー状の配布ではフィルターを段階的に転送し、単一ノードへの帯域幅の負荷を軽減します。
1. JRF の有効化と無効化
- 有効化:
set runtime_filter_mode = GLOBAL - 無効化:
set runtime_filter_mode = OFF
2. JRF の種類の設定
runtime_filter_type は JRF の種類を表す列挙値を制御します。値を組み合わせて(加算して)、複数の種類を同時に生成できます。
| 種類 | 列挙値 |
|---|---|
IN | 1 |
BLOOM | 2 |
MIN_MAX | 4 |
IN_OR_BLOOM | 8 |
IN_OR_BLOOM を使用すると、BE は実際の行数に基づいて IN と BLOOM を適応的に選択できます。例:
set runtime_filter_type = 6:BLOOM と MIN_MAX を同時に生成します。- バージョン 2.1 のデフォルト値 12(4 + 8):MIN_MAX と IN_OR_BLOOM を同時に生成します。
3. 待機時間の設定
JRF はベストエフォート方式を使用します。Scan は開始前に JRF を待機し、Doris は待機時間を自動的に見積もります。場合によっては待機時間が不足して JRF が有効にならず、Scan の出力行数が予想より多くなります。
確認方法:Profile で Scan ノードに RuntimeFilterState = NOT_READY が表示されます。
操作:
- 目的:Scan が JRF を待つ時間を延長します。
- コマンド:
set runtime_filter_wait_time_ms = <milliseconds> - 説明:デフォルトは 1000 ミリ秒です。
4. JRF の除去
場合によっては JRF に選択性がありません。たとえば orders と customer に主キーと外部キーの関係があり、customer にフィルター条件がない場合、JRF への入力はすべての custkey 値となるため、orders を絞り込めません。オプティマイザーは列統計に基づいて有効性を判断し、それに応じて JRF を除去します。
- 目的:JRF の除去を有効または無効にします。
- コマンド:
set enable_runtime_filter_prune = true|false - 説明:デフォルトは
trueです。
TopN Runtime Filter
TopN Runtime Filter は、topN オペレーターの実行時に現在のヒープ先頭の値からフィルターを動的に生成し、Scan データを事前に絞り込みます。
動作原理
Doris はデータをチャンク単位のストリーミング方式で処理します。SQL に topN が含まれる場合、Doris はすべての結果を計算する代わりに、データを事前にフィルタリングする動的な Filter を生成します。
例:
select o_orderkey from orders order by o_orderdate limit 5;
実行プランは次のとおりです。
mysql> explain select o_orderkey from orders order by o_orderdate limit 5;
+-----------------------------------------------------+
| Explain String(Nereids Planner)                     |
+-----------------------------------------------------+
| PLAN FRAGMENT 0                                     |
|   OUTPUT EXPRS:                                     |
|     o_orderkey[#11]                                 |
|   PARTITION: UNPARTITIONED                          |
|                                                     |
|   HAS_COLO_PLAN_NODE: false                         |
|                                                     |
|   VRESULT SINK                                      |
|      MYSQL_PROTOCAL                                 |
|                                                     |
|   2:VMERGING-EXCHANGE                               |
|      offset: 0                                      |
|      limit: 5                                       |
|      final projections: o_orderkey[#9]              |
|      final project output tuple id: 2               |
|      distribute expr lists:                         |
|                                                     |
| PLAN FRAGMENT 1                                     |
|                                                     |
|   PARTITION: HASH_PARTITIONED: O_ORDERKEY[#0]       |
|                                                     |
|   HAS_COLO_PLAN_NODE: false                         |
|                                                     |
|   STREAM DATA SINK                                  |
|     EXCHANGE ID: 02                                 |
|     UNPARTITIONED                                   |
|                                                     |
|   1:VTOP-N(119)                                     |
|   |  order by: o_orderdate[#10] ASC                 |
|   |  TOPN OPT                                       |
|   |  offset: 0                                      |
|   |  limit: 5                                       |
|   |  distribute expr lists: O_ORDERKEY[#0]          |
|   |                                                 |
|   0:VOlapScanNode(113)                              |
|      TABLE: tpch.orders(orders), PREAGGREGATION: ON |
|      TOPN OPT:1                                     |
|      partitions=1/1 (orders)                        |
|      tablets=3/3, tabletList=135112,135114,135116   |
|      cardinality=150000, avgRowSize=0.0, numNodes=1 |
|      pushAggOp=NONE                                 |
+-----------------------------------------------------+
41 rows in set (0.06 sec)
実行フロー:
- TopN Filter がない場合、Scan はデータブロックを一つずつ読み取って TopN に渡し、TopN はヒープソートで現在の上位 5 件を保持します。
- データ Block には約 1024 行が含まれます。最初の Block を処理した時点で、その Block の 5 位の値がわかります。
- この値が
1995-01-01だとします。Scan が二番目の Block を出力する際、o_orderdate > 1995-01-01の行を TopN に送る必要はなくなります。 - しきい値は動的に更新されます。後続の Block により小さい
o_orderdateが含まれる場合、TopN はしきい値を更新します。
TopN Runtime Filter の確認
EXPLAIN を使用して、オプティマイザーが計画した TopN Runtime Filter を確認できます。
1:VTOP-N(119)
| order by: o_orderdate[#10] ASC
| TOPN OPT
| offset: 0
| limit: 5
| distribute expr lists: O_ORDERKEY[#0]
|

0:VLapScanNode[113]
    TABLE: regression_test_nereids_tpch_p0.(orders), PREAGGREGATION: ON
    TOPN OPT: 1
    partitions=1/1 (orders)
    tablets=3/3, tabletList=135112,135114,135116
    cardinality=150000, avgRowSize=0.0, numNodes=1
    pushAggOp: NONE
主なフィールドは次のとおりです。
- TopN ノード:
TOPN OPTが表示され、この TopN ノードが TopN Runtime Filter を生成することを示します。 - Scan ノード:使用する TopN Runtime Filter を生成した TopN ノードを示します。たとえば
TOPN OPT: 1は、orders の Scan が番号 1 の TopN ノードによって生成された Runtime Filter を使用することを示します。
Doris は分散データベースであるため、TopN と Scan の物理的な位置も考慮します。BE 間の通信コストは高いので、BE はフィルターを有効にするかどうかと、その適用範囲を適応的に決定します。現在の実装は BE 単位の TopN Runtime Filter です(TopN と Scan が同じ BE 内にあります)。スレッド間通信のみを使用するため、コストは低くなります。
チューニング
limit が小さいほど、TopN Runtime Filter による絞り込みは強くなります。デフォルトでは、limit がテーブルのデータ量の半分未満の場合にのみ有効になります。
| 変数 | 機能 |
|---|---|
topn_filter_ratio | TopN Runtime Filter を生成するかどうかを制御 |
たとえば、set topn_filter_ratio=0 を設定した後は、次のクエリで TopN Runtime Filter は生成されません。
select o_orderkey from orders order by o_orderdate limit 20;
Runtime Filter の種類の比較
| 比較項目 | Join Runtime Filter | TopN Runtime Filter |
|---|---|---|
| 適用されるクエリ | Join クエリ | ORDER BY ... LIMIT クエリ |
| 生成場所 | Join ノード | TopN ノード |
| プッシュダウン先 | 左側テーブルの Scan | 同じ BE 内の Scan |
| BE 間での使用 | 対応(Global JRF のマージ) | 非対応(同じ BE 内のみ) |
| 適応的な動作 | あり | あり |
FAQ / トラブルシューティング
Q1:JRF が有効にならず、Scan の出力行数が予想よりはるかに多い場合はどうすればよいですか?
Profile の RuntimeFilterState を確認してください。READY でなければ、Scan の待機がタイムアウトしています。runtime_filter_wait_time_ms を増やすことができます。
Q2:JRF は生成されているのに、Filtered の行数が少ないのはなぜですか?
JRF の入力に選択性がない可能性があります(たとえば、右側テーブルにフィルター条件がない主キーと外部キーの Join)。enable_runtime_filter_prune = true のままにしてオプティマイザーに自動的に除去させるか、右側テーブルに必要なフィルター条件が欠けていないか確認してください。
Q3:複数の種類の JRF を同時に生成するにはどうすればよいですか?
runtime_filter_type に対応する列挙値の合計を設定します。たとえば set runtime_filter_type = 6 は BLOOM と MIN_MAX を同時に生成します。
Q4:非等価 Join で JRF を使用できますか? Min-Max Filter を使用できます。In Filter と Bloom Filter は等価 Join のみをサポートします。
Q5:TopN Runtime Filter が生成されないのはなぜですか?
topn_filter_ratio を確認してください。0 の場合、フィルターは生成されません。デフォルトでは、limit がテーブルのデータ量の半分未満の場合にのみフィルターを生成します。limit を緩和するか、topn_filter_ratio を増やすと、生成されるようになる場合があります。
Q6:Bloom Filter のサイズを制御するにはどうすればよいですか?
RUNTIME_BLOOM_FILTER_MIN_SIZE と RUNTIME_BLOOM_FILTER_MAX_SIZE を使用して、最小および最大のバイト数を制限します。フィルタリングの精度とコストのバランスを考慮する必要があります。