インデックスの概要
Apache Doris は、複数の種類のインデックスを使ってクエリを高速化します。このページでは、インデックスを追加すべきかどうか、追加するならどれを選ぶかを判断できるよう、各インデックスの詳細ページへのリンクとともに説明します。
はじめに
すべてのテーブルには、Doris が自動的に構築・維持する次の二種類のインデックスがすでにあります。
- ソートキーに対する プレフィックスインデックス は、先頭の Key カラムへのフィルターを高速化します。最も頻繁にフィルターするカラムを先頭の Key カラムにすると、このインデックスを利用できます。
- すべてのカラムにある ZoneMap インデックス は、範囲条件または等価条件に合わないデータブロックをスキップします。
これらでクエリパターンに対応できない場合にのみ、手動でインデックスを追加します。
| クエリパターン | 推奨インデックス | 必要となる場面 |
|---|---|---|
| 最も頻繁にフィルターするカラムへの条件 | そのカラムを先頭の Key カラムにする(プレフィックスインデックス) | 最初に必ず設計する |
| Key 以外のカラムへの等価条件または範囲条件 | 転置インデックス | 多くの場合 |
テキストに対する LIKE 部分文字列検索 | NGram BloomFilter インデックス | 場合による |
| インデックスのサイズを柔軟性より重視する等価条件 | BloomFilter インデックス | まれ。通常は転置インデックスを推奨 |
| キーワード、フレーズ、複数フィールドの全文検索 | 転置インデックス | テキストを検索する場合 |
| ベクトル類似検索(Top-K 最近傍) | ベクトルインデックス(ANN) | RAG、セマンティック検索、レコメンド、メディア検索の場合 |
クエリが想定より遅い場合は、QueryProfile を使い、各インデックスがどれだけデータを絞り込んだか、処理にどれだけ時間がかかったかを確認します。詳しくは各インデックスのページを参照してください。
各インデックスの仕組み
Apache Doris には、クエリの種類に応じて ポイントクエリ用インデックス、スキップインデックス、全文検索用インデックス、ベクトルインデックス の四つのカテゴリーがあります。
シナリオ 1:条件に一致する行が少ない場合(ポイントクエリ用インデックス)
適用シナリオ:主キーによる検索やユーザー ID による詳細レコードの取得など、少量のデータを正確に特定する場合。
高速化の仕組み:インデックスが WHERE 条件を満たす行を直接特定し、その行だけを読み取るため、行ごとのスキャンを回避できます。
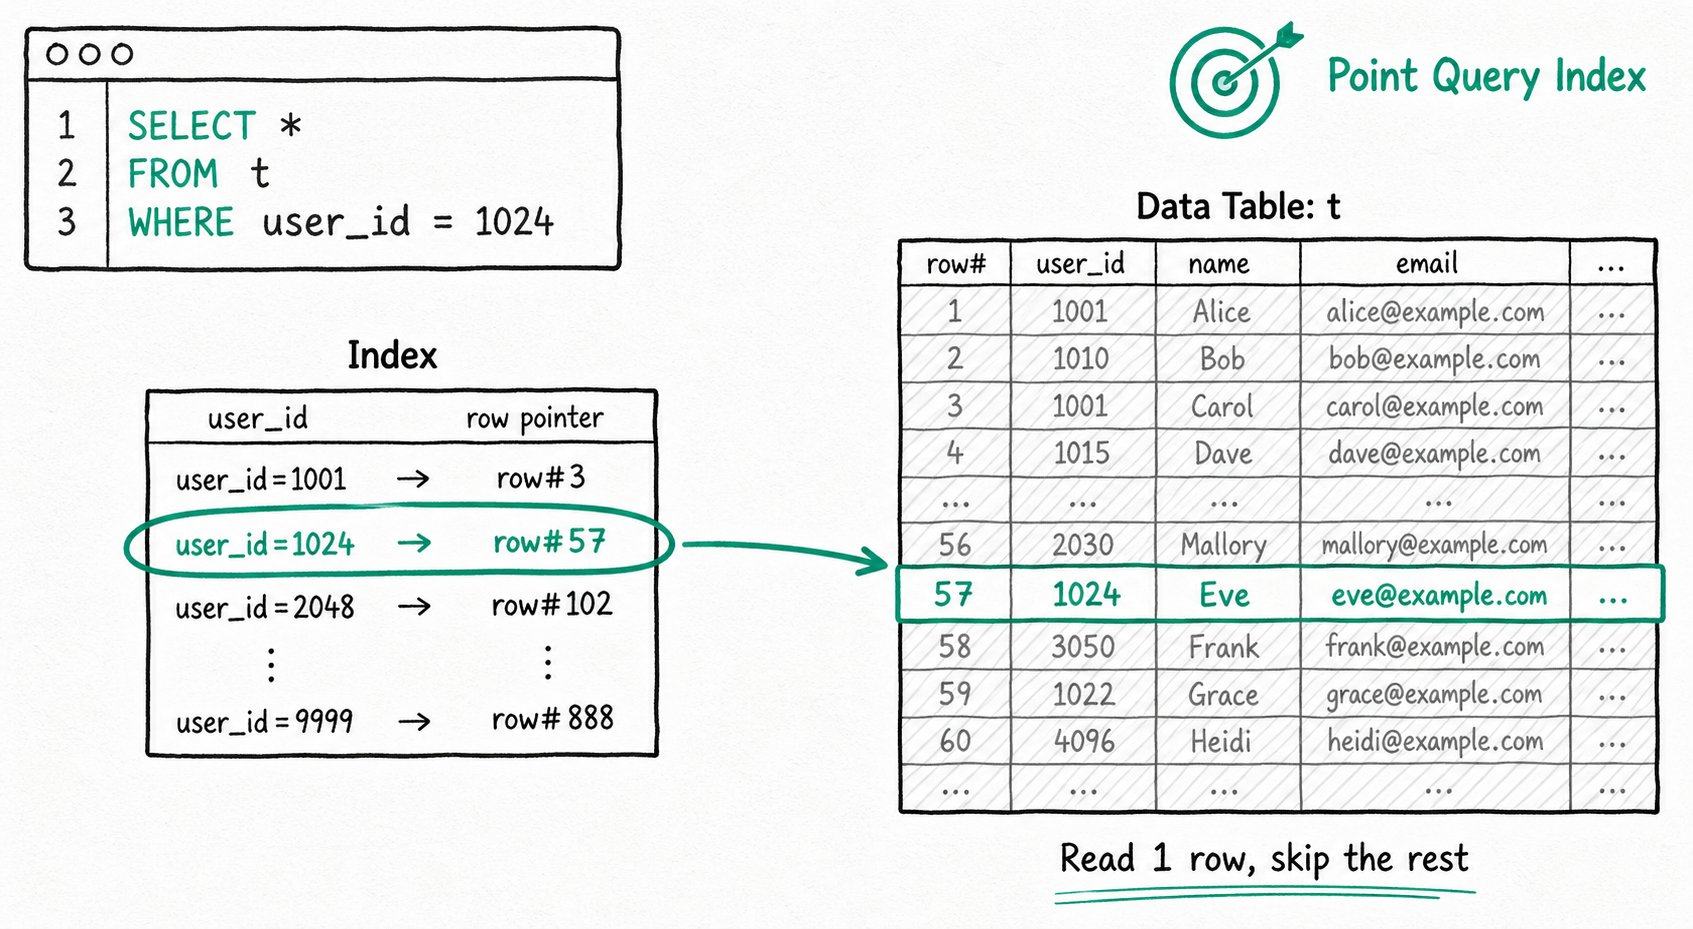
Apache Doris には、次の二種類のポイントクエリ用インデックスがあります。
- プレフィックスインデックス:Doris はソートキー順にデータを保存し、1024 行ごとに疎なプレフィックスインデックスを構築します。各インデックスエントリには、そのグループの最初の行のソートカラムの値が格納されます。クエリがソートカラムをフィルターする場合、Doris は該当するグループに移動して、そこからスキャンします。
- 転置インデックス:Doris は各値と、その値を含む行を対応付ける転置テーブルを構築します。等価条件のクエリでは、一致する行を検索してその行だけを読み取るため、全件スキャンを回避して I/O を削減できます。転置インデックスは範囲条件やテキストのキーワード検索も高速化します。アルゴリズムはより複雑ですが、基本的な考え方は同じです。
BITMAP インデックスは転置インデックスに置き換えられました。
シナリオ 2:条件に一致する行が多い場合(スキップインデックス)
適用シナリオ:時間範囲の集計やディメンションによるフィルタリングなど、大量のデータを対象とする分析クエリ。
高速化の仕組み:インデックスは WHERE 条件を満たさないデータブロックを特定してスキップし、条件を満たす可能性があるブロックだけを読み取ります。その後、行ごとにフィルターして最終結果を取得します。
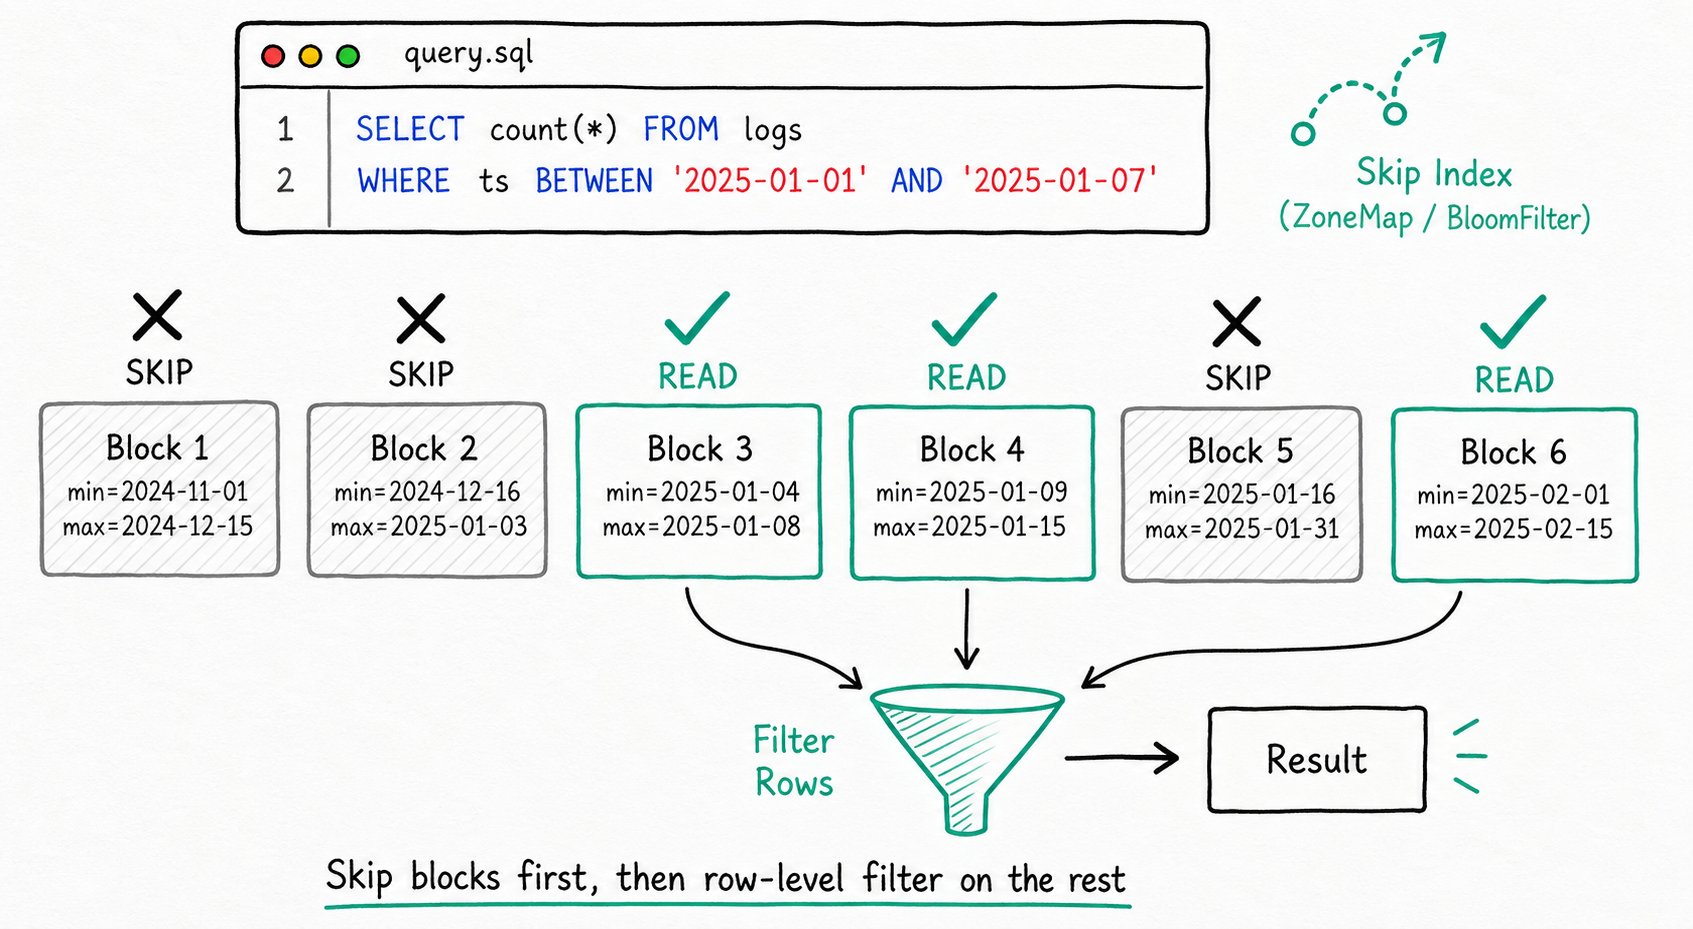
Apache Doris には、次の三種類のスキップインデックスがあります。
- ZoneMap インデックス:Doris は各データファイル(Segment)とデータブロック(Page)について、カラムごとの統計情報(最小値、最大値、NULL の有無)を自動的に保持します。等価条件、範囲条件、IS NULL 条件に対して、これらの統計情報からファイルやブロックに一致する行が含まれ得るかを判断します。含まれない場合はそのファイルやブロックをスキップし、I/O を削減します。
- BloomFilter インデックス:Doris はカラムの値を、少ない保存容量で値が存在するかを判定できる BloomFilter に格納します。等価条件のクエリで対象の値がフィルターに存在しない場合、Doris はそのファイルやブロックをスキップし、I/O を削減します。
- NGram BloomFilter インデックス:テキストに対する
LIKEクエリを高速化します。BloomFilter インデックスと同様に動作しますが、値全体の代わりにテキストの NGram トークンを格納します。LIKEクエリでは、Doris がパターンを同じ方法でトークン化し、各トークンをフィルターと照合します。いずれかのトークンが存在しなければ、そのファイルやブロックは一致しないためスキップします。
シナリオ 3:テキストの全文検索(転置インデックス)
適用シナリオ:ログ分析、コンテンツ検索、サポートチケットの分析など、キーワード、フレーズ、パターンによってテキストフィールド内のデータを検索する場合。
高速化の仕組み:トークナイザーがテキストを語に分割し、各語と対応する行番号を結び付ける転置テーブルを構築します。クエリ時には検索語を同じ方法でトークン化し、その語を含む行番号の集合を転置テーブルから取得して AND/OR/NOT の関係に従って統合します。その後、一致する行を直接読み取ります。これにより、元のテキストを行ごとにスキャンして正規表現で照合する処理を回避できます。
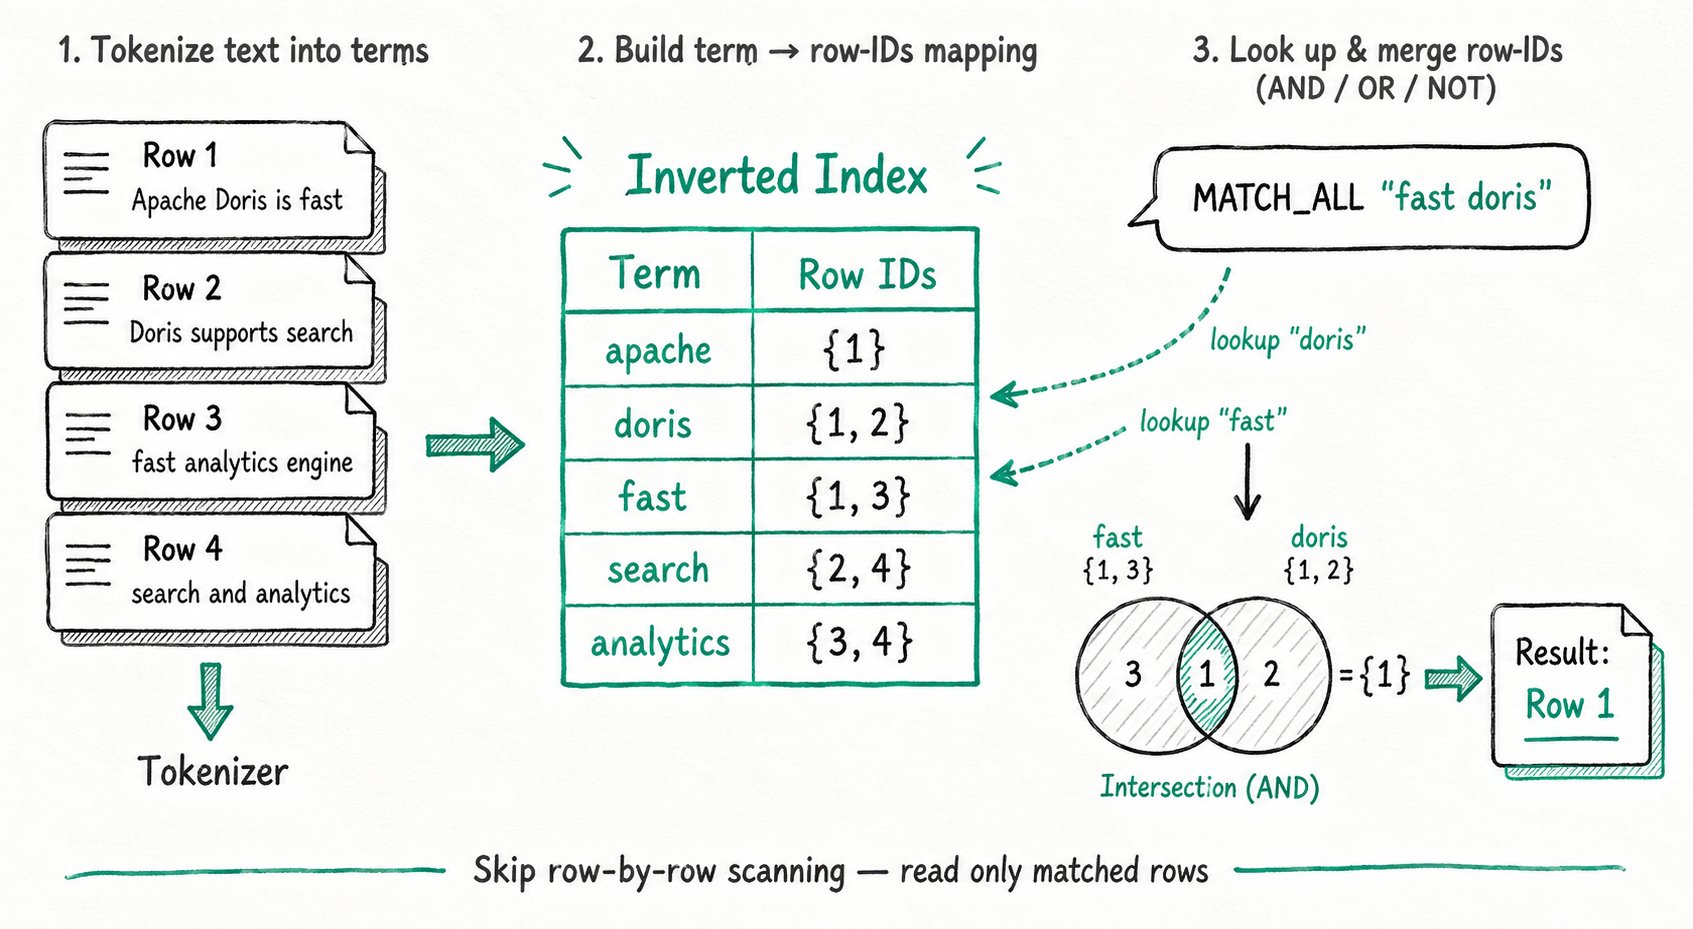
詳しい使い方は転置インデックスを参照してください。Apache Doris の転置インデックスは、次の機能をサポートします。
- キーワード検索:
MATCH_ANY(いずれかの語が一致)とMATCH_ALL(すべての語が一致)。 - フレーズ検索:
MATCH_PHRASEは語順を考慮し、単語間の距離slopを設定できるフレーズ検索をサポートします。MATCH_PHRASE_PREFIXはフレーズと最後の語のプレフィックスを組み合わせた検索を、MATCH_REGEXPはトークン化した語に対する正規表現検索をサポートします。 - 多言語のトークン化:
english、chinese、unicode、icu、basic、ikなどの組み込みトークナイザーがあり、中国語、英語、混在テキスト、多言語の用途に対応します。 - 複数カラムを組み合わせた検索:
multi_match関数を使用して、複数のフィールドを対象に OR/AND/フレーズ/プレフィックス検索を実行できます。 - 通常のフィルターとの組み合わせ:等価条件、範囲条件、
INなどの条件や、ほかのインデックスと AND/OR/NOT で自由に組み合わせ、同じ転置インデックスを使ってクエリを処理できます。
シナリオ 4:ベクトル類似検索(ベクトルインデックス)
適用シナリオ:ベクトルの類似度に基づいて Top-K 最近傍を見つける、または距離のしきい値でフィルターする必要がある RAG(検索拡張生成)、セマンティック検索、レコメンドシステム、画像・音声・動画の検索。
高速化の仕組み:従来の方法では、クエリベクトルとすべてのレコードとの距離を計算するため、コストがデータ量に比例して増加します。ベクトルインデックス(ANN、Approximate Nearest Neighbor)は、ベクトル集合に対してグラフ(HNSW など)またはクラスタリング(IVF など)の構造を事前に構築し、検索範囲を少数の候補ベクトルに絞ります。制御可能な精度低下と引き換えに、桁違いの高速化を実現します。
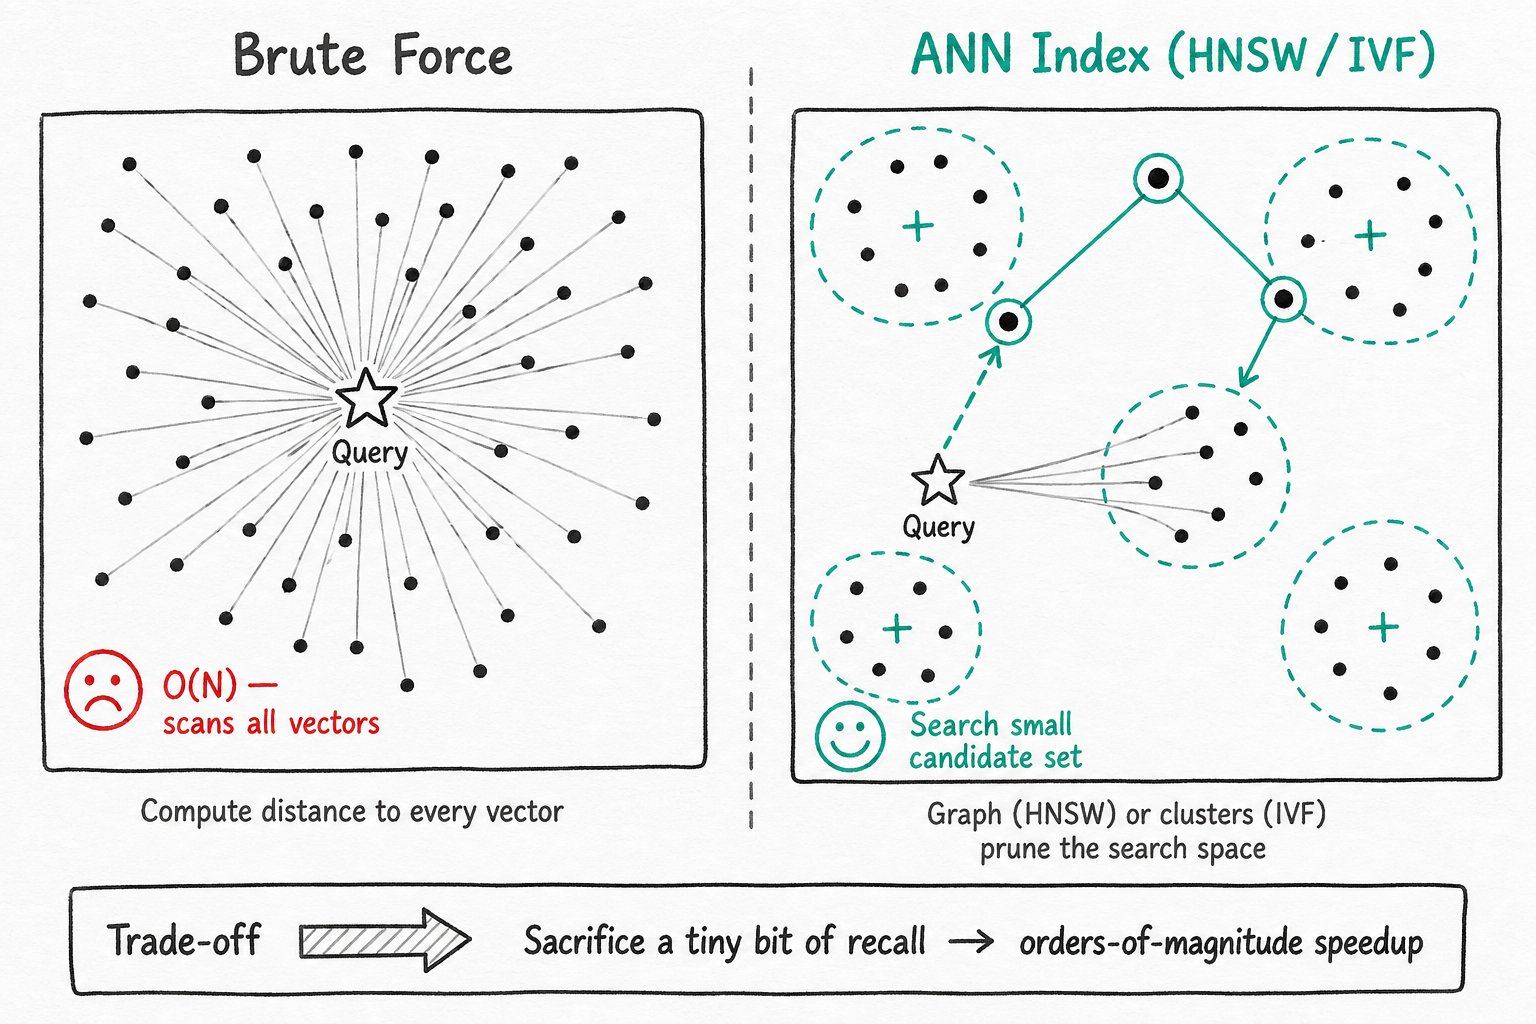
詳しい使い方はベクトルインデックスを参照してください。Apache Doris はバージョン 4.0 から ANN インデックスをサポートしています。主な機能は次のとおりです。
- 複数のインデックスアルゴリズム:
hnsw、ivf、ivf_on_diskをサポートし、それぞれメモリ上での高 QPS、メモリに制約がある場合、ディスク上の超大規模データに適しています。 - 複数の距離尺度:
l2_distance(ユークリッド距離)とinner_product(内積)をサポートします。ベクトルに L2 正規化を適用すると、コサイン類似度と同等の計算ができます。 - TopN/範囲/複合クエリ:
l2_distance_approximateとinner_product_approximateを使って ANN TopN を実行できます。また、距離のしきい値に基づく範囲検索や、同じ SQL 文で TopN と範囲条件を組み合わせるクエリもサポートします。 - スカラーフィルターとのハイブリッド検索:転置インデックスなどのセカンダリインデックスと連携します。構造化された条件(
MATCH_ANY 'music'など)で候補集合を先に絞り込み、その集合に対して ANN TopN を実行することで、フィルター条件付きのベクトル検索ができます。 - ベクトル量子化:
flat、sq8、sq4、pqなどの量子化方式をサポートし、再現率とメモリ・ディスク使用量のバランスを調整できます。
インデックスの管理方法
ユーザーによる手動管理が必要かどうかによって、Apache Doris のインデックスは次の二種類に分かれます。
| 管理方法 | インデックスの種類 | 説明 |
|---|---|---|
| 自動で維持 | プレフィックスインデックス、ZoneMap インデックス | Apache Doris に組み込まれたインデックスで、ユーザーによる管理は不要 |
| 手動で作成 | 転置インデックス、BloomFilter インデックス、NGram BloomFilter インデックス、ベクトルインデックス | クエリの種類に応じてユーザーが選び、手動で作成または削除する |
インデックスの特性比較
インデックスをすばやく選べるよう、各種類の長所と制約を次の表にまとめます。
| カテゴリー | インデックス | 長所 | 制約 |
|---|---|---|---|
| ポイントクエリ用インデックス | プレフィックスインデックス | 最高の性能を持つ組み込みインデックス | 各テーブルに設定できるプレフィックスインデックスは一組のみ |
| ポイントクエリ/全文検索 | 転置インデックス | トークン化とキーワード照合をサポートし、任意のカラムに構築できる。複数条件を組み合わせられ、関数による高速化の対応範囲も拡大し続けている | インデックスの保存容量が大きく、元データと同程度 |
| スキップインデックス | ZoneMap インデックス | 保存容量の小さい組み込みインデックス | 対応するクエリの種類が少なく、等価条件と範囲条件のみ |
| スキップインデックス | BloomFilter インデックス | ZoneMap より細かい単位で判定でき、保存容量は中程度 | 対応するクエリの種類が少なく、等価条件のみ |
| スキップインデックス | NGram BloomFilter インデックス | LIKE クエリを高速化し、保存容量は中程度 | 対応するクエリの種類が少なく、LIKE の高速化のみ |
| ベクトルインデックス | ANN インデックス | ベクトル類似度による TopN/範囲/複合検索をサポートし、スカラーフィルターと連携できる。複数の量子化方式で再現率とリソース使用量のバランスを調整できる | NOT NULL の Array<Float> カラムにのみ適用可能。DUPLICATE KEY テーブルモデル、およびマージオンライトが有効な UNIQUE KEY テーブルモデルをサポート(後者はバージョン 4.1.4 以降) |
演算子と関数に対するインデックスの対応状況
次の表は、一般的な演算子と関数に対して各インデックスが高速化をサポートするかどうかを示します。
| 演算子/関数 | プレフィックスインデックス | 転置インデックス | ZoneMap インデックス | BloomFilter インデックス | NGram BloomFilter インデックス |
|---|---|---|---|---|---|
= | 対応 | 対応 | 対応 | 対応 | 非対応 |
!= | 対応 | 対応 | 非対応 | 非対応 | 非対応 |
IN | 対応 | 対応 | 対応 | 対応 | 非対応 |
NOT IN | 対応 | 対応 | 非対応 | 非対応 | 非対応 |
>, >=, <, <=, BETWEEN | 対応 | 対応 | 対応 | 非対応 | 非対応 |
IS NULL | 対応 | 対応 | 対応 | 非対応 | 非対応 |
IS NOT NULL | 対応 | 対応 | 非対応 | 非対応 | 非対応 |
LIKE | 非対応 | 非対応 | 非対応 | 非対応 | 対応 |
MATCH, MATCH_* | 非対応 | 対応 | 非対応 | 非対応 | 非対応 |
array_contains | 非対応 | 対応 | 非対応 | 非対応 | 非対応 |
array_overlaps | 非対応 | 対応 | 非対応 | 非対応 | 非対応 |
is_ip_address_in_range | 非対応 | 対応 | 非対応 | 非対応 | 非対応 |
インデックス設計の原則
データベーステーブルのインデックス設計とチューニングは、データの特性やクエリパターンと密接に関係します。実際のユースケースに合わせたテストと調整が必要です。万能な方法はありませんが、Apache Doris ではインデックスをより簡単に利用できるよう改善を続けています。設計時は「はじめに」の選択表を参考に、インデックスを選んでテストしてください。