IVF: Apache Doris の IVF インデックスによるベクトル検索の高速化
概要:IVF(Inverted File Index)は、クラスタリングによってベクトル空間を分割し、検索範囲を絞り込む近似最近傍(ANN)インデックスです。Apache Doris 4.x 以降でネイティブにサポートされています。
この記事では、次の疑問に答えます。
- IVF インデックスとは何か。なぜベクトル検索を高速化できるのか。
- Apache Doris で IVF インデックスを作成、構築、削除するにはどうすればよいか。
nlistやnprobeなどの主要パラメータをどう選び、再現率と性能のバランスを取るか。- 再現率に影響する要因は何か。性能低下をどう防ぐか。
クイックナビゲーション
| 目的 | 参照先 |
|---|---|
| IVF の基本原理を理解する | IVF インデックスとは |
| IVF インデックスを作成して使用する | Apache Doris で IVF を使用する |
| 再現率を調整する | 再現率の最適化 |
| クエリ性能の問題を調べる | クエリ性能 |
| 性能ベンチマークを再現する | ベンチマーク |
| よくある質問を確認する | よくある質問 |
IVF インデックスとは
転置インデックスからベクトルの転置インデックスへ
IVF(Inverted File)という用語は情報検索の分野に由来します。テキスト検索を例に説明します。
-
順方向インデックス:各文書が単語のリストを保持します。クエリではすべての文書を走査する必要があります。
文書 単語 文書 1 the, cow, says, moo 文書 2 the, cat, and, the, hat 文書 3 the, dish, ran, away, with, the, spoon -
転置インデックス:各単語が「その単語を含む文書」のリストを保持します。クエリでは関連するリストだけを走査します。
単語 文書 the 文書 1, 文書 3, 文書 4, 文書 5, 文書 7 cow 文書 2, 文書 3, 文書 4 says 文書 5 moo 文書 7
現在、テキストはベクトル埋め込みで表現されることが一般的です。IVF は転置インデックスの考え方を取り入れます。クラスタの重心を「辞書」とし、各重心が「そのクラスタに属するベクトル」のリストを保持します。クエリでは選択された少数のクラスタだけを調べます。
IVF がベクトル検索を高速化する理由
データセットが数百万から数十億のベクトルに増えると、厳密な kNN 検索(クエリベクトルとデータベース内の全ベクトルとの距離を計算すること)は大規模な行列乗算に相当し、計算コストが許容できなくなります。
近似最近傍(ANN)探索は、精度をわずかに犠牲にすることで桁違いの高速化を実現します。IVF は実務で広く使用される有効な ANN 手法の一つです。中心となる考え方は 「分割統治」 です。
- ベクトルデータセット全体を複数のクラスタに分割し、それぞれを 重心 で表します。
- クエリ時には、まず重心がクエリベクトルに最も近い少数のクラスタを特定し、その中だけを検索して残りのデータをスキップします。
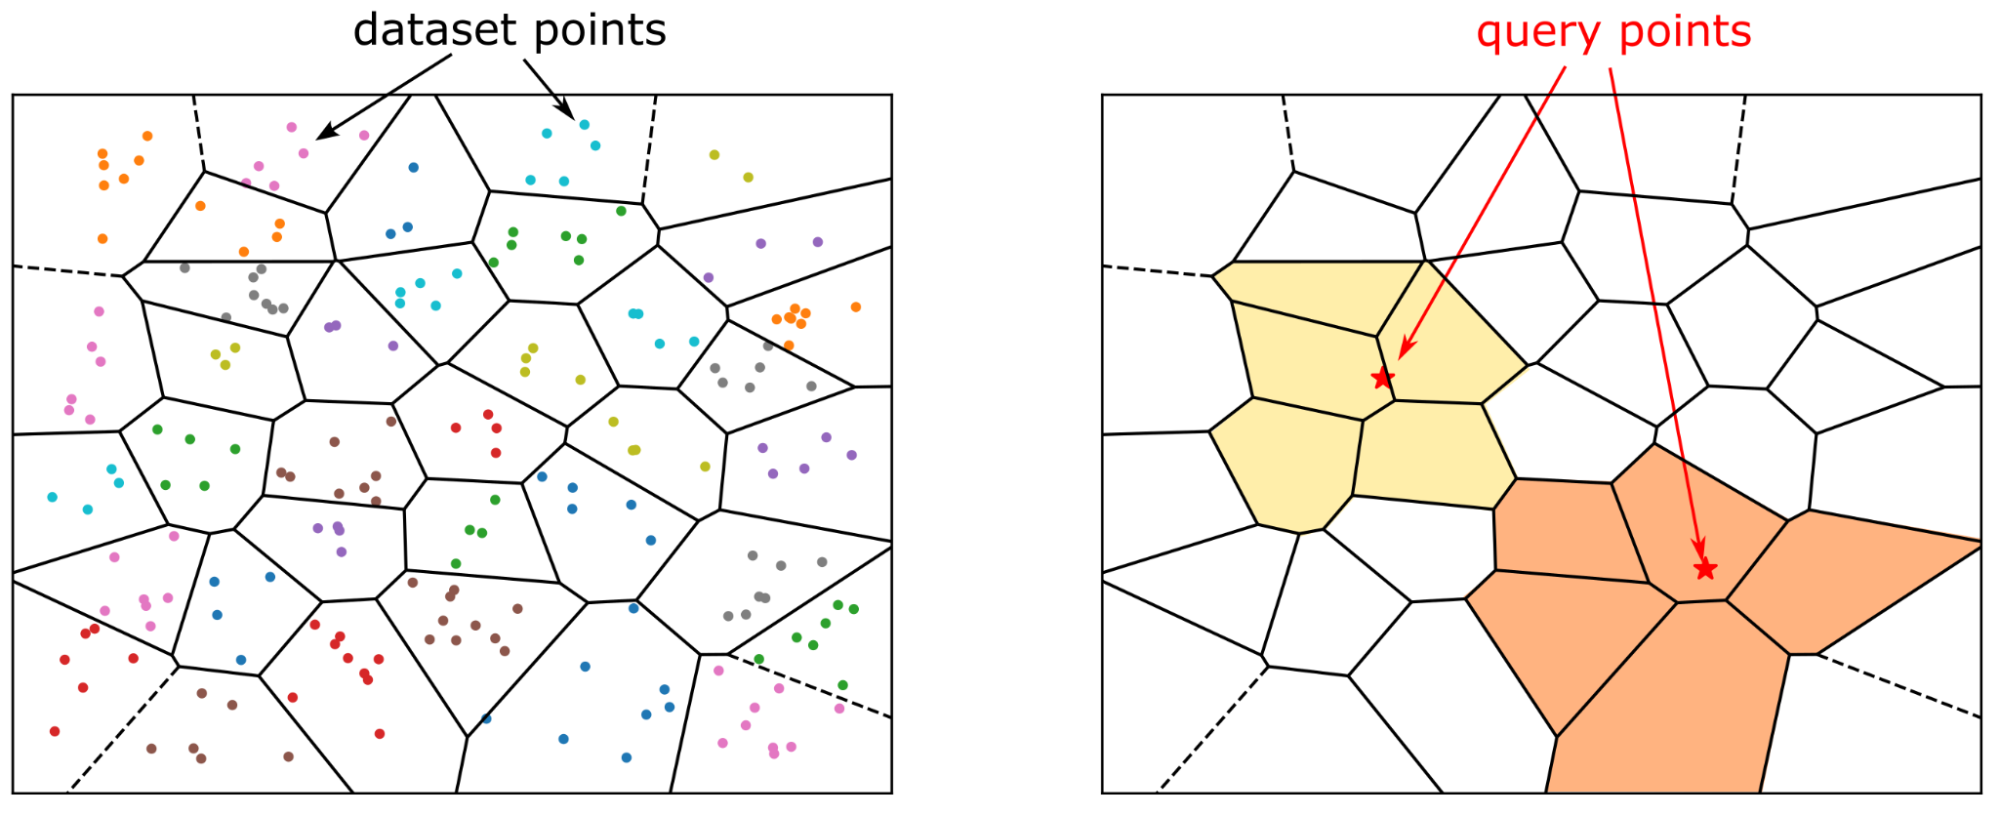
Apache Doris で IVF を使用する
Apache Doris はバージョン 4.x 以降、IVF ベースの ANN インデックスをサポートしています。インデックスの種類は ANN に固定され、index_type=ivf を指定すると IVF アルゴリズムが選択されます。
インデックスの構築方法
ANN インデックスの作成方法には、用途に応じて次の二つがあります。
| 方法 | 構築のタイミング | 利点 | 欠点 | 適した場面 |
|---|---|---|---|---|
| テーブル作成時にインデックスを定義 | データ取り込み時に同期的に構築 | データを書き込むとすぐにクエリを高速化できる | 書き込みが遅くなる。Compaction によってインデックスが再構築され、リソースを浪費する場合がある | インデックスパラメータがすでに確定している本番環境 |
CREATE INDEX + BUILD INDEX | データのロード後に非同期で構築 | データ取り込みに影響せず、パラメータ調整に便利 | 構築中は高速化されない | パラメータ調整段階、非常に大きなテーブルの初期化 |
方法 1:テーブル作成時にインデックスを定義する
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="ivf",
      "metric_type"="l2_distance",
      "dim"="128",
      "nlist"="1024"
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");
方法 2:CREATE INDEX + BUILD INDEX
ステップ 1:インデックスなしでテーブルを作成し、データをロードします。
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT ""
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");
ステップ 2:CREATE INDEX を実行してインデックス定義を追加します。この時点ではインデックスのメタデータが登録されるだけで、既存データ上にインデックスはまだ構築されていません。
CREATE INDEX idx_test_ann ON sift_1M (`embedding`) USING ANN PROPERTIES (
  "index_type"="ivf",
  "metric_type"="l2_distance",
  "dim"="128",
  "nlist"="1024"
);

SHOW DATA ALL FROM sift_1M;
想定される出力(LocalIndexSize はまだ 0):
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 10           | 1000000  | 170.093 MB     | 170.093 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
|           | Total     | 10           |          | 170.093 MB     | 170.093 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
ステップ 3:BUILD INDEX を実行して既存データ上にインデックスを構築します。このタスクは非同期で実行されます。
BUILD INDEX idx_test_ann ON sift_1M;
ステップ 4:SHOW BUILD INDEX でタスクの状態を確認します。
SHOW BUILD INDEX WHERE TableName = "sift_1M";
タスクの完了後、データサイズを再確認します。インデックスのサイズ(LocalIndexSize)が表示されます。
+---------------+-----------+---------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| JobId         | TableName | PartitionName | AlterInvertedIndexes                                                                                                                                | CreateTime              | FinishTime              | TransactionId | State    | Msg  | Progress |
+---------------+-----------+---------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| 1764392359610 | sift_1M   | sift_1M       | [ADD INDEX idx_test_ann (`embedding`) USING ANN PROPERTIES("dim" = "128", "index_type" = "ivf", "metric_type" = "l2_distance", "nlist" = "1024")],  | 2025-12-01 14:18:22.360 | 2025-12-01 14:18:27.885 | 5036          | FINISHED |      | NULL     |
+---------------+-----------+---------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+

mysql> SHOW DATA ALL FROM sift_1M;
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 10           | 1000000  | 671.084 MB     | 170.093 MB    | 500.991 MB     | 0.000           | 0.000          | 0.000           |
|           | Total     | 10           |          | 671.084 MB     | 170.093 MB    | 500.991 MB     | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
インデックスの削除
パラメータ調整中は、再現率を確保するために複数のパラメータの組み合わせを試すことがよくあります。DROP INDEX を使用すると、インデックスを柔軟に管理できます。
ALTER TABLE sift_1M DROP INDEX idx_test_ann;
ベクトルクエリの実行
ANN インデックスは TopN 検索 と 範囲検索 の両方を高速化します。
本番環境でのベストプラクティス:高次元ベクトルを文字列で表現すると SQL の解析時に余分な負荷がかかるため、高並行性が求められる場面では生の SQL を直接使用することは推奨されません。次の二つの方法を推奨します。
- Prepare Statement を使用して SQL を事前に解析します。
- Doris ベクトル検索の公式 Python ライブラリを使用します。このライブラリは Prepare Statement の呼び出しをラップし、クエリ結果を pandas DataFrame に直接変換するため、AI アプリケーションの開発に便利です。
コード例:
from doris_vector_search import DorisVectorClient, AuthOptions

auth = AuthOptions(
    host="127.0.0.1",
    query_port=9030,
    user="root",
    password="",
)

client = DorisVectorClient(database="test", auth_options=auth)

tbl = client.open_table("sift_1M")

query = [0.1] * 128  # Example 128-dimensional vector

# SELECT id FROM sift_1M ORDER BY l2_distance_approximate(embedding, query) LIMIT 10;
result = tbl.search(query, metric_type="l2_distance").limit(10).select(["id"]).to_pandas()

print(result)
想定される出力:
       id
0  123911
1  926855
2  123739
3   73311
4  124493
5  153178
6  126138
7  123740
8  125741
9  124048
再現率の最適化
ベクトル検索の中心的な指標は再現率です。再現率が許容範囲にある場合にのみ、性能の数値に意味があります。 再現率に影響する主な要因は次のとおりです。
- IVF インデックスのパラメータ(
nlist)とクエリのパラメータ(nprobe) - インデックス内のベクトル量子化
- Segment のサイズと数
このセクションでは 1 と 3 を説明します。ベクトル量子化については別のドキュメントで説明します。
インデックスのハイパーパラメータ:nlist と nprobe
IVF では、インデックス構築時とクエリ時に次の主要パラメータを使用します。
インデックス構築時:
- クラスタリング:k-means などのクラスタリングアルゴリズムを使用してベクトルを
nlist個のクラスタに分割し、各クラスタの重心を計算して保存します。 - ベクトルの割り当て:各ベクトルを最も近い重心を持つクラスタに割り当て、対応する転置リストに追加します。
クエリ時:
- クラスタの選択:クエリベクトルと
nlist個すべての重心との距離を計算し、最も近いnprobe個のクラスタを選びます。 - クラスタ内の全探索:選択した
nprobe個のクラスタ内のベクトルを一つずつ比較し、最近傍を見つけます。
| パラメータ | 用途 | 影響 | Doris のデフォルト値 |
|---|---|---|---|
nlist | クラスタ(転置リスト)の数 | 値を大きくすると分割が細かくなり検索は速くなる一方、クラスタリングのコストが増え、近傍ベクトルが異なるクラスタに分散しやすくなる | 1024 |
nprobe | クエリ時に探索するクラスタの数 | 値を大きくすると再現率とレイテンシーが上がる。値を小さくすると速くなるが、結果を見落としやすくなる | 64 |
SIFT_1M データセットでの測定結果:
| nlist | nprobe | recall@100 |
|---|---|---|
| 1024 | 64 | 0.9542 |
| 1024 | 32 | 0.9034 |
| 1024 | 16 | 0.8299 |
| 1024 | 8 | 0.7337 |
| 512 | 32 | 0.9384 |
| 512 | 16 | 0.8763 |
| 512 | 8 | 0.7869 |
実際のハイパーパラメータの選び方
最適なパラメータを事前に正確に決めることはできませんが、次の手順で体系的に選べます。
- 2~3 個のベクトルカラムを持つ、インデックスなしの一時テーブル
table_multi_indexを作成します。 - Stream Load などの方法でこのテーブルにデータをロードします。
- 各ベクトルカラムに対し、異なるパラメータで
CREATE INDEXとBUILD INDEXを実行します。 - 各カラムの再現率を比較し、最も適したパラメータの組み合わせを選びます。
例:
ALTER TABLE tbl DROP INDEX idx_embedding;
CREATE INDEX idx_embedding ON tbl (`embedding`) USING ANN PROPERTIES (
  "index_type"="ivf",
  "metric_type"="inner_product",
  "dim"="768",
  "nlist"="1024"
);
BUILD INDEX idx_embedding ON tbl;
インデックスがカバーできる行数
Doris の内部テーブルのデータは、次の階層で構成されます。
- Table から Tablet:バケットキーに従って、N 個の Tablet に均等に分散されます。Tablet はデータ移行と再バランスの基本単位です。
- Tablet から Rowset:ロードまたは Compaction のたびに、新しい Rowset が追加されます。Rowset はバージョン管理の単位です。
- Rowset から Segment:実データは Segment ファイルに保存されます。
ベクトルインデックスは転置インデックスと同様に、Segment 単位で機能します。Segment のサイズは BE の設定項目 write_buffer_size と vertical_compaction_max_segment_size によって制御されます。ロードまたは Compaction 中に memtable が一定のサイズに達すると Segment ファイルにフラッシュされ、その Segment に対してベクトルインデックスが構築されます(インデックス対象のカラムが複数あれば、複数のインデックスが作られます)。
IVF インデックスの各パラメータの組み合わせが有効にカバーできるデータ量には限りがあります。Segment 内の行数がしきい値を超えると、再現率が低下します。
ヒント:
SHOW TABLETS FROM <table>でテーブルの Compaction の状態を確認できます。対応する URL を開くと、Segment の数を確認できます。
Compaction が再現率に与える影響
Compaction は複数の小さな Segment をより大きな Segment にマージします。そのため、小さいデータサイズに合わせて調整したインデックスパラメータが有効でなくなり、再現率が低下します。
ベストプラクティス:BUILD INDEX を実行する前に FULL COMPACTION をトリガーします。完全にマージされた Segment 上にインデックスを構築すると、次の二つの利点があります。
- 再現率が安定します。
- インデックス構築による書き込み増幅を抑えられます。
クエリ性能
インデックスファイルのコールドロード
Doris の ANN インデックスは、Meta が公開しているオープンソースの faiss を基盤として実装されています。IVF インデックスでクエリを高速化するには、インデックス全体をメモリにロードする必要があります。
ベストプラクティス:高並行性のクエリを実行する前にコールドクエリを実行し、関連するすべての Segment インデックスファイルがロードされたことを確認します。そうしないと、最初のクエリの性能が大きく低下します。
メモリ使用量と性能
量子化による圧縮を行わない IVF インデックスは、対象ベクトルの約 1.02 倍のメモリを使用します。
たとえば、128 次元、1M 行のデータセットに対する IVF FLAT インデックスのメモリ使用量は、およそ次のとおりです。
128 * 4 * 1,000,000 * 1.02 ≈ 500 MB
参考値:
| 次元数 | 行数 | 推定メモリ使用量 |
|---|---|---|
| 128 | 1M | 500 MB |
| 768 | 1M | 2.9 GB |
クエリ性能を確保するには、BE にインデックス全体を保持できる十分なメモリが必要です。そうでない場合、インデックスファイルへの頻繁な IO によってクエリ性能が大幅に低下します。
ベンチマーク
デプロイに関する推奨事項:ベンチマークでは本番環境を模した構成を使用します。FE と BE を別々にデプロイし、クライアントは別のマシンで実行します。
テストフレームワーク:VectorDBBench。
Performance768D1M
ベンチマークコマンド:
# load
NUM_PER_BATCH=1000000 python3 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --stream-load-rows-per-batch 500000 --index-prop index_type=ivf,nlist=1024 --skip-search-serial --skip-search-concurrent

# search
NUM_PER_BATCH=1000000 python3 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --search-concurrent --search-serial --num-concurrency 10,40,80 --stream-load-rows-per-batch 500000 --index-prop index_type=ivf,nlist=1024 --session-var ivf_nprobe=64 --skip-load --skip-drop-old
よくある質問
Q1:IVF と HNSW はどう使い分ければよいですか? IVF は、十分なメモリがあり、構築コストとクエリのレイテンシーのバランスを取る必要がある大規模な用途に適しています。HNSW はクエリのレイテンシーで有利ですが、メモリ使用量はより多くなります。詳しくは HNSW のドキュメントを参照してください。
Q2:BUILD INDEX の後も再現率が低いのはなぜですか?
主な原因として、nprobe の設定値が低すぎる、Segment が大きすぎてインデックスで十分にカバーできない、BUILD の前に FULL COMPACTION を実行していない、などがあります。再現率の最適化を参照してください。
Q3:高並行性のクエリの前にコールドクエリを実行するのはなぜですか? IVF インデックスでクエリを高速化するには、インデックス全体をメモリにロードする必要があります。コールドクエリでディスクからメモリにインデックスをロードしてキャッシュをウォームアップすると、最初のオンラインクエリでの性能低下を防げます。
Q4:nlist のデフォルト値 1024 は調整する必要がありますか?
Doris のデフォルト値は nlist=1024 と nprobe=64 で、多くの中規模データセットに適しています。実際のデータサイズと再現率の要件に応じて、実際のハイパーパラメータの選び方に従って調整してください。
Q5:DROP INDEX を実行するとメモリはすぐに解放されますか?
DROP INDEX はインデックス定義を削除し、その後インデックスファイルがクリーンアップされます。パラメータ調整中は、CREATE INDEX および BUILD INDEX のワークフローと組み合わせて使用してください。
トラブルシューティング
| 症状 | 考えられる原因 | 対処方法 |
|---|---|---|
| 再現率が想定より大幅に低い | nprobe が低すぎる/Segment が大きすぎる/FULL COMPACTION が実行されていない | nprobe を増やす。BUILD の前に FULL COMPACTION を実行する。nlist を調整する |
| 最初のクエリのレイテンシーが非常に高く、後続のクエリは正常 | インデックスがまだメモリにロードされていない(コールドロード) | 高並行性のクエリの前にコールドクエリを実行してウォームアップする |
| BE のメモリが不足し、クエリ性能が低下する | インデックス全体をメモリに保持できず、頻繁な IO が発生する | BE のメモリを増やす。メモリ使用量を減らすため、量子化による圧縮を検討する |
BUILD INDEX が長時間完了しない | タスクが非同期で、データ量が多い | SHOW BUILD INDEX WHERE TableName = "<tbl>" で進捗を確認する |
| データ取り込みが遅くなる | テーブル作成時にインデックスが同期的に構築される | CREATE INDEX + BUILD INDEX の方法に切り替え、非同期で構築する |