ベクトル検索
Apache Doris はバージョン 4.0 から、ANN(Approximate Nearest Neighbor、近似最近傍)ベクトル検索をネイティブでサポートしています。Faiss を基盤とする HNSW および IVF インデックスにより、数十億件のベクトルに対してミリ秒単位の TopN 検索と範囲検索を実現します。
適用シナリオ
ベクトル検索は、RAG(Retrieval-Augmented Generation、検索拡張生成)とマルチモーダル検索の中核となる機能です。代表的な用途は次のとおりです。
- RAG 検索:大規模なナレッジベースからユーザーの質問に最も関連する上位 K 件のテキストを取得し、LLM による生成の根拠として使用します。これにより、ハルシネーションや知識の陳腐化による問題を軽減できます。
- マルチモーダル検索:画像、音声、動画などのデータをベクトル化し、意味的な類似性で検索します。たとえば医療分野の質疑応答では、症例記録や文献を検索し、診断の提案を支援できます。
- 推薦システム:範囲検索で「似ているが同一ではない」候補コンテンツを取得し、推薦の多様性を高めます。
- 異常検知:通常のパターンから外れるデータ点を特定します。
ベクトル検索では、クエリと文書を同じ方式で意味ベクトルに変換し、大量のベクトルの中からクエリに最も類似する K 個のベクトルを探します。
クイックナビゲーション
| 目的 | 参照先 |
|---|---|
| ベクトルインデックスの作成方法を知る | 近似最近傍探索 |
| コサイン類似度による検索を実装する | コサイン類似度の使用 |
| 距離のしきい値で絞り込む | 近似範囲検索 |
| TopN と範囲条件を組み合わせる | 複合検索 |
| ANN 検索の前に他の列で絞り込む | フィルター付き ANN 検索 |
| クエリ動作のパラメーターを調整する | クエリパラメーター |
| メモリ使用量とインデックスサイズを削減する | ベクトル量子化 |
| QPS を向上させ、レイテンシーを削減する | 性能チューニング |
| Python SDK を使用する | Python SDK |
| 使用上の制限を確認する | 使用上の制限 |
近似最近傍探索
Doris では新しいデータ型は導入されていません。ベクトルは固定長の Array<Float> として保存され、距離に基づく検索には Faiss ベースの ANN インデックスタイプを使用します。
テーブル作成例
一般的な SIFT データセットを例にします。
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="flat"
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
主要なパラメーターの意味は次のとおりです。
index_type:インデックスアルゴリズムです。hnsw(Hierarchical Navigable Small World)、ivf(転置ファイルインデックス)、ivf_on_disk(転置リストをディスクに書き込み、キャッシュ経由で提供する IVF の派生方式)から選択します。metric_type:距離の尺度です。l2_distanceは距離関数として L2 距離を使用します。dim:ベクトルの次元数です。128は、この列の各ベクトルの長さが 128 であることを示します。quantizer:エンコード方式です。flatは各次元を元の float32 値のまま保存します。
インデックスパラメーター一覧
| パラメーター | 必須 | 指定可能な値 | デフォルト | 説明 |
|---|---|---|---|---|
index_type | はい | hnsw, ivf, ivf_on_disk | (なし) | ANN インデックスのアルゴリズムを指定します。現在、HNSW、メモリ内 IVF、IVF On-Disk をサポートしています。 |
metric_type | はい | l2_distance, inner_product | (なし) | ベクトルの類似度または距離の尺度を指定します。l2_distance はユークリッド距離です。inner_product はコサイン類似度を使う場合にも利用できますが、ベクトルを事前に正規化する必要があります。 |
dim | はい | 正の整数(> 0) | (なし) | ベクトルの次元数を指定します。後で読み込むすべてのベクトルも同じ次元数でなければならず、異なる場合はエラーになります。 |
nlist | いいえ | 正の整数 | 1024 | IVF の転置バケット数です。index_type=ivf または ivf_on_disk の場合に有効です。値を大きくすると通常は再現率と速度のバランスが改善しますが、構築コストも増加します。 |
max_degree | いいえ | 正の整数 | 32 | HNSW グラフにおけるノードごとの隣接ノードの最大数(M)です。インデックスのメモリ使用量と検索性能に影響します。 |
ef_construction | いいえ | 正の整数 | 40 | HNSW 構築時の候補キューのサイズ(efConstruction)です。値を大きくするとグラフの品質が上がる一方、構築時間は長くなります。 |
quantizer | いいえ | flat, sq8, sq4, pq | flat | ベクトルのエンコード・量子化方式です。flat は元の値を保存します。sq8 / sq4 はスカラー量子化(8 / 4 ビット)、pq は積量子化です。 |
pq_m | quantizer=pq の場合は必須 | 正の整数 | (なし) | 元の高次元ベクトルを分割するサブベクトルの数です。dim は pq_m で割り切れる必要があります。 |
pq_nbits | quantizer=pq の場合は必須 | 正の整数 | (なし) | 各サブベクトルの量子化に使うビット数で、部分空間のコードブックのサイズ(k = 2 ^ pq_nbits)を決めます。Faiss では通常 24 以下であることが求められます。 |
データの読み込み
S3 TVF を使用して SIFT データセットを読み込みます。
INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");

select count(*) from sift_1M
--------------

+----------+
| count(*) |
+----------+
|  1000000 |
+----------+
クエリ例
l2_distance_approximate / inner_product_approximate を呼び出すと、ANN インデックスを使用する処理経路が選択されます。
呼び出し時のルール:
- 関数名はインデックスの
metric_typeと正確に対応させる必要があります。metric_type=l2_distance→l2_distance_approximateを使用metric_type=inner_product→inner_product_approximateを使用
- ソート順:
- L2 距離は昇順です(
ORDER BY dist ASC。値が小さいほど近い)。 - 内積は降順です(
ORDER BY dist DESC。値が大きいほど近い)。
- L2 距離は昇順です(
SELECT id,
       l2_distance_approximate(
        embedding,
        [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]
       ) AS distance
FROM sift_1M
ORDER BY distance
LIMIT 10;
--------------

+--------+----------+
| id     | distance |
+--------+----------+
| 178811 | 210.1595 |
| 177646 | 217.0161 |
| 181997 | 218.5406 |
| 181605 | 219.2989 |
| 821938 | 221.7228 |
| 807785 | 226.7135 |
| 716433 | 227.3148 |
| 358802 | 230.7314 |
| 803100 | 230.9112 |
| 866737 | 231.6441 |
+--------+----------+
10 rows in set (0.02 sec)
厳密な結果と比較するには、l2_distance / inner_product(_approximate 接尾辞なし)を使用します。この例では厳密検索に約 290 ms かかりますが、ANN インデックスを使うとクエリのレイテンシーは約 290 ms から約 20 ms に短縮されます。
10 rows in set (0.29 sec)
実行の仕組み
ANN インデックスはセグメント単位で構築されます。分散テーブルでは、次のように動作します。
- 各セグメントがローカルの TopN 結果を返します。
- TopN オペレーターがタブレットとセグメントをまたいで結果を統合し、グローバルな TopN を生成します。
コサイン類似度の使用
Doris の ANN インデックスの metric_type は現在、l2_distance と inner_product のみをサポートしており、cosine は直接サポートしていません。コサイン類似度を使う場合は、正規化によって内積と等価な計算に変換できます。
手順
- 書き込み前:ベクトルを L2 正規化します(単位長にします)。
- インデックス作成時:
metric_type="inner_product"を使用します。 - クエリ時:
inner_product_approximate(...)を使用し、ORDER BY ... DESCで降順に並べます。
例:
CREATE INDEX idx_emb_cosine ON your_table (embedding) USING ANN PROPERTIES (
  "index_type"="hnsw",
  "metric_type"="inner_product",
  "dim"="768"
);
等価になる理由
- コサイン類似度の式:
cos(x, y) = (x · y) / (||x|| ||y||) - ベクトルを L2 正規化した場合(
||x|| = ||y|| = 1):cos(x, y) = x · y
したがって、単位ベクトル空間では、コサイン類似度を最大化することと内積を最大化することは等価です。正規化しない場合、内積とコサイン類似度は等価ではありません。
近似範囲検索
TopN 最近傍探索のほかに、ベクトル検索でよく使われるクエリとして距離のしきい値に基づく範囲検索があります。このクエリは固定件数の行を返すのではなく、対象ベクトルとの距離が条件を満たすデータ点をすべて探します。
代表的な用途:
- 推薦システムでは、「近いが同一ではない」コンテンツを取得して多様性を高めます。
- 異常検知では、通常のパターンから外れるデータ点を特定します。
例:対象ベクトルとの L2 距離が 300 を超える行を数えます。
SELECT count(*)
FROM   sift_1M
WHERE  l2_distance_approximate(
        embedding,
        [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2])
        > 300
--------------

+----------+
| count(*) |
+----------+
|   999271 |
+----------+
1 row in set (0.19 sec)
範囲検索も ANN インデックスによって高速化されます。システムはまず候補ベクトル集合をすばやく絞り込み、次に近似距離を精密に計算することで、処理負荷を大幅に削減します。現在サポートされる範囲条件は >、>=、<、<= です。
複合検索
複合検索では、同じ SQL 文の中で ANN TopN と範囲フィルタリングの両方を行い、範囲条件を満たす上位 N 件を返します。
SELECT id,
       l2_distance_approximate(
        embedding, [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]) as dist
FROM sift_1M
WHERE l2_distance_approximate(
        embedding, [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2])
        > 300
ORDER BY dist limit 10
--------------

+--------+----------+
| id     | dist     |
+--------+----------+
| 243590 |  300.005 |
| 549298 | 300.0317 |
| 429685 | 300.0533 |
| 690172 | 300.0916 |
| 123410 | 300.1333 |
| 232540 | 300.1649 |
| 547696 | 300.2066 |
| 855437 | 300.2782 |
| 589017 | 300.3048 |
| 930696 | 300.3381 |
+--------+----------+
10 rows in set (0.12 sec)
事前フィルタリングと事後フィルタリング
| 戦略 | 処理順 | 利点 | 欠点 |
|---|---|---|---|
| 事前フィルタリング(Doris が使用) | 先に述語を適用し、残った集合から TopN を取得する | 再現率が高い | 比較的遅い |
| 事後フィルタリング | 先に TopN を取得してから絞り込む | 速い | 再現率が大幅に低下する可能性がある |
Doris では、複合検索の両段階をインデックスで高速化できます。ただし、最初の範囲フィルターの選択性が高い場合など、両段階でインデックスを使用すると再現率が低下することがあります。Doris は述語の選択性とインデックスの種類に基づき、両段階でインデックスを使用するかどうかを適応的に判断します。
フィルター付き ANN 検索
フィルター付き ANN 検索では、ANN TopN の実行前に他の述語を適用し、条件を満たす上位 N 件を返します。
次の 8 次元の例は、ハイブリッド検索の処理を示します。
CREATE TABLE ann_with_fulltext (
  id int NOT NULL,
  embedding array<float> NOT NULL,
  comment String NOT NULL,
  value int NULL,
  INDEX idx_comment(`comment`) USING INVERTED PROPERTIES("parser" = "english") COMMENT 'inverted index for comment',
  INDEX ann_embedding(`embedding`) USING ANN PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY (`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES("replication_num"="1");

INSERT INTO ann_with_fulltext VALUES
(1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music', 10),
(2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today',   20),
(3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend',  30),
(4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update',40)
ユーザーのクエリベクトルを [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4] とします。comment に "music" を含む文書の中から、最も類似する上位 2 件を取得します。
SELECT id, comment,
       l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
FROM ann_with_fulltext
WHERE comment MATCH_ANY 'music'       -- Filter using the inverted index first
ORDER BY dist ASC                     -- Then perform ANN TopN over the filtered result set
LIMIT 2;

+------+---------------------+----------+
| id   | comment             | dist     |
+------+---------------------+----------+
|    1 | this is about music | 0.663325 |
|    3 | latest music trend  | 1.280625 |
+------+---------------------+----------+
2 rows in set (0.04 sec)
フィルター付き ANN 検索でベクトルインデックスによる TopN の高速化を利用するには、フィルターに使用する列に転置インデックスなどのセカンダリインデックスが必要です。
クエリパラメーター
HNSW インデックス構築時に指定するパラメーターに加え、クエリ実行時にもセッション変数で動作を調整できます。
| セッション変数 | デフォルト | 説明 |
|---|---|---|
hnsw_ef_search | 32 | HNSW インデックスの EF 検索パラメーターです。検索中の候補キューの最大長を制御します。値を大きくすると精度が上がる一方、レイテンシーも増加します。 |
hnsw_check_relative_distance | true | HNSW 検索の精度を高めるため、相対距離のチェック機構を有効にするかどうかを指定します。 |
hnsw_bounded_queue | true | HNSW 検索の性能を最適化するため、長さに上限のある優先度付きキューを使うかどうかを指定します。 |
ベクトル量子化
FLAT エンコードでは、HNSW インデックス(元のベクトルとグラフ構造)が大量のメモリを消費する場合があります。HNSW が動作するには全体をメモリ上に保持する必要があるため、非常に大きなデータセットではボトルネックになりやすくなります。
Doris は次の二種類の量子化方式を提供します。
| 量子化方式 | 仕組み | Doris でのサポート |
|---|---|---|
| スカラー量子化(SQ) | 各 FLOAT32 次元を圧縮し、メモリ使用量を削減する | sq8(INT8)、sq4(INT4) |
| 積量子化(PQ) | 高次元ベクトルを分割し、各サブベクトルを個別に量子化する | pq |
スカラー量子化(SQ)の例
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="sq8"    -- Use INT8 for quantization
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
768 次元の Cohere-MEDIUM-1M および Cohere-LARGE-10M データセットを使ったテストでは、SQ8 によりインデックスサイズが FLAT の約 1/3 に圧縮されました。
量子化方式の比較
| データセット | ベクトル次元数 | 保存・インデックス方式 | ディスク使用量の合計 | データ部分 | インデックス部分 | 備考 |
|---|---|---|---|---|---|---|
| Cohere-MEDIUM-1M | 768D | Doris(FLAT) | 5.647 GB (2.533 + 3.114) | 2.533 GB | 3.114 GB | 1M ベクトル、元データと HNSW FLAT インデックス |
| Cohere-MEDIUM-1M | 768D | Doris SQ INT8 | 3.501 GB (2.533 + 0.992) | 2.533 GB | 0.992 GB | INT8 対称量子化 |
| Cohere-MEDIUM-1M | 768D | Doris PQ (pq_m=384, pq_nbits=8) | 3.149 GB (2.535 + 0.614) | 2.535 GB | 0.614 GB | 積量子化 |
| Cohere-LARGE-10M | 768D | Doris(FLAT) | 56.472 GB (25.328 + 31.145) | 25.328 GB | 31.145 GB | 10M ベクトル |
| Cohere-LARGE-10M | 768D | Doris SQ INT8 | 35.016 GB (25.329 + 9.687) | 25.329 GB | 9.687 GB | INT8 量子化。インデックスが大幅に小さくなる |
積量子化(PQ)
Doris は積量子化もサポートしますが、PQ を使用するには追加のパラメーターが必要です。
pq_m:元の高次元ベクトルを分割するサブベクトルの数です。ベクトルの次元数dimはpq_mで割り切れる必要があります。pq_nbits:各サブベクトルの量子化に使うビット数で、部分空間のコードブックのサイズを決めます。Faiss では通常 24 以下であることが求められます。
PQ 量子化では、学習時にクラスタ中心の数以上の学習データ点が必要です。つまり、学習データ点数 n >= 2 ^ pq_nbits を満たす必要があります。
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="pq",    -- Use PQ for quantization
      "pq_m"="2",          -- Required when using PQ. Number of low-dim sub-vectors the high-dim vector is split into
      "pq_nbits"="2"       -- Required when using PQ. Number of bits per subspace codebook
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
量子化のコスト
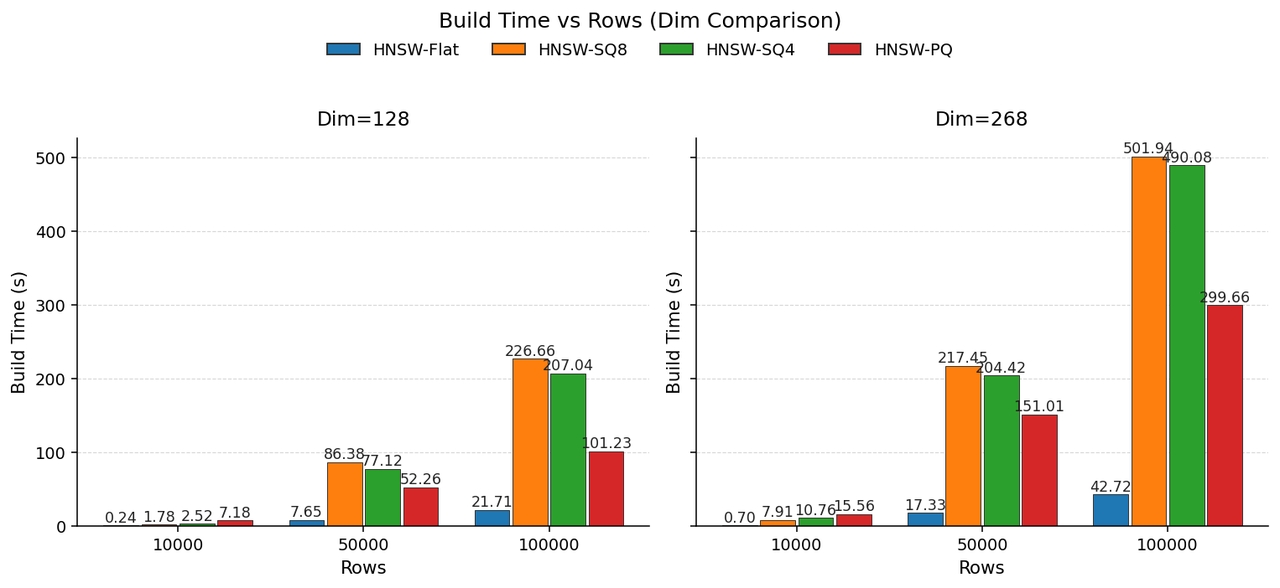
量子化により、インデックス構築時の負荷が増えます。構築段階では多数の距離計算が必要で、計算のたびに量子化した値をデコードしなければなりません。128 次元のベクトルでは行数に応じて構築時間が増え、SQ の構築コストは FLAT の約 10 倍になる場合があります。
性能チューニング
ベクトル検索は、セカンダリインデックスを使う典型的なポイントクエリのシナリオです。高い QPS や低いレイテンシーが求められる場合は、以下の提案を参照してください。チューニング後、FE 32C 64GB + BE 32C 64GB のマシンでは、Doris は 3000+ QPS に達します(データセット:Cohere-MEDIUM-1M)。
クエリ性能ベンチマーク
| 同時実行数 | 方式 | QPS | 平均レイテンシー(秒) | P99 レイテンシー(秒) | CPU 使用率 | 再現率 |
|---|---|---|---|---|---|---|
| 240 | Doris | 3340.4399 | 0.071368168 | 0.163399825 | 40% | 91.00% |
| 240 | Doris SQ INT8 | 3188.6359 | 0.074728852 | 0.160370195 | 40% | 88.26% |
| 240 | Doris SQ INT4 | 2818.2291 | 0.084663868 | 0.174826815 | 43% | 80.38% |
| 240 | Doris 総当たり検索 | 3.6787 | 25.554878826 | 29.363227973 | 100% | 100.00% |
| 480 | Doris | 4155.7220 | 0.113387271 | 0.261086075 | 60% | 91.00% |
| 480 | Doris SQ INT8 | 3833.1130 | 0.123040214 | 0.276912867 | 50% | 88.26% |
| 480 | Doris SQ INT4 | 3431.0538 | 0.137636995 | 0.281631249 | 57% | 80.38% |
| 480 | Doris 総当たり検索 | 3.6787 | 25.554878826 | 29.363227973 | 100% | 100.00% |
プリペアドステートメントの使用
一般的な埋め込みモデルの出力は通常 768 次元以上です。このようなベクトルを SQL にリテラルとして直接埋め込むと、解析時間が実際の実行時間を上回る場合があります。そのため、プリペアドステートメントの使用を推奨します。現在、Doris はこれらのコマンドを mysql クライアントから直接実行することをサポートしていないため、JDBC が必要です。
-
JDBC URL でサーバー側のプリペアドステートメントを有効にします。
url = jdbc:mysql://127.0.0.1:9030/demo?useServerPrepStmts=true -
プリペアドステートメントを使用します。
// use `?` for placement holders, readStatement should be reused
PreparedStatement readStatement = conn.prepareStatement("SELECT id, l2_distance_approximate(embedding, cast (? as ARRAY<FLOAT>)) AS distance
    FROM sift_1M
    ORDER BY distance
    LIMIT 10");

...

readStatement.setString("[0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]");

ResultSet resultSet = readStatement.executeQuery();
セグメント数の削減
Doris の ANN インデックスはセグメント上に構築されます。セグメントが多すぎると、追加の処理負荷が生じます。
- 推奨:ANN インデックスがあるテーブルでは、タブレットあたりのセグメント数を 5 以下にします。
- 方法:
write_buffer_sizeとvertical_compaction_max_segment_sizeをbe.confで調整して各セグメントを大きくし、セグメント数を減らします。両方を10737418240(10 GB)に設定することを推奨します。
Rowset 数の削減
読み込みのたびに単一の rowset が作成され、rowset が多すぎるとスケジューリングの負荷も増えます。バッチ読み込みには Stream Load または INSERT INTO SELECT を使用します。
ANN インデックスをメモリ上に保持する
現在の ANN インデックスアルゴリズムはメモリベースです。クエリ対象セグメントのインデックスがメモリ上にない場合、ディスク I/O が発生します。性能を確保するため、be.conf に次のように設定してメモリ上に保持します。
enable_segment_cache_prune=false
parallel_pipeline_task_num = 1
ANN TopN クエリが返す行数は非常に少なく、高い並列度は必要ありません。次を使用します。
SET parallel_pipeline_task_num = 1;
enable_profile = false
レイテンシーに対する要求が特に厳しい場合は、クエリプロファイルを無効にします。
SET enable_profile = false;
Python SDK
AI が普及する中、Python はデータ処理やインテリジェントアプリケーション開発で広く使われる言語になっています。開発者が Python から Doris のベクトル検索を利用しやすくするため、コミュニティから次の Python SDK が提供されています。
- doris_vector_search:ベクトルの距離に基づく検索向けに最適化されています。現在、Doris のベクトル検索用 Python SDK の中で最も高い性能を持ちます。
使用上の制限
Doris のベクトルインデックスを使用する際は、次の制限に注意してください。
-
データ型の制限:ANN インデックスを作成する列は、
NOT NULLABLEのArray<Float>である必要があります。データの読み込み時には、この列の各ベクトルの長さがインデックスプロパティで指定した次元数(dim)と一致していなければならず、異なる場合はエラーになります。 -
テーブルモデルの制限:ANN インデックスを使用できるのは、Duplicate Key テーブル、または merge-on-write を有効にした Unique Key テーブル(
enable_unique_key_merge_on_write = true)のみです。Unique Key テーブルのサポートはバージョン 4.1.4 で追加されました。merge-on-read の Unique Key テーブルと Aggregate Key テーブルは引き続きサポートされず、これらにインデックスを作成しようとするとANN index can only be used in DUP_KEYS table or UNIQUE_KEYS table with merge-on-write enabledというエラーが報告されます。 -
述語に使用する列にはセカンダリインデックスが必要:Doris は事前フィルタリングの意味論を使用します(述語は AnnTopN より前に評価されます)。SQL の述語で参照される列にセカンダリインデックスがない場合、正しい結果を得るために総当たり計算にフォールバックします。例:
SELECT id, l2_distance_approximate(embedding, [xxx]) AS distance
    FROM sift_1M
    WHERE round(id) > 100
ORDER BY distance limit 10;idは主キーですが、この列には行番号を正確に特定できる転置インデックスなどのセカンダリインデックスが構築されていません。このような述語はインデックス解析後に評価されます。ANN TopN の事前フィルタリングの意味論を維持するため、システムは総当たり計算にフォールバックします。 -
距離関数はメトリックの種類と一致する必要がある:SQL で使用する距離関数が、DDL で定義したインデックスの
metric_typeと一致しない場合、l2_distance_approximate/inner_product_approximateを使用しても、Doris は TopN の計算に ANN インデックスを使用できません。 -
inner_productでは降順ソートが必要:metric_typeがinner_productの場合、ANN インデックスで高速化できるのはORDER BY inner_product_approximate() DESC LIMIT Nのみです(DESCは省略できません)。 -
関数の引数の順序:
xxx_approximate()関数がインデックス解析を実行するのは、第一引数がColumnArray、第二引数がCASTまたはArrayLiteralの場合だけです。順序を入れ替えると、総当たり検索にフォールバックします。
よくある質問
Q1:Doris の ANN インデックスはどの距離尺度をサポートしますか?
現在、l2_distance(ユークリッド距離)と inner_product をサポートしています。コサイン類似度については、コサイン類似度の使用を参照してください。
Q2:ANN クエリでインデックスが使われないのはなぜですか?
考えられる原因は次のとおりです。
- 距離関数が
metric_typeと一致していない。 inner_productの使用時にORDER BY ... DESCを指定していない。- 関数の引数の順序が逆になっている(
ColumnArrayを第一引数にする必要があります)。 - フィルターに使う列に転置インデックスなどのセカンダリインデックスがなく、総当たり計算へのフォールバックが発生している。
Q3:HNSW、IVF、IVF On-Disk はどのように選べばよいですか?
| インデックス | メモリ使用量 | クエリ性能 | 適用シナリオ |
|---|---|---|---|
| HNSW | 多い(全体をメモリ上に保持する必要がある) | 高い | 小規模から中規模、低レイテンシーが強く求められる場合 |
| IVF | 中程度 | 中程度 | 大規模データ |
| IVF On-Disk | 少ない(ディスクとキャッシュを使用) | 中程度 | 非常に大規模なデータ、メモリに制約がある場合 |
Q4:メモリが足りない場合はどうすればよいですか?
量子化によってメモリ使用量を削減します。
- まず
sq8(INT8 スカラー量子化)を試します。通常、再現率への影響を抑えながら、インデックスを元の約 1/3 のサイズに圧縮できます。 - メモリの制約が非常に厳しい場合は
sq4またはpqを使用しますが、再現率はある程度低下します。
Q5:キーワードによる絞り込みとベクトル検索はどう組み合わせますか?
フィルターに使う列に転置インデックスを構築してから、WHERE 句を含む ANN クエリを使用します。フィルター付き ANN 検索を参照してください。
Q6:QPS を向上させるにはどうすればよいですか?
性能チューニングを参照してください。主なポイントは次のとおりです。
- プリペアドステートメントを使用し、SQL の解析による負荷を避ける。
- セグメント数と rowset 数を減らす。
- ANN インデックスをメモリ上に保持する。
parallel_pipeline_task_num = 1を設定する。- クエリプロファイルを無効にする。