パフォーマンステストと分析
このドキュメントでは、Apache Doris のベクトルインデックス(ANN Index)のクエリ性能とデータ取り込み性能のベンチマーク結果を示します。すべてのテストは VectorDBBench を使用して実施しています。この結果は、次の判断に役立ちます。
- Doris のベクトル検索が業務要件を満たすか評価する。
- 再現率、クエリ性能、データ取り込み速度のトレードオフを理解する。
- テスト結果をローカル環境で再現し、本番環境での動作を検証する。
単一ノード構成および分散構成での大規模データセット(10M / 100M 規模)のベンチマーク結果については、大規模環境での性能ベンチマークを参照してください。
テスト環境
| 項目 | 構成 |
|---|---|
| マシン仕様 | 16C 64GB |
| CPU モデル | Intel(R) Xeon(R) Platinum 8369B CPU @ 2.70GHz |
| 配置 | FE と BE を同一マシンに配置 |
| Doris のバージョン | Apache Doris 4.0.2 |
| テストデータセット | VectorDBBench Performance768D1M(768 次元ベクトル、1 million 行) |
FE と BE を同一マシンに配置することは、本番環境で推奨される構成ではありません。本番環境では、FE と BE を別々のマシンに配置してください。
テスト結果
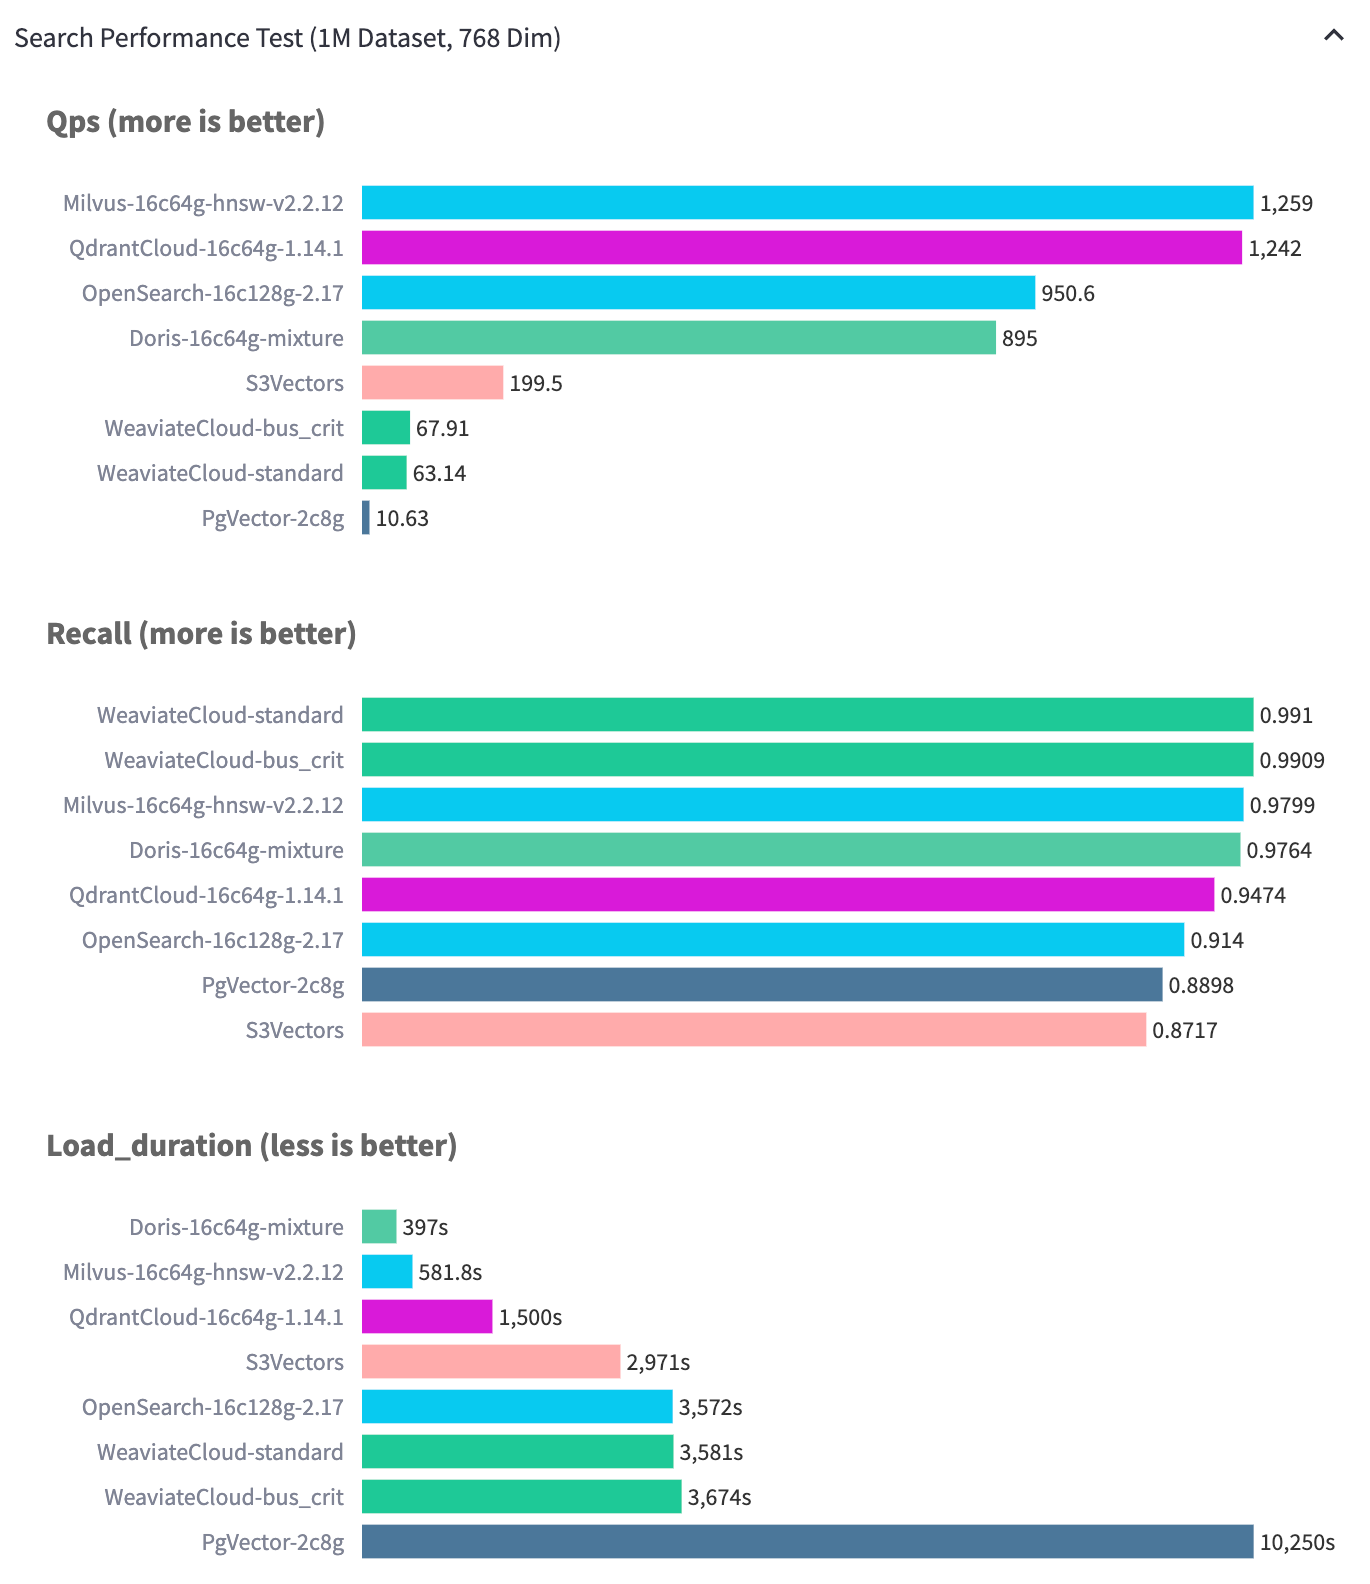
Performance768D1M データセットでは、Apache Doris は 989.1 QPS を達成しながら 97% を超える再現率を維持し、データ取り込み性能も同種のシステムを大幅に上回りました。
結果の分析
ベクトルデータベースの「性能の三角形」
ベクトル検索では、本番環境で安定稼働する成熟したベクトルデータベースは、通常、次の三つの側面の間でトレードオフを考慮する必要があります。
                    ┌──────────────────────┐
                    │      Recall          │
                    │  (Higher is Better)  │
                    └──────────▲───────────┘
                               / \
                              /   \
                             /     \
                            /       \
                           /         \
                          /           \
             ┌───────────┘             └───────────┐
             │                                     │
             │                                     │
             ▼                                     ▼
 ┌──────────────────────┐                 ┌────────────────────────┐
 │      Query QPS       │                 │     Indexing           │
 │   (Latency / QPS)    │                 │     Throughput         │
 │  (Lower Latency Better)│               │  (Higher is Better)    │
 └──────────────────────┘                 └────────────────────────┘
| 側面 | 指標 | 望ましい方向 |
|---|---|---|
| 再現率 | Top-K のヒット率 | 高いほどよい |
| クエリ QPS / レイテンシー | 秒あたりのクエリ数 / クエリごとのレイテンシー | QPS は高く、レイテンシーは低いほどよい |
| インデックス構築スループット | インデックス構築のスループット | 高いほどよい |
通常、これら三つを同時に最大化することは難しいため、ベクトルデータベースの設計ではバランスを取る必要があります。
HNSW の主要なパラメータとトレードオフ
業界で広く使われているベクトルインデックスである HNSW(Hierarchical Navigable Small World)を例に説明します。HNSW はグラフ構造を利用して検索を最適化し、主に次の三つのハイパーパラメータを調整できます。
| パラメータ | 役割 | 影響 |
|---|---|---|
max_degree | グラフ内の各ノードの最大出次数 | グラフの密度と全体的な連結性を決める |
ef_construction | インデックス構築時の候補集合のサイズ | 値を大きくすると、より品質の高いグラフが構築される |
hnsw_ef_search | クエリ時の探索ウィンドウのサイズ | 再現率とクエリのレイテンシーに直接影響する |
一般的なチューニングのトレードオフは次のとおりです。
max_degreeとef_constructionを大きくすると、グラフの連結性と探索効率が大幅に向上し、再現率が高くなります。- 品質の高いグラフであれば、クエリ時の
hnsw_ef_searchを小さく設定でき、検索コストの削減とクエリ性能の向上につながります。 - 一方、インデックスの構築にはより多くの計算資源とメモリが必要になり、データ取り込み性能は低下します。
これは、ベクトルデータベースの設計で直面する典型的な「トリレンマ」です。
Apache Doris の最適化アプローチ
Apache Doris はベクトル検索機能の設計にあたり、次の方法でよりバランスの取れた性能の三角形を目指しています。
- 基盤となる実行エンジンを最適化する。
- ストレージフォーマットを改善する。
- HNSW 構築パイプラインを実装レベルで並列化し、高速化する。
これにより Doris は、インデックスの品質や高い再現率を犠牲にすることなく、インデックスのデータ取り込み速度を大幅に向上させています。
Performance768D1M データセットのベンチマーク結果は、この設計目標を裏付けています。
- インデックスの品質が同等の場合、Doris のデータ取り込み性能は同種のシステムを大幅に上回ります。
- データ取り込み速度を高めるために、グラフの品質を下げていません。
- QPS は 989.1 に達し、再現率は 97% を超え、三つの側面でバランスの取れた結果が得られています。
再現手順
次のコマンドを使用して、ローカル環境でテストを再現できます。
NUM_PER_BATCH=500000 vectordbbench doris \
    --host 127.0.0.1 \
    --port 9030 \
    --http-port 8030 \
    --case-type Performance768D1M \
    --db-name vdb \
    --num-concurrency 80 \
    --stream-load-rows-per-batch 500000 \
    --index-prop max_degree=128,ef_construction=256 \
    --session-var hnsw_ef_search=100
主なパラメータは次のとおりです。
| パラメータ | 意味 |
|---|---|
--case-type | テストケースを選択する(ここでは 768D1M データセット) |
--num-concurrency | クエリの同時実行数 |
--stream-load-rows-per-batch | Stream Load のバッチあたりの行数 |
--index-prop | インデックス構築のパラメータ(max_degree、ef_construction) |
--session-var | クエリ時のセッション変数(hnsw_ef_search) |
関連ドキュメント
- 大規模環境での性能ベンチマーク:単一ノード構成および分散構成での大規模データセット(10M / 100M 規模)のテスト結果。
- HNSW インデックスの内部構造
- ベクトルインデックスの概要
- ベクトルインデックスの実践ガイド