AI の概要
Apache Doris は、テキスト検索、ベクトル検索、AI 関数、MCP を利用したインテリジェントな連携を統合した、高性能なリアルタイム分析データベースです。データの保存、検索、分析をカバーする包括的な AI データスタックを構成し、AI アプリケーションに統一されたデータ基盤を提供します。
次の表は、一般的な AI のユースケースと、それぞれに対応する Doris の機能を示します。目的に合ったソリューションを確認できます。
| 実現したいこと | ユースケース | 主な機能 |
|---|---|---|
| AI エージェントがビジネスデータをリアルタイムに照会できるようにする | エージェント向け分析 | MPP アーキテクチャ、ミリ秒単位のクエリ、MCP Server |
| 同じデータに対してキーワード検索、ベクトル検索、集約を実行する | ハイブリッド検索と分析 | 転置インデックス + ベクトルインデックス + SQL |
| AI の学習データ準備と特徴量エンジニアリングを高速化する | AI 向けレイクハウス | レイクハウスアーキテクチャ、オープンなテーブル形式、高速な SQL |
| 企業内ナレッジベースとインテリジェントなカスタマーサポートを構築する | RAG アプリケーション | 高い同時実行性を備えたベクトル検索、ハイブリッド検索 |
| モデルの学習と推論サービスを監視する | AI オブザーバビリティ | 高スループットのデータ取り込み、転置インデックス、低いストレージコスト |
| 検索時にユーザーの意図を理解する | セマンティック検索 | HNSW/IVF、量子化、マルチモーダルへの拡張 |
エージェント向け分析
AI エージェント技術が普及するにつれ、分析に基づく判断を AI が自動で行う機会が増えています。そのため、データプラットフォームには極めて高いリアルタイム性能と同時実行性が求められます。従来の人による分析と異なり、エージェント向け分析では、データ照会と判断をミリ秒単位で完了し、大量のエージェントからの同時アクセスに対応する必要があります。代表的なユースケースには、リアルタイムの不正検知、インテリジェントな広告配信、パーソナライズされたレコメンデーションがあります。
高性能な MPP アーキテクチャを基盤とする Doris には、エージェント向け分析に次の利点があります。
| 項目 | 指標 | 利点 |
|---|---|---|
| データの遅延 | サブ秒 | リアルタイムの取り込みと更新により、エージェントは最新のデータに基づいて判断できます |
| クエリ応答 | 平均 < 100 ms | エージェントがリアルタイムに判断するための要件を満たします |
| 同時実行性 | 10,000+ QPS | 大量のエージェントからの同時クエリに対応できます |
| 連携 | ネイティブの MCP Server | AI エージェントとシームレスに連携し、開発を簡素化します |
ハイブリッド検索と分析処理
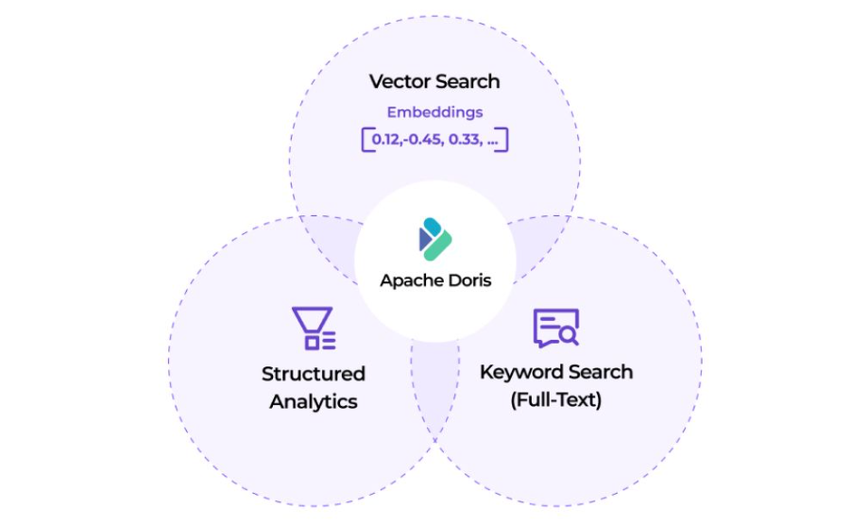
半構造化データと非構造化データは、データ分析で重要性を増しています。顧客レビュー、チャットログ、製造ログ、車両のテレメトリ信号は、ビジネス上の意思決定に深く組み込まれています。従来の構造化データ分析に全文検索とベクトル検索を組み合わせ、単一のプラットフォームでセマンティック検索と集約を伴う多次元分析の両方を行う必要があります。代表的なユースケースは次のとおりです。
- 顧客インサイト:レビュー文の検索とユーザー行動分析を組み合わせ、顧客のニーズと満足度の傾向を正確に把握します。
- スマート製造:製造ログの全文検索、設備画像の認識、IoT 指標の分析を組み合わせ、故障予測と品質改善に役立てます。
- コネクテッドカー:車両テレメトリの分析、ユーザーフィードバックのテキストマイニング、運転行動のベクトル検索を組み合わせ、スマートコックピットの体験を向上させます。
Doris でハイブリッド検索と分析アプリケーションを構築する利点は次のとおりです。
- 統一されたアーキテクチャ:データの移行や異種システムの統合を行わずに、構造化データ分析、全文検索、ベクトル検索を単一のプラットフォームで処理できます。
- ハイブリッドクエリの性能:ベクトル類似検索、キーワードフィルタリング、集約を単一の SQL 文で実行し、高いクエリ性能を得られます。
- 柔軟なスキーマのサポート:VARIANT 型は動的な JSON 構造をネイティブにサポートし、Light Schema Change によってフィールドとインデックスを数秒で変更できます。
- スタック全体の最適化:転置インデックスとベクトルインデックスから MPP 実行エンジンまでを一貫して最適化し、検索精度と分析効率のバランスを取ります。
AI 向けレイクハウス
AI モデルやアプリケーションの開発には、大量のデータから学習用データセットを準備し、特徴量エンジニアリングを行い、データ品質を評価する必要があります。従来のアーキテクチャでは、データレイクと分析エンジンの間で頻繁なデータ移行が必要になることがあります。レイクハウスアーキテクチャは、データレイクのオープンなストレージとリアルタイム分析エンジンを密接に統合し、単一のプラットフォームでデータ準備、特徴量エンジニアリング、モデル評価の全工程を支えます。これによりデータのサイロ化を解消し、AI 開発の反復を速めます。
アーキテクチャの特徴:
- レイクハウスとの統合:Iceberg や Paimon などのオープンなレイクテーブル形式と Catalog を基盤にオープンなレイクハウスを構築し、分析用データと AI 用データを統一的に管理します。
- 高速な SQL エンジン:Doris は、対話的なクエリと軽量な ETL をサポートするリアルタイム分析エンジンとして機能し、データ準備と特徴量エンジニアリングに効率的な SQL 処理を提供します。
- シームレスなデータフロー:データを移動せずにデータレイクを直接読み書きできます。ストレージ層を統一的に管理しながら、コンピューティング層で柔軟に処理を高速化できます。
AI ワークフロー全体の高速化:
- 大規模なデータ準備:PB 規模のデータレイクからデータを効率よくフィルタリング、サンプリング、クレンジングし、高品質な学習用データセットを迅速に構築します。
- リアルタイムの特徴量エンジニアリング:オンラインで特徴量を抽出、変換、集約し、モデルの学習と推論にリアルタイムの特徴量サービスを提供します。
- 品質評価:テストセットと本番データを多次元で迅速に分析し、モデルの性能とデータドリフトを継続的に監視します。
RAG(検索拡張生成)
RAG は外部のナレッジベースから関連情報を検索し、大規模言語モデルにコンテキストを提供します。これにより、モデルのハルシネーションと知識の鮮度に関する課題に効果的に対処します。ベクトルエンジンは RAG システムの中核です。膨大なナレッジベースから関連性の高い文書の断片を迅速に取得するとともに、多数のユーザーからの同時クエリに対応して、アプリケーションの応答性を確保する必要があります。
代表的なアプリケーション:
- 企業内ナレッジベース:社内文書やマニュアルに基づく質問応答システムを構築し、従業員が自然言語で正確な回答をすばやく得られるようにします。
- インテリジェントなカスタマーサポート支援:製品ナレッジベースと過去の対応事例を組み合わせ、サポート担当者やチャットボットに適切な回答案を提示します。
- インテリジェントな文書アシスタント:大量の文書から関連する内容を迅速に探し、調査、執筆、意思決定を支援します。
Doris で RAG を構築する利点:
- 高い同時実行性能:分散アーキテクチャが高い同時実行性を備えたベクトル検索を支え、大規模なユーザーの同時アクセスに対応します。
- ハイブリッド検索機能:ベクトル類似検索とキーワードフィルタリングを単一の SQL 文で実行し、意味に基づく検索と完全一致のバランスを取ります。
- 柔軟なスケーリング:クラスターの拡張に応じて検索性能が線形に向上し、数百万から数百億のベクトルまで円滑に拡張できます。
- 統一されたソリューション:ベクトルデータ、元の文書、ビジネスデータを統一的に管理し、RAG アプリケーションのデータアーキテクチャを簡素化します。
AI オブザーバビリティ
AI モデルの学習の反復やアプリケーションの実行時には、大量のログ、メトリクス、トレースデータが生成されます。問題を正確に特定し、性能を継続的に最適化するために、オブザーバビリティシステムは AI インフラストラクチャの重要な要素になっています。事業規模が拡大するにつれ、オブザーバビリティプラットフォームには、PB 規模のデータを高スループットで取り込み、ミリ秒単位で検索結果を返し、コストを抑えるという複合的な課題が生じます。
代表的なユースケース:
- モデルの学習の監視:学習の指標とリソース消費量をリアルタイムに追跡し、学習時の異常や性能上のボトルネックを迅速に特定します。
- 推論サービスのトレース:各推論リクエストの呼び出し経路全体を記録し、遅延の原因とエラーのパターンを分析します。
- AI アプリケーションのログ分析:大量のアプリケーションログに全文検索と集約を実行し、問題の調査と行動の把握を支援します。
Doris で AI オブザーバビリティを構築する利点:
| 項目 | 機能の指標 |
|---|---|
| 取り込み性能 | PB/day (10 GB/s) の継続的な取り込みをサポートします。転置インデックスによってログ検索を高速化し、秒単位の応答を実現します |
| ストレージコスト | 圧縮率 5:1~10:1 により、ストレージコストを 50%-80% 削減します。コールドデータには低コストのストレージを使用できます |
| スキーマの柔軟性 | Light Schema Change によってフィールドを数秒で変更でき、VARIANT 型は動的な JSON をネイティブにサポートします |
| エコシステムとの互換性 | OpenTelemetry および ELK エコシステムと互換性があり、Grafana や Kibana などの可視化ツールと連携できます |
セマンティック検索
セマンティック検索は、ベクトル化によってテキストの深い意味を捉え、クエリの語句が文書の表現と異なっていても、意味的に関連する内容を検索します。言語をまたぐ検索、類義語の認識、意図の理解などに重要で、検索の再現率とユーザー体験を大きく向上させます。
代表的なユースケース:
- 企業内文書の検索:従業員が自然言語で質問すると、システムが意図を理解し、膨大な文書から意味的に関連する規程、手順、知識を探します。
- EC サイトの商品検索:ユーザーが「夏に適した通気性のよい靴」と入力すると、システムはキーワードだけで照合するのではなく、ニーズを理解して関連商品を探します。
- コンテンツ推薦プラットフォーム:記事や動画の意味的な類似性に基づいて、表現は異なっていてもユーザーが関心を持ちそうなコンテンツを推薦します。
Doris でセマンティック検索を構築する利点:
- 高性能なベクトル検索:HNSW と IVF のアルゴリズムをサポートし、億件規模のベクトルに対してサブ秒で応答するため、大規模なセマンティック検索に対応できます。
- ハイブリッド検索による強化:単一の SQL 文でセマンティック検索とキーワードフィルタリングを組み合わせ、必須キーワードへの一致を確保しながら意味的に関連する内容を探せます。
- マルチモーダルへの拡張:テキストだけでなく、画像や音声などのマルチモーダルコンテンツに対するセマンティック検索もサポートします。
- 柔軟な量子化による最適化:SQ/PQ 量子化技術によって、検索精度を維持しながらストレージと計算のコストを大幅に削減します。