継続的データロードの概要
Doris は Streaming Job を使用して、複数のデータソースから Doris テーブルへデータを継続的にロードできます。Job を送信すると、Doris はデータロード Job の実行を継続し、ソースからリアルタイムでデータを読み取って Doris テーブルに書き込みます。
この機能はバージョン 4.1.0 以降でサポートされます。
このドキュメントでは、次の疑問に答えます。
- 継続的データロードでは、どのデータソースと同期方式がサポートされますか?
- SQL Mapping Sync と Auto Table Creation Sync はどのように選べばよいですか?
- Job の状態はどのように遷移し、自動復旧はどのように機能しますか?
- 日常の運用でデータロード Job を表示、一時停止、再開、削除するにはどうすればよいですか?
- 共通の FE 設定パラメータと Job 設定パラメータには何がありますか?
サポートされるデータソースと同期方式
継続的データロードでは、次のデータソースと同期方式がサポートされます。
| データソース | サポートされるバージョン | SQL Mapping Sync | Auto Table Creation Sync | 設定ガイド |
|---|---|---|---|---|
| MySQL | 5.6、5.7、8.0.x | MySQL CDC と SQL Mapping | MySQL CDC とテーブルの自動作成 | Amazon RDS MySQL · Amazon Aurora MySQL |
| PostgreSQL | 14、15、16、17 | PostgreSQL CDC と SQL Mapping | PostgreSQL CDC とテーブルの自動作成 | Amazon RDS PostgreSQL · Amazon Aurora PostgreSQL |
| OceanBase | MySQL 互換モード | - | OceanBase CDC とテーブルの自動作成(バージョン 4.1.4 以降) | - |
| S3 | - | S3 の継続的データロード | - | - |
アップストリームのカラム型から Doris の型への対応については、MySQL、PostgreSQL、OceanBase のデータ型マッピングを参照してください。
同期方式の選び方
SQL Mapping Sync と Auto Table Creation Sync は、基盤となる仕組みがまったく異なる継続的データロード方式であり、単なる「テーブル数」の違いではありません。Auto Table Creation Sync でも include_tables を使用して単一のテーブルだけを同期できます。必要な機能に基づいて選択してください。
機能比較
| 機能 | SQL Mapping Sync | Auto Table Creation Sync |
|---|---|---|
| 基盤となる仕組み | Job + TVF(INSERT INTO tbl SELECT * FROM tvf()) | Job + ネイティブのデータベース全体を対象とする DDL(FROM src TO DATABASE db) |
| 同期先の単位 | 既存の Doris テーブル | Doris データベースのコンテナ |
| 同期範囲 | 単一のテーブル | 単一のテーブルからデータベース全体まで(include_tables で制御) |
| テーブルの自動作成 | テーブルを事前に作成する必要がある | 初回同期時に主キーテーブルを自動作成する |
| SQL の柔軟性 | カラムのマッピング、フィルタリング、変換をサポートする(SELECT 句) | 同期先テーブルの名前変更と、キー以外のカラムの除外をサポートする。SQL 式、行のフィルタリング、データ変換はサポートしない |
| セマンティクスの保証 | exactly-once | at-least-once |
| 必要な権限 | Load | Load + Create(テーブルを自動作成する場合) |
| 代表的な用途 | SQL 式、型変換、条件付きフィルタリングを必要とするリアルタイム同期 | データベース全体またはテーブル群のミラー複製。同期先テーブルの簡単な名前変更やカラムの除外が可能 |
選択の目安
- データに SQL 処理を適用する必要がある、または exactly-once セマンティクスが厳密に求められる場合 -> SQL Mapping Sync を選択します
- Doris にテーブルを自動作成させ、テーブル群を一つの設定で同期したい場合 -> Auto Table Creation Sync を選択します
- データソースが OceanBase の場合 -> 現時点では、MySQL 互換モードの Auto Table Creation Sync のみがサポートされます
- データソースが S3 オブジェクトストレージの場合 -> S3 TVF を使用する SQL Mapping Sync のみがサポートされます
Job の状態遷移
Streaming Job は実行中に次の状態間を遷移します。SQL Mapping Sync と Auto Table Creation Sync は同じ状態遷移に従います。
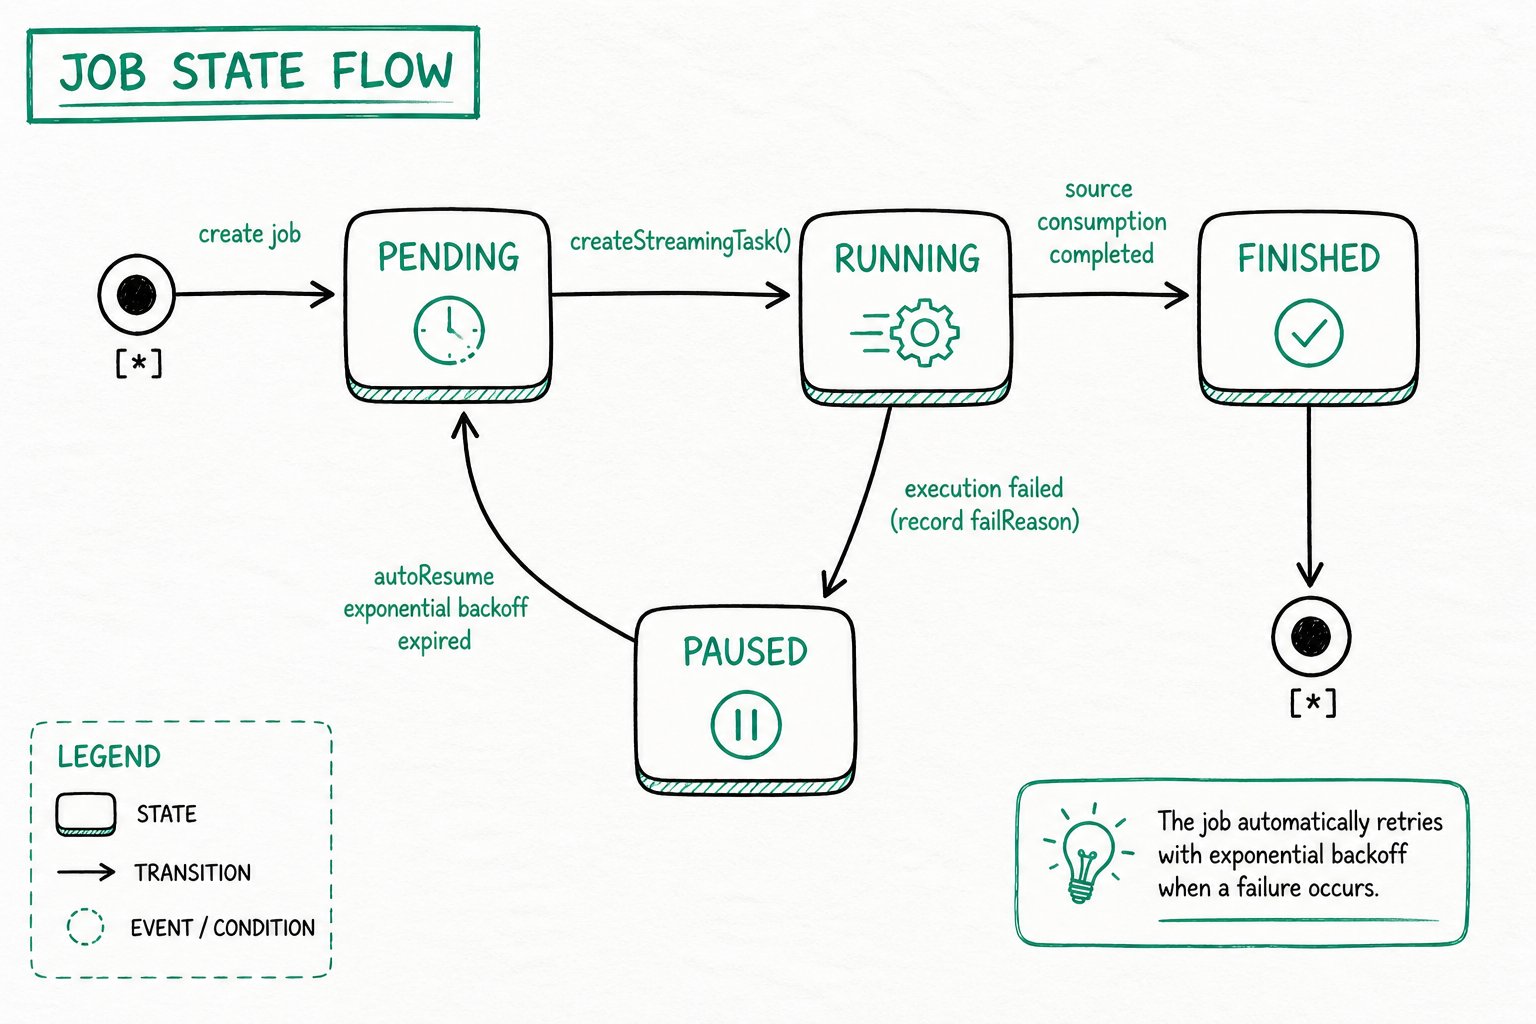
状態の説明
| 状態 | 意味 |
|---|---|
| PENDING | Job は作成済みですが、サブタスクはまだスケジュールされていません。次のスケジューリング時に StreamingTask が作成されるのを待っています。 |
| RUNNING | サブタスクが作成されて実行中です。ソースから増分データを読み取り、Doris に書き込んでいます。 |
| FINISHED | ソースのデータがすべて処理され、Job が終了しました。S3 TVF の Job は、すべてのファイルのデータロードが完了するとこの状態になります。 |
| PAUSED | サブタスクが失敗したため、Job が自動的に一時停止され、failReason が記録されています。原因は ErrorMsg フィールド(select * from jobs(...) の結果)で確認できます。 |
自動復旧(autoResume)
Job が PAUSED になると、スケジューラは指数バックオフ方式で定期的に復旧を試みます。復旧時には Job が PENDING に戻り、サブタスクの作成を続けます。手動操作は不要です。ネットワークの揺らぎやアップストリームの短時間の停止など、一時的な障害は自動的に吸収されます。
状況に応じて、次のコマンドを使用してください。
- すぐに再開する、または問題を調査してから手動で開始する場合:
RESUME JOBを使用します - 完全に停止し、以後スケジュールしない場合:
PAUSE JOBまたはDROP JOBを使用します(手動で一時停止した Job は autoResume によって再開されません)
CDC タスクの実行 ID と障害への対処
4.1.5 以降、Streaming CDC は、固定の管理者 ID ではなく、Job の作成者の Doris ID を使用して書き込み、テーブルメタデータのクエリ、スキーマ変更を行います。作成者には、同期先テーブルに対する LOAD 権限、テーブルの自動作成に必要な CREATE 権限、スキーマ同期に必要な ALTER 権限とテーブルの参照権限が必要です。実行中に権限を取り消した場合も、後続のタスクに影響します。Job に記録された作成者の権限を確認してください。
cdc_stream() に基づく Streaming INSERT タスクが失敗しても、通常のタスク再試行フローには入りません。jobs() と tasks() でエラーを確認し、ソースまたは権限の問題を修正して、Job の状態に応じて再開してください。失敗したタスクが自動的に再実行されるとは想定しないでください。
共通の操作
データロードの状態を表示する
Streaming タイプの Insert Job をすべてクエリします。
select * from jobs("type"="insert") where ExecuteType = "STREAMING";
結果のカラムは次のとおりです。
| カラム | 説明 |
|---|---|
| ID | Job ID |
| NAME | Job 名 |
| Definer | Job の定義者 |
| ExecuteType | Job のスケジューリングタイプ: ONE_TIME/RECURRING/STREAMING/MANUAL |
| RecurringStrategy | 繰り返し実行の方式。通常の Insert で使用されます。ExecuteType=Streaming の場合は空です |
| Status | Job の状態 |
| ExecuteSql | Job の Insert SQL 文 |
| CreateTime | Job の作成時刻 |
| SucceedTaskCount | 成功したタスクの数 |
| FailedTaskCount | 失敗したタスクの数 |
| CanceledTaskCount | キャンセルされたタスクの数 |
| Comment | Job のコメント |
| Properties | Job のプロパティ |
| CurrentOffset | Job が処理を完了した位置。ExecuteType=Streaming の場合にのみ設定されます |
| EndOffset | データソースから取得した EndOffset の最大値。ExecuteType=Streaming の場合にのみ設定されます |
| LoadStatistic | Job の統計情報 |
| ErrorMsg | Job のエラーメッセージ |
| JobRuntimeMsg | Job の実行時のヒント |
| LagBytes | ソースログ(MySQL / OceanBase の binlog または PostgreSQL の WAL)に残っている未処理データのバイト数。-1 は、S3 データソースの場合やフルスナップショットの段階など、現在値を取得できないことを示します。バージョン 4.1.4 以降、このカラムは従来の秒単位の Lag カラムに代わり、バイト単位で報告されます |
| LastSourceEventTimestamp | コミット済みオフセットに記録された最新のソースイベントのタイムスタンプ(Unix 秒)。取得できない場合は空です。バージョン 4.1.4 で追加されました |
| LastTaskSuccessTime | 直近の Task が正常に完了した時刻 |
タスクの状態を表示する
Job ID を指定して、その Job に属するすべてのサブタスクをクエリします。
select * from tasks("type"="insert") where jobId='<job_id>';
結果のカラムは次のとおりです。
| カラム | 説明 |
|---|---|
| TaskId | タスク ID |
| JobID | JobID |
| JobName | Job 名 |
| Label | Task がデータロードに使用するラベル |
| Status | タスクの状態 |
| ErrorMsg | タスクの失敗メッセージ |
| CreateTime | タスクの作成時刻 |
| StartTime | タスクの開始時刻 |
| FinishTime | タスクの終了時刻 |
| LoadStatistic | タスクの統計情報 |
| User | タスクの実行ユーザー |
| RunningOffset | タスクが現在同期している位置の情報。Job.ExecuteType=Streaming の場合にのみ設定されます |
データロード Job を一時停止する
指定した Job を手動で一時停止します(手動で一時停止した Job は autoResume によって再開されません)。
PAUSE JOB WHERE jobname = <job_name>;
データロード Job を再開する
PAUSED 状態の Job を再開します。
RESUME JOB WHERE jobName = <job_name>;
データロード Job を削除する
指定した Job を完全に削除します。削除後、その Job はスケジュールされなくなります。
DROP JOB WHERE jobName = <job_name>;
共通パラメータ
FE 設定パラメータ
以下は FE の設定パラメータです(BE の設定ではありません)。
| パラメータ | デフォルト | 説明 |
|---|---|---|
| max_streaming_job_num | 1024 | Streaming Job の最大数 |
| job_streaming_task_exec_thread_num | 10 | StreamingTask の実行に使用するスレッド数 |
| max_streaming_task_show_count | 100 | メモリに保持する StreamingTask の実行記録の最大数 |
Job 共通データロード設定パラメータ
以下のパラメータは CREATE JOB ... PROPERTIES (...) で設定します。特に記載がない限り、MySQL、PostgreSQL、OceanBase の継続的データロード Job で使用できます。
| パラメータ | デフォルト | 説明 |
|---|---|---|
max_interval | 10 | アップストリームに新しいデータがない場合の、秒単位のアイドル時スケジューリング間隔。1 以上の整数のみを受け付けます。10s のような単位の接尾辞はサポートされません。 |
compute_group | 現在のセッションまたはユーザーのデフォルトのコンピュートグループ | コンピュートとストレージを分離したモードでのみサポートされます。Job を実行するコンピュートグループを指定します。明示的に設定する値を空にはできず、ユーザーにはそのコンピュートグループに対する USAGE 権限が必要です。このパラメータが設定されておらず、現在のセッションにもユーザーにも利用可能なデフォルトのコンピュートグループがない場合、Job の作成は失敗します。 |
session.<variable_name> | 対応するセッション変数のデフォルト値 | TVF モードでのみサポートされます。session.insert_max_filter_ratio など、Job の INSERT タスクに使用するセッション変数を設定します。変数名と値は、有効な Doris セッション変数である必要があります。 |
Job Property として使用する offset は、CDC Job の初期位置を設定しません。Job の作成時には、FROM MYSQL、FROM POSTGRES、FROM OCEANBASE、または cdc_stream(...) のソースパラメータで初期位置を設定してください。CDC Job を一時停止した後は、ALTER JOB ... PROPERTIES ("offset" = '<json_offset>') で位置を再設定できます。MySQL と OceanBase では {"file":"binlog.000001","pos":"154"} を、PostgreSQL では {"lsn":"12345678"} を使用します。ALTER JOB が受け付けるのは、正確な JSON オフセットのみです。
制限事項
同期範囲、テーブルの自動作成、セマンティクスの保証(exactly-once / at-least-once)については、機能比較で説明しています。このセクションでは、サポートされない制約と動作のみを示します。
主キーテーブル
同期できるのは、主キーを持つアップストリームのテーブルのみです(両方の同期方式に共通)。対応する Doris テーブルは Unique Key テーブルです。Auto Table Creation Sync では自動作成され、SQL Mapping Sync ではユーザーが作成します。主キーのないテーブルはサポートされません。
スキーマ変更(DDL)
DDL 同期が適用されるのは**Auto Table Creation Sync 方式のみ**です。SQL Mapping Sync 方式では DDL は一切同期されません。cdc_stream() テーブル関数は常に schema_change_enabled を false に固定します。
- MySQL、PostgreSQL、OceanBase: 同期されるのは
ADD COLUMNとDROP COLUMNのみです。カラム型の変更、RENAME COLUMN、主キー・制約・インデックス・パーティションの変更は同期されません。Doris で手動で適用してください。ソースごとの動作と制限については、MySQL、PostgreSQL、OceanBase の Schema Change Sync を参照してください。
Auto Table Creation Sync では、Schema Change Sync がデフォルトで有効です。現在、Doris にはこれを無効にする SQL プロパティはありません。
よくある質問
MySQL 接続エラー: Public Key Retrieval is not allowed
原因: 設定された MySQL ユーザーは SHA256 パスワード認証を使用しており、TLS などのプロトコルを介してパスワードを送信する必要があります。
解決策 1: JDBC URL に allowPublicKeyRetrieval=true パラメータを追加します。
jdbc:mysql://127.0.0.1:3306?allowPublicKeyRetrieval=true
解決策 2: MySQL ユーザーの認証方式を mysql_native_password に変更します。
ALTER USER 'username'@'%' IDENTIFIED WITH mysql_native_password BY 'password';
FLUSH PRIVILEGES;