データ更新の概要
この記事では、Apache Doris のデータ更新機能と削除機能を紹介し、次の疑問に答えます。
- 業務要件に応じて、どのテーブルモデルを選ぶべきか。
- 取り込みによる更新(UPSERT、部分列更新)と、DML による更新(
UPDATE、INSERT INTO SELECT)をどう使い分けるか。 - Unique Key モデルはどのような仕組みで動作するか(Merge-on-Write、Sequence 列、削除マーカー、部分列更新)。
- CDC 同期やリアルタイムのワイドテーブルなど、代表的なユースケースをどう実現するか。
読み方の目安:
- 更新方法をすぐに選びたい場合は、1. 適切な更新方法の選択を参照してください。
- 仕組みの理解やパフォーマンス問題の調査には、2. Unique Key モデルの実装の仕組みを参照してください。
- 代表的な業務での使い方は、3. 代表的な業務シナリオを参照してください。
- ベストプラクティスと制限事項は、4. 利用上の推奨事項を参照してください。
1. 適切な更新方法の選択
1.1 テーブルモデルと更新機能の比較
Doris には三つのテーブルモデルがあり、更新と削除への対応は大きく異なります。モデルを選ぶ際は、まず行単位の更新や部分列更新が業務上必要かどうかを確認してください。
| テーブルモデル | データの構成 | 対応する更新・削除方法 | 代表的なユースケース |
|---|---|---|---|
| Unique Key モデル | 一意の主キーで各行を識別し、書き込み時に重複を排除する | UPSERT、部分列更新、UPDATE、削除マーカーによる削除、DELETE | 注文ステータスの変更、ユーザータグの更新、CDC 同期 |
| Aggregate Key モデル | 同じ Key を持つ Value 列を集計関数(SUM/MAX/MIN/REPLACE)でマージする | 集計セマンティクスに従って取り込み時に更新する。DELETE の条件には Key 列のみ使用できる | リアルタイムレポート、クリック数などの集計 |
| Duplicate Key モデル | 重複排除や集計を行わず、データを追加する | DELETE のみ対応 | ログ、行動追跡など、追記のみを行う用途 |
選択の目安:行単位の更新または部分列更新が必要な場合は、Unique Key モデルを選びます。
1.2 更新経路の選択
Unique Key モデルでは、データ量と業務上の更新頻度に応じて、二つの更新経路から選べます。
| 経路 | 適した場面 | 推奨される書き込み方法 |
|---|---|---|
| 取り込みによる更新(UPSERT) | 高頻度かつ大量の更新、CDC 同期、複数ソースからのワイドテーブル構築 | Stream Load、Routine Load、Broker Load、INSERT INTO |
DML による更新(UPDATE) | 低頻度の一括更新、条件に基づくデータの更新、複数テーブルを関連付けた更新 | UPDATE、INSERT INTO ... SELECT ... |
1.2.1 取り込みによる更新(UPSERT)
Unique Key モデルでは、すべての取り込み方法(Stream Load、Broker Load、Routine Load、INSERT INTO)がデフォルトで UPSERT セマンティクスに従ってデータを処理します。
- 主キーがすでに存在する場合は、古い行を新しい行で上書きします。
- 主キーが存在しない場合は、新しい行を挿入します。
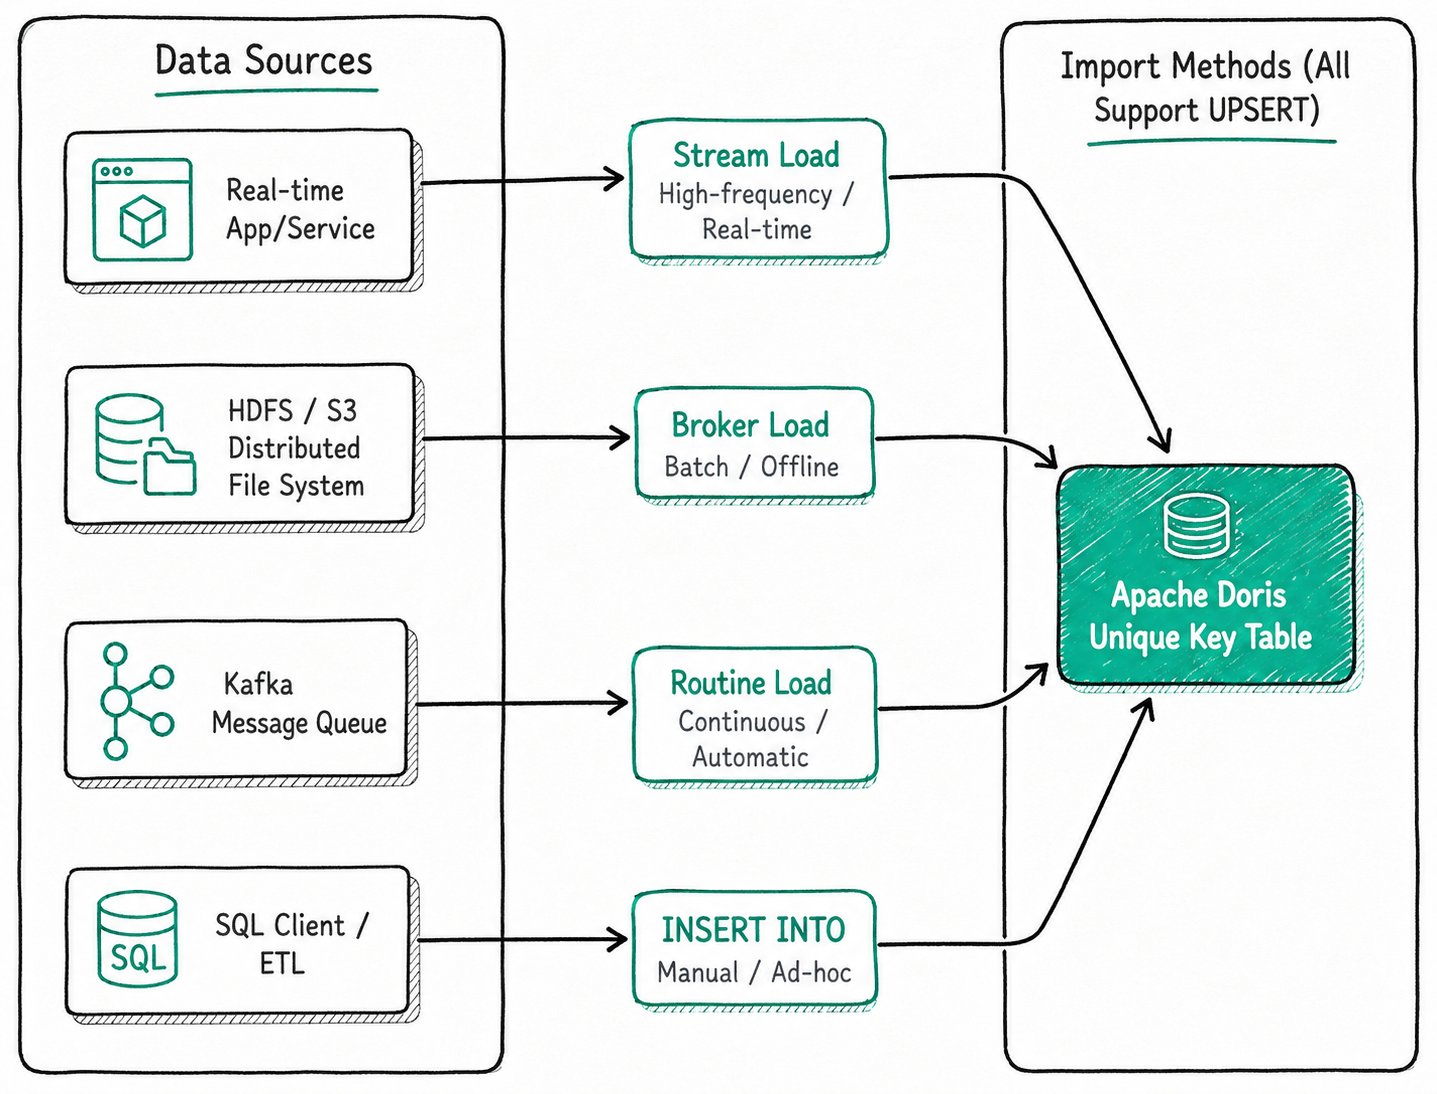
取り込みによる更新の動作は、テーブルモデルによって異なります。詳細は次を参照してください。
- Unique Key モデルでの取り込みによる更新:Stream Load、Routine Load などを使用して、行全体の UPSERT と部分列更新を行う方法。
- Aggregate モデルでの取り込みによる更新:Aggregate モデルの書き込みセマンティクスと利用可能な更新方法。
1.2.2 UPDATE 文による更新
Doris は標準 SQL の UPDATE に対応しています。Unique Key モデルのテーブルで WHERE 条件に基づいてデータを更新でき、他のテーブルと関連付けた更新も行えます。
-- Simple update
UPDATE user_profiles SET age = age + 1 WHERE user_id = 1;

-- Cross-table associated update
UPDATE sales_records t1
SET t1.user_name = t2.name
FROM user_profiles t2
WHERE t1.user_id = t2.user_id;
UPDATE は、まず条件に一致するデータをスキャンし、更新した行を書き戻します。このため、低頻度の一括更新に適しています。
同じ主キーを持つデータに対して、高い並行度で UPDATE を実行することは推奨しません。同じ主キーに対する UPDATE を並行して実行した場合、データの分離性は保証されません。
UPDATE 文の構文、代表的な使い方、制限事項については、UPDATE コマンドによるデータの更新を参照してください。
1.2.3 INSERT INTO SELECT による更新
Unique Key モデルではデフォルトで UPSERT セマンティクスが適用されるため、INSERT INTO ... SELECT ... を使用して UPDATE と同様の更新を行うこともできます。他のテーブルからデータを一括で書き戻す場合に適しています。
1.3 データの削除経路
Doris には二つのデータ削除経路があり、実装の仕組みはテーブルモデルによって異なります。
| 削除経路 | 対応するテーブルモデル | 説明 |
|---|---|---|
| 取り込みによる削除マーカーの設定 | Unique Key モデル | __DORIS_DELETE_SIGN__ = 1 のマーカーを書き込み、バックグラウンドの Compaction で物理的に削除する |
DML による削除(DELETE / TRUNCATE) | すべてのモデル | 条件に基づいてデータを削除するか、テーブルまたはパーティションを空にする |
詳細はデータの削除を参照してください。
2. Unique Key モデルの実装の仕組み
2.1 Merge-on-Write と Merge-on-Read
Unique Key モデルには、二つのデータマージ戦略があります。Doris 2.1 以降、Merge-on-Write がデフォルトの実装です。
| 比較項目 | Merge-on-Write(MoW) | Merge-on-Read(MoR、旧方式) |
|---|---|---|
| 書き込み時の動作 | 書き込み時に重複排除とマージを行い、主キーごとに最新のレコード一件のみをストレージに保持する | 書き込み時に複数のバージョンを保持する |
| クエリ性能 | 更新のない Duplicate Key テーブルに近い | クエリ時にリアルタイムでマージするため、MoW の約 3~10 倍の時間がかかる |
| 書き込み性能 | マージ処理の負荷があり、MoR よりやや低い(小規模バッチで約 10~20%、大規模バッチで約 30~50%) | Duplicate Key テーブルに近い |
| リソース消費 | 書き込みとバックグラウンドの Compaction で CPU とメモリを多く消費する | クエリで CPU とメモリを多く消費する |
| 適した場面 | 読み取りが多く、書き込みが少ない場合(推奨) | 書き込みが多く、読み取りが少ない場合(現在は非推奨) |
新規作成するテーブルでは、追加の設定なしで MoW がデフォルトで使用されます。
2.2 Sequence 列と順序が入れ替わったデータ
分散システムでは、データが順序どおりに到着しない場合があります。たとえば、注文ステータスが「支払い済み」から「発送済み」に変わっても、ネットワーク遅延により「発送済み」のメッセージが「支払い済み」より先に Doris に届くことがあります。
Sequence 列は、この問題を解決します。テーブル作成時に、列(通常はタイムスタンプまたはバージョン番号)を Sequence 列として指定します。同じ主キーのデータを書き込むと、Doris は Sequence 値が最大の行を常に保持します。
CREATE TABLE order_status (
    order_id BIGINT,
    status_name STRING,
    update_time DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id)
PROPERTIES (
    "function_column.sequence_col" = "update_time" -- Specify update_time as the Sequence column
);

-- 1. Write the "Shipped" record (larger update_time)
-- {"order_id": 1001, "status_name": "Shipped", "update_time": "2023-10-26 12:00:00"}

-- 2. Write the "Paid" record (smaller update_time, arrives later)
-- {"order_id": 1001, "status_name": "Paid", "update_time": "2023-10-26 11:00:00"}

-- Final result: the record with the largest update_time is retained
-- order_id: 1001, status_name: "Shipped", update_time: "2023-10-26 12:00:00"
詳細は次を参照してください。
- Sequence 列、MVCC によるバージョン管理、
UPDATEの並行実行パラメータなどについては、Unique Key モデルにおける更新の並行制御を参照してください。 - 複数のデータストリームが同じワイドテーブルの異なる列を同時に更新する場合は、Sequence Mapping を使用して列ごとのバージョン順序を個別に制御できます。詳細はUnique Key モデルにおける複数ストリームからの更新を参照してください。
2.3 削除マーカーの処理の流れ
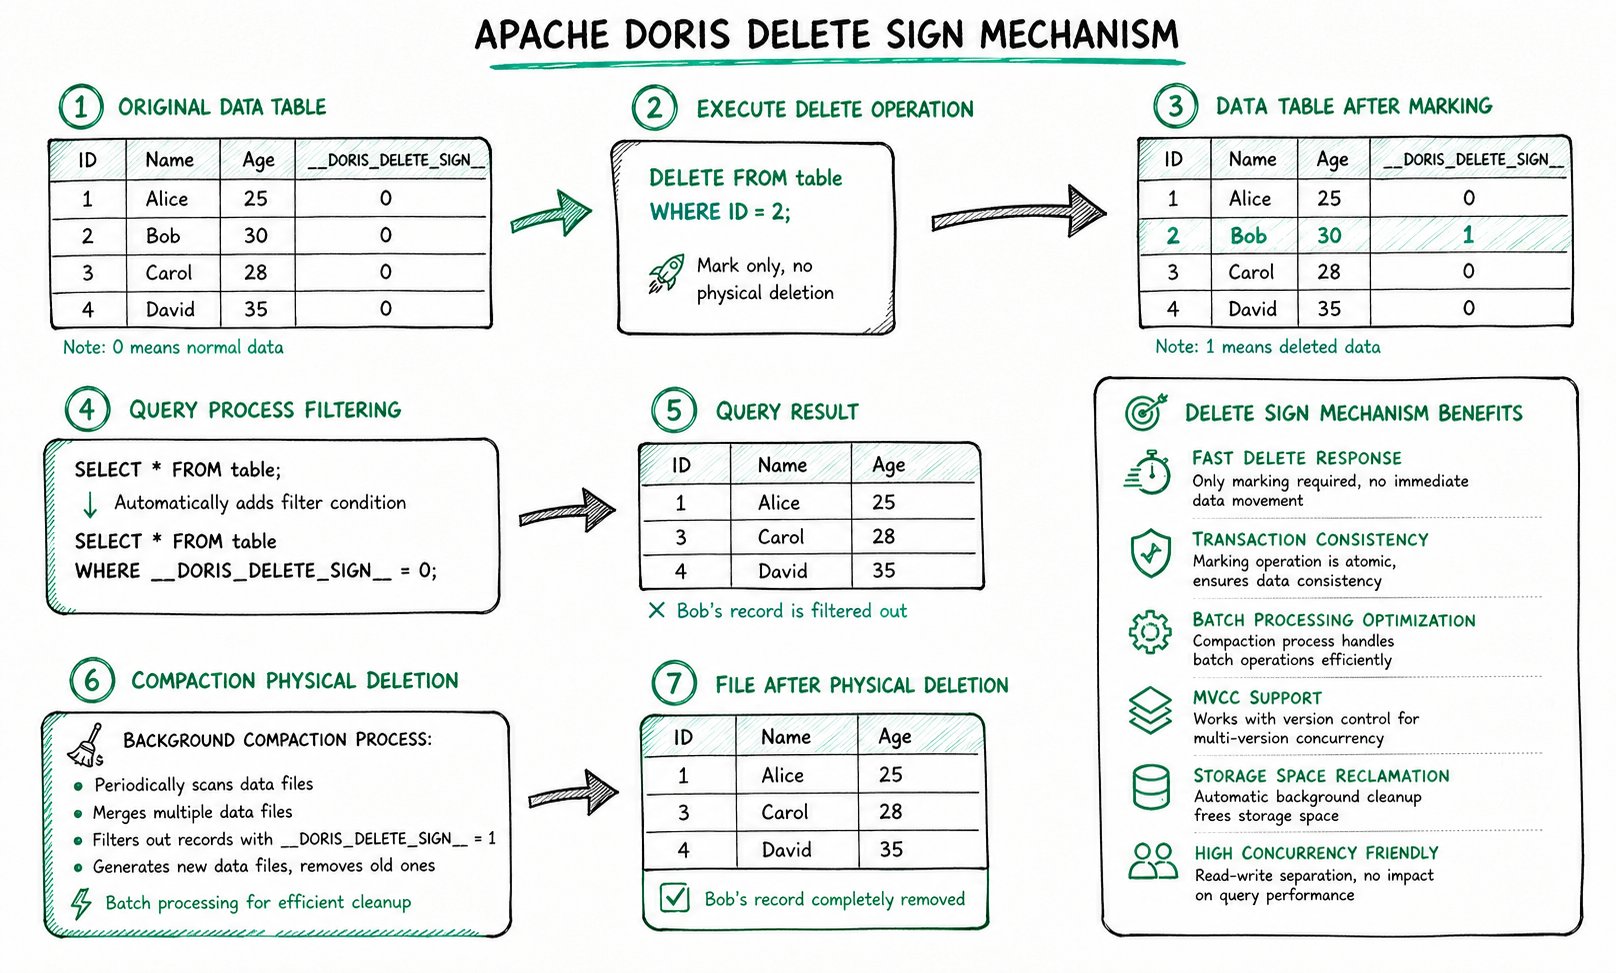
__DORIS_DELETE_SIGN__ は「論理的なマーカーを付け、バックグラウンドでクリーンアップする」方式で、次の三段階に分かれます。
- 削除の実行:取り込みまたは
DELETE文でデータを削除すると、Doris は物理ファイルからデータをすぐには取り除きません。代わりに、__DORIS_DELETE_SIGN__を1に設定した新しいレコードを書き込みます。 - クエリ時のフィルタリング:クエリ時に Doris はフィルター条件
WHERE __DORIS_DELETE_SIGN__ = 0を自動的に追加し、削除済みの行を結果から除外します。 - バックグラウンドの Compaction:ある主キーに通常のレコードと削除マーカー付きのレコードの両方があることを Compaction 処理が検出すると、マージ時に両方を物理的に削除してストレージ領域を解放します。
2.4 部分列更新
バージョン 2.0 以降、Unique Key モデル(MoW)は部分列更新に対応しています。取り込み時には、主キーと更新対象の列だけを指定します。指定していない列には元の値が保持されます。
有効化する方法:
| 取り込み方法 | 有効化するための設定 |
|---|---|
INSERT INTO | セッション変数 enable_unique_key_partial_update = true を設定する |
| Stream Load などの取り込み方法 | partial_columns パラメータを true に設定する |
テーブル作成時には、Merge-on-Write を有効にする必要があります。
CREATE TABLE user_profiles (
    user_id BIGINT,
    name STRING,
    age INT,
    last_login DATETIME
)
UNIQUE KEY(user_id)
DISTRIBUTED BY HASH(user_id)
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true"
);

-- Initial data
-- user_id: 1, name: 'Alice', age: 30, last_login: '2023-10-01 10:00:00'

-- Partial update via Stream Load, writing only age and last_login
-- {"user_id": 1, "age": 31, "last_login": "2023-10-26 18:00:00"}

-- Data after update
-- user_id: 1, name: 'Alice', age: 31, last_login: '2023-10-26 18:00:00'
実装上、Unique Key モデルの部分列更新は、その場で値を書き換える更新ではありません。取り込み時に既存の列を読み取り、省略されたフィールドを補完してから、行全体を書き直します。このため、読み取りと書き込みが増幅されます。たとえば、各フィールドのサイズがほぼ同じ 100 列のワイドテーブルで 10 フィールドを更新する場合、実際の更新データが 1 MB でも、約 9 MB のデータ読み取りと 10 MB のデータ書き込みが発生します。
パフォーマンスに関する推奨事項:
| 推奨事項 | 説明 |
|---|---|
| SSD を使用する | 部分列更新ではランダム IO が大量に発生します。HDD ではボトルネックが大きいため、SSD(可能であれば NVMe)を推奨します |
| ワイドテーブルで行ストアを有効にする | 非常に幅の広いテーブルでは行ストアを有効にすると、一回の IO で行全体を読み取れます。列ストアでは、省略されたフィールドごとに別々の IO が必要です |
Stream Load、INSERT INTO、Flink Connector などを使用する方法の詳細は、列の更新を参照してください。
3. 代表的な業務シナリオ
3.1 リアルタイム CDC 同期
Flink CDC などのツールは、上流データベース(MySQL、PostgreSQL、Oracle など)の Binlog を取得し、Doris の Unique Key モデルのテーブルに書き込みます。
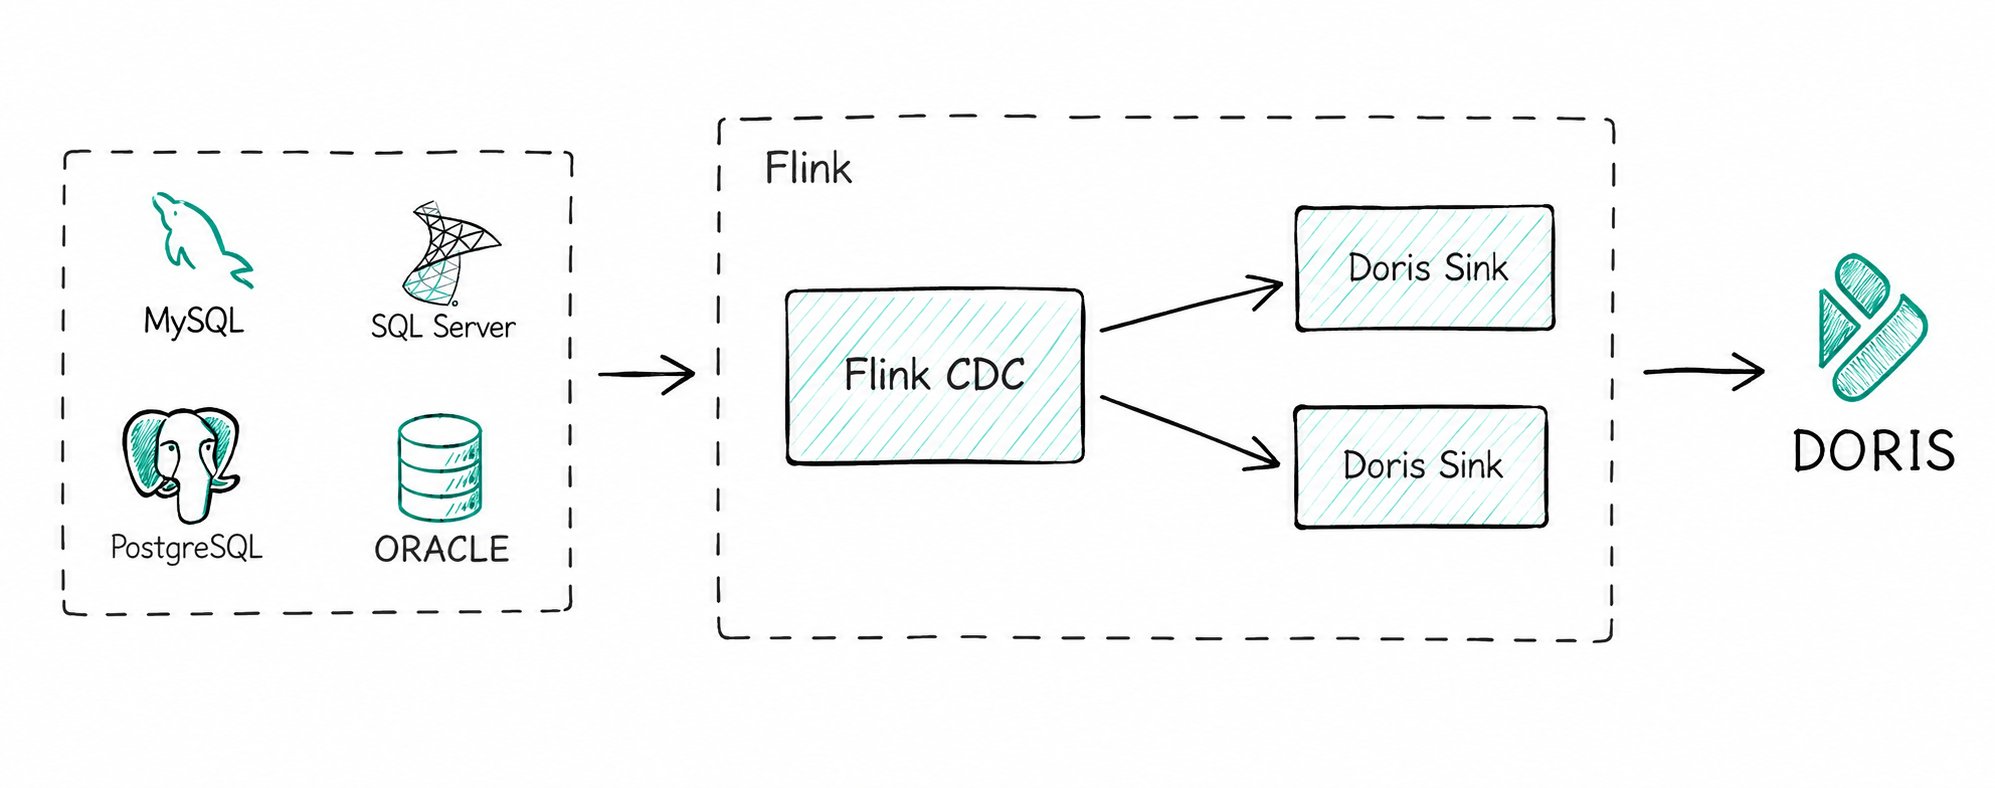
主な機能:
- データベース全体の同期:Flink Doris Connector には Flink CDC が内部で統合されており、テーブルの手動作成やフィールドのマッピングを行わずに、データベース全体をエンドツーエンドで同期できます。
- 整合性の保証:次の機能を組み合わせて、上流データベースの状態と一致させます。
- Unique Key モデルの UPSERT で
INSERT/UPDATEを処理します。 __DORIS_DELETE_SIGN__でDELETEを処理します。- Sequence 列(Binlog のタイムスタンプなど)で順序が入れ替わったデータを処理します。
- Unique Key モデルの UPSERT で
3.2 リアルタイムのワイドテーブル構築
部分列更新を使用すると、Flink でリアルタイム JOIN を行わずに、複数ソースからのワイドテーブル構築を Doris 内で直接完結できます。
- Unique Key モデルのワイドテーブルを作成します。
- 異なるデータソース(基本情報、行動ログ、取引データなど)から、Stream Load / Routine Load を使用してリアルタイムで書き込みます。
- 各データストリームは、担当する列のみを書き込みます。たとえば、次のようにします。
- ユーザー行動ストリームは
page_view_countとlast_login_timeを更新します。 - 取引ストリームは
total_ordersとtotal_amountを更新します。
- ユーザー行動ストリームは
各ストリームが変更された列だけを書き込むことで、IO の負荷を軽減し、リアルタイム JOIN のリソース消費を避けられます。複数ストリームの並行実行時のバージョン管理については、Unique Key モデルにおける複数ストリームからの更新を参照してください。
4. 利用上の推奨事項
4.1 一般的な推奨事項
| 番号 | 推奨事項 | 説明 |
|---|---|---|
| 1 | 取り込みによる更新を優先する | 高頻度かつ大量の更新では、UPDATE DML より Stream Load や Routine Load を優先します |
| 2 | 書き込みをバッチ化する | 単一行の INSERT を高頻度(> 100 TPS)で実行することは避けてください。INSERT ごとにトランザクションのオーバーヘッドが発生します。Group Commit を有効にすると、小規模バッチのコミットをまとめられます |
| 3 | Duplicate/Aggregate モデルでの高頻度な DELETE に注意する | 削除条件が蓄積すると、その後のクエリ性能に影響します |
| 4 | パーティション全体の削除には TRUNCATE PARTITION を使用する | パーティション全体を削除する場合、TRUNCATE PARTITION は DELETE よりはるかに効率的です |
| 5 | UPDATE を逐次実行する | 同じ主キーに作用する可能性のある UPDATE タスクの並行実行を避けてください |
4.2 コンピュートとストレージを分離したアーキテクチャにおける Unique Key モデル
Doris 3.0 では、コンピュートとストレージを分離したアーキテクチャが導入されました。このアーキテクチャでは BE はステートレスです。Merge-on-Write は、取り込み、Compaction、Schema Change の間で書き込み競合を解決するために、Meta Service を通じてグローバルな状態を維持する必要があります。Unique Key モデルの MoW は、書き込みの整合性を保証するために、Meta Service に基づく分散テーブルロックを使用します。
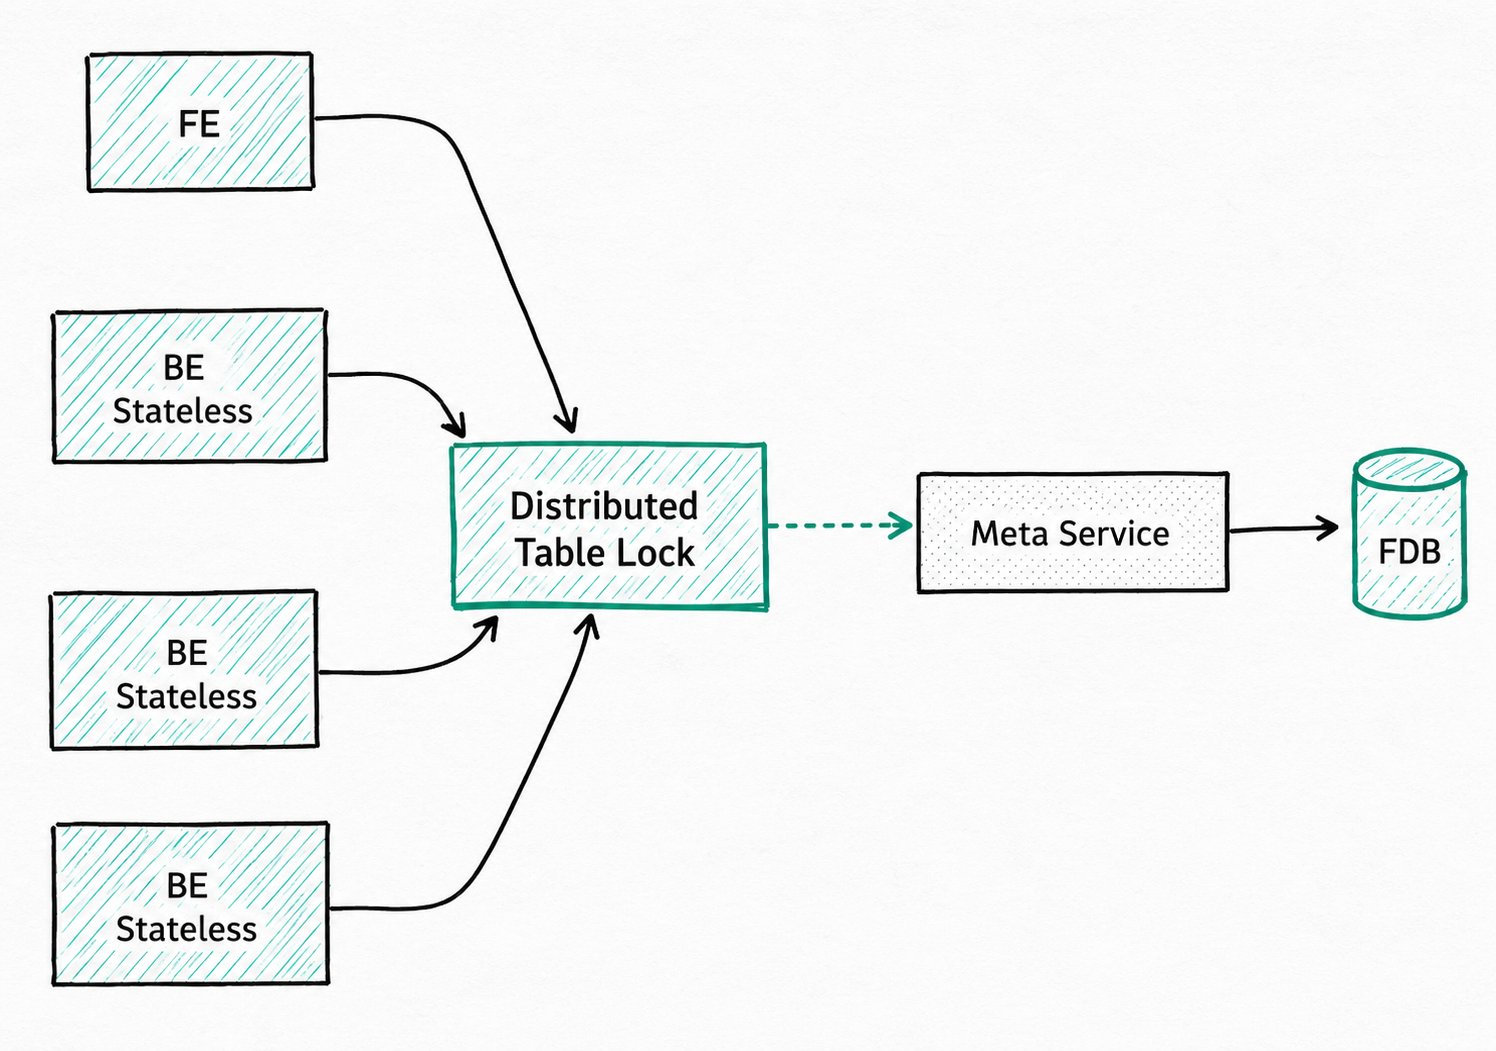
高頻度の取り込みと Compaction によって、テーブルロックの競合が発生することがあります。このアーキテクチャでは、次を推奨します。
- 単一テーブルへの取り込み頻度を制御する:単一の Unique Key テーブルへの取り込み頻度は、毎秒 60 回を超えないようにすることを推奨します。バッチ化や並行度の調整によって頻度を下げられます。
- パーティションとバケットを適切に設計する:
- パーティション:時間単位のパーティション(日単位または時間単位)を使用し、各取り込みで更新するパーティション数を少なくします。
- バケット:バケット数(Tablet 数)はデータ量に合わせ、通常は 8~64 個にします。Tablet が多すぎるとロック競合が悪化します。
- Compaction の方針を調整する:書き込み負荷が高い場合は Compaction の頻度を下げ、取り込みタスクとのロック競合を軽減します。
- 新しいバージョンを使用する:バージョン 3.1 では分散テーブルロックの実装が大きく最適化されています。最新の安定版の使用を推奨します。