埋め込み(Embedding)
要約 Apache Doris には、テキスト(または画像、動画、音声ファイル)を外部の埋め込みモデルに送る組み込み SQL 関数
EMBED()があります。結果はARRAY<FLOAT>で返され、列への格納や距離関数に使用できます。モデルを AIRESOURCEとして一度設定すれば、値を指定できる場所ならどこでもEMBED('your text')を使用できます。UDF、クライアント側の連携コード、別途運用するサービスは不要です。
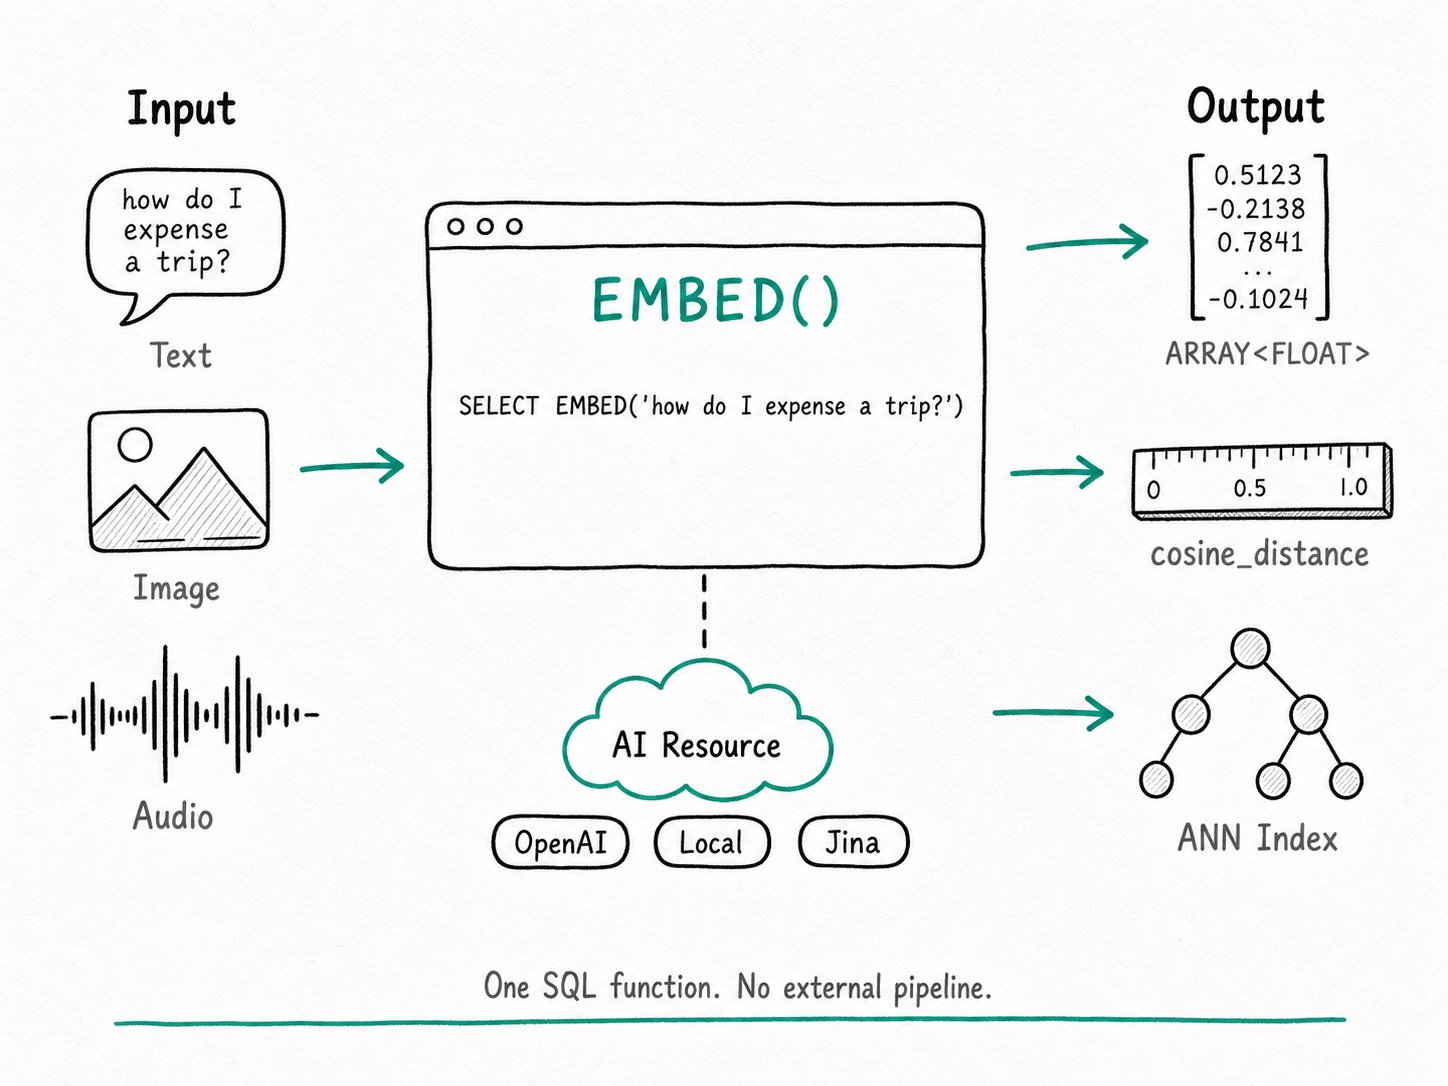
Apache Doris で EMBED 関数を使う理由
Apache Doris の EMBED() 関数を使うと、通常はアプリケーション側にある埋め込み生成の処理を 一回の SQL 呼び出しにまとめられます。別の ETL サービスを使わずに、データベース内でベクトルを生成、保存、検索できます。ベクトル検索にはベクトルが必要であり、ベクトルは埋め込みモデルから得られます。通常は、アプリケーションサーバーがデータベースから行を取り出し、OpenAI またはローカルモデルに送信してベクトルを受け取り、ベクトルテーブルに書き込みます。検索時にも、検索文字列について同じ往復処理が発生します。その結果、HTTP API を呼び出して結果を保存するためだけの小さな ETL サービスを維持することになります。
この構成では、次のような問題が起こりがちです。
- パイプラインが元のテーブルと同期しなくなります。新しい行は次回のバッチ実行まで埋め込みがない状態になります。
- 既存データへの埋め込みの追加は独立したジョブとなり、多くの場合、最初の取り込みより時間も費用もかかります。
- 一つの論理的な処理を 二つのチームが分担します。データチームが行を、アプリケーションチームがベクトルを担当し、その間の問題を誰も担当しません。
EMBED() は、この一連の処理を SQL 内に戻します。モデルは Apache Doris のリソースとして登録し、関数で呼び出します。結果は INSERT で列に保存することも、その場で計算することもできます。
Apache Doris の EMBED 関数とは
Apache Doris の EMBED() 関数は組み込みの AI 関数です。テキストまたはマルチモーダルファイルへの参照を受け取り、外部の埋め込みプロバイダーにベクトルの生成を要求して、ARRAY<FLOAT> を返します。Apache Doris は、CREATE RESOURCE で一度設定した AI リソースを通じてプロバイダーに接続します。同じ関数呼び出しをデータの読み込み時に使用して埋め込みを列に保存したり、クエリ時に使用してユーザーの検索文字列を SQL 内でその場で埋め込んだりできます。
主な用語
- AI リソース: 埋め込みプロバイダーへの名前付き接続です。
EMBED()にはopenai、gemini、voyageai、jina、qwen、minimax向けの専用アダプターと、社内のモデルサーバー向けのlocalオプションがあります。エンドポイント、モデル名、API キー、および省略可能な次元数を保持します。 EMBED([resource_name], input): SQL 関数です。引数が 一つの場合はセッションのデフォルトリソースを使用し、二つの場合は最初の引数でリソースを明示的に指定します。default_ai_resource: セッションの残りの期間に使用するリソースを選択するセッション変数です。- マルチモーダル入力: ファイル(URI、コンテンツタイプ、省略可能な S3 認証情報)を記述する JSON 値です。Apache Doris は署名付き S3 URL を生成し、画像、動画、音声の埋め込みに対応するプロバイダーへ転送します。
Apache Doris の EMBED 関数の仕組み
Apache Doris の EMBED() 関数は、AI リソースの登録、FE での呼び出しの計画、BE での行のバッチ化、失敗時の再試行、各行に対する ARRAY<FLOAT> の返却という 五段階で動作します。
- モデルを登録する。
CREATE RESOURCEは、プロバイダーの種類、エンドポイント、モデル名、認証情報を保存します。Apache Doris はプロバイダーへの試行呼び出しでリソースを検証します。ただし、provider_type = "local"の場合は検証をスキップします。 - 呼び出しを計画する。 プランナーが
EMBED()を検出すると、処理を BE に送ります。関数は入力列を行ごとに処理しますが、プロバイダーを行ごとに呼び出すわけではありません。 - BE でバッチ化する。 BE は行をバッチにまとめます。上限は
embed_max_batch_size(デフォルトは 5 入力)とai_context_window_size(蓄積したテキストのデフォルト上限は 128 KB)で決まります。各バッチは 一回の HTTP リクエストになり、往復回数と 一分あたりのレート制限の影響を抑えます。 - 再試行し、問題があれば明確に失敗させる。 プロバイダーへの呼び出しでは、リソースに指定された
ai.max_retriesとai.retry_delay_secondを使用します。API が返すベクトルの数が正しくない場合、行とベクトルの対応がずれるのを避けるため、Apache Doris はクエリを失敗させます。 - 列として返す。 各行にそれぞれの
ARRAY<FLOAT>が返されます。結果を保存したり、cosine_distanceに渡したり、ベクトル検索用の ANN インデックスに読み込んだりできます。
クイックスタート
CREATE RESOURCE "openai_embed" PROPERTIES (
  "type" = "ai", "ai.provider_type" = "openai",
  "ai.endpoint"   = "https://api.openai.com/v1/embeddings",
  "ai.model_name" = "text-embedding-3-small",
  "ai.api_key"    = "sk-xxx", "ai.dimensions" = "8"
);

SET default_ai_resource = "openai_embed";

CREATE TABLE notes (id INT, body STRING, vec ARRAY<FLOAT>)
  DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO notes VALUES
  (1, 'travel reimbursement policy', EMBED('travel reimbursement policy')),
  (2, 'VPN setup guide',             EMBED('VPN setup guide'));

SELECT id, body, cosine_distance(vec, EMBED('how do I expense a trip?')) AS d
FROM notes ORDER BY d ASC LIMIT 1;
想定される結果
+----+-----------------------------+--------+
| id | body                        | d      |
+----+-----------------------------+--------+
|  1 | travel reimbursement policy | 0.4463 |
+----+-----------------------------+--------+
INSERT は各行のベクトルを事前に計算します。SELECT はクエリ文字列を実行時に一度埋め込み、コサイン距離で行を並べ替えます。API 呼び出しは合計 二回で、どちらも SQL 内で処理されます。
マルチモーダル入力のクイックスタート
マルチモーダル埋め込みでは、テキスト文字列の代わりに JSON オブジェクトを渡します。オブジェクトにはファイルの uri と MIME タイプを示す content_type が必要です。URI には HTTP または HTTPS URL、もしくは S3 互換 URI を指定できます。設定したプロバイダーとモデルが入力メディアの種類に対応していることを確認してください。
次の例では、S3 互換オブジェクトストレージに保存された動画の埋め込みを生成します。
SELECT ARRAY_SIZE(
  EMBED(
    'multimodal_embed_resource',
    CAST('{
      "uri": "s3://example-bucket/videos/demo.mp4",
      "content_type": "video/mp4",
      "endpoint": "s3.us-east-1.amazonaws.com",
      "region": "us-east-1",
      "ak": "<access_key>",
      "sk": "<secret_key>"
    }' AS JSON)
  )
) AS video_embedding_dimension;
実行結果の例
+---------------------------+
| video_embedding_dimension |
+---------------------------+
|                      2560 |
+---------------------------+
ベクトルの次元数は設定したプロバイダーとモデルによって異なるため、上記の結果は一例です。HTTP または HTTPS URL の場合、必要なのは uri と content_type だけです。S3 互換 URI の場合、Doris は署名付き URL を生成し、AK/SK 認証情報、または role_arn と external_id を使用する IAM ロール認証に対応します。
Apache Doris の EMBED 関数を使うべき場面
Apache Doris の EMBED() 関数は、データがすでに Apache Doris にあるコーパスを対象とした RAG やセマンティック検索、処理を SQL 内で完結させる既存データへの埋め込みの追加、ベクトルとキーワードフィルターを組み合わせるハイブリッドパイプライン、S3 にあるファイルのマルチモーダル埋め込みに適しています。大量の行を対象とする実行頻度の高い処理で行ごとに埋め込みを生成する場合、対応プロバイダーの一覧にないモデルを使用する場合、プロバイダーへの接続経路がないネットワーク隔離されたクラスターには適していません。
適している用途
- コーパスがすでに Apache Doris にあり、取り込み、埋め込み生成、検索を 一つのシステムで処理したい場合の RAG やセマンティック検索。
- 既存テーブルの埋め込みを後から生成する処理。
UPDATE t SET vec = EMBED(body) WHERE vec IS NULLにより、処理をデータベース内で完結できます。 EMBED()を保存用の ANN インデックスやキーワードフィルタリング用のMATCH_*述語と組み合わせるハイブリッドパイプライン。詳しくはハイブリッド検索を参照してください。- ファイルが S3 にあり、ダウンロードしてからアップロードするスクリプトを書きたくない場合のマルチモーダル埋め込み(画像、動画、音声)。
適していない用途
- 数百万行のそれぞれについて埋め込みを生成するリアルタイムクエリ。各行でプロバイダー呼び出しが 一回発生するため、料金とレイテンシーは行数に応じて増加します。一度事前計算して、繰り返し利用してください。
- 対応プロバイダーの一覧にない特定の埋め込みモデルが必要なワークロード。埋め込みアダプターを持つプロバイダーは OpenAI、Gemini、VoyageAI、Jina、Qwen、MiniMax、および社内モデルサーバー用の
localです。Apache Doris の AI リソースには DeepSeek、MoonShot、Anthropic、Zhipu、Baichuan も指定できますが、これらは LLM SQL 関数で使用するもので、チャットと補完にのみ対応し、EMBED()には対応しません。埋め込みアダプターに含まれないモデルを接続するには、OpenAI または Gemini と互換性のある API を公開する必要があります。 - プロバイダーへの接続経路がないネットワーク隔離されたクラスター。社内モデルサーバーに対して
provider_type = "local"を使用するか、独自のパイプラインでベクトルを事前計算してください。 - 埋め込みモデルの次元数と ANN インデックスの次元数が一致しない列。ARRAY の長さはモデル(または次元数の切り詰めを許すモデルでは
ai.dimensions)で決まり、インデックスの次元数はテーブル作成時に固定されます。一致しない場合は書き込み時に失敗します。
コストとスループットに関する注意点
EMBED() の処理速度は背後にあるプロバイダーに左右されます。実行頻度の高い処理で EMBED() を使う前に、次の点を確認してください。
- 外部 API にはレート制限があります。
embed_max_batch_sizeを増やすと往復回数は減りますが、一回のリクエストに含まれるトークン数が増えるため、両方を考慮して調整してください。 - 入力が
ai_context_window_sizeを超える行は自動的に単独のバッチになるため、サイズの大きいドキュメントが 一つあってもクエリの残りの処理を妨げません。 - プロバイダーは行数ではなく入力トークン数に応じて課金します。同じテキストを 二回埋め込むと、費用も 二回分かかります。ベクトルを複数回読み取るなら保存してください。
localプロバイダーでは認証情報の検証をスキップし、ネットワーク内で実行します。トークン単位の課金はなくなりますが、推論サーバーを運用する必要があります。
関連資料
- EMBED 関数のリファレンス: 完全な構文、マルチモーダル JSON 入力、距離ごとの例を説明します。
- AI 関数の概要: 対応するすべてのプロバイダーと
CREATE RESOURCEの全プロパティを説明します。 - ハイブリッド検索: 一つのクエリで
EMBED()、全文検索述語、ANN インデックスを組み合わせる方法を説明します。 - ベクトルインデックスの概要: HNSW または IVF を使用して、ANN 検索向けに埋め込みを保存する方法を説明します。
- 転置インデックス: ハイブリッドクエリでベクトルによる順位付けを行う前に、行を絞り込むためのインデックスを説明します。
- Reciprocal Rank Fusion: 埋め込みを用意した後に BM25 とベクトルの順位を統合する方法を説明します。
- LLM SQL 関数:
EMBED()とAI_*系の関数は同じ AI リソースモデルを共有します。こちらでは、AI SQL のもう一方の機能群を説明します。 - Doris の AI 機能: 分類、生成、行をまたぐ集計など、その他の AI 関数を説明します。
