転置インデックス
要点 Apache Doris の転置インデックスは、
INDEX ... USING INVERTEDで任意のカラムに定義できる、CLucene ベースのセカンダリインデックスです。行をスキャンする代わりにポスティングリストを読み取ることで、等価、範囲、IN、IS NULL、配列の要素判定、全文検索のMATCH_*条件を高速化します。Apache Doris 2.0 から利用できます。
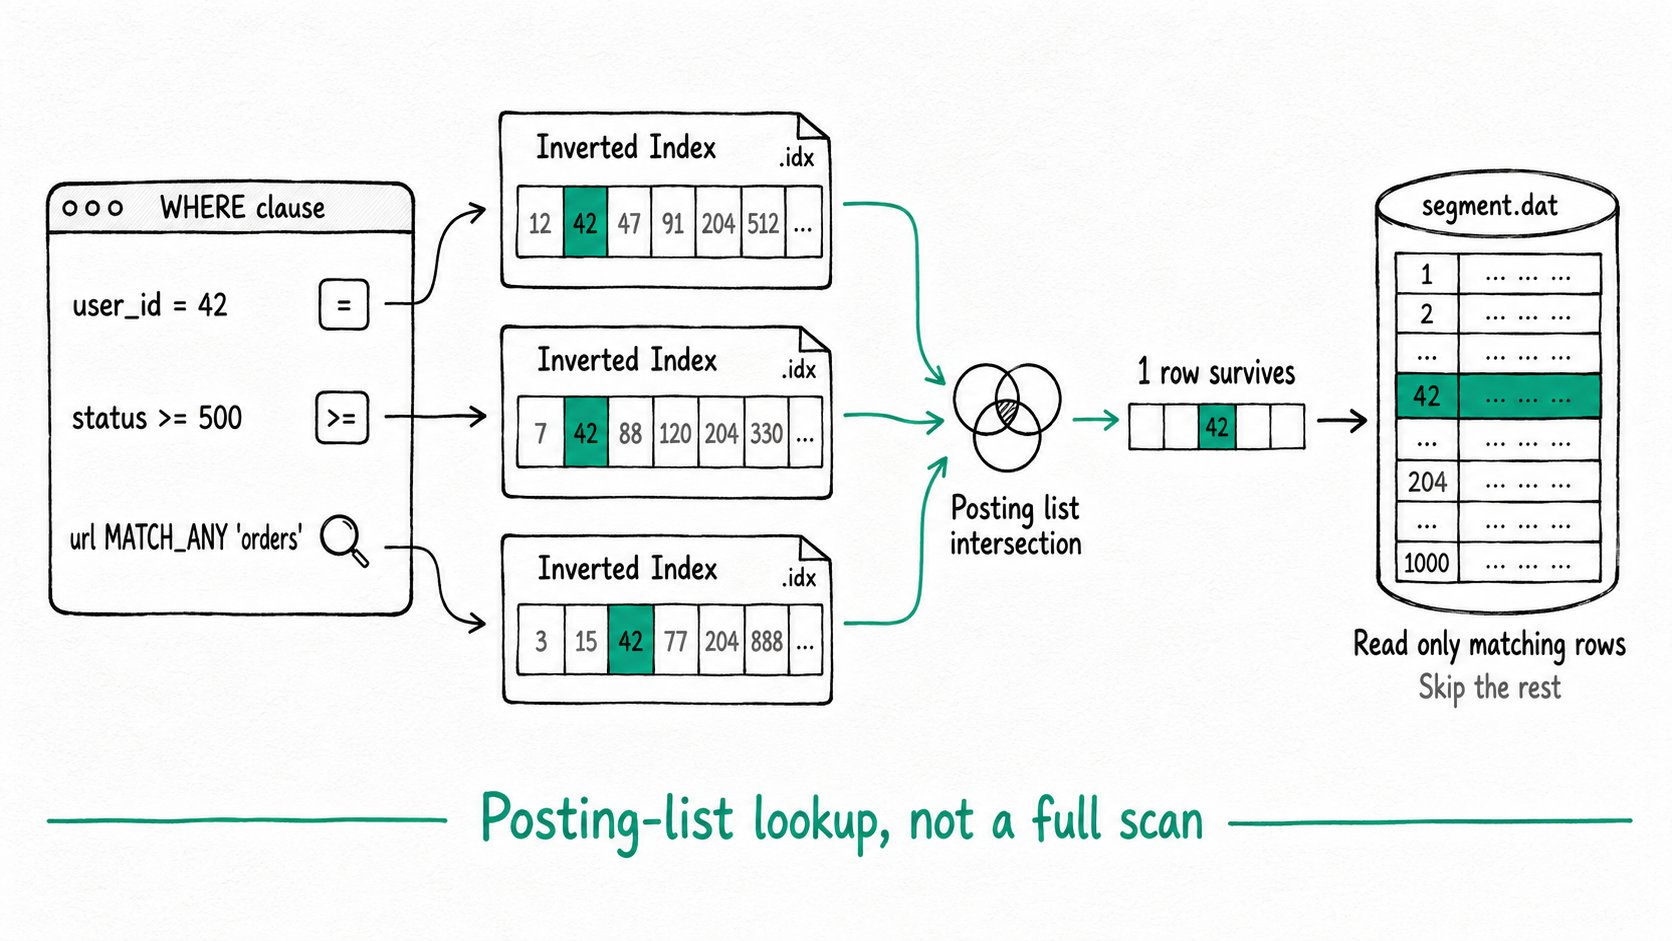
Apache Doris で転置インデックスを使う理由
Apache Doris の転置インデックスは、OLAP クエリで大きなコストを占める WHERE 条件の評価を、全件スキャンからポスティングリストの参照に変えます。たとえば、2 TB のイベントテーブルで user_id の条件、request_time の範囲条件、url のキーワード検索を指定する場合、転置インデックスがなければ、絞り込み後に残ったすべてのセグメントの各行について、各カラムをデコードする必要があります。通常の代替策である増分マテリアライズドビューや別の検索クラスタでは、ストレージと運用のコストが倍になります。
特にコストが高いのは、次のケースです。
- 高カーディナリティのカラムに対する等価検索(
WHERE order_id = ?)では、セグメントを低コストで除外する手段がないため、タブレット全体をスキャンします。 - 数値または日時カラムの範囲フィルタ(
WHERE event_time BETWEEN ...)では、ZoneMap の最小値と最大値でしか絞り込めず、範囲内のすべてのページにアクセスします。 - テキストカラムのキーワード検索は、基本的な SQL エンジンでは対応できません。
LIKE '%term%'はスキャンにフォールバックし、データを Elasticsearch に送る場合は、同期を維持するための追加のパイプラインが必要です。
Apache Doris の転置インデックスなら、同じ DDL でこれらすべてに対応できます。
Apache Doris の転置インデックスとは
Apache Doris の転置インデックスは、各値、またはテキストカラムをトークン化した各単語を、それを含む行 ID の集合に対応付けるカラム単位のセカンダリインデックスです。Lucene の C++ 移植版である CLucene を基盤とし、Apache Doris のカラムナストレージおよびベクトル化実行と完全に統合されています。
転置インデックスは、DDL で INDEX <name>(<col>) USING INVERTED [PROPERTIES(...)] と指定して定義します。対応するカラム型には、整数型、DECIMAL、DATE、DATETIME、TIMESTAMP_NS、IPV4、IPV6、CHAR/VARCHAR/STRING、およびこれらを要素とする ARRAY<T> が含まれます。テキストカラムでは、トークン化を制御する parser を指定できます。
主な用語
Posting list(ポスティングリスト): 値または単語に対応する行 ID の集合です。条件の評価は、ポスティングリストの参照と集合演算(AND/OR/NOT)になります。Parser(パーサー): テキストカラムに使用するトークナイザーです。組み込みの選択肢にはnone(文字列全体を扱う、デフォルト)、english、chinese、kuromoji(日本語、5.0.0 以降)、unicode、standardがあり、3.1 以降はカスタムアナライザーも使用できます。MATCH operators(MATCH 演算子):MATCH_ANY(いずれかの単語)、MATCH_ALL(すべての単語)、MATCH_PHRASE(隣接する単語)、MATCH_PHRASE_PREFIX、MATCH_REGEXPです。これらにはパーサーを設定した転置インデックスが必要ですが、通常の=とLIKEには必要ありません。.idx file(.idx ファイル): ディスク上のインデックスデータです。タブレットディレクトリ内では、各セグメントファイルの隣に単一の.idxファイルが存在します。そのため、インデックスはセグメントに紐づき、コンパクション時には行セットとともに処理されます。
Apache Doris の転置インデックスの仕組み
Apache Doris の転置インデックスは、対象のセグメントと同じ場所に保持され、書き込み時に一度構築してクエリ時に繰り返し参照します。
- 書き込み時に構築する。 行セットがフラッシュされると、BE は CLucene 形式のインデックスを、セグメントと同じ場所の
.idxファイルに書き込みます。セグメント内の各行は CLucene のDocIDと 1:1 で対応するため、行とドキュメントの対応表を別途管理する必要はありません。 - クエリ時に処理経路を選ぶ。 プランナーがプッシュダウンした条件について、BE はまず転置インデックスを参照します。構築時と同じパーサーで条件のリテラルをトークン化し、単語辞書をたどってポスティングリストを読み取ります。
- 集合演算で結果を組み合わせる。 条件間の
AND、OR、NOTは、カラムデータにアクセスせずに、ポスティングリストの積集合、和集合、補集合として処理されます。 - 行のビットマップをスキャナーに渡す。 スキャナーは、絞り込み後に残った行だけをカラムナストアから読み取ります。ZoneMap、BloomFilter、転置インデックスの結果は組み合わせて使用でき、それぞれが後続の処理対象を減らします。
- セグメント単位に保つ。 インデックスはセグメントと同じ場所にあるため、コンパクションではデータとともにマージされ、リモートストレージへの階層化でもデータとともに移動します。再構築が必要なグローバルインデックスはありません。
クイックスタート
CREATE TABLE access_log (
  ts        DATETIME    NOT NULL,
  user_id   BIGINT      NOT NULL,
  status    INT         NOT NULL,
  url       STRING      NOT NULL,
  INDEX idx_user(user_id)  USING INVERTED,
  INDEX idx_status(status) USING INVERTED,
  INDEX idx_url(url) USING INVERTED PROPERTIES("parser"="english")
) DUPLICATE KEY(ts) DISTRIBUTED BY HASH(user_id) BUCKETS 4;

INSERT INTO access_log VALUES
  ('2026-05-01 10:00:00', 42, 200, '/api/orders/list'),
  ('2026-05-01 10:01:00', 42, 500, '/api/orders/create'),
  ('2026-05-01 10:02:00', 99, 200, '/api/users/profile');

SELECT user_id, status, url FROM access_log
WHERE user_id = 42 AND status >= 500 AND url MATCH_ANY 'orders';
期待される結果
+---------+--------+---------------------+
| user_id | status | url                 |
+---------+--------+---------------------+
|      42 |    500 | /api/orders/create  |
+---------+--------+---------------------+
各条件はインデックスの参照によって評価されます。user_id = 42 と status >= 500 は、等価検索と範囲検索に転置インデックスを使用します。url MATCH_ANY 'orders' は english パーサーでカラムをトークン化し、orders のポスティングリストを参照します。スキャナーが読み取るのは、三つのポスティングリストの AND 演算で残った一行だけです。
Apache Doris の転置インデックスを使うべき場面
Apache Doris の転置インデックスは、高カーディナリティの条件、テキストや配列の検索、ZoneMap による絞り込みだけでは粗すぎるカラムで効果を発揮します。
適しているケース
- キーカラム以外での高カーディナリティの等価条件や
IN条件:order_id、trace_id、device_id。 - ZoneMap だけでは十分に絞り込めない範囲フィルタや
BETWEENフィルタを、数値カラムまたはDATETIMEカラムに適用する場合。 - NULL 値がまばらなカラムの
IS NULL/IS NOT NULL: インデックスは NULL を記録し、O(1) で参照します。 - ログ、ドキュメント、コンテンツのカラムに対するキーワード検索やフレーズ検索。演算子については全文検索、関連度順の並べ替えについては BM25 スコアリングを参照してください。
- 配列の要素判定条件:
array_contains(tags, 'x')、array_overlaps(tags, ['a','b'])。
適していないケース
- 先頭にワイルドカードがある
LIKE '%abc%'。転置インデックスは部分文字列に対するLIKEを高速化しません。代わりに NGram BloomFilter インデックスを使用してください。 - テーブルで最も頻繁にフィルタに使うカラム。プレフィックスインデックスを使用できるようにキーカラムにすると、より密度が高く、追加コストのないインデックスを利用できます。
- 数百万行程度の小さなテーブル。全件スキャンが数ミリ秒で終わる場合、インデックスの参照コストを大きく上回る量のデータをスキップできなければ、導入効果はありません。
- 条件に一致する行がすでに大半を占めるカラム。ポスティングリストは短い場合に有利です。行の 80% が残るなら、スキャナーの処理量はどちらの場合も同じです。
- ストレージ容量に制約があるテーブル。幅の広いテキストカラムの転置インデックスは、カラム自体に匹敵するサイズになることがあります。テキスト検索よりも容量を重視するなら、BloomFilter インデックスを使用してください。
関連資料
- 転置インデックスのユーザーガイド: DDL の完全な構文、パーサーの選択肢、管理コマンド。
- 検索演算子リファレンス: すべての
MATCH_*演算子と使用例。 - インデックスの概要: 転置インデックスとプレフィックス、ZoneMap、BloomFilter、NGram BloomFilter の各インデックスの比較。
- 全文検索: このインデックスを基盤とするトークナイザー、フレーズクエリ、
SEARCH()DSL。 - BM25 関連度スコアリング:
score()による一致結果のランキング。4.0 から利用できます。 - ハイブリッド検索: 単一の SQL クエリで転置インデックスと ANN ベクトルインデックスを組み合わせる方法。
- Apache Doris の転置インデックスの仕組み: 内部構造とベンチマークの詳細な解説。
