VARIANT データ型
要約 Apache Doris の
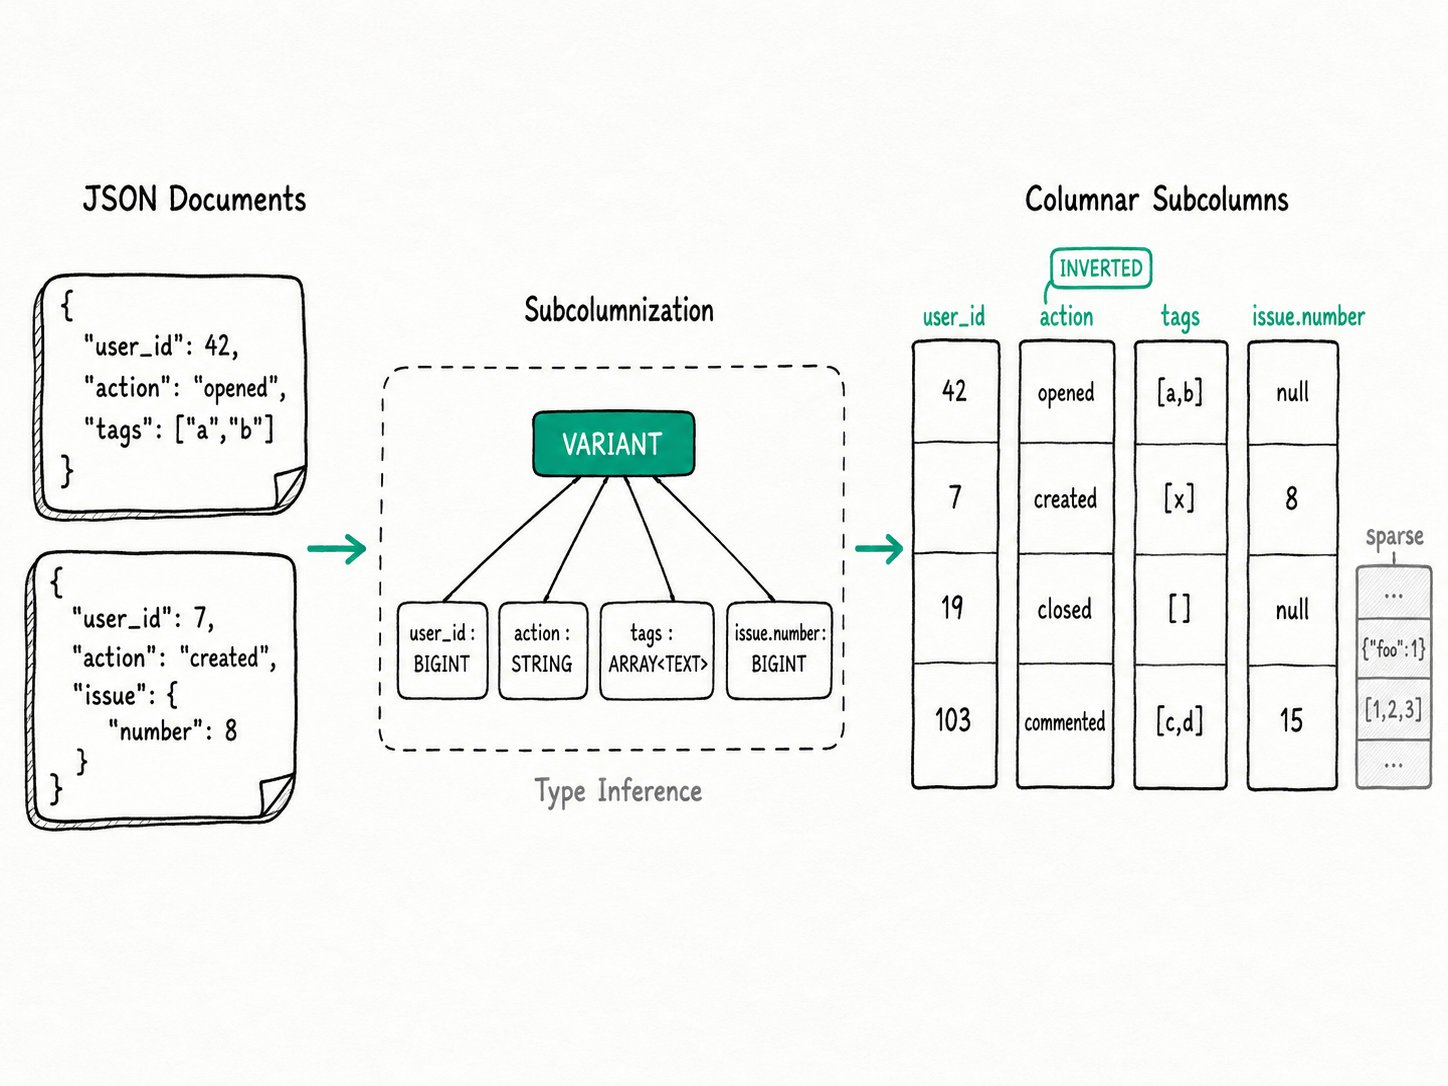
VARIANTは、構造が時間とともに変化する JSON のためのカラム型です。書き込み時に各ドキュメントを解析し、JSON パスごとに型を推論して、頻繁に参照されるパスを独立した列指向サブカラムとして保存します。VARIANT カラムあたりのサブカラム数は、デフォルトで最大 2048 個です。そのため、v['user_id']に対するフィルタリングや集計では、ドキュメント全体を解析する代わりに一つのカラムを読み取ります。VARIANT は Snowflake と ClickHouse に着想を得ており、Apache Doris 2.1.0(2024 年三月)で GA となりました。
Apache Doris で VARIANT データ型を使う理由
Apache Doris の VARIANT データ型は、柔軟な JSON ストレージと列指向ストレージのクエリ速度という、従来の二者択一を解消します。OLAP システムに JSON を保存するには、長らくどちらかを犠牲にする必要がありました。
STRINGまたはJSONBカラムなら柔軟に保存できますが、パスを参照するクエリのたびにドキュメント全体を解析します。十億行に対するWHERE payload['action'] = 'opened'では、actionが大きなドキュメント内の短いフィールドであっても、すべてのペイロードを隅々まで読み取ります。- 静的カラムは高速ですが、スキーマが安定している場合に限ります。データの生成元が次の開発サイクルでフィールドを追加すると、
ALTER TABLEによる移行か、JSON を格納する補助カラムが再び必要になります。
Apache Doris の VARIANT なら、この二者択一は不要です。一つのカラムを宣言して JSON を書き込むと、Apache Doris は頻繁に参照されるパスを実際の列指向ストレージに変換します。クエリは SQL のまま実行でき、ディスク上では手動で設計したテーブルに近い形で保存されます。
Apache Doris の VARIANT データ型とは
Apache Doris の VARIANT データ型は、半構造化データ用のカラム型です。VARIANT は、スカラー、配列、ネストしたオブジェクトなど、有効な JSON 値を受け付けます。行が到着すると、書き込み側はパスのプレフィックスツリーを構築し、パスごとに型を推論して、各パスをセグメント内のページエンコードとページインデックスを備えた独立したカラムとして書き込みます。クエリでは JSON を扱い、ディスク上ではパスごとに一つのサブカラムが得られます。
主な用語
Subcolumn(サブカラム):JSON パスから生成される、ディスク上の独立したカラムです。静的カラムと同様に、各サブカラムには独自のエンコーディング、圧縮、ゾーンマップ、Bloom フィルタがあります。Subcolumnization(サブカラム化):書き込み時に頻繁に参照されるパスを JSON からサブカラムに昇格させる処理です。variant_max_subcolumns_countで制御し、デフォルト値は2048です。Schema Template(スキーマテンプレート):選択したパスを固定型に指定する、省略可能なVARIANT<'path' : TYPE, ...>句です。ロードをまたいでストレージとインデックスを安定させます。Sparse column(スパースカラム):パス数がサブカラム数の上限を超えたとき、参照頻度の低いパスを格納する共有の退避先カラムです。多数の論理パスが一つの物理カラムを共有します。スパースシャーディングが有効な場合は、少数の物理カラムを共有します。Type promotion(型昇格):同じパスに、ある行ではINT、別の行ではSTRINGが入ったときの処理を決める規則です。幅の異なる整数型は拡張されます(TINYINTからBIGINTなど)。整数と倍精度浮動小数点数、数値と文字列など、それ以外の型の衝突はJSONBにフォールバックします。
Apache Doris の VARIANT データ型の仕組み
Apache Doris の VARIANT は、書き込み時に各 JSON ドキュメントを解析し、JSON パスごとに型を推論して、出現頻度の高いパスを独立した列指向サブカラムに保存します。参照頻度の低いパスは、共有のスパースカラムに格納されます。ディスク上での一つのパスの処理は、次のように進みます。
- 解析と推論。 JSON がメモリテーブルに入ると、書き込み側はすべてのリーフパスをプレフィックスツリーに追加し、パスごとに一つの保存型を選びます。整数には
BIGINT、小数にはDOUBLE、ほかにSTRING、BOOLEAN、スカラー値の配列にはARRAY<T>を選びます。ネストしたオブジェクトは、さらに深いパスになります。 - 型昇格またはフォールバック。 新しい値が現在の型と合わない場合、Doris は可能であれば型を拡張します(幅の異なる整数型は
BIGINTになります)。それ以外の場合、たとえば整数と倍精度浮動小数点数や文字列が混在すると、そのパスはJSONBにフォールバックし、スキーマが修正されるまで、そのパスに対するクエリではプッシュダウンを利用できなくなります。 - サブカラムまたはスパースカラムへの書き込み。 null 以外の値の割合が高いパスは独立したサブカラムとなり、静的カラムと同じようにエンコード、圧縮されます。
variant_max_subcolumns_countの上限に達すると、残りの出現頻度の低いパスはスパースカラムにまとめられます。 - スキーマの統合。 各 rowset は、独自のサブカラムスキーマを記録します。Compaction は 最小共通カラムスキーマ を使って rowset を統合するため、今日新しいフィールドが追加されても
ALTER TABLEは不要です。 - パス単位の読み取り。
SELECT v['user_id']は一つのサブカラムに解決され、そのカラムだけを読み取ります。静的カラムと同様に、ゾーンマップと Bloom フィルタを使ってページをスキップします。述語もプッシュダウンされ、CAST(v['user_id'] AS BIGINT) = 42は JSON テキストではなく、型付きサブカラムに対して実行されます。
転置インデックスもサブパスに対して同じように機能します。INDEX idx_v(v) USING INVERTED PROPERTIES("parser" = "english") を指定すると、すべてのテキストサブカラムを検索できるようになり、スキーマテンプレートを使えば特定のパスにインデックスを固定できます。
クイックスタート
CREATE TABLE github_events (
  id          BIGINT,
  type        VARCHAR(30),
  payload     VARIANT,
  created_at  DATETIME,
  INDEX idx_payload (payload) USING INVERTED PROPERTIES("parser" = "english")
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 4
PROPERTIES ("storage_format" = "V3", "replication_num" = "1");

-- INSERT keeps a plain string as a VARIANT string, so parse the JSON text.
-- Load jobs such as Stream Load parse JSON automatically.
INSERT INTO github_events VALUES
  (1, 'PushEvent', PARSE_TO_VARIANT('{"action":"opened","commits":[{"sha":"abc"}],"size":4}'), '2026-05-01'),
  (2, 'IssueCommentEvent', PARSE_TO_VARIANT('{"action":"created","issue":{"number":42}}'), '2026-05-01');

SELECT CAST(payload['action'] AS STRING) AS action, COUNT(*) AS n
FROM github_events
WHERE payload['action'] MATCH 'opened'
GROUP BY action;
期待される結果
+--------+---+
| action | n |
+--------+---+
| opened | 1 |
+--------+---+
フィルタは一つのサブカラムを読み取り、転置インデックスを使用するため、commits 配列にはアクセスしません。SET describe_extend_variant_column = true; DESC github_events; を実行すると、推論されたサブカラム(payload.action、payload.commits、payload.issue.number など)を、手動で宣言したカラムのように確認できます。
Apache Doris の VARIANT データ型を使うべき場面
JSON スキーマが変化しても、ほとんどのクエリが少数の決まったパスを参照する場合は、Apache Doris の VARIANT を使います。構造が固定されている場合は静的カラムか STRUCT を使い、主キー、ソートキー、結合キーには型付きカラムを使います。
適しているケース
- ほとんどのクエリが少数の決まったパスを参照し、ドキュメントの残りの部分は付随的に保持するイベントログや監査用ペイロード。
- データの生成元がフィールドを追加し続けるため、スキーマ移行を待って取り込みを止められないテレメトリやユーザープロファイルのテーブル。
- 何千もの省略可能なタグを持つオブザーバビリティデータ。よく使うタグはサブカラムになり、参照頻度の低いタグは Compaction の負荷を不必要に増やさずにスパースカラムに格納されます。
VARIANTとUSING INVERTEDを組み合わせた、JSON 内の全文検索。
適していないケース
- スキーマが安定しており、内容が明確なテーブル。通常の型付きカラムは理解もインデックス作成も容易で、意図せず
JSONBに型昇格することもありません。実際にスキーマが変化する場合に限ってVARIANTを選びます。 - 主キー、ソートキー、結合キー。
VARIANTカラムをキーカラムにすることはできません。VARIANT の値も結合やソートに使用できますが、静的カラムより低速です。idが結合キーなら、静的なBIGINTカラムとして宣言します。 WHERE v LIKE '%doris%'のようなドキュメント全体の検索。転置インデックスはカラム全体ではなくサブパスに適用されます。元の JSON を別のSTRINGカラムにも保持してインデックスを作成するか、高速なSELECT vのために DOC モードを有効にします。- 設計時に構造が分かっているデータ。すべての行が必ず
{a, b, c}という構造で型も変わらないなら、STRUCTのほうが適切です。VARIANTは予期しないフィールドをそのまま取り込みますが、STRUCT 型はそれを許しません。 - チューニングせずに扱う、パス数が非常に多い JSON(10k+ パス)。デフォルトでは、サブカラム化の上限は 2048 パスです。それを超える場合は、スパースカラムか DOC モードの利用を計画し、本番データをロードする前に VARIANT ワークロードガイドを参照してください。
パフォーマンスと数値
- ClickBench、43 クエリを 16 コア / 64 GB の EC2 インスタンスで実行した結果:VARIANT の使用量は 12.7 GB、JSON は 35.7 GB(約 65% 削減)でした。ウォーム状態のクエリは JSON より約 8 倍高速で、事前定義した静的カラムとの差は約 10% 以内でした。出典:Apache Doris 2.1.0 の Variant。
- GuanceDB がオブザーバビリティデータを Elasticsearch から VARIANT を使う Doris に移行した結果:マシンコストが 70% 低下し、クエリ速度は全体で約 2 倍、単純なクエリでは 4 倍以上になりました。出典:同じ記事。
関連資料
- VARIANT の SQL リファレンス:完全な構文、型の規則、インデックス、設定
- VARIANT ワークロードガイド:デフォルト、スパース、DOC モード、スキーマテンプレートの選び方
- VARIANT データのインポート:Stream Load、Routine Load、Broker Load の例
- 列指向ストレージの機能紹介:サブカラムのエンコード、ページ化、インデックスの仕組み
- 転置インデックスの概要:VARIANT が JSON 内のテキスト検索に使用するインデックス
- LLM SQL 関数:
AI_*関数群は JSON を出力するため VARIANT カラムと相性がよく、AI_EXTRACTやAI_CLASSIFYなどが含まれます。 - Apache Doris ブログ:Apache Doris 2.1.0 の Variant の発表記事とベンチマーク
