BITMAP による厳密な重複排除
BITMAP による厳密な重複排除は、ビットマップデータ構造を使って COUNT DISTINCT を置き換え、大量のデータに対して高速に厳密な重複排除を行う機能です。COUNT DISTINCT と比較して、Bitmap による厳密な重複排除には次の利点があります。
- クエリが高速
- メモリとディスクの使用量が少ない
COUNT DISTINCT の仕組み
従来の厳密な重複排除では、count distinct を使用します。次のソースデータの name 列で厳密な重複排除を行う場合を考えます。
| id | name |
|---|---|
| 1 | bob |
| 2 | alex |
| 3 | jack |
| 4 | tom |
| 5 | bob |
| 6 | alex |
select count(distinct name) from t を実行すると、Doris は次の図のように結果を計算します。まず group by によって name 列の最初の重複排除を行い、次にデータをシャッフルして再度重複排除を行い、最後に count を計算します。
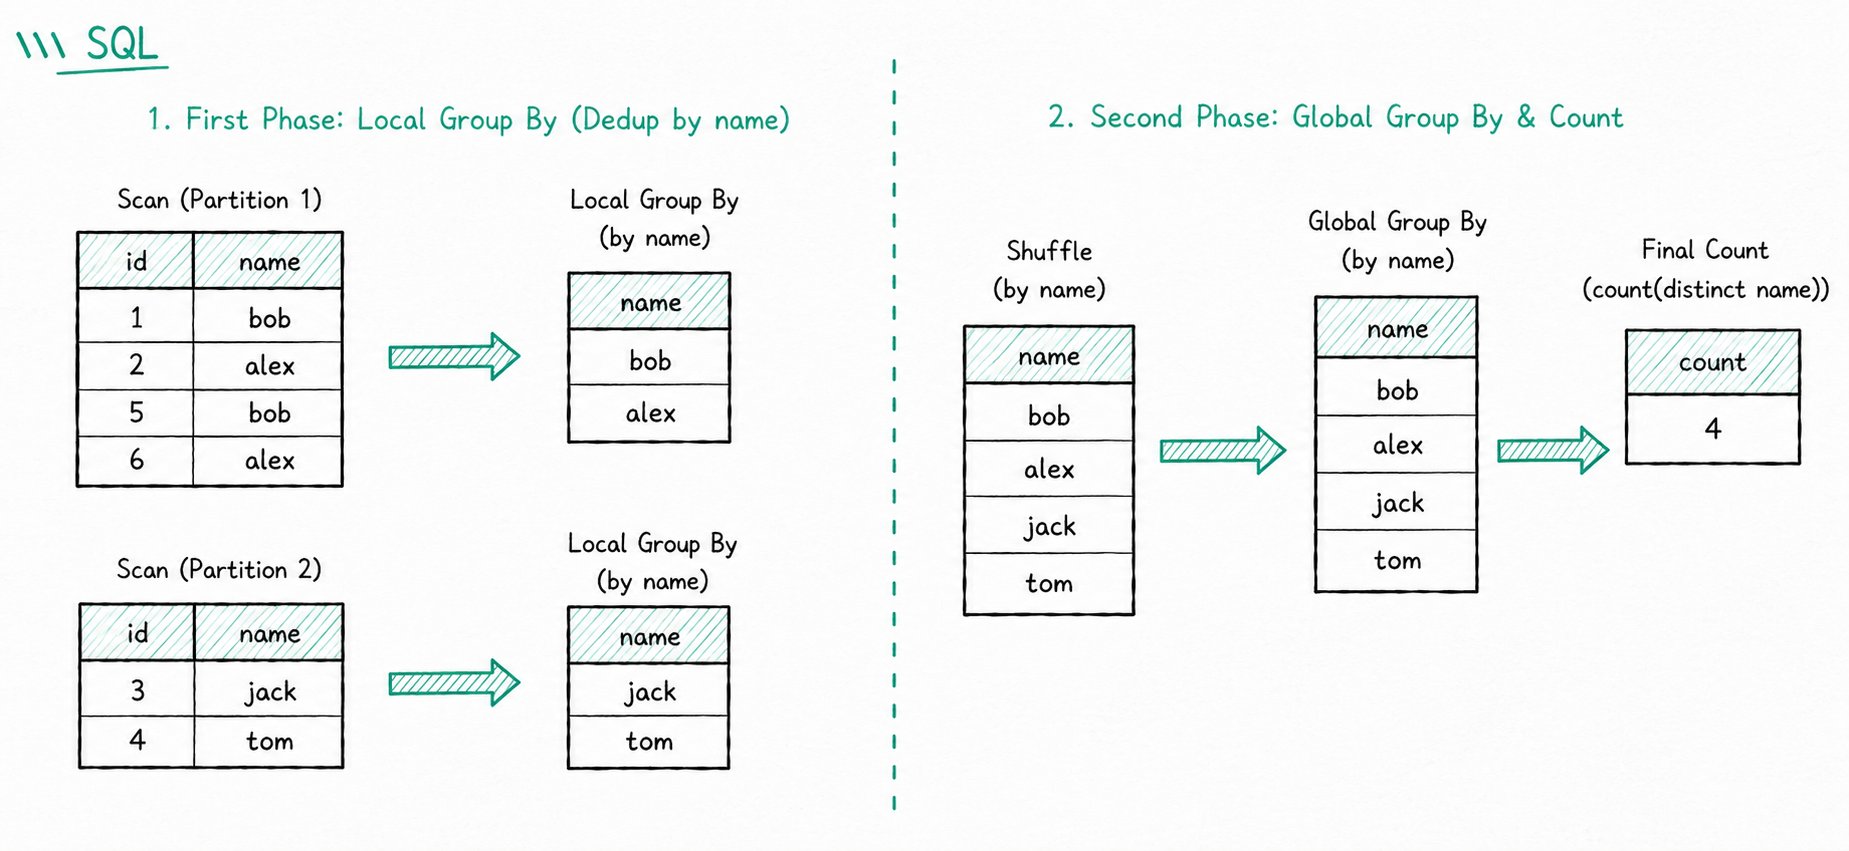
COUNT DISTINCT は計算中に詳細データを保持し、シャッフルも必要とするため、データ量が増えるほどクエリが遅くなります。Bitmap による厳密な重複排除は、大量データに対する COUNT DISTINCT の性能上の問題を解決するためのものです。
適用場面
Bitmap は詳細データをビット位置に対応付けます。詳細データの柔軟性と引き換えに、計算効率を大幅に高めます。次のような場合に、Bitmap を使った厳密な重複排除を検討してください。
| シナリオ | 説明 |
|---|---|
| クエリの高速化 | Bitmap はビット演算でクエリを計算するため、高い性能を発揮します |
| 圧縮されたストレージ | 各詳細レコードを単一のビットに圧縮するため、ディスクとメモリの使用量は詳細データを保持する場合よりも大幅に少なくなります |
制限事項:
- Bitmap が厳密な重複排除をサポートするデータ型は、
TINYINT、SMALLINT、INT、BIGINTのみです - その他のデータ型で厳密な重複排除を行うには、別途グローバル辞書を構築する必要があります
- Bitmap 型の列は Key 列として使用できません
Doris は RoaringBitmap を基に Bitmap による厳密な重複排除を実装しています。基本原理と詳細については、RoaringBitmap を参照してください。
BITMAP を使用した厳密な重複排除
全体の手順は、テーブルの作成 -> データのロード -> データのクエリの三つのステップです。
ステップ 1: テーブルを作成する
目的: 対象列を Bitmap 型として宣言し、集約関数 BITMAP_UNION を設定します。
注意事項:
- Bitmap を使って重複排除を行う場合は、対象列の型を
Bitmap、集約関数をBITMAP_UNIONに設定したCREATE TABLE文を使用します - Bitmap 型の列は Key 列として使用できません
例: 集約テーブル test_bitmap を作成します。id 列は訪問ユーザー ID を表し、uv 列は BITMAP 型で、集約関数 BITMAP_UNION を使ってデータを集約します。
create table test_bitmap(
        dt date,
        id int,
        name char(10),
        province char(10),
        os char(10),
        uv bitmap bitmap_union
)
Aggregate KEY (dt,id,name,province,os)
distributed by hash(id) buckets 10;
ステップ 2: データをロードする
目的: Stream Load で元の詳細データをロードし、ロード時に to_bitmap(id) を使用して Bitmap 型に変換します。
サンプルデータ(test_bitmap.csv):
2022-05-05,10001,test 01,Beijing,windows
2022-05-05,10002,test 01,Beijing,linux
2022-05-05,10003,test 01,Beijing,macos
2022-05-05,10004,test 01,Hebei,windows
2022-05-06,10001,test 01,Shanghai,windows
2022-05-06,10002,test 01,Shanghai,linux
2022-05-06,10003,test 01,Jiangsu,macos
2022-05-06,10004,test 01,Shaanxi,windows
Stream Load コマンド:
curl --location-trusted -u root: -H "label:label_test_bitmap_load" \
    -H "column_separator:," \
    -H "columns:dt,id,name,province,os, uv=to_bitmap(id)" -T test_bitmap.csv http://fe_IP:8030/api/demo/test_bitmap/_stream_load
ステップ 3: データをクエリする
目的: 集約関数 bitmap_union_count を使用して、Bitmap 列の重複排除後の結果を取得します。
Bitmap 列の元の値を直接クエリすることはできません。集約関数
bitmap_union_countを使用してクエリする必要があります。
シナリオ 1: UV の合計
mysql> select bitmap_union_count(uv) from test_bitmap;
+---------------------+
| bitmap_union_count(`uv`) |
+---------------------+
|                   4 |
+---------------------+
1 row in set (0.00 sec)
これは次のクエリと同等です。
mysql> SELECT COUNT(DISTINCT id) FROM test_bitmap;
+----------------------+
| count(DISTINCT `id`) |
+----------------------+
|                    4 |
+----------------------+
1 row in set (0.01 sec)
シナリオ 2: 日ごとの UV
mysql> select bitmap_union_count(uv) from test_bitmap group by dt;
+---------------------+
| bitmap_union_count(`uv`) |
+---------------------+
|                   4 |
|                   4 |
+---------------------+
2 rows in set (0.01 sec)
よくある質問
Q1: Bitmap で厳密な重複排除をサポートするデータ型は何ですか?
TINYINT、SMALLINT、INT、BIGINT のみです。文字列などの型で重複排除を行うには、別途グローバル辞書を構築する必要があります。
Q2: Bitmap 列を Key 列として使用できますか?
いいえ。Bitmap 型の列は Value 列としてのみ使用でき、集約関数 BITMAP_UNION と組み合わせる必要があります。
Q3: Bitmap 列の元の値を直接クエリできないのはなぜですか?
Bitmap はビットマップ構造であり、詳細データを保存しないためです。重複排除後の結果は、bitmap_union_count などの集約関数を使用して取得する必要があります。
Q4: COUNT DISTINCT と比べて Bitmap にはどのような利点がありますか?
| 比較項目 | COUNT DISTINCT | BITMAP による厳密な重複排除 |
|---|---|---|
| 計算方法 | 詳細データを保持し、シャッフルして重複を排除する | ビット演算 |
| クエリ速度 | 大量データでは低下する | 大幅に高速 |
| リソース使用量 | 詳細データが多くのリソースを消費する | ディスクとメモリの使用量が少ない |
| データ型 | すべての型 | 整数型のみ。それ以外の型にはグローバル辞書が必要 |