増分ビュー保守(IVM)
増分ビュー保守(IVM)は、ベーステーブルの行単位の変更に基づいて非同期マテリアライズドビューを維持します。通常の非同期マテリアライズドビューは全データまたは影響を受けるすべてのパーティションを再計算しますが、IVM は更新間にベーステーブルで挿入、更新、削除された行だけを計算し、その変更をマテリアライズドビューに適用します。
IVM は Doris 5.0.0 以降で利用できます。実験的機能であり、デフォルトでは無効です。使用する前に、FE の設定で changelog と Table Stream を有効にしてください。前提条件を参照してください。
IVM を使用する場面
更新方法を選ぶ前に、更新ごとの変更行数、影響を受けるパーティションのサイズ、整合性の要件を比較してください。
| シナリオ | 推奨 | 理由 |
|---|---|---|
| ベーステーブルで挿入、更新、削除が頻繁に発生し、変更行がテーブルまたはパーティションの一部にとどまる | IVM を使用する | 更新間の行単位の変更だけを計算するため、パーティション全体を再計算せずに済む |
| 変更が少数のパーティションに集中し、それらの再計算に無理がない | PARTITIONS を使用する | 設定が簡単で、影響を受けるパーティションを再計算する |
| 最初のベースラインを構築する、データ量が少ない、または IVM のベースラインを復旧する | COMPLETE を使用する | マテリアライズドビューの全データを再計算する |
| 結果にベーステーブルとのリアルタイムなトランザクション整合性が必要 | 非同期マテリアライズドビューを使用しない | IVM も非同期タスクで更新するため、リアルタイムの整合性は提供しない |
パーティション単位の増分更新との違い
Doris は非同期マテリアライズドビューに対して複数の更新方法をサポートします。IVM は INCREMENTAL に対応します。PARTITIONS が提供するパーティション単位の増分更新とは区別してください。
| 更新方法 | 計算の粒度 | 適した場面 | 条件を満たさない場合の動作 |
|---|---|---|---|
INCREMENTAL | 行単位の変更 | 変更行数がテーブル全体や影響を受けるパーティションよりはるかに少ない | デフォルトでは失敗する。FALLBACK を指定するとフォールバックできる |
PARTITIONS | 影響を受けるマテリアライズドビューの各パーティション | 変更が少数のパーティションに集中し、その再計算に無理がない | デフォルトでは失敗する。FALLBACK を指定すると COMPLETE にフォールバックする |
COMPLETE | 全データ | データ量が少ない、最初のベースラインを作る、または IVM のベースラインを復旧する | 常に全データを再計算する |
AUTO | Doris が自動的に選択 | 利用可能な方法を Doris に選ばせたい | 利用可能な方法として IVM、パーティション更新、完全更新を順に試す |
INCREMENTAL FALLBACK が変更するのは更新時の失敗の扱いだけです。マテリアライズドビューの作成時には、定義 SQL が IVM の要件を満たす必要があります。FALLBACK を指定しても、サポート対象外の定義は作成時のチェックを通過できません。
仕組み
IVM は Doris の changelog と Table Stream の機能を再利用します。
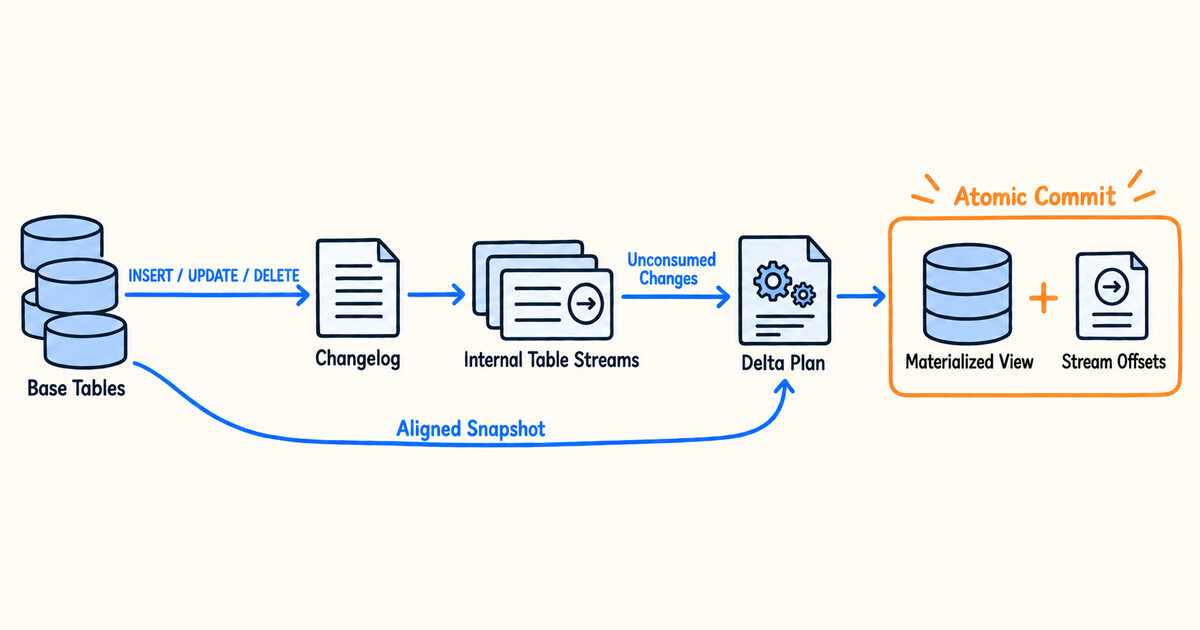
IVM をサポートするマテリアライズドビューを作成すると、Doris は増分保守に参加する各ベーステーブルに内部 Table Stream を作成します。内部 Stream の名前は __doris_ivm_stream_ で始まります。これらの Stream を作成、消費、削除する必要はありません。
更新時に、Doris は各ベーステーブルの未消費の変更から差分プランを生成します。結合クエリでは、消費オフセットに対応するベーステーブルのスナップショットも読み取り、複数テーブルの計算で整合性のあるデータ境界を使用します。マテリアライズドビューのデータと消費オフセットは同じトランザクションでコミットされます。トランザクションが失敗すると、どちらもコミットされません。
前提条件
バージョンと FE の設定
-
Doris 5.0.0 以降を使用します。
-
すべての FE の
fe.confに次のオプションを設定し、FE を再起動します。enable_feature_changelog = true
enable_table_stream = true
どちらも静的な設定であり、動的には変更できません。enable_feature_changelog は changelog とグローバルコミットタイムスタンプを有効にし、enable_table_stream は Table Stream の DDL と内部 Stream の管理を有効にします。
ベーステーブルの要件
増分保守に参加するベーステーブルは、Internal Catalog 内の Doris OLAP 内部テーブルであり、次の要件を満たす必要があります。
| ベーステーブルのモデル | サポート | 要件と動作 |
|---|---|---|
| Unique Key Merge-on-Write | 対応 | changelog と更新前イメージを有効にする必要がある。挿入、更新、削除をすべて処理する |
| Duplicate Key | 対応 | changelog を有効にする必要がある。追加された変更のみが提供され、削除述語による削除は記録されない |
| Unique Key Merge-on-Read | 非対応 | 代わりに Merge-on-Write を使用する |
| Aggregate Key | 増分保守の対象外 | 増分更新をトリガーしない excluded_trigger_tables 内のテーブルとしてのみ使用できる |
| 外部テーブル | 非対応 | IVM の増分保守対象のベーステーブルは Doris の内部テーブルである必要がある |
更新と削除を処理するワークロードには Unique Key Merge-on-Write テーブルを使用し、作成時に次のプロパティを設定します。
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);
changelog を有効にできるのはテーブルの作成時だけで、その後に無効にはできません。テーブルモデル、列の型、書き込み方法、DDL に関する制限の一覧は、Changelogを参照してください。
クイックスタート
次の例では、注文をステータス別に集計する IVM を作成します。最初の更新では COMPLETE を使用して完全なベースラインを構築し、その後の更新では INCREMENTAL FALLBACK を使用して行単位の変更を処理します。
手順は次のとおりです。
- changelog を有効にした Unique Key Merge-on-Write ベーステーブルを作成します。
REFRESH INCREMENTAL FALLBACKを指定して IVM を作成します。COMPLETE更新を実行して完全なベースラインを構築します。- ベーステーブルのデータを変更し、増分更新を実行します。
- 更新タスクをクエリして結果とフォールバック理由を確認します。
ステップ 1:ベーステーブルを作成して初期データをロードする
changelog と更新前イメージを有効にし、更新と削除をサポートするベーステーブルを作成します。
CREATE DATABASE IF NOT EXISTS ivm_demo;
USE ivm_demo;

CREATE TABLE orders (
    order_id BIGINT,
    order_status VARCHAR(16),
    amount DECIMAL(10, 2)
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);

INSERT INTO orders VALUES
    (1, 'created', 100.00),
    (2, 'created', 200.00),
    (3, 'paid',    300.00);
ステップ 2:IVM を作成する
CREATE MATERIALIZED VIEW で REFRESH INCREMENTAL を指定します。この例では FALLBACK も指定するため、変更を安全に増分計算できない場合に、Doris はパーティション更新または完全更新にフォールバックできます。各更新を段階的に確認できるよう、トリガーには ON MANUAL を使用します。本番環境のビューでは通常、スケジュールまたはコミット時のトリガーに切り替えます。自動更新間隔の設定を参照してください。
CREATE MATERIALIZED VIEW orders_by_status
BUILD DEFERRED
REFRESH INCREMENTAL FALLBACK ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
)
AS
SELECT
    order_status,
    COUNT(*) AS order_count,
    SUM(amount) AS total_amount
FROM orders
GROUP BY order_status;
ビューの作成後、Doris は対応する内部 Table Stream を自動的に作成します。mv_infos で対応関係を確認できます。
SELECT Name, RefreshInfo, IvmBaseTableStreams
FROM mv_infos("database" = "ivm_demo")
WHERE Name = "orders_by_status";
ステップ 3:完全なベースラインを構築する
最初の更新では COMPLETE を使用して、その後の増分保守のベースラインを構築します。
REFRESH MATERIALIZED VIEW orders_by_status COMPLETE;
更新タスクは非同期で実行されます。タスクが成功したら、マテリアライズドビューをクエリします。
SELECT order_status, order_count, total_amount
FROM orders_by_status
ORDER BY order_status;
+--------------+-------------+--------------+
| order_status | order_count | total_amount |
+--------------+-------------+--------------+
| created      |           2 |       300.00 |
| paid         |           1 |       300.00 |
+--------------+-------------+--------------+
ステップ 4:変更を書き込み、増分更新を実行する
次の文では、注文 1 を更新し、注文 2 を削除し、注文 4 を挿入します。
INSERT INTO orders VALUES (1, 'paid', 100.00);
DELETE FROM orders WHERE order_id = 2;
INSERT INTO orders VALUES (4, 'created', 400.00);

REFRESH MATERIALIZED VIEW orders_by_status INCREMENTAL FALLBACK;
更新タスクが成功すると、IVM は上記の行単位の変更だけを処理します。マテリアライズドビューの内容は次のようになります。
SELECT order_status, order_count, total_amount
FROM orders_by_status
ORDER BY order_status;
+--------------+-------------+--------------+
| order_status | order_count | total_amount |
+--------------+-------------+--------------+
| created      |           1 |       400.00 |
| paid         |           2 |       400.00 |
+--------------+-------------+--------------+
ステップ 5:更新方法とフォールバック理由を確認する
最新の更新タスクをクエリして、要求した方法、実際の更新範囲、フォールバック理由を確認します。
SELECT Status, TaskContext, RefreshMode, IvmFallbackReason, ErrorMsg
FROM tasks("type" = "mv")
WHERE MvDatabaseName = "ivm_demo"
  AND MvName = "orders_by_status"
ORDER BY CreateTime DESC, TaskId DESC
LIMIT 1;
TaskContextには、このタスクが要求した更新方法(例:INCREMENTAL)が記録されます。RefreshModeには、タスクが実際に更新したパーティションの範囲としてCOMPLETE、PARTIAL、NOT_REFRESHのいずれかが記録されます。IvmFallbackReasonは IVM のフォールバックが起きなかった場合は空で、それ以外の場合は安定したフォールバック理由が記録されます。ErrorMsgには、厳密な増分更新が失敗した際の詳細が記録されます。
サポートされるクエリ
IVM はマテリアライズドビューの作成時に定義 SQL をチェックします。明示的に REFRESH INCREMENTAL を指定した場合、サポート対象外の定義では作成が失敗します。このセクションでは、サポートされる関係演算と集約関数をそれぞれ実行可能な例とともに示し、その後にサポート対象外のクエリ形式を示します。
サンプルテーブル
このセクションの例では、顧客テーブル customers、売上テーブル sales、返金テーブル refunds を使用します。いずれも changelog と更新前イメージを有効にした Unique Key Merge-on-Write テーブルです。クイックスタートで作成した ivm_demo データベースで実行できます。
CREATE TABLE customers (
    customer_id BIGINT,
    name VARCHAR(32),
    city VARCHAR(16)
)
UNIQUE KEY(customer_id)
DISTRIBUTED BY HASH(customer_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);

CREATE TABLE sales (
    sale_id BIGINT,
    customer_id BIGINT,
    channel VARCHAR(16),
    amount DECIMAL(10, 2)
)
UNIQUE KEY(sale_id)
DISTRIBUTED BY HASH(sale_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);

CREATE TABLE refunds (
    refund_id BIGINT,
    sale_id BIGINT,
    amount DECIMAL(10, 2)
)
UNIQUE KEY(refund_id)
DISTRIBUTED BY HASH(refund_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);

INSERT INTO customers VALUES
    (1, 'Alice', 'Beijing'),
    (2, 'Bob',   'Shanghai'),
    (3, 'Carol', 'Beijing');

INSERT INTO sales VALUES
    (101, 1,    'web',   120.00),
    (102, 1,    'app',    80.00),
    (103, 2,    'web',   200.00),
    (104, NULL, 'store',  50.00);

INSERT INTO refunds VALUES
    (9001, 102, 80.00),
    (9002, 103, 50.00);
このデータには、結合と集約の例で使用する特別なケースを意図的に含めています。店舗の注文 104 には顧客がいないため customer_id は NULL で、顧客 Carol にはまだ注文がありません。
どの例でも手順は同じです。CREATE MATERIALIZED VIEW を実行した後、REFRESH MATERIALIZED VIEW <mv_name> COMPLETE でベースラインを構築し、更新タスクの成功後に SELECT * FROM <mv_name> で結果を確認します。ここに示す結果は先頭列で並べ替えています。
サポートされる関係演算
| 演算 | 説明 |
|---|---|
| 列と式 | 一部の列を選択するか、決定的な式で新しい列を計算する |
WHERE フィルター | 条件によってベーステーブルの行を絞り込む |
FROM サブクエリ | FROM 句内の別名付きサブクエリ。入れ子にできるが、集約は含められない |
| 定数行 | FROM のない SELECT で、常に定数からなる単一行を返すもの。例:SELECT -1, 'unknown'。UNION ALL の分岐、結合の片側、定義全体のいずれにもできる |
GROUP BY 集約 | 集約は、上位に射影のみを持つクエリの最も外側の演算である必要がある。グループ化列や集約結果に対する決定的な式はサポートされる |
GROUPING SETS、ROLLUP、CUBE | GROUPING() および GROUPING_ID() とともに使用できる。GROUP BY と同じ制限が適用される |
SELECT DISTINCT | 集約関数のない GROUP BY として処理される。GROUP BY と同じ制限が適用される |
INNER JOIN、CROSS JOIN | 複数テーブルの結合と自己結合をサポートする |
LEFT OUTER JOIN、RIGHT OUTER JOIN、FULL OUTER JOIN | すべての行を保持する側(LEFT JOIN の左側、RIGHT JOIN の右側、FULL JOIN の両側)には、excluded_trigger_tables に列挙された changelog のない Duplicate Key テーブルを使用できない。このようなテーブルの行には固定の行識別子がないため |
| 入れ子の外部結合 | 外部結合で NULL が補われる側自体が結合である。その側が複雑になるほど、増分更新プランは大きくなる |
UNION ALL | 分岐には異なるテーブル、同じテーブル、定数行を使用できる |
| 連鎖した IVM | 別の IVM をベーステーブルとして使用する。ベーステーブルとして使用する IVM では changelog と更新前イメージを有効にする必要がある |
以下の例はカテゴリ別にまとめています。
単一テーブルのクエリ
- 列と式
- WHERE フィルター
- FROM サブクエリ
- 定数行
必要な列を選択するか、式で新しい列を計算します。式は決定的、つまり同じ入力から常に同じ結果を生成する必要があります。たとえば NOW() と RAND() は使用できません。
CREATE MATERIALIZED VIEW mv_sales_projection
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT sale_id, channel, amount, amount * 0.9 AS discounted_amount
FROM sales;
結果:
+---------+---------+--------+-------------------+
| sale_id | channel | amount | discounted_amount |
+---------+---------+--------+-------------------+
|     101 | web     | 120.00 |           108.000 |
|     102 | app     |  80.00 |            72.000 |
|     103 | web     | 200.00 |           180.000 |
|     104 | store   |  50.00 |            45.000 |
+---------+---------+--------+-------------------+
条件を満たす行だけを残します。ベーステーブルの行が更新されると、Doris は新しい値で条件を再評価します。条件を満たさなくなった行はマテリアライズドビューから削除され、新たに条件を満たすようになった行は追加されます。
CREATE MATERIALIZED VIEW mv_large_sales
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT sale_id, customer_id, amount
FROM sales
WHERE amount >= 100;
結果:
+---------+-------------+--------+
| sale_id | customer_id | amount |
+---------+-------------+--------+
|     101 |           1 | 120.00 |
|     103 |           2 | 200.00 |
+---------+-------------+--------+
FROM 句で別名付きサブクエリを使用できます。たとえば、先に Web 経由の注文を選択してから顧客テーブルと結合します。サブクエリは入れ子にできます。その内部でも、このセクションに記載された演算だけを使用でき、集約は含められません。
CREATE MATERIALIZED VIEW mv_web_sales
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT w.sale_id, c.name, w.amount
FROM (
    SELECT sale_id, customer_id, amount
    FROM sales
    WHERE channel = 'web'
) AS w
INNER JOIN customers AS c ON w.customer_id = c.customer_id;
結果:
+---------+-------+--------+
| sale_id | name  | amount |
+---------+-------+--------+
|     101 | Alice | 120.00 |
|     103 | Bob   | 200.00 |
+---------+-------+--------+
定数行とは、FROM を持たず、常に定数からなる単一行を返す SELECT です。よくある用途は、対応付けられない行のために、ディメンションテーブルに「不明」のメンバーを追加することです。
CREATE MATERIALIZED VIEW mv_customers_with_unknown
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT customer_id, name, city
FROM customers
UNION ALL
SELECT -1, 'unknown', 'unknown';
結果:
+-------------+---------+----------+
| customer_id | name    | city     |
+-------------+---------+----------+
|          -1 | unknown | unknown  |
|           1 | Alice   | Beijing  |
|           2 | Bob     | Shanghai |
|           3 | Carol   | Beijing  |
+-------------+---------+----------+
定数行は結合の片側にもできます。たとえば CROSS JOIN (SELECT 0.14 AS usd_rate) r で各行にパラメーターを付けられます。また、SELECT 1 AS id, 'x' AS name のように、マテリアライズドビューの定義全体にもできます。
定数行から変更は発生しません。定数行を含むマテリアライズドビューの最初の更新は、INCREMENTAL を要求しても必ず COMPLETE で実行されます。その後の増分更新ではベーステーブルの変更だけを処理します。
集約
- GROUP BY
- GROUPING SETS / ROLLUP / CUBE
- SELECT DISTINCT
グループごとに集約結果を計算します。集約の入力には単一テーブル、結合、UNION ALL、FROM サブクエリを使用できますが、集約自体はクエリの最も外側の演算である必要があります。次の例では sales と customers を結合し、都市別に集約します。注文 104 には顧客がいないため、集計されません。
CREATE MATERIALIZED VIEW mv_city_sales
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.city, COUNT(*) AS sale_cnt, SUM(s.amount) AS total_amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id
GROUP BY c.city;
結果:
+----------+----------+--------------+
| city     | sale_cnt | total_amount |
+----------+----------+--------------+
| Beijing  |        2 |       200.00 |
| Shanghai |        1 |       200.00 |
+----------+----------+--------------+
集約の上位にある射影では、列名や列の順序を変更したり、決定的な式でグループ化列や集約結果を計算したりできます。たとえば SUM(amount) * 100、MAX(amount) + 1、SUM(amount) / COUNT(*) は、使用する集約関数の制限内で増分更新をサポートします。HAVING、およびサブクエリや結合入力の内部に置かれた集約はサポートされません。サポート対象外のクエリ形式を参照してください。
単一の集約で複数のディメンションの組み合わせを計算します。次の例では ROLLUP(c.city, s.channel) を使用して、都市とチャネルの明細、都市ごとの小計、総計を生成します。小計と総計の行では、ロールアップされた列が NULL になります。GROUPING SETS、CUBE、および小計行を識別する GROUPING() と GROUPING_ID() 関数もサポートされます。
CREATE MATERIALIZED VIEW mv_city_channel_rollup
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.city, s.channel, SUM(s.amount) AS total_amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id
GROUP BY ROLLUP(c.city, s.channel);
結果:
+----------+---------+--------------+
| city     | channel | total_amount |
+----------+---------+--------------+
| NULL     | NULL    |       400.00 |
| Beijing  | NULL    |       200.00 |
| Beijing  | app     |        80.00 |
| Beijing  | web     |       120.00 |
| Shanghai | NULL    |       200.00 |
| Shanghai | web     |       200.00 |
+----------+---------+--------------+
SELECT DISTINCT は集約関数のない GROUP BY として処理され、GROUP BY と同じ制限が適用されます。ただし、UNION(つまり UNION DISTINCT)はサポートされません。
CREATE MATERIALIZED VIEW mv_channels
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT DISTINCT channel
FROM sales;
結果:
+---------+
| channel |
+---------+
| app     |
| store   |
| web     |
+---------+
結合
- INNER JOIN
- CROSS JOIN
- 外部結合
- 入れ子の外部結合
両側で一致する行だけを残します。注文 104 には顧客がいないため、結果には含まれません。
CREATE MATERIALIZED VIEW mv_sales_customer
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT s.sale_id, c.name, c.city, s.amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id;
結果:
+---------+-------+----------+--------+
| sale_id | name  | city     | amount |
+---------+-------+----------+--------+
|     101 | Alice | Beijing  | 120.00 |
|     102 | Alice | Beijing  |  80.00 |
|     103 | Bob   | Shanghai | 200.00 |
+---------+-------+----------+--------+
両側の行のすべての組み合わせ(直積)を返します。次の例では customers を自己結合して、顧客のすべての組を一覧表示します。
CREATE MATERIALIZED VIEW mv_customer_pairs
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT a.name AS customer_a, b.name AS customer_b
FROM customers a
CROSS JOIN customers b
WHERE a.customer_id < b.customer_id;
結果:
+------------+------------+
| customer_a | customer_b |
+------------+------------+
| Alice      | Bob        |
| Alice      | Carol      |
| Bob        | Carol      |
+------------+------------+
外部結合では片側のすべての行を保持し、一致する行がない場合はもう片側を NULL で埋めます。LEFT OUTER JOIN は左側、RIGHT OUTER JOIN は右側、FULL OUTER JOIN は両側の行を保持します。
LEFT OUTER JOIN:すべての注文を保持します。注文 104 に一致する顧客はいないため、name は NULL です。
CREATE MATERIALIZED VIEW mv_sales_left
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT s.sale_id, s.amount, c.name
FROM sales s
LEFT OUTER JOIN customers c ON s.customer_id = c.customer_id;
結果:
+---------+--------+-------+
| sale_id | amount | name  |
+---------+--------+-------+
|     101 | 120.00 | Alice |
|     102 |  80.00 | Alice |
|     103 | 200.00 | Bob   |
|     104 |  50.00 | NULL  |
+---------+--------+-------+
RIGHT OUTER JOIN:すべての顧客を保持します。まだ注文のない Carol も結果に含まれます。
CREATE MATERIALIZED VIEW mv_sales_right
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.name, s.sale_id, s.amount
FROM sales s
RIGHT OUTER JOIN customers c ON s.customer_id = c.customer_id;
結果:
+-------+---------+--------+
| name  | sale_id | amount |
+-------+---------+--------+
| Alice |     101 | 120.00 |
| Alice |     102 |  80.00 |
| Bob   |     103 | 200.00 |
| Carol |    NULL |   NULL |
+-------+---------+--------+
FULL OUTER JOIN:顧客のいない注文 104 と、注文のない Carol の両方を保持します。
CREATE MATERIALIZED VIEW mv_sales_full
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.name, s.sale_id, s.amount
FROM customers c
FULL OUTER JOIN sales s ON c.customer_id = s.customer_id;
結果:
+-------+---------+--------+
| name  | sale_id | amount |
+-------+---------+--------+
| NULL  |     104 |  50.00 |
| Alice |     101 | 120.00 |
| Alice |     102 |  80.00 |
| Bob   |     103 | 200.00 |
| Carol |    NULL |   NULL |
+-------+---------+--------+
外部結合で NULL が補われる側を NULL 生成側と呼びます。たとえば LEFT JOIN の右側です。入れ子の外部結合とは、その NULL 生成側自体が結合であるものです。次の例では、まず sales LEFT JOIN refunds で返金を付け、次にその結合全体を customers LEFT JOIN の右側に使用します。
CREATE MATERIALIZED VIEW mv_customer_refunds
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.name, s.sale_id, r.refund_id, r.amount AS refund_amount
FROM customers c
LEFT OUTER JOIN (
    sales s
    LEFT OUTER JOIN refunds r ON s.sale_id = r.sale_id
) ON c.customer_id = s.customer_id;
結果:
+-------+---------+-----------+---------------+
| name  | sale_id | refund_id | refund_amount |
+-------+---------+-----------+---------------+
| Alice |     101 |      NULL |          NULL |
| Alice |     102 |      9001 |         80.00 |
| Bob   |     103 |      9002 |         50.00 |
| Carol |    NULL |      NULL |          NULL |
+-------+---------+-----------+---------------+
増分更新では変更前と変更後の両方で NULL 生成側を計算する必要があるため、その側が複雑になるほど更新プランも大きくなります。プランの作成や更新にかかるコストが高すぎる場合は、その側を先に下位の IVM として作成し、その上に現在のマテリアライズドビューを構築します。UNION ALL と連鎖した IVMの例を参照してください。
UNION ALL と連鎖した IVM
- UNION ALL
- 連鎖した IVM
重複を取り除かずに複数のクエリ結果を結合します。分岐には異なるテーブル、同じテーブル、定数行を使用できます。次の例では売上と返金を単一の台帳にまとめ、返金額を負数として記録します。
CREATE MATERIALIZED VIEW mv_ledger
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT sale_id AS doc_id, 'sale' AS doc_type, amount
FROM sales
UNION ALL
SELECT refund_id, 'refund', -amount
FROM refunds;
結果:
+--------+----------+--------+
| doc_id | doc_type | amount |
+--------+----------+--------+
|    101 | sale     | 120.00 |
|    102 | sale     |  80.00 |
|    103 | sale     | 200.00 |
|    104 | sale     |  50.00 |
|   9001 | refund   | -80.00 |
|   9002 | refund   | -50.00 |
+--------+----------+--------+
ある IVM を別の IVM のベーステーブルとして使用し、複雑な計算を層に分けます。たとえば、下位の IVM で結合し、上位の IVM で集約します。ベーステーブルとして使用する IVM 自体も Unique Key Merge-on-Write テーブルなので、ほかの Merge-on-Write ベーステーブルと同様に、changelog と更新前イメージを有効にする必要があります。そうしないと上位の IVM を作成できません。たとえば changelog が無効だと changelog is not enabled for table で作成が失敗します。
CREATE MATERIALIZED VIEW mv_sales_city_detail
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
)
AS
SELECT s.sale_id, c.city, s.amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id;

CREATE MATERIALIZED VIEW mv_city_total
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT city, COUNT(*) AS sale_cnt, SUM(amount) AS total_amount
FROM mv_sales_city_detail
GROUP BY city;
上位の IVM は、下位の IVM がすでに更新した結果しか読み取れません。そのため、先に下位、次に上位を更新してください。両方の更新後に mv_city_total をクエリすると、次の結果が返されます。
+----------+----------+--------------+
| city     | sale_cnt | total_amount |
+----------+----------+--------------+
| Beijing  |        2 |       200.00 |
| Shanghai |        1 |       200.00 |
+----------+----------+--------------+
通常の非同期マテリアライズドビュー(IVM ではないもの)は、IVM のベーステーブルとして使用できません。
サポートされる集約関数
IVM は次の集約関数をサポートします。引数には列または決定的な式を使用できます。
COUNT(*)、COUNT(expr)SUMAVGMINMAXBITMAP_UNIONBITMAP_UNION_COUNTARRAY_AGGCOLLECT_LIST(引数が単一の形式のみ)
次の例では、いずれも sales テーブルをチャネル別にグループ化します。
- COUNT
- SUM
- AVG
- MIN / MAX
- Bitmap 集約
- 配列集約
COUNT(*) は行数を数え、COUNT(expr) は expr が NULL でない行だけを数えます。店舗の注文 104 の customer_id は NULL なので、店舗チャネルの member_sale_cnt は 0 です。
CREATE MATERIALIZED VIEW mv_agg_count
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       COUNT(*) AS sale_cnt,
       COUNT(customer_id) AS member_sale_cnt
FROM sales
GROUP BY channel;
結果:
+---------+----------+-----------------+
| channel | sale_cnt | member_sale_cnt |
+---------+----------+-----------------+
| app     |        1 |               1 |
| store   |        1 |               0 |
| web     |        2 |               2 |
+---------+----------+-----------------+
合計を計算します。引数には列または決定的な式を使用できます。たとえば、金額が 100 以上の注文だけを合計できます。
CREATE MATERIALIZED VIEW mv_agg_sum
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       SUM(amount) AS total_amount,
       SUM(IF(amount >= 100, amount, 0)) AS large_amount
FROM sales
GROUP BY channel;
結果:
+---------+--------------+--------------+
| channel | total_amount | large_amount |
+---------+--------------+--------------+
| app     |        80.00 |         0.00 |
| store   |        50.00 |         0.00 |
| web     |       320.00 |       320.00 |
+---------+--------------+--------------+
平均を計算します。Doris はさらに、非表示の合計値と件数をマテリアライズドビューに保持し、増分更新時にそれらを使って平均を再計算します。
CREATE MATERIALIZED VIEW mv_agg_avg
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel, AVG(amount) AS avg_amount
FROM sales
GROUP BY channel;
結果:
+---------+------------+
| channel | avg_amount |
+---------+------------+
| app     |    80.0000 |
| store   |    50.0000 |
| web     |   160.0000 |
+---------+------------+
最小値と最大値を計算します。
CREATE MATERIALIZED VIEW mv_agg_minmax
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel, MIN(amount) AS min_amount, MAX(amount) AS max_amount
FROM sales
GROUP BY channel;
結果:
+---------+------------+------------+
| channel | min_amount | max_amount |
+---------+------------+------------+
| app     |      80.00 |      80.00 |
| store   |      50.00 |      50.00 |
| web     |     120.00 |     200.00 |
+---------+------------+------------+
新しく書き込まれた値は、現在の最小値や最大値と直接比較できます。一方、削除または更新された行が現在の最小値または最大値を持つ場合、既存の結果から新しい結果を導けないため、全データを再度読み取る必要があります。たとえば、ベースライン構築後に注文 101(Web チャネルの現在の最小値である 120.00)を削除すると、厳密な INCREMENTAL 更新は IvmFallbackReason の MIN_MAX_BOUNDARY_HIT で失敗し、INCREMENTAL FALLBACK 更新は COMPLETE にフォールバックします。
BITMAP_UNION はグループの Bitmap を統合し、BITMAP_UNION_COUNT は統合結果に含まれる異なる値の数を返します。これらは正確な重複排除カウントによく使用されます。次の例では、チャネルごとの異なる顧客数を数えます。customer_bitmap には顧客 ID の集合が入り、customer_cnt には異なる顧客の数が入ります。customer_id が NULL の注文 104 は数えられません。
CREATE MATERIALIZED VIEW mv_agg_bitmap
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       BITMAP_UNION(TO_BITMAP(customer_id)) AS customer_bitmap,
       BITMAP_UNION_COUNT(TO_BITMAP(customer_id)) AS customer_cnt
FROM sales
GROUP BY channel;
Bitmap 列を表示する前に、BITMAP_TO_STRING で変換する必要があります。
SELECT channel, BITMAP_TO_STRING(customer_bitmap) AS customers, customer_cnt
FROM mv_agg_bitmap
ORDER BY channel;
+---------+-----------+--------------+
| channel | customers | customer_cnt |
+---------+-----------+--------------+
| app     | 1         |            1 |
| store   |           |            0 |
| web     | 1,2       |            2 |
+---------+-----------+--------------+
Bitmap は統合後の結果しか保存しないため、ある行が寄与した値を差し引くことはできません。集約に参加する行が削除または更新され、そのグループにほかの行が残る場合は、Bitmap 全体を再計算する必要があります。厳密な INCREMENTAL 更新は IvmFallbackReason の BITMAP_AGG_DELETE で失敗し、INCREMENTAL FALLBACK は COMPLETE にフォールバックします。
ARRAY_AGG と COLLECT_LIST は、グループの値を配列に集めます。NULL の扱いは異なり、ARRAY_AGG は NULL 要素を保持し、COLLECT_LIST は NULL をスキップします。
CREATE MATERIALIZED VIEW mv_agg_array
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       ARRAY_AGG(customer_id) AS customer_ids,
       COLLECT_LIST(customer_id) AS member_ids
FROM sales
GROUP BY channel;
結果:
+---------+--------------+------------+
| channel | customer_ids | member_ids |
+---------+--------------+------------+
| app     | [1]          | [1]        |
| store   | [null]       | []         |
| web     | [1, 2]       | [1, 2]     |
+---------+--------------+------------+
増分更新では配列を順序のない多重集合として維持するため、要素の順序は固定されません。COLLECT_LIST は引数が単一の形式のみをサポートします。最大長を指定する COLLECT_LIST(expr, max_size) はサポートされません。ARRAY_AGG は JSONB または VARIANT 要素をサポートしません。
COUNT(DISTINCT customer_id) のような DISTINCT 付きの集約関数はサポートされません。非負整数列の正確な重複排除カウントには、代わりに BITMAP_UNION_COUNT(TO_BITMAP(customer_id)) を使用できます。ただし、後述のように、削除と更新が発生すると Bitmap 全体の再計算が必要です。
一部の集約関数では、行が削除された際に現在の差分だけから新しい結果を安全に導けません。Unique Key テーブルの更新は古い行を削除してから新しい行を書き込むため、更新でも次の状況が発生し得ます。
- 削除された値が現在の
MINまたはMAXである可能性がある場合は、全データを再度読み取る必要があります。 - 削除が Bitmap 集約の結果に影響する場合は、Bitmap 全体を再計算する必要があります。
このような場合、厳密な INCREMENTAL は失敗し、INCREMENTAL FALLBACK は COMPLETE にフォールバックします。
サポート対象外のクエリ形式
次の形式はサポートされず、明示的な REFRESH INCREMENTAL を指定すると作成が失敗します。
UNION(つまりUNION DISTINCT)、INTERSECT、EXCEPT。ORDER BY、LIMIT、ウィンドウ関数。HAVING、およびFROMサブクエリや結合入力の内部に記述された集約。集約はクエリの最も外側の演算に限られます。集約結果を絞り込む場合は、マテリアライズドビューをクエリするときに絞り込んでください。WHEREまたはSELECTリスト内のサブクエリ。たとえばIN (SELECT ...)、EXISTS (SELECT ...)、スカラーサブクエリ。INサブクエリやスカラーサブクエリはMultiple columns returned by subquery are not yet supportedで失敗することがありますが、原因は同じく IVM がこれらのサブクエリをサポートしないことです。WITH句(CTE)。FROMサブクエリに書き換えてください。LATERAL VIEW。- 通常の非同期マテリアライズドビューをベーステーブルとして使用すること。連鎖した保守では、下位のマテリアライズドビューも IVM である必要があります。
- 上の表に記載されていないその他の演算。
更新とフォールバック
作成時に更新方法を選ぶ
| 定義 | 作成時の動作 | その後の更新のデフォルト動作 |
|---|---|---|
REFRESH INCREMENTAL | IVM のサポート範囲を厳密にチェックし、対象外なら作成に失敗する | IVM だけを試し、IVM が失敗するとタスクも失敗する |
REFRESH INCREMENTAL FALLBACK | 厳密モードと同じで、IVM のチェックを通過する必要がある | まず IVM を試し、失敗理由に応じてフォールバックする |
REFRESH AUTO | 定義が IVM をサポートするか確認し、サポートしなければ通常の非同期マテリアライズドビューを作成する | IVM 対応ビューでは、IVM、パーティション更新、完全更新を順に試す |
REFRESH PARTITIONS [FALLBACK] | マテリアライズドビューで PARTITION BY を定義する必要がある | 変更されたパーティションを再計算する。FALLBACK があれば完全更新にフォールバックできる |
REFRESH COMPLETE | IVM メタデータを作成しない | 常に完全更新する |
自動更新間隔の設定
IVM は非同期マテリアライズドビューのトリガー方式を再利用し、独自のトリガー構文を持ちません。REFRESH INCREMENTAL [FALLBACK] の後の ON 句でトリガーを指定します。
| トリガー | 構文 | 説明 |
|---|---|---|
| 手動 | ON MANUAL | デフォルト。REFRESH MATERIALIZED VIEW の実行時だけ更新する |
| スケジュール | ON SCHEDULE EVERY <interval> <unit> [STARTS '<start_time>'] | 固定間隔で増分更新を自動実行する |
| コミット時 | ON COMMIT | ベーステーブルのロードトランザクションがコミットされた後に増分更新を自動実行する |
スケジュール間隔のルールは次のとおりです。
<interval>は正の整数で、<unit>にはMINUTE、HOUR、DAY、WEEKを指定できます。- 最短の更新間隔は
EVERY 1 MINUTEです。SECONDを指定するとinterval time unit can not be secondで失敗します。FE オプションのenable_job_schedule_second_for_testを使うと秒単位の間隔を設定できますが、テスト専用であり本番環境では有効にしないでください。 STARTSは最初のスケジュール時刻を'yyyy-MM-dd HH:mm:ss'形式で設定します。現在時刻より後にする必要があります。省略すると、最初の更新はマテリアライズドビュー作成から指定した間隔の経過後に実行されます。その後の実行時刻は、前のタスクの終了時刻にかかわらず、最初のスケジュール時刻に間隔の整数倍を加えた時刻に固定されます。
次の例では、増分更新を 5 分ごとに実行し、変更を増分計算できない場合のフォールバックを許可します。
CREATE MATERIALIZED VIEW orders_by_status
BUILD IMMEDIATE
REFRESH INCREMENTAL FALLBACK ON SCHEDULE EVERY 5 MINUTE
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
)
AS
SELECT
    order_status,
    COUNT(*) AS order_count,
    SUM(amount) AS total_amount
FROM orders
GROUP BY order_status;
スケジュールタスクとコミット時タスクは、マテリアライズドビューの作成時に定義された更新方法で実行されます。INCREMENTAL は IVM だけを試し、INCREMENTAL FALLBACK はまず IVM を試して理由に応じてフォールバックし、AUTO は IVM、パーティション更新、完全更新を順に試します。自動トリガーのタスクには、次の動作もあります。
- 最初の自動更新は、自身でベースラインを構築します。 マテリアライズドビューの更新がまだ一度も成功していない場合(たとえば、
BUILD DEFERREDで作成したまま更新していない場合)、最初のスケジュールタスクまたはコミット時タスクが自動的にCOMPLETEを実行して完全なベースラインを構築します。手動でCOMPLETEを実行する必要はありません。その後のタスクは増分更新を行います。 - 同じマテリアライズドビューの更新タスクは直列に実行され、余分なトリガーはスキップされます。 自動トリガーのタスクは、実行中のタスクと待機中のタスクを最大で各自ひとつ保持します。間隔が単一の更新にかかる時間より短い場合や、
ON COMMITでベーステーブルのコミットが非常に頻繁な場合、新しいトリガーはスキップされ、FE メトリクスasync_materialized_view_task_skip_numが増加します。待機中のタスクが蓄積された変更を一度に処理するため変更は失われませんが、実際の更新遅延は設定した間隔より長くなります。通常の負荷で単一の増分更新が間隔内に完了するように、間隔を選んでください。 ON COMMITをトリガーするのは、増分保守に参加するベーステーブルだけです。excluded_trigger_tablesに列挙されたテーブルのコミットでは更新されません。excluded_trigger_tablesを参照してください。
トリガーを変更するときは ON 句だけを指定し、INCREMENTAL を繰り返さないでください。IVM の更新方法は ALTER で変更できないため、ALTER MATERIALIZED VIEW ... REFRESH INCREMENTAL ... は拒否されます。トリガーだけなら変更でき、Doris は新しいトリガーでスケジュールジョブを再作成します。
ALTER MATERIALIZED VIEW orders_by_status REFRESH ON SCHEDULE EVERY 1 MINUTE;
ALTER MATERIALIZED VIEW orders_by_status REFRESH ON COMMIT;
ALTER MATERIALIZED VIEW orders_by_status REFRESH ON MANUAL;
更新方法を手動で上書きする
IVM の作成後は、必要に応じて次のいずれかを実行できます。
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL;
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL FALLBACK;
REFRESH MATERIALIZED VIEW <mv_name> PARTITIONS;
REFRESH MATERIALIZED VIEW <mv_name> PARTITIONS FALLBACK;
REFRESH MATERIALIZED VIEW <mv_name> COMPLETE;
IVM では、更新対象のパーティションを名前で指定する従来の PARTITION (<partition_name>) または PARTITIONS (<partition_name>, ...) 構文を使用できません。PARTITIONS キーワードを使用して Doris に更新が必要なパーティションを計算させるか、COMPLETE ですべてのデータを更新してください。
フォールバックの順序
要求でフォールバックを許可している場合、Doris はデフォルトで次の順序を試します。
IVM -> PARTITIONS -> COMPLETE
失敗の種類によっては、既存の IVM ベースラインを安全に使用できなくなります。その場合、Doris はパーティション更新をスキップして COMPLETE を直接実行します。主な理由は次のとおりです。
IvmFallbackReason | 意味 | 復旧方法 |
|---|---|---|
STREAM_UNSUPPORTED | 内部 Stream が存在しないか、使用できなくなった | 完全更新する。これにより内部 Stream も再構築され、消費オフセットが再調整される |
MIN_MAX_BOUNDARY_HIT | 削除によって現在の MIN または MAX が変わる可能性がある | 集約結果を完全に再計算する |
BITMAP_AGG_DELETE | 削除が Bitmap 集約に影響する | Bitmap を完全に再計算する |
PLAN_SIGNATURE_MISMATCH | 現在のクエリプランが永続化された IVM のレイアウトと一致しない | 完全更新して新しいベースラインを構築する |
INCOMPLETE_REFRESH_SNAPSHOT | フォールバックの連鎖に必要な完全更新スナップショットがまだない | 完全更新してベースラインを構築する |
厳密な INCREMENTAL はフォールバックしません。タスクが失敗しても、マテリアライズドビューには更新前のデータが残り、内部 Stream の消費オフセットは進みません。エラーを修正した後、増分更新を再実行するか、COMPLETE でベースラインを再構築できます。
最初の更新とベースラインの再構築
増分更新で処理できるのは、ベースライン以降の変更だけです。ベースラインは、マテリアライズドビューの直近の完全計算結果と、それに対応付けられた内部 Stream の消費オフセットで構成されます。Doris はベースラインの有効性をマテリアライズドビューのパーティションごとに追跡します。ベースラインが無効なパーティションは全体を再構築し、ほかのパーティションは増分更新を続けます。
最初の更新
マテリアライズドビューの更新が一度も成功していない場合、どのパーティションにもベースラインがありません。要求した更新方法にかかわらず、最初の更新では全データを計算します。
| 更新要求 | 最初の更新の動作 |
|---|---|
COMPLETE | 全データを完全更新する |
INCREMENTAL | まずすべてのパーティションを再構築し、その後に差分を処理する |
INCREMENTAL FALLBACK、AUTO | COMPLETE を直接実行する |
| スケジュールまたはコミット時トリガー | COMPLETE を実行する。自動更新間隔の設定を参照 |
これらのタスクの RefreshMode はいずれも COMPLETE で、IvmFallbackReason は空です。したがって、IVM の作成後に COMPLETE を別途実行する必要はありません。クイックスタートでは、ベースライン構築の手順を明確にするためだけに COMPLETE を明示的に実行しています。
一部のパーティションのベースラインが無効になる場合
次のベーステーブル操作はメタデータだけを変更し、changelog に変更レコードを書き込みません。そのため、増分更新ではどの行が削除または置換されたかを変更から判別できません。これらのベーステーブルパーティションを読み取るマテリアライズドビューのパーティションを再構築する必要があります。
- 一部のパーティションだけを切り詰める場合を含む
TRUNCATE TABLE ALTER TABLE ... DROP PARTITIONRECOVER PARTITION- デフォルトの厳密な範囲一致を使用する
ALTER TABLE ... REPLACE PARTITION
マテリアライズドビューがベーステーブルのパーティション列でパーティション化されている場合、Doris は影響を受けるマテリアライズドビューのパーティションだけにマークを付けます。次の更新では、厳密な INCREMENTAL を指定した場合も、まずそれらのパーティションを再構築し、その後にほかのパーティションを増分更新します。tasks("type"="mv") の IvmRebuiltPartitions 列には、更新時に追加で再構築したパーティション数が記録されます。ベーステーブルのパーティションを削除した場合、対応するマテリアライズドビューのパーティションはパーティション同期時に削除されるため、再構築は不要です。
マテリアライズドビューがパーティション化されていない場合、または Doris が影響を受けるマテリアライズドビューのパーティションを特定できない場合は、後述のようにビュー全体のベースラインが無効になります。excluded_trigger_tables に列挙されたベーステーブルでこれらの操作を行っても、ベースラインは無効になりません。
マテリアライズドビュー全体のベースラインが無効になる場合
次の状況ではマテリアライズドビュー全体のベースラインが無効になり、ビューは SCHEMA_CHANGE 状態になります。この状態は mv_infos の State 列と SchemaChangeDetail 列で確認できます。
- ベーステーブルで
DROP COLUMN、MODIFY COLUMN、RENAME COLUMN、RENAME(テーブル名の変更)、REPLACE WITH TABLEを実行した場合。ADD COLUMNではベースラインは無効になりません。changelog を有効にしたテーブルではMODIFY COLUMNとRENAME COLUMNは許可されません。changelog の DDL 制限を参照してください。 - ベーステーブルで厳密な範囲一致を使用せずに
REPLACE PARTITIONを実行した場合、または前述のパーティション操作を特定のマテリアライズドビューパーティションに対応付けられない場合。 - プロパティの変更によってマテリアライズドビューの保守対象が広がった場合。たとえば、ベーステーブルを
excluded_trigger_tablesから除外する、ivm_partition_window_limitを拡大または削除する、partition_sync_limitの範囲を広げる場合。
マテリアライズドビューが SCHEMA_CHANGE 状態の間は、次の INCREMENTAL、INCREMENTAL FALLBACK、AUTO、COMPLETE、または PARTITIONS FALLBACK 更新でビュー全体を再構築し、成功すると状態が NORMAL に戻ります。FALLBACK のない PARTITIONS 更新は失敗し、代わりに COMPLETE、AUTO、または PARTITIONS FALLBACK を使用するよう求められます。
ベーステーブルの変更後に定義 SQL を解析できなくなった場合、たとえばマテリアライズドビューで使用する列が削除された場合は、すべての更新が失敗します。その場合はマテリアライズドビューを削除して作成し直す必要があります。
内部 Stream が使用できない場合
内部 Stream が存在しないか使用できなくなった場合、INCREMENTAL FALLBACK と AUTO は IvmFallbackReason を STREAM_UNSUPPORTED として COMPLETE を直接実行します。COMPLETE 更新では内部 Stream を再構築し、消費オフセットを再調整します。厳密な INCREMENTAL 更新は失敗するため、COMPLETE または AUTO を一度実行する必要があります。
差分プランのプレビューと説明
EXPLAIN で更新プランを表示する
次のコマンドはプランを生成するだけです。マテリアライズドビューのデータ、内部 Stream のオフセット、IVM のメタデータは変更しません。
EXPLAIN REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL;
デフォルトでは、プランに含まれるのは現在未消費のデータがある Stream だけです。差分プランの構造全体を確認するには、次を使用します。
EXPLAIN REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH ALL STREAMS;
WITH ALL STREAMS は、すでにすべて消費済みの Stream もプランに含めます。複数テーブルの結合について増分プラン全体の形を確認するのに役立ちます。永続化された状態は変更しません。
完全更新のプランも確認できます。
EXPLAIN REFRESH MATERIALIZED VIEW <mv_name> COMPLETE;
DRY RUN で書き込み対象の行を表示する
WITH DRY RUN は次の増分更新の差分クエリを実行し、その結果をクライアントに返します。マテリアライズドビューへの書き込みや Stream のオフセットの更新は行いません。
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH DRY RUN;
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH DRY RUN LIMIT 100;
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH DRY RUN LIMIT 100 OFFSET 200;
結果には、更新で実際に書き込まれる行が含まれます。そのため、業務データの列に加え、IVM、Sequence、Delete Sign などの内部列も含まれます。ベーステーブルのデータが変わらない限り、繰り返し実行しても同じ結果が返されます。
DRY RUN がサポートするのは IVM の INCREMENTAL 更新だけです。COMPLETE、EXPLAIN、パーティション更新とは組み合わせられません。
内部 Table Stream
IVM は内部 Table Stream のライフサイクル全体を自動管理します。
- IVM の作成時に、増分保守に参加する各ベーステーブルに内部 Stream が作成されます。
excluded_trigger_tablesを変更すると、新しいベーステーブルの集合に応じて内部 Stream が追加または削除されます。- IVM を削除すると、そのマテリアライズドビューが所有する内部 Stream も削除されます。
- 更新時には、消費オフセットがベーステーブルのパーティションごとに記録され、進められます。
mv_infos を使用すると、ベーステーブルと内部 Stream の対応関係を直接確認できます。
SELECT Name, IvmBaseTableStreams
FROM mv_infos("database" = "<database_name>")
WHERE Name = "<mv_name>";
information_schema.table_streams と information_schema.table_stream_consumption では、Stream の状態とパーティションごとの未処理量も確認できます。
内部 Stream の名前は __doris_ivm_stream_ で始まり、IVM 専用です。INSERT INTO ... SELECT で消費したり、手動で削除または再作成したりしないでください。Doris は通常の INSERT INTO による内部 Stream の消費を拒否します。
Table Stream のオフセット、スナップショット、同時実行のセマンティクスについては、Table Stream BasicsとTable Stream Advancedを参照してください。
IVM のプロパティ
まず行の識別、パーティションウィンドウ、トリガーの関係に基づいてプロパティを選び、詳しい影響を以下の各セクションで確認してください。
| プロパティ | デフォルト | 変更可能 | 効果 |
|---|---|---|---|
ivm_use_full_keys | false | いいえ | ソース行の識別キーをマテリアライズドビューの Unique Key に追加し、ハッシュ衝突のリスクを下げる |
ivm_partition_window_limit | 制限なし | はい | 指定したベーステーブルについて、パーティション値順で直近の N 個のパーティションだけを保守する |
excluded_trigger_tables | なし | はい | 内部 Stream が作成されず、それ自体では増分更新をトリガーしないベーステーブルを指定する |
ivm_use_full_keys
ivm_use_full_keys は、マテリアライズドビューの Unique Key にソース行の識別キーも含めるかどうかを制御します。
| 項目 | 説明 |
|---|---|
| 型 | Boolean |
| デフォルト | false |
| 変更可能 | いいえ。IVM の作成時にのみ設定できる |
| 効果 | 複合行識別子をハッシュ化する際の衝突リスクを下げる |
| コスト | マテリアライズドビューのキー幅とストレージ使用量が増える |
PROPERTIES (
    "ivm_use_full_keys" = "true"
)
クエリに複数テーブルの結合、UNION ALL、または連鎖した IVM が含まれ、ワークロードで行識別子のハッシュ衝突の回避が重要な場合は、このプロパティを有効にします。有効にする前に、ソースキーの型と合計長が Doris の Unique Key の制限を満たすことを確認してください。
ivm_partition_window_limit
ivm_partition_window_limit は、IVM の各更新で読み取る範囲を、指定したベーステーブルについてパーティション値順で直近の N 個のパーティションに制限します。形式は <table_name>:<partition_count> で、複数のテーブルはコンマで区切ります。
PROPERTIES (
    "ivm_partition_window_limit" = "orders:7,users:1"
)
このプロパティが制限するのは、IVM の増分更新で読み取るパーティションだけです。マテリアライズドビューのパーティション保持ポリシーではありません。COMPLETE は引き続きベーステーブル全体を読み取り、完全な結果を構築します。ウィンドウから除外された古いパーティションの変更は、その後の IVM 結果に入りません。したがって、これは変更を取りこぼす設定であり、直近のパーティションだけを明示的に対象とするワークロードに限って適しています。
このプロパティは ALTER MATERIALIZED VIEW ... SET で変更できます。ウィンドウを拡大または制限を削除すると、以前に無視した変更を既存のオフセットから復元できないため、マテリアライズドビューのベースラインが無効になり、次の更新でビュー全体が再構築されます。最初の更新とベースラインの再構築を参照してください。
excluded_trigger_tables
excluded_trigger_tables に列挙されたベーステーブルには内部 Stream が作成されず、そのテーブル単独の変更では増分更新がトリガーされません。ほかのベーステーブルの変更によって更新がトリガーされた場合、Doris は計算時にこれらのテーブルの現在のデータを引き続き読み取ります。
除外するのは、ほとんど変更されないディメンションテーブルか、別のベーステーブルが更新をトリガーするまで変更の反映を待てるテーブルだけにしてください。頻繁に変更されるテーブルを除外すると、そのテーブルだけが変更された後、マテリアライズドビューの結果が古いままになります。
リソースとパーティションのプロパティ
workload_group:更新タスクが使用する Workload Group。CPU とメモリのリソースを制限します。partition_sync_limit、partition_sync_time_unit:マテリアライズドビューが保持し同期するパーティションの範囲を制御します。これはivm_partition_window_limitの増分読み取りウィンドウとは異なります。refresh_partition_num:パーティション更新とフォールバックの際、単一のINSERTが処理するパーティション数を制御します。IVM の差分に含まれる行数は制御しません。
マテリアライズドビューのすべてのプロパティについては、CREATE ASYNC MATERIALIZED VIEWを参照してください。
制限と注意事項
- IVM を有効にできるのはマテリアライズドビューの作成時だけです。
ALTER MATERIALIZED VIEWで通常のマテリアライズドビューを IVM に変えたり、IVM のデフォルト更新方法を別の方法に変更したりすることはできません。切り替えるにはマテリアライズドビューを作成し直してください。 - changelog を有効にすると、書き込みとストレージの負荷が増えます。Unique Key MoW テーブルでは、各更新前の値も読み取り、保存する必要があります。IVM が実際に必要なベーステーブルでのみ有効にし、本番導入前に実際のワークロードに近い条件でロードスループットを評価してください。
- IVM も非同期タスクで更新するため、ベーステーブルのトランザクションとのリアルタイムな整合性は提供しません。更新遅延はトリガー方式、待機時間、差分プランの実行時間に左右されます。スケジュール更新の最短間隔は 1 分です。自動更新間隔の設定を参照してください。
- 複雑な入れ子の外部結合は、特に NULL 生成側に複雑な部分木がある場合に差分プランを大きくします。プランの作成や更新にかかるコストが高すぎる場合は、結合を簡素化するか、複雑な部分木を先に下位の IVM としてマテリアライズしてください。
MIN、MAX、Bitmap 集約では、一部の削除時に完全な再計算が必要です。本番環境ではINCREMENTAL FALLBACKまたはAUTOを使用し、IvmFallbackReasonを監視してください。- changelog のテーブルモデル、列の型、スキーマ変更、削除に関する制限は IVM にもそのまま適用されます。changelog のサポート範囲と制限を参照してください。
よくある質問
作成が失敗した場合、更新がフォールバックした場合、またはデータが更新されない場合は、次の表で原因を調べてください。
| 問題 | 診断と対処 |
|---|---|
CREATE MATERIALIZED VIEW ... REFRESH INCREMENTAL が失敗する | FE で enable_feature_changelog と enable_table_stream が有効か、ベーステーブルがテーブルモデルと changelog の要件を満たすか、定義 SQL が IVM のサポート範囲内かを確認する |
厳密な増分更新タスクの RefreshMode が COMPLETE と表示される、または IvmRebuiltPartitions が 0 より大きい | 最初の更新または無効になったベースラインの自動再構築であり、エラーではない。発生条件については最初の更新とベースラインの再構築を参照 |
FALLBACK のない PARTITIONS 更新が The refresh baseline of MV ... was invalidated で失敗する | マテリアライズドビュー全体のベースラインが無効になっている。代わりに COMPLETE、AUTO、または PARTITIONS FALLBACK で更新する |
ON SCHEDULE EVERY 30 SECOND が interval time unit can not be second で失敗する | スケジュールの最短間隔は EVERY 1 MINUTE で、単位は MINUTE、HOUR、DAY、WEEK に限られる。遅延を短くする必要がある場合は ON COMMIT を使用する。自動更新間隔の設定を参照 |
| スケジュール更新の実際の遅延が設定間隔より長い | 同じマテリアライズドビューのタスクは直列に実行され、単一の更新が間隔より長くかかると余分なトリガーはスキップされる。tasks("type"="mv") でタスクの所要時間を、FE メトリクス async_materialized_view_task_skip_num でスキップを確認し、間隔を延ばす、定義を簡素化する、または workload_group で更新用のリソースを増やす |
更新タスクが COMPLETE にフォールバックする | tasks("type"="mv") の IvmFallbackReason をクエリし、フォールバックの順序に記載された理由に応じて対処する |
| 除外したベーステーブルだけが変更されてもビューが更新されない | excluded_trigger_tables 内のテーブル単独の変更では更新がトリガーされない。ほかのベーステーブルによる更新を待つか、COMPLETE 更新を実行する。そのテーブルを excluded_trigger_tables から除外すると、次の更新でマテリアライズドビュー全体が再構築される |
| 内部 Stream を手動で消費またはリセットできるか | できない。内部 Stream は IVM 専用であり、Doris がライフサイクルと消費オフセットを管理する |
ベストプラクティス
- まず変更行数とパーティションサイズを比較します。 変更がパーティションの一部にとどまるなら IVM を優先します。変更がパーティションの大半に及ぶなら、
PARTITIONSのほうが簡単な場合があります。 - 本番環境では安全なフォールバックを有効にします。
INCREMENTAL FALLBACKまたはAUTOを使用し、削除やベースラインの問題によって更新の失敗が長く続くことを防ぎます。 - 更新の所要時間に基づいてトリガーと間隔を選びます。 スケジュールの最短間隔は 1 分です。通常の負荷で単一の増分更新にかかる時間より長い間隔を設定してください。遅延を短くする必要があり、ベーステーブルのコミットが頻繁すぎない場合は
ON COMMITを使用します。 - 最初にベースラインを確認します。 最初の更新では全データを計算します。その結果を確認してから、増分更新による維持を開始してください。
- 更新と削除があるワークロードには Unique Key MoW を使用します。 Duplicate Key テーブルは追加専用データにのみ適しています。
- 更新タスクのリソースを分離します。
workload_groupを使用し、複雑な差分プランがオンラインクエリとリソースを奪い合わないようにします。 - タスクと Stream の未処理量を監視します。
tasks("type"="mv")、mv_infos、information_schema.table_stream_consumptionを併せて確認します。 - フォールバック理由を定期的に確認します。 ときどき発生するフォールバックは正確性を守ります。継続的なフォールバックは、クエリの形、changelog の連続性、またはベースラインの確認が必要であることを示します。
サンプル環境のクリーンアップ
DROP MATERIALIZED VIEW orders_by_status;
DROP TABLE orders;
DROP DATABASE ivm_demo;
IVM を削除すると、Doris は内部 Table Stream も削除します。別途 DROP STREAM を実行する必要はありません。
関連項目
- 非同期マテリアライズドビューの機能とユースケースの概要:Async Materialized View Overview
- 非同期マテリアライズドビューの作成、クエリ、保守:Manage and Query Async Materialized Views
- 更新方法の選択とリソース計画:Async Materialized View Best Practices
- changelog の有効化方法と制限:Changelog
- Table Stream の消費、オフセット、スナップショットのセマンティクス:Table Stream Basics
- 手動更新の構文:REFRESH MATERIALIZED VIEW
- IVM と内部 Stream の対応関係の表示:MV_INFOS
- 更新範囲とフォールバック理由の表示:TASKS