結合(JOIN)
データ分析では、業務データが複数のテーブル(注文テーブル、ユーザーテーブル、商品テーブルなど)に分かれていることがよくあります。これらのテーブルを関連付けて分析結果を得るには、JOIN を使用します。この記事では、Apache Doris がサポートする JOIN の種類に加え、MPP アーキテクチャにおける JOIN の物理実装と Shuffle 戦略を説明し、用途に合った JOIN 方法を選べるようにします。
JOIN とは
リレーショナルデータベースでは、データは特定の関係で結び付いた複数のテーブルに分散しています。SQL の JOIN 演算を使用すると、結合条件に基づいて異なるテーブルを組み合わせ、より完全な結果セットを得られます。
Doris がサポートする JOIN の種類
Doris は、通常の結合からアンチ結合、セミ結合まで、次の JOIN をサポートします。
| JOIN の種類 | 説明 |
|---|---|
| INNER JOIN | JOIN 条件を使用して左テーブルの各行と右テーブルの全行を比較し、条件を満たす両テーブルの行を返します。 |
| LEFT JOIN | INNER JOIN の結果に加え、左テーブルの行に対応する右テーブルの行がない場合も左テーブルの行を返します。このとき、右テーブルの対応する列には NULL が入ります。 |
| RIGHT JOIN | LEFT JOIN の逆です。右テーブルの行に対応する左テーブルの行がない場合も右テーブルの行を返し、左テーブルの対応する列には NULL が入ります。 |
| FULL JOIN | INNER JOIN の結果に加え、両テーブルのすべての行を返します。相手側のテーブルに一致する行がない場合、そのテーブルの対応する列には NULL が入ります。 |
| CROSS JOIN | JOIN 条件を指定せず、二つのテーブルのデカルト積を返します。左テーブルの各行が右テーブルの各行と組み合わされます。 |
| LEFT SEMI JOIN | JOIN 条件を使用して左テーブルの各行と右テーブルの全行を比較し、一致する行があれば左テーブルの該当行を返します。 |
| RIGHT SEMI JOIN | LEFT SEMI JOIN の逆です。JOIN 条件を使用して右テーブルの各行と左テーブルの全行を比較し、一致する行があれば右テーブルの該当行を返します。 |
| LEFT ANTI JOIN | JOIN 条件を使用して左テーブルの各行と右テーブルの全行を比較し、一致する行がなければ左テーブルの該当行を返します。 |
| RIGHT ANTI JOIN | LEFT ANTI JOIN の逆です。JOIN 条件を使用して右テーブルの各行と左テーブルの全行を比較し、一致する行がなければ右テーブルの該当行を返します。 |
| NULL AWARE LEFT ANTI JOIN | NULL 値を特別に処理する LEFT ANTI JOIN です。LEFT ANTI JOIN と似ていますが、左テーブルの照合対象の列が NULL の行を無視します。 |
JOIN の SQL 構文全体については、SELECT を参照してください。
JOIN の物理実装
Doris は、JOIN の物理実装として Hash Join と Nest Loop Join の二種類をサポートします。それぞれの適用場面は次のとおりです。
-
Hash Join: 等価 JOIN の列に基づいて右テーブルのハッシュテーブルを構築し、左テーブルのデータをそのハッシュテーブルに通して JOIN を計算します。この方法は等価 JOIN 条件にしか適用できません。
-
Nest Loop Join: 左テーブルを基点とする二重ループを使用し、左テーブルの各行について右テーブルのすべての行を走査して JOIN 条件を評価します。大小比較を含むクエリやデカルト積の計算など、Hash Join では処理できない場合を含むすべての JOIN に適用できます。ただし、Hash Join より性能が低くなる場合があります。
Hash Join の Shuffle 戦略
分散 MPP データベースである Apache Doris は、JOIN 結果の正しさを確保するため、Hash Join の際にデータを適切な場所へ振り分け、分割する必要があります。Doris は、データ分散に対する要件と期待できる性能が低い順に、Broadcast Join、Partition Shuffle Join、Bucket Shuffle Join、Colocate Join の四つの Shuffle 戦略を提供します。
Broadcast Join
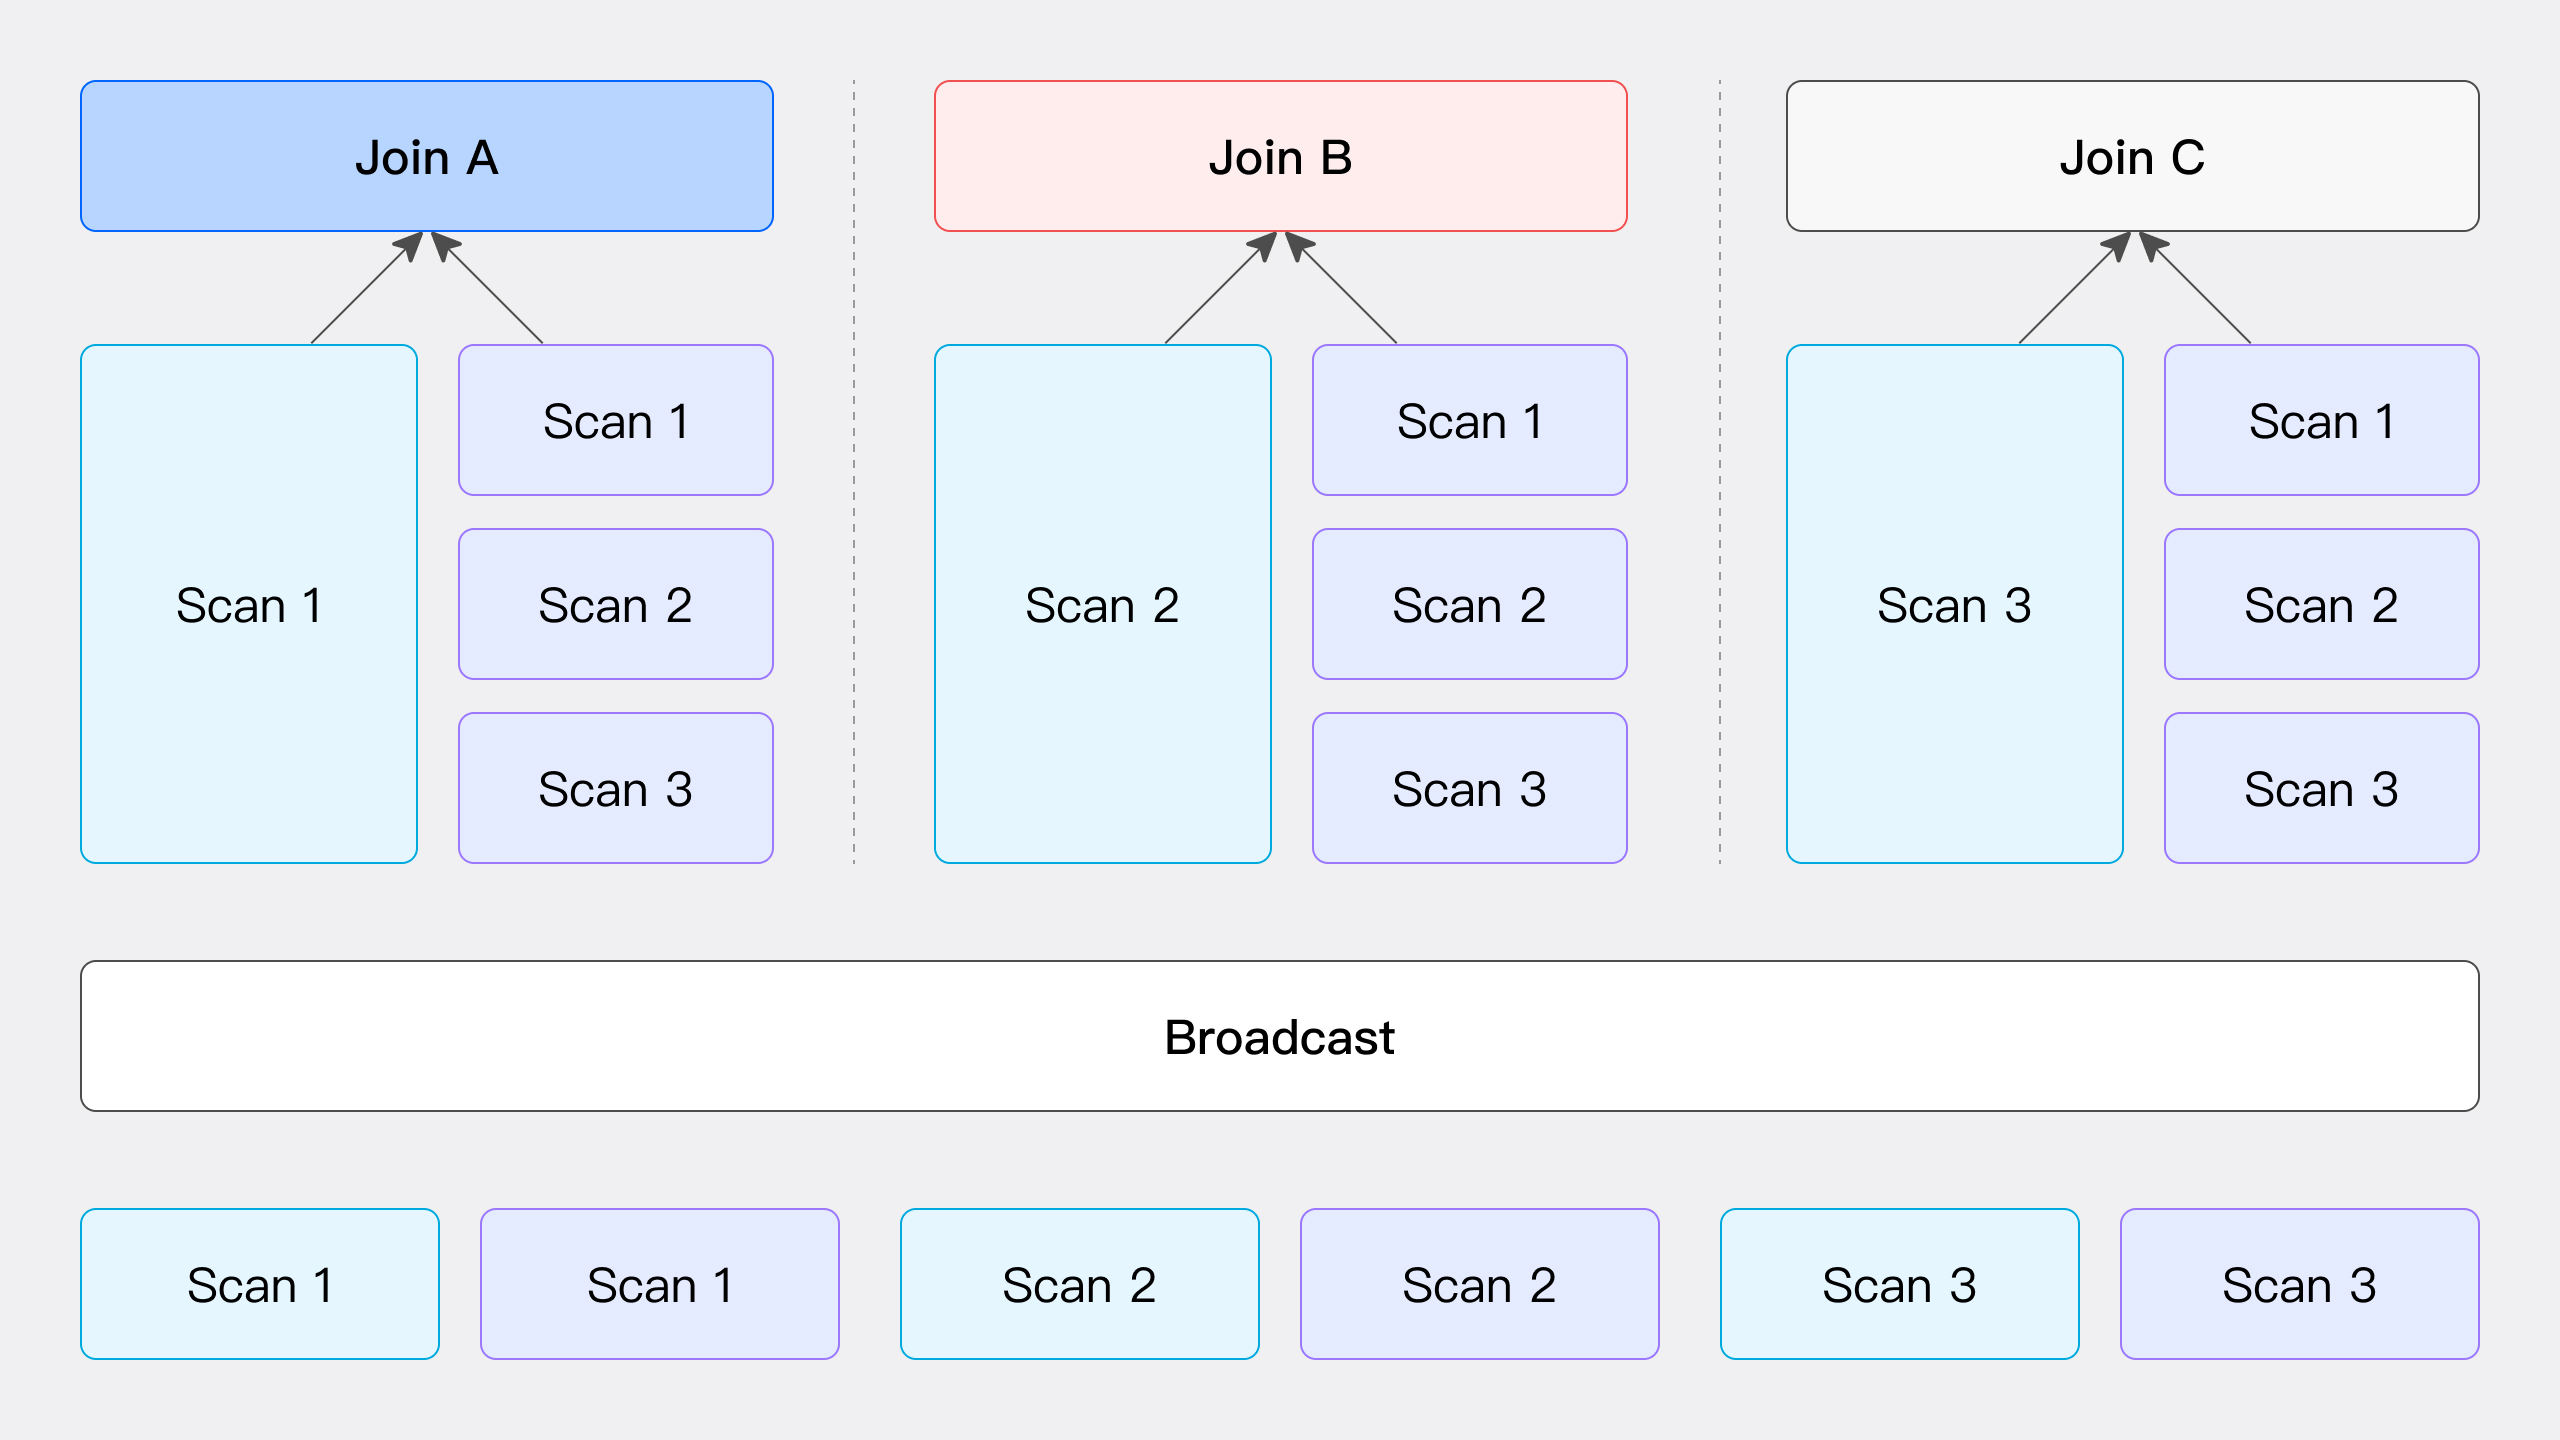
図に示すように、Broadcast Join では、右テーブルのすべてのデータを、左テーブルのデータをスキャンするノードを含む、JOIN の計算に参加するすべてのノードへ送信します。左テーブルのデータは移動しません。この処理で各ノードは右テーブルの完全なコピー(それぞれ T(R) のデータ)を受け取り、JOIN に必要なデータをそろえます。
この方法は多くの一般的な場面に適用できますが、RIGHT OUTER、RIGHT ANTI、RIGHT SEMI の各 Hash Join には使用できません。ネットワーク負荷は、JOIN ノード数 N と右テーブルのデータ量 T(R) の積になります。
Partition Shuffle Join
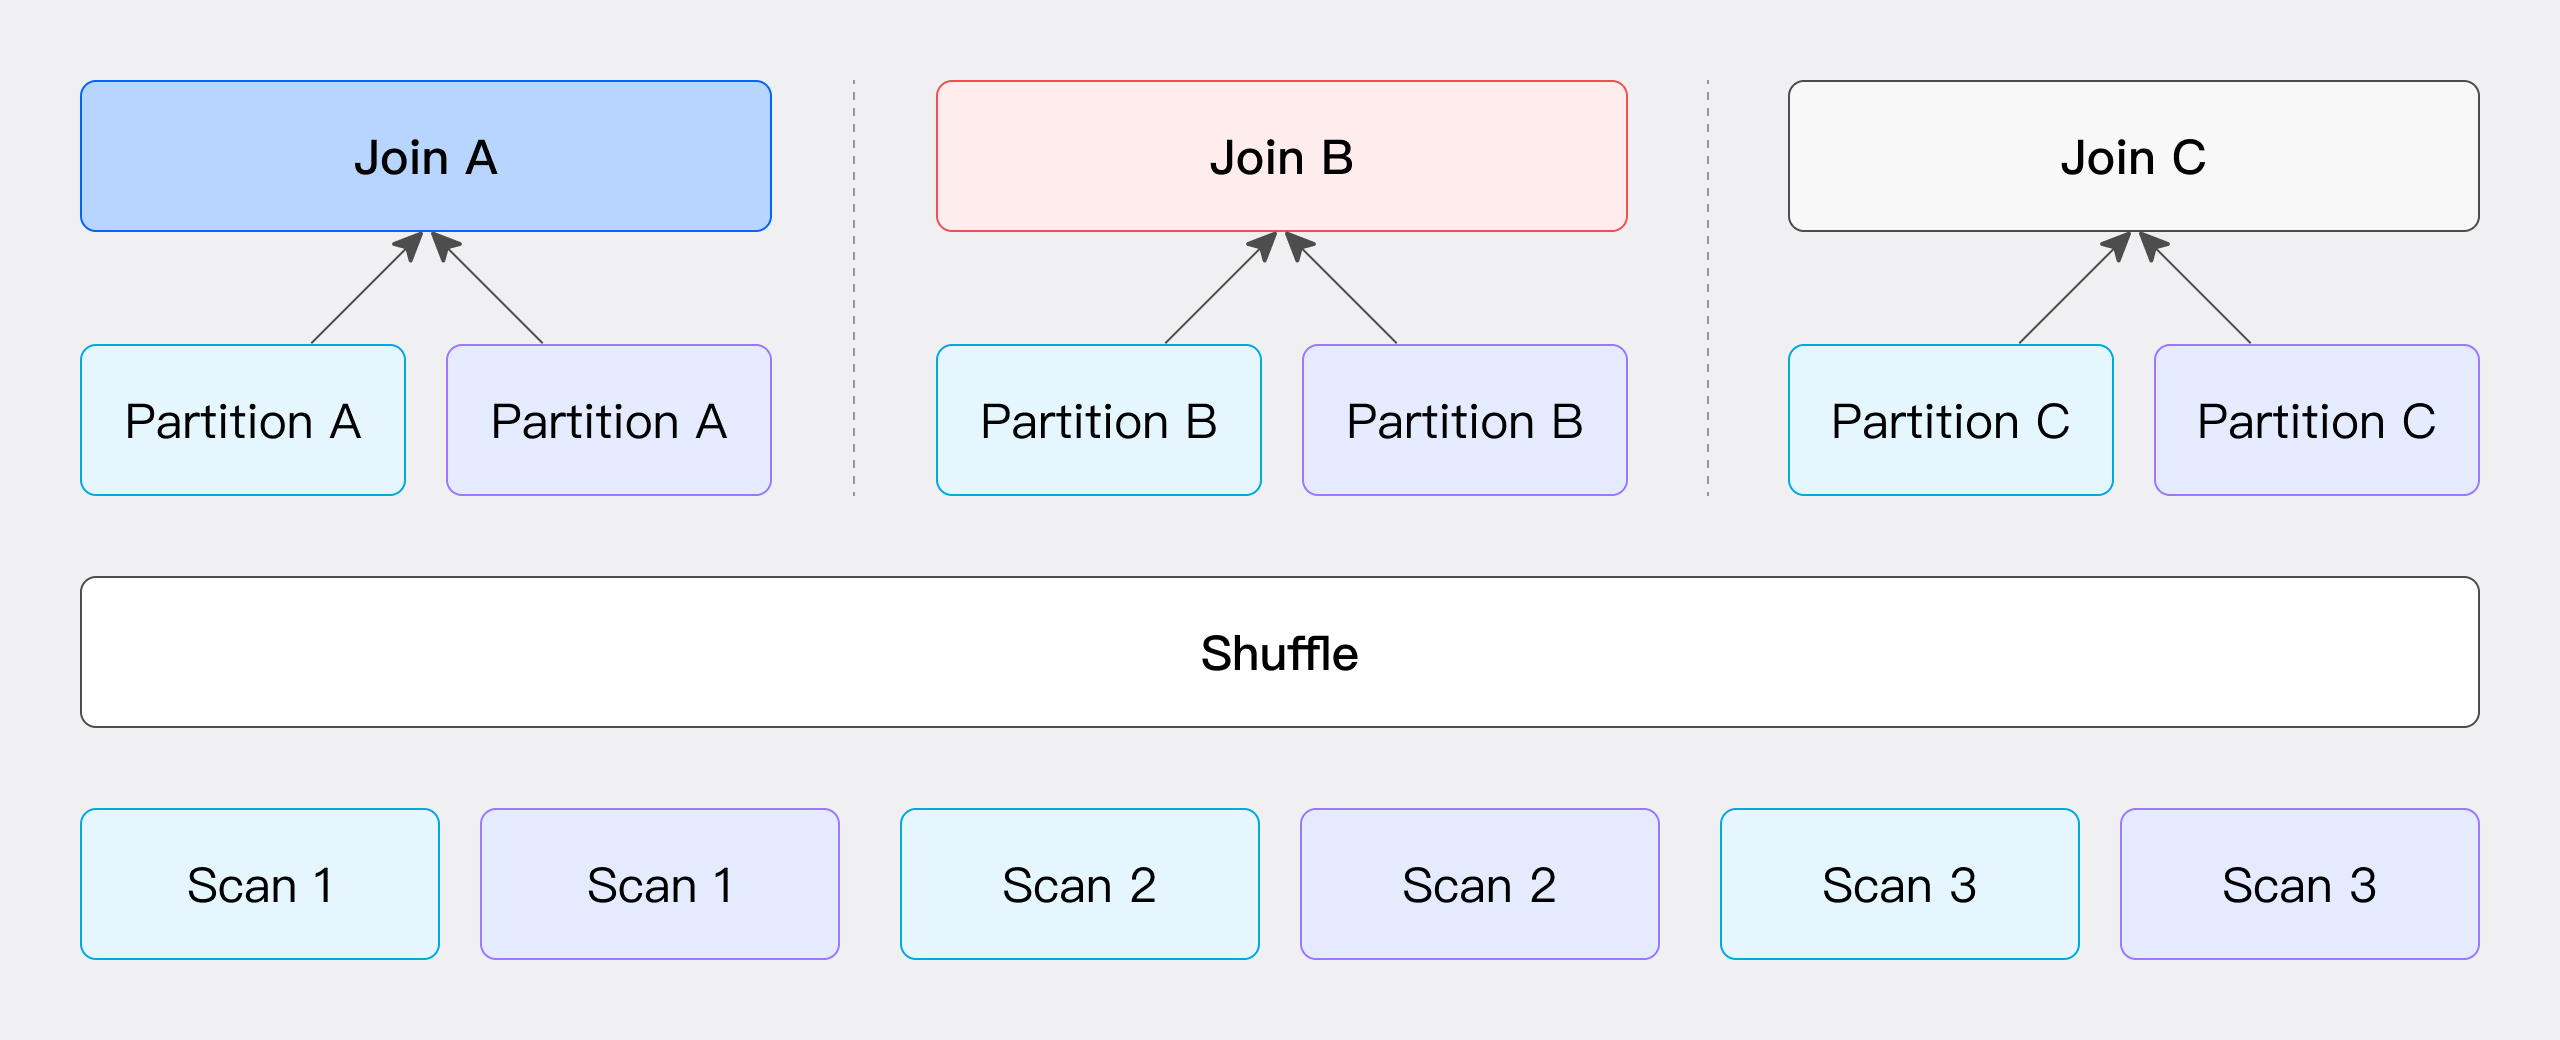
この方法では、JOIN 条件からハッシュ値を計算し、それに応じてデータを分割します。具体的には、左テーブルと右テーブルのデータを JOIN 条件から計算したハッシュ値に従って分割し、各パーティションを対応するノードへ送信します(図を参照)。
この方法のネットワーク負荷は、左テーブルのデータ T(S) と右テーブルのデータ T(R) をそれぞれ転送する負荷の合計です。データをバケットに振り分ける際に JOIN 条件を使用するため、この方法がサポートするのは Hash Join のみです。
Bucket Shuffle Join
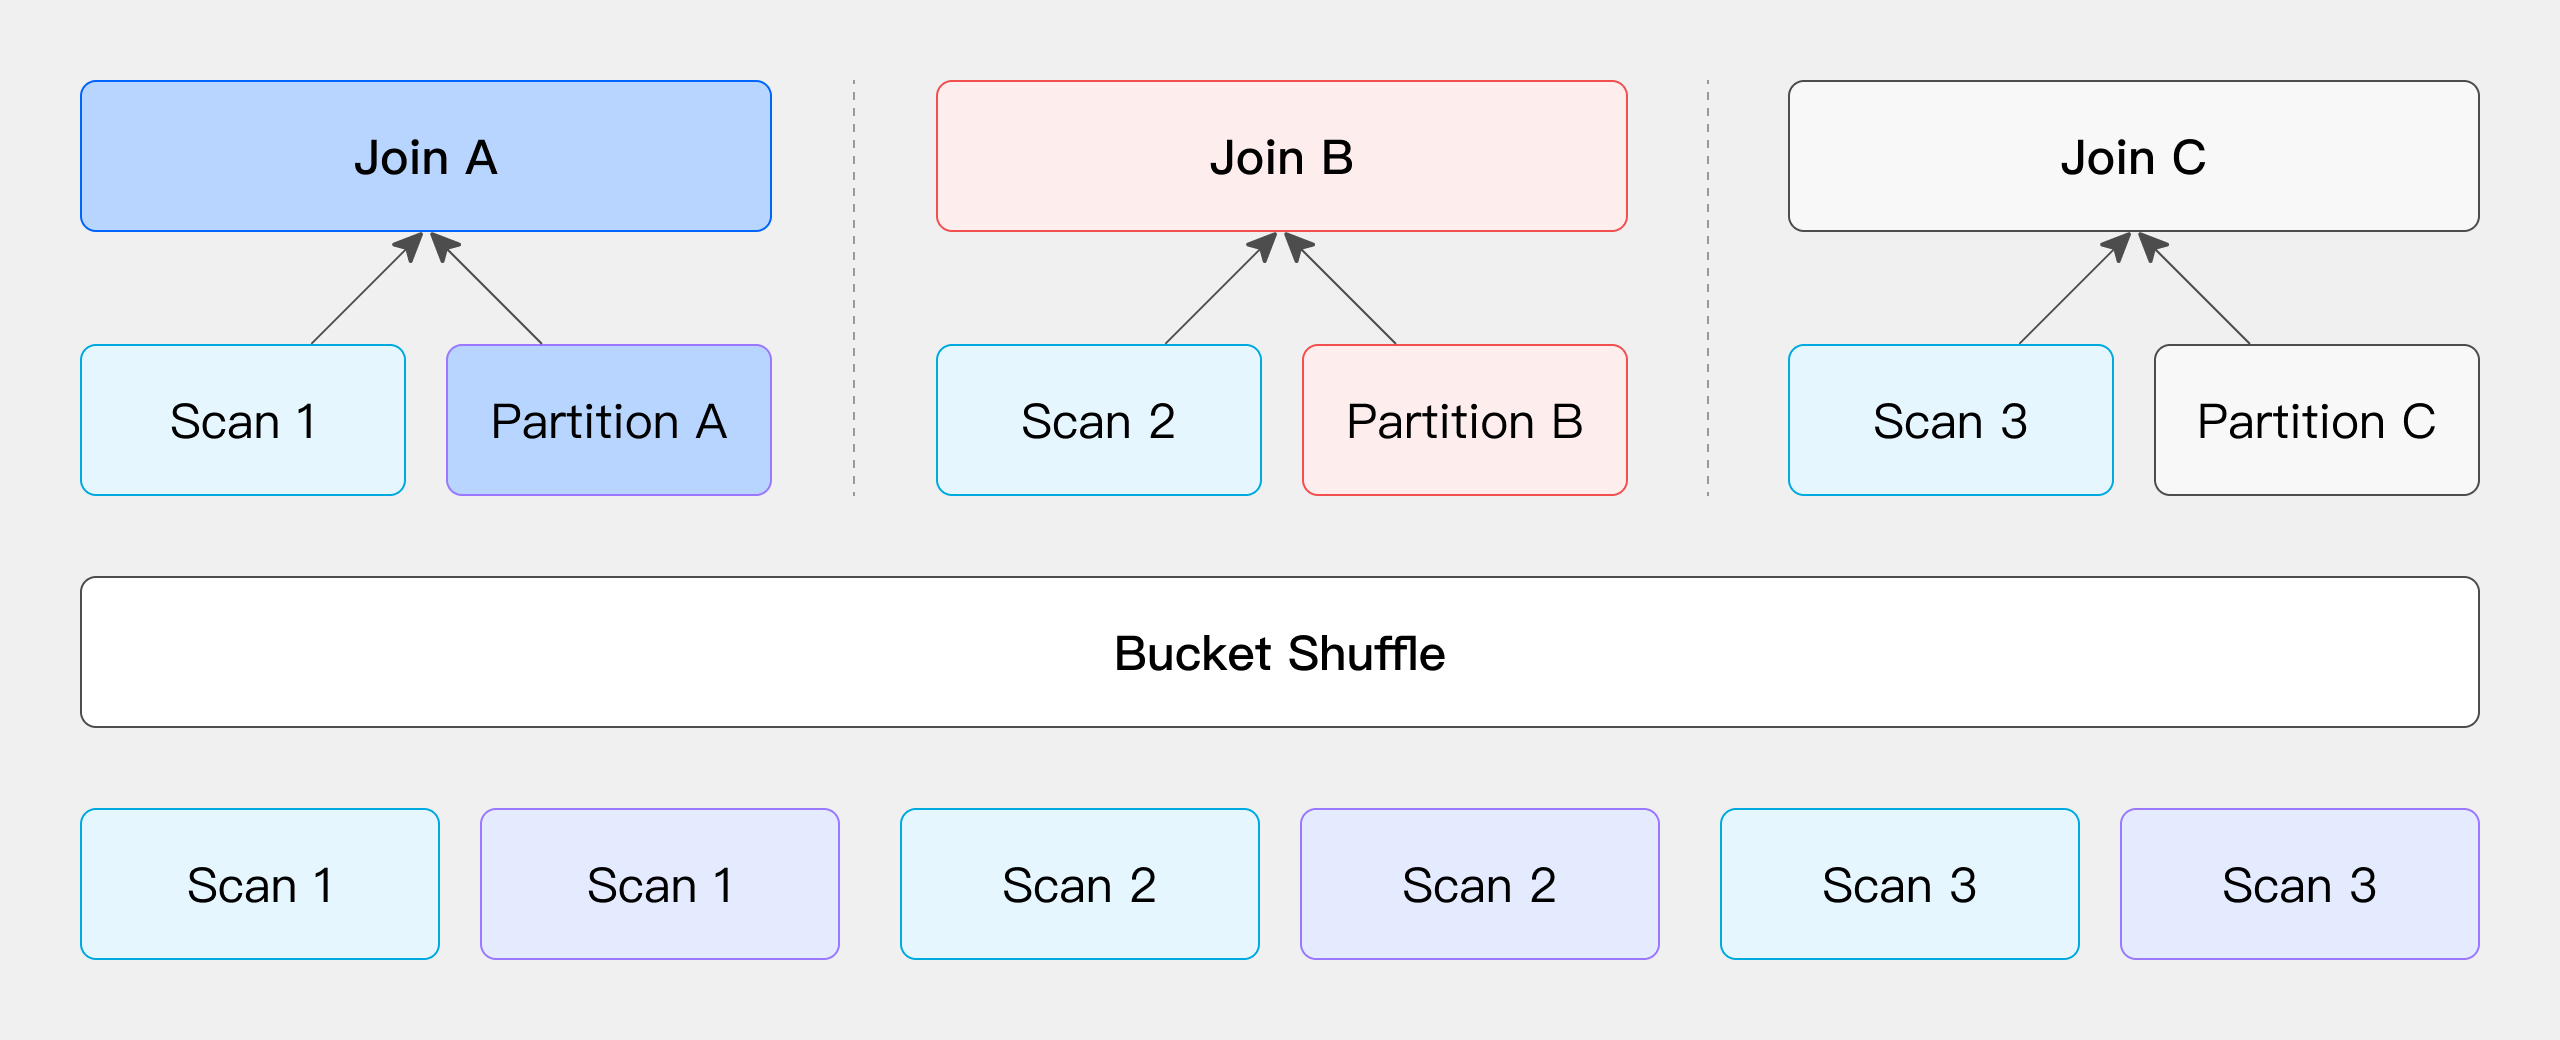
JOIN 条件に左テーブルのバケット列が含まれる場合、左テーブルのデータは移動させず、右テーブルのデータを左テーブル側のノードに振り分けて JOIN を行います。これにより、ネットワーク負荷を抑えられます。
JOIN の一方のデータがすでに JOIN 条件の列でハッシュ分散されている場合、そのデータを移動させず、他方のデータを同じ JOIN 条件の列と同じハッシュ分散計算で振り分けることができます。(ここでいう「テーブル」は物理的に保存されたテーブルに限りません。SQL クエリ内の任意の演算子の出力も含み、左側と右側のどちらのデータをその場に残すかを選び、他方を移動して振り分けることができます。)
Doris の物理テーブルを例に説明します。テーブルのデータはハッシュ計算によってバケットに格納されるため、この性質を直接利用して JOIN のデータ移動を最適化できます。二つのテーブルを結合し、JOIN 列が左テーブルのバケット列であるとします。この場合、左テーブルのデータを移動する必要はありません。右テーブルのデータを左テーブルのバケット情報に基づいて対応する位置へ振り分ければ、JOIN を計算できます(図を参照)。
この処理のネットワーク負荷は、主に右テーブルのデータ T(R) の移動によって生じます。
Colocate Join
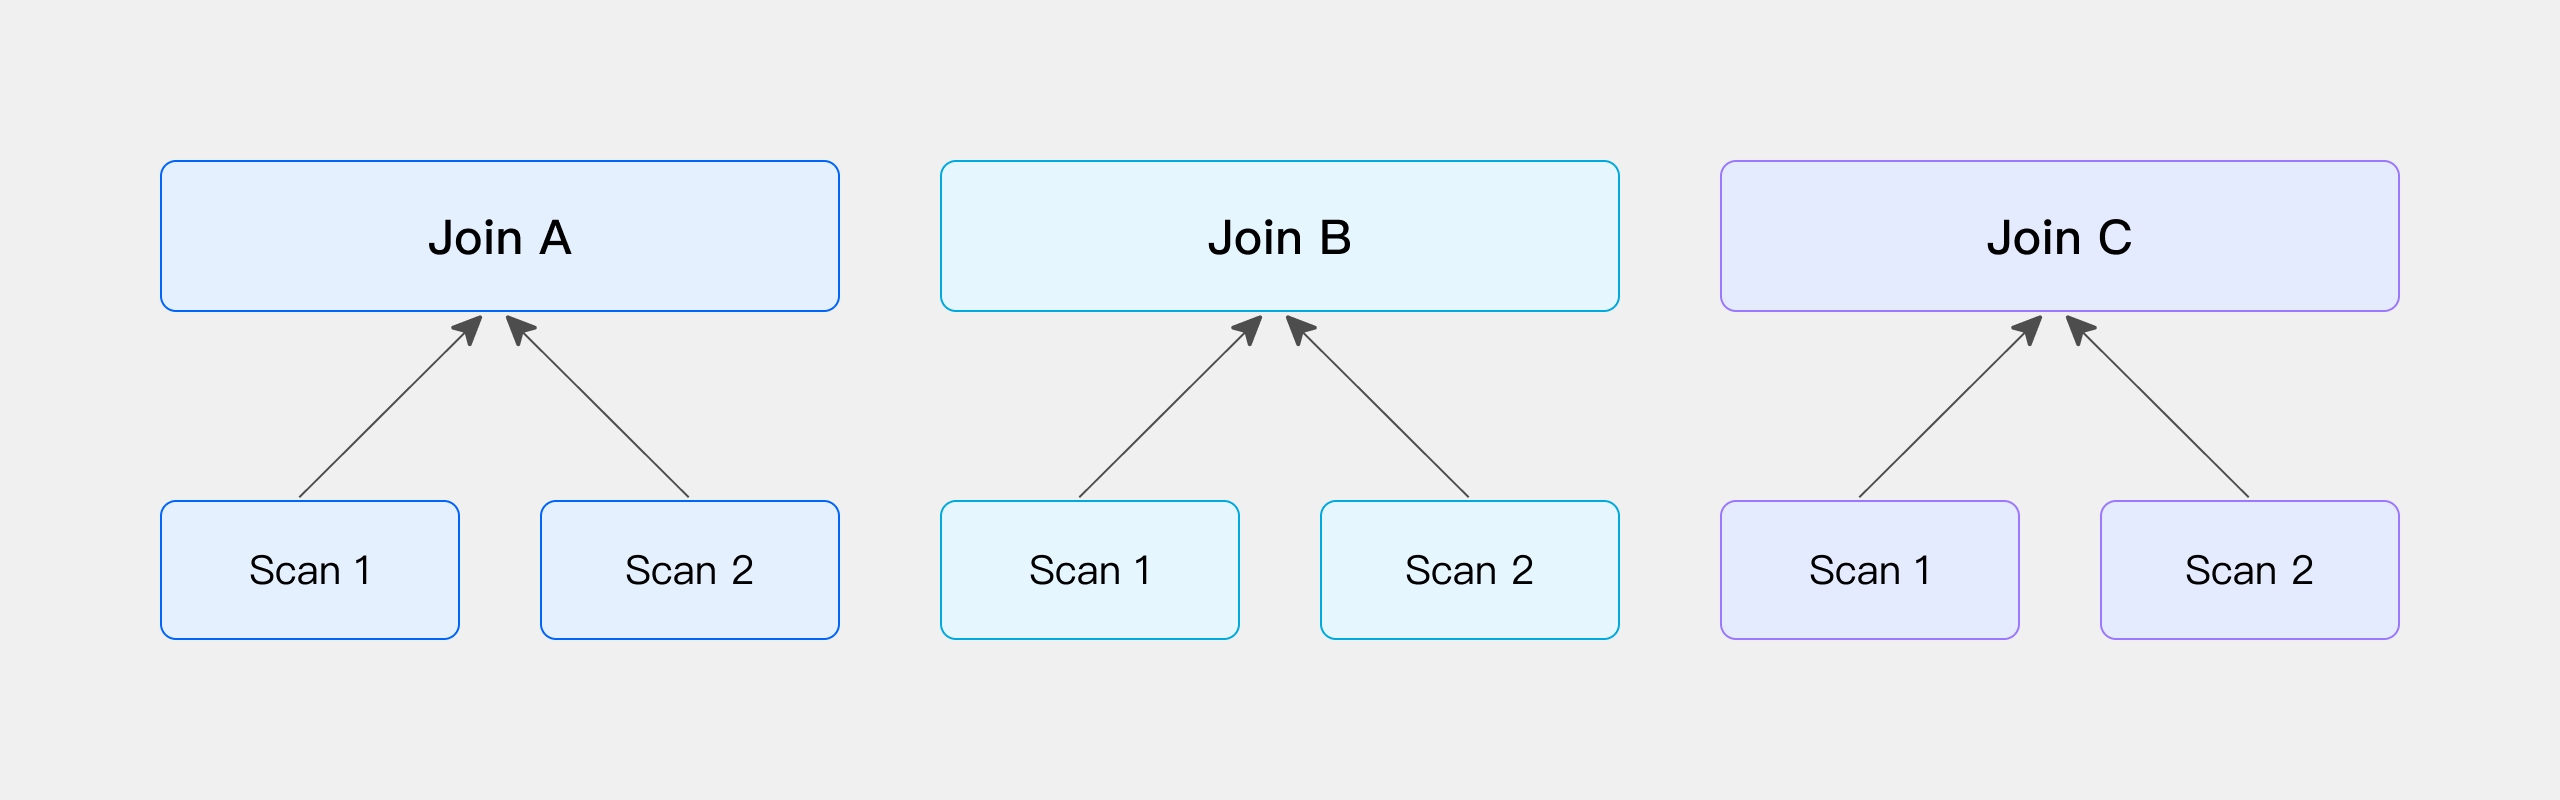
Bucket Shuffle Join と同様に、JOIN に参加する両テーブルが JOIN 条件の列でハッシュ分散されている場合は、Shuffle 処理を省き、ローカルノードで直接 JOIN を計算できます。以下、物理テーブルを使って簡単に説明します。
Doris のテーブルを DISTRIBUTED BY HASH で作成すると、データの取り込み時にハッシュ分散キーに基づいてデータが振り分けられます。二つのテーブルのハッシュ分散キーが JOIN 条件の列と一致する場合、両テーブルのデータは JOIN の要件に従ってあらかじめ分散されているとみなせるため、追加の Shuffle は不要です。そのため、実際のクエリでは、これら二つのテーブルに対して直接 JOIN を計算できます。
データのスキャン直後に JOIN を行う場合は、テーブルの作成時に一定の条件を満たす必要があります。詳しくは、後述する二つの物理テーブルに関する Colocate Join の制約 を参照してください。
四つの Shuffle 方法の比較
次の表に、四つの Shuffle 方法のネットワーク負荷、対応する物理演算子、適用場面をまとめます。
| Shuffle 方法 | ネットワーク負荷 | 物理演算子 | 適用場面 |
|---|---|---|---|
| Broadcast | N * T(R) | Hash Join / Nest Loop Join | 一般的な場面 |
| Shuffle | T(S) + T(R) | Hash Join | 一般的な場面 |
| Bucket Shuffle | T(R) | Hash Join | JOIN 条件に左テーブルのバケット列が含まれ、左テーブルが単一パーティションである場合。 |
| Colocate | 0 | Hash Join | JOIN 条件に左テーブルのバケット列が含まれ、両テーブルが同じ Colocate Group に属する場合。 |
- N: JOIN の計算に参加する Instance の数。
- T(relation): リレーションに含まれるタプルの数。
上記四つの Shuffle 方法は、順に柔軟性が低くなり、データ分散に対する要件が厳しくなります。多くの場合、データ分散の要件が高くなるほど、JOIN の性能も向上する傾向があります。ただし、テーブルのバケット数が少ない場合、Bucket Shuffle Join や Colocate Join は並列度が低くなって性能が落ち、Shuffle Join より遅くなる可能性があります。これは、Shuffle 処理によってデータをより均等に分散でき、後続処理の並列度を高められるためです。
Bucket Shuffle Join と Colocate Join の実例
前述のとおり、Bucket Shuffle Join と Colocate Join は、JOIN に参加する両側のデータ分散が所定の条件を満たせば実行できます(ここでいう「テーブル」は広い意味で使っています。SQL クエリ内の任意の演算子の出力を「テーブル」とみなせます)。
次に、二つのテーブル t1 と t2 と関連する SQL の例を使い、この広い意味での Bucket Shuffle Join と Colocate Join を説明します。まず、二つのテーブルを作成する CREATE TABLE 文を示します。
create table t1
(
    c1 bigint,
    c2 bigint
)
DISTRIBUTED BY HASH(c1) BUCKETS 3
PROPERTIES ("replication_num" = "1");

create table t2
(
    c1 bigint,
    c2 bigint
)
DISTRIBUTED BY HASH(c1) BUCKETS 3
PROPERTIES ("replication_num" = "1");
Bucket Shuffle Join の例
次の例では、t1 と t2 の両方を GROUP BY 演算子で処理して新しいテーブルを生成します(この時点で、tx は c1 によって、ty は c2 によってハッシュ分散されています)。続く JOIN 条件は tx.c1 = ty.c2 であり、Bucket Shuffle Join の条件を満たしています。
explain select *
from
    (
        -- Table t1 is hash-distributed by c1, and after the group by operator, it remains hash-distributed by c1.
        select c1 as c1, sum(c2) as c2
        from t1
        group by c1
    ) tx
join
    (
        -- Table t2 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t2
        group by c2
    ) ty
on tx.c1 = ty.c2;
以下の Explain 出力では、Hash Join ノード 7 の左の子が集約ノード 6、右の子が Exchange ノード 4 です。これは、集約後の左の子のデータは移動せず、右の子のデータが Bucket Shuffle によって左の子のノードへ振り分けられ、その後に Hash Join が実行されることを示します。
+------------------------------------------------------------+
| Explain String(Nereids Planner)                            |
+------------------------------------------------------------+
| PLAN FRAGMENT 0                                            |
|   OUTPUT EXPRS:                                            |
|     c1[#18]                                                |
|     c2[#19]                                                |
|     c2[#20]                                                |
|     c1[#21]                                                |
|   PARTITION: HASH_PARTITIONED: c1[#8]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   VRESULT SINK                                             |
|      MYSQL_PROTOCAL                                        |
|                                                            |
|   7:VHASH JOIN(364)                                        |
|   |  join op: INNER JOIN(BUCKET_SHUFFLE)[]                 |
|   |  equal join conjunct: (c1[#12] = c2[#6])               |
|   |  cardinality=10                                        |
|   |  vec output tuple id: 8                                |
|   |  output tuple id: 8                                    |
|   |  vIntermediate tuple ids: 7                            |
|   |  hash output slot ids: 6 7 12 13                       |
|   |  final projections: c1[#14], c2[#15], c2[#16], c1[#17] |
|   |  final project output tuple id: 8                      |
|   |  distribute expr lists: c1[#12]                        |
|   |  distribute expr lists: c2[#6]                         |
|   |                                                        |
|   |----4:VEXCHANGE                                         |
|   |       offset: 0                                        |
|   |       distribute expr lists: c2[#6]                    |
|   |                                                        |
|   6:VAGGREGATE (update finalize)(342)                      |
|   |  output: sum(c2[#9])[#11]                              |
|   |  group by: c1[#8]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  final projections: c1[#10], c2[#11]                   |
|   |  final project output tuple id: 6                      |
|   |  distribute expr lists: c1[#8]                         |
|   |                                                        |
|   5:VOlapScanNode(339)                                     |
|      TABLE: tt.t1(t1), PREAGGREGATION: ON                  |
|      partitions=1/1 (t1)                                   |
|      tablets=1/1, tabletList=491188                        |
|      cardinality=21, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
| PLAN FRAGMENT 1                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c2[#2]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 04                                        |
|     BUCKET_SHFFULE_HASH_PARTITIONED: c2[#6]                |
|                                                            |
|   3:VAGGREGATE (merge finalize)(355)                       |
|   |  output: sum(partial_sum(c1)[#3])[#5]                  |
|   |  group by: c2[#2]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  final projections: c2[#4], c1[#5]                     |
|   |  final project output tuple id: 3                      |
|   |  distribute expr lists: c2[#2]                         |
|   |                                                        |
|   2:VEXCHANGE                                              |
|      offset: 0                                             |
|      distribute expr lists:                                |
|                                                            |
| PLAN FRAGMENT 2                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#0]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 02                                        |
|     HASH_PARTITIONED: c2[#2]                               |
|                                                            |
|   1:VAGGREGATE (update serialize)(349)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#0])[#3]                       |
|   |  group by: c2[#1]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  distribute expr lists: c1[#0]                         |
|   |                                                        |
|   0:VOlapScanNode(346)                                     |
|      TABLE: tt.t2(t2), PREAGGREGATION: ON                  |
|      partitions=1/1 (t2)                                   |
|      tablets=1/1, tabletList=491198                        |
|      cardinality=10, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
|                                                            |
| Statistics                                                 |
|  planed with unknown column statistics                     |
+------------------------------------------------------------+
97 rows in set (0.01 sec)
Colocate Join の例
次の例では、t1 と t2 の両方を GROUP BY 演算子で処理して新しいテーブルを生成します(この時点で、tx と ty はどちらも c2 によってハッシュ分散されています)。続く JOIN 条件は tx.c2 = ty.c2 であり、Colocate Join の条件を満たしています。
explain select *
from
    (
        -- Table t1 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t1
        group by c2
    ) tx
join
    (
        -- Table t2 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t2
        group by c2
    ) ty
on tx.c2 = ty.c2;
以下の Explain 出力では、Hash Join ノード 8 の左の子が集約ノード 7、右の子が集約ノード 3 であり、その間に Exchange ノードはありません。これは、集約後の両側のデータを移動させる必要がなく、その後の Hash Join をローカルで実行できることを示します。
+------------------------------------------------------------+
| Explain String(Nereids Planner)                            |
+------------------------------------------------------------+
| PLAN FRAGMENT 0                                            |
|   OUTPUT EXPRS:                                            |
|     c2[#20]                                                |
|     c1[#21]                                                |
|     c2[#22]                                                |
|     c1[#23]                                                |
|   PARTITION: HASH_PARTITIONED: c2[#10]                     |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   VRESULT SINK                                             |
|      MYSQL_PROTOCAL                                        |
|                                                            |
|   8:VHASH JOIN(373)                                        |
|   |  join op: INNER JOIN(PARTITIONED)[]                    |
|   |  equal join conjunct: (c2[#14] = c2[#6])               |
|   |  cardinality=10                                        |
|   |  vec output tuple id: 9                                |
|   |  output tuple id: 9                                    |
|   |  vIntermediate tuple ids: 8                            |
|   |  hash output slot ids: 6 7 14 15                       |
|   |  final projections: c2[#16], c1[#17], c2[#18], c1[#19] |
|   |  final project output tuple id: 9                      |
|   |  distribute expr lists: c2[#14]                        |
|   |  distribute expr lists: c2[#6]                         |
|   |                                                        |
|   |----3:VAGGREGATE (merge finalize)(367)                  |
|   |    |  output: sum(partial_sum(c1)[#3])[#5]             |
|   |    |  group by: c2[#2]                                 |
|   |    |  sortByGroupKey:false                             |
|   |    |  cardinality=5                                    |
|   |    |  final projections: c2[#4], c1[#5]                |
|   |    |  final project output tuple id: 3                 |
|   |    |  distribute expr lists: c2[#2]                    |
|   |    |                                                   |
|   |    2:VEXCHANGE                                         |
|   |       offset: 0                                        |
|   |       distribute expr lists:                           |
|   |                                                        |
|   7:VAGGREGATE (merge finalize)(354)                       |
|   |  output: sum(partial_sum(c1)[#11])[#13]                |
|   |  group by: c2[#10]                                     |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  final projections: c2[#12], c1[#13]                   |
|   |  final project output tuple id: 7                      |
|   |  distribute expr lists: c2[#10]                        |
|   |                                                        |
|   6:VEXCHANGE                                              |
|      offset: 0                                             |
|      distribute expr lists:                                |
|                                                            |
| PLAN FRAGMENT 1                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#8]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 06                                        |
|     HASH_PARTITIONED: c2[#10]                              |
|                                                            |
|   5:VAGGREGATE (update serialize)(348)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#8])[#11]                      |
|   |  group by: c2[#9]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  distribute expr lists: c1[#8]                         |
|   |                                                        |
|   4:VOlapScanNode(345)                                     |
|      TABLE: tt.t1(t1), PREAGGREGATION: ON                  |
|      partitions=1/1 (t1)                                   |
|      tablets=1/1, tabletList=491188                        |
|      cardinality=21, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
| PLAN FRAGMENT 2                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#0]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 02                                        |
|     HASH_PARTITIONED: c2[#2]                               |
|                                                            |
|   1:VAGGREGATE (update serialize)(361)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#0])[#3]                       |
|   |  group by: c2[#1]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  distribute expr lists: c1[#0]                         |
|   |                                                        |
|   0:VOlapScanNode(358)                                     |
|      TABLE: tt.t2(t2), PREAGGREGATION: ON                  |
|      partitions=1/1 (t2)                                   |
|      tablets=1/1, tabletList=491198                        |
|      cardinality=10, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
|                                                            |
| Statistics                                                 |
|  planed with unknown column statistics                     |
+------------------------------------------------------------+
105 rows in set (0.06 sec)
FAQ
Bucket Shuffle Join と Colocate Join には、データ分散と JOIN 条件に関する制約があります。以下、それぞれの具体的な制約を説明します。
Bucket Shuffle Join の制約
二つの物理テーブルを直接スキャンして Bucket Shuffle Join を行う場合は、次の条件を満たす必要があります。
- 等価 JOIN 条件: Bucket Shuffle Join は、ハッシュ計算を使ってデータの分散先を決めるため、等価 JOIN 条件がある場合にのみ適用できます。
- バケット列を含む等価条件: 等価 JOIN 条件には、両テーブルのバケット列が含まれている必要があります。左テーブルのバケット列が等価 JOIN 条件に含まれると、Bucket Shuffle Join として計画される可能性が高くなります。
- テーブル種別の制約: Bucket Shuffle Join は Doris ネイティブの OLAP テーブルにのみ適用できます。ODBC、MySQL、ES などの外部テーブルを左テーブルとして使用した場合、Bucket Shuffle Join は適用されません。
- 単一パーティションの要件: パーティションテーブルでは、パーティション間でデータ分散が異なる場合があるため、左テーブルが単一パーティションの場合にのみ Bucket Shuffle Join の動作が保証されます。そのため、SQL を実行する際は、可能な限り
WHERE条件を使用してパーティションプルーニングを有効にしてください。
Colocate Join の制約
二つの物理テーブルを直接スキャンする場合、Colocate Join には Bucket Shuffle Join より厳しい制約があります。Bucket Shuffle Join のすべての条件に加えて、次の要件も満たす必要があります。
- バケット列の整合性: データ分散を一致させるため、バケット列の型と数をそろえる必要があります。
- 同じ Colocation Group: Colocation Group を明示的に指定する必要があり、同じ Colocation Group に属するテーブル同士でのみ Colocate Join を実行できます。
- Group の状態が Stable: レプリカの修復やレプリカ間のバランス調整中は、Colocation Group が Unstable 状態になる場合があります。その場合、Colocate Join は通常の JOIN にフォールバックします。