分析関数(ウィンドウ関数)
分析関数はウィンドウ関数とも呼ばれ、結果セットの複数行にまたがる複雑な計算を行う SQL 関数です。ウィンドウ関数の特徴は、クエリが返す行数を減らさず、各行に計算結果の値を追加することです。
ウィンドウ関数は、累積合計、順位付け、移動平均、前年比や前期比の比較など、多くのデータ分析で役立ちます。詳しい構文については、ウィンドウ関数の概要を参照してください。
適用シナリオ
ウィンドウ関数は主に次のデータ分析で使用します。
| シナリオ | 典型的な問い | 推奨する関数 |
|---|---|---|
| 順位付けとグループ化 | 「地域ごとに店舗を売上順に並べるには?」 | RANK / DENSE_RANK / ROW_NUMBER / NTILE |
| 累積集計 | 「商品カテゴリごとの月次累積売上を計算するには?」 | SUM() OVER (... ROWS UNBOUNDED PRECEDING) |
| 移動平均 | 「店舗の売上について、前後三日を含む移動平均を計算するには?」 | AVG() OVER (... ROWS BETWEEN n PRECEDING AND n FOLLOWING) |
| レポート分析 | 「各年で売上が最も高い商品カテゴリを見つけるには?」 | MAX() / SUM() OVER (PARTITION BY ...) |
| 行間の比較 | 「カテゴリごとの売上の前年差を計算するには?」 | LAG / LEAD |
クイックスタート: 移動平均の例
次の一連の例では、ウィンドウ関数を使い、各店舗の売上について当日とその前後三日間の移動平均を計算します。
1. テーブルの作成とデータの投入
CREATE TABLE daily_sales (
    store_id INT,
    sales_date DATE,
    sales_amount DECIMAL(10, 2)
) PROPERTIES ("replication_num" = "1");

INSERT INTO daily_sales (store_id, sales_date, sales_amount) VALUES
(1, '2023-01-01', 100.00), (1, '2023-01-02', 150.00), (1, '2023-01-03', 200.00),
(1, '2023-01-04', 250.00), (1, '2023-01-05', 300.00), (1, '2023-01-06', 350.00),
(1, '2023-01-07', 400.00), (1, '2023-01-08', 450.00), (1, '2023-01-09', 500.00),
(2, '2023-01-01', 110.00), (2, '2023-01-02', 160.00), (2, '2023-01-03', 210.00),
(2, '2023-01-04', 260.00), (2, '2023-01-05', 310.00), (2, '2023-01-06', 360.00),
(2, '2023-01-07', 410.00), (2, '2023-01-08', 460.00), (2, '2023-01-09', 510.00);
2. クエリの作成
SELECT
    store_id,
    sales_date,
    sales_amount,
    AVG(sales_amount) OVER (
        PARTITION BY store_id
        ORDER BY sales_date
        ROWS BETWEEN 3 PRECEDING AND 3 FOLLOWING
    ) AS moving_avg_sales
FROM daily_sales;
3. クエリ結果
+----------+------------+--------------+------------------+
| store_id | sales_date | sales_amount | moving_avg_sales |
+----------+------------+--------------+------------------+
|        1 | 2023-01-01 |       100.00 |         175.0000 |
|        1 | 2023-01-02 |       150.00 |         200.0000 |
|        1 | 2023-01-03 |       200.00 |         225.0000 |
|        1 | 2023-01-04 |       250.00 |         250.0000 |
|        1 | 2023-01-05 |       300.00 |         300.0000 |
|        1 | 2023-01-06 |       350.00 |         350.0000 |
|        1 | 2023-01-07 |       400.00 |         375.0000 |
|        1 | 2023-01-08 |       450.00 |         400.0000 |
|        1 | 2023-01-09 |       500.00 |         425.0000 |
|        2 | 2023-01-01 |       110.00 |         185.0000 |
|        2 | 2023-01-02 |       160.00 |         210.0000 |
|        2 | 2023-01-03 |       210.00 |         235.0000 |
|        2 | 2023-01-04 |       260.00 |         260.0000 |
|        2 | 2023-01-05 |       310.00 |         310.0000 |
|        2 | 2023-01-06 |       360.00 |         360.0000 |
|        2 | 2023-01-07 |       410.00 |         385.0000 |
|        2 | 2023-01-08 |       460.00 |         410.0000 |
|        2 | 2023-01-09 |       510.00 |         435.0000 |
+----------+------------+--------------+------------------+
18 rows in set (0.09 sec)
基本概念
ウィンドウ関数を使う前に、処理順序、パーティション、ウィンドウ枠、現在行という基本概念を理解しておきましょう。
処理順序
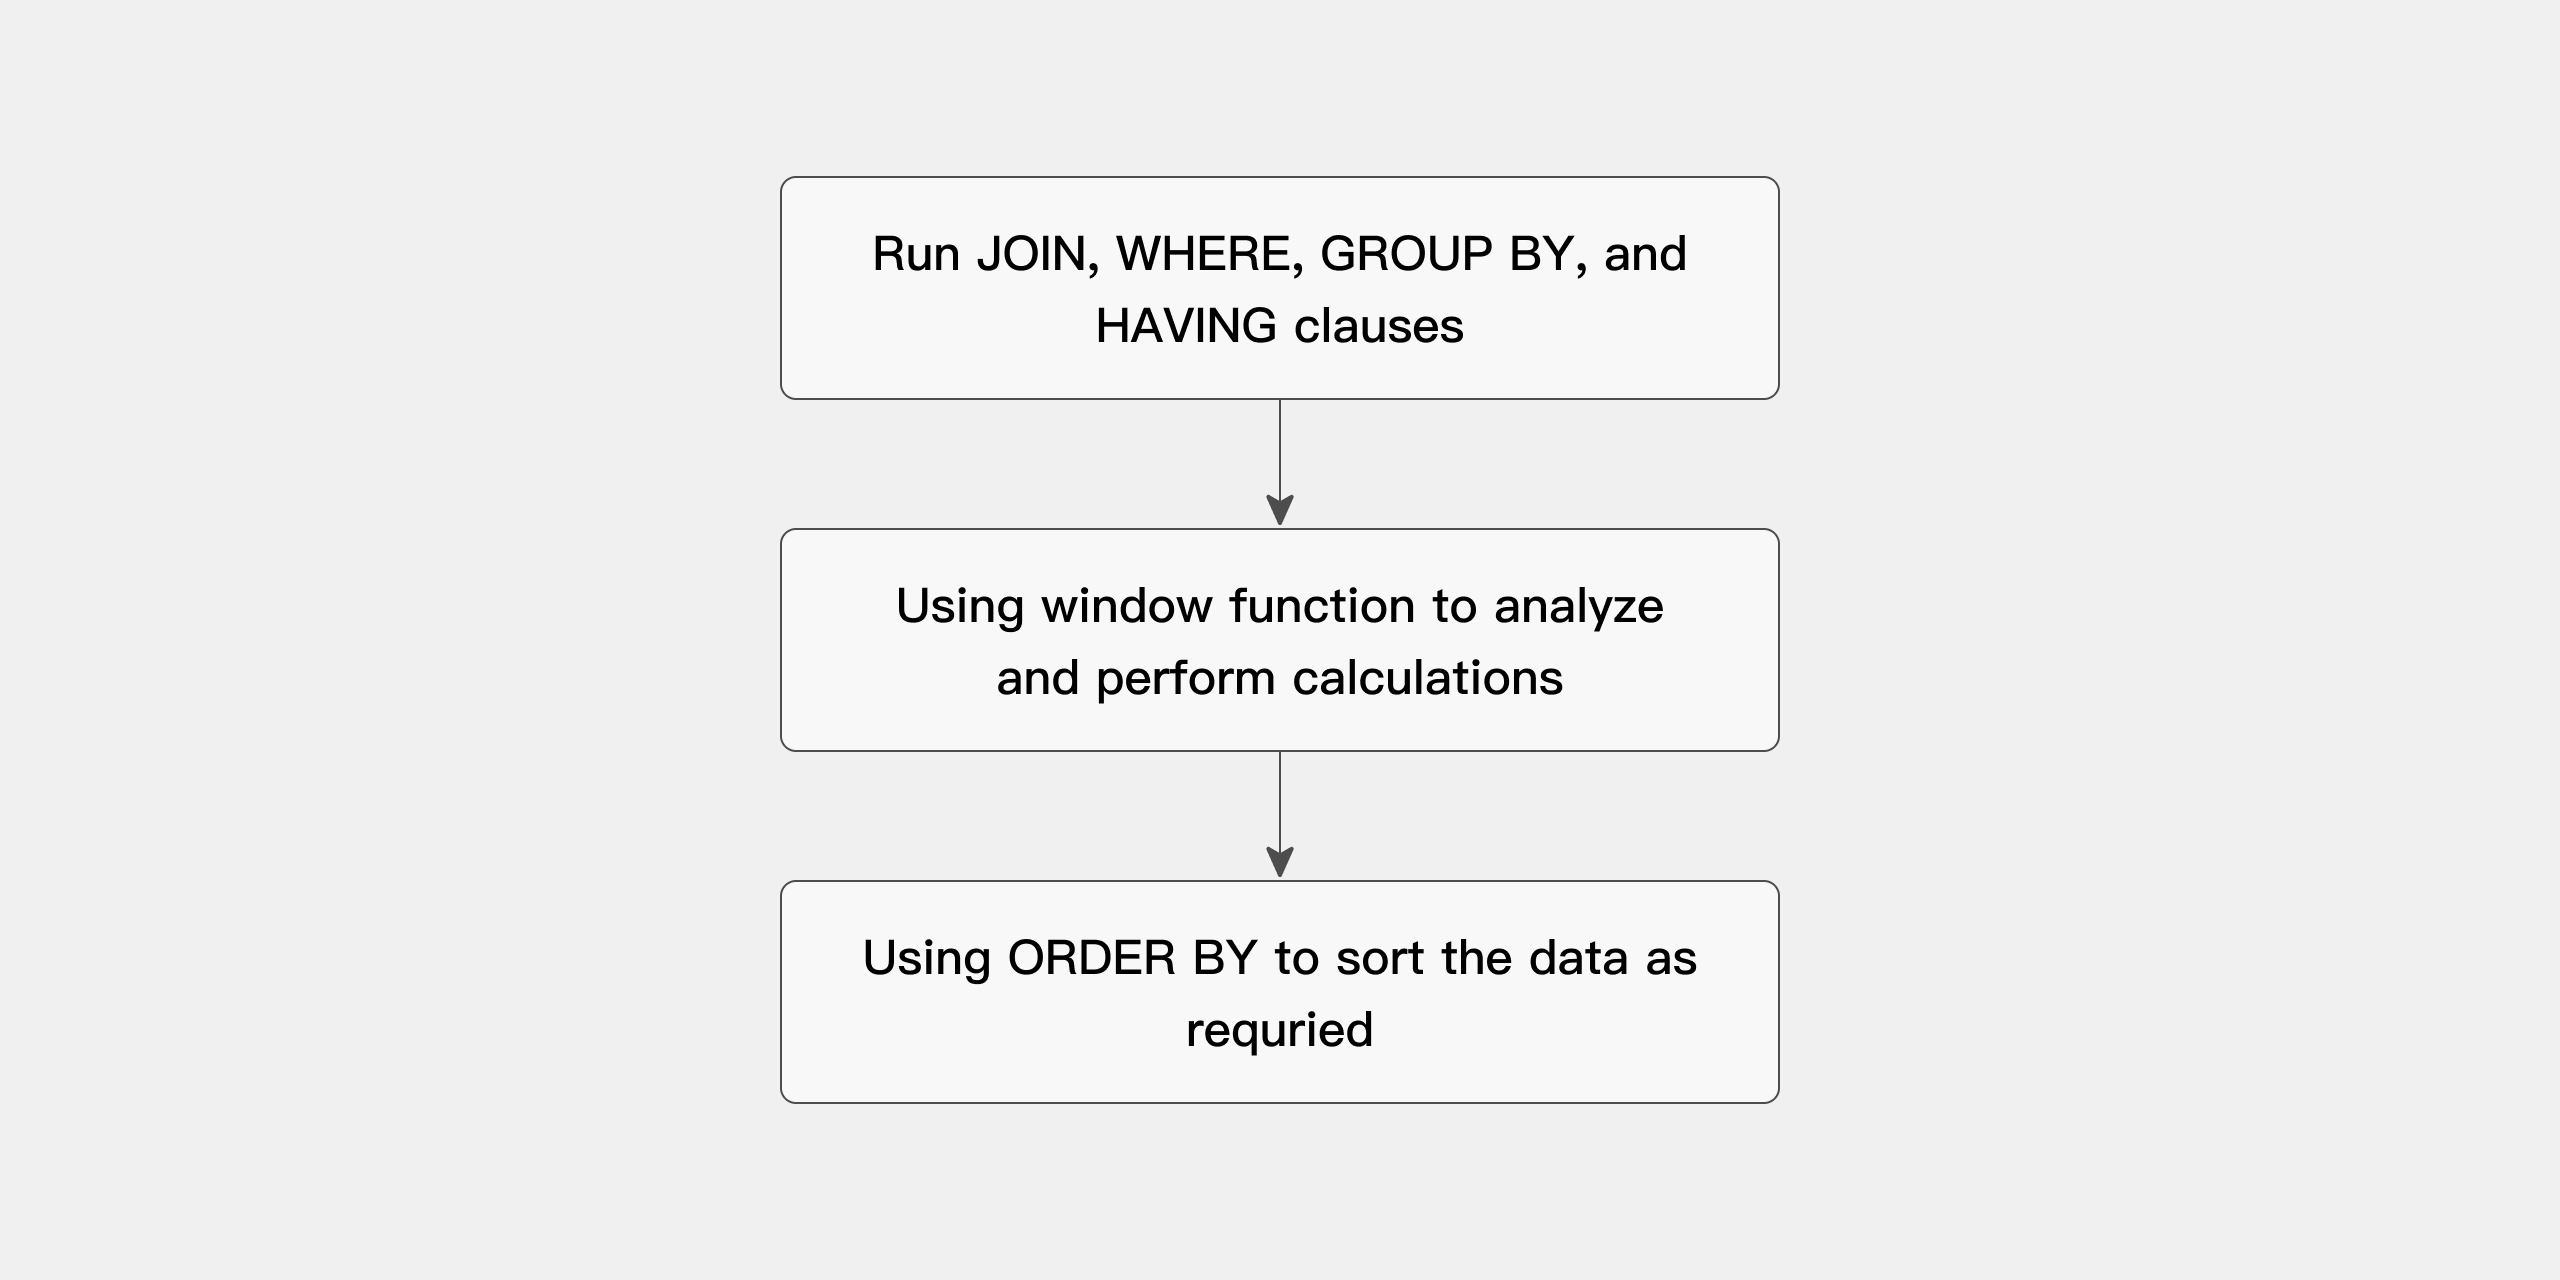
分析関数を使用するクエリは、次の三段階で処理されます。
- まず、
JOIN、WHERE、GROUP BY、HAVINGの各句を評価します。 - 得られた結果セットを分析関数に渡し、すべてのウィンドウ計算を行います。
- クエリの最後に
ORDER BY句がある場合は、最後にその句を処理して出力順序を決めます。
処理順序を次の図に示します。
結果セットのパーティション分割
パーティションは、PARTITION BY 句で定義する論理的なグループです。各パーティション内の行は、それぞれ独立して計算されます。
分析関数の「パーティション」は、テーブルのパーティショニングとは無関係です。この章での「パーティション」は、分析関数における意味だけを指します。
ウィンドウ
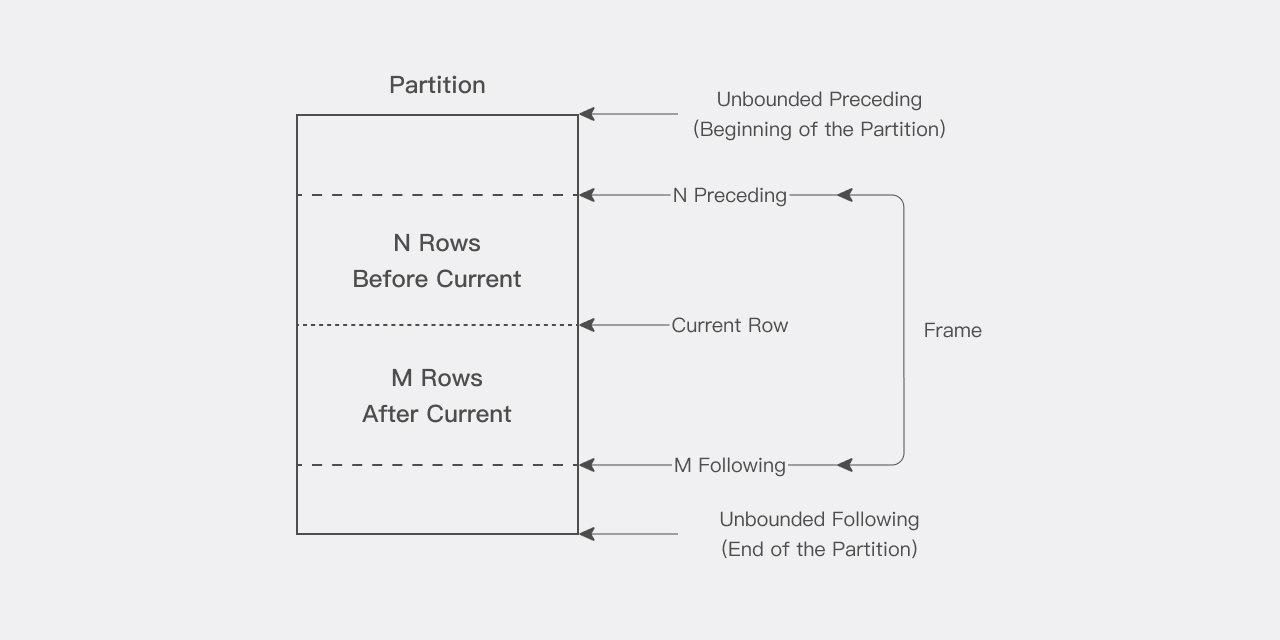
パーティション内の各行に対して、移動するデータの範囲を定義できます。このウィンドウ枠は、現在行の計算に使用する行の範囲を決めます。ウィンドウ枠には開始行と終了行があり、定義に応じて片端または両端が移動します。
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW: 累積和に使用します。開始位置はパーティションの先頭行に固定され、終了位置は先頭行から末尾行まで移動します。ROWS BETWEEN 3 PRECEDING AND 3 FOLLOWING: 移動平均に使用します。開始位置と終了位置の両方が現在行とともに移動します。
ウィンドウ枠は、パーティション全体を含む大きさにも、一行だけを含む大きさにもできます。パーティションの境界付近では、計算に含められる行数が境界によって減ることがあり、関数は利用できる行だけを使って結果を返します。
ウィンドウ関数では、現在行も計算に含まれます。そのため、n 個の要素を対象にする場合は (n-1) を指定します。たとえば 5 日間の平均を求めるには、ROWS BETWEEN 4 PRECEDING AND CURRENT ROW を指定します。ROWS 4 PRECEDING と省略することもできます。
現在行
分析関数の計算は、パーティション内の現在行を基準に行われます。現在行は、ウィンドウ枠の開始位置と終了位置を決める基準点です。
たとえば、ROWS BETWEEN 6 PRECEDING AND 6 FOLLOWING は、現在行を中心とする移動平均のウィンドウ枠を定義します。この枠には現在行、前の 6 行、後の 6 行の合計 13 行が含まれます。
順位付け関数
順位付け関数は、パーティション内の行を並べたりグループ化したりします。注意: 指定した並べ替え列の値が一意の場合にのみ、クエリ結果は確定的になります。並べ替え列に重複する値がある場合、実行ごとに結果が変わることがあります。その他の関数については、ウィンドウ関数の概要を参照してください。
NTILE 関数
NTILE は結果セットを指定した数のバケット(グループ)に分割し、各行にバケット番号を割り当てます。データ分析やレポートで、グループごとの順位付けによく使われます。
構文
NTILE(num_buckets) OVER ([PARTITION BY partition_expression] ORDER BY order_expression)
パラメータの説明:
| パラメータ | 説明 |
|---|---|
num_buckets | 行を分割するバケットの数。 |
PARTITION BY partition_expression | 省略可能。データをパーティションに分割する方法を定義します。 |
ORDER BY order_expression | 必須。データの並べ替え方法を定義します。 |
例: スコアによる学生のバケット分割
学生の試験のスコアを格納した class_student_scores テーブルがあり、スコアに基づいて学生を 4 つのグループに分け、各グループの人数をほぼ同じにしたいとします。
まず、テーブルを作成してデータを挿入します。
CREATE TABLE class_student_scores (
    class_id INT,
    student_id INT,
    student_name VARCHAR(50),
    score INT
) DISTRIBUTED BY HASH(student_id) PROPERTIES('replication_num'='1');

INSERT INTO class_student_scores VALUES
(1, 1, 'Alice', 85),
(1, 2, 'Bob', 92),
(1, 3, 'Charlie', 87),
(2, 4, 'David', 78),
(2, 5, 'Eve', 95),
(2, 6, 'Frank', 80),
(2, 7, 'Grace', 90),
(2, 8, 'Hannah', 84);
次に、NTILE 関数を使ってスコアに基づき学生をバケットに分割します。
SELECT
    student_id,
    student_name,
    score,
    NTILE(4) OVER (ORDER BY score DESC) AS bucket
FROM class_student_scores;
クエリ結果:
+------------+--------------+-------+--------+
| student_id | student_name | score | bucket |
+------------+--------------+-------+--------+
|          5 | Eve          |    95 |      1 |
|          2 | Bob          |    92 |      1 |
|          7 | Grace        |    90 |      2 |
|          3 | Charlie      |    87 |      2 |
|          1 | Alice        |    85 |      3 |
|          8 | Hannah       |    84 |      3 |
|          6 | Frank        |    80 |      4 |
|          4 | David        |    78 |      4 |
+------------+--------------+-------+--------+
8 rows in set (0.12 sec)
この例では、NTILE(4) が学生をスコアに基づいて 4 つのバケットに分け、各バケットの人数をほぼ同じにします。
- 行をバケットに均等に分配できない場合、一部のバケットの行数が一行多くなることがあります。
NTILEはパーティションごとに独立して動作します。PARTITION BYを使うと、各パーティション内のデータが個別にバケットへ分割されます。
PARTITION BY との組み合わせ
「まずクラスごとに分け、次に各クラスの学生をスコアに基づいて 3 グループに分ける」には、NTILE と PARTITION BY を組み合わせます。
SELECT
    class_id,
    student_id,
    student_name,
    score,
    NTILE(3) OVER (PARTITION BY class_id ORDER BY score DESC) AS bucket
FROM class_student_scores;
クエリ結果:
+----------+------------+--------------+-------+--------+
| class_id | student_id | student_name | score | bucket |
+----------+------------+--------------+-------+--------+
|        1 |          2 | Bob          |    92 |      1 |
|        1 |          3 | Charlie      |    87 |      2 |
|        1 |          1 | Alice        |    85 |      3 |
|        2 |          5 | Eve          |    95 |      1 |
|        2 |          7 | Grace        |    90 |      1 |
|        2 |          8 | Hannah       |    84 |      2 |
|        2 |          6 | Frank        |    80 |      2 |
|        2 |          4 | David        |    78 |      3 |
+----------+------------+--------------+-------+--------+
8 rows in set (0.05 sec)
結果から、学生がクラスごとにパーティション分割され、各クラス内でスコアに基づいて 3 つのバケットに分けられていることがわかります。各バケットの人数はほぼ同じです。
集約関数
SUM、AVG、MAX、MIN などの集約関数は、OVER 句と組み合わせるとウィンドウ関数として使用できます。GROUP BY を使わずに、各行についてパーティション内の集約値を計算します。
SUM を使った累積合計の計算
次のクエリは、2000 年の Books と Electronics の商品カテゴリについて、月ごとの売上と月次累積売上を計算します。
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    sum(sum(ss_net_paid)) OVER (
        PARTITION BY i_category
        ORDER BY year(d_date), month(d_date)
        ROWS UNBOUNDED PRECEDING
    ) AS cum_sales
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category IN ('Books', 'Electronics')
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
クエリ結果:
+-------------+--------------+---------------+-------------+-------------+
| i_category  | year(d_date) | month(d_date) | total_sales | cum_sales   |
+-------------+--------------+---------------+-------------+-------------+
| Books       |         2000 |             1 |  5348482.88 |  5348482.88 |
| Books       |         2000 |             2 |  4353162.03 |  9701644.91 |
| Books       |         2000 |             3 |  4466958.01 | 14168602.92 |
| Books       |         2000 |             4 |  4495802.19 | 18664405.11 |
| Books       |         2000 |             5 |  4589913.47 | 23254318.58 |
| Books       |         2000 |             6 |  4384384.00 | 27638702.58 |
| Books       |         2000 |             7 |  4488018.76 | 32126721.34 |
| Books       |         2000 |             8 |  9909227.94 | 42035949.28 |
| Books       |         2000 |             9 | 10366110.30 | 52402059.58 |
| Books       |         2000 |            10 | 10445320.76 | 62847380.34 |
| Books       |         2000 |            11 | 15246901.52 | 78094281.86 |
| Books       |         2000 |            12 | 15526630.11 | 93620911.97 |
| Electronics |         2000 |             1 |  5534568.17 |  5534568.17 |
| Electronics |         2000 |             2 |  4472655.10 | 10007223.27 |
| Electronics |         2000 |             3 |  4316942.60 | 14324165.87 |
| Electronics |         2000 |             4 |  4211523.06 | 18535688.93 |
| Electronics |         2000 |             5 |  4723661.00 | 23259349.93 |
| Electronics |         2000 |             6 |  4127773.06 | 27387122.99 |
| Electronics |         2000 |             7 |  4286523.05 | 31673646.04 |
| Electronics |         2000 |             8 | 10004890.96 | 41678537.00 |
| Electronics |         2000 |             9 | 10143665.77 | 51822202.77 |
| Electronics |         2000 |            10 | 10312020.35 | 62134223.12 |
| Electronics |         2000 |            11 | 14696000.54 | 76830223.66 |
| Electronics |         2000 |            12 | 15344441.52 | 92174665.18 |
+-------------+--------------+---------------+-------------+-------------+
24 rows in set (0.13 sec)
この例では、SUM 集約関数が各行のウィンドウ枠を定義します。開始位置はパーティションの先頭行(UNBOUNDED PRECEDING)に固定され、終了位置はデフォルトで現在行になります。ここでは、外側の SUM が内側の SUM の結果を集約するため、SUM がネストされています。分析用の集約関数では、集約のネストがよく使われます。
AVG を使った移動平均の計算
次のクエリは、「3 か月移動平均」(当月と前の二か月)を、2000 年の Books カテゴリの月次売上から計算します。
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    avg(sum(ss_net_paid)) OVER (
        ORDER BY year(d_date), month(d_date)
        ROWS 2 PRECEDING
    ) AS avg
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category = 'Books'
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
クエリ結果:
+------------+--------------+---------------+-------------+---------------+
| i_category | year(d_date) | month(d_date) | total_sales | avg           |
+------------+--------------+---------------+-------------+---------------+
| Books      |         2000 |             1 |  5348482.88 |  5348482.8800 |
| Books      |         2000 |             2 |  4353162.03 |  4850822.4550 |
| Books      |         2000 |             3 |  4466958.01 |  4722867.6400 |
| Books      |         2000 |             4 |  4495802.19 |  4438640.7433 |
| Books      |         2000 |             5 |  4589913.47 |  4517557.8900 |
| Books      |         2000 |             6 |  4384384.00 |  4490033.2200 |
| Books      |         2000 |             7 |  4488018.76 |  4487438.7433 |
| Books      |         2000 |             8 |  9909227.94 |  6260543.5666 |
| Books      |         2000 |             9 | 10366110.30 |  8254452.3333 |
| Books      |         2000 |            10 | 10445320.76 | 10240219.6666 |
| Books      |         2000 |            11 | 15246901.52 | 12019444.1933 |
| Books      |         2000 |            12 | 15526630.11 | 13739617.4633 |
+------------+--------------+---------------+-------------+---------------+
12 rows in set (0.13 sec)
出力の最初の二行にある avg 列は、厳密には 3 か月平均ではありません。前に十分な行がないためです(SQL では 3 行のウィンドウ枠を指定しています)。
現在行を中心とするウィンドウ集約も計算できます。次の例は、2000 年の Books カテゴリの月次売上について、「前月、当月、翌月」の売上の平均、つまり中央寄せの移動平均を計算します。
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    avg(sum(ss_net_paid)) OVER (
        ORDER BY year(d_date), month(d_date)
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS avg_sales
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category = 'Books'
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
出力の最初と最後の行では、境界の片側に十分な行がないため、中央寄せの移動平均は二か月分のデータだけで計算されます。
レポート関数
レポート関数には、「各行のウィンドウ枠がパーティション全体に及ぶ」という特性があります。主な利点は、一つのクエリ内で同じデータを複数回参照できることです。これにより明示的な JOIN を避け、クエリの性能を高められます。
たとえば、「各年で売上が最も高い商品カテゴリを見つける」という要件は、JOIN を使わずにレポート関数で実現できます。
SELECT year, category, total_sum FROM (
    SELECT
        year(d_date) AS year,
        i_category AS category,
        sum(ss_net_paid) AS total_sum,
        max(sum(ss_net_paid)) OVER (PARTITION BY year(d_date)) AS max_sales
    FROM
        store_sales,
        date_dim d1,
        item
    WHERE
        d1.d_date_sk = ss_sold_date_sk
        AND i_item_sk = ss_item_sk
        AND year(d_date) IN (1998, 1999)
    GROUP BY
        year(d_date), i_category
) t
WHERE total_sum = max_sales;
内側のクエリは MAX(SUM(ss_net_paid)) を使って、各年の商品カテゴリの最高売上を示します。結果は次のとおりです。
+------+-------------+-------------+-------------+
| year | category    | total_sum   | max_sales   |
+------+-------------+-------------+-------------+
| 1998 | Electronics | 91723676.27 | 91723676.27 |
| 1998 | Books       | 91307909.84 | 91723676.27 |
| 1999 | Electronics | 90310850.54 | 90310850.54 |
| 1999 | Books       | 88993351.11 | 90310850.54 |
+------+-------------+-------------+-------------+
4 rows in set (0.11 sec)
外側のクエリで total_sum = max_sales によって絞り込むと、各年で最も売上が高いカテゴリが得られます。
+------+-------------+-------------+
| year | category    | total_sum   |
+------+-------------+-------------+
| 1998 | Electronics | 91723676.27 |
| 1999 | Electronics | 90310850.54 |
+------+-------------+-------------+
2 rows in set (0.12 sec)
レポート用の集約は、ネストしたクエリと組み合わせて、より複雑な問題にも使用できます。たとえば、「商品カテゴリの総売上の 20% を超える売上を占めるサブカテゴリを探し、そのサブカテゴリから売上上位 5 件の商品を選ぶ」場合です。
SELECT i_category AS categ, i_class AS sub_categ, i_item_id
FROM (
    SELECT
        i_item_id, i_class, i_category,
        sum(ss_net_paid) AS sales,
        sum(sum(ss_net_paid)) OVER (PARTITION BY i_category) AS cat_sales,
        sum(sum(ss_net_paid)) OVER (PARTITION BY i_class) AS sub_cat_sales,
        rank() OVER (PARTITION BY i_class ORDER BY sum(ss_net_paid) DESC) AS rank_in_line
    FROM
        store_sales,
        item
    WHERE
        i_item_sk = ss_item_sk
    GROUP BY i_class, i_category, i_item_id
) t
WHERE sub_cat_sales > 0.2 * cat_sales AND rank_in_line <= 5;
LAG / LEAD 関数
LAG と LEAD は、「行間の比較」に使う関数です。どちらも自己結合を使わずに別の行へアクセスできるため、クエリを大幅に効率化できます。
LAG: 現在行より指定したオフセットだけ前の行にアクセスします。LEAD: 現在行より指定したオフセットだけ後の行にアクセスします。
例 1: LAG を使った売上の前年差の計算
次のクエリは、1999 年、2000 年、2001 年、2002 年の各商品カテゴリについて、総売上、前年の総売上、両者の差を取得します。
SELECT year, category, total_sales, before_year_sales, total_sales - before_year_sales FROM (
    SELECT
        sum(ss_net_paid) AS total_sales,
        year(d_date) AS year,
        i_category AS category,
        lag(sum(ss_net_paid), 1, 0) OVER (
            PARTITION BY i_category
            ORDER BY YEAR(d_date)
        ) AS before_year_sales
    FROM
        store_sales,
        date_dim d1,
        item
    WHERE
        d1.d_date_sk = ss_sold_date_sk
        AND i_item_sk = ss_item_sk
    GROUP BY
        YEAR(d_date), i_category
) t
WHERE year IN (1999, 2000, 2001, 2002);
クエリ結果:
+------+-------------+-------------+-------------------+-----------------------------------+
| year | category    | total_sales | before_year_sales | (total_sales - before_year_sales) |
+------+-------------+-------------+-------------------+-----------------------------------+
| 1999 | Books       | 88993351.11 |       91307909.84 |                       -2314558.73 |
| 2000 | Books       | 93620911.97 |       88993351.11 |                        4627560.86 |
| 2001 | Books       | 90640097.99 |       93620911.97 |                       -2980813.98 |
| 2002 | Books       | 89585515.90 |       90640097.99 |                       -1054582.09 |
| 1999 | Electronics | 90310850.54 |       91723676.27 |                       -1412825.73 |
| 2000 | Electronics | 92174665.18 |       90310850.54 |                        1863814.64 |
| 2001 | Electronics | 92598527.85 |       92174665.18 |                         423862.67 |
| 2002 | Electronics | 94303831.84 |       92598527.85 |                        1705303.99 |
+------+-------------+-------------+-------------------+-----------------------------------+
8 rows in set (0.16 sec)
例 2: ウィンドウ関数を使った 3 日間の株価平均の計算
次の株価データがあるとします。銘柄コードは JDR、closing_price は日次の終値です。
CREATE TABLE stock_ticker (
    stock_symbol STRING,
    closing_price DECIMAL(8, 2),
    closing_date DATETIME
);

INSERT INTO stock_ticker VALUES
    ("JDR", 12.86, "2014-10-02 00:00:00"),
    ("JDR", 12.89, "2014-10-03 00:00:00"),
    ("JDR", 12.94, "2014-10-04 00:00:00"),
    ("JDR", 12.55, "2014-10-05 00:00:00"),
    ("JDR", 14.03, "2014-10-06 00:00:00"),
    ("JDR", 14.75, "2014-10-07 00:00:00"),
    ("JDR", 13.98, "2014-10-08 00:00:00");

SELECT * FROM stock_ticker ORDER BY stock_symbol, closing_date;
| stock_symbol | closing_price | closing_date        |
|--------------|---------------|---------------------|
| JDR          | 12.86         | 2014-10-02 00:00:00 |
| JDR          | 12.89         | 2014-10-03 00:00:00 |
| JDR          | 12.94         | 2014-10-04 00:00:00 |
| JDR          | 12.55         | 2014-10-05 00:00:00 |
| JDR          | 14.03         | 2014-10-06 00:00:00 |
| JDR          | 14.75         | 2014-10-07 00:00:00 |
| JDR          | 13.98         | 2014-10-08 00:00:00 |
次のクエリはウィンドウ関数を使って moving_average 列を生成します。この列の値は、前日、当日、翌日の株価の平均です。初日には前日がなく、最終日には翌日がないため、この二行は二日分だけで平均を計算します。PARTITION BY は、この例では実質的なグループ分けを行いません(すべてのデータが JDR に属するためです)。ただし、複数の銘柄がある場合、PARTITION BY によって同じ銘柄内だけでウィンドウ計算が行われます。
SELECT
    stock_symbol,
    closing_date,
    closing_price,
    avg(closing_price) OVER (
        PARTITION BY stock_symbol
        ORDER BY closing_date
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS moving_average
FROM stock_ticker;
| stock_symbol | closing_date        | closing_price | moving_average |
|--------------|---------------------|---------------|----------------|
| JDR          | 2014-10-02 00:00:00 | 12.86         | 12.87          |
| JDR          | 2014-10-03 00:00:00 | 12.89         | 12.89          |
| JDR          | 2014-10-04 00:00:00 | 12.94         | 12.79          |
| JDR          | 2014-10-05 00:00:00 | 12.55         | 13.17          |
| JDR          | 2014-10-06 00:00:00 | 14.03         | 13.77          |
| JDR          | 2014-10-07 00:00:00 | 14.75         | 14.25          |
| JDR          | 2014-10-08 00:00:00 | 13.98         | 14.36          |
付録: サンプルデータの準備
この文書の集約関数、レポート関数、LAG/LEAD の例は、いずれも TPC-DS 形式のテーブル(item、store_sales、date_dim、customer_address)に基づいています。例を再現するには、次の手順でデータを準備してください。
1. サンプルテーブルの作成
CREATE DATABASE IF NOT EXISTS doc_tpcds;
USE doc_tpcds;

CREATE TABLE IF NOT EXISTS item (
    i_item_sk bigint not null,
    i_item_id char(16) not null,
    i_rec_start_date date,
    i_rec_end_date date,
    i_item_desc varchar(200),
    i_current_price decimal(7,2),
    i_wholesale_cost decimal(7,2),
    i_brand_id integer,
    i_brand char(50),
    i_class_id integer,
    i_class char(50),
    i_category_id integer,
    i_category char(50),
    i_manufact_id integer,
    i_manufact char(50),
    i_size char(20),
    i_formulation char(20),
    i_color char(20),
    i_units char(10),
    i_container char(10),
    i_manager_id integer,
    i_product_name char(50)
)
DUPLICATE KEY(i_item_sk)
DISTRIBUTED BY HASH(i_item_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS store_sales (
    ss_item_sk bigint not null,
    ss_ticket_number bigint not null,
    ss_sold_date_sk bigint,
    ss_sold_time_sk bigint,
    ss_customer_sk bigint,
    ss_cdemo_sk bigint,
    ss_hdemo_sk bigint,
    ss_addr_sk bigint,
    ss_store_sk bigint,
    ss_promo_sk bigint,
    ss_quantity integer,
    ss_wholesale_cost decimal(7,2),
    ss_list_price decimal(7,2),
    ss_sales_price decimal(7,2),
    ss_ext_discount_amt decimal(7,2),
    ss_ext_sales_price decimal(7,2),
    ss_ext_wholesale_cost decimal(7,2),
    ss_ext_list_price decimal(7,2),
    ss_ext_tax decimal(7,2),
    ss_coupon_amt decimal(7,2),
    ss_net_paid decimal(7,2),
    ss_net_paid_inc_tax decimal(7,2),
    ss_net_profit decimal(7,2)
)
DUPLICATE KEY(ss_item_sk, ss_ticket_number)
DISTRIBUTED BY HASH(ss_item_sk, ss_ticket_number) BUCKETS 32
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS date_dim (
    d_date_sk bigint not null,
    d_date_id char(16) not null,
    d_date date,
    d_month_seq integer,
    d_week_seq integer,
    d_quarter_seq integer,
    d_year integer,
    d_dow integer,
    d_moy integer,
    d_dom integer,
    d_qoy integer,
    d_fy_year integer,
    d_fy_quarter_seq integer,
    d_fy_week_seq integer,
    d_day_name char(9),
    d_quarter_name char(6),
    d_holiday char(1),
    d_weekend char(1),
    d_following_holiday char(1),
    d_first_dom integer,
    d_last_dom integer,
    d_same_day_ly integer,
    d_same_day_lq integer,
    d_current_day char(1),
    d_current_week char(1),
    d_current_month char(1),
    d_current_quarter char(1),
    d_current_year char(1)
)
DUPLICATE KEY(d_date_sk)
DISTRIBUTED BY HASH(d_date_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS customer_address (
    ca_address_sk bigint not null,
    ca_address_id char(16) not null,
    ca_street_number char(10),
    ca_street_name varchar(60),
    ca_street_type char(15),
    ca_suite_number char(10),
    ca_city varchar(60),
    ca_county varchar(30),
    ca_state char(2),
    ca_zip char(10),
    ca_country varchar(20),
    ca_gmt_offset decimal(5,2),
    ca_location_type char(20)
)
DUPLICATE KEY(ca_address_sk)
DISTRIBUTED BY HASH(ca_address_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);
2. Stream Load によるデータのダウンロードと読み込み
ターミナルで次のコマンドを実行し、データをローカルにダウンロードして Stream Load で読み込みます。
curl -L https://cdn.selectdb.com/static/doc_ddl_dir_d27a752a7b.tar -o - | tar -Jxf -

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: i_item_sk, i_item_id, i_rec_start_date, i_rec_end_date, i_item_desc, i_current_price, i_wholesale_cost, i_brand_id, i_brand, i_class_id, i_class, i_category_id, i_category, i_manufact_id, i_manufact, i_size, i_formulation, i_color, i_units, i_container, i_manager_id, i_product_name" \
    -T "doc_ddl_dir/item_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/item/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: d_date_sk, d_date_id, d_date, d_month_seq, d_week_seq, d_quarter_seq, d_year, d_dow, d_moy, d_dom, d_qoy, d_fy_year, d_fy_quarter_seq, d_fy_week_seq, d_day_name, d_quarter_name, d_holiday, d_weekend, d_following_holiday, d_first_dom, d_last_dom, d_same_day_ly, d_same_day_lq, d_current_day, d_current_week, d_current_month, d_current_quarter, d_current_year" \
    -T "doc_ddl_dir/date_dim_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/date_dim/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: ss_sold_date_sk, ss_sold_time_sk, ss_item_sk, ss_customer_sk, ss_cdemo_sk, ss_hdemo_sk, ss_addr_sk, ss_store_sk, ss_promo_sk, ss_ticket_number, ss_quantity, ss_wholesale_cost, ss_list_price, ss_sales_price, ss_ext_discount_amt, ss_ext_sales_price, ss_ext_wholesale_cost, ss_ext_list_price, ss_ext_tax, ss_coupon_amt, ss_net_paid, ss_net_paid_inc_tax, ss_net_profit" \
    -T "doc_ddl_dir/store_sales.csv" \
    http://127.0.0.1:8030/api/doc_tpcds/store_sales/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: ca_address_sk, ca_address_id, ca_street_number, ca_street_name, ca_street_type, ca_suite_number, ca_city, ca_county, ca_state, ca_zip, ca_country, ca_gmt_offset, ca_location_type" \
    -T "doc_ddl_dir/customer_address_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/customer_address/_stream_load
データファイル item_1_10.dat、date_dim_1_10.dat、store_sales.csv、customer_address_1_10.dat は、このアーカイブからもダウンロードできます。