NGram BloomFilter インデックス
NGram BloomFilter インデックスは、文字列カラムに対する LIKE '%pattern%' あいまいクエリの高速化に特化した Skip Index です。BloomFilter インデックスを基盤とし、N-Gram による分割を導入しています。テキストを隣接する文字からなる複数の語群に分割してから BloomFilter に書き込むことで、あいまい一致を高速に絞り込めます。
主な利点: 適した条件では、インデックスを使用しないフルスキャンと比較して、クエリを数倍から十数倍高速化できます(使用例にある約 8 倍の高速化事例を参照してください)。
インデックスの仕組み
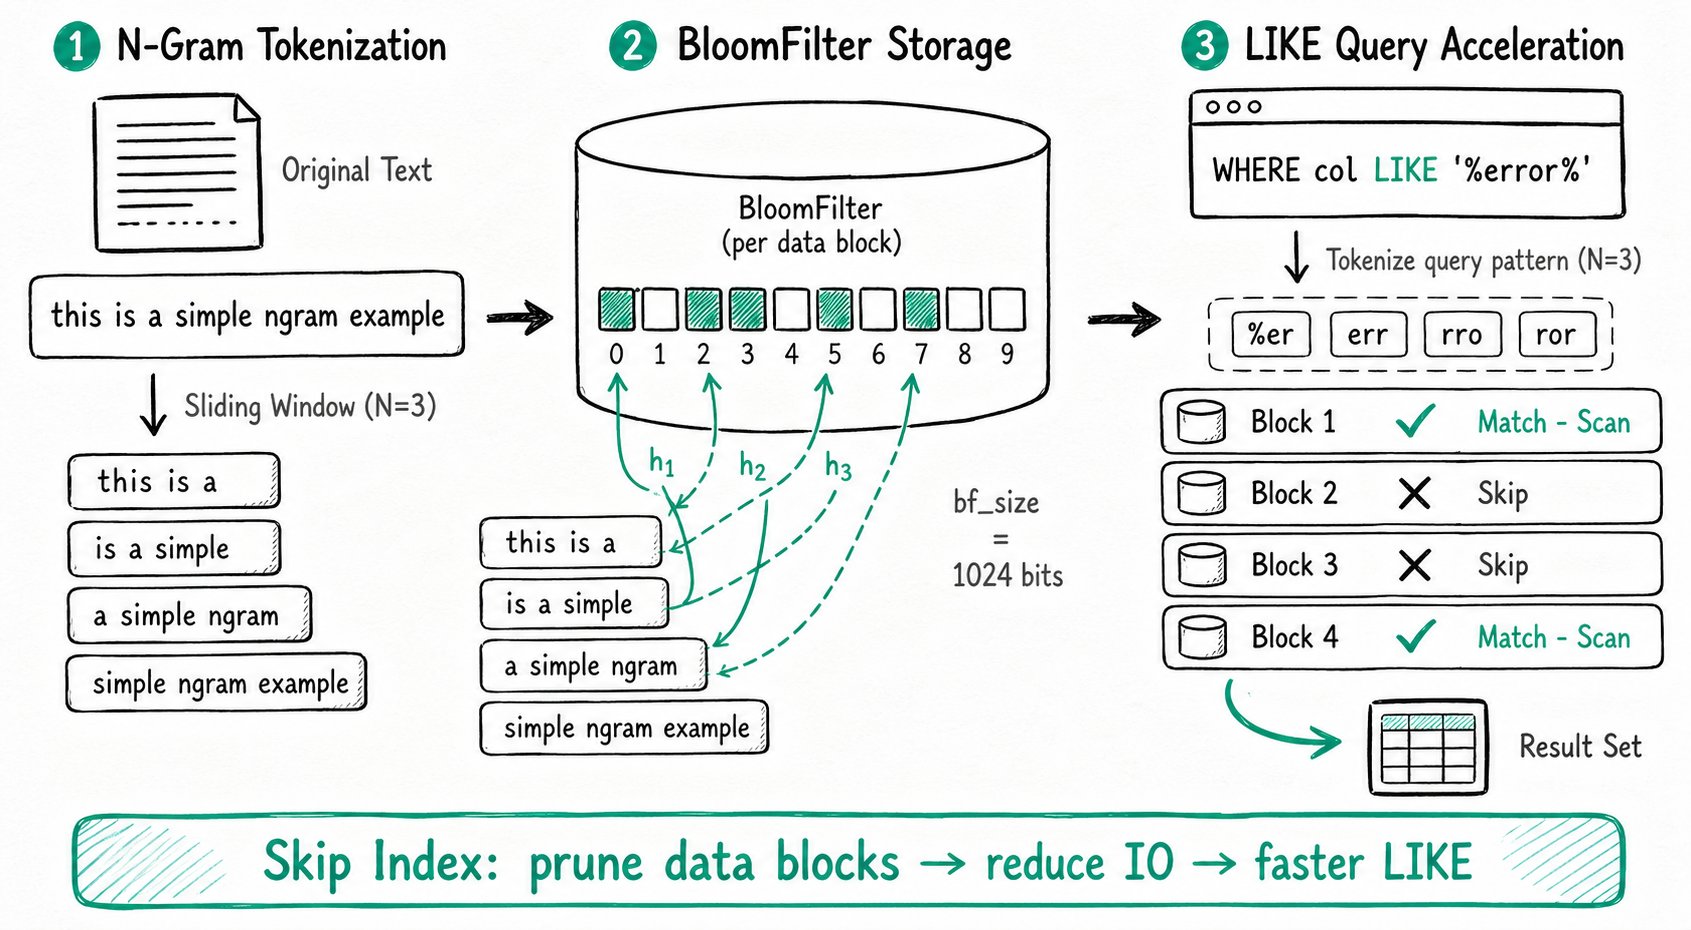
N-Gram による分割では、文やテキストを隣接する文字からなる複数の語群に分けます。たとえば、文字列 'This is a simple ngram example' を N = 3 で分割すると、次の 4 つの語群になります。
'This is a''is a simple''a simple ngram''simple ngram example'
NGram BloomFilter インデックスと通常の BloomFilter インデックスの主な違いは次のとおりです。
| 比較項目 | BloomFilter インデックス | NGram BloomFilter インデックス |
|---|---|---|
| 書き込む内容 | 元のカラム値 | 元のテキストを N-Gram で分割して得た各語群 |
| 高速化できるクエリの種類 | 等価クエリ(=、IN) | LIKE '%pattern%' あいまいクエリ |
| 対応するカラムの型 | 複数のデータ型 | 文字列カラムのみ |
クエリを高速化する流れ:
LIKE '%pattern%'内のpatternを N-Gram で分割します。- 分割して得た各語群が BloomFilter に存在するか、順に確認します。
- 語群が BloomFilter に存在しなければ、対応するデータブロックは LIKE 条件を満たさないため、スキップできます。
- 一致しないデータブロックをスキップすることで IO を削減し、クエリを高速化します。
ユースケース
NGram BloomFilter インデックスは、次の条件に適しています。
- 文字列カラムに対する
LIKE '%pattern%'あいまいクエリを高速化する場合。 LIKEパターン内の連続する文字数が、インデックスに設定したgram_size以上の場合。
- 対応するのは文字列カラムのみで、高速化できるのは
LIKEクエリのみです。 - NGram BloomFilter インデックスと通常の BloomFilter インデックスは併用できません。同じカラムには、いずれか一方のみを選択できます。
- インデックスの効果を分析する方法は、BloomFilter インデックスの場合と同じです。
インデックスの管理
インデックスの作成
テーブル作成時に作成する
テーブル作成文の COLUMN 定義の後に、インデックス定義を追加します。
INDEX `idx_column_name` (`column_name`) USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index'
構文の説明
| パラメータ | 必須かどうか | 説明 |
|---|---|---|
idx_column_name (column_name) | 必須 | column_name はインデックスを作成するカラムの名前で、事前に定義されている必要があります。idx_column_name はインデックス名で、テーブル内で一意である必要があります |
USING NGRAM_BF | 必須 | インデックスの種類として NGram BloomFilter インデックスを指定します |
PROPERTIES | 任意 | NGram BloomFilter インデックスの追加プロパティを指定します。詳細は以下の表を参照してください |
COMMENT | 任意 | インデックスのコメントを指定します |
インデックス名には、idx_review_body のように idx_ を付けることを推奨します。
PROPERTIES のパラメータ
| プロパティ | 説明 |
|---|---|
gram_size | N-Gram の N です。連続する N 文字ごとに語群を作ることを指定します。たとえば、'This is a simple ngram example' は N = 3 の場合、4 つの語群に分割されます。LIKE クエリで検索する文字列の最小長に合わせて設定することを推奨しますが、2 未満にはしないでください。 |
bf_size | BloomFilter のサイズをビット単位で指定します。各データブロックのインデックスサイズを決定します。値を大きくするとストレージの使用量は増えますが、ハッシュ衝突の確率は下がります。 |
推奨設定: 通常は "gram_size"="3" と "bf_size"="1024" から始め、Query Profile に基づいて調整することを推奨します。
インデックスの確認
-- Method 1: In the INDEX section of the table schema, USING NGRAM_BF marks an NGram BloomFilter index
SHOW CREATE TABLE table_name;

-- Method 2: An IndexType of NGRAM_BF marks an NGram BloomFilter index
SHOW INDEX FROM table_name;
インデックスの削除
ALTER TABLE table_ngrambf DROP INDEX idx_ngrambf;
インデックスの変更
既存のテーブルには、次のいずれかの方法で NGram BloomFilter インデックスを追加できます。
-- Method 1: Use CREATE INDEX
CREATE INDEX idx_column_name2(column_name2) ON table_ngrambf
USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index';

-- Method 2: Use ALTER TABLE ADD INDEX
ALTER TABLE table_ngrambf
ADD INDEX idx_column_name2(column_name2) USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index';
インデックスの使用
関数プッシュダウンの有効化
NGram BloomFilter インデックスを使用する前に、関数プッシュダウンを有効にします(enable_function_pushdown のデフォルト値は false です)。
SET enable_function_pushdown = true;
インデックスによる高速化の適用
NGram BloomFilter インデックスは、次のような LIKE クエリの高速化に自動的に使用されます。
SELECT count() FROM table1 WHERE message LIKE '%error%';
インデックスの効果の分析
BloomFilter インデックス(NGram BloomFilter を含む)による高速化の効果は、Query Profile の次の指標で分析できます。
| 指標 | 意味 |
|---|---|
RowsBloomFilterFiltered | BloomFilter インデックスによって除外された行数です。他の Rows 指標と比較して、絞り込みの効果を分析できます |
BlockConditionsFilteredBloomFilterTime | BloomFilter インデックスにかかった時間です |
使用例
ここでは、Amazon の商品ユーザーレビューデータセット amazon_reviews を例に、NGram BloomFilter インデックスの使い方と高速化の効果を示します。
ステップ 1:テーブルの作成
CREATE TABLE `amazon_reviews` (
    `review_date` int(11) NULL,
    `marketplace` varchar(20) NULL,
    `customer_id` bigint(20) NULL,
    `review_id` varchar(40) NULL,
    `product_id` varchar(10) NULL,
    `product_parent` bigint(20) NULL,
    `product_title` varchar(500) NULL,
    `product_category` varchar(50) NULL,
    `star_rating` smallint(6) NULL,
    `helpful_votes` int(11) NULL,
    `total_votes` int(11) NULL,
    `vine` boolean NULL,
    `verified_purchase` boolean NULL,
    `review_headline` varchar(500) NULL,
    `review_body` string NULL
) ENGINE=OLAP
DUPLICATE KEY(`review_date`)
COMMENT 'OLAP'
DISTRIBUTED BY HASH(`review_date`) BUCKETS 16
PROPERTIES (
    "replication_allocation" = "tag.location.default: 1",
    "compression" = "ZSTD"
);
ステップ 2:データロード
1. データセットをダウンロードする
wget などのツールを使い、次の URL からデータセットをダウンロードします。
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2010.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2011.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2012.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2013.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2014.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet
2. Stream Load でデータをロードする
curl --location-trusted -u root: -T amazon_reviews_2010.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2011.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2012.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2013.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2014.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2015.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
上記のファイルは 10 GB を超える場合があります。Stream Load のファイルアップロードサイズの上限を超えないよう、be.conf の streaming_load_max_mb を調整してください。次のコマンドで設定を動的に変更できます(各 BE で実行してください)。
curl -X POST http://{be_ip}:{be_http_port}/api/update_config?streaming_load_max_mb=32768
3. データロードを確認する
SQL で count() を実行し、データが正常にロードされたことを確認します。
mysql> SELECT COUNT() FROM amazon_reviews;
+-----------+
| count(*)  |
+-----------+
| 135589433 |
+-----------+
ステップ 3:性能比較
シナリオ 1:インデックスなしのクエリ(所要時間 7.60s)
SELECT
    product_id,
    any_value(product_title),
    AVG(star_rating) AS rating,
    COUNT() AS count
FROM
    amazon_reviews
WHERE
    review_body LIKE '%is super awesome%'
GROUP BY
    product_id
ORDER BY
    count DESC,
    rating DESC,
    product_id
LIMIT 5;
クエリ結果:
+------------+------------------------------------------+--------------------+-------+
| product_id | any_value(product_title)                 | rating             | count |
+------------+------------------------------------------+--------------------+-------+
| B00992CF6W | Minecraft                                | 4.8235294117647056 |    17 |
| B009UX2YAC | Subway Surfers                           | 4.7777777777777777 |     9 |
| B00DJFIMW6 | Minion Rush: Despicable Me Official Game |              4.875 |     8 |
| B0086700CM | Temple Run                               |                  5 |     6 |
| B00KWVZ750 | Angry Birds Epic RPG                     |                  5 |     6 |
+------------+------------------------------------------+--------------------+-------+
5 rows in set (7.60 sec)
シナリオ 2:NGram BloomFilter インデックス追加後(所要時間 0.93s)
インデックスを追加します。
ALTER TABLE amazon_reviews
ADD INDEX review_body_ngram_idx(review_body) USING NGRAM_BF
PROPERTIES("gram_size"="10", "bf_size"="10240");
同じクエリを再度実行します。
+------------+------------------------------------------+--------------------+-------+
| product_id | any_value(product_title)                 | rating             | count |
+------------+------------------------------------------+--------------------+-------+
| B00992CF6W | Minecraft                                | 4.8235294117647056 |    17 |
| B009UX2YAC | Subway Surfers                           | 4.7777777777777777 |     9 |
| B00DJFIMW6 | Minion Rush: Despicable Me Official Game |              4.875 |     8 |
| B0086700CM | Temple Run                               |                  5 |     6 |
| B00KWVZ750 | Angry Birds Epic RPG                     |                  5 |     6 |
+------------+------------------------------------------+--------------------+-------+
5 rows in set (0.93 sec)
性能比較:
| シナリオ | 時間 | 性能向上 |
|---|---|---|
| インデックスなし | 7.60 s | 基準 |
| NGram BloomFilter インデックスあり | 0.93 s | 約 8 倍 |
エスケープを含む LIKE パターンに対するインデックスの制限
4.1.5 以降、カスタム ESCAPE を指定した LIKE クエリや、パターンにバックスラッシュを含む LIKE クエリでは、誤った絞り込みを避けるため、NGRAM Bloom Filter をデータブロックのスキップに使用しません。これらのクエリは、通常のスキャンで引き続き実行できます。エスケープを含まない LIKE パターンは、既存の条件を満たしていれば引き続きインデックスを使用できます。