性能テストを支える最適化
概要
Apache Doris は、2.x の転置インデックスによるテキスト検索から、3.x のストレージとコンピューティングの分離を経て、4.x でベクトルインデックス機能を備えるようになり、本格的に AI データ分析の時代に入りました。この記事は、次の読者を対象としています。
- Doris 4.x のベクトルインデックスが業界トップクラスの性能を実現する理由を知りたいアーキテクトや開発者。
- Doris とベクトル専用データベースの性能差がどこから生じるかを理解したい、ベクトルデータベースを評価中の技術意思決定者。
- Doris の ANN 検索をチューニングする運用担当者やパフォーマンスエンジニア。
この記事は、ベクトル検索の二つの主要なフェーズに沿って構成されています。
| フェーズ | 主な目標 | 主な最適化 |
|---|---|---|
| インデックス作成フェーズ | 品質を犠牲にせずインデックス構築を高速化する | 多段階シャーディング、二段階の並列化、SIMD による距離計算 |
| クエリフェーズ | 高い同時実行数でも P99 レイテンシーを抑える | Prepare Statement、Index Only Scan、仮想列、Scan の並列化、グローバル TopN の遅延実体化 |
インデックス作成フェーズ
インデックス作成フェーズの性能は、インデックスのハイパーパラメータと強く相関します。品質を高めるほど構築は遅くなります。Doris はデータ取り込み経路を最適化し、高いインデックス品質を維持しながら取り込みスループットを大幅に向上させています。
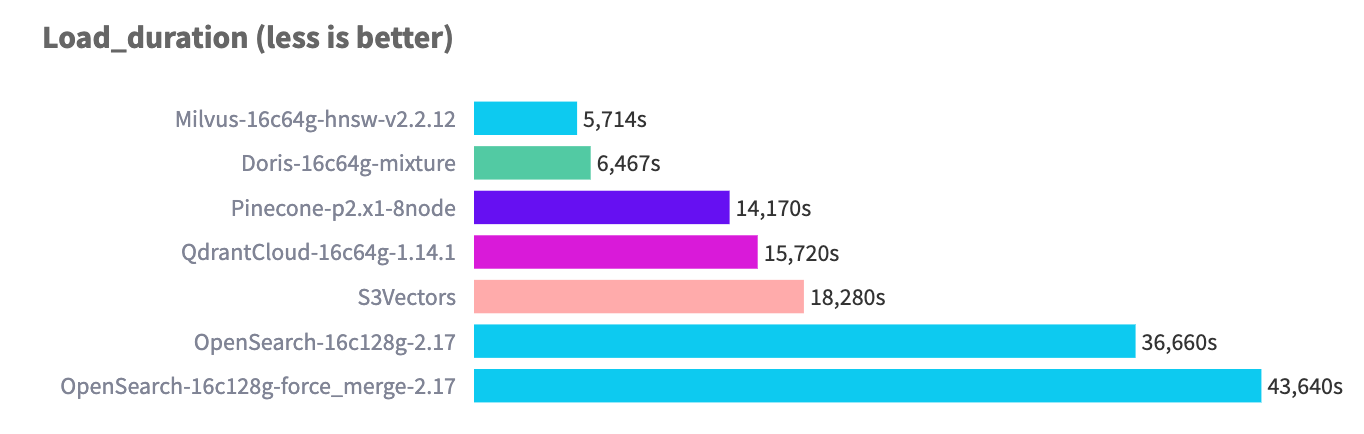
768 次元、10M 行の規模では、Doris の取り込み性能は業界トップクラスに達しています。
多段階シャーディング
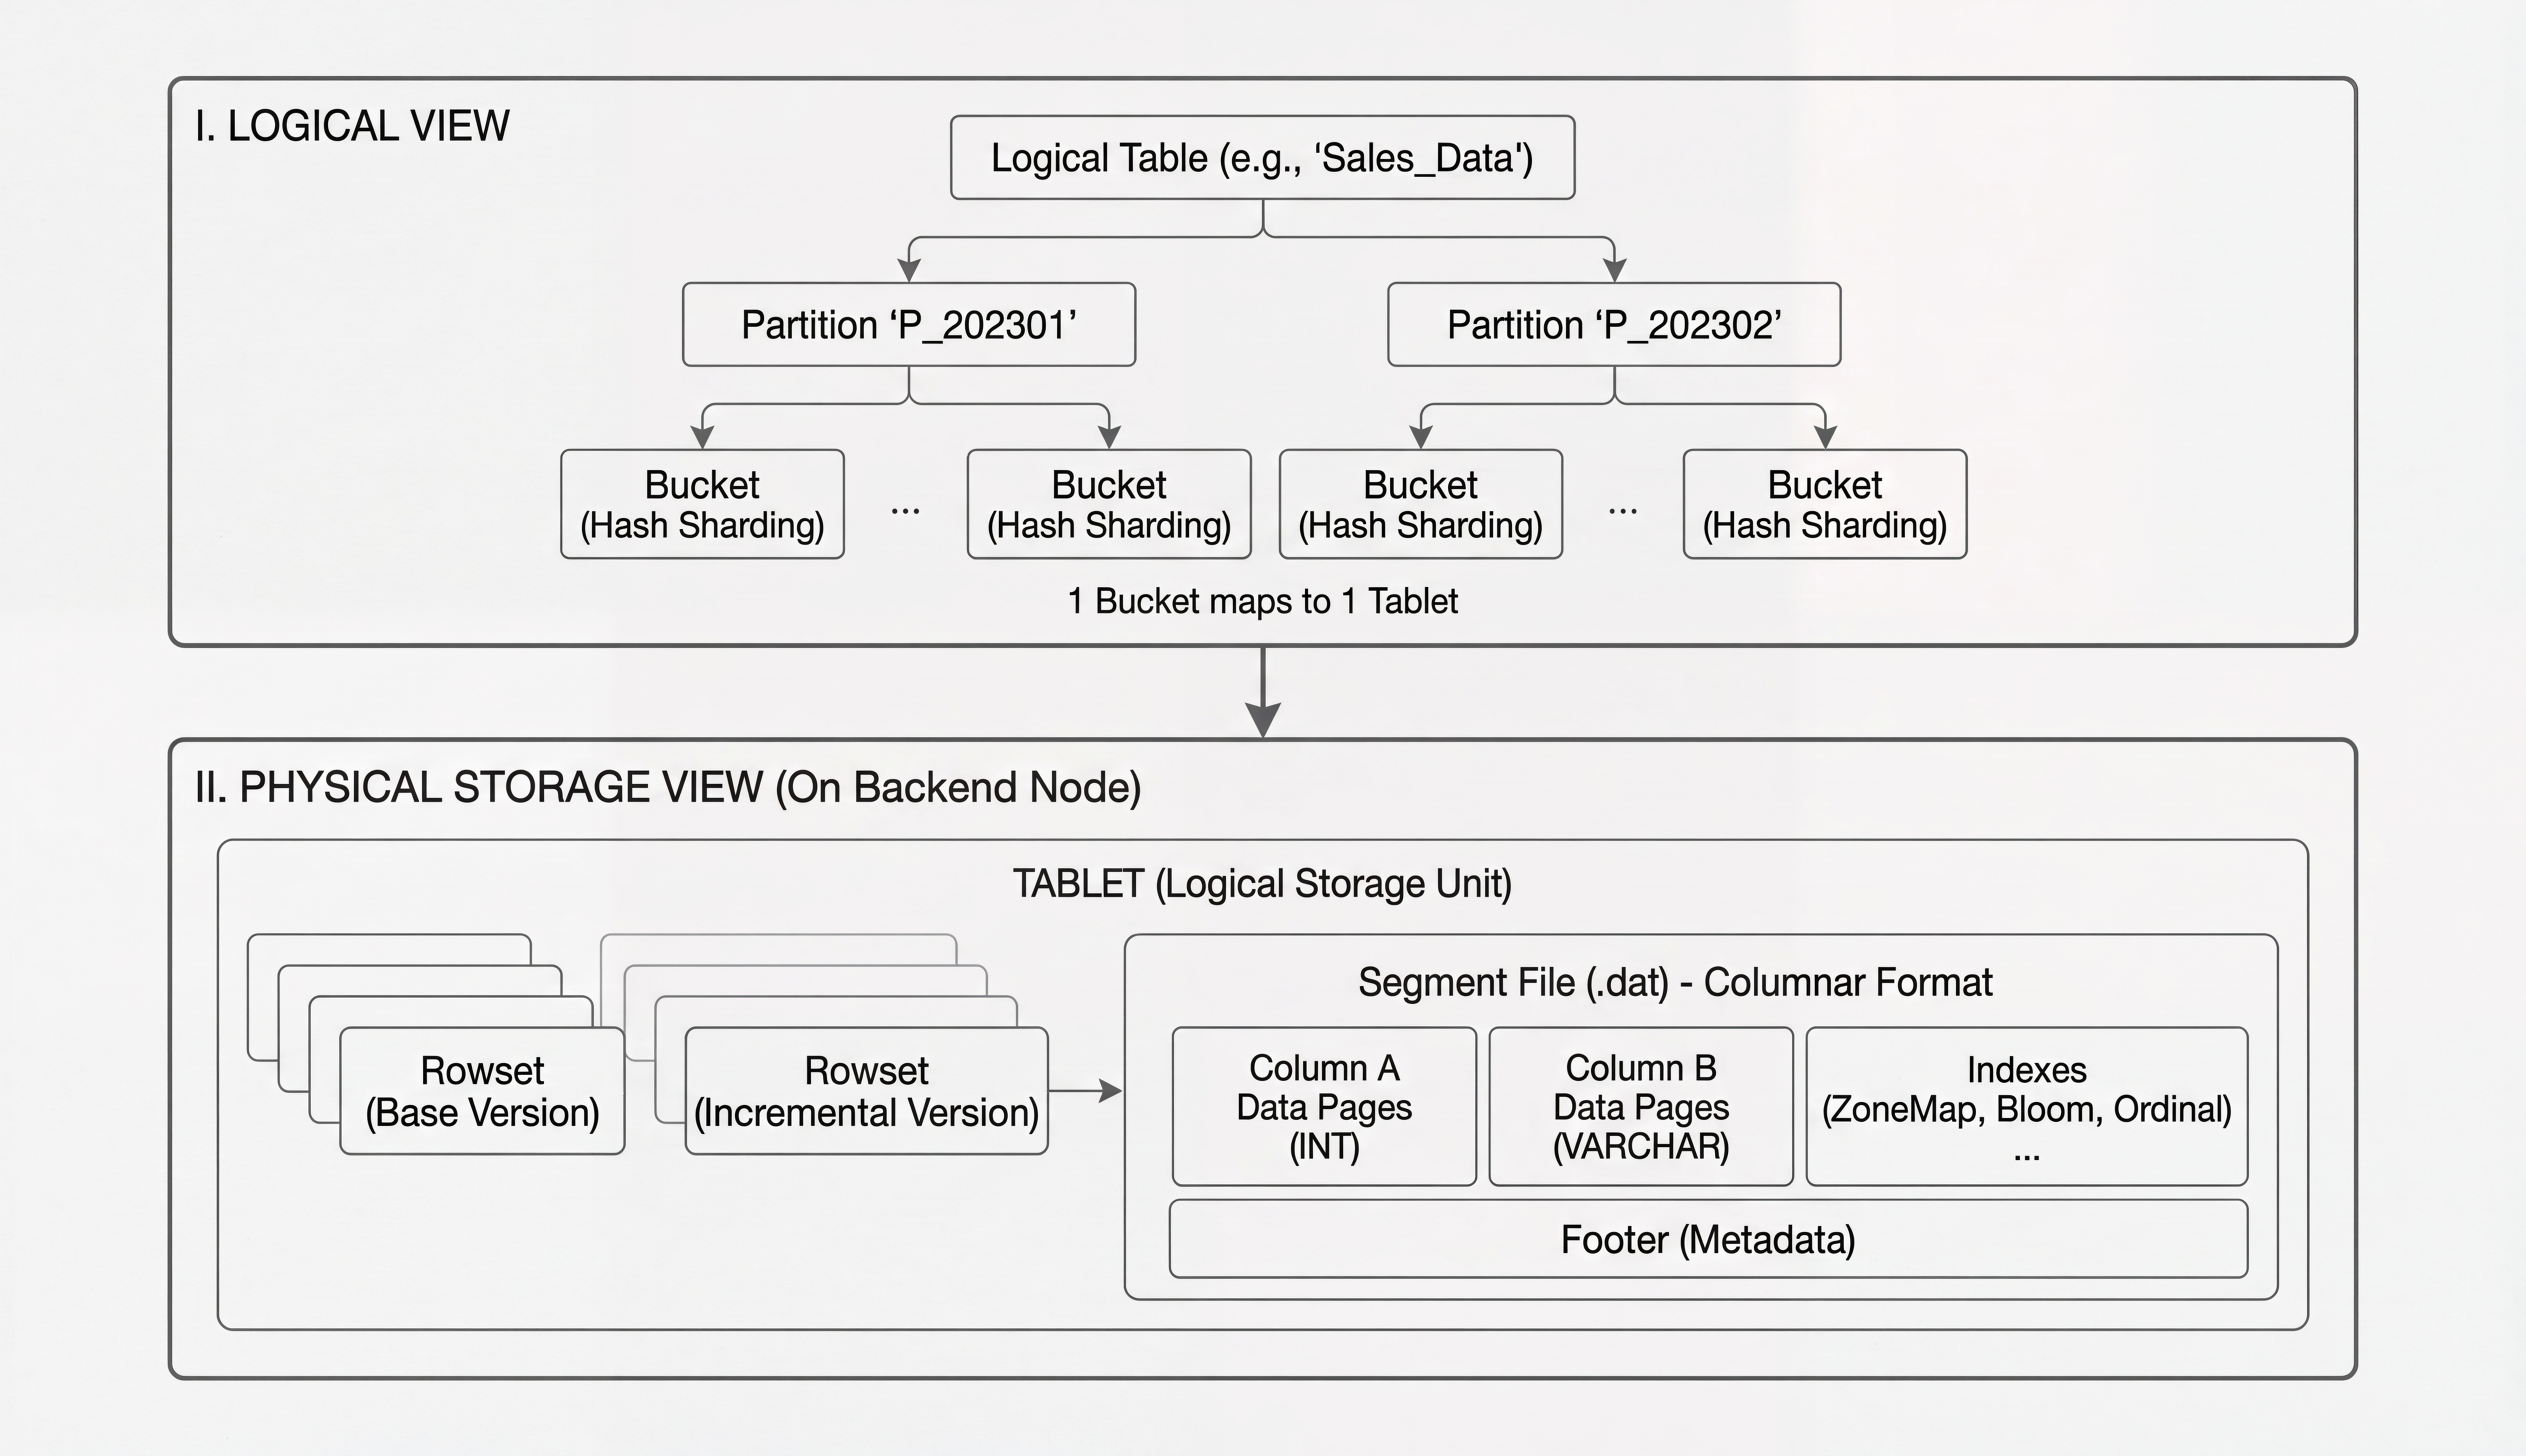
Doris の内部テーブルは、もともと分散型です。ユーザーがクエリやデータ取り込み時に意識するのは単一の論理テーブル(Table)だけです。一方、Doris のカーネルはテーブル定義に従って物理シャードを自動的に作成し、パーティションキーとバケットキーに基づいて、対応する BE 上のタブレットへデータを振り分けます。
各階層の関係は次のとおりです。
| 階層 | 役割 |
|---|---|
| Table | ユーザーが認識する論理テーブル |
| Tablet | 必要な数量を満たす物理シャード |
| Rowset | タブレット上で取り込みトランザクションごとに生成されるバージョン管理単位 |
| Segment | Rowset 配下で実際にデータを保持するファイル。ANN インデックスは Segment 単位で動作します |
ベクトルインデックス(HNSW など)は、いくつかの重要なハイパーパラメータに依存します。これらのパラメータはインデックス品質とクエリ性能を直接左右し、通常は特定のデータ規模でのみ理想的な結果が得られます。
Doris の多段階シャーディングは「インデックスパラメータ」と「テーブル全体のデータ規模」を切り離します。データ総量が増えても、ユーザーはインデックスを再構築する必要がありません。各取り込みバッチのサイズと、それに対応するパラメータ設定に注目するだけで済みます。
測定結果に基づく、バッチサイズ別の HNSW インデックスの経験的なパラメータは次のとおりです。
| batch_size | max_degree | ef_construction | ef_search | recall@100 |
|---|---|---|---|---|
| 250000 | 100 | 200 | 50 | 89% |
| 250000 | 100 | 200 | 100 | 93% |
| 250000 | 100 | 200 | 150 | 95% |
| 250000 | 100 | 200 | 200 | 98% |
| 500000 | 120 | 240 | 50 | 91% |
| 500000 | 120 | 240 | 100 | 94% |
| 500000 | 120 | 240 | 150 | 96% |
| 500000 | 120 | 240 | 200 | 99% |
| 1000000 | 150 | 300 | 50 | 90% |
| 1000000 | 150 | 300 | 100 | 93% |
| 1000000 | 150 | 300 | 150 | 96% |
| 1000000 | 150 | 300 | 200 | 98% |
つまり、ユーザーは「取り込みバッチごとのデータ量」に注目し、それに応じて適切なインデックスパラメータを選ぶだけで、インデックス品質を確保しながら安定したクエリ性能を得られます。
高性能なインデックス構築
高品質なインデックスの並列構築
Doris は「二段階の並列化」でインデックス構築を高速化します。
- クラスターレベルの並列化:複数の BE ノードで並列に構築します。
- ノード内の並列化:各 BE 内で、同じバッチからグループ化したデータに対してマルチスレッドで距離を計算し、インデックスのデータ構造の構築を高速化します。
Doris は高速化と同時に、メモリ内でのバッチ化によってインデックス品質を高めています。ベクトルの総数が一定でも、バッチが小さすぎてインデックスへの追記回数が多すぎると、グラフ構造が疎になりやすく、再現率が低下します。
たとえば、768D / 10M のベクトルデータでは、次のようになります。
- 10 バッチでインデックスを構築すると、再現率は約 99% になります。
- 100 バッチで構築すると、再現率は約 95% まで低下する可能性があります。
メモリ内でのバッチ化により、Doris は同じハイパーパラメータの下でメモリ使用量とグラフ品質のバランスを取り、バッチの細分化による品質低下を防げます。
SIMD による距離計算
ANN インデックス構築の主なコストは、大量の距離計算にあります。これは典型的な CPU 集約型タスクです。Doris はこの計算を BE ノードに集約します。関連する実装は C++ で記述され、Faiss の自動および手動のベクトル化最適化を最大限に活用します。
L2 距離を例に取ると、Faiss はコンパイラ指示用のマクロで自動ベクトル化を促します。
FAISS_PRAGMA_IMPRECISE_FUNCTION_BEGIN
float fvec_L2sqr(const float* x, const float* y, size_t d) {
    size_t i;
    float res = 0;
    FAISS_PRAGMA_IMPRECISE_LOOP
    for (i = 0; i < d; i++) {
        const float tmp = x[i] - y[i];
        res += tmp * tmp;
    }
    return res;
}
FAISS_PRAGMA_IMPRECISE_FUNCTION_END
FAISS_PRAGMA_IMPRECISE_* マクロは、コンパイラに自動ベクトル化を指示します。
#define FAISS_PRAGMA_IMPRECISE_LOOP \
    _Pragma("clang loop vectorize(enable) interleave(enable)")
同時に、Faiss は _mm* / _mm256* / _mm512* 命令を #ifdef SSE3/AVX2/AVX512F の条件付きブロック内で使い、明示的にベクトル化します。さらに、L2 と内積の要素ごとの演算をそれぞれ実装するテンプレート ElementOpL2 / ElementOpIP と、次元ごとの特殊化 fvec_op_ny_D{1,2,4,8,12} を組み合わせることで、次を実現します。
- 複数サンプルのバッチ処理:8 件や 16 件などのサンプルを、レジスタ内の行列転置(
transpose_8x2/16x4/...など)とともに処理し、アクセスの局所性を高めます。 - FMA 命令:
_mm512_fmadd_psなどで積和演算を一つにまとめ、命令数を減らします。 - 水平加算:スカラー値の結果をすばやく生成します。
- マスク付き分岐:4、8、16 の境界に揃わない末尾の要素を処理します。
これらの最適化によって、距離計算の命令とメモリアクセスのオーバーヘッドが効果的に抑えられ、インデックス構築のスループットが大幅に向上します。
クエリフェーズ
検索用途ではレイテンシーが極めて重要です。数千万行のデータに対して多数のクエリを同時に実行する場合、通常は P99 レイテンシーを 500 ms 未満に保つ必要があります。そのため、Doris のオプティマイザー、実行エンジン、インデックス実装には、より高い性能が求められます。
初期設定のまま行ったテストでは、Doris のクエリ性能は業界の主要なベクトル専用データベースと同程度に達しています。次の図は、Performance768D10M データセットで、Doris とベクトル検索機能を持つ他のデータベースを比較したものです。他のデータベースのデータは、Zilliz が公開するオープンソースの VectorDBBench フレームワークに基づいています。
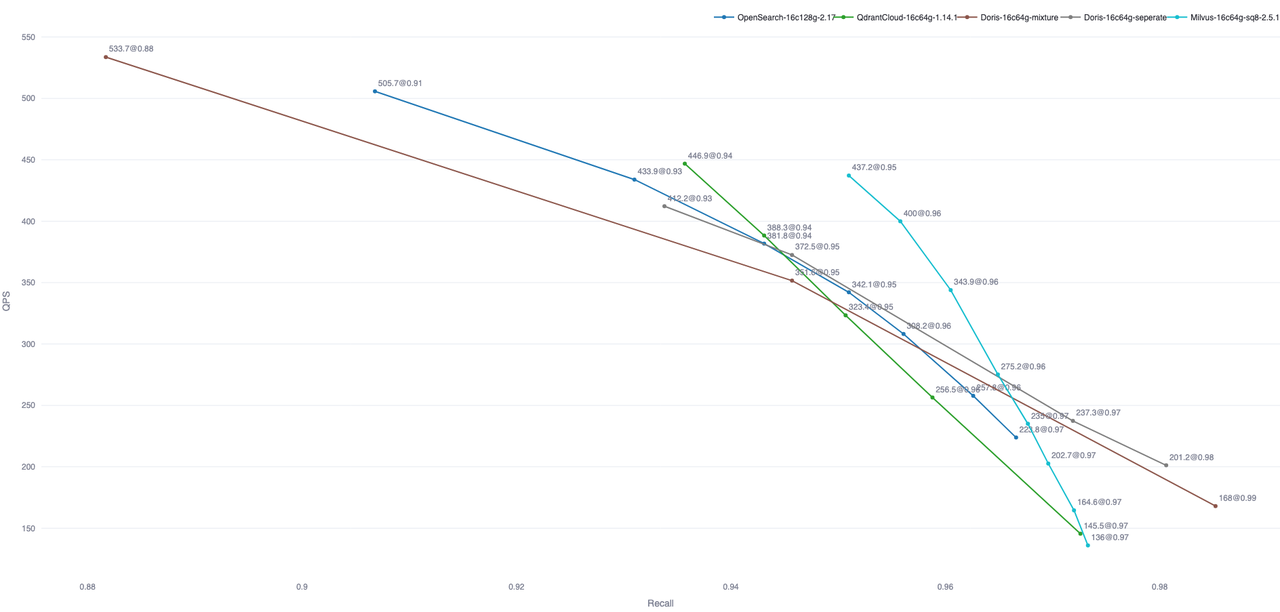
注:この図に含まれるのは、一部のデータベースを初期設定のままテストした結果だけです。OpenSearch と Elastic Cloud は、インデックスファイル数を最適化することでクエリ性能をさらに向上できます。
クエリフェーズの最適化は、重複した計算と不要なディスク IO をなくし、同時実行時の性能を最大化するという一つの目標を中心に設計されています。具体的な手法は次のとおりです。
Prepare Statement
従来の実行経路では、Doris は SQL 文ごとに最適化処理の全工程(構文解析、意味解析、RBO、CBO)を実行します。これは一般的な OLAP 用途では欠かせませんが、検索のように単純で繰り返しの多いクエリパターンでは、余分なオーバーヘッドが目立ちます。
Doris 4.0 では Prepare Statement を拡張し、ポイントクエリだけでなく、ベクトル検索を含むすべての SQL タイプをサポートします。中心となる考え方は次のとおりです。
- コンパイルと実行の分離
- Prepare フェーズで解析、意味解析、最適化を一度だけ行い、再利用可能な論理プランを生成します。
- Execute フェーズでは実際のパラメータをバインドして生成済みのプランを直接実行し、オプティマイザーを完全に省略します。
- プランキャッシュ
- プランを再利用できるかどうかは、SQL フィンガープリント(正規化された SQL とスキーマバージョン)で判断します。
- パラメータ値が異なっていても構造が同じなら、プランをそのまま再利用でき、最適化の繰り返しを避けられます。
- スキーマバージョンの検証
- 実行時にテーブルのスキーマバージョンを確認し、プランの正しさを保証します。
- スキーマが変わっていなければプランを再利用します。変更されていれば、プランを自動的に無効化して再度 Prepare します。
- オプティマイザーの省略による大幅な高速化
- Execute では RBO/CBO が実行されず、最適化にかかる時間はほぼなくなります。
- ベクトル検索のようなテンプレート化されたクエリでは、Prepare によりエンドツーエンドのレイテンシーを大幅に削減できます。
Index Only Scan
Doris のベクトルインデックスは、付属インデックスとして実装されています。付属インデックスは管理しやすく、非同期で構築できますが、重複した計算と不要な IO をどう避けるかという性能上の課題もあります。
ANN インデックスは、一致した行 ID に加えてベクトル間の距離も返せます。この追加情報を効率的に利用するため、実行エンジンは Scan オペレーターで距離に関する式を「早期に短絡評価」します。Doris は「仮想列」の仕組みでこの短絡評価を自動的に行い、Ann Index Only Scan を使って距離計算に関わる読み取り IO を完全に排除します。
単純な処理の流れ:Scan が述語をインデックスにプッシュダウンし、インデックスが行 ID を返します。Scan は行 ID を使ってデータページを読み取り、式を計算して、N 行の結果を上位へ返します。
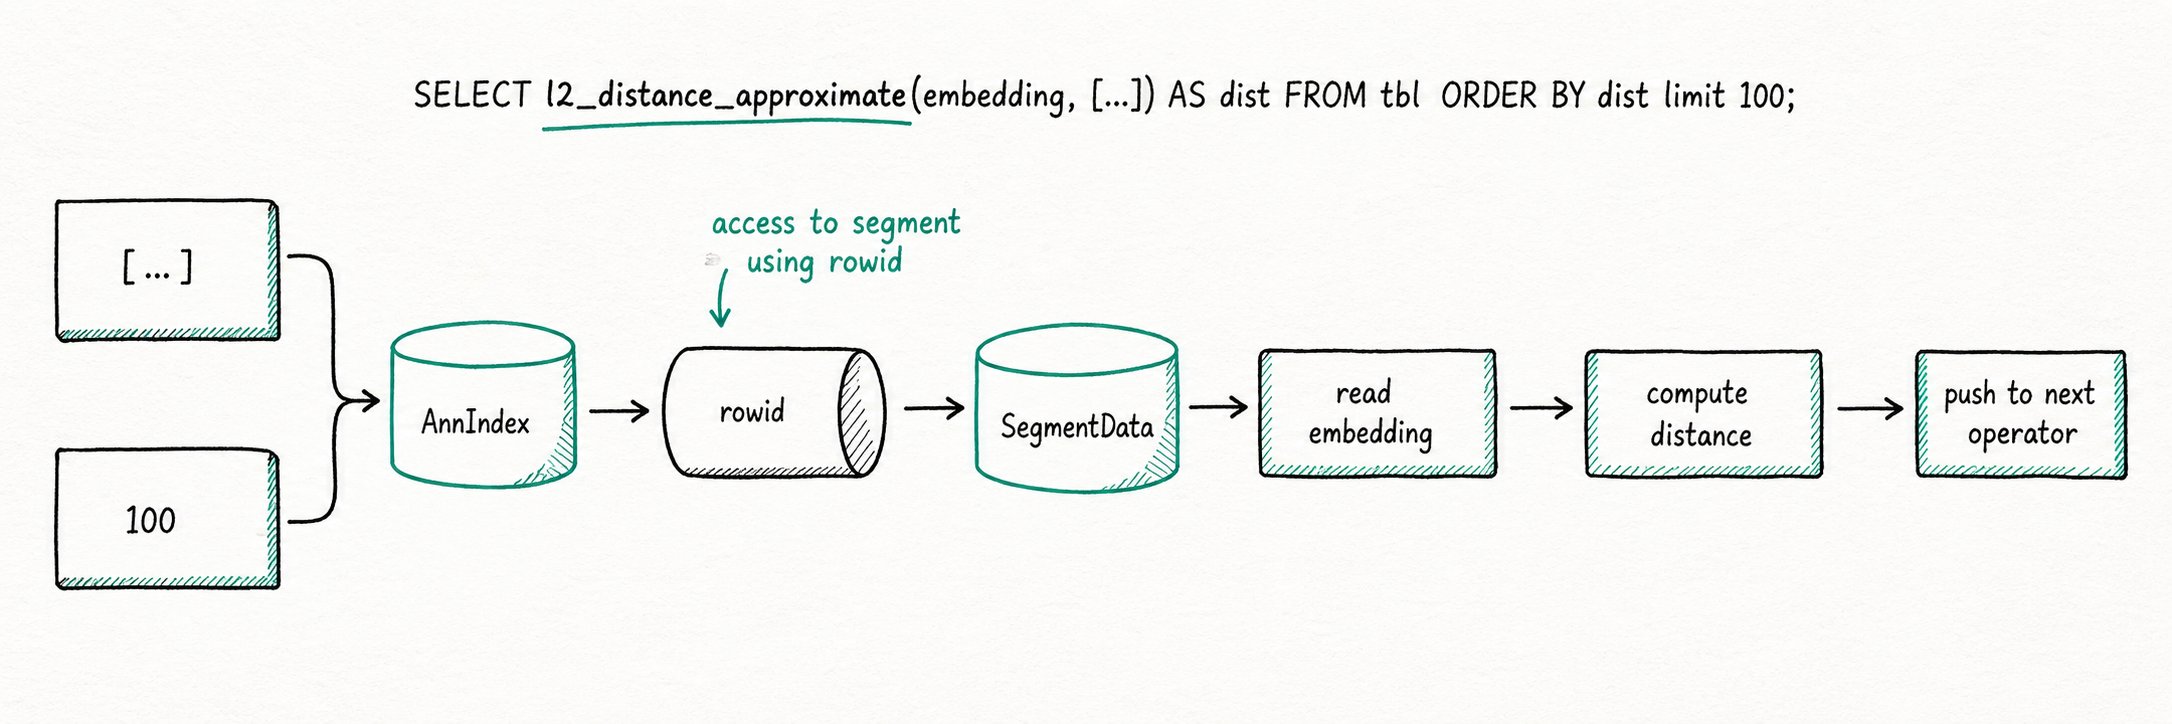
Index Only Scan を適用した場合:
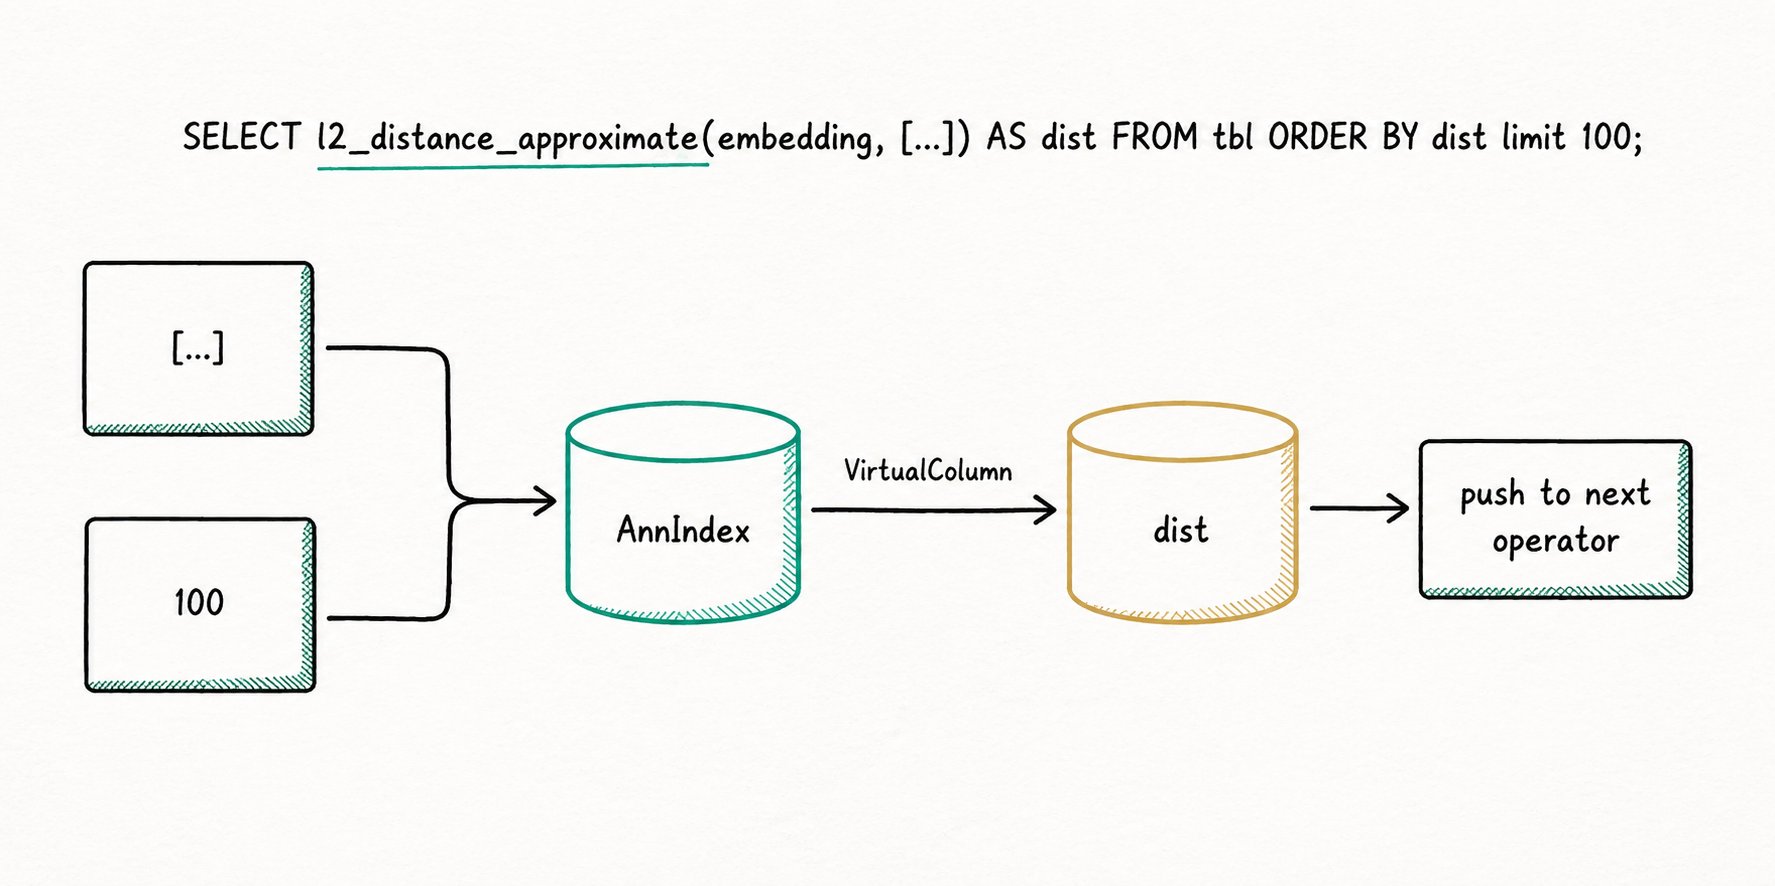
たとえば、次のクエリです。
SELECT l2_distance_approximate(embedding, [...]) AS dist
FROM tbl
ORDER BY dist
LIMIT 100;
実行時にデータファイルの IO が発生しなくなります。
Index Only Scan がサポートするクエリタイプ
Ann TopN Search に加え、インデックスによる高速化に対応した Range Search や Compound Search でも、同様の最適化が使われます。Range Search は TopN より複雑で、比較方法によってインデックスが dist を返せるかどうかが変わります。次の表に、Ann Index Only Scan に関係するクエリタイプをまとめます。
| 番号 | パターン | IndexScan を使用 | 主な理由 |
|---|---|---|---|
| Sql1 | Range + 射影、dist <= 10 | True | インデックスが dist を返せるため、CSE 用の仮想列によって射影での dist の再計算を避けられる |
| Sql2 | Range + 射影なし、dist <= 10 | True | インデックスが dist を返せる |
| Sql3 | Range + 射影、dist > 10 | False | インデックスが dist を返せず、射影に dist が必要なため、embedding を再度読み取る必要がある |
| Sql4 | Range + 射影、dist > 10、射影には dist が不要 | True | 射影に dist が不要なため、embedding を再度読み取る必要がない |
| Sql5 | TopN | True | インデックスが dist を返し、仮想スロットが射影まで渡される |
| Sql6 | TopN + IndexFilter | True | comment 列は転置インデックスの Scan によってすでに最適化されており、embedding は読み取られない |
| Sql7 | TopN + Range | True | Sql1 と Sql5 の組み合わせ |
| Sql8 | TopN + Range + IndexFilter | True | Sql6 と Sql7 の組み合わせ |
| Sql9 | TopN + Range + CommonFilter(dist < 10) | False | 残余の共通フィルターにより、embedding が引き続き実体化される(費用対効果が低いため、現時点では未最適化) |
| Sql10 | Sql9 の変形(dist > 10) | False | インデックスが embedding を返せないため、abs の計算には実体化が必要 |
| Sql11 | Sql9 の変形(array_size(embedding) > 10) | False | array_size によって embedding の実体化が必要になる |
詳細なコメントを付けた SQL 全体を以下に示します。
-- Sql1
-- Range + proj
-- The Ann index can return dist, so dist does not need to be computed again.
-- At the same time, virtual column for cse avoids the dist computation in proj.
-- IndexScan: True
select id, dist(embedding, [...]) from tbl where dist <= 10;

-- Sql2
-- Range + no-proj
-- The Ann index can return dist, so dist does not need to be computed again.
-- IndexScan: True
select id from tbl where dist <= 10 order by id limit N;

-- Sql3
-- Range + proj + no-dist-from index
-- The Ann index cannot return dist (the index can only update the rowid map).
-- Since proj requires dist to be returned, embedding must be re-read.
-- IndexScan: False
select id, dist(embedding, [...]) from tbl where dist > 10;

-- Sql4
-- Range + proj + no-dist-from index
-- The Ann index cannot return dist (the index can only update the rowid map).
-- However, proj does not need dist, so embedding does not need to be re-read.
-- IndexScan: True
select id from tbl where dist > 10;

-- Sql5
-- TopN
-- AnnIndex returns dist, and virtual slot for cse ensures that the dist from the index is passed up to proj,
-- so the embedding column does not need to be read.
-- IndexScan: True
select id[, dist(embedding, [...])] from tbl order by dist(embedding, [...]) asc limit N;

-- Sql6
-- TopN + IndexFilter
-- 1. The comment column does not need to be read; the inverted index scan has already done this optimization.
-- 2. The embedding column does not need to be read, for the same reason as Sql5.
-- IndexScan: True
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql7
-- TopN + Range
-- IndexScan: True, because this is a combination of Sql1 and Sql5.
select id[, dist(embedding, [...])] from tbl where dist(embedding, [...]) > 10 order by dist(embedding, [...]) limit N;

-- Sql8
-- TopN + Range + IndexFilter
-- IndexScan: True, because this is a combination of Sql7 and Sql6.
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql9
-- TopN + Range + CommonFilter
-- The key points here: 1. dist < 10, not dist > 10; 2. the common filter does not read embedding directly, but reads dist.
-- The Ann index can return dist, and virtual slot ref for cse ensures that all reads of dist refer to the same column.
-- In this case, although Ann TopN cannot be applied, in theory the embedding column does not need to be materialized at any point.
-- However, in practice, embedding is still materialized, because whether a column can skip reading is currently judged by whether predicates on this column still have residuals;
-- the common filter itself cannot be eliminated, so the current code still considers it necessary to materialize the column.
-- The ROI of this optimization is low, so it is not done.
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) < 10 AND abs(dist(embedding) + 10) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql10
-- A variant of Sql9: dist < 10 becomes dist > 10. In this case the index cannot return embedding,
-- so embedding must be materialized in order to compute abs(dist(embedding, [...])).
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) > 10 AND abs(dist(embedding) + 10) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql11
-- A variant of Sql9: abs(dist(embedding) + 10) > 10 becomes array_size(embedding) > 10. The difference is that array_size forces embedding to be materialized.
-- To compute array_size(embedding, [...]), embedding must be materialized.
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) < 10 AND array_size(embedding) > 10 ORDER BY dist(embedding, [...]) LIMIT N;
共通部分式の最適化に用いる仮想列
Index Only Scan は主に IO の問題に対処し、embedding に対する大量のランダム読み取りを回避します。重複した計算もなくすため、Doris は計算レイヤーに「仮想列」の仕組みを導入し、インデックスが返した dist を列として式実行器に渡します。
仮想列の主な設計上のポイントは次のとおりです。
- 式ノード
VirtualSlotRefは、式によって実体化され、複数の式で共有できる、特別な「実行時に計算される」列を表します。最初に使用されるときに一度だけ計算され、射影と述語の間で共通部分式(CSE)が重複して計算されるのを防ぎます。 - 列イテレーター
VirtualColumnIteratorは、インデックスが返した距離を式に実体化し、距離関数の重複計算を避けます。
この仕組みは当初、ANN 関連クエリの CSE を除去するために使われ、その後、一般的な射影 + Scan + Filter の組み合わせにも拡張されました。
測定結果
ClickBench データセットを使い、Google からのクリック数が多いウェブサイトの上位 20 件を集計します。
set experimental_enable_virtual_slot_for_cse=true;

SELECT counterid,
       COUNT(*)               AS hit_count,
       COUNT(DISTINCT userid) AS unique_users
FROM   hits
WHERE  ( UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) = 'GOOGLE.COM'
         OR UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) = 'GOOGLE.RU'
         OR UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) LIKE '%GOOGLE%' )
       AND ( LENGTH(regexp_extract(referer, '^https?://([^/]+)', 1)) > 3
              OR regexp_extract(referer, '^https?://([^/]+)', 1) != ''
              OR regexp_extract(referer, '^https?://([^/]+)', 1) IS NOT NULL )
       AND eventdate = '2013-07-15'
GROUP  BY counterid
HAVING hit_count > 100
ORDER  BY hit_count DESC
LIMIT  20;
中核となる式 regexp_extract(referer, '^https?://([^/]+)', 1) は CPU 負荷が高く、複数の箇所で再利用されます。仮想列の最適化を無効にした場合と有効にした場合の比較は次のとおりです。
| 状態 | 時間 |
|---|---|
| 最適化が無効 | 1.50 s |
最適化が有効(set experimental_enable_virtual_slot_for_cse=true) | 0.57 s |
エンドツーエンドの性能は約 3 倍に向上します。
Scan の並列化最適化
Doris は Ann TopN Search に特化して Scan の並列化戦略を再設計しました。
| 項目 | 従来の戦略 | 新しい戦略 |
|---|---|---|
| 並列度の基準 | 行数(デフォルトでは Scan Task あたり 2,097,152 行) | Segment ごとに必ず一つの Scan Task を作成 |
| 高次元ベクトルを扱う場合の動作 | 単一 Segment の行数がしきい値を大きく下回るため、複数の Segment を直列に Scan する | インデックス解析フェーズで並列度を高める |
| テーブル参照の影響 | - | Ann TopN はフィルター率が高いため、直列のテーブル参照は全体の性能に影響しない |
SIFT 1M を例に取ると、set optimize_index_scan_parallelism=true; を有効にした後、直列 TopN クエリの実行時間は 230 ms から 50 ms に短縮されます。
さらに 4.0 では「並列度の動的調整」が導入されました。各スケジューリングラウンドの前に、Scan スレッドプールの負荷に応じて、投入できるタスク数を動的に決定します。負荷が高いときは並列度を下げ、リソースに余裕があるときは上げることで、直列処理と高い同時実行数の両方において、リソース利用率とスケジューリングのオーバーヘッドのバランスを取ります。
グローバル TopN の遅延実体化
一般的な Ann TopN クエリには、二つのフェーズがあります。
- 第一フェーズ:Scan オペレーターが、インデックスを使って各 Segment の TopN の距離を取得します。
- 第二フェーズ:グローバルソートノードが Segment ごとの TopN をマージしてソートし、最終的な TopN を取得します。
射影で複数の列を返す場合や、String のような大きな列を含む場合、第一フェーズで各 Segment から読み取った N 行によって大量のディスク IO が発生することがあります。これらの行は最終的な TopN に含まれず、第二フェーズのグローバルソートで破棄される場合もあります。Doris は「グローバル TopN の遅延実体化」を使い、第一フェーズでの読み取り量を最小限に抑えます。
次の例を見てみましょう。
SELECT id, l2_distance_approximate(embedding, [...]) AS dist
FROM tbl
ORDER BY dist
LIMIT 100;
実行の流れは次のとおりです。
- 第一フェーズ:各 Segment は Ann Index Only Scan と仮想列を使い、100 件の
dist値とそれぞれのrowidだけを出力します。 - 第二フェーズ:Segment が合計 M 個ある場合、
100 * M個のdist値をグローバルソートして、最終的な TopN とそのrowidを取得します。 - 最後に、Materialize オペレーターが、これらの
rowidに基づいて、対応する Tablet、Rowset、Segment 上の必要な列を実体化します。