메타데이터 설계
이 문서는 Apache Doris FE 메타데이터의 전체 아키텍처, 저장 구조, 데이터 흐름과 함께 구현 세부 사항, 시작 절차, 장애 복구 메커니즘을 설명합니다.
용어
| 용어 | 설명 |
|---|---|
| FE | Frontend로, Doris의 프런트엔드 노드입니다. 클라이언트 요청을 수신하고 응답하며, 메타데이터와 클러스터를 관리하고 쿼리 계획을 생성합니다. |
| BE | Backend로, Doris의 백엔드 노드입니다. 데이터를 저장하고 관리하며 쿼리 계획을 실행합니다. |
| bdbje | Oracle Berkeley DB Java Edition입니다. Doris에서 bdbje는 메타데이터 작업 로그를 영구 저장하고 FE의 고가용성을 제공합니다. |
전체 아키텍처
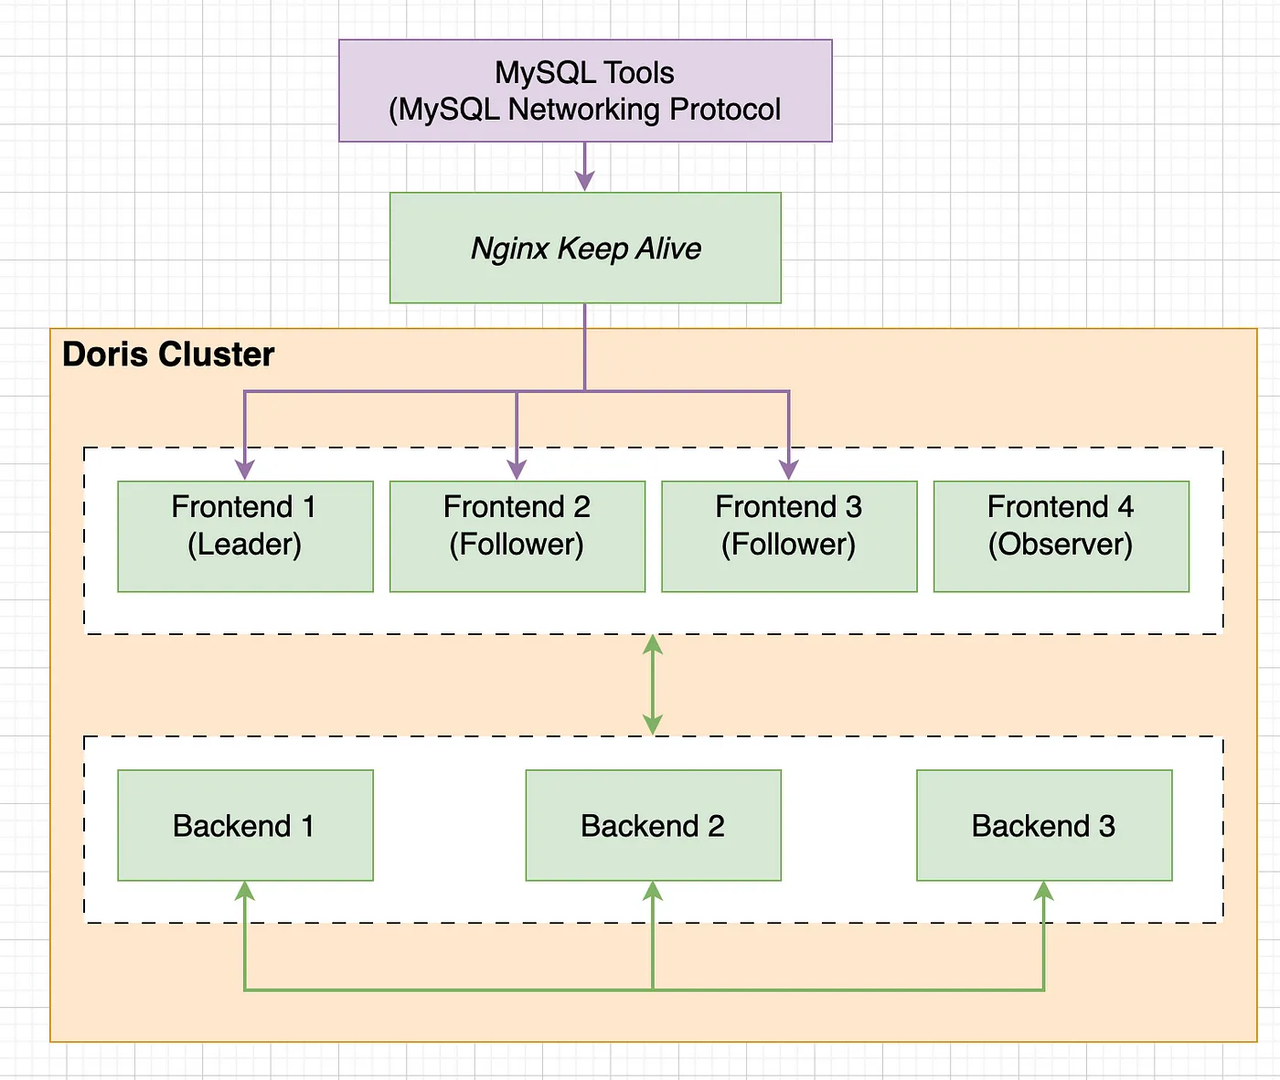
위 그림과 같이 Doris는 두 계층으로 구성된 아키텍처를 사용합니다. 여러 FE가 첫 번째 계층을 구성하여 FE의 수평 확장과 고가용성을 제공합니다. 여러 BE는 두 번째 계층을 구성하며, 데이터 저장과 관리를 담당합니다. 이 문서는 FE 계층의 메타데이터 설계와 구현에 중점을 둡니다.
-
FE 노드는 follower와 observer의 두 유형으로 나뉩니다. FE는 bdbje(BerkeleyDB Java Edition)를 통해 leader 선출, 데이터 동기화 및 관련 작업을 수행합니다.
-
follower 노드는 메타데이터 쓰기 작업을 처리할 leader를 선출합니다. leader 노드에 장애가 발생하면 나머지 follower 노드가 새 leader를 선출하여 서비스의 고가용성을 유지합니다.
-
observer 노드는 leader의 메타데이터를 동기화하기만 하며, 선출에 참여하지 않습니다. 수평 확장을 통해 메타데이터 읽기 서비스를 확장할 수 있습니다.
참고: Doris의 follower와 observer 개념은 bdbje의 replica와 observer에 각각 대응합니다. 아래 설명에서는 두 명칭이 모두 사용될 수 있습니다.
메타데이터 구조
Doris 메타데이터는 전체가 메모리에 저장됩니다. 각 FE는 완전한 메타데이터 이미지를 메모리에 유지합니다. Baidu의 내부 배포 환경에서는 테이블 2,500개와 tablet 1백만 개(replica 3백만 개)가 있는 클러스터의 메타데이터가 약 2 GB의 메모리만 사용합니다. (쿼리 중간 객체, 각종 작업 정보 등의 메모리 오버헤드는 별도로 산정해야 하지만, 전체 메모리 사용량은 여전히 적습니다.)
메타데이터는 메모리에 트리 형태의 계층 구조로 저장되며, 각 계층의 메타데이터에 빠르게 접근할 수 있도록 보조 구조를 사용합니다.
아래 그림은 Doris 메타데이터의 구성을 보여 줍니다.
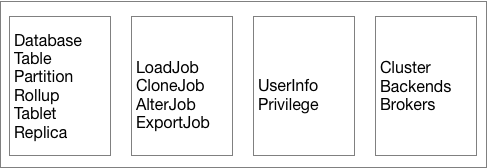
위 그림과 같이 Doris 메타데이터에는 네 가지 범주의 데이터가 저장됩니다.
- 데이터베이스, 테이블 스키마, tablet 정보 등을 포함한 사용자 데이터 정보.
- 데이터 적재 작업, 복제 작업, 스키마 변경 작업 등 각종 작업 정보.
- 사용자 및 권한 정보.
- 클러스터 및 노드 정보.
데이터 흐름
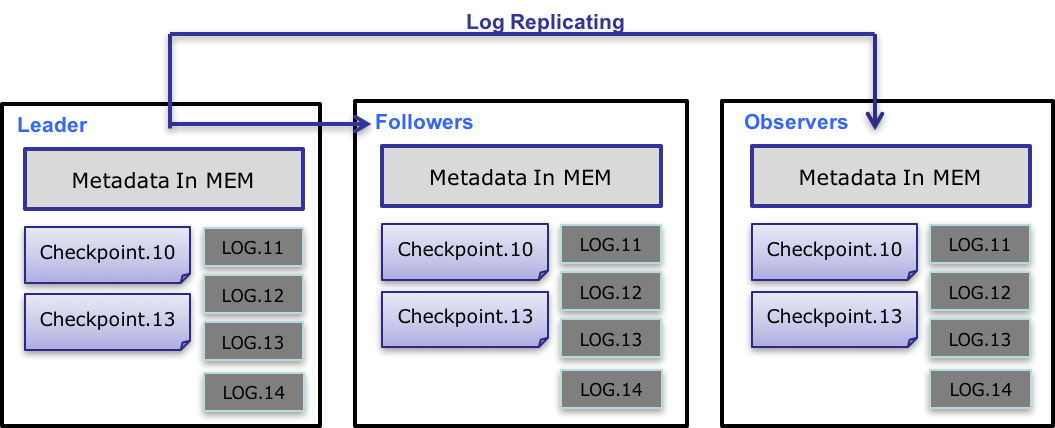
메타데이터의 데이터 흐름은 다음과 같습니다.
-
leader FE만 메타데이터를 쓸 수 있습니다. 쓰기 작업으로 leader의 메모리가 변경되면, 해당 작업은 로그 항목으로 직렬화되어 bdbje에 키-값 쌍으로 기록됩니다. 키는 로그 id 역할을 하는 연속된 정수이며, 값은 직렬화된 작업 로그입니다.
-
로그가 bdbje에 기록되면, bdbje는 정책(write-majority 또는 write-all)에 따라 leader가 아닌 다른 FE 노드에 로그를 복제합니다. leader가 아닌 FE 노드는 로그를 재생하여 자체 메모리의 메타데이터 이미지를 갱신하고, leader와의 메타데이터 동기화를 완료합니다.
-
leader의 로그 항목 수가 임계값(기본값 10w개)에 도달하고 체크포인트 스레드의 실행 주기(기본값 60초)가 되면, 체크포인트는 기존 이미지 파일과 그 이후의 로그를 읽습니다. 그런 다음 로그를 재생하여 메모리에 새 메타데이터 이미지 복사본을 만들고, 이를 디스크에 기록하여 새 이미지를 생성합니다. 기존 이미지를 직접 기록하지 않고 새 이미지 복사본을 재생하는 이유는 이미지 기록에 읽기 잠금이 필요하며, 이 잠금이 쓰기 작업을 차단하기 때문입니다. 따라서 체크포인트를 수행할 때마다 메모리를 두 배로 사용합니다.
-
이미지 파일이 생성되면 leader는 다른 노드에 새 이미지를 사용할 수 있음을 알립니다. leader가 아닌 노드는 HTTP를 통해 최신 이미지 파일을 직접 가져와 로컬의 기존 파일을 교체합니다.
-
이미지가 생성된 후에는 bdbje의 오래된 로그가 주기적으로 삭제됩니다.
구현 세부 사항
메타데이터 디렉터리
- 메타데이터 디렉터리는 FE 설정 항목
meta_dir로 지정합니다. bdb/디렉터리에는 bdbje 데이터가 저장됩니다.image/디렉터리에는 이미지 파일이 저장됩니다.
image/ 디렉터리의 주요 파일은 다음과 같습니다.
| 파일 | 설명 |
|---|---|
image.[logid] | 최신 이미지 파일입니다. logid 접미사는 이미지에 포함된 마지막 로그 항목의 id를 나타냅니다. |
image.ckpt | 현재 기록 중인 이미지 파일입니다. 기록이 성공적으로 완료되면 image.[logid]로 이름이 변경되어 기존 이미지 파일을 대체합니다. |
VERSION | Doris 클러스터를 고유하게 식별하는 cluster_id를 기록합니다. cluster_id는 leader가 처음 시작될 때 생성되는 임의의 32비트 정수이며, FE 설정 항목 cluster_id로도 지정할 수 있습니다. |
ROLE | FE 자체의 역할을 기록하며, 값은 FOLLOWER 또는 OBSERVER만 가능합니다. FOLLOWER는 해당 FE가 선출 가능한 노드임을 나타냅니다. (참고: leader 노드의 역할도 FOLLOWER입니다.) |
시작 절차
-
FE를 처음 시작할 때 시작 스크립트를 매개변수 없이 실행하면 FE는 leader로 시작하려고 시도합니다. FE 시작 로그에는 최종적으로
transfer from UNKNOWN to MASTER가 표시됩니다. -
FE를 처음 시작할 때 시작 스크립트에서
--helper매개변수가 올바른 leader FE 노드를 가리키도록 지정하면, FE는 먼저 HTTP를 통해 leader에 자신의 역할(ROLE)과cluster_id를 요청한 다음 최신 이미지 파일을 가져옵니다. 이미지 파일을 읽어 메타데이터 이미지를 생성한 후에는 bdbje를 시작하여 로그를 동기화합니다. 동기화가 완료되면 bdbje에서 이미지 파일 이후의 로그를 재생하여 최종 메타데이터 이미지를 생성합니다.참고 1:
--helper매개변수로 시작할 때는 먼저 leader에서 mysql 명령으로 해당 FE를 추가해야 합니다. 그렇지 않으면 오류가 발생하여 시작에 실패합니다.참고 2:
--helper는 어느 follower 노드든 가리킬 수 있으며, 반드시 leader를 가리킬 필요는 없습니다.참고 3: bdbje가 로그를 동기화하는 동안 FE 로그에
xxx detached가 표시됩니다. 이는 로그를 가져오는 중임을 나타내는 정상적인 메시지입니다. -
FE를 다시 시작할 때 시작 스크립트를 매개변수 없이 실행하면, FE는 로컬에 저장된 ROLE 정보를 바탕으로 자신의 역할을 판단합니다. 또한 로컬 bdbje에 저장된 클러스터 정보에서 leader 정보를 읽은 다음, 로컬 이미지 파일과 bdbje의 로그를 읽어 메타데이터 이미지를 생성합니다. (로컬 ROLE에 기록된 역할이 bdbje에 기록된 역할과 일치하지 않으면 오류가 보고됩니다.)
-
FE를 다시 시작할 때 시작 스크립트에서
--helper매개변수를 지정하면, 절차는 처음 시작할 때와 같습니다. FE는 먼저 leader에 역할을 요청하지만, 이후 그 결과를 로컬에 저장된 ROLE과 비교하여 일치하지 않으면 오류를 보고합니다.
메타데이터 읽기, 쓰기 및 동기화
-
mysql을 사용하여 어느 FE 노드에든 연결해 메타데이터를 읽고 쓸 수 있습니다. 연결한 노드가 leader가 아니면 쓰기 작업을 leader로 전달합니다. leader는 쓰기에 성공하면 최신 로그 id를 반환합니다. leader가 아닌 노드는 자신이 재생한 로그의 id가 반환받은 로그 id보다 커질 때까지 기다린 후 클라이언트에 성공 메시지를 반환합니다. 이 메커니즘은 어느 FE 노드에서든 Read-Your-Write 의미 체계를 제공합니다.
참고:
SHOW LOAD와 같이 쓰기 작업이 아닌 일부 작업도 leader로 전달됩니다. 이러한 명령은 일반적으로 일부 작업의 중간 상태를 읽어야 하는데, 중간 상태는 bdbje에 기록되지 않으므로 leader가 아닌 노드의 메모리에는 존재하지 않습니다. (FE 간 메타데이터 동기화는 전적으로 bdbje 로그 재생에 의존합니다. 메타데이터 변경 작업이 bdbje 로그에 기록되지 않으면 leader가 아닌 다른 노드에서는 변경 결과를 확인할 수 없습니다.) -
leader 노드는 현재 시간을 포함한 키-값 항목을 bdbje에 주기적으로 기록하는
TimePrinter스레드를 시작합니다. leader가 아닌 나머지 노드는 이 로그를 재생하여 기록된 시간을 읽고 로컬 시간과 비교합니다. 로컬 시간 기준 지연이 지정된 임계값(설정 항목meta_delay_toleration_second이며, 쓰기 간격은 이 값의 절반으로 설정됨)을 초과하면 해당 노드는 읽기 불가 상태가 됩니다. 이 메커니즘은 leader와 장시간 연결이 끊긴 노드가 오래된 메타데이터를 계속 제공하는 것을 방지합니다. -
FE 간 메타데이터는 최종적 일관성만 제공합니다. 정상적인 상황에서 일관성이 유지되지 않는 시간은 밀리초 수준입니다. 동일한 세션 내에서는 메타데이터 접근의 단조 일관성이 보장되지만, 동일한 클라이언트가 서로 다른 FE에 연결하면 메타데이터 롤백이 발생할 수 있습니다. (일괄 갱신 시스템에서는 이 문제의 영향이 크지 않습니다.)
장애 복구
| 상황 | 동작 |
|---|---|
| leader 노드에 장애 발생 | 나머지 follower가 즉시 새 leader를 선출하여 서비스를 제공합니다. |
| 과반수의 follower 노드에 장애 발생 | 메타데이터를 쓸 수 없습니다. 이때 쓰기 요청이 들어오면 현재는 FE 프로세스가 즉시 종료됩니다. 향후 최적화를 통해 쓰기 불가 상태에서도 읽기 서비스를 계속 제공할 예정입니다. |
| observer 노드에 장애 발생 | 다른 노드의 상태나 다른 노드에서의 메타데이터 읽기 및 쓰기에 영향을 주지 않습니다. |