Compaction 원리
1. Compaction의 역할
Apache Doris는 LSM-Tree 기반 스토리지 엔진을 사용하며, 쓰기 작업 시 기존 파일을 직접 업데이트하는 대신 새 데이터 파일에 데이터를 순차적으로 추가합니다. 이 설계는 높은 쓰기 성능을 보장하지만, 시간이 지남에 따라 버전과 크기가 서로 다른 데이터 파일이 쌓이면서 다음과 같은 문제가 발생합니다.
- 쿼리 성능 저하: 쿼리 실행 시 여러 파일에 걸쳐 다방향 병합 정렬을 수행해야 합니다.
- 스토리지 공간 낭비: 삭제 표시된 데이터나 중복 데이터가 남아 있습니다.
Compaction(데이터 압축 및 정리)은 이러한 문제를 해결하는 핵심 메커니즘입니다. 백그라운드에서 데이터 파일을 자동으로 병합하고 다시 작성하여, 기본 키가 같거나 범위가 인접한 데이터를 더 적은 수의 정렬된 파일로 통합하고 삭제되었거나 만료된 데이터를 정리합니다. 이를 통해 높은 쿼리 성능을 유지하면서 스토리지 공간 활용도를 최적화합니다.
Doris에서 Compaction은 지속적으로 자동 수행되므로 수동으로 실행할 필요가 없습니다. 다만 그 원리와 실행 상태를 이해하면 동시성이 높고 대용량 데이터를 다루는 환경에서 성능을 튜닝하는 데 도움이 됩니다.
1.1 쿼리 성능 개선
Doris의 데이터 적재 방식: 각 데이터 적재 작업은 대상 파티션의 각 tablet에 rowset을 생성합니다.
- 각 rowset은 0개에서 n개의 segment를 포함합니다.
- 각 segment는 디스크에 있는 정렬된 파일에 대응합니다.
쿼리 실행 시 스토리지 계층은 집계하거나 중복을 제거한 결과를 반환해야 하므로, 여러 rowset/segment의 데이터를 다방향 병합 정렬합니다. rowset 수가 증가하면 병합 경로 수도 늘어나 쿼리 효율이 떨어집니다.
Compaction의 역할:
- BE 노드는 백그라운드에서 이러한 rowset을 지속적으로 병합하여 병합 경로 수를 줄이고 쿼리 효율을 높입니다.
- Compaction은 tablet 단위로 실행됩니다.
1.2 데이터 정리
Compaction은 성능 개선 외에도 데이터 정리를 담당합니다.
- 삭제 표시된 데이터 정리
- Doris의 DELETE 작업은 데이터를 즉시 삭제하지 않고 delete rowset을 생성합니다. 이 rowset에는 실제 데이터 없이 삭제 조건식만 포함됩니다. Compaction 과정에서 이 조건식에 일치하는 데이터를 걸러내고 실제로 삭제합니다.
- Merge-on-Write 유형의 테이블에서는 삭제 표시가 있는 데이터도 Compaction 단계에서 정리합니다.
- 중복 데이터 제거
- Aggregate 모델: 키가 같은 행을 집계합니다.
- Unique 모델: 키가 같은 데이터 중 최신 데이터만 유지합니다.
이를 통해 데이터의 정확성을 보장하고 스토리지 공간 사용량을 줄입니다.
2. 핵심 개념
2.1 Compaction Score
Compaction Score는 tablet 내 데이터가 얼마나 정리되지 않은 상태인지를 나타내는 지표이며, Compaction 우선순위를 결정하는 기준이기도 합니다. 쿼리 실행 중 해당 tablet의 데이터를 병합하는 데 필요한 경로 수에 해당합니다.
- Score가 높을수록 쿼리 오버헤드가 커집니다.
- 따라서 Compaction은 Score가 높은 tablet을 우선 처리합니다.
예시:
"rowsets": [
    "[0-100] 3 DATA NONOVERLAPPING 0200000000001c30804822f519cf378fbe6f162b7de393a6 500.32 MB",
    "[101-101] 2 DATA OVERLAPPING 02000000000021d0804822f519cf378fbe6f162b7de393a6 180.46 MB",
    "[102-102] 1 DATA NONOVERLAPPING 0200000000002211804822f519cf378fbe6f162b7de393a6 50.59 MB"
]
- [0-100] rowset은 segment가 3개지만 서로 겹치지 않음 → 경로 1개 차지
- [101-101] rowset은 segment가 2개이고 서로 겹침 → 경로 2개 차지
- [102-102] rowset은 경로 1개를 차지합니다. 따라서 이 tablet의 Compaction Score = 4입니다.
2.2 Compaction 유형
- Cumulative Compaction: 작은 증분 rowset을 병합하여 병합 효율을 높입니다.
- Base Compaction: 특정 rowset 이전의 모든 rowset을 새로운 rowset으로 병합합니다.
- Full Compaction: 모든 rowset을 병합합니다.
- Cumulative Point: Base Compaction과 Cumulative Compaction을 나누는 경계점입니다.
이상적인 전략은 먼저 Cumulative Compaction으로 작은 rowset을 병합하고, 일정 규모까지 누적되면 Base Compaction을 수행하는 것입니다.
3. Compaction 전략
3.1 Tablet 선택 전략
Compaction의 목적은 쿼리 성능 개선이므로, Compaction Score가 가장 높은 tablet을 우선 처리합니다.
3.2 Rowset 선택 전략
대상 tablet을 정한 후에는 Compaction에 적합한 rowset을 선택해야 합니다. 선택 원칙은 다음과 같습니다.
- 연산 부하를 최소화하면서 Compaction Score를 최대한 줄입니다.
- 쓰기 증폭률을 제어합니다.
- 시스템 리소스를 과도하게 점유하지 않도록 합니다.
주요 고려 사항:
- 비용 대비 효율
- Cumulative Compaction: 병합에 참여하는 rowset 간의 크기 차이가 너무 크지 않아야 합니다. 가장 큰 rowset의 크기 ≤ 전체 크기의 절반이어야 합니다.
- Base Compaction: Base rowset과 다른 후보 rowset 간의 비율이 ≥ 0.3인 경우에만 실행됩니다.
- 쓰기 증폭 제어
- Cumulative Compaction:
- 후보 rowset의 Score > 5인 경우에만 실행됩니다.
- 데이터양이 promotion size를 초과하는 경우에만 실행됩니다.
- Base Compaction: 후보 rowset의 Score > 5인 경우에만 실행됩니다.
- Cumulative Compaction:
- 시스템 리소스 제어
- 단일 Cumulative Compaction에 포함되는 rowset 수 ≤ 1000
- 단일 Base Compaction에 포함되는 rowset 수 ≤ 20
4. Compaction 처리 과정
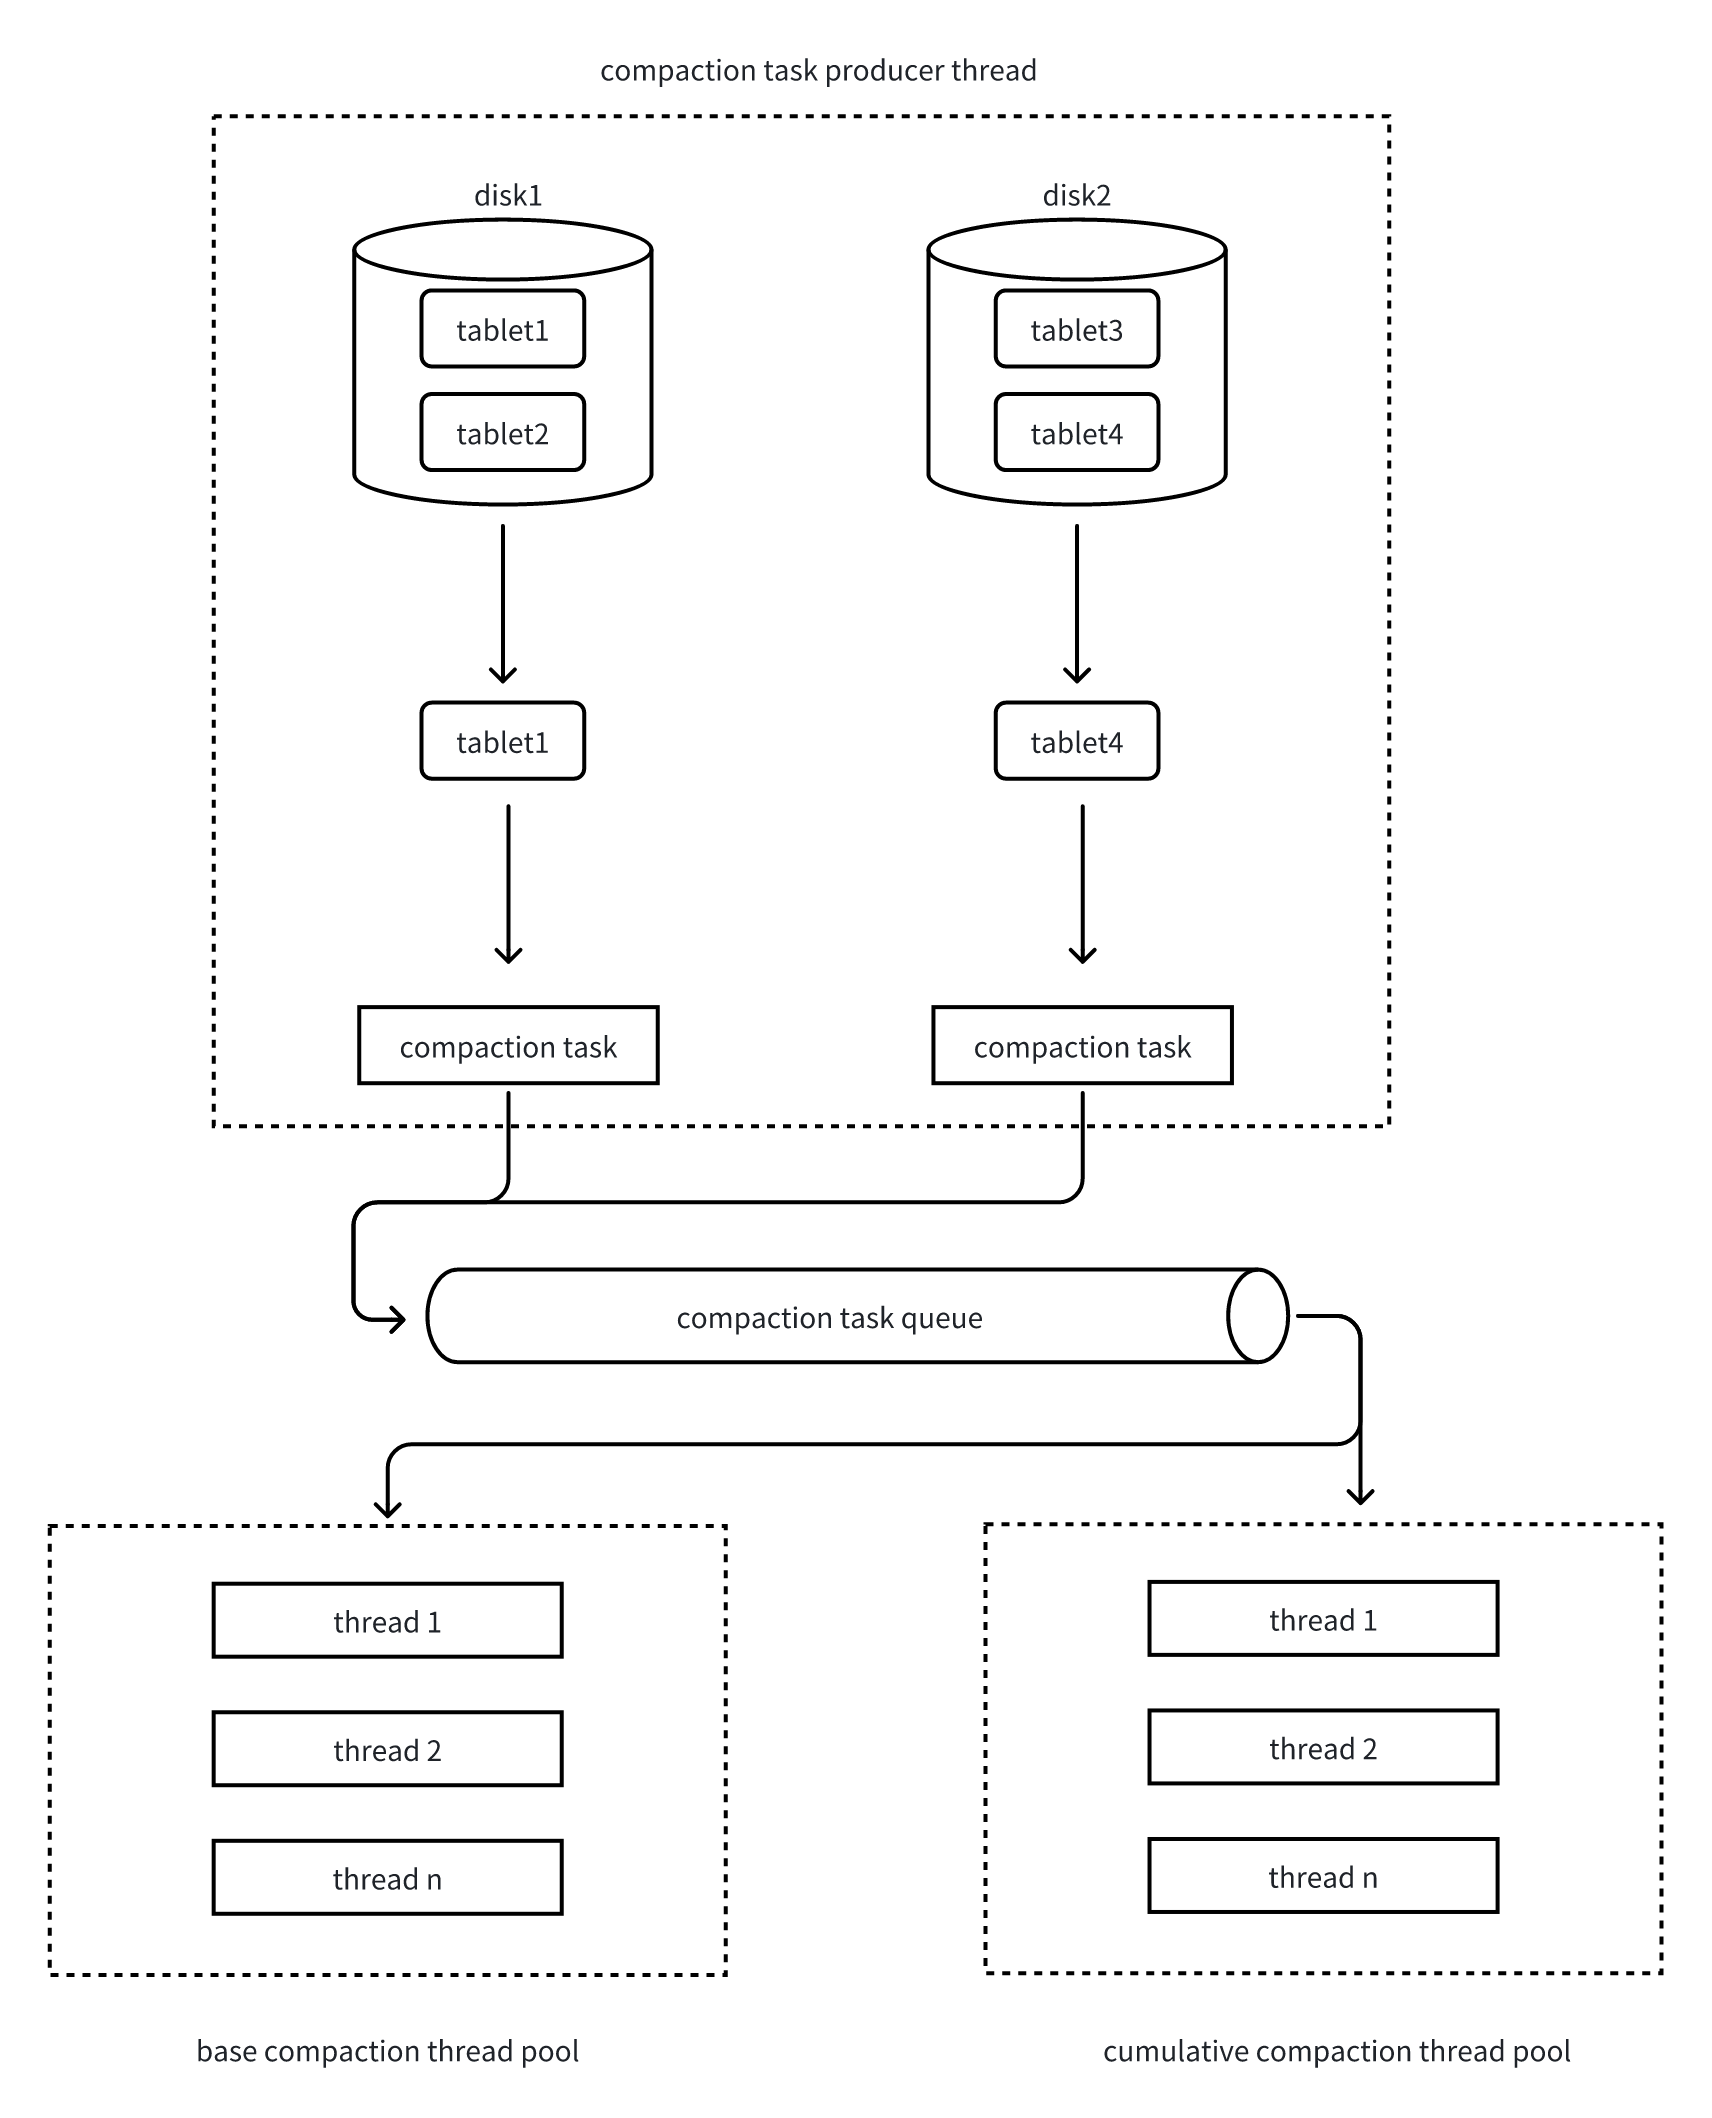
Compaction은 생산자-소비자 모델에 따라 실행됩니다.
- Tablet 스캔 및 작업 생성
- Compaction 작업 생산자 스레드가 주기적으로 모든 tablet을 스캔하고 각 tablet의 Compaction Score를 계산합니다.
- 매 라운드마다 각 디스크에서 Score가 가장 높은 tablet을 선택합니다.
- 10라운드마다 Base Compaction을 선택하고, 나머지 9라운드에서는 Cumulative Compaction을 선택합니다.
- 동시성 제어
- 현재 디스크의 Compaction 작업 수가 설정된 제한을 초과하는지 확인합니다.
- 제한을 초과하지 않으면 해당 tablet에서 Compaction을 수행하도록 허용합니다.
- Rowset 선택
- 크기가 비슷하고 연속된 rowset을 입력으로 선택합니다.
- 데이터양의 큰 차이로 인해 다방향 병합이 비효율적으로 수행되는 상황을 방지합니다.
- 작업 제출
- tablet과 후보 rowset을 Compaction Task로 묶습니다.
- 작업 유형(Base/Cumulative)에 따라 해당 스레드 풀의 큐에 제출합니다.
- 작업 실행
- Compaction 스레드 풀이 큐에서 작업을 가져옵니다.
- 다방향 병합 정렬을 수행하여 여러 rowset을 새로운 rowset으로 병합합니다.
5. 주요 Compaction 매개변수
| 매개변수 이름 | 의미 | 기본값 |
|---|---|---|
| tive_compaction_rounds_for_each_base_compaction_round | Base Compaction 작업을 한 번 생성하기 전에 Cumulative Compaction 작업을 생성하는 라운드 수입니다. 이 매개변수를 조정하면 Cumulative Compaction 작업과 Base Compaction 작업 간의 비율을 제어할 수 있습니다. | 9 |
| compaction_task_num_per_fast_disk | SSD 디스크당 동시에 실행할 수 있는 Compaction 작업의 최대 수입니다. | 8 |
| compaction_task_num_per_disk | HDD 디스크당 동시에 실행할 수 있는 Compaction 작업의 최대 수입니다. | 4 |
| max_base_compaction_threads | Base Compaction 스레드 풀의 작업 스레드 수입니다. | 4 |
| max_cumu_compaction_threads | Cumulative Compaction 스레드 풀의 작업 스레드 수입니다. -1은 디스크 수에 따라 스레드 풀의 크기를 결정하며, 디스크당 스레드를 하나씩 할당한다는 의미입니다. | -1 |
| base_compaction_min_rowset_num | Base Compaction의 실행 조건입니다. rowset 수를 기준으로 실행할 때 Base Compaction에 필요한 최소 rowset 수입니다. | 5 |
| base_compaction_max_compaction_score | Base Compaction에 참여하는 rowset의 최대 Compaction Score입니다. | 20 |
| cumulative_compaction_min_deltas | Cumulative Compaction에 참여하는 rowset의 최소 Compaction Score입니다. | 5 |
| cumulative_compaction_max_deltas | Cumulative Compaction에 참여하는 rowset의 최대 Compaction Score입니다. | 1000 |