AI 개요
Apache Doris는 텍스트 검색, 벡터 검색, AI 함수, MCP 기반의 지능형 상호작용을 긴밀하게 통합한 고성능 실시간 분석 데이터베이스입니다. 데이터 저장, 검색, 분석을 아우르는 완전한 AI 데이터 스택을 구축하여 AI 애플리케이션에 통합 데이터 인프라를 제공합니다.
다음 표에서는 일반적인 AI 활용 시나리오와 이에 대응하는 Doris의 기능을 정리하여 적합한 솔루션을 빠르게 찾을 수 있도록 안내합니다.
| 수행하려는 작업 | 시나리오 | 핵심 기능 |
|---|---|---|
| AI Agent가 비즈니스 데이터를 실시간으로 쿼리하도록 지원 | Agent 대상 분석 | MPP 아키텍처, 밀리초 수준의 쿼리, MCP Server |
| 동일한 데이터에 키워드 검색, 벡터 검색, 집계 수행 | 하이브리드 검색 및 분석 | 역색인 + 벡터 인덱스 + SQL |
| AI 학습 데이터 준비 및 피처 엔지니어링 가속화 | AI를 위한 Lakehouse | Lakehouse 아키텍처, 개방형 테이블 포맷, 빠른 SQL |
| 기업 지식 베이스 및 지능형 고객 서비스 구축 | RAG 애플리케이션 | 높은 동시성을 지원하는 벡터 검색, 하이브리드 검색 |
| 모델 학습 및 추론 서비스 모니터링 | AI 관측 가능성 | 높은 처리량의 데이터 수집, 역색인, 낮은 저장 비용 |
| 검색에서 사용자 의도 파악 | 시맨틱 검색 | HNSW/IVF, 양자화, 멀티모달 확장 |
Agent 대상 분석
AI Agent 기술이 확산되면서 AI가 분석에 기반한 의사결정을 자동으로 내리는 경우가 늘고 있습니다. 이에 따라 데이터 플랫폼에는 매우 높은 실시간 성능과 동시성이 요구됩니다. 기존의 '사람을 위한 분석'과 달리, Agent 대상 분석은 밀리초 이내에 데이터 쿼리와 의사결정을 완료하고 대규모 Agent의 동시 접근을 지원해야 합니다. 대표적인 시나리오로는 실시간 사기 탐지, 지능형 광고 게재, 개인화 추천 등이 있습니다.
Doris는 고성능 MPP 아키텍처를 기반으로 Agent 대상 분석 시나리오에서 다음과 같은 이점을 제공합니다.
| 기능 | 지표 | 가치 |
|---|---|---|
| 데이터 지연 시간 | 초 미만 | 실시간 데이터 수집과 업데이트를 통해 Agent가 최신 데이터를 기반으로 의사결정을 내릴 수 있도록 지원 |
| 쿼리 응답 | 평균 100 ms 미만 | Agent의 실시간 의사결정 요구 충족 |
| 동시성 | 10,000+ QPS | 대규모 Agent의 동시 쿼리를 원활하게 처리 |
| 통합 | 네이티브 MCP Server | AI Agent와 원활하게 통합하고 개발을 간소화 |
하이브리드 검색 및 분석 처리
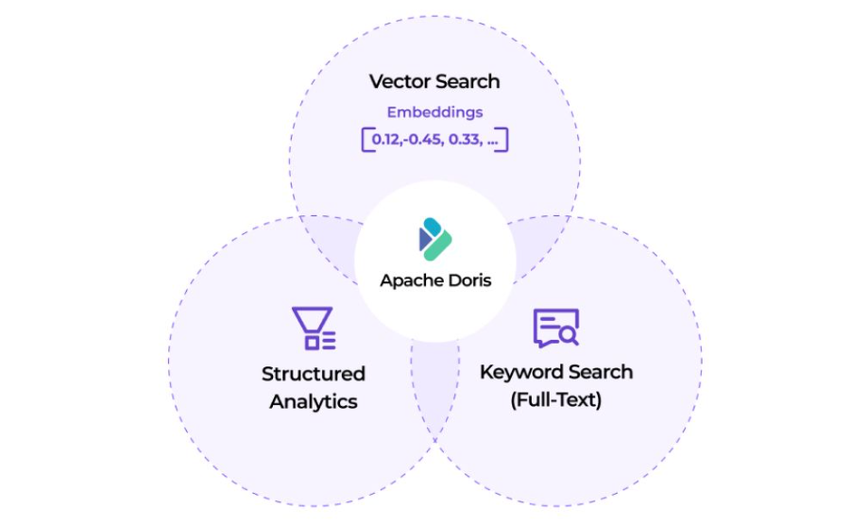
반정형 및 비정형 데이터가 데이터 분석의 핵심 요소로 자리 잡고 있습니다. 고객 리뷰, 채팅 기록, 생산 로그, 차량 텔레메트리 신호는 이제 비즈니스 의사결정에 깊이 통합되어 있습니다. 기존의 정형 데이터 분석 솔루션은 전문 검색과 벡터 검색 기능을 결합하여 단일 플랫폼에서 시맨틱 검색과 집계를 포함한 다차원 분석을 모두 지원해야 합니다. 대표적인 시나리오는 다음과 같습니다.
- 고객 인사이트: 리뷰 텍스트 검색과 사용자 행동 분석을 결합하여 고객 요구와 만족도 추세를 정확하게 파악합니다.
- 스마트 제조: 생산 로그의 전문 검색, 설비 이미지 인식, IoT 지표 분석을 결합하여 고장을 예측하고 품질을 최적화합니다.
- 커넥티드 차량: 차량 텔레메트리 분석, 사용자 피드백 텍스트 마이닝, 주행 행동 벡터 검색을 결합하여 스마트 콕핏 경험을 개선합니다.
Doris에서 하이브리드 검색 및 분석 애플리케이션을 구축할 때의 이점은 다음과 같습니다.
- 통합 아키텍처: 데이터 마이그레이션이나 이기종 시스템 통합 없이 단일 플랫폼에서 정형 데이터 분석, 전문 검색, 벡터 검색을 처리합니다.
- 하이브리드 쿼리 성능: 하나의 SQL 문에서 벡터 유사도 검색, 키워드 필터링, 집계를 수행하며 뛰어난 쿼리 성능을 제공합니다.
- 유연한 스키마 지원: VARIANT 타입은 동적 JSON 구조를 기본으로 지원하며, Light Schema Change를 통해 필드와 인덱스를 수초 내에 변경할 수 있습니다.
- 전체 스택 최적화: 역색인과 벡터 인덱스부터 MPP 실행 엔진까지 전체 경로를 최적화하여 검색 정확도와 분석 효율성의 균형을 맞춥니다.
AI를 위한 Lakehouse
AI 모델과 애플리케이션을 개발하려면 대규모 데이터셋에서 학습 데이터셋을 준비하고, 피처 엔지니어링을 수행하며, 데이터 품질을 평가해야 합니다. 기존 아키텍처에서는 데이터 레이크와 분석 엔진 사이에 데이터를 자주 이동해야 하는 경우가 많습니다. Lakehouse 아키텍처는 데이터 레이크의 개방형 스토리지와 실시간 분석 엔진을 긴밀하게 통합하여, 통합 플랫폼에서 데이터 준비, 피처 엔지니어링, 모델 평가에 이르는 전체 워크플로를 지원합니다. 이를 통해 데이터 사일로를 해소하고 AI 개발의 반복 주기를 단축합니다.
아키텍처 특성:
- Lakehouse 통합: 개방형 데이터 레이크 테이블 포맷(예: Iceberg, Paimon)과 Catalog를 기반으로 개방형 Lakehouse를 구축하여 분석 데이터와 AI 데이터를 통합 관리합니다.
- 빠른 SQL 엔진: Doris는 대화형 쿼리와 경량 ETL을 지원하는 실시간 분석 엔진으로서, 데이터 준비와 피처 엔지니어링에 효율적인 SQL 연산 기능을 제공합니다.
- 원활한 데이터 흐름: 데이터를 이동하지 않고 데이터 레이크에서 직접 읽고 쓸 수 있습니다. 스토리지 계층은 통합 관리하고 컴퓨팅 계층은 유연한 가속 기능을 제공합니다.
AI 워크플로 전반의 가속화:
- 대규모 데이터 준비: PB 규모 데이터 레이크의 데이터를 효율적으로 필터링, 샘플링, 정제하여 고품질 학습 데이터셋을 빠르게 구축합니다.
- 실시간 피처 엔지니어링: 온라인으로 피처 추출, 변환, 집계를 수행하여 모델 학습과 추론에 실시간 피처 서비스를 제공합니다.
- 품질 평가: 테스트 데이터셋과 운영 데이터를 다차원으로 신속하게 분석하여 모델 성능과 데이터 드리프트를 지속적으로 모니터링합니다.
RAG(검색 증강 생성)
RAG는 외부 지식 베이스에서 관련 정보를 검색하여 대규모 언어 모델에 컨텍스트를 제공함으로써 모델의 환각 현상과 지식의 최신성 문제를 효과적으로 해결합니다. 벡터 엔진은 RAG 시스템의 핵심 구성 요소입니다. 빠른 응답을 제공하는 애플리케이션 경험을 보장하려면, 대규모 지식 베이스에서 관련성이 가장 높은 문서 조각을 빠르게 검색하면서 동시성이 높은 사용자 쿼리 요청도 처리해야 합니다.
대표적인 활용 사례:
- 기업 지식 베이스: 내부 문서와 매뉴얼을 기반으로 지능형 질의응답 시스템을 구축하여 직원이 자연어로 정확한 답변을 빠르게 얻을 수 있도록 합니다.
- 지능형 고객 서비스 어시스턴트: 제품 지식 베이스와 과거 사례를 결합하여 고객 상담원이나 챗봇에 정확한 답변 제안을 제공합니다.
- 지능형 문서 어시스턴트: 대규모 문서 모음에서 관련 내용을 빠르게 찾아 연구, 글쓰기, 의사결정을 지원합니다.
Doris에서 RAG를 구축할 때의 이점:
- 높은 동시성 성능: 분산 아키텍처가 높은 동시성의 벡터 검색을 지원하여 대규모 사용자의 동시 접근을 원활하게 처리합니다.
- 하이브리드 검색 기능: 하나의 SQL 문에서 벡터 유사도 검색과 키워드 필터링을 수행하여 시맨틱 검색의 재현율과 정확한 일치 검색 사이의 균형을 맞춥니다.
- 탄력적 확장: 클러스터가 커질수록 검색 성능이 선형적으로 확장되며, 수백만 개에서 수백억 개의 벡터까지 원활하게 확장할 수 있습니다.
- 통합 솔루션: 벡터 데이터, 원본 문서, 비즈니스 데이터를 통합 관리하여 RAG 애플리케이션의 데이터 아키텍처를 간소화합니다.
AI 관측 가능성
AI 모델의 반복 학습과 애플리케이션 실행 과정에서는 방대한 양의 로그, 지표, 추적 데이터가 생성됩니다. 문제를 정확히 찾아내고 성능을 지속적으로 최적화하기 위해 관측 가능성 시스템은 AI 인프라의 핵심 요소가 되었습니다. 비즈니스 규모가 커지면서 관측 가능성 플랫폼은 PB 규모 데이터를 높은 처리량으로 수집하고, 밀리초 수준으로 검색에 응답하며, 비용을 관리해야 하는 복합적인 과제에 직면하고 있습니다.
대표적인 사용 사례:
- 모델 학습 모니터링: 학습 지표와 리소스 사용량을 실시간으로 추적하여 학습 이상과 성능 병목을 빠르게 파악합니다.
- 추론 서비스 추적: 모든 추론 요청의 전체 호출 체인을 기록하여 지연 시간의 원인과 오류 패턴을 분석합니다.
- AI 애플리케이션 로그 분석: 방대한 애플리케이션 로그에 전문 검색과 집계를 수행하여 문제 해결과 행동 인사이트 도출을 지원합니다.
Doris에서 AI 관측 가능성 시스템을 구축할 때의 이점:
| 항목 | 기능 지표 |
|---|---|
| 데이터 수집 성능 | PB/day (10 GB/s)의 지속적인 데이터 수집을 지원하며, 역색인으로 로그 검색을 가속하여 초 단위 응답 제공 |
| 스토리지 비용 | 5:1~10:1의 압축률로 스토리지 비용을 50%-80% 절감하며, 콜드 데이터를 저비용으로 저장 |
| 스키마 유연성 | Light Schema Change로 필드를 수초 내에 변경할 수 있으며, VARIANT 타입이 동적 JSON을 기본으로 지원 |
| 생태계 호환성 | OpenTelemetry 및 ELK 생태계와 호환되며, Grafana와 Kibana 같은 시각화 도구와 통합 |
시맨틱 검색
시맨틱 검색은 벡터화를 통해 텍스트의 깊은 의미를 포착하여, 쿼리에 사용된 용어가 문서의 표현과 달라도 의미상 관련된 콘텐츠를 검색합니다. 이는 언어 간 검색, 동의어 인식, 의도 파악 등의 시나리오에서 핵심적인 역할을 하며 검색 재현율과 사용자 경험을 크게 개선합니다.
대표적인 사용 사례:
- 기업 문서 검색: 직원이 자연어로 질문을 설명하면 시스템이 의도를 파악하고 대규모 문서 저장소에서 의미상 관련된 정책, 프로세스, 지식을 검색합니다.
- 전자상거래 상품 검색: 사용자가 '여름에 신기 좋은 통기성 있는 신발'을 입력하면 시스템이 키워드 일치에만 의존하지 않고 요구를 이해하여 관련 상품을 검색합니다.
- 콘텐츠 추천 플랫폼: 기사와 동영상의 의미적 유사성을 기반으로 지능형 추천을 제공하여, 표현은 다르지만 사용자가 관심을 가질 만한 콘텐츠를 찾아 제시합니다.
Doris에서 시맨틱 검색을 구축할 때의 이점:
- 고성능 벡터 검색: HNSW 및 IVF 알고리즘을 지원하고 억 단위 벡터에서도 초 미만의 응답 시간을 제공하여 대규모 시맨틱 검색 요구를 원활하게 처리합니다.
- 하이브리드 검색 강화: 하나의 SQL 문에서 시맨틱 검색과 키워드 필터링을 결합하여 의미상 관련된 콘텐츠를 검색하면서 필수 키워드의 일치도 보장합니다.
- 멀티모달 확장: 텍스트뿐 아니라 이미지와 오디오 같은 멀티모달 콘텐츠의 시맨틱 검색도 지원합니다.
- 유연한 양자화 최적화: SQ/PQ 양자화 기법으로 검색 정확도를 유지하면서 스토리지 및 컴퓨팅 비용을 크게 줄입니다.