Flink Doris Connector
Flink Doris Connector는 Flink를 통해 Doris 클러스터의 데이터를 읽고 씁니다. 또한 Flink CDC와 통합되어 MySQL 등의 업스트림 데이터베이스 전체를 간편하게 동기화할 수 있습니다.
주요 기능은 다음과 같습니다.
- Doris 데이터 읽기: BE에서 병렬로 데이터를 읽어 읽기 효율을 높입니다.
- Doris 데이터 쓰기: Flink에서 데이터를 배치로 모은 다음 Stream Load를 통해 일괄 데이터 적재를 수행합니다.
- Lookup Join을 통한 차원 테이블 조인: 배치 처리와 비동기 쿼리로 차원 테이블 조인 속도를 높입니다.
- 데이터베이스 전체 동기화: Flink CDC를 사용하여 MySQL, Oracle, PostgreSQL 등의 데이터베이스 전체를 동기화하며, 자동 테이블 생성과 DDL 동기화를 지원합니다.
버전 안내
| Connector 버전 | Flink 버전 | Doris 버전 | Java 버전 | Scala 버전 |
|---|---|---|---|---|
| 1.0.3 | 1.11,1.12,1.13,1.14 | 0.15+ | 8 | 2.11,2.12 |
| 1.1.1 | 1.14 | 1.0+ | 8 | 2.11,2.12 |
| 1.2.1 | 1.15 | 1.0+ | 8 | - |
| 1.3.0 | 1.16 | 1.0+ | 8 | - |
| 1.4.0 | 1.15 - 1.17 | 1.0+ | 8 | - |
| 1.5.2 | 1.15 - 1.18 | 1.0+ | 8 | - |
| 1.6.1 | 1.15 - 1.19 | 1.0+ | 8 | - |
| 24.0.1 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 24.1.0 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 25.0.0 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 25.1.0 | 1.15 - 1.20 | 1.0+ | 8 | - |
| 26.0.0 | 1.15 - 1.20,2.0 - 2.2 | 1.0+ | 8(1.x),17(2.x) | - |
| 26.1.1 | 1.15 - 1.20,2.0 - 2.2 | 1.0+ | 8(1.x),17(2.x) | - |
설치
Jar 패키지 방식과 Maven 의존성 방식을 모두 지원합니다.
Jar 패키지 방식
Doris 다운로드 페이지에서 해당 버전의 Flink Doris Connector Jar 패키지를 다운로드하여 Flink의 classpath에 복사합니다.
- Standalone 모드: Jar 파일을
lib/디렉터리에 배치합니다. - Yarn 클러스터 모드: Jar 파일을 배포할 패키지에 미리 포함합니다.
Maven 의존성 방식
프로젝트의 pom.xml에 다음 의존성을 추가합니다.
<dependency>
    <groupId>org.apache.doris</groupId>
    <artifactId>flink-doris-connector-${flink.version}</artifactId>
    <version>${connector.version}</version>
</dependency>
예를 들면 다음과 같습니다.
<dependency>
    <groupId>org.apache.doris</groupId>
    <artifactId>flink-doris-connector-1.16</artifactId>
    <version>25.1.0</version>
</dependency>
동작 원리
읽기 동작 원리
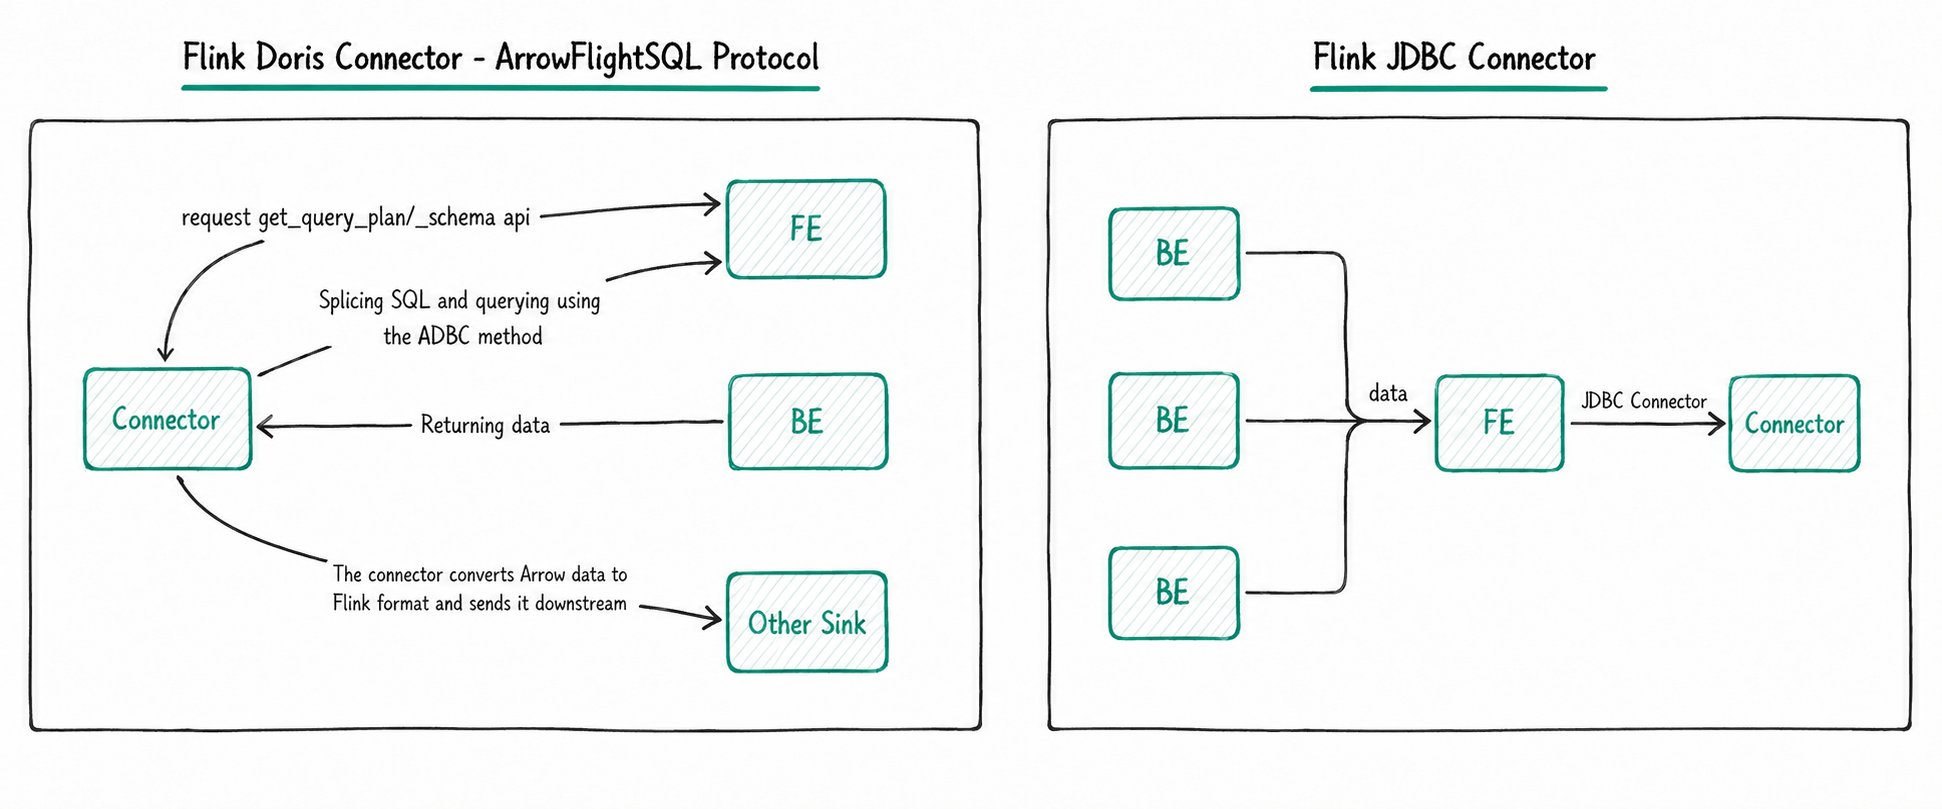
Flink Doris Connector는 Flink JDBC Connector보다 데이터 읽기 성능이 높으므로 사용을 권장합니다.
- Flink JDBC Connector: Doris는 MySQL 프로토콜과 호환되지만, JDBC를 통해 읽고 쓰면 단일 FE 노드에서 데이터를 순차적으로 읽고 쓰게 됩니다. 이로 인해 병목이 발생하여 성능에 영향을 주므로 권장하지 않습니다.
- Flink Doris Connector: Doris 2.1부터 ADBC 프로토콜을 기본 읽기 프로토콜로 사용합니다. 읽기 과정은 다음과 같습니다.
- Flink Doris Connector가 FE에서 쿼리 계획의 Tablet ID 정보를 가져옵니다.
- 쿼리 문
SELECT * FROM tbs TABLET(id1, id2, id3)을 생성합니다. - FE의 ADBC 포트를 통해 쿼리를 실행합니다.
- BE가 데이터를 직접 반환하므로 데이터가 FE를 거치지 않아 FE의 단일 지점 병목이 해소됩니다.
쓰기 동작 원리
데이터를 쓸 때 Flink Doris Connector는 Flink 메모리에서 데이터를 배치로 모은 다음 Stream Load를 통해 Doris에 일괄 데이터 적재를 수행합니다. Connector는 두 가지 배치 처리 모드를 제공하며, 기본값은 Flink Checkpoint 기반의 스트리밍 쓰기입니다.
| 비교 항목 | 스트리밍 쓰기 | 배치 쓰기 |
|---|---|---|
| 실행 조건 | Flink Checkpoint에 의존하며, 각 Checkpoint 주기마다 Doris에 데이터를 씁니다. | Connector 내부의 시간 및 데이터량 임계값에 따라 주기적으로 커밋합니다. |
| 일관성 | Exactly-Once | At-Least-Once. 기본 키 모델을 사용하면 Exactly-Once를 보장할 수 있습니다. |
| 지연 시간 | Checkpoint 간격의 제약을 받아 일반적으로 더 깁니다. | 독립적인 배치 처리 메커니즘으로 유연하게 조정할 수 있습니다. |
| 장애 허용 및 복구 | Flink 상태 복구와 완전히 일치합니다. | 외부 중복 제거 로직에 의존합니다. 예를 들어 Doris 기본 키 중복 제거를 사용할 수 있습니다. |
빠른 시작
이 섹션에서는 Flink 클러스터 배포부터 FlinkSQL을 사용한 Doris 데이터 읽기와 쓰기까지 전체 예제를 살펴봅니다.
1. Flink 클러스터 배포
Standalone 클러스터를 예로 들어 설명합니다.
- Flink 1.18.1 설치 패키지를 다운로드합니다.
- 압축을 푼 후 Flink Doris Connector Jar 패키지를
<FLINK_HOME>/lib에 배치합니다. <FLINK_HOME>디렉터리로 이동하여bin/start-cluster.sh를 실행하고 Flink 클러스터를 시작합니다.jps명령을 사용하여 Flink 클러스터가 정상적으로 시작되었는지 확인합니다.
2. Doris 테이블 초기화
다음 SQL을 실행하여 Doris 테이블을 생성하고 테스트 데이터를 씁니다.
CREATE DATABASE test;

CREATE TABLE test.student (
    `id` INT,
    `name` VARCHAR(256),
    `age` INT
)
UNIQUE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_allocation" = "tag.location.default: 3"
);

INSERT INTO test.student values(1, "James", 18);
INSERT INTO test.student values(2, "Emily", 28);

CREATE TABLE test.student_trans (
    `id` INT,
    `name` VARCHAR(256),
    `age` INT
)
UNIQUE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_allocation" = "tag.location.default: 3"
);
3. FlinkSQL 작업 실행
FlinkSQL Client를 시작합니다.
bin/sql-client.sh
다음 FlinkSQL을 실행합니다.
CREATE TABLE Student (
    id STRING,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'test.student',
    'username' = 'root',
    'password' = ''
);

CREATE TABLE StudentTrans (
    id STRING,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'test.student_trans',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'doris_label'
);

INSERT INTO StudentTrans SELECT id, concat('prefix_', name), age + 1 FROM Student;
4. 결과 조회
mysql> select * from test.student_trans;
+------+--------------+------+
| id   | name         | age  |
+------+--------------+------+
|    1 | prefix_James |   19 |
|    2 | prefix_Emily |   29 |
+------+--------------+------+
2 rows in set (0.02 sec)
사용 사례
사례 1: Doris 데이터 읽기
Flink에서 Doris 데이터를 읽을 때 Doris Source는 유한 스트림이며, CDC를 통한 연속 읽기를 지원하지 않습니다. 다음 두 가지 읽기 프로토콜을 지원합니다.
| 프로토콜 | 설명 | 권장 버전 |
|---|---|---|
| Thrift | BE의 thrift 인터페이스를 호출하여 데이터를 읽습니다. | 모든 버전과 호환 |
| ArrowFlightSQL | Doris 2.1을 기반으로 Arrow Flight SQL 프로토콜을 통해 대량의 데이터를 고속으로 읽습니다. | Connector 24.0.0+ |
- Thrift 처리 과정에 대한 자세한 내용은 Thrift 인터페이스를 통한 데이터 읽기를 참조하세요.
- ArrowFlightSQL 사용법에 대한 자세한 내용은 Arrow Flight SQL 기반 고속 데이터 전송 경로를 참조하세요. Doris 2.1 이후에는 ArrowFlightSQL 방식의 사용을 권장합니다.
FlinkSQL 읽기(Thrift 방식)
CREATE TABLE student (
    id INT,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',  -- FE host:HttpPort
    'table.identifier' = 'test.student',
    'username' = 'root',
    'password' = ''
);

SELECT * FROM student;
FlinkSQL 읽기(ArrowFlightSQL 방식)
CREATE TABLE student (
    id INT,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '{fe.conf:http_port}',
    'table.identifier' = 'test.student',
    'source.use-flight-sql' = 'true',
    'source.flight-sql-port' = '{fe.conf:arrow_flight_sql_port}',
    'username' = 'root',
    'password' = ''
);

SELECT * FROM student;
DataStream API로 읽기
DataStream API로 데이터를 읽으려면 프로젝트의 POM 파일에 의존성을 미리 추가해야 합니다. 설치 섹션을 참조하세요.
final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
DorisOptions option = DorisOptions.builder()
        .setFenodes("127.0.0.1:8030")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("")
        .build();

DorisReadOptions readOptions = DorisReadOptions.builder().build();
DorisSource<List<?>> dorisSource = DorisSource.<List<?>>builder()
        .setDorisOptions(option)
        .setDorisReadOptions(readOptions)
        .setDeserializer(new SimpleListDeserializationSchema())
        .build();

env.fromSource(dorisSource, WatermarkStrategy.noWatermarks(), "doris source").print();
env.execute("Doris Source Test");
사례 2: Doris 데이터 쓰기
Flink는 Stream Load를 통해 Doris에 데이터를 쓰며, 스트리밍 쓰기와 배치 쓰기의 두 가지 모드를 지원합니다.
배치 쓰기는 Connector 1.5.0 이후에 지원됩니다. 배치 쓰기는 Checkpoint에 의존하지 않으며, 데이터를 메모리에 캐시하고 배치 처리 매개변수에 따라 쓰기 시점을 제어합니다. 스트리밍 쓰기는 Checkpoint를 활성화해야 하며, 데이터를 항상 메모리에 캐시해 두지 않고 Checkpoint 전체 주기 동안 업스트림 데이터를 Doris에 지속적으로 씁니다.
FlinkSQL 쓰기
Flink의 Datagen을 사용하여 업스트림에서 지속적으로 생성되는 데이터를 시뮬레이션합니다.
-- Enable checkpoint
SET 'execution.checkpointing.interval' = '30s';

CREATE TABLE student_source (
    id INT,
    name STRING,
    age INT
) WITH (
    'connector' = 'datagen',
    'rows-per-second' = '1',
    'fields.name.length' = '20',
    'fields.id.min' = '1',
    'fields.id.max' = '100000',
    'fields.age.min' = '3',
    'fields.age.max' = '30'
);

-- doris sink
CREATE TABLE student_sink (
    id INT,
    name STRING,
    age INT
)
WITH (
    'connector' = 'doris',
    'fenodes' = '10.16.10.6:28737',
    'table.identifier' = 'test.student',
    'username' = 'root',
    'password' = 'password',
    'sink.label-prefix' = 'doris_label'
    -- 'sink.enable.batch-mode' = 'true'  Add this configuration to use batch write
);

INSERT INTO student_sink SELECT * FROM student_source;
DataStream API로 쓰기
DataStream API로 데이터를 쓸 때는 다양한 직렬화 방식을 사용하여 업스트림 데이터를 Doris 테이블에 쓸 수 있습니다.
Connector에는 HttpClient 버전 4.5.13이 내부적으로 포함되어 있습니다. 프로젝트에서 HttpClient를 별도로 참조한다면 버전이 일치하는지 확인하세요.
일반 문자열 형식
업스트림 데이터가 csv 또는 json 형식이면 SimpleStringSerializer를 직접 사용하여 데이터를 직렬화할 수 있습니다.
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.enableCheckpointing(30000);
DorisSink.Builder<String> builder = DorisSink.builder();

DorisOptions dorisOptions = DorisOptions.builder()
        .setFenodes("10.16.10.6:28737")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("")
        .build();

Properties properties = new Properties();
// When upstream is json data, the following configuration is required
properties.setProperty("read_json_by_line", "true");
properties.setProperty("format", "json");

// When upstream is csv, the following configuration is required
// properties.setProperty("format", "csv");
// properties.setProperty("column_separator", ",");

DorisExecutionOptions executionOptions = DorisExecutionOptions.builder()
        .setLabelPrefix("label-doris")
        .setDeletable(false)
        // .setBatchMode(true)  Enable batch write
        .setStreamLoadProp(properties)
        .build();

builder.setDorisReadOptions(DorisReadOptions.builder().build())
        .setDorisExecutionOptions(executionOptions)
        .setSerializer(new SimpleStringSerializer())
        .setDorisOptions(dorisOptions);

List<String> data = new ArrayList<>();
data.add("{\"id\":3,\"name\":\"Michael\",\"age\":28}");
data.add("{\"id\":4,\"name\":\"David\",\"age\":38}");

env.fromCollection(data).sinkTo(builder.build());
env.execute("doris test");
RowData 형식
RowData는 Flink 내부 형식입니다. 업스트림에서 RowData 형식으로 데이터를 전달하면 RowDataSerializer를 사용하여 데이터를 직렬화해야 합니다.
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.enableCheckpointing(10000);
env.setParallelism(1);

DorisSink.Builder<RowData> builder = DorisSink.builder();

Properties properties = new Properties();
properties.setProperty("column_separator", ",");
properties.setProperty("line_delimiter", "\n");
properties.setProperty("format", "csv");
// When upstream is json, the following configuration is required
// properties.setProperty("read_json_by_line", "true");
// properties.setProperty("format", "json");
DorisOptions.Builder dorisBuilder = DorisOptions.builder();
dorisBuilder
        .setFenodes("10.16.10.6:28737")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("");
DorisExecutionOptions.Builder executionBuilder = DorisExecutionOptions.builder();
executionBuilder.setLabelPrefix(UUID.randomUUID().toString()).setDeletable(false).setStreamLoadProp(properties);

// flink rowdata's schema
String[] fields = {"id", "name", "age"};
DataType[] types = {DataTypes.INT(), DataTypes.VARCHAR(256), DataTypes.INT()};

builder.setDorisExecutionOptions(executionBuilder.build())
        .setSerializer(
                RowDataSerializer.builder() // serialize according to rowdata
                        .setType(LoadConstants.CSV)
                        .setFieldDelimiter(",")
                        .setFieldNames(fields)
                        .setFieldType(types)
                        .build())
        .setDorisOptions(dorisBuilder.build());

// mock rowdata source
DataStream<RowData> source =
        env.fromElements("")
                .flatMap(
                        new FlatMapFunction<String, RowData>() {
                            @Override
                            public void flatMap(String s, Collector<RowData> out)
                                    throws Exception {
                                GenericRowData genericRowData = new GenericRowData(3);
                                genericRowData.setField(0, 1);
                                genericRowData.setField(1, StringData.fromString("Michael"));
                                genericRowData.setField(2, 18);
                                out.collect(genericRowData);

                                GenericRowData genericRowData2 = new GenericRowData(3);
                                genericRowData2.setField(0, 2);
                                genericRowData2.setField(1, StringData.fromString("David"));
                                genericRowData2.setField(2, 38);
                                out.collect(genericRowData2);
                            }
                        });

source.sinkTo(builder.build());
env.execute("doris test");
Debezium 형식
업스트림에서 전달되는 Debezium 형식의 데이터(예: Flink CDC 데이터 또는 Kafka의 Debezium 형식 데이터)는 JsonDebeziumSchemaSerializer를 사용하여 직렬화합니다.
// Enable checkpoint
env.enableCheckpointing(10000);

Properties props = new Properties();
props.setProperty("format", "json");
props.setProperty("read_json_by_line", "true");
DorisOptions dorisOptions = DorisOptions.builder()
        .setFenodes("127.0.0.1:8030")
        .setTableIdentifier("test.student")
        .setUsername("root")
        .setPassword("").build();

DorisExecutionOptions.Builder executionBuilder = DorisExecutionOptions.builder();
executionBuilder.setLabelPrefix("label-prefix")
        .setStreamLoadProp(props)
        .setDeletable(true);

DorisSink.Builder<String> builder = DorisSink.builder();
builder.setDorisReadOptions(DorisReadOptions.builder().build())
        .setDorisExecutionOptions(executionBuilder.build())
        .setDorisOptions(dorisOptions)
        .setSerializer(JsonDebeziumSchemaSerializer.builder().setDorisOptions(dorisOptions).build());

env.fromSource(mySqlSource, WatermarkStrategy.noWatermarks(), "MySQL Source")
        .sinkTo(builder.build());
여러 테이블 쓰기 형식
DorisSink는 단일 Sink로 여러 테이블을 동기화할 수 있습니다. 데이터와 함께 데이터베이스 및 테이블 정보를 Sink에 전달하고, RecordWithMetaSerializer를 사용하여 직렬화해야 합니다.
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.setParallelism(1);
DorisSink.Builder<RecordWithMeta> builder = DorisSink.builder();
Properties properties = new Properties();
properties.setProperty("column_separator", ",");
properties.setProperty("line_delimiter", "\n");
properties.setProperty("format", "csv");
DorisOptions.Builder dorisBuilder = DorisOptions.builder();
dorisBuilder
        .setFenodes("10.16.10.6:28737")
        .setTableIdentifier("")
        .setUsername("root")
        .setPassword("");

DorisExecutionOptions.Builder executionBuilder = DorisExecutionOptions.builder();

executionBuilder
        .setLabelPrefix("label-doris")
        .setStreamLoadProp(properties)
        .setDeletable(false)
        .setBatchMode(true);

builder.setDorisReadOptions(DorisReadOptions.builder().build())
        .setDorisExecutionOptions(executionBuilder.build())
        .setDorisOptions(dorisBuilder.build())
        .setSerializer(new RecordWithMetaSerializer());

RecordWithMeta record = new RecordWithMeta("test", "student_1", "1,David,18");
RecordWithMeta record1 = new RecordWithMeta("test", "student_2", "1,Jack,28");
env.fromCollection(Arrays.asList(record, record1)).sinkTo(builder.build());
사례 3: Lookup Join을 통한 차원 테이블 조인
Lookup Join은 Flink의 차원 테이블 조인 성능을 최적화할 수 있습니다. Flink JDBC Connector를 사용하여 차원 테이블을 조인할 때는 다음 문제가 발생할 수 있습니다.
- Flink JDBC Connector는 동기 쿼리 모드를 사용합니다. Kafka 등의 업스트림에서 레코드를 보낼 때마다 즉시 Doris 차원 테이블을 쿼리하므로 동시성이 높은 환경에서는 쿼리 지연 시간이 길어집니다.
- JDBC로 실행하는 쿼리는 일반적으로 레코드를 하나씩 조회하는 포인트 쿼리입니다. 반면 Doris는 쿼리 효율을 높이기 위해 배치 쿼리를 권장합니다.
Flink Doris Connector에서 Lookup Join을 사용하면 다음과 같은 이점이 있습니다.
- 업스트림 데이터를 배치로 캐시하여 레코드별 쿼리로 인한 긴 지연 시간과 데이터베이스 부하를 줄입니다.
- 조인 쿼리를 비동기로 실행하여 데이터 처리량을 높이고 Doris 쿼리 부하를 줄입니다.
CREATE TABLE fact_table (
    `id` BIGINT,
    `name` STRING,
    `city` STRING,
    `process_time` as proctime()
) WITH (
    'connector' = 'kafka',
    ...
);

create table dim_city(
    `city` STRING,
    `level` INT,
    `province` STRING,
    `country` STRING
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'jdbc-url' = 'jdbc:mysql://127.0.0.1:9030',
    'table.identifier' = 'dim.dim_city',
    'username' = 'root',
    'password' = '',
    'lookup.cache.max-rows' = '100000',
    'lookup.cache.ttl' = '300s'
);

SELECT a.id, a.name, a.city, c.province, c.country, c.level
FROM fact_table a
LEFT JOIN dim_city FOR SYSTEM_TIME AS OF a.process_time AS c
ON a.city = c.city
사례 4: CDC를 통한 데이터베이스 전체 동기화
Flink Doris Connector는 Flink CDC와 통합되어 MySQL 등의 관계형 데이터베이스를 Doris로 간편하게 동기화할 수 있으며, 자동 테이블 생성, Schema Change 등을 지원합니다. 현재 지원하는 데이터베이스는 MySQL, Oracle, PostgreSQL, SQLServer, MongoDB, DB2입니다.
- 데이터베이스 전체 동기화를 사용하려면 해당 Flink CDC 의존성(Fat Jar)을
$FLINK_HOME/lib에 추가해야 합니다. 예를 들어flink-sql-connector-mysql-cdc-${version}.jar또는flink-sql-connector-oracle-cdc-${version}.jar를 추가합니다. Flink CDC는 3.1부터 이전 버전과 호환되지 않습니다. 다운로드 위치: Flink CDC 3.x, Flink CDC 2.x. - Connector 24.0.0 이후에는 의존하는 Flink CDC 버전이 3.1 이상이어야 합니다. 다운로드 위치. Flink CDC로 MySQL과 Oracle을 동기화하려면 관련 JDBC 드라이버도
$FLINK_HOME/lib에 추가해야 합니다.
Flink 클러스터가 시작되면 데이터 소스 유형에 맞는 명령을 실행할 수 있습니다.
MySQL 데이터베이스 전체 동기화
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.16-24.0.1.jar \
    mysql-sync-database \
    --database test_db \
    --mysql-conf hostname=127.0.0.1 \
    --mysql-conf port=3306 \
    --mysql-conf username=root \
    --mysql-conf password=123456 \
    --mysql-conf database-name=mysql_db \
    --including-tables "tbl1|test.*" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=123456 \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
Oracle 데이터베이스 전체 동기화
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.16-24.0.1.jar \
    oracle-sync-database \
    --database test_db \
    --oracle-conf hostname=127.0.0.1 \
    --oracle-conf port=1521 \
    --oracle-conf username=admin \
    --oracle-conf password="password" \
    --oracle-conf database-name=XE \
    --oracle-conf schema-name=ADMIN \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=\
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
PostgreSQL 데이터베이스 전체 동기화
<FLINK_HOME>/bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.16-24.0.1.jar \
    postgres-sync-database \
    --database db1 \
    --postgres-conf hostname=127.0.0.1 \
    --postgres-conf port=5432 \
    --postgres-conf username=postgres \
    --postgres-conf password="123456" \
    --postgres-conf database-name=postgres \
    --postgres-conf schema-name=public \
    --postgres-conf slot.name=test \
    --postgres-conf decoding.plugin.name=pgoutput \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=\
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
SQLServer 데이터베이스 전체 동기화
<FLINK_HOME>/bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.16-24.0.1.jar \
    sqlserver-sync-database \
    --database db1 \
    --sqlserver-conf hostname=127.0.0.1 \
    --sqlserver-conf port=1433 \
    --sqlserver-conf username=sa \
    --sqlserver-conf password="123456" \
    --sqlserver-conf database-name=CDC_DB \
    --sqlserver-conf schema-name=dbo \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=\
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
DB2 데이터베이스 전체 동기화
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.16-24.0.1.jar \
    db2-sync-database \
    --database db2_test \
    --db2-conf hostname=127.0.0.1 \
    --db2-conf port=50000 \
    --db2-conf username=db2inst1 \
    --db2-conf password=doris123456 \
    --db2-conf database-name=testdb \
    --db2-conf schema-name=DB2INST1 \
    --including-tables "FULL_TYPES|CUSTOMERS" \
    --single-sink true \
    --use-new-schema-change true \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password=123456 \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
MongoDB 데이터베이스 전체 동기화
<FLINK_HOME>/bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    ./lib/flink-doris-connector-1.18-24.0.1.jar \
    mongodb-sync-database \
    --database doris_db \
    --schema-change-mode debezium_structure \
    --mongodb-conf hosts=127.0.0.1:27017 \
    --mongodb-conf username=flinkuser \
    --mongodb-conf password=flinkpwd \
    --mongodb-conf database=test \
    --mongodb-conf scan.startup.mode=initial \
    --mongodb-conf schema.sample-percent=0.2 \
    --including-tables "tbl1|tbl2" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password= \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --sink-conf sink.enable-2pc=false \
    --table-conf replication_num=1
AWS Aurora MySQL 데이터베이스 전체 동기화
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.18-25.0.0.jar \
    mysql-sync-database \
    --database testwd \
    --mysql-conf hostname=xxx.us-east-1.rds.amazonaws.com \
    --mysql-conf port=3306 \
    --mysql-conf username=admin \
    --mysql-conf password=123456 \
    --mysql-conf database-name=test \
    --mysql-conf server-time-zone=UTC \
    --including-tables "student" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password= \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
AWS RDS MySQL 데이터베이스 전체 동기화
<FLINK_HOME>bin/flink run \
    -Dexecution.checkpointing.interval=10s \
    -Dparallelism.default=1 \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.18-25.0.0.jar \
    mysql-sync-database \
    --database testwd \
    --mysql-conf hostname=xxx.ap-southeast-1.rds.amazonaws.com \
    --mysql-conf port=3306 \
    --mysql-conf username=admin \
    --mysql-conf password=123456 \
    --mysql-conf database-name=test \
    --mysql-conf server-time-zone=UTC \
    --including-tables "student" \
    --sink-conf fenodes=127.0.0.1:8030 \
    --sink-conf username=root \
    --sink-conf password= \
    --sink-conf jdbc-url=jdbc:mysql://127.0.0.1:9030 \
    --sink-conf sink.label-prefix=label \
    --table-conf replication_num=1
구성 참조
공통 구성
| 키 | 기본값 | 필수 | 설명 |
|---|---|---|---|
| fenodes | -- | Y | Doris FE http 주소. 여러 주소를 쉼표로 구분하여 지정할 수 있습니다. |
| benodes | -- | N | Doris BE http 주소. 여러 주소를 쉼표로 구분하여 지정할 수 있습니다. |
| jdbc-url | -- | N | jdbc 연결 정보. 예: jdbc:mysql://127.0.0.1:9030 |
| table.identifier | -- | Y | Doris 테이블 이름. 예: db.tbl |
| username | -- | Y | Doris에 접근하기 위한 사용자 이름 |
| password | -- | Y | Doris에 접근하기 위한 비밀번호 |
| auto-redirect | TRUE | N | Stream Load 요청을 리디렉션할지 여부. 활성화하면 BE 정보를 명시적으로 가져오지 않고 FE를 통해 Stream Load 쓰기를 수행합니다. |
| doris.request.retries | 3 | N | Doris로 요청을 보낼 때의 재시도 횟수 |
| doris.request.connect.timeout | 30s | N | Doris로 요청을 보낼 때의 연결 제한 시간 |
| doris.request.read.timeout | 30s | N | Doris로 요청을 보낼 때의 읽기 제한 시간 |
Source 구성
| 키 | 기본값 | 필수 | 설명 |
|---|---|---|---|
| doris.request.query.timeout | 21600s | N | Doris 쿼리 제한 시간. 기본값은 6시간입니다. |
| doris.request.tablet.size | 1 | N | 하나의 Partition에 대응하는 Doris Tablet 수. 이 값을 작게 설정할수록 더 많은 Partition이 생성되어 Flink 측 병렬성이 높아지지만, Doris에 가해지는 부하도 커집니다. |
| doris.batch.size | 4064 | N | BE에서 한 번에 읽는 최대 행 수. 이 값을 늘리면 Flink와 Doris 사이에 설정되는 연결 수를 줄여 네트워크 지연으로 인한 추가 시간 오버헤드를 줄일 수 있습니다. |
| doris.exec.mem.limit | 8192mb | N | 단일 쿼리의 메모리 한도. 기본값은 8GB이며, 단위는 바이트입니다. |
| source.use-flight-sql | TRUE | N | 읽기에 Arrow Flight SQL을 사용할지 여부 |
| source.flight-sql-port | - | N | Arrow Flight SQL로 읽을 때 사용하는 FE의 arrow_flight_sql_port |
DataStream 전용 구성
| 키 | 기본값 | 필수 | 설명 |
|---|---|---|---|
| doris.read.field | -- | N | Doris 테이블에서 읽을 컬럼 이름 목록. 쉼표로 구분합니다. |
| doris.filter.query | -- | N | 읽을 데이터를 필터링하는 표현식. 이 표현식은 Doris에 그대로 전달되며, Doris는 이를 사용하여 소스에서 데이터를 필터링합니다. 예: age=18. |
Sink 구성
| 키 | 기본값 | 필수 | 설명 |
|---|---|---|---|
| sink.label-prefix | -- | Y | Stream Load 데이터 적재에 사용하는 label 접두사. 2pc를 사용하는 경우 Flink의 EOS 의미론을 보장하려면 전역적으로 고유해야 합니다. |
| sink.properties.* | -- | N | Stream Load 데이터 적재 매개변수. 예를 들어 'sink.properties.column_separator' = ', '는 컬럼 구분자를 정의합니다. 'sink.properties.escape_delimiters' = 'true'는 특수 문자를 구분자로 사용함을 나타내며, \x01은 바이너리 0x01로 변환됩니다. JSON 형식 데이터 적재에는 'sink.properties.format' = 'json', 'sink.properties.read_json_by_line' = 'true'를 사용합니다. 자세한 매개변수는 Stream Load를 참조하세요. Group Commit 모드: 'sink.properties.group_commit' = 'sync_mode'는 group commit을 동기 모드로 설정합니다. Flink Connector는 1.6.2부터 데이터 적재에 group commit을 설정할 수 있습니다. 자세한 사용법과 제한 사항은 Group Commit을 참조하세요. 26.1.0부터 Stream Load에 gz 압축이 기본적으로 활성화되며, 'sink.properties.compress_type' = ''로 설정하여 비활성화할 수 있습니다. |
| sink.enable-delete | TRUE | N | 삭제를 활성화할지 여부. 이 옵션을 사용하려면 Doris 테이블에서 배치 삭제가 활성화되어 있어야 하며(Doris 0.15+에서는 기본적으로 활성화됨), Unique 모델만 지원합니다. |
| sink.enable-2pc | TRUE | N | 이단계 커밋(2pc)을 활성화할지 여부. 기본값은 true이며, Exactly-Once 의미론을 보장합니다. 이단계 커밋에 대한 자세한 내용은 Stream Load 2PC를 참조하세요. |
| sink.buffer-size | 1MB | N | 쓰기 데이터 캐시의 버퍼 크기. 단위는 바이트입니다. 기본 구성으로 충분하므로 변경을 권장하지 않습니다. |
| sink.buffer-count | 3 | N | 쓰기 데이터 캐시 버퍼 수. 기본 구성으로 충분하므로 변경을 권장하지 않습니다. |
| sink.max-retries | 3 | N | Commit 실패 후 최대 재시도 횟수. 기본값은 3입니다. |
| sink.enable.batch-mode | FALSE | N | 배치 모드를 사용하여 Doris에 쓸지 여부. 활성화하면 쓰기 시점이 Checkpoint에 의존하지 않고 sink.buffer-flush.max-rows, sink.buffer-flush.max-bytes, sink.buffer-flush.interval 매개변수로 제어됩니다. 활성화한 후에는 Exactly-Once 의미론이 더 이상 보장되지 않습니다. Unique 모델을 사용하여 멱등성을 구현할 수 있습니다. |
| sink.flush.queue-size | 2 | N | 배치 모드에서의 캐시 큐 크기 |
| sink.buffer-flush.max-rows | 500000 | N | 배치 모드에서 단일 배치로 쓰는 최대 행 수 |
| sink.buffer-flush.max-bytes | 100MB | N | 배치 모드에서 단일 배치로 쓰는 최대 바이트 수 |
| sink.buffer-flush.interval | 10s | N | 배치 모드에서 캐시를 비동기로 플러시하는 간격 |
| sink.ignore.update-before | TRUE | N | update-before 이벤트를 무시할지 여부. 기본적으로 무시합니다. |
Lookup Join 구성
| 키 | 기본값 | 필수 | 설명 |
|---|---|---|---|
| lookup.cache.max-rows | -1 | N | lookup에서 캐시하는 최대 행 수. 기본값은 -1이며, 캐시를 비활성화한다는 의미입니다. |
| lookup.cache.ttl | 10s | N | lookup의 최대 캐시 유지 시간. 기본값은 10s입니다. |
| lookup.max-retries | 1 | N | lookup 쿼리 실패 후 재시도 횟수 |
| lookup.jdbc.async | FALSE | N | 비동기 lookup을 활성화할지 여부. 기본값은 false입니다. |
| lookup.jdbc.read.batch.size | 128 | N | 비동기 lookup에서 쿼리당 최대 배치 크기 |
| lookup.jdbc.read.batch.queue-size | 256 | N | 비동기 lookup에서 중간 버퍼 큐의 크기 |
| lookup.jdbc.read.thread-size | 3 | N | 각 작업에서 lookup에 사용하는 jdbc 스레드 수 |
데이터베이스 전체 동기화 구성
구문
<FLINK_HOME>bin/flink run \
    -c org.apache.doris.flink.tools.cdc.CdcTools \
    lib/flink-doris-connector-1.16-1.6.1.jar \
    <mysql-sync-database|oracle-sync-database|postgres-sync-database|sqlserver-sync-database|mongodb-sync-database> \
    --database <doris-database-name> \
    [--job-name <flink-job-name>] \
    [--table-prefix <doris-table-prefix>] \
    [--table-suffix <doris-table-suffix>] \
    [--including-tables <mysql-table-name|name-regular-expr>] \
    [--excluding-tables <mysql-table-name|name-regular-expr>] \
    --mysql-conf <mysql-cdc-source-conf> [--mysql-conf <mysql-cdc-source-conf> ...] \
    --oracle-conf <oracle-cdc-source-conf> [--oracle-conf <oracle-cdc-source-conf> ...] \
    --postgres-conf <postgres-cdc-source-conf> [--postgres-conf <postgres-cdc-source-conf> ...] \
    --sqlserver-conf <sqlserver-cdc-source-conf> [--sqlserver-conf <sqlserver-cdc-source-conf> ...] \
    --sink-conf <doris-sink-conf> [--table-conf <doris-sink-conf> ...] \
    [--table-conf <doris-table-conf> [--table-conf <doris-table-conf> ...]]
구성 항목
| 키 | 설명 |
|---|---|
| --job-name | Flink 작업 이름. 선택 사항입니다. |
| --database | Doris로 동기화할 데이터베이스의 이름 |
| --table-prefix | Doris 테이블 접두사. 예: --table-prefix ods_. |
| --table-suffix | 위와 동일한 방식으로 지정하는 Doris 테이블 접미사 |
| --including-tables | 동기화할 MySQL 테이블. 여러 테이블은 |로 구분할 수 있으며 정규 표현식을 지원합니다. 예: --including-tables table1. |
| --excluding-tables | 동기화하지 않을 테이블. 사용법은 위와 같습니다. |
| --mysql-conf | MySQL CDCSource 구성. 예: --mysql-conf hostname=127.0.0.1. 전체 구성은 MySQL CDC를 참조하세요. hostname/username/password/database-name은 필수입니다. 동기화할 데이터베이스/테이블에 기본 키가 없는 테이블이 포함되어 있으면 scan.incremental.snapshot.chunk.key-column을 설정해야 하며, null이 아닌 단일 필드만 선택할 수 있습니다. 예: scan.incremental.snapshot.chunk.key-column=database.table:column,database.table1:column.... 서로 다른 데이터베이스/테이블의 컬럼은 쉼표로 구분합니다. |
| --oracle-conf | Oracle CDCSource 구성. 예: --oracle-conf hostname=127.0.0.1. 전체 구성은 Oracle CDC를 참조하세요. hostname/username/password/database-name/schema-name은 필수입니다. |
| --postgres-conf | Postgres CDCSource 구성. 예: --postgres-conf hostname=127.0.0.1. 전체 구성은 Postgres CDC를 참조하세요. hostname/username/password/database-name/schema-name/slot.name은 필수입니다. |
| --sqlserver-conf | SQLServer CDCSource 구성. 예: --sqlserver-conf hostname=127.0.0.1. 전체 구성은 SQLServer CDC를 참조하세요. hostname/username/password/database-name/schema-name은 필수입니다. |
| --db2-conf | DB2 CDCSource 구성. 예: --db2-conf hostname=127.0.0.1. 전체 구성은 DB2 CDC를 참조하세요. hostname/username/password/database-name/schema-name은 필수입니다. |
| --mongodb-conf | MongoDB CDCSource 구성. 예: --mongodb-conf hosts=127.0.0.1:27017. 전체 구성은 Mongo CDC를 참조하세요. hosts/username/password/database는 필수입니다. --mongodb-conf schema.sample-percent는 Doris 테이블을 생성하기 위해 MongoDB 데이터를 자동으로 샘플링하는 구성으로, 기본값은 0.2입니다. |
| --sink-conf | Doris Sink의 모든 구성. 전체 구성 항목은 Sink 구성을 참조하세요. |
| --table-conf | Doris 테이블의 구성 항목으로, properties에 포함되는 내용입니다. 단, table-buckets는 properties 속성이 아닙니다. 예를 들어 --table-conf replication_num=1을 사용할 수 있습니다. --table-conf table-buckets="tbl1:10,tbl2:20,a.*:30,b.*:40,.*:50"은 정규 표현식 순서에 따라 각 테이블의 버킷 수를 지정합니다. 일치하는 항목이 없으면 BUCKETS AUTO를 사용하여 테이블을 생성합니다. |
| --schema-change-mode | 스키마 변경 사항의 파싱 모드. debezium_structure와 sql_parser의 두 가지 파싱 모드를 지원합니다. 기본값은 debezium_structure입니다. debezium_structure는 업스트림 CDC 데이터를 동기화할 때 사용하는 데이터 구조를 파싱하여 DDL 변경 작업을 판단합니다. sql_parser는 업스트림 CDC 데이터를 동기화할 때 DDL 문을 파싱하여 DDL 변경 작업을 판단하므로 더 정확합니다. 사용 예: --schema-change-mode debezium_structure. Connector 24.0.0 이후에 지원됩니다. |
| --single-sink | 단일 Sink로 모든 테이블을 동기화할지 여부. 활성화하면 업스트림에서 새로 생성한 테이블도 자동으로 감지하고 테이블을 자동으로 생성합니다. |
| --multi-to-one-origin | 여러 업스트림 테이블을 동일한 테이블에 쓸 때 사용하는 소스 테이블 구성. 예: --multi-to-one-origin "a_.*|b_.*". 자세한 내용은 #208을 참조하세요. |
| --multi-to-one-target | --multi-to-one-origin과 함께 사용하는 대상 테이블 구성. 예: --multi-to-one-target "a|b". |
| --create-table-only | 테이블 구조만 동기화할지 여부 |
데이터 타입 매핑
Doris에서 Flink로
| Doris 타입 | Flink 타입 |
|---|---|
| NULL_TYPE | NULL |
| BOOLEAN | BOOLEAN |
| TINYINT | TINYINT |
| SMALLINT | SMALLINT |
| INT | INT |
| BIGINT | BIGINT |
| FLOAT | FLOAT |
| DOUBLE | DOUBLE |
| DATE | DATE |
| DATETIME | TIMESTAMP |
| DECIMAL | DECIMAL |
| CHAR | STRING |
| LARGEINT | STRING |
| VARCHAR | STRING |
| STRING | STRING |
| DECIMALV2 | DECIMAL |
| ARRAY | ARRAY |
| MAP | STRING |
| JSON | STRING |
| VARIANT | STRING |
| IPV4 | STRING |
| IPV6 | STRING |
Flink에서 Doris로
| Flink 타입 | Doris 타입 |
|---|---|
| BOOLEAN | BOOLEAN |
| TINYINT | TINYINT |
| SMALLINT | SMALLINT |
| INTEGER | INTEGER |
| BIGINT | BIGINT |
| FLOAT | FLOAT |
| DOUBLE | DOUBLE |
| DECIMAL | DECIMAL |
| CHAR | CHAR |
| VARCHAR | VARCHAR/STRING |
| STRING | STRING |
| DATE | DATE |
| TIMESTAMP | DATETIME |
| TIMESTAMP_LTZ | DATETIME |
| ARRAY | ARRAY |
| MAP | MAP/JSON |
| ROW | STRUCT/JSON |
모니터링 지표
Flink는 Flink 클러스터 지표를 모니터링하기 위한 다양한 Metrics를 제공합니다. 다음은 Flink Doris Connector에서 새로 추가한 모니터링 지표입니다.
| 이름 | 지표 유형 | 설명 |
|---|---|---|
| totalFlushLoadBytes | Counter | 플러시되어 적재된 총 바이트 수 |
| flushTotalNumberRows | Counter | 데이터 적재 및 처리된 총 행 수 |
| totalFlushLoadedRows | Counter | 성공적으로 적재된 총 행 수 |
| totalFlushTimeMs | Counter | 데이터 적재를 성공적으로 완료하는 데 걸린 총 시간 |
| totalFlushSucceededNumber | Counter | 데이터 적재 성공 횟수 |
| totalFlushFailedNumber | Counter | 데이터 적재 실패 횟수 |
| totalFlushFilteredRows | Counter | 데이터 품질 기준을 충족하지 못한 총 행 수 |
| totalFlushUnselectedRows | Counter | where 조건으로 필터링되어 제외된 총 행 수 |
| beginTxnTimeMs | Histogram | FE에 트랜잭션 시작을 요청하는 데 걸린 시간. 단위는 밀리초입니다. |
| putDataTimeMs | Histogram | FE에 데이터 적재 실행 계획을 요청하여 가져오는 데 걸린 시간 |
| readDataTimeMs | Histogram | 데이터를 읽는 데 걸린 시간 |
| writeDataTimeMs | Histogram | 데이터 쓰기 작업을 수행하는 데 걸린 시간 |
| commitAndPublishTimeMs | Histogram | FE에 트랜잭션 커밋 및 게시를 요청하는 데 걸린 시간 |
| loadTimeMs | Histogram | 데이터 적재를 완료하는 데 걸린 시간 |
권장 사용법
FlinkSQL에서 CDC를 통해 MySQL 데이터 빠르게 적재하기
-- Enable checkpoint
SET 'execution.checkpointing.interval' = '10s';

CREATE TABLE cdc_mysql_source (
    id int,
    name VARCHAR,
    PRIMARY KEY (id) NOT ENFORCED
) WITH (
    'connector' = 'mysql-cdc',
    'hostname' = '127.0.0.1',
    'port' = '3306',
    'username' = 'root',
    'password' = 'password',
    'database-name' = 'database',
    'table-name' = 'table'
);

-- Supports synchronizing insert/update/delete events
CREATE TABLE doris_sink (
    id INT,
    name STRING
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'database.table',
    'username' = 'root',
    'password' = '',
    'sink.properties.format' = 'json',
    'sink.properties.read_json_by_line' = 'true',
    'sink.enable-delete' = 'true',  -- Synchronize delete events
    'sink.label-prefix' = 'doris_label'
);

insert into doris_sink select id, name from cdc_mysql_source;
Flink로 일부 컬럼 업데이트하기
CREATE TABLE doris_sink (
    id INT,
    name STRING,
    bank STRING,
    age int
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'database.table',
    'username' = 'root',
    'password' = '',
    'sink.properties.format' = 'json',
    'sink.properties.read_json_by_line' = 'true',
    'sink.properties.columns' = 'id,name,bank,age', -- Columns to update
    'sink.properties.partial_columns' = 'true' -- Enable partial column update
);
Flink로 Bitmap 데이터 적재하기
CREATE TABLE bitmap_sink (
    dt int,
    page string,
    user_id int
)
WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'test.bitmap_test',
    'username' = 'root',
    'password' = '',
    'sink.label-prefix' = 'doris_label',
    'sink.properties.columns' = 'dt,page,user_id,user_id=to_bitmap(user_id)'
)
Flink CDC로 키 컬럼 업데이트하기
업무용 데이터베이스에서는 일반적으로 ID를 테이블의 기본 키로 사용합니다. 예를 들어 Student 테이블은 ID(id)를 기본 키로 사용합니다. 하지만 업무가 변화하면서 데이터에 대응하는 ID가 변경될 수 있습니다. 이 경우 Flink CDC + Doris Connector로 데이터를 동기화하면 Doris 기본 키 컬럼의 데이터가 자동으로 업데이트됩니다.
동작 원리
Flink CDC의 기반 데이터 수집 도구는 Debezium입니다. Debezium은 내부적으로 op 필드를 사용하여 해당 작업을 식별합니다. op 필드의 값은 c, u, d, r이며, 각각 생성, 업데이트, 삭제, 읽기에 대응합니다. 기본 키 컬럼이 업데이트되면 Flink CDC는 다운스트림으로 DELETE 및 INSERT 이벤트를 보냅니다. 데이터가 Doris에 동기화되면 기본 키 컬럼의 데이터가 자동으로 업데이트됩니다.
사용법
Flink 프로그램은 위의 CDC 동기화 예제를 참조하면 됩니다. 작업을 성공적으로 제출한 후 MySQL 측에서 기본 키 컬럼에 대한 Update 문(예: update student set id = '1002' where id = '1001')을 실행하면 Doris의 데이터가 변경됩니다.
Flink에서 지정한 컬럼을 기준으로 데이터 삭제하기
Kafka 메시지는 특정 필드로 작업 유형을 표시하는 경우가 많습니다. 예를 들면 {"op_type":"delete",data:{...}}와 같습니다. 이러한 데이터에서는 op_type=delete인 레코드를 삭제해야 할 수 있습니다.
기본적으로 DorisSink는 RowKind를 기준으로 이벤트 유형을 구분합니다. CDC의 경우 이벤트 유형을 직접 가져올 수 있으며, 숨겨진 컬럼 __DORIS_DELETE_SIGN__에 값을 할당하여 삭제를 수행합니다. Kafka의 경우 애플리케이션 로직에서 값을 결정한 다음 숨겨진 컬럼의 값으로 명시적으로 전달해야 합니다.
-- For example, upstream data: {"op_type":"delete",data:{"id":1,"name":"zhangsan"}}
CREATE TABLE KAFKA_SOURCE(
    data STRING,
    op_type STRING
) WITH (
    'connector' = 'kafka',
    ...
);

CREATE TABLE DORIS_SINK(
    id INT,
    name STRING,
    __DORIS_DELETE_SIGN__ INT
) WITH (
    'connector' = 'doris',
    'fenodes' = '127.0.0.1:8030',
    'table.identifier' = 'db.table',
    'username' = 'root',
    'password' = '',
    'sink.enable-delete' = 'false',        -- false means do not get the event type from RowKind
    'sink.properties.columns' = 'id, name, __DORIS_DELETE_SIGN__'  -- Explicitly specify the import columns of Stream Load
);

INSERT INTO DORIS_SINK
SELECT json_value(data, '$.id') as id,
    json_value(data, '$.name') as name,
    if(op_type = 'delete', 1, 0) as __DORIS_DELETE_SIGN__
from KAFKA_SOURCE;
Flink CDC로 DDL 문 동기화하기
MySQL 등의 업스트림 데이터 소스를 동기화할 때 업스트림에서 필드가 추가되거나 삭제되면 Doris에서도 이에 맞춰 Schema Change 작업을 수행해야 합니다.
이 경우 일반적으로 DataStream API 프로그램을 작성하고 DorisSink에서 제공하는 JsonDebeziumSchemaSerializer를 사용하여 직렬화해야 합니다. 그러면 Schema Change가 자동으로 수행됩니다.
Connector에서 제공하는 데이터베이스 전체 동기화 도구를 사용하면 추가 구성이 필요하지 않습니다. 업스트림 DDL이 자동으로 동기화되고 Doris에서 Schema Change 작업이 수행됩니다.
자주 묻는 질문
1. errCode = 2, detailMessage = Label [label_0_1] has already been used, relate to txn [19650]
Exactly-Once를 사용하는 경우 Flink Job을 재시작할 때 반드시 최신 Checkpoint/Savepoint에서 시작해야 합니다. 그렇지 않으면 위 오류가 발생합니다. Exactly-Once가 필요하지 않다면 2PC 커밋을 비활성화하거나(sink.enable-2pc=false) 다른 sink.label-prefix를 사용하여 해결할 수도 있습니다.
2. errCode = 2, detailMessage = transaction [19650] not found
이 오류는 Commit 단계에서 발생합니다. Checkpoint에 기록된 트랜잭션 ID가 FE 측에서 만료된 상태이므로 다시 커밋하면 위 오류가 발생합니다. 이 경우 해당 Checkpoint에서 시작할 수 없습니다. streaming_label_keep_max_second 구성을 fe.conf에서 변경하여 만료 시간을 늘릴 수 있습니다(기본값 12시간). Doris 2.0 이후에는 label_num_threshold 구성도 fe.conf에서 이 제한에 영향을 줍니다(기본값 2000). 이 값을 늘리거나 -1로 설정할 수 있습니다(-1은 시간 제한만 적용한다는 의미입니다).
3. errCode = 2, detailMessage = current running txns on db 10006 is 100, larger than limit 100
동일한 데이터베이스에 대한 동시 데이터 적재 수가 100을 초과하면 발생합니다. max_running_txn_num_per_db 매개변수를 fe.conf에서 조정하여 해결할 수 있습니다. 자세한 내용은 max_running_txn_num_per_db를 참조하세요. 또한 label을 자주 변경하면서 작업을 재시작해도 이 오류가 발생할 수 있습니다. 2pc를 사용하는 경우(Duplicate/Aggregate 모델) 각 작업의 label은 고유해야 하며, Checkpoint에서 재시작할 때만 Flink 작업이 사전 커밋에는 성공했지만 아직 커밋되지 않은 이전 트랜잭션을 능동적으로 중단합니다. label을 자주 변경하면서 재시작하면 사전 커밋에 성공한 많은 트랜잭션이 중단되지 못하고 트랜잭션 슬롯을 차지하게 됩니다. Unique 모델에서는 2pc를 비활성화하여 멱등성 있는 쓰기를 구현할 수도 있습니다.
4. tablet writer write failed, tablet_id=190958, txn_id=3505530, err=-235
이 오류는 주로 Connector 1.1.0 이전 버전에서 발생하며, 쓰기가 너무 빈번하여 버전 수가 지나치게 많아지는 것이 원인입니다. sink.batch.size와 sink.batch.interval 매개변수를 설정하여 Stream Load 빈도를 줄일 수 있습니다. Connector 1.1.0 이후에는 기본 쓰기 시점이 Checkpoint로 제어되므로 Checkpoint 간격을 늘려 쓰기 빈도를 줄일 수 있습니다.
5. Flink 데이터 적재 시 잘못된 데이터를 건너뛰려면 어떻게 해야 하나요?
Flink가 데이터를 적재할 때 잘못된 데이터(예: 필드 형식 또는 길이 문제)가 있으면 Stream Load가 오류를 보고하고 Flink는 계속 재시도합니다. 이를 건너뛰려면 Stream Load의 엄격 모드를 비활성화하거나(strict_mode=false, max_filter_ratio=1) Sink 연산자 전에 데이터를 필터링하면 됩니다.
6. Flink 머신과 BE 머신 간에 네트워크가 연결되어 있지 않습니다. 어떻게 구성해야 하나요?
Flink가 Doris에 쓰기를 시작하면 Doris는 쓰기 요청을 BE로 리디렉션합니다. 이때 반환되는 주소는 BE의 내부 IP입니다. 즉, show backends로 확인되는 IP입니다. Flink와 Doris가 통신할 수 없으면 오류가 발생합니다. 이 경우 BE의 외부 IP를 benodes에 구성할 수 있습니다.
7. stream load error: HTTP/1.1 307 Temporary Redirect
Flink는 먼저 FE에 요청을 보냅니다. 307을 수신하면 리디렉션된 BE에 요청을 보냅니다. FE가 FullGC 상태이거나 부하가 높거나 네트워크 지연이 발생하면, HttpClient는 기본적으로 응답을 받지 못한 상태에서 일정 시간(3초)이 지난 후 데이터를 보냅니다. 요청 본문은 기본적으로 InputStream이므로 307 응답을 수신했을 때 데이터를 재전송할 수 없어 즉시 오류가 발생합니다. 해결 방법은 다음 세 가지입니다.
- 기본 대기 시간이 늘어난 Connector 25.1.0 이상으로 업그레이드합니다.
auto-redirect=false를 설정하여 BE에 직접 요청을 보냅니다(일부 클라우드 환경에서는 적용할 수 없음).- 기본 키 모델에서는 배치 모드를 활성화할 수 있습니다.