데이터 적재 중 데이터 변환
Doris는 데이터 적재 중 강력한 데이터 변환 기능을 제공하여 데이터 처리 파이프라인의 일부를 단순화하고 별도의 ETL 도구에 대한 의존도를 줄일 수 있습니다. 이러한 내장 변환 기능을 사용하면 적재 효율을 높이고 일관된 데이터 처리 로직을 유지할 수 있습니다.
변환 기능 개요
Doris는 데이터 적재 중 다음 네 가지 데이터 변환 방식을 지원합니다.
| 변환 방식 | 목적 | 실행 시점 |
|---|---|---|
| 컬럼 매핑 | 원본 데이터 컬럼을 대상 테이블의 다른 컬럼에 매핑 | 데이터 파싱 후 |
| 컬럼 변환 | 함수와 표현식을 사용하여 원본 데이터를 실시간으로 변환 | 컬럼 매핑 후 |
| 사전 필터링 | 컬럼 매핑 및 컬럼 변환 전에 불필요한 원시 데이터를 필터링 | 데이터 파싱 후, 컬럼 매핑 전 |
| 사후 필터링 | 컬럼 매핑 및 컬럼 변환 후 최종 결과를 필터링 | 컬럼 변환 후 |
각 적재 방식에서 네 가지 변환 기능을 지원하는지는 다음과 같습니다.
| 적재 방식 | 컬럼 매핑 | 컬럼 변환 | 사전 필터링 | 사후 필터링 |
|---|---|---|---|---|
| Stream Load | 지원 | 지원 | 지원하지 않음 | 지원 |
| Broker Load | 지원 | 지원 | 지원 | 지원 |
| Routine Load | 지원 | 지원 | 지원 | 지원 |
| Insert Into | SELECT로 구현 | SELECT로 구현 | WHERE로 구현 | WHERE로 구현 |
적재 구문
적재 방식에 따라 서로 다른 매개변수나 절을 사용하여 데이터 변환 로직을 선언합니다. 아래에 각 방식에서 사용하는 매개변수와 절을 정리했습니다.
Stream Load
HTTP 헤더에 다음 매개변수를 설정하여 데이터 변환을 구현합니다.
| 매개변수 | 설명 |
|---|---|
columns | 컬럼 매핑 및 컬럼 변환 지정 |
where | 사후 필터링 지정 |
참고: Stream Load는 사전 필터링을 지원하지 않습니다.
예제:
curl --location-trusted -u user:passwd \
    -H "columns: k1, k2, tmp_k3, k3 = tmp_k3 + 1" \
    -H "where: k1 > 1" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
Broker Load
SQL 문에서 다음 절을 사용하여 데이터 변환을 구현합니다.
| 절 | 설명 |
|---|---|
column list | (k1, k2, tmp_k3) 형식으로 컬럼 매핑 지정 |
SET | 컬럼 변환 지정 |
PRECEDING FILTER | 사전 필터링 지정 |
WHERE | 사후 필터링 지정 |
예제:
LOAD LABEL test_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE `test_tbl`
    (k1, k2, tmp_k3)
    PRECEDING FILTER k1 = 1
    SET (
        k3 = tmp_k3 + 1
    )
    WHERE k1 > 1
)
WITH S3 (...);
Routine Load
SQL 문에서 다음 절을 사용하여 데이터 변환을 구현합니다.
| 절 | 설명 |
|---|---|
COLUMNS | 컬럼 매핑 및 컬럼 변환 지정 |
PRECEDING FILTER | 사전 필터링 지정 |
WHERE | 사후 필터링 지정 |
예제:
CREATE ROUTINE LOAD test_db.label1 ON test_tbl
    COLUMNS(k1, k2, tmp_k3, k3 = tmp_k3 + 1),
    PRECEDING FILTER k1 = 1,
    WHERE k1 > 1
    ...
Insert Into
Insert Into는 SELECT 문에서 직접 데이터 변환을 수행할 수 있으며, WHERE 절을 사용하여 데이터를 필터링합니다.
컬럼 매핑
컬럼 매핑은 원본 데이터 컬럼과 대상 테이블 컬럼 간의 대응 관계를 정의합니다. 다음과 같은 상황을 처리할 수 있습니다.
- 원본 데이터의 컬럼 순서가 대상 테이블의 컬럼 순서와 다른 경우
- 원본 데이터의 컬럼 수가 대상 테이블의 컬럼 수와 다른 경우
구현 원리
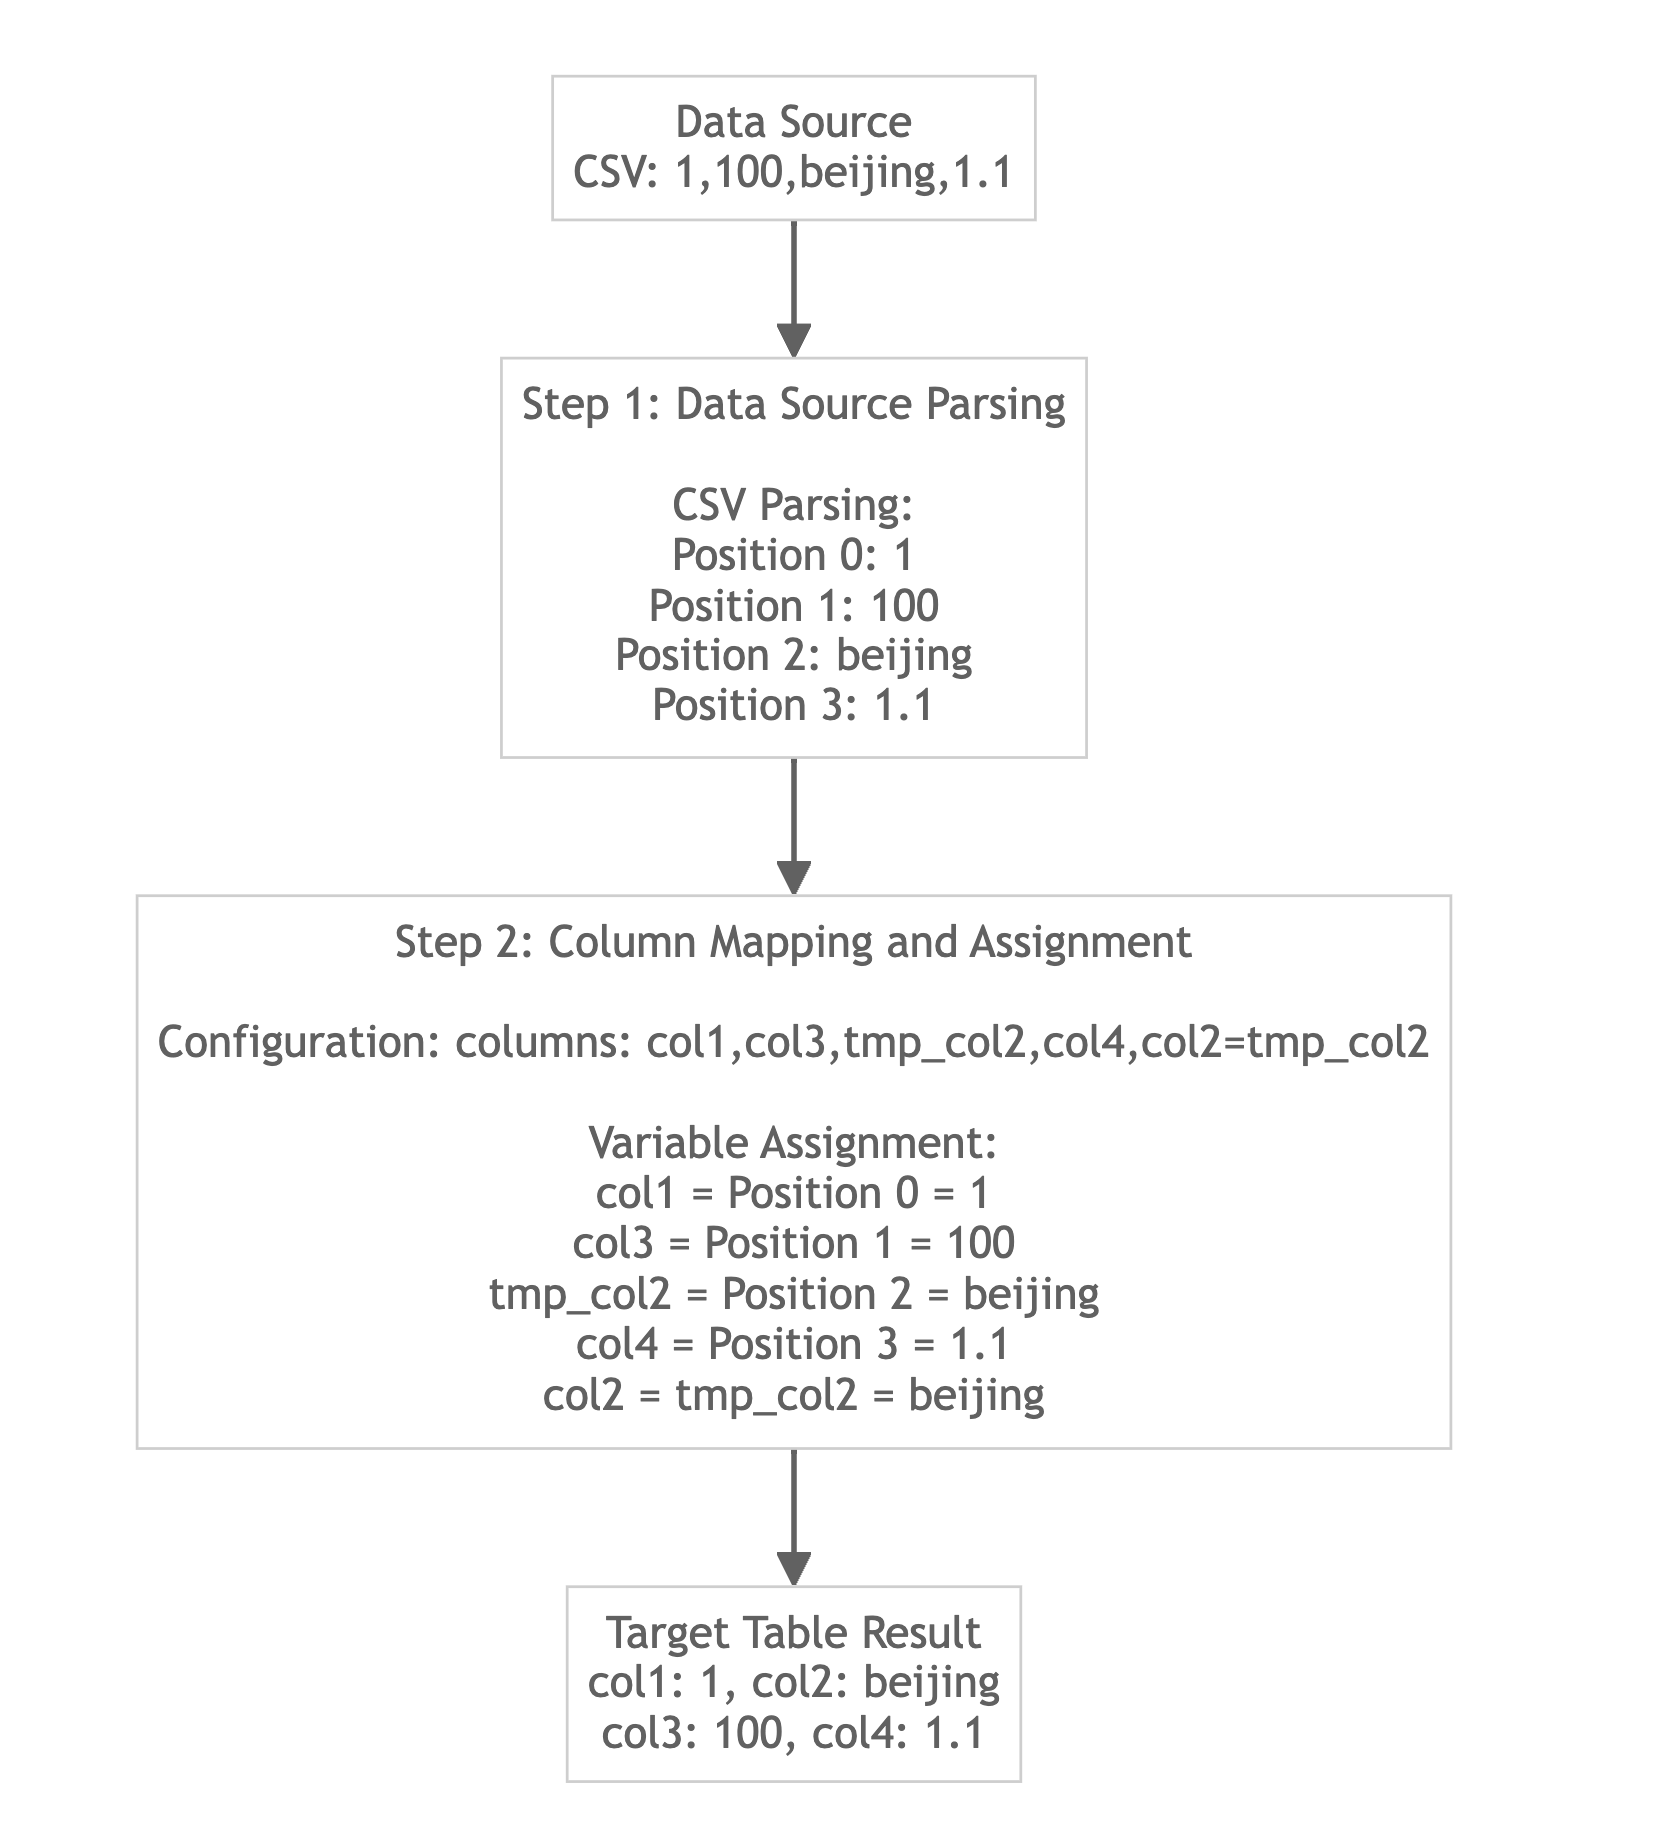
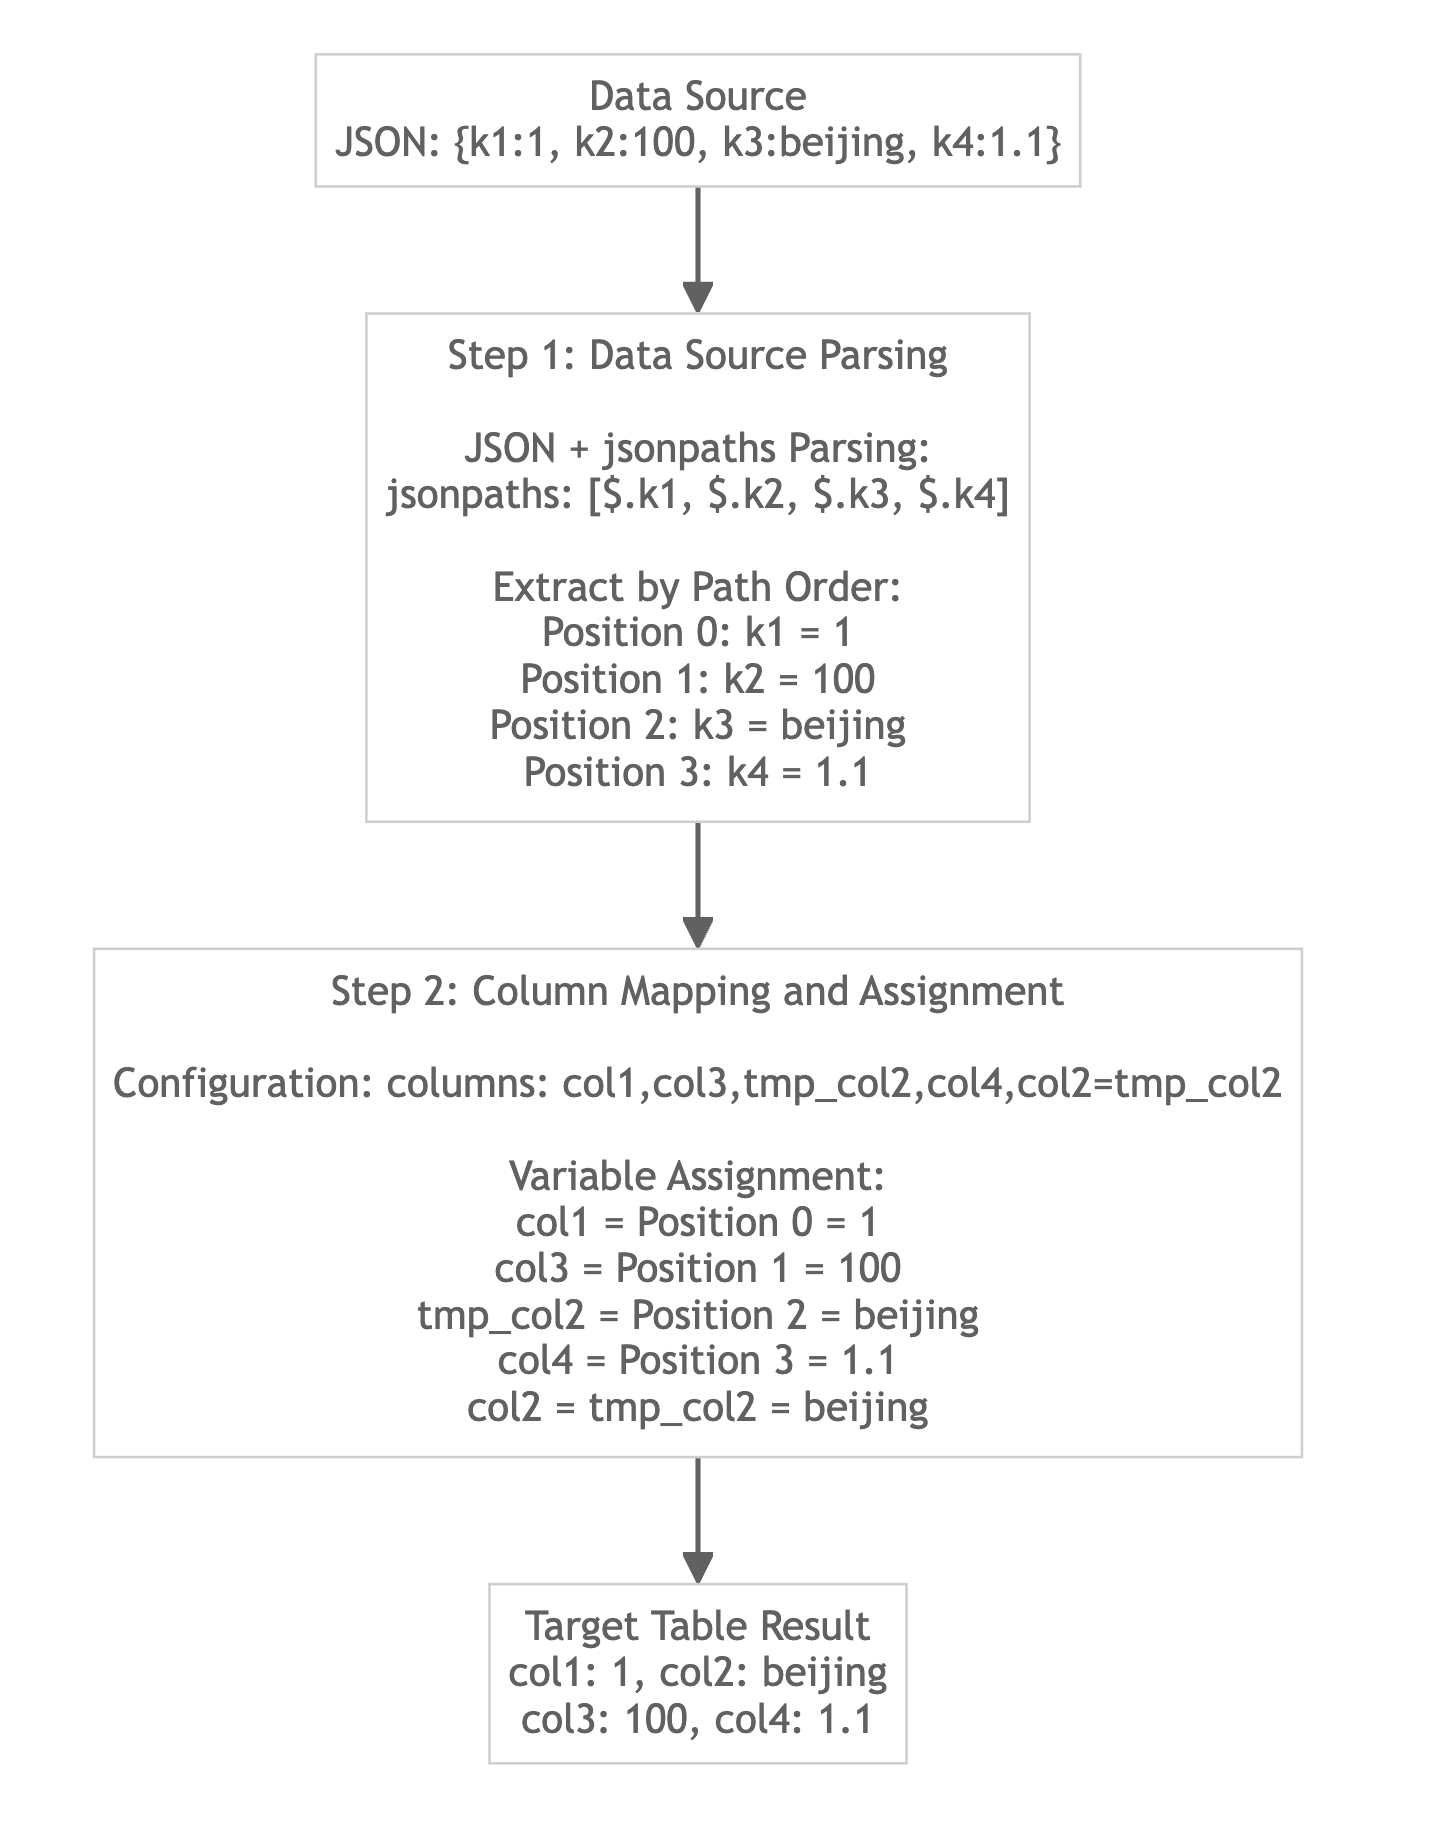
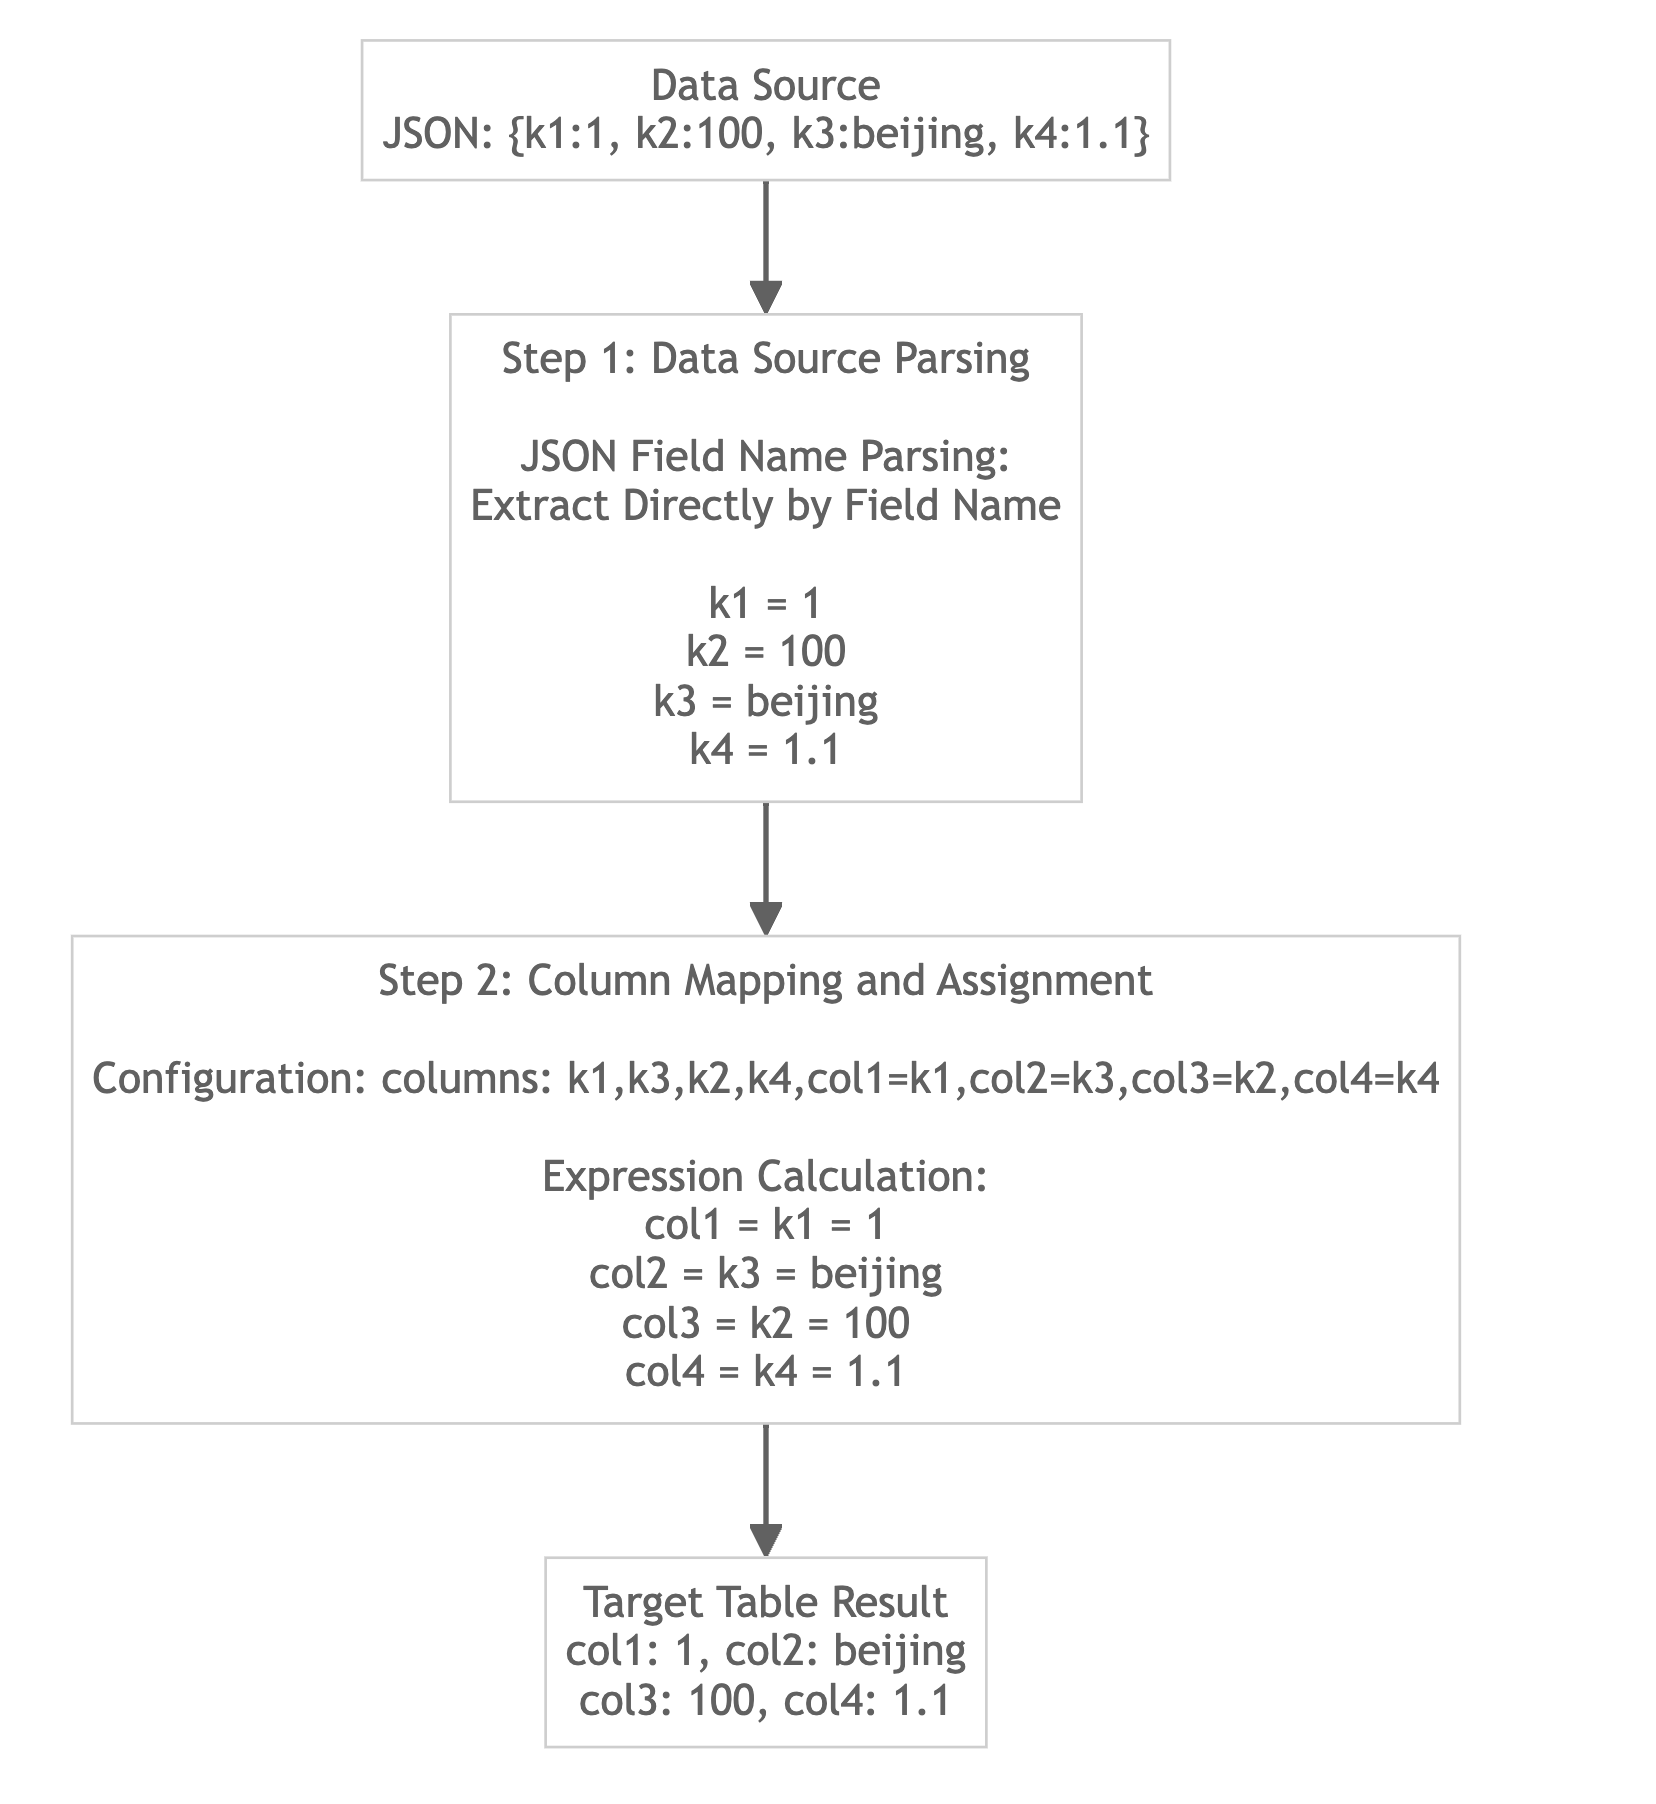
컬럼 매핑의 구현은 두 가지 핵심 단계로 나눌 수 있습니다.
- 원본 데이터 파싱: 데이터 형식에 따라 원시 데이터를 파싱하여 중간 변수에 저장합니다.
- 컬럼 매핑을 통한 할당: 컬럼 이름을 기준으로 중간 변수를 대상 테이블의 필드에 매핑합니다.
다음은 세 가지 데이터 형식별 처리 흐름입니다.
CSV 형식 데이터 적재
jsonpaths를 지정하여 JSON 형식 데이터 적재
jsonpaths를 지정하지 않고 JSON 형식 데이터 적재
시나리오 1: jsonpaths를 지정하여 JSON 데이터 적재
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
{"k1":1,"k2":"100","k3":"beijing","k4":1.1}
{"k1":2,"k2":"200","k3":"shanghai","k4":1.2}
{"k1":3,"k2":"300","k3":"guangzhou","k4":1.3}
{"k1":4,"k2":"\\N","k3":"chongqing","k4":1.4}
대상 테이블 생성
CREATE TABLE example_table
(
    col1 INT,
    col2 STRING,
    col3 INT,
    col4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(col1)
DISTRIBUTED BY HASH(col1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "columns:col1, col3, col2, col4" \
    -H "jsonpaths:[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]" \
    -H "format:json" \
    -H "read_json_by_line:true" \
    -T data.json \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.json")
    INTO TABLE example_table
    FORMAT AS "json"
    (col1, col3, col2, col4)
    PROPERTIES
    (
        "jsonpaths" = "[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]"
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(col1, col3, col2, col4)
PROPERTIES
(
    "format" = "json",
    "jsonpaths" = "[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]",
    "read_json_by_line" = "true"
)
FROM KAFKA (...);
쿼리 결과
mysql> SELECT * FROM example_table;
+------+-----------+------+------+
| col1 | col2      | col3 | col4 |
+------+-----------+------+------+
|    1 | beijing   |  100 |  1.1 |
|    2 | shanghai  |  200 |  1.2 |
|    3 | guangzhou |  300 |  1.3 |
|    4 | chongqing | NULL |  1.4 |
+------+-----------+------+------+
시나리오 2: jsonpaths를 지정하지 않고 JSON 데이터 적재
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
{"k1":1,"k2":"100","k3":"beijing","k4":1.1}
{"k1":2,"k2":"200","k3":"shanghai","k4":1.2}
{"k1":3,"k2":"300","k3":"guangzhou","k4":1.3}
{"k1":4,"k2":"\\N","k3":"chongqing","k4":1.4}
대상 테이블 생성
CREATE TABLE example_table
(
    col1 INT,
    col2 STRING,
    col3 INT,
    col4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(col1)
DISTRIBUTED BY HASH(col1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "columns:k1, k3, k2, k4,col1 = k1, col2 = k3, col3 = k2, col4 = k4" \
    -H "format:json" \
    -H "read_json_by_line:true" \
    -T data.json \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.json")
    INTO TABLE example_table
    FORMAT AS "json"
    (k1, k3, k2, k4)
    SET (
        col1 = k1,
        col2 = k3,
        col3 = k2,
        col4 = k4
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4, col1 = k1, col2 = k3, col3 = k2, col4 = k4),
PROPERTIES
(
    "format" = "json",
    "read_json_by_line" = "true"
)
FROM KAFKA (...);
쿼리 결과
mysql> SELECT * FROM example_table;
+------+-----------+------+------+
| col1 | col2      | col3 | col4 |
+------+-----------+------+------+
|    1 | beijing   |  100 |  1.1 |
|    2 | shanghai  |  200 |  1.2 |
|    3 | guangzhou |  300 |  1.3 |
|    4 | chongqing | NULL |  1.4 |
+------+-----------+------+------+
시나리오 3: 컬럼 순서 조정
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
대상 테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. 매핑은 다음과 같아야 합니다.
column 1 -> k1
column 2 -> k3
column 3 -> k2
column 4 -> k4
대상 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1,k3,k2,k4" \
    -T data.csv \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k3, k2, k4)
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
쿼리 결과
mysql> select * from example_table;
+------+-----------+------+------+
| k1   | k2        | k3   | k4   |
+------+-----------+------+------+
|    2 | shanghai  |  200 |  1.2 |
|    4 | chongqing | NULL |  1.4 |
|    3 | guangzhou |  300 |  1.3 |
|    1 | beijing   |  100 |  1.1 |
+------+-----------+------+------+
시나리오 4: 원본 파일의 컬럼 수가 테이블보다 많은 경우
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
대상 테이블에는 k1, k2, k3라는 세 개의 컬럼이 있고, 원본 파일에는 네 개의 컬럼이 있습니다. 원본 파일의 1번째, 2번째, 4번째 컬럼만 필요하며, 매핑은 다음과 같습니다.
column 1 -> k1
column 2 -> k2
column 4 -> k3
원본 파일에서 특정 컬럼을 건너뛰려면 컬럼 매핑 시 대상 테이블에 존재하지 않는 임의의 컬럼 이름을 사용하면 됩니다. 이러한 컬럼 이름은 제한 없이 지정할 수 있으며, 해당 컬럼의 데이터는 적재 중 자동으로 무시됩니다.
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:password \
    -H "column_separator:," \
    -H "columns: k1,k2,tmp_skip,k3" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (tmp_k1, tmp_k2, tmp_skip, tmp_k3)
    SET (
        k1 = tmp_k1,
        k2 = tmp_k2,
        k3 = tmp_k3
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_skip, k3),
PROPERTIES
(
    "format" = "csv",
    "column_separator" = ","
)
FROM KAFKA (...);
참고: 예제의
tmp_skip은 대상 테이블의 컬럼 정의에 없는 이름이라면 어떤 이름으로든 바꿀 수 있습니다.
쿼리 결과
mysql> select * from example_table;
+------+------+------+
| k1   | k2   | k3   |
+------+------+------+
|    1 | 100  |  1.1 |
|    2 | 200  |  1.2 |
|    3 | 300  |  1.3 |
|    4 | NULL |  1.4 |
+------+------+------+
시나리오 5: 원본 파일의 컬럼 수가 테이블보다 적은 경우
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
대상 테이블에는 k1, k2, k3, k4, k5라는 다섯 개의 컬럼이 있고, 원본 파일에는 네 개의 컬럼이 있습니다. 원본 파일의 1번째, 2번째, 3번째, 4번째 컬럼만 필요하며, 매핑은 다음과 같습니다.
column 1 -> k1
column 2 -> k3
column 3 -> k2
column 4 -> k4
k5 uses the default value
대상 테이블의 컬럼 중 원본에 없는 컬럼은 다음 규칙에 따라 처리됩니다.
- 컬럼에 기본값이 있으면 기본값을 사용합니다.
- 컬럼이 NULL을 허용하지만 기본값이 없으면 NULL을 사용합니다.
- 컬럼이 NULL을 허용하지 않고 기본값도 없으면 적재에 실패합니다.
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE,
    k5 INT DEFAULT 2
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1,k3,k2,k4" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (tmp_k1, tmp_k3, tmp_k2, tmp_k4)
    SET (
        k1 = tmp_k1,
        k3 = tmp_k3,
        k2 = tmp_k2,
        k4 = tmp_k4
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
쿼리 결과
mysql> select * from example_table;
+------+-----------+------+------+------+
| k1   | k2        | k3   | k4   | k5   |
+------+-----------+------+------+------+
|    1 | beijing   |  100 |  1.1 |    2 |
|    2 | shanghai  |  200 |  1.2 |    2 |
|    3 | guangzhou |  300 |  1.3 |    2 |
|    4 | chongqing | NULL |  1.4 |    2 |
+------+-----------+------+------+------+
컬럼 변환
컬럼 변환을 사용하면 원본 파일의 컬럼 값을 변환할 수 있습니다. 대부분의 내장 함수를 지원합니다. 컬럼 변환은 일반적으로 컬럼 매핑과 함께 정의하며, 먼저 컬럼을 매핑한 다음 변환합니다.
시나리오 1: 원본 컬럼 값의 산술 변환
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. 적재 시 매핑 및 변환은 다음과 같습니다.
column 1       -> k1
column 2 * 100 -> k3
column 3       -> k2
column 4       -> k4
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, tmp_k3, k2, k4, k3 = tmp_k3 * 100" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp_k3, k2, k4)
    SET (
        k3 = tmp_k3 * 100
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp_k3, k2, k4, k3 = tmp_k3 * 100),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
쿼리 결과
mysql> select * from example_table;
+------+-----------+-------+------+
| k1   | k2        | k3    | k4   |
+------+-----------+-------+------+
|    1 | beijing   | 10000 |  1.1 |
|    2 | shanghai  | 20000 |  1.2 |
|    3 | guangzhou | 30000 |  1.3 |
|    4 | chongqing |  NULL |  1.4 |
+------+-----------+-------+------+
시나리오 2: CASE WHEN 함수를 사용한 조건부 컬럼 변환
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. 원본 데이터의 beijing, shanghai, guangzhou, chongqing 값을 해당 지역 ID로 변환한 후 적재합니다.
column 1                                 -> k1
column 2                                 -> k2
column 3 (after region ID conversion)    -> k3
column 4                                 -> k4
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, tmp_k3, k4, k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, tmp_k3, k4)
    SET (
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_k3, k4, k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
쿼리 결과
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    3 |  300 |    3 |  1.3 |
|    4 | NULL |    4 |  1.4 |
+------+------+------+------+
시나리오 3: 원본 파일의 NULL 값 처리
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. 지역 ID를 변환하면서 적재 중 원본 데이터의 k2 컬럼에 있는 null 값을 0으로 변환합니다.
column 1                                  -> k1
column 2 (convert null to 0 if null)      -> k2
column 3                                  -> k3
column 4                                  -> k4
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, tmp_k2, tmp_k3, k4, k2 = ifnull(tmp_k2, 0), k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp_k2, tmp_k3, k4)
    SET (
        k2 = ifnull(tmp_k2, 0),
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp_k2, tmp_k3, k4, k2 = ifnull(tmp_k2, 0), k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
쿼리 결과
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    3 |  300 |    3 |  1.3 |
|    4 |    0 |    4 |  1.4 |
+------+------+------+------+
사전 필터링
사전 필터링은 변환 전에 원시 데이터를 필터링합니다. 처리할 필요가 없는 데이터를 미리 제거하여 후속 처리의 데이터 양을 줄이고 적재 효율을 높일 수 있습니다. 이 기능은 Broker Load와 Routine Load에서만 지원합니다.
사용 사례
- 변환 전 필터링: 컬럼 매핑 및 컬럼 변환 전에 필터링하여 불필요한 데이터를 미리 제거할 수 있습니다.
- 테이블에 없고 필터링용 표시로만 사용하는 컬럼을 기준으로 필터링: 예를 들어, 원본 데이터에 여러 테이블의 행이 저장되어 있거나 여러 테이블의 행이 동일한 Kafka 메시지 큐에 기록되어 있고, 각 행에 해당 행이 속한 테이블을 나타내는 테이블 이름 컬럼이 있는 경우입니다. 사전 필터 조건을 사용하면 해당 테이블의 데이터만 선택하여 적재할 수 있습니다.
제한 사항
| 제한 사항 | 설명 |
|---|---|
| 필터 컬럼 제한 | 사전 필터링은 컬럼 목록에 있는 독립적인 단순 컬럼만 필터링할 수 있으며, 표현식으로 생성된 컬럼은 필터링할 수 없습니다. 예를 들어 컬럼 매핑이 (a, tmp, b = tmp + 1)인 경우, 컬럼 b는 필터 조건으로 사용할 수 없습니다. |
| 데이터 처리 제한 | 사전 필터링은 데이터 변환 전에 수행되며, 원시 데이터 값을 사용하여 비교합니다. 원시 데이터는 문자열 타입으로 취급됩니다. 예를 들어 \N과 같은 데이터는 비교 전에 NULL로 변환되지 않고 문자열 \N으로 직접 비교됩니다. |
예제 1: 숫자 조건을 사용한 사전 필터링
이 예제에서는 간단한 숫자 비교 조건을 사용하여 원본 데이터를 필터링하는 방법을 보여 줍니다. 필터 조건을 k1 > 1로 설정하면 데이터 변환 전에 불필요한 레코드를 제거할 수 있습니다.
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
사전 필터 조건은 다음과 같습니다.
column 1 > 1, that is, only data with column 1 > 1 is imported, and the rest is filtered out.
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    PRECEDING FILTER k1 > 1
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
PRECEDING FILTER k1 > 1
FROM KAFKA (...)
쿼리 결과
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    2 |  200 | shanghai  |  1.2 |
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
예제 2: 중간 컬럼을 사용하여 유효하지 않은 데이터 필터링
이 예제에서는 유효하지 않은 데이터가 포함된 적재 시나리오를 처리하는 방법을 보여 줍니다.
원본 데이터는 다음과 같습니다.
1,1
2,abc
3,3
테이블 생성문
CREATE TABLE example_table
(
    k1 INT,
    k2 INT NOT NULL
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
int 타입인 k2 컬럼에서 abc는 유효하지 않은 불량 데이터입니다. 이 데이터를 제거하려면 필터링용 중간 컬럼을 도입할 수 있습니다.
데이터 적재문
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp, k2 = tmp)
    PRECEDING FILTER tmp != "abc"
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp, k2 = tmp),
COLUMNS TERMINATED BY ","
PRECEDING FILTER tmp != "abc"
FROM KAFKA (...);
데이터 적재 결과
mysql> select * from example_table;
+------+----+
| k1   | k2 |
+------+----+
|    1 |  1 |
|    3 |  3 |
+------+----+
사후 필터링
사후 필터링은 데이터 변환 후에 수행되며, 변환된 결과를 기준으로 필터링할 수 있습니다.
시나리오 1: 컬럼 매핑이나 변환 없이 직접 필터링
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. 컬럼 매핑이나 변환 없이 원본 파일의 4번째 컬럼 값이 1.2보다 큰 행만 적재합니다.
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, k3, k4" \
    -H "where: k4 > 1.2" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    where k4 > 1.2
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
WHERE k4 > 1.2;
FROM KAFKA (...)
쿼리 결과
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
시나리오 2: 컬럼 변환 후 데이터 필터링
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. 컬럼 변환 예제에서는 성 이름을 ID로 변환했습니다. 여기서는 ID가 3인 행을 제거합니다.
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, tmp_k3, k4, k3 = case tmp_k3 when 'beijing' then 1 when 'shanghai' then 2 when 'guangzhou' then 3 when 'chongqing' then 4 else null end" \
    -H "where: k3 != 3" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, tmp_k3, k4)
    SET (
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
    WHERE k3 != 3
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_k3, k4),
COLUMNS TERMINATED BY ","
SET (
    k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
)
WHERE k3 != 3;
FROM KAFKA (...)
쿼리 결과
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    4 | NULL |    4 |  1.4 |
+------+------+------+------+
시나리오 3: 여러 조건을 사용한 필터링
다음과 같은 원본 데이터가 있다고 가정합니다(설명을 돕기 위해 헤더의 컬럼 이름을 표시했으며, 실제 데이터에는 헤더가 없습니다).
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
테이블에는 k1, k2, k3, k4라는 네 개의 컬럼이 있습니다. k1 컬럼이 null인 행과 k4 컬럼 값이 1.2보다 작은 행을 제거합니다.
예제 테이블 생성
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
데이터 적재
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, k3, k4" \
    -H "where: k1 is not null and k4 > 1.2" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    where k1 is not null and k4 > 1.2
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
WHERE k1 is not null and k4 > 1.2
FROM KAFKA (...);
쿼리 결과
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
자주 묻는 질문
1. Stream Load에는 왜 PRECEDING FILTER가 없나요?
Stream Load는 사전 필터링을 지원하지 않습니다. where 매개변수를 통한 사후 필터링만 수행할 수 있습니다. 사전 필터링이 필요하면 Broker Load 또는 Routine Load를 사용하세요.
2. 사전 필터링에서는 왜 \N을 NULL로 처리하지 않나요?
사전 필터링은 데이터 변환 전에 수행되며, 원시 데이터 값을 사용하여 비교합니다. 원시 데이터는 문자열 타입으로 취급됩니다. \N의 경우 먼저 NULL로 변환하지 않고 문자열 \N을 직접 비교에 사용합니다. NULL을 기준으로 필터링하려면 사후 필터링(WHERE)을 사용하세요.
3. 컬럼 매핑 시 원본 파일의 특정 컬럼을 건너뛰려면 어떻게 하나요?
컬럼 매핑 목록에서 불필요한 컬럼에 대상 테이블에 존재하지 않는 컬럼 이름(예: tmp_skip)을 할당하세요. 이러한 임시 컬럼 이름은 자리 표시자로만 사용되며, 적재 중 자동으로 무시됩니다.
4. 대상 테이블에 원본 파일에는 없는 컬럼이 있으면 어떻게 처리하나요?
다음 규칙에 따라 값을 채웁니다.
- 컬럼에 기본값이 있으면 기본값을 사용합니다.
- 컬럼이 NULL을 허용하지만 기본값이 없으면 NULL을 사용합니다.
- 컬럼이 NULL을 허용하지 않고 기본값도 없으면 적재에 실패합니다.
5. 컬럼 변환에서 어떤 함수를 사용할 수 있나요?
컬럼 변환은 ifnull, CASE WHEN, 문자열 함수, 날짜 함수, 산술 연산 등 대부분의 내장 함수를 지원합니다. 이러한 함수는 columns 또는 SET 절에서 사용할 수 있습니다.
6. 사전 필터링에서는 왜 표현식으로 값이 할당된 컬럼을 참조할 수 없나요?
사전 필터링은 독립적인 단순 컬럼만 필터링할 수 있으며, 표현식으로 생성된 컬럼(예: b = tmp + 1)은 필터링할 수 없습니다. 이러한 컬럼을 참조하려면 사후 필터링(WHERE)을 사용하세요.