데이터 업데이트 개요
이 문서에서는 Apache Doris의 데이터 업데이트 및 삭제 기능을 소개하고, 다음 질문에 대한 답을 안내합니다.
- 비즈니스 시나리오에 어떤 테이블 모델을 선택해야 할까요?
- 데이터 적재 기반 업데이트(UPSERT, 부분 열 업데이트)는 언제 사용하고, DML 업데이트(
UPDATE,INSERT INTO SELECT)는 언제 사용해야 할까요? - Unique Key 모델은 어떤 원리로 구현되어 있을까요? (Merge-on-Write, Sequence 열, 삭제 마커, 부분 열 업데이트)
- CDC 동기화와 실시간 와이드 테이블 같은 일반적인 시나리오는 어떻게 구현할까요?
목적에 따라 다음 섹션을 참고하세요.
- 빠르게 방식을 선택하려면 1. 적절한 업데이트 방식 선택을 바로 확인하세요.
- 원리를 이해하거나 성능 문제를 해결하려면 2. Unique Key 모델의 구현 원리를 참고하세요.
- 일반적인 비즈니스 활용 사례는 3. 주요 비즈니스 시나리오를 참고하세요.
- 권장 사항과 제약 사항은 4. 사용 권장 사항을 참고하세요.
1. 적절한 업데이트 방식 선택
1.1 테이블 모델 및 업데이트 기능 비교
Doris는 세 가지 테이블 모델을 제공하며, 모델마다 업데이트와 삭제 지원 방식에 큰 차이가 있습니다. 모델을 선택할 때는 먼저 비즈니스에 행 단위 업데이트나 부분 열 업데이트가 필요한지 확인하세요.
| 테이블 모델 | 데이터 구성 방식 | 지원하는 업데이트/삭제 방식 | 주요 활용 사례 |
|---|---|---|---|
| Unique Key 모델 | 각 행을 고유한 기본 키로 식별하며, 쓰기 시 중복 제거 | UPSERT, 부분 열 업데이트, UPDATE, 마커 기반 삭제, DELETE | 주문 상태 변경, 사용자 태그 업데이트, CDC 동기화 |
| Aggregate Key 모델 | 동일한 Key를 가진 값 열을 집계 함수(SUM/MAX/MIN/REPLACE)로 병합 | 집계 시맨틱에 따른 데이터 적재로 업데이트하며, DELETE는 Key 열 조건만 지원 | 실시간 보고서, 클릭 수 집계 및 기타 집계 시나리오 |
| Duplicate Key 모델 | 추가 전용 쓰기, 중복 제거나 집계 없음 | DELETE만 지원 | 로그, 행동 추적 및 기타 추가 전용 시나리오 |
선택 기준: 행 단위 업데이트나 부분 열 업데이트가 필요하면 Unique Key 모델을 선택하세요.
1.2 업데이트 경로 선택
Unique Key 모델은 두 가지 업데이트 경로를 지원하며, 데이터 규모와 작업 빈도에 따라 선택할 수 있습니다.
| 경로 | 적용 시나리오 | 권장 쓰기 방식 |
|---|---|---|
| 데이터 적재 기반 업데이트(UPSERT) | 고빈도 대규모 배치 업데이트, CDC 동기화, 여러 소스의 데이터를 이용한 와이드 테이블 구성 | Stream Load, Routine Load, Broker Load, INSERT INTO |
DML 업데이트(UPDATE) | 저빈도 배치 업데이트, 조건에 따른 데이터 갱신, 테이블 간 연관 업데이트 | UPDATE, INSERT INTO ... SELECT ... |
1.2.1 데이터 적재를 통한 업데이트(UPSERT)
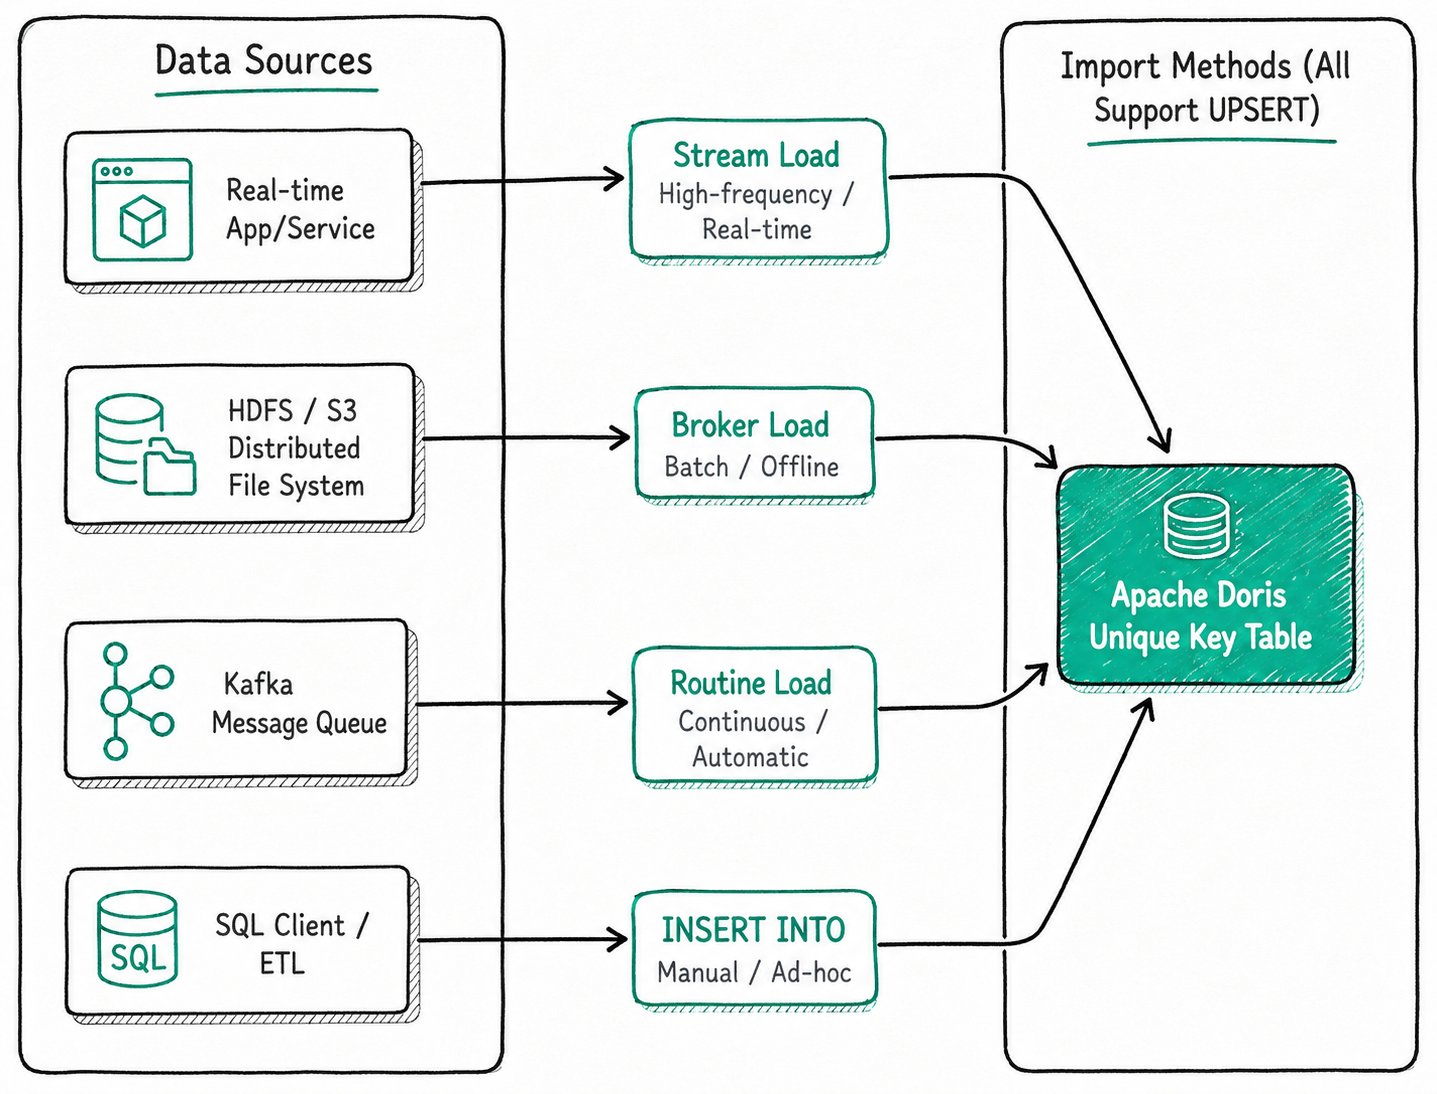
모든 데이터 적재 방식(Stream Load, Broker Load, Routine Load, INSERT INTO)은 기본적으로 Unique Key 모델의 데이터를 UPSERT 시맨틱으로 처리합니다.
- 기본 키가 이미 존재하면 새 행으로 기존 행을 덮어씁니다.
- 기본 키가 존재하지 않으면 새 행을 삽입합니다.
데이터 적재 기반 업데이트의 동작은 테이블 모델에 따라 다릅니다. 자세한 내용은 다음 문서를 참고하세요.
- Unique Key 모델의 데이터 적재를 통한 업데이트: Stream Load, Routine Load 등의 방식으로 전체 행 Upsert와 부분 열 업데이트를 구현합니다.
- Aggregate 모델의 데이터 적재를 통한 업데이트: Aggregate 모델의 쓰기 시맨틱과 사용 가능한 업데이트 방식을 설명합니다.
1.2.2 UPDATE 문을 통한 업데이트
Doris는 표준 SQL UPDATE를 지원합니다. Unique Key 모델 테이블의 데이터를 WHERE 조건에 따라 업데이트할 수 있으며, 테이블 간 연관 업데이트도 지원합니다.
-- Simple update
UPDATE user_profiles SET age = age + 1 WHERE user_id = 1;

-- Cross-table associated update
UPDATE sales_records t1
SET t1.user_name = t2.name
FROM user_profiles t2
WHERE t1.user_id = t2.user_id;
UPDATE는 먼저 조건에 맞는 데이터를 스캔한 다음, 업데이트한 행을 다시 쓰는 순서로 실행됩니다. 이 방식은 저빈도 배치 업데이트 시나리오에 적합합니다.
동일한 기본 키를 가진 데이터에 대해 동시성이 높은 UPDATE 작업을 수행하는 것은 권장하지 않습니다. 동시에 실행되는 UPDATE 작업이 동일한 기본 키를 대상으로 하면 데이터 격리성이 보장되지 않습니다.
UPDATE 문의 구문, 일반적인 사용법 및 제약 사항은 UPDATE 명령을 사용한 데이터 업데이트를 참고하세요.
1.2.3 INSERT INTO SELECT를 통한 업데이트
Unique Key 모델은 기본적으로 UPSERT 시맨틱을 사용하므로, INSERT INTO ... SELECT ...로도 UPDATE와 같은 효과를 얻을 수 있습니다. 이 방식은 다른 테이블에서 가져온 데이터를 배치로 다시 쓰는 데 적합합니다.
1.3 데이터 삭제 경로
Doris는 두 가지 데이터 삭제 경로를 제공하며, 테이블 모델마다 구현 방식이 다릅니다.
| 삭제 경로 | 지원하는 테이블 모델 | 설명 |
|---|---|---|
| 데이터 적재를 통한 마커 기반 삭제 | Unique Key 모델 | __DORIS_DELETE_SIGN__ = 1 마커를 기록하고, 백그라운드 Compaction이 데이터를 물리적으로 정리 |
DML 삭제(DELETE / TRUNCATE) | 모든 모델 | 조건에 따라 데이터를 삭제하거나 테이블/파티션을 비움 |
전체 내용은 데이터 삭제를 참고하세요.
2. Unique Key 모델의 구현 원리
2.1 Merge-on-Write와 Merge-on-Read
Unique Key 모델에는 두 가지 데이터 병합 전략이 있습니다. Doris 2.1부터는 Merge-on-Write가 기본 구현 방식입니다.
| 비교 항목 | Merge-on-Write (MoW) | Merge-on-Read (MoR, 레거시) |
|---|---|---|
| 쓰기 시 동작 | 쓰기 시 중복을 제거하고 병합하여, 스토리지에 기본 키당 최신 레코드 하나만 유지 | 쓰기 시 여러 버전을 유지 |
| 쿼리 성능 | 업데이트가 없는 Duplicate Key 테이블과 유사 | 쿼리 시 실시간으로 병합하므로 MoW보다 약 3-10배 오래 걸림 |
| 쓰기 성능 | 병합 오버헤드로 인해 MoR보다 다소 낮음(소규모 배치는 약 10-20%, 대규모 배치는 약 30-50%) | Duplicate Key 테이블과 유사 |
| 리소스 사용량 | 쓰기와 백그라운드 Compaction에서 더 많은 CPU/메모리 사용 | 쿼리에서 더 많은 CPU/메모리 사용 |
| 적용 시나리오 | 읽기가 많고 쓰기가 드문 경우(권장) | 쓰기가 많고 읽기가 드문 경우(더 이상 권장하지 않음) |
새로 생성한 테이블은 기본적으로 MoW를 사용하며, 별도의 설정이 필요하지 않습니다.
2.2 Sequence 열과 순서가 뒤바뀐 데이터
분산 시스템에서는 데이터가 순서대로 도착하지 않을 수 있습니다. 예를 들어 주문 상태가 "결제 완료"에서 "발송 완료"로 순차적으로 바뀌었지만, 네트워크 지연으로 인해 "발송 완료" 메시지가 "결제 완료" 메시지보다 먼저 Doris에 도착할 수 있습니다.
Sequence 열 메커니즘은 이 문제를 해결합니다. 테이블을 생성할 때 특정 열(일반적으로 타임스탬프 또는 버전 번호)을 Sequence 열로 지정합니다. 동일한 기본 키를 가진 데이터를 쓸 때 Doris는 항상 Sequence 값이 가장 큰 행을 유지합니다.
CREATE TABLE order_status (
    order_id BIGINT,
    status_name STRING,
    update_time DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id)
PROPERTIES (
    "function_column.sequence_col" = "update_time" -- Specify update_time as the Sequence column
);

-- 1. Write the "Shipped" record (larger update_time)
-- {"order_id": 1001, "status_name": "Shipped", "update_time": "2023-10-26 12:00:00"}

-- 2. Write the "Paid" record (smaller update_time, arrives later)
-- {"order_id": 1001, "status_name": "Paid", "update_time": "2023-10-26 11:00:00"}

-- Final result: the record with the largest update_time is retained
-- order_id: 1001, status_name: "Shipped", update_time: "2023-10-26 12:00:00"
자세한 내용은 다음 문서를 참고하세요.
- Sequence 열, MVCC 버전 관리,
UPDATE동시성 매개변수 등의 동시성 제어 기능은 Unique Key 모델의 업데이트 동시성 제어를 참고하세요. - 여러 데이터 스트림이 동일한 와이드 테이블의 서로 다른 열을 동시에 업데이트하는 경우, Sequence Mapping을 사용하여 각 열의 버전 순서를 독립적으로 제어할 수 있습니다. 자세한 내용은 Unique Key 모델의 다중 스트림 업데이트를 참고하세요.
2.3 삭제 마커의 처리 과정
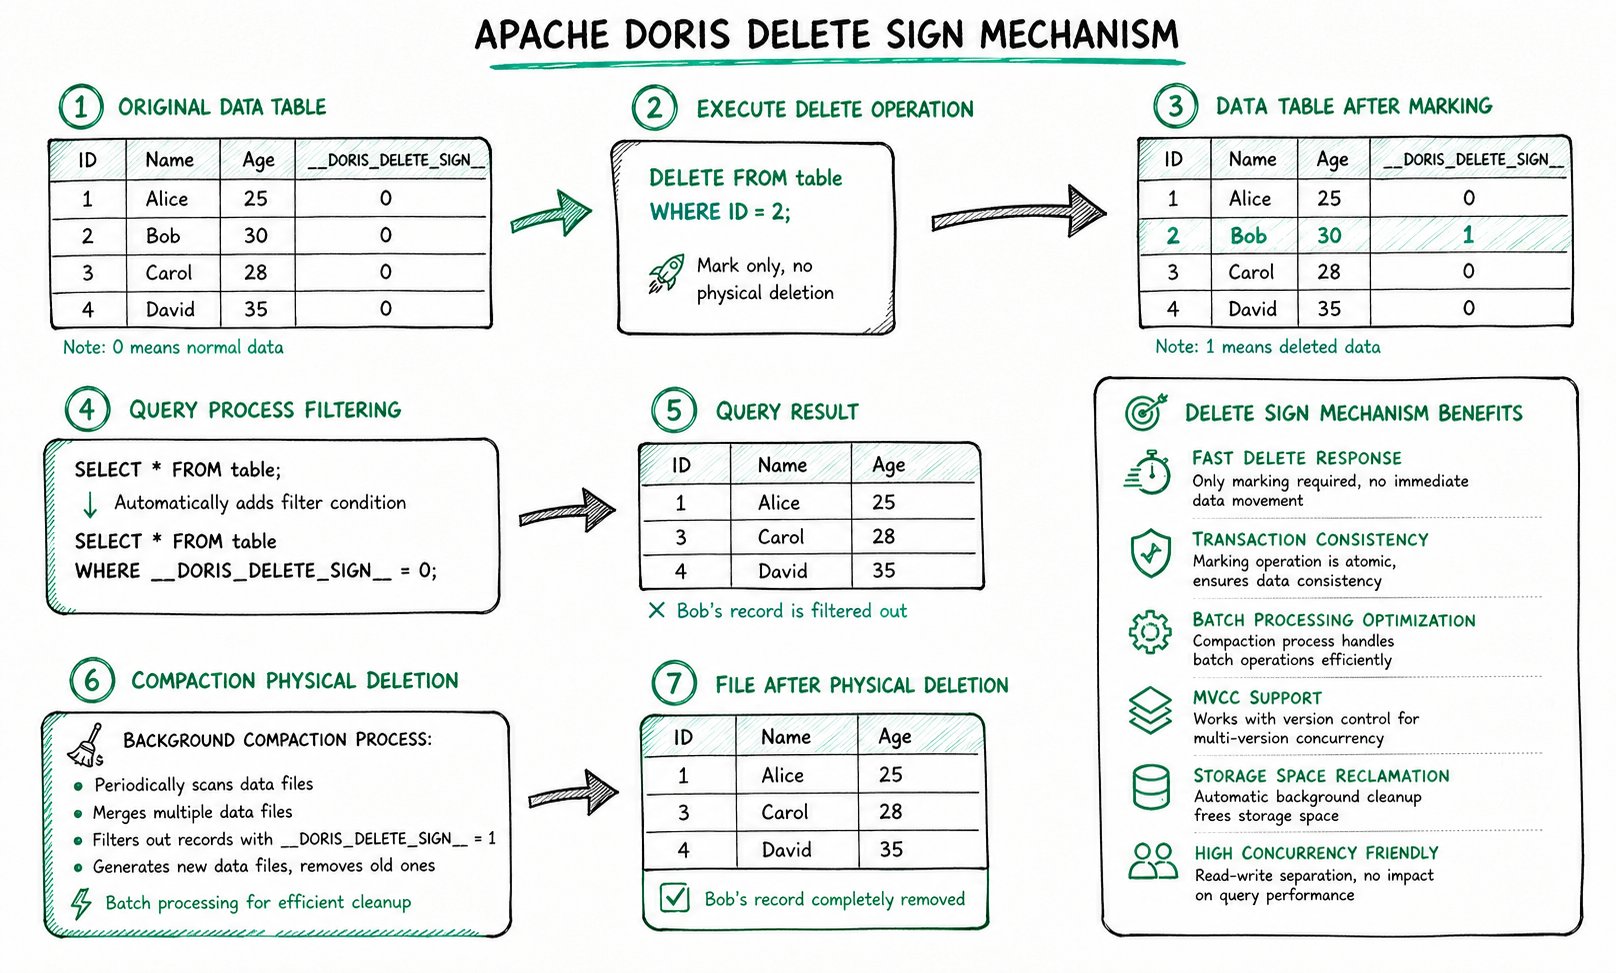
__DORIS_DELETE_SIGN__은 "논리적 표시, 백그라운드 정리" 방식을 사용하며, 다음 세 단계로 처리됩니다.
- 삭제 실행: 데이터 적재나
DELETE문을 통해 데이터를 삭제할 때, Doris는 물리적 파일에서 데이터를 즉시 제거하지 않습니다. 대신__DORIS_DELETE_SIGN__이1로 표시된 새 레코드를 씁니다. - 쿼리 필터링: 쿼리 시 Doris는 필터 조건
WHERE __DORIS_DELETE_SIGN__ = 0을 자동으로 추가하여 삭제 표시된 행을 결과에서 제외합니다. - 백그라운드 Compaction: Compaction 프로세스가 동일한 기본 키에 일반 레코드와 삭제 마커 레코드가 모두 있는 것을 감지하면, 병합 과정에서 두 레코드를 물리적으로 제거하여 저장 공간을 확보합니다.
2.4 부분 열 업데이트
2.0 버전부터 Unique Key 모델(MoW)은 부분 열 업데이트를 지원합니다. 데이터 적재 시 기본 키와 업데이트할 열만 제공하면 됩니다. 제공하지 않은 열은 기존 값을 유지합니다.
활성화 방법:
| 데이터 적재 방식 | 활성화 설정 |
|---|---|
INSERT INTO | 세션 변수를 enable_unique_key_partial_update = true로 설정 |
| Stream Load 및 기타 데이터 적재 방식 | partial_columns 매개변수를 true로 설정 |
테이블 생성 시 Merge-on-Write를 활성화해야 합니다.
CREATE TABLE user_profiles (
    user_id BIGINT,
    name STRING,
    age INT,
    last_login DATETIME
)
UNIQUE KEY(user_id)
DISTRIBUTED BY HASH(user_id)
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true"
);

-- Initial data
-- user_id: 1, name: 'Alice', age: 30, last_login: '2023-10-01 10:00:00'

-- Partial update via Stream Load, writing only age and last_login
-- {"user_id": 1, "age": 31, "last_login": "2023-10-26 18:00:00"}

-- Data after update
-- user_id: 1, name: 'Alice', age: 31, last_login: '2023-10-26 18:00:00'
구현 측면에서 Unique Key 모델의 부분 열 업데이트는 데이터를 제자리에서 수정하는 방식이 아닙니다. 데이터 적재 중에 기존 열을 읽고, 누락된 필드를 채운 다음, 전체 행을 다시 씁니다. 이로 인해 읽기 증폭과 쓰기 증폭이 발생합니다. 예를 들어 필드 크기가 비슷한 100개 열의 와이드 테이블에서 10개 필드를 업데이트하면, 1 MB의 실제 업데이트로 약 9 MB의 데이터 읽기와 10 MB의 데이터 쓰기가 발생합니다.
성능 권장 사항:
| 권장 사항 | 설명 |
|---|---|
| SSD 사용 | 부분 열 업데이트는 대량의 랜덤 IO를 발생시킵니다. 기계식 디스크에서는 병목이 크므로 SSD 사용을 권장합니다(NVMe 권장) |
| 와이드 테이블에 행 저장 활성화 | 열이 매우 많은 테이블에서는 한 번의 IO로 전체 행을 읽을 수 있도록 행 저장을 활성화하는 것이 좋습니다. 열 저장 모드에서는 누락된 필드마다 별도의 IO가 필요합니다 |
전체 사용법(Stream Load, INSERT INTO, Flink Connector 등)은 열 업데이트를 참고하세요.
3. 주요 비즈니스 시나리오
3.1 실시간 CDC 동기화
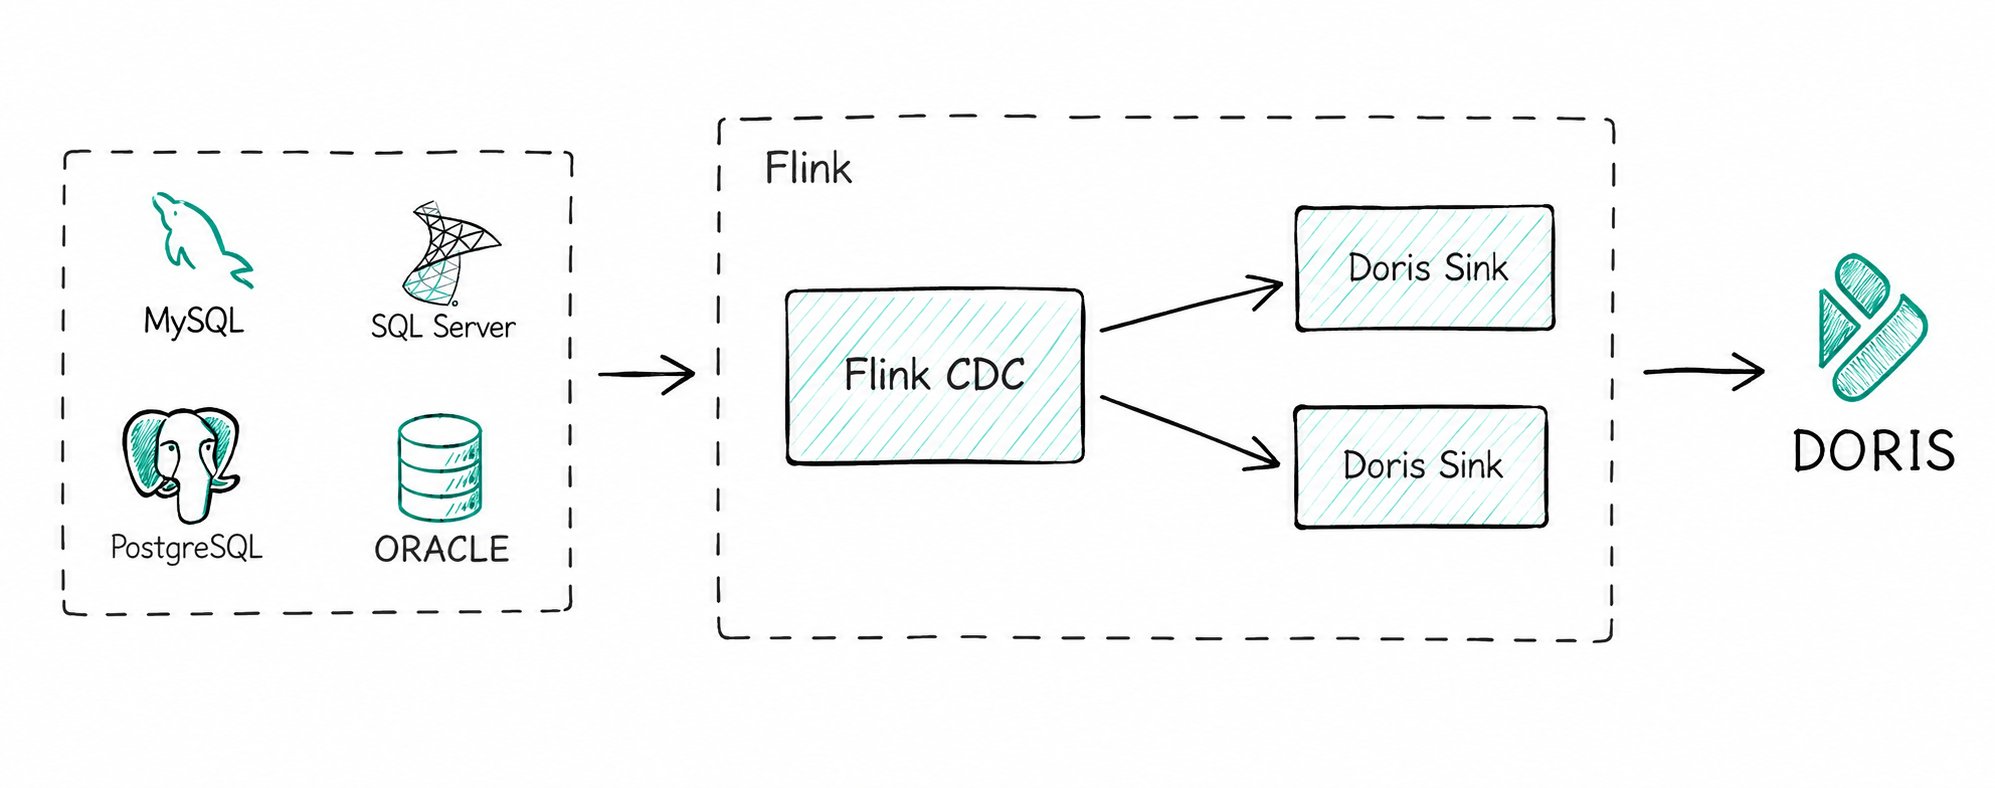
Flink CDC 같은 도구는 업스트림 데이터베이스(MySQL, PostgreSQL, Oracle 등)의 Binlog를 캡처하여 Doris Unique Key 모델 테이블에 기록합니다.
주요 기능:
- 전체 데이터베이스 동기화: Flink Doris Connector는 내부적으로 Flink CDC를 통합하여, 수동으로 테이블을 생성하거나 필드를 매핑하지 않고도 전체 데이터베이스를 종단 간 동기화할 수 있습니다.
- 일관성 보장: 다음 기능을 조합하여 업스트림 데이터베이스의 상태와 일치시킵니다.
- Unique Key 모델의 UPSERT가
INSERT/UPDATE를 처리합니다. __DORIS_DELETE_SIGN__이DELETE를 처리합니다.- Sequence 열(예: Binlog 타임스탬프)이 순서가 뒤바뀐 데이터를 처리합니다.
- Unique Key 모델의 UPSERT가
3.2 실시간 와이드 테이블 구성
부분 열 업데이트를 사용하면 Flink에서 실시간 조인을 수행하지 않고도 Doris 내에서 여러 소스의 데이터를 이용해 와이드 테이블을 직접 구성할 수 있습니다.
- Unique Key 모델의 와이드 테이블을 생성합니다.
- 서로 다른 데이터 소스(기본 정보, 행동 로그, 트랜잭션 데이터 등)가 Stream Load / Routine Load를 통해 이 테이블에 실시간으로 데이터를 씁니다.
- 각 데이터 스트림은 자신이 담당하는 열만 씁니다. 예를 들면 다음과 같습니다.
- 사용자 행동 스트림은
page_view_count와last_login_time을 업데이트합니다. - 트랜잭션 스트림은
total_orders와total_amount를 업데이트합니다.
- 사용자 행동 스트림은
각 스트림은 변경된 열만 쓰므로 IO 오버헤드를 줄이고 실시간 조인의 리소스 사용을 피할 수 있습니다. 여러 스트림이 동시에 업데이트하는 시나리오의 버전 제어는 Unique Key 모델의 다중 스트림 업데이트를 참고하세요.
4. 사용 권장 사항
4.1 일반 권장 사항
| 번호 | 권장 사항 | 설명 |
|---|---|---|
| 1 | 데이터 적재 기반 업데이트 우선 사용 | 고빈도 대용량 업데이트에는 UPDATE DML보다 Stream Load와 Routine Load를 우선 사용하세요 |
| 2 | 배치 쓰기 | 각 INSERT에는 트랜잭션 오버헤드가 있으므로 고빈도 단일 행 INSERT(> 100 TPS)를 피하세요. Group Commit을 활성화하여 소규모 배치 커밋을 병합할 수 있습니다 |
| 3 | Duplicate/Aggregate 모델에서 고빈도 DELETE 사용 시 주의 | 조건식이 누적되면 이후 쿼리 성능에 영향을 줍니다 |
| 4 | 전체 파티션 삭제 시 TRUNCATE PARTITION 사용 | 전체 파티션을 삭제할 때는 TRUNCATE PARTITION이 DELETE보다 훨씬 효율적입니다 |
| 5 | UPDATE를 순차적으로 실행 | 동일한 기본 키에 대해 작업할 가능성이 있는 UPDATE 작업을 동시에 실행하지 마세요 |
4.2 컴퓨팅-스토리지 분리 아키텍처의 Unique Key 모델
Doris 3.0은 컴퓨팅-스토리지 분리 아키텍처를 도입했습니다. 이 아키텍처에서 BE는 상태를 유지하지 않으며, Merge-on-Write는 데이터 적재, Compaction, Schema Change 사이의 쓰기 간 충돌을 해결하기 위해 Meta Service를 통해 전역 상태를 유지해야 합니다. Unique Key 모델의 MoW는 Meta Service 기반의 분산 테이블 잠금을 사용하여 쓰기 일관성을 보장합니다.
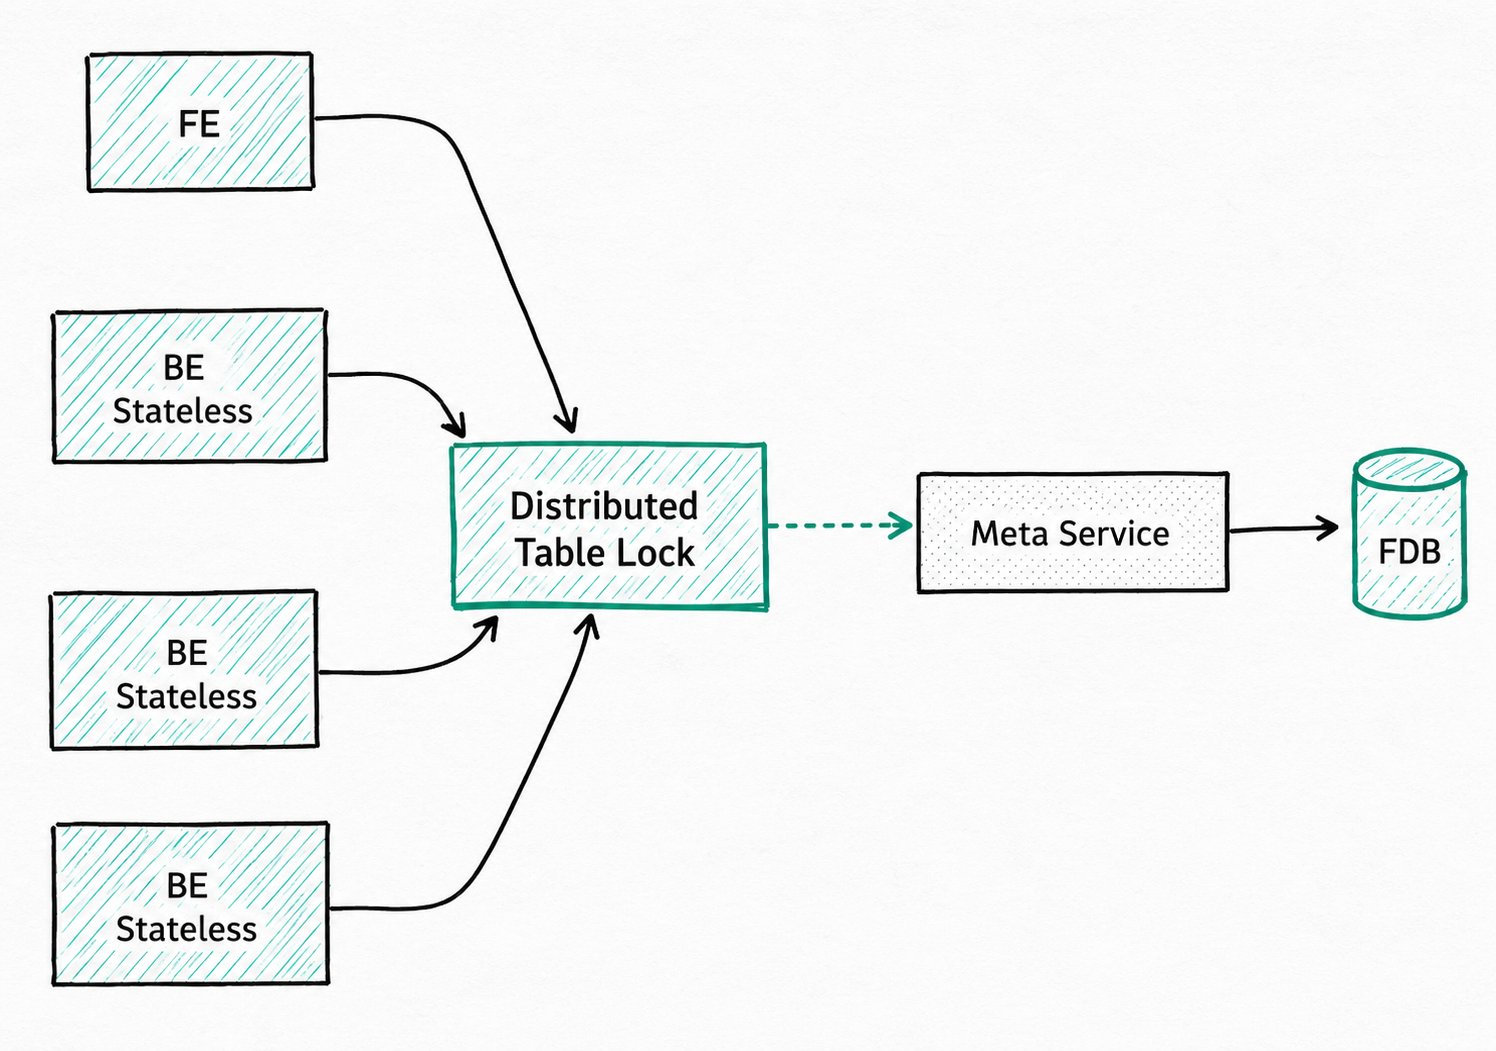
고빈도 데이터 적재와 Compaction은 테이블 잠금 경합을 일으킬 수 있습니다. 이 아키텍처를 사용할 때는 다음 사항을 권장합니다.
- 단일 테이블의 데이터 적재 빈도 제어: 단일 Unique Key 테이블의 데이터 적재 빈도가 초당 60회를 넘지 않도록 권장합니다. 배치 처리나 동시성 조정으로 빈도를 줄일 수 있습니다.
- 파티션과 버킷을 적절하게 설계:
- 파티션: 일별 또는 시간별 파티션을 사용하여 각 데이터 적재가 소수의 파티션만 업데이트하도록 합니다.
- 버킷: 버킷 수(Tablet 수)는 데이터 규모에 맞춰야 하며, 일반적으로 8개에서 64개 사이가 적절합니다. Tablet이 너무 많으면 잠금 경합이 심해집니다.
- Compaction 전략 조정: 쓰기 부하가 높을 때는 Compaction 빈도를 낮춰 데이터 적재 작업과의 잠금 충돌을 줄이세요.
- 최신 버전 사용: 3.1 버전에서는 분산 테이블 잠금 구현이 크게 최적화되었습니다. 최신 안정 버전 사용을 권장합니다.