Query Profile 분석 가이드: Doris에서 느린 쿼리의 성능 병목 찾기
Query Profile은 Apache Doris에서 쿼리 실행 세부 정보를 보여 주는 진단 도구입니다. 각 연산자의 소요 시간, 행 수, 메모리 사용량과 같은 주요 지표를 기록하여 느린 쿼리의 병목을 빠르게 찾을 수 있도록 도와줍니다.
문서를 읽기 전에 다음 사항을 확인하세요.
- Apache Doris 클러스터가 배포되어 있으며, FE 설정 파일인
fe.conf를 수정할 권한이 있습니다. - MySQL 클라이언트로 Doris에 연결되어 있으며,
show query profile과 같은 명령을 실행할 수 있습니다. - 쿼리 계획의 기본 개념(Fragment, PlanNode)을 이해하고 있습니다.
이 문서는 크게 세 부분으로 구성됩니다.
| 구분 | 내용 |
|---|---|
| 전체 아키텍처 | BE에서 Profile을 수집하여 FE에 저장하는 방식 |
| 매개변수 설정 | 불필요한 정보를 걸러 내고 쿼리의 주요 세부 정보에 집중하도록 시스템을 설정하는 방법 |
| 해석 방법 | 쿼리 성능에 영향을 주는 연산자를 빠르게 찾는 방법 |
Query Profile의 전체 아키텍처
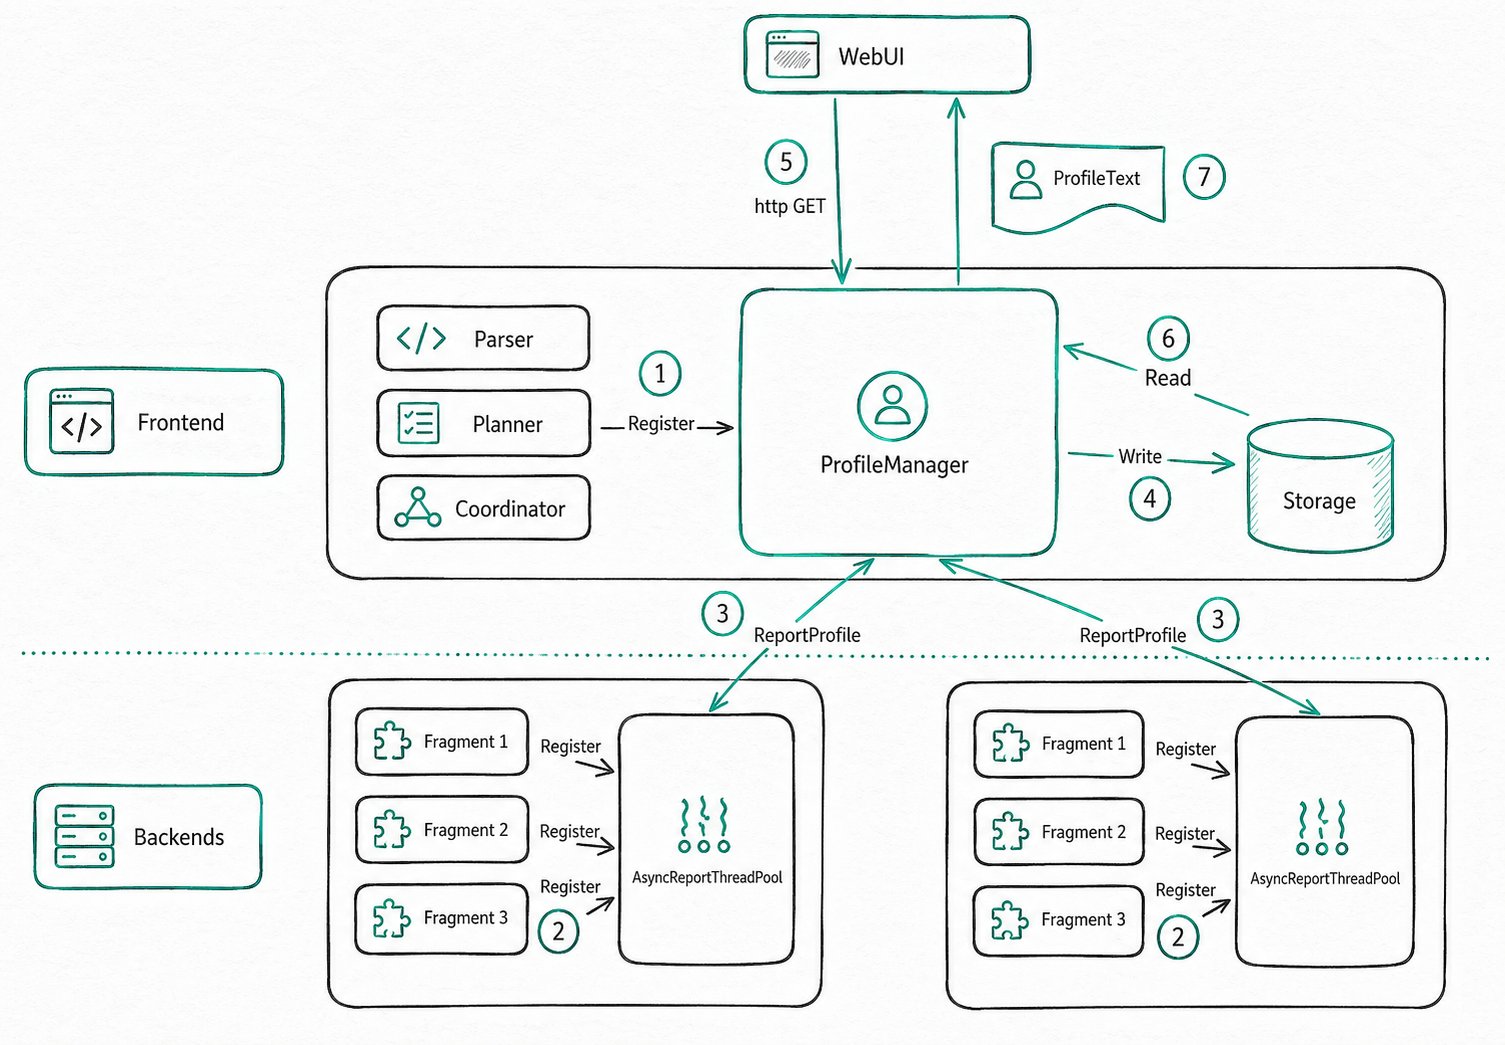
Query Profile의 핵심은 FE의 ProfileManager와 BE의 AsyncReportThreadPool 두 부분으로 구성됩니다.
수집 과정
| 단계 | 주체 | 동작 |
|---|---|---|
| 1 | FE | 사용자가 쿼리를 실행하면 FE가 Profile 데이터 구조를 ProfileManager에 등록합니다 |
| 2 | BE | 쿼리가 완료되면 BE가 자체 Profile을 비동기 보고 작업으로 등록합니다 |
| 3 | BE | AsyncReportThreadPool이 쿼리 단위로 RPC를 실행하여 Profile을 FE에 전송합니다 |
| 4 | FE | 백그라운드 스레드가 Profile을 처리하고 정책에 따라 보관하거나 제거하며, 저장 대상 Profile을 압축한 후 스토리지에 기록합니다 |
| 5 | 사용자 | 사용자가 Web UI 또는 curl HTTP 요청으로 Profile을 조회합니다 |
| 6 | FE | ProfileManager가 메모리 또는 외부 스토리지에서 Profile을 찾아 텍스트로 반환합니다 |
전체 과정에서 Profile 기능에 가장 큰 영향을 주는 부분은 2단계의 비동기 보고와 4단계의 Profile 영구 저장입니다.
비동기 보고 시간 초과
클러스터 부하가 높으면 비동기 보고 시간이 초과될 수 있습니다. FE가 메모리를 과도하게 사용하지 않도록 ProfileManager는 일정 시간 동안 기다린 후 시간이 초과된 Profile을 폐기합니다.
- 조정 방법:
profile_async_collect_expire_time_secs값을fe.conf에서 수정하여 대기 시간을 조정합니다. - 권장 조치: 시간 초과가 자주 발생하면 먼저 서버의 리소스 사용량을 확인하세요. 필요한 경우 전역 Profile을 비활성화하여 위험을 줄이세요.
Profile 영구 저장의 이점
ProfileManager가 Profile을 디스크에 영구 저장하면 다음과 같은 이점이 있습니다.
- Profile이 더 이상 FE 메모리를 대량으로 사용하지 않습니다.
- FE를 재시작한 후에도 이전에 생성된 Profile을 조회할 수 있습니다.
첫 번째 이점 덕분에 FE는 완전한 Profile을 수천 개 보관할 수 있습니다. 두 번째 이점은 업그레이드 전후의 클러스터 성능을 쉽게 비교할 수 있게 해 주므로, 버전 업그레이드가 Doris 쿼리 성능을 개선하는지 확인하는 데 도움이 됩니다.
Profile 설정
매개변수 빠른 참조
| 매개변수 | 범위 | 기본값 | 설명 |
|---|---|---|---|
enable_profile | 세션/전역 | false | Profile 생성 여부 |
profile_level | 세션/전역 | 2 | Profile의 상세 수준(1~3, 4.0+에서 적용) |
auto_profile_threshold_ms | 전역 | -1 | 소요 시간이 임계값을 초과하는 쿼리에 대해서만 Profile 생성(3.0+에서 적용) |
max_query_profile_num | fe.conf | 500 | FE 메모리에 보관할 Profile의 최대 개수 |
max_spilled_profile_num | fe.conf | 500 | 디스크에 보관할 Profile의 최대 개수 |
spilled_profile_storage_path | fe.conf | log/profile | Profile의 로컬 저장 디렉터리 |
spilled_profile_storage_limit_bytes | fe.conf | 1 GB | 디스크에 저장할 Profile의 총 용량 한도 |
아래의 보관 파일 예제와 ChangedSessionVariables 예제에는 과거에 수집한 Profile이 포함되어 있습니다. 이 예제의 profile_level 기본값인 1은 현재 기본값이 아니라 수집 당시 버전의 기본값입니다.
4.1.5부터 Master FE로 전달되는 쿼리는 세션의 profile_level을 유지합니다. 설정 가능한 값은 세션 변수 참조를 확인하세요.
Profile 활성화
enable_profile
- 용도: Profile 생성 여부를 제어합니다.
- 명령:
set enable_profile=true; - 설명: 기본값은
false입니다. 비활성화하면show query profile을 실행해도 새로 생성된 기록이 반환되지 않습니다.
mysql> select 1;
--------------
select 1
--------------

+------+
| 1    |
+------+
|    1 |
+------+
1 row in set (0.00 sec)

mysql> show query profile;
--------------
show query profile
--------------

+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| Profile ID                        | Task Type | Start Time          | End Time            | Total | Task State | User | Default Catalog | Default Db | Sql Statement |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| 74b9e30d6ba7491d-9dbf9289f6f5c208 | QUERY     | 2025-02-26 18:47:07 | 2025-02-26 18:47:07 | 4ms   | EOF        | root | internal        | tpcds      | select 1      |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
1 row in set (0.01 sec)

mysql> set enable_profile=false;
--------------
set enable_profile=false
--------------

Query OK, 0 rows affected (0.00 sec)

mysql> select 1;
--------------
select 1
--------------

+------+
| 1    |
+------+
|    1 |
+------+
1 row in set (0.01 sec)

mysql> show query profile;
--------------
show query profile
--------------

+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| Profile ID                        | Task Type | Start Time          | End Time            | Total | Task State | User | Default Catalog | Default Db | Sql Statement |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| 74b9e30d6ba7491d-9dbf9289f6f5c208 | QUERY     | 2025-02-26 18:47:07 | 2025-02-26 18:47:07 | 4ms   | EOF        | root | internal        | tpcds      | select 1      |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
1 row in set (0.00 sec)
profile_level
- 용도: Profile의 상세 수준을 제어합니다.
- 명령:
set profile_level=2; - 설명: 기본값은
2입니다. 이 매개변수는 4.0 이상 버전에서 적용됩니다. 4.0 이전 버전에서는 의미가 다르므로 사용하지 마세요.
| 수준 | 동작 | 성능 영향 |
|---|---|---|
| 1 | BE가 간소화된 Profile만 보고합니다. 이 정보만으로도 FE에서 MergedProfile로 집계할 수 있습니다 | 매우 작음 |
| 2(기본값) | 심층 분석에 적합한 더 상세한 Counter를 출력합니다 | 작음 |
| 3 | 가장 세밀한 수준입니다. 일부 Counter를 수집하면 쿼리 성능에 영향을 줄 수 있습니다 | 큼 |
예: profile_level=1일 때 EXCHANGE_OPERATOR의 Counter는 다음과 같습니다.
EXCHANGE_OPERATOR(id=1):
     - InstanceID: ef33b72e30b84b68-82ad027edbee5910
     - BlocksProduced: 1
     - CloseTime: 4.243us
     - ExecTime: 30.834us
     - InitTime: 20.902us
     - MemoryUsage: 0.00
     - MemoryUsagePeak: 36.00 KB
     - OpenTime: 1.93us
     - ProjectionTime: 0ns
     - RowsProduced: 10
     - WaitForDependencyTime: 0ns
       - WaitForData0: 635.324us
profile_level=2일 때는 더 상세한 Counter를 확인할 수 있습니다.
EXCHANGE_OPERATOR(id=1):
     - InstanceID: 514023de1b7b41a3-9e59e43c591103a2
     - BlocksProduced: 1
     - CloseTime: 3.523us
     - CreateMergerTime: 0ns
     - DataArrivalWaitTime: 0ns
     - DecompressBytes: 0.00
     - DecompressTime: 0ns
     - DeserializeRowBatchTimer: 0ns
     - ExecTime: 28.439us
     - FilterTime: 287ns
     - FirstBatchArrivalWaitTime: 0ns
     - GetDataFromRecvrTime: 3.482us
     - InitTime: 18.258us
     - LocalBytesReceived: 36.00 KB
     - MaxFindRecvrTime(NS): 0
     - MaxWaitForWorkerTime: 0
     - MaxWaitToProcessTime: 0
     - MemoryUsage: 0.00
     - MemoryUsagePeak: 36.00 KB
     - OpenTime: 1.44us
     - ProjectionTime: 0ns
     - RemoteBytesReceived: 0.00
     - RowsProduced: 10
     - SendersBlockedTotalTimer(*): 0ns
     - WaitForDependencyTime: 0ns
       - WaitForData0: 596.708us
auto_profile_threshold_ms
- 용도: 소요 시간이 임계값을 초과하는 쿼리에 대해서만 Profile을 생성하여, 소규모 쿼리의 Profile에 느린 쿼리의 Profile이 묻히지 않도록 합니다.
- 명령:
set global auto_profile_threshold_ms=1000; - 설명: 기본값은
-1이며, 모든 쿼리에 대해 Profile을 생성한다는 의미입니다. 이 매개변수는 3.0 이상 버전에서 적용됩니다.
이 매개변수가 필요한 이유는 무엇일까요? Profile을 전역으로 활성화하면 대량의 데이터가 생성되어 FE의 CPU, 메모리, 디스크를 사용하며, 지연 시간에 민감한 소규모 쿼리에도 영향을 줍니다. 따라서 FE는 주기적으로 Profile을 정리합니다. 이 매개변수를 사용하면 느린 쿼리의 Profile이 묻히지 않도록 할 수 있습니다.
예: Profile이 전역으로 활성화되어 모든 쿼리가 Profile을 생성한다고 가정합니다.
mysql> show query profile;
--------------
show query profile
--------------

+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| Profile ID                        | Task Type | Start Time          | End Time            | Total | Task State | User | Default Catalog | Default Db | Sql Statement |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| d59b04f636e49c0-bf6b6b3011c40f67  | QUERY     | 2025-02-26 18:25:59 | 2025-02-26 18:25:59 | 3ms   | EOF        | root | internal        | tpcds      | select 1      |
| f2ccb78011aa4526-9919ee76af1e57d7 | QUERY     | 2025-02-26 18:25:59 | 2025-02-26 18:25:59 | 4ms   | EOF        | root | internal        | tpcds      | select 1      |
| a8464728ebf5481d-864e3016ad22f045 | QUERY     | 2025-02-26 18:25:58 | 2025-02-26 18:25:58 | 6ms   | EOF        | root | internal        | tpcds      | select 1      |
| 912b09ea8f634c47-89e65d4fe354a94b | QUERY     | 2025-02-26 18:25:58 | 2025-02-26 18:25:58 | 4ms   | EOF        | root | internal        | tpcds      | select 1      |
| e6e6f0a3a31640bc-ad5994de0334ae8d | QUERY     | 2025-02-26 18:25:57 | 2025-02-26 18:25:57 | 4ms   | EOF        | root | internal        | tpcds      | select 1      |
| b28da27b4cc847a7-82e239320d6facc5 | QUERY     | 2025-02-26 18:25:57 | 2025-02-26 18:25:57 | 4ms   | EOF        | root | internal        | tpcds      | select 1      |
| fec3cdcd4664408c-a38508ce3a2bbe32 | QUERY     | 2025-02-26 18:24:48 | 2025-02-26 18:24:48 | 6ms   | EOF        | root | internal        | tpcds      | select 1      |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
7 rows in set (0.00 sec)
이러한 소규모 쿼리의 Profile 생성을 중지하려면 다음과 같이 실행합니다.
mysql> clean all profile;
--------------
clean all profile
--------------

Query OK, 0 rows affected (0.01 sec)

mysql> set global auto_profile_threshold_ms=1000;
--------------
set global auto_profile_threshold_ms=1000
--------------

Query OK, 0 rows affected (0.01 sec)

mysql> select 1;
--------------
select 1
--------------

+------+
| 1    |
+------+
|    1 |
+------+
1 row in set (0.05 sec)

mysql> select 1;
--------------
select 1
--------------

+------+
| 1    |
+------+
|    1 |
+------+
1 row in set (0.01 sec)

mysql> show query profile;
--------------
show query profile
--------------

Empty set (0.00 sec)
Profile 저장 설정
Doris는 더 많은 기록을 보관할 수 있도록 Profile을 FE의 로컬 디스크에 영구 저장하는 기능을 지원합니다. fe.conf의 다음 매개변수로 이를 제어할 수 있습니다.
| 매개변수 | 기본값 | 설명 |
|---|---|---|
max_query_profile_num | 500 | FE 메모리에 보관할 Profile의 최대 개수입니다. 초과하면 가장 오래된 항목부터 제거합니다 |
max_spilled_profile_num | 500 | 디스크에 보관할 Profile의 최대 개수입니다. 초과하면 가장 오래된 항목부터 삭제합니다 |
spilled_profile_storage_path | log/profile | Profile의 로컬 저장 디렉터리 |
spilled_profile_storage_limit_bytes | 1 GB | 디스크에 보관할 Profile의 총 용량 한도 |
Profile 조회
| 방법 | 적합한 상황 | 접근 위치 |
|---|---|---|
| FE Web UI | 일상적인 문제 해결, 시각적 조회 | ip:http_port의 QueryProfile 페이지 |
| 명령줄 | 보안 제한이 있는 환경, 일괄 다운로드 | show query profile + curl |
| 디스크 파일 직접 읽기 | 영구 저장된 Profile에 빠르게 접근 | log/profile 디렉터리의 zip 파일 |
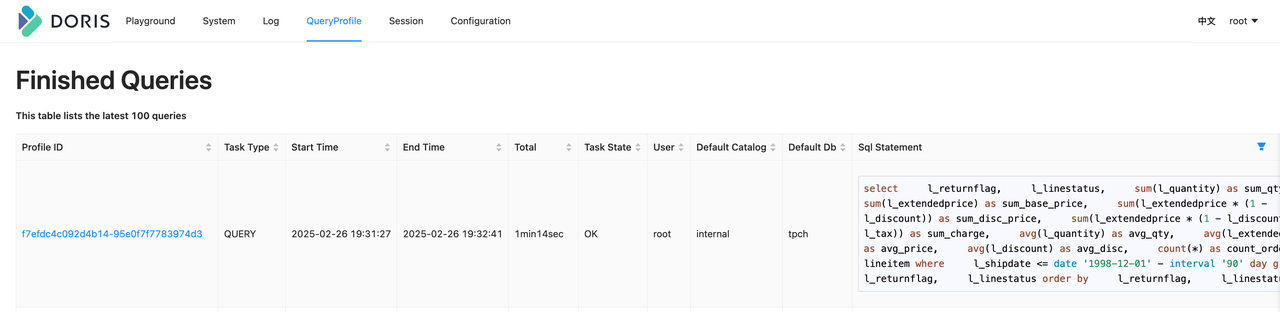
FE Web UI에서 조회
-
용도: 브라우저에서 FE에 있는 모든 쿼리의 Profile을 조회합니다.
-
사용 방법: FE의
ip:http_port에 접속하고 사용자 이름과 비밀번호를 입력하여 QueryProfile 페이지로 이동한 다음, Profile ID를 클릭하여 세부 정보를 확인합니다. -
설명:
- Profile은 SQL을 실행한 FE에만 존재하며, 여러 FE 간에 동기화되지 않습니다. Profile을 조회하려면 해당 SQL을 실행한 FE에 연결해야 합니다.
- 모든 데이터 적재 작업은 최종적으로 FE Master에서 실행되므로, 해당 Profile은 FE Master에서 조회해야 합니다.
명령줄에서 조회
보안 제한이 있는 경우와 같은 일부 환경에서는 FE Web UI에 접근할 수 없습니다. 이때는 명령줄에서 Profile을 조회할 수 있습니다.
1단계: show query profile을 사용하여 가장 최근 Profile 20개의 메타데이터를 조회합니다.
mysql> show query profile;
--------------
show query profile
--------------

+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| Profile ID                        | Task Type | Start Time          | End Time            | Total | Task State | User | Default Catalog | Default Db | Sql Statement |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
| c7f48291d62147f4-92b1a511f6fe3395 | QUERY     | 2025-02-26 19:35:15 | 2025-02-26 19:35:15 | 5ms   | EOF        | root | internal        | tpch       | select 20     |
| 9c6cd24d2f354c6f-9652c097cae00b05 | QUERY     | 2025-02-26 19:35:12 | 2025-02-26 19:35:12 | 4ms   | EOF        | root | internal        | tpch       | select 19     |
| b908f7b484084492-9c4dc48762c9cb89 | QUERY     | 2025-02-26 19:35:09 | 2025-02-26 19:35:09 | 5ms   | EOF        | root | internal        | tpch       | select 18     |
| ef411c0eb00541dc-ba5a39677be3e117 | QUERY     | 2025-02-26 19:35:06 | 2025-02-26 19:35:06 | 5ms   | EOF        | root | internal        | tpch       | select 17     |
| c89deefa85974da7-ad53cb3d6f4cad75 | QUERY     | 2025-02-26 19:35:03 | 2025-02-26 19:35:03 | 5ms   | EOF        | root | internal        | tpch       | select 16     |
| dd97a36d2a1f4cbc-b23f13b975cd2dde | QUERY     | 2025-02-26 19:34:59 | 2025-02-26 19:34:59 | 6ms   | EOF        | root | internal        | tpch       | select 15     |
| af75095f7a7c4d9f-9422d04d0604f904 | QUERY     | 2025-02-26 19:34:56 | 2025-02-26 19:34:56 | 8ms   | EOF        | root | internal        | tpch       | select 14     |
| 2764a7aaf2cf446d-922b4c5b5f853788 | QUERY     | 2025-02-26 19:34:54 | 2025-02-26 19:34:54 | 10ms  | EOF        | root | internal        | tpch       | select 13     |
| bf15d7d96b9c4f6b-8e6fe4c40b077ae8 | QUERY     | 2025-02-26 19:34:53 | 2025-02-26 19:34:53 | 9ms   | EOF        | root | internal        | tpch       | select 12     |
| ebf2221627b0435e-9bafebbe46d7315d | QUERY     | 2025-02-26 19:34:51 | 2025-02-26 19:34:51 | 7ms   | EOF        | root | internal        | tpch       | select 11     |
| 3309a4c57f61471c-9c863f6bb72a146b | QUERY     | 2025-02-26 19:34:50 | 2025-02-26 19:34:50 | 10ms  | EOF        | root | internal        | tpch       | select 10     |
| cb764ed358f34312-a7c56cbf7f521761 | QUERY     | 2025-02-26 19:34:48 | 2025-02-26 19:34:48 | 10ms  | EOF        | root | internal        | tpch       | select 9      |
| 38878f3344b649ff-a69f1c8cd0dc1960 | QUERY     | 2025-02-26 19:34:46 | 2025-02-26 19:34:46 | 9ms   | EOF        | root | internal        | tpch       | select 8      |
| 1182dc4c8105407c-b77c50a993cc0cb1 | QUERY     | 2025-02-26 19:34:42 | 2025-02-26 19:34:42 | 14ms  | EOF        | root | internal        | tpch       | select 7      |
| 8596d808d2814e8d-aefbac7d30a599d1 | QUERY     | 2025-02-26 19:34:40 | 2025-02-26 19:34:40 | 31ms  | EOF        | root | internal        | tpch       | select 6      |
| 325a66e868844aa4-90fae17f3a98d3e6 | QUERY     | 2025-02-26 19:34:38 | 2025-02-26 19:34:38 | 40ms  | EOF        | root | internal        | tpch       | select 5      |
| e30d1166a2674393-997246e064a7674c | QUERY     | 2025-02-26 19:34:36 | 2025-02-26 19:34:36 | 19ms  | EOF        | root | internal        | tpch       | select 4      |
| 4dfb91db8b448db-a4eab023bc119cea  | QUERY     | 2025-02-26 19:34:33 | 2025-02-26 19:34:33 | 14ms  | EOF        | root | internal        | tpch       | select 3      |
| 1453559772434cda-b64c2eae47ce6424 | QUERY     | 2025-02-26 19:34:31 | 2025-02-26 19:34:31 | 10ms  | EOF        | root | internal        | tpch       | select 2      |
| cbf8bf829740488c-b6da653e391b13c6 | QUERY     | 2025-02-26 19:34:30 | 2025-02-26 19:34:30 | 20ms  | EOF        | root | internal        | tpch       | select 1      |
+-----------------------------------+-----------+---------------------+---------------------+-------+------------+------+-----------------+------------+---------------+
20 rows in set (0.00 sec)
2단계: curl로 HTTP API에 접근하여 특정 Profile을 조회합니다. 예를 들어, ID가 f7efdc4c092d4b14-95e0f7f7783974d3인 Profile을 조회하려면 다음과 같이 실행합니다.
curl -uroot: http://127.0.0.1:5937/api/profile/text?query_id=f7efdc4c092d4b14-95e0f7f7783974d3 > f7efdc4c092d4b14-95e0f7f7783974d3.profile
결과는 Web UI에서 조회한 내용과 같습니다.
> head f7efdc4c092d4b14-95e0f7f7783974d3.profile -n 10
Summary:
   - Profile ID: f7efdc4c092d4b14-95e0f7f7783974d3
   - Task Type: QUERY
   - Start Time: 2025-02-26 19:31:27
   - End Time: 2025-02-26 19:32:41
   - Total: 1min14sec
   - Task State: OK
   - User: root
   - Default Catalog: internal
   - Default Db: tpch
디스크에서 Profile 파일 직접 조회
3.0부터 Profile의 영구 저장을 지원하며, 기본 저장 디렉터리는 log/profile입니다. 빠르게 확인하려면 unzip으로 대상 파일의 압축을 직접 풀어 텍스트 형식으로 읽을 수 있습니다.
참고 사항:
- Doris FE에는
log/profile디렉터리에 대한 보호 메커니즘이 있습니다. 압축을 푼 파일을 해당 디렉터리에 두지 마세요. 그대로 두면 삭제됩니다. - Profile 텍스트는 Web UI에 표시되는 내용과 약간 다릅니다.
Summary는 JSON 메타데이터로 저장되며, 나머지는 Web UI와 동일합니다.
[hezhiqiang@VM-10-2-centos log]$ unzip profile/1740745121714_33bf38e988ea4945-b585d2f74d1da3fd.zip
Archive:  profile/1740745121714_33bf38e988ea4945-b585d2f74d1da3fd.zip
  inflating: 33bf38e988ea4945-b585d2f74d1da3fd.profile
[hezhiqiang@VM-10-2-centos log]$ head 33bf38e988ea4945-b585d2f74d1da3fd.profile -n 10
{"summaryProfile":{"counterTotalTime":{"value":0,"type":5,"level":1},"localTimePercent":0.0,"infoStrings":{"Distributed Plan":"N/A","Task Type":"QUERY","User":"root","Default Catalog":"internal","Total":"9sec745ms","Default Db":"tpch","Profile ID":"33bf38e988ea4945-b585d2f74d1da3fd","Task State":"OK","Sql Statement":"SELECT      c.c_name,      COUNT(o.o_orderkey) AS total_orders,      SUM(o.o_totalprice) AS total_spent FROM      customer c JOIN      orders o ON c.c_custkey = o.o_custkey GROUP BY      c.c_name limit 20","Start Time":"2025-02-28 20:18:31","End Time":"2025-02-28 20:18:41"}, ...}
Changed Session Variables:
VarName                       | CurrentValue | DefaultValue
------------------------------|--------------|-------------
insert_visible_timeout_ms     | 10000        | 60000
fetch_splits_max_wait_time_ms | 4000         | 1000
exec_mem_limit                | 2147483648   | 100147483648
profile_level                 | 2            | 1
auto_profile_threshold_ms     | 1            | -1
Profile 구조
Profile의 내용은 다음 다섯 부분으로 나뉩니다.
| 부분 | 용도 | 활용 시점 |
|---|---|---|
| Summary | 조회에 사용하는 주요 필드를 기록하는 Profile 메타데이터 | Profile 검색, 쿼리 기본 정보 확인 |
| ExecutionSummary | 각 Planner 단계의 소요 시간을 포함하는 실행 과정 요약 | SQL 컴파일/계획 수립 단계의 소요 시간 문제 해결 |
| ChangedSessionVariables | 이 쿼리 실행 과정에서 변경된 세션 변수 | 비정상적인 설정으로 인한 성능 문제 해결 |
| MergedProfile | DetailProfile의 집계 결과 | 쿼리 구조를 빠르게 파악하고, 병목 연산자를 찾고, 데이터 편향 비교 |
| DetailProfile | 모든 BE에서 각 Fragment와 각 Pipeline의 PipelineTask에 대한 실행 세부 정보 | 병목을 찾은 후 심층 분석 |
1. Summary
SummaryProfile은 Profile의 메타데이터로, Profile ID와 Total 등 조회에 사용하는 주요 필드를 기록합니다.
-  Profile  ID:  d4d281168bf7490a-a133623295744f85
-  Task  Type:  QUERY
-  Start  Time:  2025-02-28  19:23:14
-  End  Time:  2025-02-28  19:23:16
-  Total:  2sec420ms
-  Task  State:  OK
2. ExecutionSummary
실행 과정을 요약합니다. 이 중 Plan 관련 필드는 Planner의 소요 시간을 기록합니다.
3. ChangedSessionVariables
이 쿼리 실행 과정에서 변경된 세션 변수를 기록합니다.
ChangedSessionVariables:
VarName                       | CurrentValue | DefaultValue
------------------------------|--------------|-------------
insert_visible_timeout_ms     | 10000        | 60000
fetch_splits_max_wait_time_ms | 4000         | 1000
exec_mem_limit                | 2147483648   | 100147483648
profile_level                 | 2            | 1
auto_profile_threshold_ms     | 1            | -1
위 테이블은 이 쿼리가 실행되기 전에 세션 변수 5개가 변경되었음을 보여 줍니다.
4. MergedProfile
MergedProfile은 DetailProfile의 집계 결과입니다. 주요 용도는 세 가지입니다.
-
쿼리 계획과 Pipeline의 구조를 빠르게 파악
Doris 쿼리 계획은 Query, Fragment, PlanNode의 계층 구조로 이루어져 있습니다. 실행 계층에서는 Pipeline 단위로 작업을 스케줄링하며, 각 Pipeline은 여러 Operator로 구성됩니다. MergedProfile은 이러한 변환 관계를 명확하게 보여 줍니다.
-
성능 병목 연산자를 빠르게 파악
성능 문제를 찾을 때는 일반적으로 병목을 일으키는 구체적인 연산자를 식별해야 합니다. 먼저 MergedProfile에서
DependencyWaitTime을 기준으로 소요 시간이 가장 긴 연산자를 찾은 다음, DetailProfile에서 해당 연산자의 세부 정보를 확인하여 병목을 더 정확하게 파악합니다. -
데이터 편향 비교
MergedProfile은 연산자 간 데이터 흐름의 세부 정보를 기록합니다.
InputRows와RowsProduced를 비교하면 서로 다른 Backend에 데이터가 불균등하게 분포되어 있는지 판단할 수 있습니다. 데이터 분포가 불균등하면 쿼리가 느려지거나 실패하는 경우가 많습니다.
5. DetailProfile
실행 세부 정보입니다. DetailProfile은 모든 Backend에서 쿼리의 각 Fragment와 Pipeline에 속한 각 PipelineTask의 실행 세부 정보를 기록합니다. MergedProfile로 병목을 확인한 후에는 보통 DetailProfile을 함께 살펴보며 심층 분석합니다.
Profile 해석 예제
다음 예제에서는 Aggregation, Join, Scan을 포함하는 일반적인 쿼리를 사용하여 Profile 해석 방법을 설명합니다. 이 쿼리는 TPCH 데이터셋의 customer 테이블과 orders 테이블을 JOIN한 다음 결과를 집계합니다.
SELECT c.c_name,
       Count(o.o_orderkey) AS total_orders,
       Sum(o.o_totalprice) AS total_spent
FROM   customer c
       JOIN orders o
         ON c.c_custkey = o.o_custkey
GROUP  BY c.c_name
LIMIT  20
Profile이 지나치게 길어지지 않도록 쿼리 병렬도를 제한합니다.
set parallel_pipeline_task_num=2;
위 쿼리를 실행하고 Web UI에서 Profile을 조회한 후, 먼저 MergedProfile을 살펴봅니다. 전체 구조에 집중할 수 있도록 아래에는 주요 필드만 남겼습니다. 다른 필드의 의미는 관련 문서를 참고하세요.
MergedProfile:
     Fragments:
       Fragment 0:
         Pipeline 0(instance_num=1):
           RESULT_SINK_OPERATOR(id=0):
             CommonCounters:
                - ExecTime: avg 176.545us, max 176.545us, min 176.545us
                - InputRows: sum 20, avg 20, max 20, min 20
                - WaitForDependency[RESULT_SINK_OPERATOR_DEPENDENCY]Time: avg 0ns, max 0ns, min 0ns
             CustomCounters:
           EXCHANGE_OPERATOR(id=8):
             CommonCounters:
                - ExecTime: avg 84.559us, max 84.559us, min 84.559us
                - RowsProduced: sum 20, avg 20, max 20, min 20
             CustomCounters:
                - WaitForDependencyTime: avg 0ns, max 0ns, min 0ns
                  - WaitForData0: avg 11sec450ms, max 11sec450ms, min 11sec450ms
       Fragment 1:
         Pipeline 0(instance_num=2):
           DATA_STREAM_SINK_OPERATOR(dest_id=8):
             CommonCounters:
                - ExecTime: avg 31.515us, max 33.405us, min 29.626us
                - InputRows: sum 20, avg 10, max 11, min 9
                - WaitForDependencyTime: avg 0ns, max 0ns, min 0ns
                  - WaitForRpcBufferQueue: avg 0ns, max 0ns, min 0ns
             CustomCounters:
                - BlocksProduced: sum 2, avg 1, max 1, min 1
           SORT_OPERATOR(nereids_id=443)(id=7):
             CommonCounters:
                - ExecTime: avg 980ns, max 1.199us, min 762ns
                - RowsProduced: sum 20, avg 10, max 11, min 9
                - WaitForDependency[SORT_OPERATOR_DEPENDENCY]Time: avg 11sec450ms, max 11sec450ms, min 11sec450ms
             CustomCounters:
         Pipeline 1(instance_num=2):
           SORT_SINK_OPERATOR(nereids_id=443)(id=7):
             CommonCounters:
                - ExecTime: avg 49.414us, max 54.802us, min 44.27us
                - InputRows: sum 20, avg 10, max 11, min 9
                - WaitForDependency[SORT_SINK_OPERATOR_DEPENDENCY]Time: avg 0ns, max 0ns, min 0ns
             CustomCounters:
           AGGREGATION_OPERATOR(nereids_id=438)(id=6):
             CommonCounters:
                - ExecTime: avg 34.521us, max 36.402us, min 32.640us
                - RowsProduced: sum 20, avg 10, max 11, min 9
                - WaitForDependency[AGGREGATION_OPERATOR_DEPENDENCY]Time: avg 11sec450ms, max 11sec450ms, min 11sec450ms
             CustomCounters:
         Pipeline 2(instance_num=2):
           AGGREGATION_SINK_OPERATOR(nereids_id=438)(id=6):
             CommonCounters:
                - ExecTime: avg 109.89us, max 118.582us, min 99.596us
                - InputRows: sum 40, avg 20, max 22, min 18
                - WaitForDependency[AGGREGATION_SINK_OPERATOR_DEPENDENCY]Time: avg 0ns, max 0ns, min 0ns
             CustomCounters:
           EXCHANGE_OPERATOR(id=5):
             CommonCounters:
                - ExecTime: avg 29.741us, max 34.521us, min 24.962us
                - RowsProduced: sum 40, avg 20, max 22, min 18
             CustomCounters:
                - WaitForDependencyTime: avg 0ns, max 0ns, min 0ns
                  - WaitForData0: avg 11sec450ms, max 11sec450ms, min 11sec450ms
       Fragment 2:
         Pipeline 0(instance_num=2):
           DATA_STREAM_SINK_OPERATOR(dest_id=5):
             CommonCounters:
                - ExecTime: avg 71.148us, max 73.242us, min 69.54us
                - InputRows: sum 40, avg 20, max 20, min 20
                - WaitForDependencyTime: avg 0ns, max 0ns, min 0ns
                  - WaitForRpcBufferQueue: avg 0ns, max 0ns, min 0ns
             CustomCounters:
           AGGREGATION_OPERATOR(nereids_id=428)(id=4):
             CommonCounters:
                - ExecTime: avg 350.431us, max 393.100us, min 307.762us
                - RowsProduced: sum 40, avg 20, max 20, min 20
                - WaitForDependency[AGGREGATION_OPERATOR_DEPENDENCY]Time: avg 11sec30ms, max 11sec450ms, min 10sec610ms
             CustomCounters:
         Pipeline 1(instance_num=2):
           AGGREGATION_SINK_OPERATOR(nereids_id=428)(id=4):
             CommonCounters:
                - ExecTime: avg 442.308ms, max 449.109ms, min 435.506ms
                - InputRows: sum 150.0M (150000000), avg 75.0M (75000000), max 75.000001M (75000001), min 74.999999M (74999999)
                - MemoryUsage: sum 2.05 MB, avg 1.03 MB, max 1.03 MB, min 1.03 MB
                - MemoryUsagePeak: sum 2.05 MB, avg 1.03 MB, max 1.03 MB, min 1.03 MB
                - WaitForDependency[AGGREGATION_SINK_OPERATOR_DEPENDENCY]Time: avg 0ns, max 0ns, min 0ns
             CustomCounters:
                - MemoryUsageHashTable: sum 1.03 MB, avg 526.28 KB, max 526.28 KB, min 526.28 KB
                - MemoryUsageSerializeKeyArena: sum 1.02 MB, avg 524.00 KB, max 524.00 KB, min 524.00 KB
           HASH_JOIN_OPERATOR(nereids_id=418)(id=3):
             CommonCounters:
                - ExecTime: avg 9sec169ms, max 9sec582ms, min 8sec756ms
                - RowsProduced: sum 150.0M (150000000), avg 75.0M (75000000), max 75.000001M (75000001), min 74.999999M (74999999)
                - WaitForDependency[HASH_JOIN_OPERATOR_DEPENDENCY]Time: avg 949.860ms, max 962.978ms, min 936.743ms
             CustomCounters:
                - ProbeRows: sum 150.0M (150000000), avg 75.0M (75000000), max 75.000001M (75000001), min 74.999999M (74999999)
           OLAP_SCAN_OPERATOR(nereids_id=397. table_name=orders(orders))(id=2):
             CommonCounters:
                - ExecTime: avg 396.233ms, max 410.306ms, min 382.160ms
                - RowsProduced: sum 150.0M (150000000), avg 75.0M (75000000), max 75.000001M (75000001), min 74.999999M (74999999)
             CustomCounters:
                - WaitForDependency[OLAP_SCAN_OPERATOR_DEPENDENCY]Time: avg 0ns, max 0ns, min 0ns
         Pipeline 2(instance_num=2):
           HASH_JOIN_SINK_OPERATOR(nereids_id=418)(id=3):
             CommonCounters:
                - ExecTime: avg 445.146ms, max 890.258ms, min 34.635us
                - InputRows: sum 15.0M (15000000), avg 7.5M (7500000), max 15.0M (15000000), min 0
                - WaitForDependency[HASH_JOIN_SINK_OPERATOR_DEPENDENCY]Time: avg 482.355ms, max 964.711ms, min 0ns
             CustomCounters:
                - MemoryUsageHashTable: sum 185.22 MB, avg 92.61 MB, max 185.22 MB, min 0.00
           EXCHANGE_OPERATOR(id=1):
             CommonCounters:
                - ExecTime: avg 10.131ms, max 20.243ms, min 19.26us
                - RowsProduced: sum 15.0M (15000000), avg 7.5M (7500000), max 15.0M (15000000), min 0
             CustomCounters:
                - WaitForDependencyTime: avg 0ns, max 0ns, min 0ns
                  - WaitForData0: avg 47.582ms, max 47.582ms, min 47.582ms
       Fragment 3:
         Pipeline 0(instance_num=2):
           DATA_STREAM_SINK_OPERATOR(dest_id=1):
             CommonCounters:
                - ExecTime: avg 3.269ms, max 3.281ms, min 3.258ms
                - InputRows: sum 15.0M (15000000), avg 7.5M (7500000), max 7.500001M (7500001), min 7.499999M (7499999)
                - WaitForDependencyTime: avg 0ns, max 0ns, min 0ns
                  - WaitForLocalExchangeBuffer0: avg 142.859ms, max 285.713ms, min 6.733us
                  - WaitForRpcBufferQueue: avg 0ns, max 0ns, min 0ns
             CustomCounters:
           OLAP_SCAN_OPERATOR(nereids_id=403. table_name=customer(customer))(id=0):
             CommonCounters:
                - ExecTime: avg 77.435ms, max 78.752ms, min 76.118ms
                - RowsProduced: sum 15.0M (15000000), avg 7.5M (7500000), max 7.500001M (7500001), min 7.499999M (7499999)
             CustomCounters:
                - WaitForDependency[OLAP_SCAN_OPERATOR_DEPENDENCY]Time: avg 49.690ms, max 50.522ms, min 48.858ms
위 내용은 간소화된 MergedProfile입니다. Doris 쿼리 계획은 Query, Fragment, PlanNode의 세 계층으로 구성되며, Backend의 실행 엔진은 여기에 Pipeline과 Operator라는 두 계층을 추가합니다. 아래 그림은 먼저 쿼리 계획의 관점에서 위 쿼리가 세 계층으로 나뉘는 모습을 보여 줍니다.
Query, Fragment, PlanNode
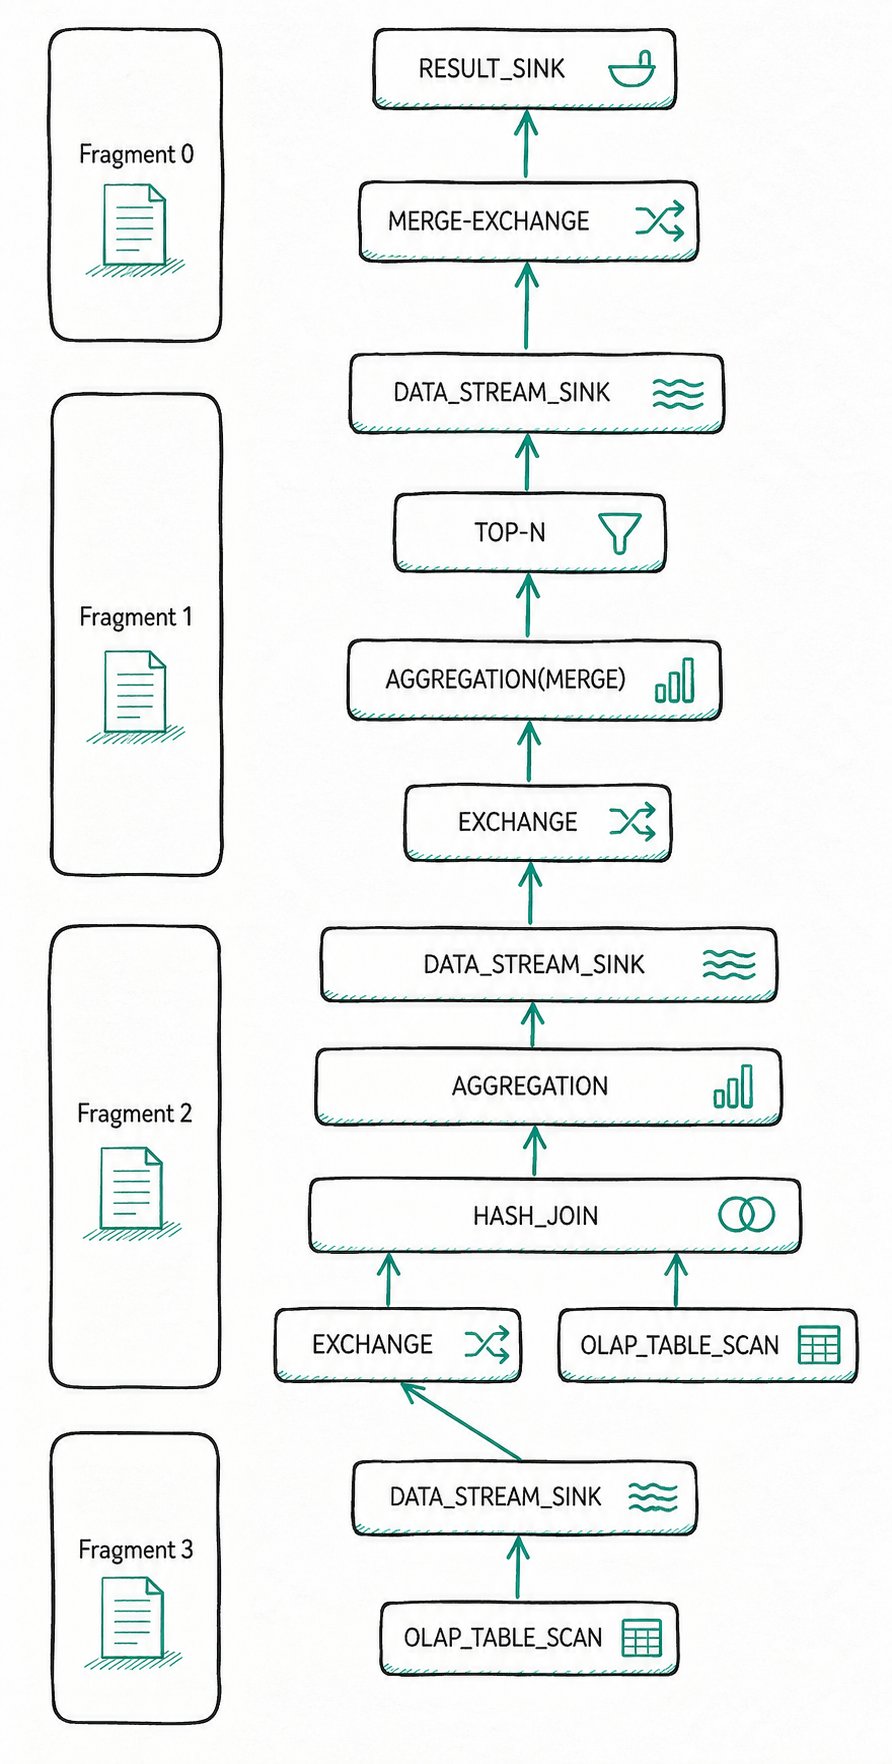
그림의 화살표는 데이터 흐름의 방향을 나타냅니다. 전체 Query의 쿼리 계획은 4개의 Fragment(그림 왼쪽의 네 상자)와 여러 PlanNode로 나뉩니다. Fragment와 그 안에 포함된 PlanNode는 같은 가로선에 배치되어 있습니다. 각 PlanNode의 역할은 다음과 같습니다.
| PlanNode | 역할 |
|---|---|
SCAN_NODE x2 | 각각 customer 테이블과 orders 테이블을 읽습니다 |
DATA_STREAM_SINK / EXCHANGE | 서로 다른 Fragment 간에 데이터를 전달합니다 |
HASH_JOIN | SCAN이 읽은 데이터에 대해 조인 연산을 수행합니다 |
AGGREGATION(첫 번째 단계) / AGGREGATION(MERGE)(두 번째 단계) | 두 단계로 집계합니다 |
TOP-N | 결과 행 수를 제한합니다 |
RESULT_SINK | 최종 결과를 FE에 반환합니다 |
Pipeline과 Operator
위 쿼리 계획은 실행 엔진에서 어떻게 Pipeline과 Operator로 변환될까요? AGGREGATION과 HASH_JOIN을 포함하는 Fragment 1과 Fragment 2를 예로 살펴보겠습니다.
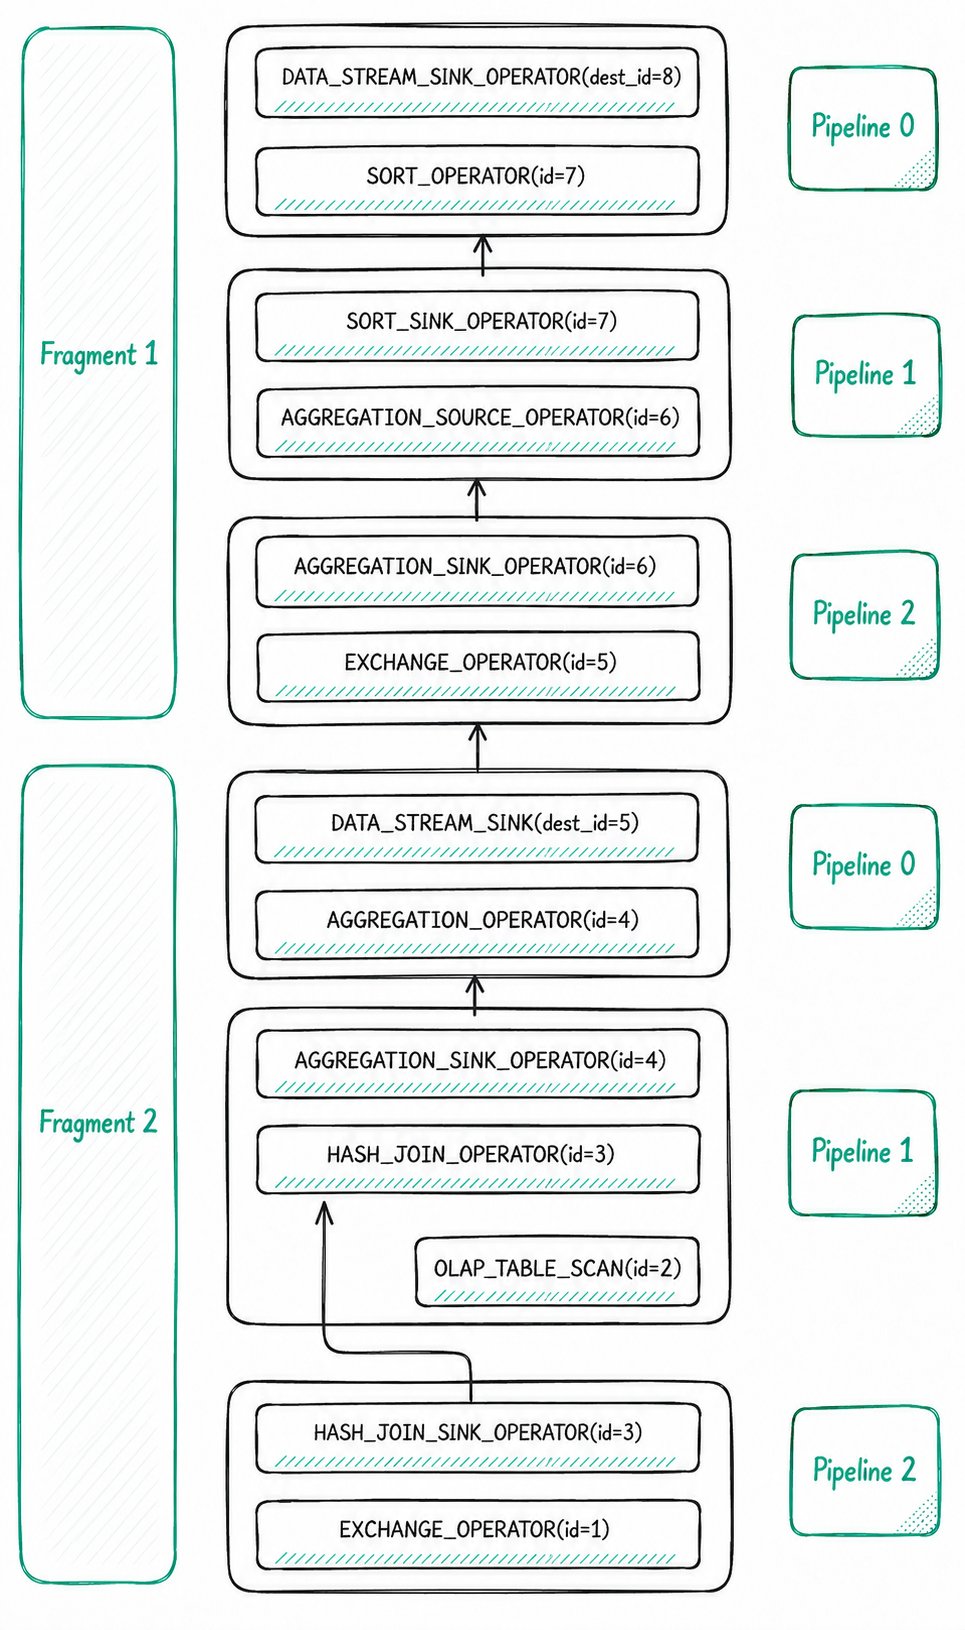
실행 중에 Doris 실행 엔진은 일부 PlanNode를 하나 이상의 Operator로 분리합니다.
예제 1: DATA_STREAM_SINK
DATA_STREAM_SINK는 DATA_STREAM_SINK_OPERATOR로 변환됩니다. 이 노드는 Fragment가 외부로 데이터를 출력할 때 사용하는 연산자입니다. 자체 OperatorId는 없으며, 목적지 OperatorId만 있습니다. 예를 들어 dest_id=5는 이 연산자가 EXCHANGE_OPERATOR 중 id=5인 연산자에 데이터를 전송한다는 의미입니다.
예제 2: HASH_JOIN
PlanNodeId가 3인 HASH_JOIN은 HASH_JOIN_SINK_OPERATOR와 HASH_JOIN_OPERATOR라는 두 Operator로 분리됩니다. 두 Operator의 Operator Id는 모두 3이며, PlanNodeId와 같습니다. 첫 번째 단계의 AGGREGATION과 두 번째 단계의 AGGREGATION(MERGE)도 각각 SINK와 SOURCE 연산자 쌍으로 분리됩니다.
Pipeline 연결과 블로킹 관계
PlanNode를 Operator로 분리한 후, 실행 엔진은 이 Operator 중 일부를 연결하여 Pipeline을 구성합니다. Fragment 1과 Fragment 2에는 각각 내부적으로 3개의 Pipeline이 있습니다.
| 블로킹 유형 | 원인 | 예 |
|---|---|---|
| 연산 논리 의존성 | 연산자 간 연산 순서 | HashJoin의 Probe 측은 Build 측이 해시 테이블 구성을 마칠 때까지 기다려야 합니다 |
| 물리적 환경 의존성 | 네트워크, 버퍼링 등의 시스템 요인 | EXCHANGE_OPERATOR는 DATA_STREAM_SINK_OPERATOR가 네트워크로 데이터를 전송할 때까지 기다려야 합니다 |
같은 Pipeline 안의 Operator 간 데이터 흐름에서는 블로킹이 발생하지 않습니다. 서로 다른 Pipeline의 Operator 간 연결에는 블로킹 관계가 있습니다. 블로킹이 없는 Operator를 하나의 Pipeline으로 연결하여 스케줄링하고 실행하면 리소스 활용률과 캐시 적중률을 높일 수 있습니다.
CommonCounters와 CustomCounters
CommonCounters는 모든 Operator가 반드시 갖는 Counter입니다. 현재 Doris에는 다음 항목이 있습니다.
| Counter | 적용 대상 연산자 | 의미 |
|---|---|---|
ExecTime | 모두 | 현재 Operator를 실행하는 데 걸린 시간으로, 업스트림 연산자의 시간은 제외합니다 |
RowsProduced | Sink가 아닌 Operator | 소스 연산자가 출력한 행 수 |
InputRows | Sink Operator | 현재 연산자가 받은 입력 행 수 |
MemoryUsage & MemoryUsagePeak | 모두 | 연산자의 현재 메모리 사용량과 최대 메모리 사용량 |
WaitForDependency | 모두 | 의존 대상의 실행이 완료되기를 기다린 시간 |
CustomCounters는 각 Operator에 고유한 Counter입니다. 각 연산자의 CustomCounter가 의미하는 바는 "Doris Operator Profile 개요" 문서의 상세 설명을 참고하세요.
HashJoin 해석
Doris 실행의 기본 개념을 이해했으므로, 앞의 쿼리로 돌아가 MergedProfile을 통해 Join의 실행 세부 과정을 재구성해 보겠습니다.
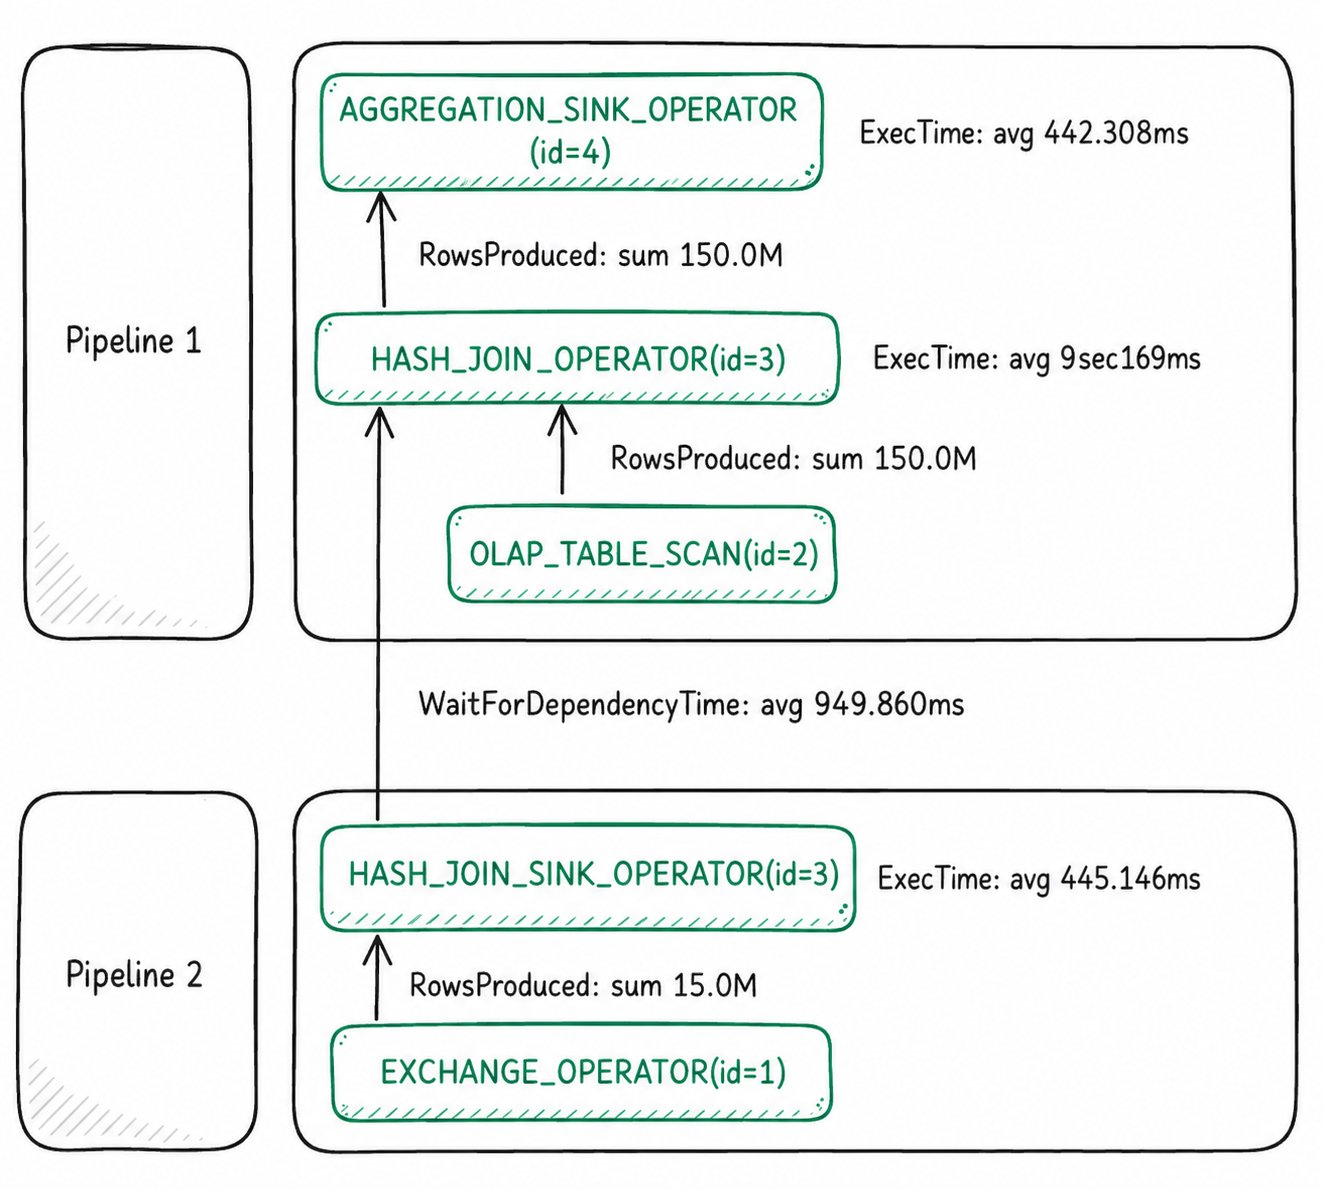
SQL을 실행하기 전에 쿼리의 Pipeline 병렬도를 2로 설정했습니다. 따라서 그림에는 서로 연결된 Pipeline 1과 Pipeline 2가 한 쌍만 표시되어 있지만, 실제 실행 시에는 각 Pipeline에 두 개씩 총 4개의 Pipeline Task가 있어야 합니다.
Pipeline 0(instance_num=2)
각 Pipeline 뒤의 괄호에 있는 instance_num은 모든 BE에 걸쳐 해당 Pipeline에 속한 PipelineTask의 총개수입니다. 여기서 사용한 클러스터에는 BE가 1개뿐이므로 instance_num = 1 * parallel_pipeline_task_num = 2입니다.
Build 측: HashTable 구성
Pipeline 2의 두 PipelineTask는 총 15M개 행의 데이터를 처리하여 HashTable을 구성했으며, HashTable 구성에 걸린 평균 실행 시간은 445.146 ms입니다. Pipeline 1은 Pipeline 2가 HashTable 구성을 마친 후에만 실행할 수 있습니다. 이 대기 시간은 WaitForDependency에 반영되며, avg는 949.860 ms입니다. 그런데 평균 HashTable 구성 시간은 445.146 ms에 불과합니다. 이 차이는 어디서 생긴 것일까요?
HASH_JOIN_SINK_OPERATOR(nereids_id=418)(id=3):
 CommonCounters:
    - ExecTime: avg 445.146ms, max 890.258ms, min 34.635us
    - InputRows: sum 15.0M (15000000), avg 7.5M (7500000), max 15.0M (15000000), min 0
    - WaitForDependency[HASH_JOIN_SINK_OPERATOR_DEPENDENCY]Time: avg 482.355ms, max 964.711ms, min 0ns
 CustomCounters:
    - MemoryUsageHashTable: sum 185.22 MB, avg 92.61 MB, max 185.22 MB, min 0.00
이 예제에서 FE가 JOIN 유형을 BROADCAST_JOIN으로 계획했기 때문입니다. 이 유형에서는 JOIN Build 연산을 수행하는 두 PipelineTask 중 하나만 실제로 해시 테이블을 구성합니다. HASH_JOIN_SINK_OPERATOR의 MergedProfile에서 다음을 확인할 수 있습니다.
- 평균 실행 시간은 445.146 ms이지만, 가장 느린 PipelineTask는 890.258 ms가 걸리고 가장 빠른 PipelineTask는 34.635 us만 걸립니다.
min값이InputRows에서 0이므로, 한 PipelineTask가 모든 데이터를 처리하고 다른 PipelineTask는 아무 작업도 하지 않았음을 알 수 있습니다.
이로써 아래 줄의 대기 시간을 설명할 수 있습니다.
- WaitForDependency[HASH_JOIN_OPERATOR_DEPENDENCY]Time: avg 949.860ms, max 962.978ms, min 936.743ms
Probe 측: Scan과 조인
이제 HASH_JOIN_OPERATOR를 살펴보겠습니다. 평균 949.860 ms를 기다린 후 JOIN의 Probe 측 실행을 시작합니다. 두 OLAP_SCAN_OPERATOR 인스턴스 중 id=2인 인스턴스들이 스토리지에서 150M개 행을 읽습니다. 이 150M개 행은 HASH_JOIN_OPERATOR에서 하나도 남김없이 처리된 후 모두 AGGREGATION_SINK_OPERATOR로 전달됩니다. 이 연산자는 이 150M개 행에 대한 해시 테이블을 구성하고 집계 연산을 이어 갑니다.
Aggregation 해석
이 쿼리에 포함된 집계 연산은 Count(o.o_orderkey) AS total_orders, Sum(o.o_totalprice) AS total_spent와 GROUP BY c.c_name입니다.
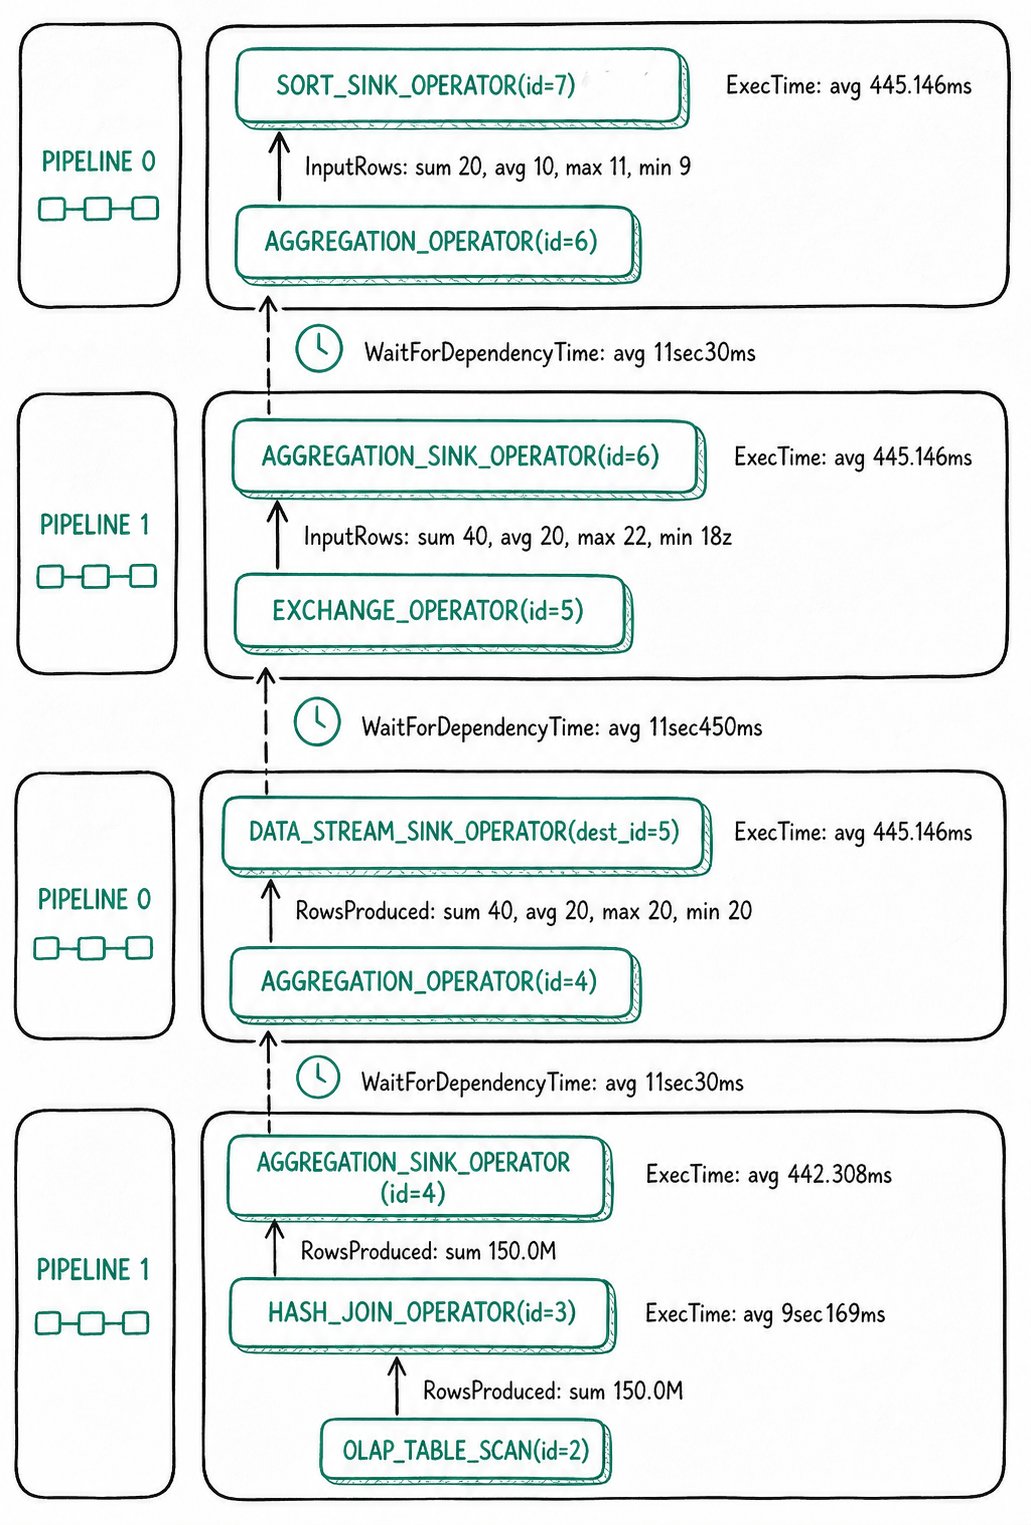
Doris는 이 쿼리에 두 단계 Aggregation을 사용합니다.
첫 번째 단계 집계
id=4인 AGGREGATION 연산자 쌍에서 수행됩니다.AGGREGATION_SINK_OPERATOR(id=4)의 입력은 총 150M개 행입니다.GROUP BY열을 기준으로 해시 테이블을 구성하고 각 집계 결과의AggregationData를 갱신합니다.- 첫 번째 단계가 완료되면
AggregationData를 EXCHANGE를 통해 두 번째 단계로 보냅니다. 서로 다른 PipelineTask가 같은 GROUP BY 열 값을 처리할 수 있으므로, EXCHANGE 단계에서는name열을 기준으로 HASH 파티셔닝을 수행하여 이름이 같은 행을 동일한 두 번째 단계 연산자로 보냅니다. AGGREGATION_OPERATOR(id=4)의 출력은 총 40개 행이며, 이는 첫 번째 단계에서 구성한 해시 테이블에 40개 행이 있음을 나타냅니다.
두 번째 단계 집계
AGGREGATION_SINK_OPERATOR(id=6)가 첫 번째 단계의 결과를AggregationData로 다시 역직렬화한 다음 Merge 연산을 수행합니다.AGGREGATION_OPERATOR(id=6)가 결과를 다운스트림의 TOP-N으로 보냅니다. 쿼리에LIMIT 20이 있으므로 TOP-N 연산자는 20개 행을 수집하면 조기에 종료합니다.
전체 병목
전체적으로 이 쿼리에서 가장 시간이 많이 걸리는 연산은 HASH_JOIN_OPERATOR(id=3)입니다. 이 연산자를 찾았다면 DetailProfile에서 HASH_JOIN_OPERATOR(id=3)의 더 세밀한 Counter를 확인할 수 있습니다. 각 Counter의 의미는 각 연산자의 전용 문서를 참고하세요.
문제 해결 및 FAQ
show query profile이 빈 결과를 반환하나요?
enable_profile이true인지 확인합니다:show variables like 'enable_profile';.auto_profile_threshold_ms를 확인합니다. 큰 값으로 설정되어 있으면 실행 시간이 짧은 쿼리는 Profile을 생성하지 않습니다.- 연결한 FE가 SQL을 실행한 FE와 같은 노드인지 확인합니다. 데이터 적재 작업의 경우 FE Master에 연결해야 합니다.
Profile 보고 시간이 자주 초과되나요?
-
증상: FE 로그에 비동기 Profile 수집 시간 초과가 표시됩니다.
-
조치:
- 서버의 CPU, 메모리, 네트워크 리소스 사용량을 확인합니다.
profile_async_collect_expire_time_secs값을fe.conf에서 늘립니다.- 상황이 심각하면 전역 Profile을 비활성화하고 느린 쿼리에 대해서만 Profile을 수집합니다(
auto_profile_threshold_ms설정).
Profile이 FE 메모리를 너무 많이 사용하나요?
max_query_profile_num을 줄여 메모리에 보관하는 Profile 수를 제한합니다.- 디스크 영구 저장을 활성화하여(기본적으로 활성화됨) 과거 Profile을 디스크로 내보냅니다.
auto_profile_threshold_ms를 사용하여 소규모 쿼리를 걸러 냅니다.
압축을 푼 Profile 파일이 사라졌나요?
- 원인: FE에는
log/profile디렉터리에 대한 정리 보호 메커니즘이 있습니다. - 조치: 압축을 푼 파일을
log/profile이외의 디렉터리에 둡니다.
데이터 편향이 있는지 어떻게 확인하나요?
- MergedProfile에서 같은 연산자의
min,avg,max값을InputRows/RowsProduced에 대해 비교합니다. max가avg보다 훨씬 크거나,min이 0이면서max가 매우 크면 일반적으로 데이터 편향을 의미합니다.
용어집
| 용어 | 한 문장 정의 |
|---|---|
| Query Profile | 단일 쿼리의 실행 세부 정보를 기록하는 진단 구조 |
| Fragment | 실행을 위해 BE에 배포할 수 있는 쿼리 계획의 실행 단위 |
| PlanNode | 쿼리 계획의 논리적 연산자 노드 |
| Pipeline | 블로킹이 없는 여러 Operator로 구성된 실행 파이프라인 |
| Operator | PlanNode에서 분리된 실행 엔진의 최소 실행 단위 |
| MergedProfile | 여러 BE와 PipelineTask에 걸쳐 집계한 Profile |
| DetailProfile | 각 BE의 개별 PipelineTask에 대한 상세 Profile |
WaitForDependency | 연산자가 의존 대상의 완료를 기다리는 시간으로, 병목을 찾는 데 자주 사용됨 |