조인 (JOIN)
데이터 분석에서는 업무 데이터가 여러 테이블로 나뉘어 있는 경우가 많습니다. 예를 들어 주문 테이블, 사용자 테이블, 상품 테이블로 나뉠 수 있습니다. 이러한 테이블을 연결하여 완전한 분석 결과를 얻으려면 JOIN을 사용합니다. 이 문서에서는 Apache Doris가 지원하는 JOIN 유형과 MPP 아키텍처에서의 JOIN 물리적 구현 및 Shuffle 전략을 설명하여, 업무 시나리오에 적합한 JOIN 방식을 선택할 수 있도록 돕습니다.
JOIN이란
관계형 데이터베이스에서는 데이터가 여러 테이블에 분산되어 있으며, 테이블은 특정 관계를 통해 서로 연결됩니다. SQL JOIN 연산을 사용하면 이러한 연결 조건을 기반으로 서로 다른 테이블을 결합하여 더 완전한 결과 집합을 만들 수 있습니다.
Doris가 지원하는 JOIN 유형
Doris는 일반적인 결합부터 안티 조인과 세미 조인까지 다양한 시나리오를 지원하는 다음 JOIN 유형을 제공합니다.
| JOIN 유형 | 설명 |
|---|---|
| INNER JOIN | JOIN 조건을 사용하여 왼쪽 테이블의 각 행을 오른쪽 테이블의 모든 행과 비교하고, JOIN 조건을 만족하는 양쪽 테이블의 행을 반환합니다. |
| LEFT JOIN | INNER JOIN 결과 집합을 기반으로, 왼쪽 테이블의 행과 일치하는 행이 오른쪽 테이블에 없더라도 왼쪽 테이블의 행을 반환하고 오른쪽 테이블의 해당 컬럼을 NULL로 채웁니다. |
| RIGHT JOIN | LEFT JOIN과 반대로, 오른쪽 테이블의 행과 일치하는 행이 왼쪽 테이블에 없더라도 오른쪽 테이블의 행을 반환하고 왼쪽 테이블의 해당 컬럼을 NULL로 채웁니다. |
| FULL JOIN | INNER JOIN 결과 집합을 기반으로 양쪽 테이블의 모든 행을 반환합니다. 다른 테이블에서 일치하는 행을 찾지 못하면 해당 테이블의 대응 컬럼을 NULL로 채웁니다. |
| CROSS JOIN | JOIN 조건 없이 두 테이블의 카테시안 곱을 반환합니다. 왼쪽 테이블의 모든 행을 오른쪽 테이블의 모든 행과 각각 결합합니다. |
| LEFT SEMI JOIN | JOIN 조건을 사용하여 왼쪽 테이블의 각 행을 오른쪽 테이블의 모든 행과 비교하고, 일치하는 행이 있으면 왼쪽 테이블의 해당 행을 반환합니다. |
| RIGHT SEMI JOIN | LEFT SEMI JOIN과 반대로, JOIN 조건을 사용하여 오른쪽 테이블의 각 행을 왼쪽 테이블의 모든 행과 비교하고, 일치하는 행이 있으면 오른쪽 테이블의 해당 행을 반환합니다. |
| LEFT ANTI JOIN | JOIN 조건을 사용하여 왼쪽 테이블의 각 행을 오른쪽 테이블의 모든 행과 비교하고, 일치하는 행이 없으면 왼쪽 테이블의 해당 행을 반환합니다. |
| RIGHT ANTI JOIN | LEFT ANTI JOIN과 반대로, JOIN 조건을 사용하여 오른쪽 테이블의 각 행을 왼쪽 테이블의 모든 행과 비교하고, 일치하는 행이 없으면 해당 행을 반환합니다. |
| NULL AWARE LEFT ANTI JOIN | NULL 값을 특별하게 처리하는 LEFT ANTI JOIN입니다. LEFT ANTI JOIN과 유사하지만, 왼쪽 테이블에서 일치 여부를 비교하는 컬럼이 NULL인 행은 제외합니다. |
JOIN의 전체 SQL 구문은 SELECT를 참조하세요.
JOIN의 물리적 구현
Doris는 JOIN의 물리적 구현으로 Hash Join과 Nest Loop Join을 지원합니다. 각 방식의 적용 시나리오는 다음과 같습니다.
-
Hash Join: 동등 JOIN 컬럼을 기준으로 오른쪽 테이블에 대한 해시 테이블을 구축하고, 왼쪽 테이블의 데이터를 이 해시 테이블에 스트리밍하여 JOIN을 계산합니다. 이 방식은 동등 JOIN 조건에만 적용할 수 있다는 제약이 있습니다.
-
Nest Loop Join: 왼쪽 테이블을 기준으로 중첩된 두 루프를 실행합니다. 왼쪽 테이블의 각 행마다 오른쪽 테이블의 모든 행을 순회하며 JOIN 조건을 평가합니다. 크거나 작음을 비교하는 쿼리나 카테시안 곱 계산이 필요한 쿼리처럼 Hash Join으로 처리할 수 없는 경우를 포함하여 모든 JOIN 시나리오에 적용할 수 있습니다. 다만 Nest Loop Join은 Hash Join보다 성능이 낮을 수 있습니다.
Hash Join의 Shuffle 전략
분산 MPP 데이터베이스인 Apache Doris는 JOIN 결과의 정확성을 보장하기 위해 Hash Join을 수행할 때 데이터를 적절하게 전달하고 분할하는 Shuffle 과정이 필요합니다. Doris는 데이터 분포 요구 사항과 성능 향상 가능성이 낮은 순서부터 Broadcast Join, Partition Shuffle Join, Bucket Shuffle Join, Colocate Join의 네 가지 Shuffle 전략을 제공합니다.
Broadcast Join
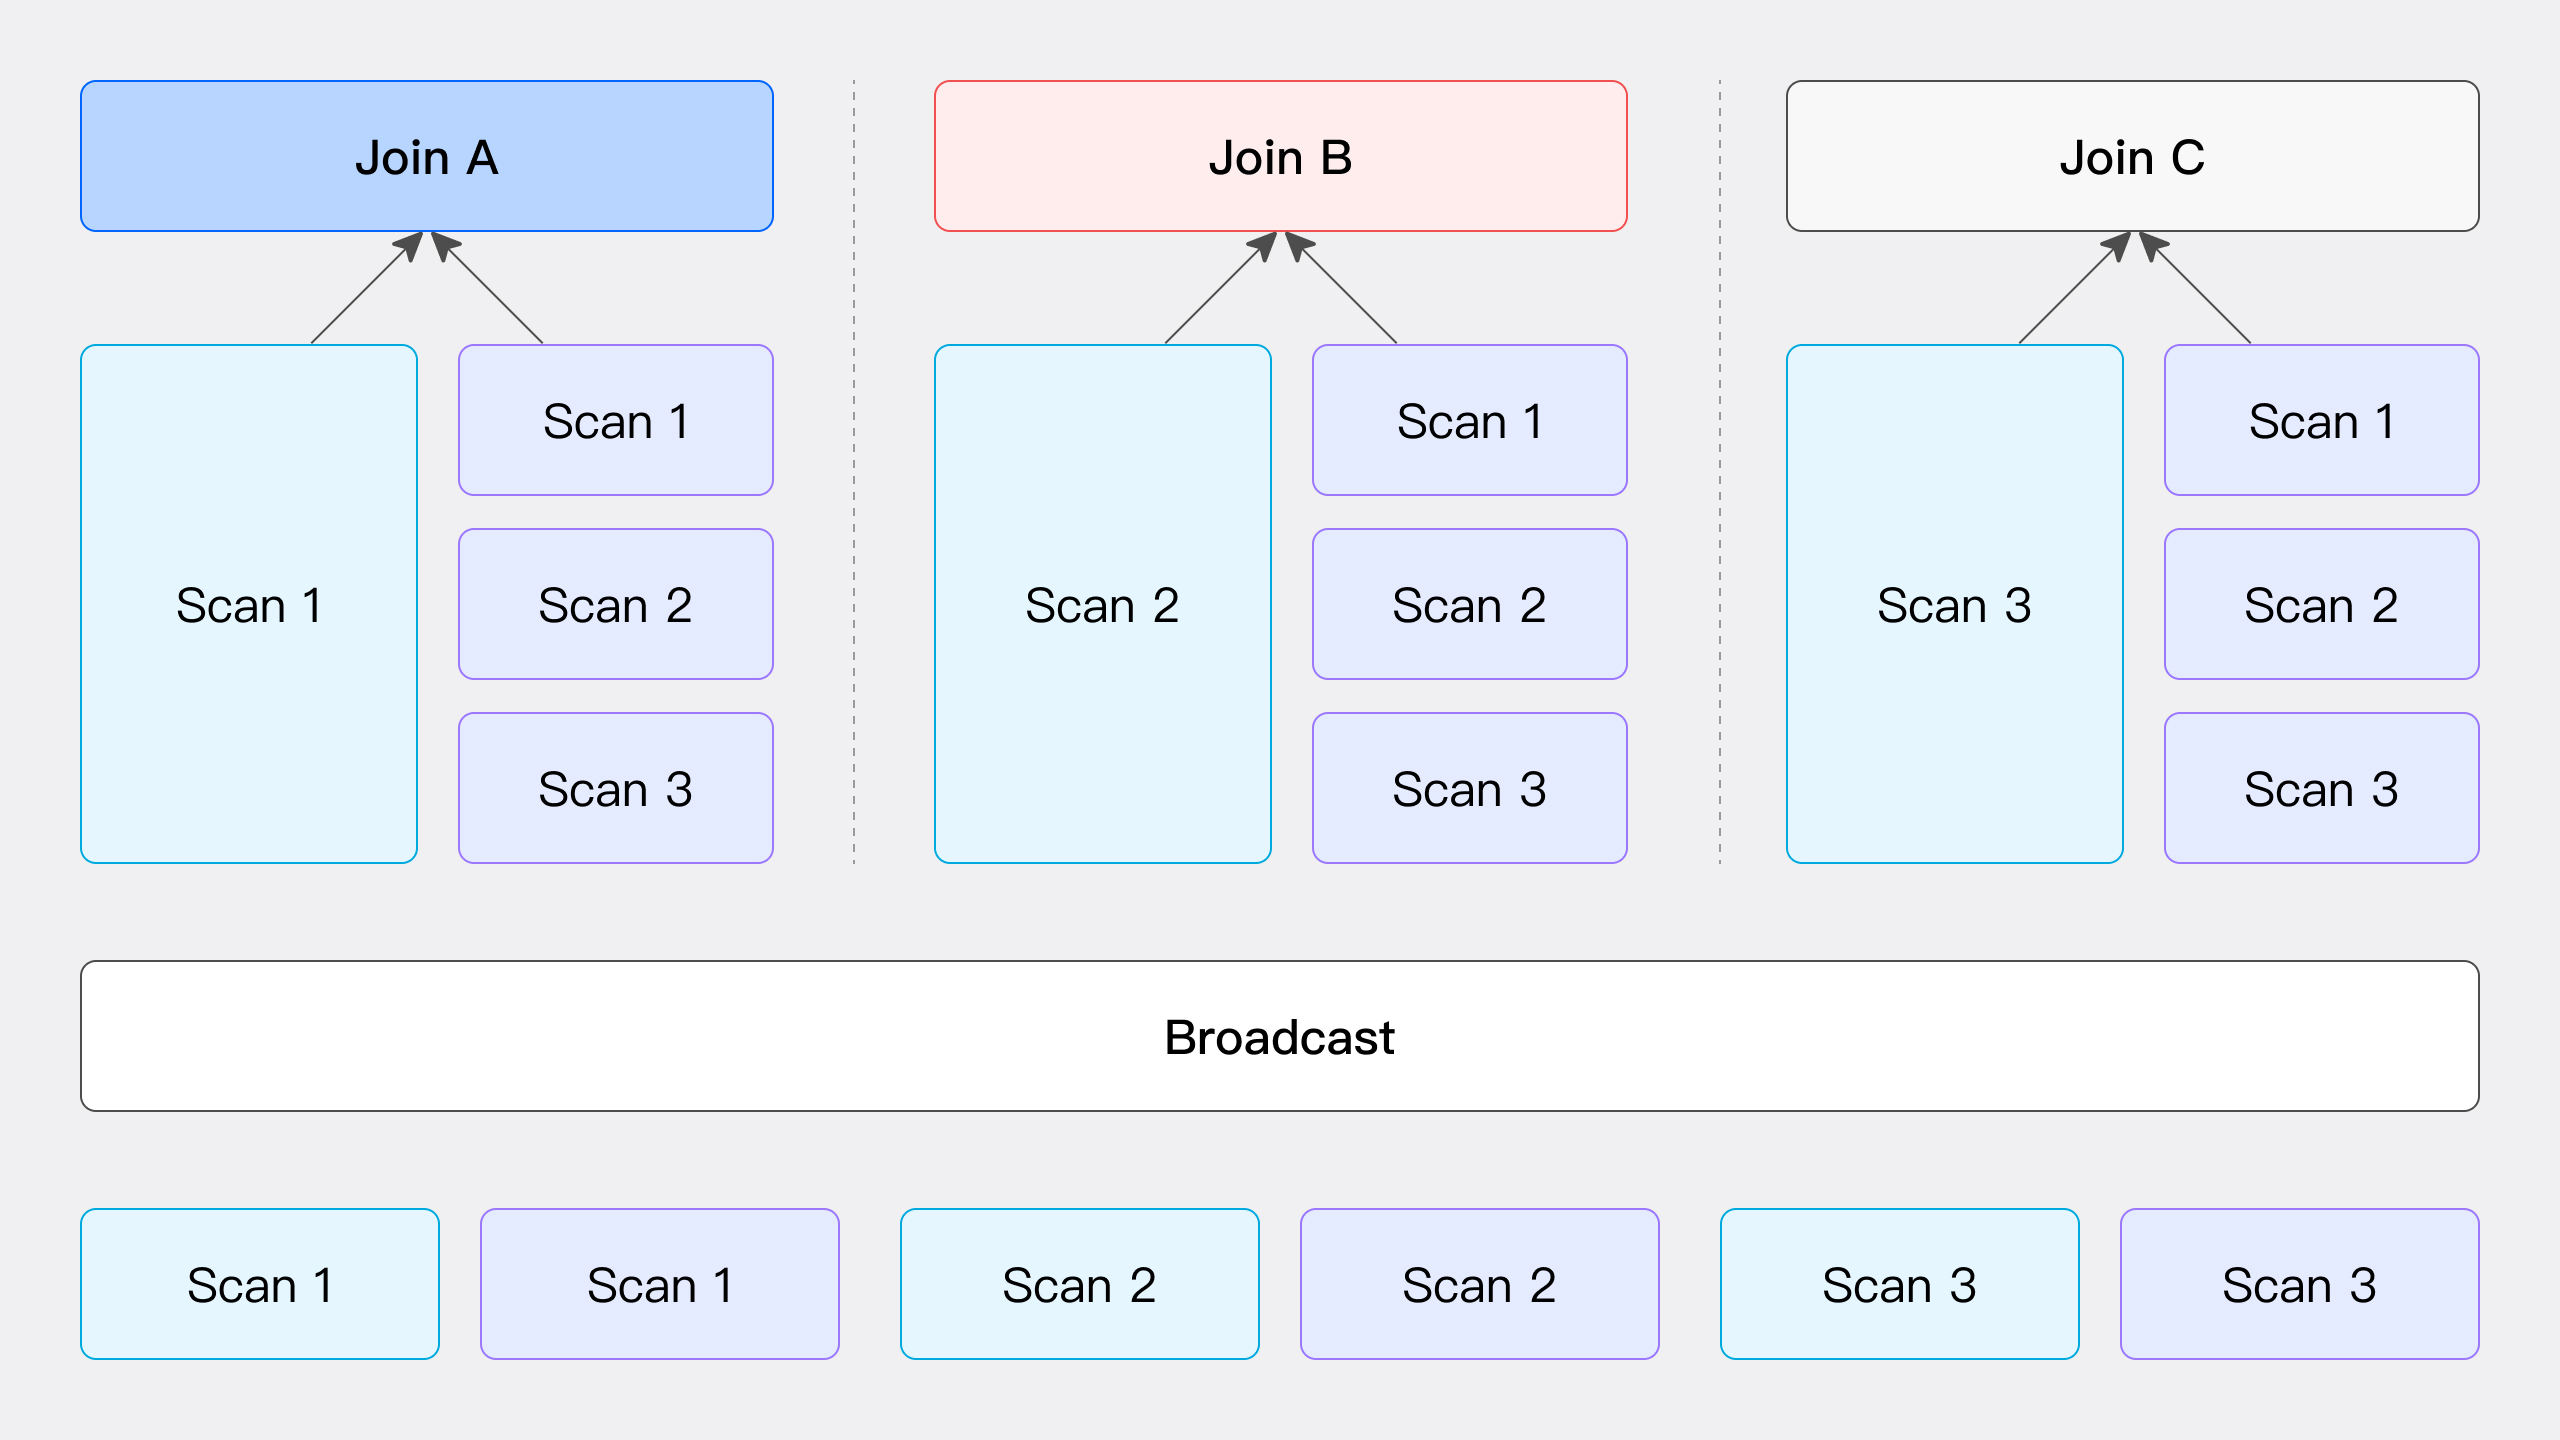
그림과 같이 Broadcast Join은 왼쪽 테이블 데이터의 스캔 노드를 포함하여 JOIN 계산에 참여하는 모든 노드에 오른쪽 테이블의 전체 데이터를 전송하고, 왼쪽 테이블의 데이터는 현재 위치에 유지합니다. 이 과정에서 각 노드는 오른쪽 테이블 데이터의 완전한 복사본인 총 T(R)의 데이터를 받으므로, 모든 노드가 JOIN 수행에 필요한 데이터를 갖게 됩니다.
이 방식은 일반적인 여러 시나리오에 적용할 수 있지만 RIGHT OUTER, RIGHT ANTI, RIGHT SEMI Hash Join에는 사용할 수 없습니다. 네트워크 오버헤드는 JOIN 노드 수 N에 오른쪽 테이블의 데이터 크기 T(R)을 곱한 값입니다.
Partition Shuffle Join
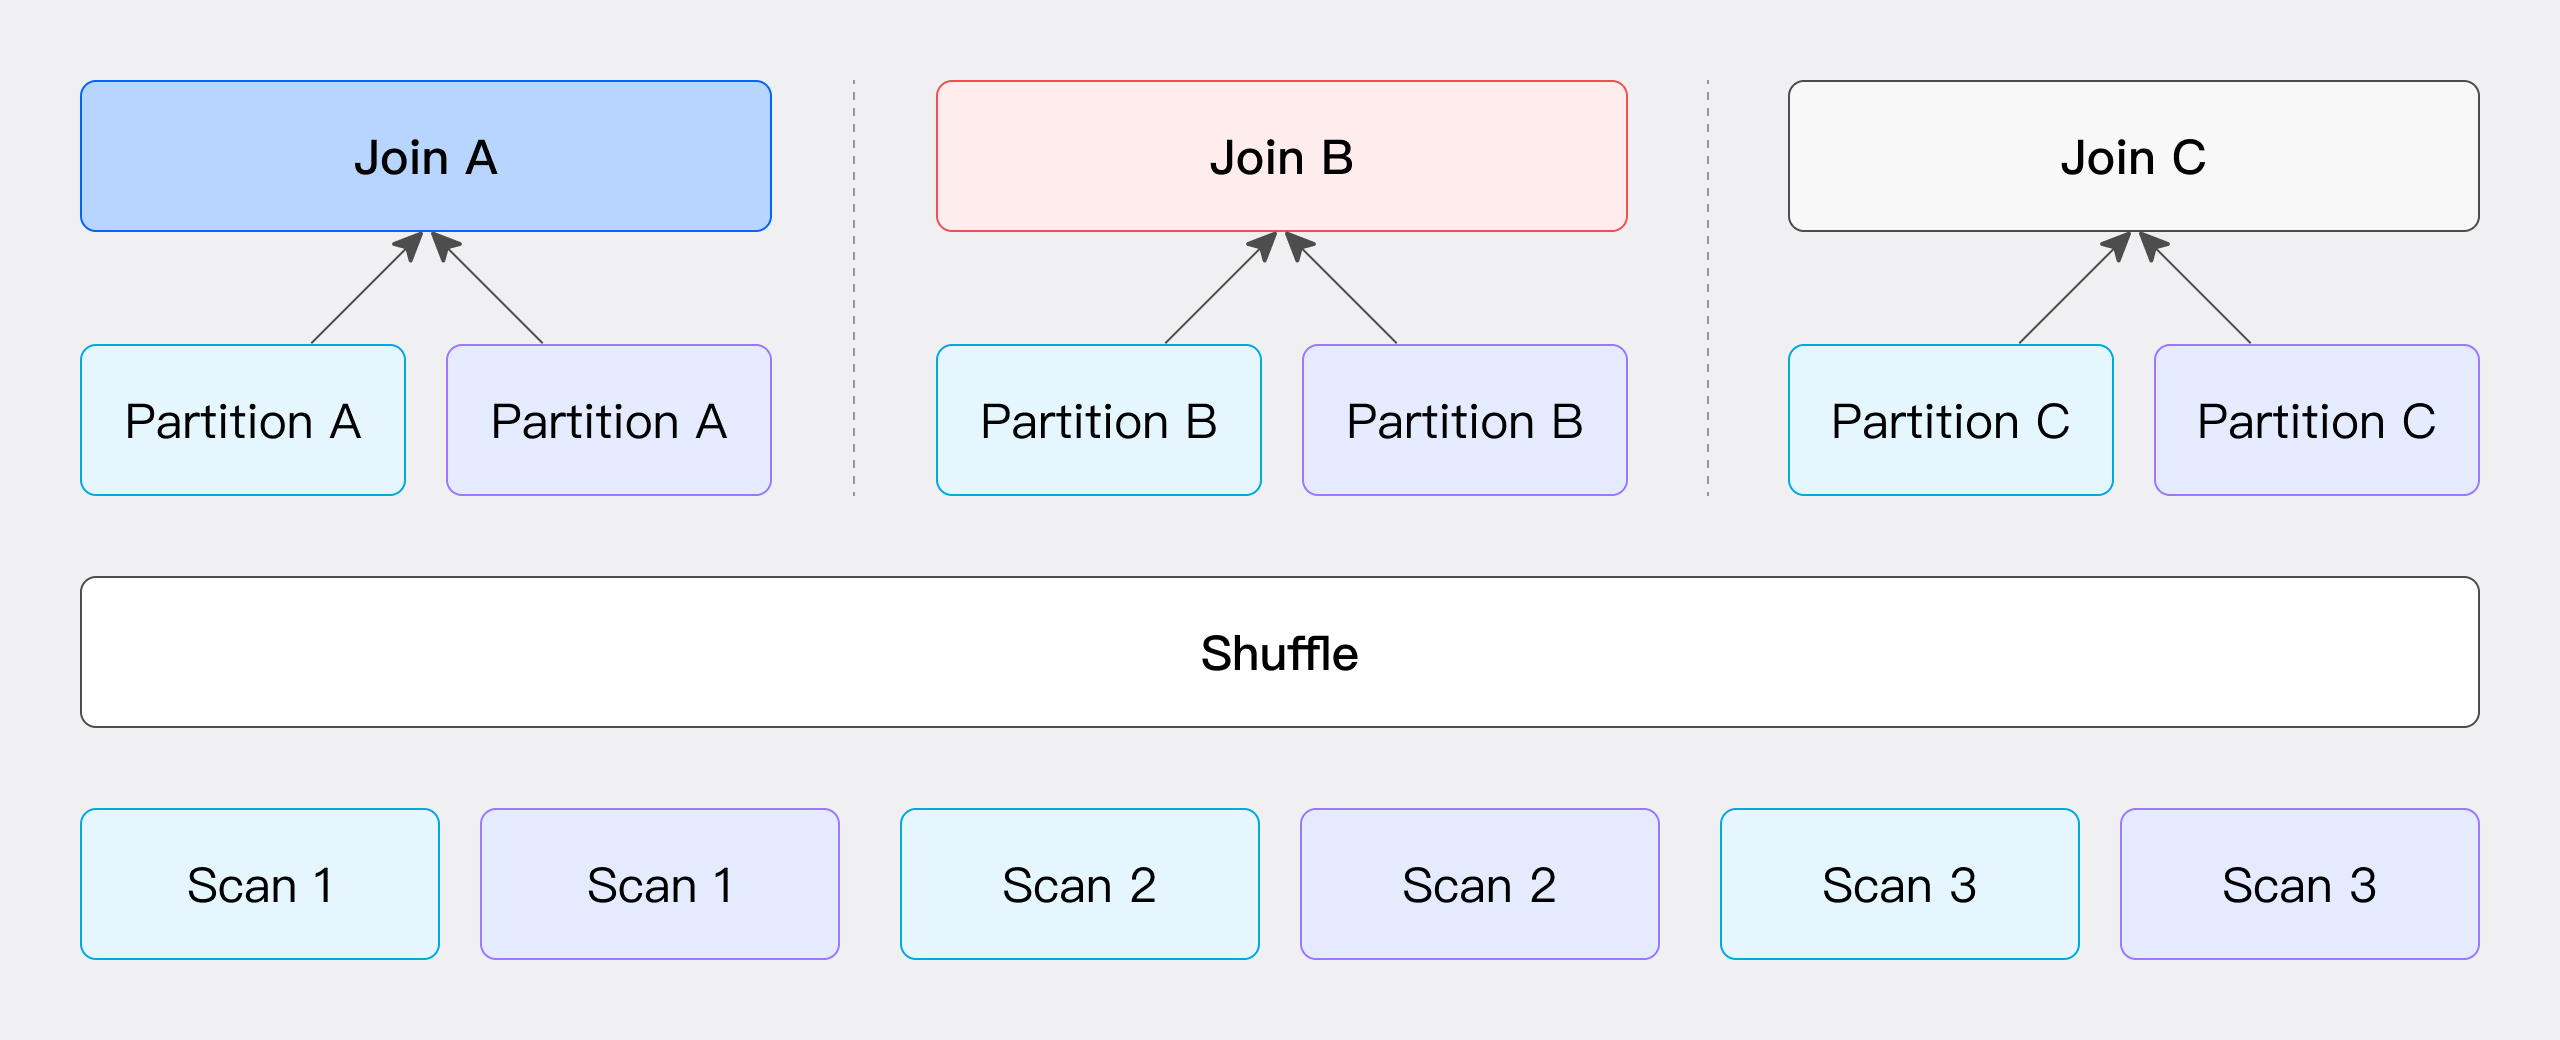
이 방식은 JOIN 조건에서 해시 값을 계산하고 그에 따라 데이터를 분할합니다. 구체적으로 왼쪽 테이블과 오른쪽 테이블의 데이터를 JOIN 조건에서 계산한 해시 값에 따라 각각 분할한 후, 그림과 같이 각 파티션을 해당 파티션 노드로 전송합니다.
이 방식의 네트워크 오버헤드는 왼쪽 테이블 데이터 T(S)의 전송 비용과 오른쪽 테이블 데이터 T(R)의 전송 비용으로 구성됩니다. JOIN 조건을 기반으로 데이터를 버킷에 나누므로 Hash Join만 지원합니다.
Bucket Shuffle Join
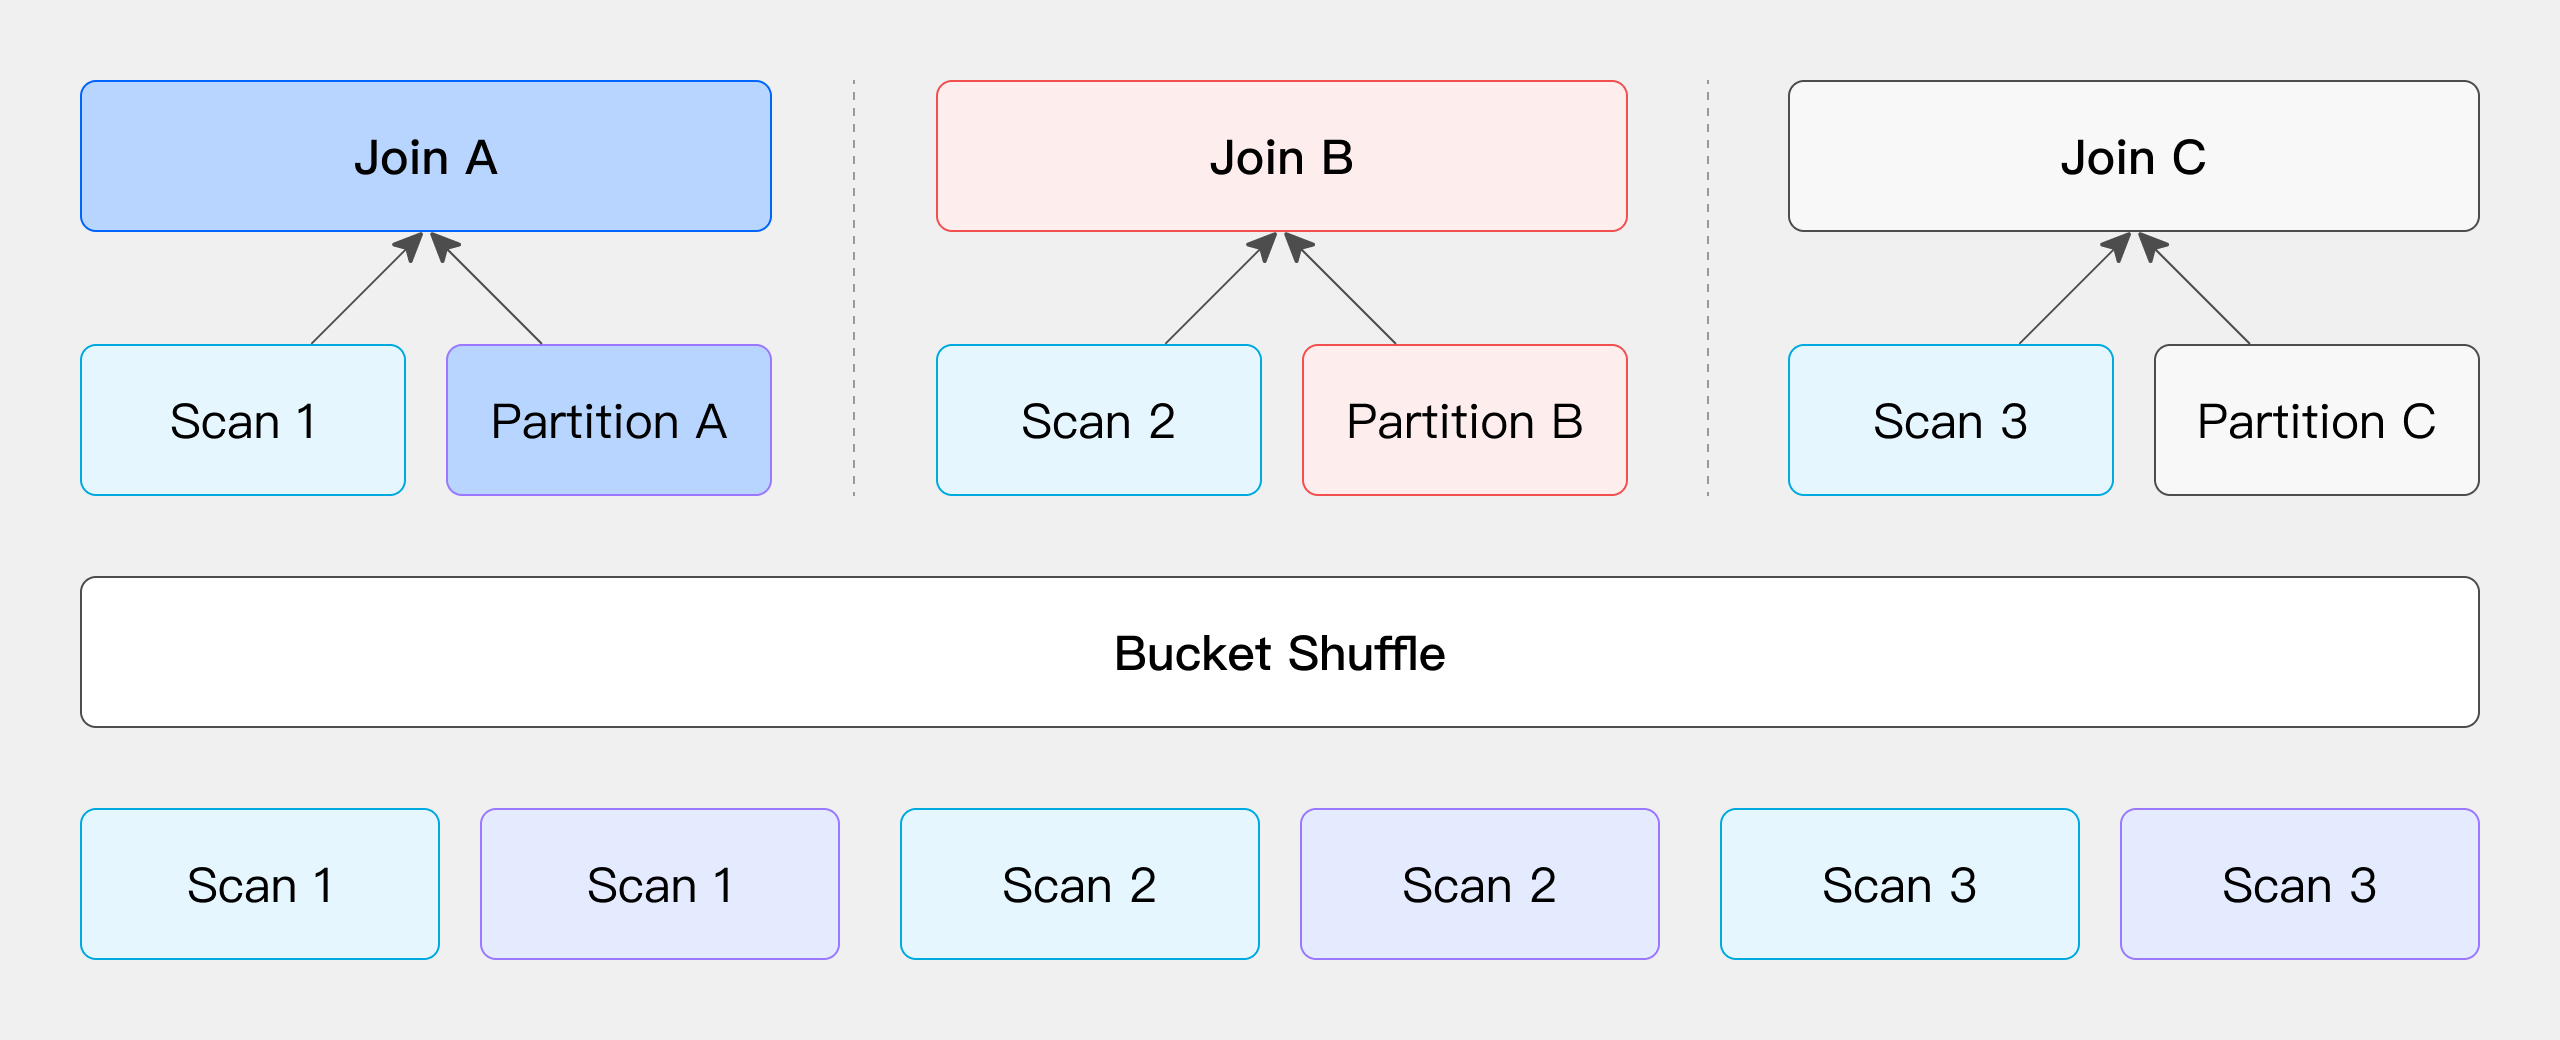
JOIN 조건에 왼쪽 테이블의 버킷 컬럼이 포함되면 왼쪽 테이블의 데이터는 현재 위치에 유지하고, 오른쪽 테이블의 데이터를 왼쪽 테이블의 노드로 분산하여 JOIN을 수행함으로써 네트워크 오버헤드를 줄일 수 있습니다.
JOIN의 한쪽 데이터가 이미 JOIN 조건 컬럼을 기준으로 해시 분산되어 있다면 해당 데이터는 현재 위치에 유지하고, 다른 쪽 데이터에 동일한 JOIN 조건 컬럼과 동일한 해시 분산 계산을 적용하여 분산할 수 있습니다. 여기서 말하는 "테이블"은 물리적으로 저장된 테이블에 한정되지 않으며, SQL 쿼리 내 어떤 연산자의 출력도 될 수 있습니다. 또한 왼쪽이나 오른쪽 중 어느 테이블의 데이터를 현재 위치에 유지하고 다른 쪽 데이터를 이동하여 분산할지 유연하게 선택할 수 있습니다.
Doris의 물리적 테이블을 예로 들어 보겠습니다. 테이블 데이터 자체가 해시 계산을 통해 버킷에 저장되므로, 이 특성을 직접 활용하여 JOIN 연산의 데이터 Shuffle 과정을 최적화할 수 있습니다. 두 테이블을 조인해야 하고 JOIN 컬럼이 왼쪽 테이블의 버킷 컬럼이라고 가정해 보겠습니다. 이 경우 왼쪽 테이블의 데이터를 이동할 필요 없이, 왼쪽 테이블의 버킷 정보를 기반으로 오른쪽 테이블의 데이터를 해당 위치로 분산하기만 하면 그림과 같이 JOIN 계산을 완료할 수 있습니다.
이 과정의 네트워크 오버헤드는 주로 오른쪽 테이블 데이터를 이동하는 데서 발생하며, 그 크기는 T(R)입니다.
Colocate Join
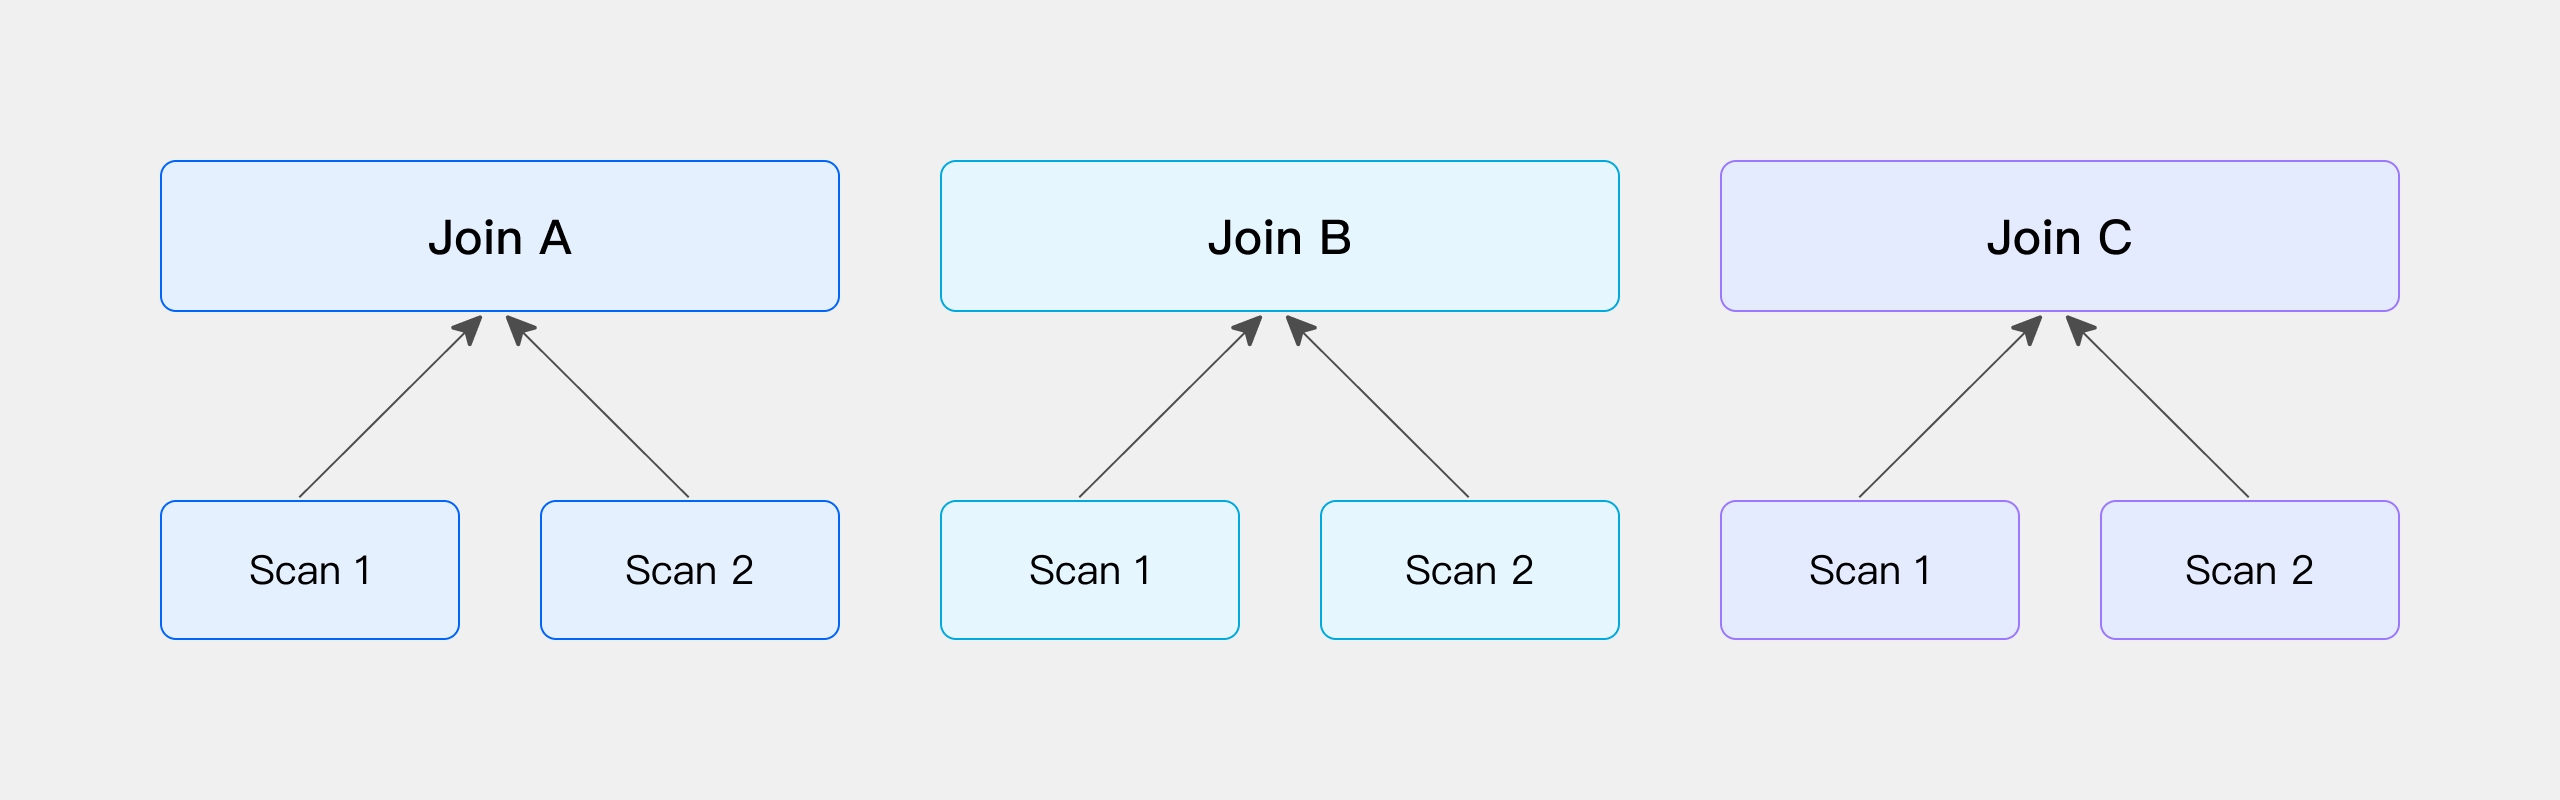
Bucket Shuffle Join과 마찬가지로, JOIN에 참여하는 두 테이블이 모두 JOIN 조건 컬럼을 기준으로 해시 분산되어 있다면 Shuffle 과정을 생략하고 로컬 노드에서 직접 JOIN을 계산할 수 있습니다. 다음은 물리적 테이블을 사용한 간단한 설명입니다.
Doris 테이블을 DISTRIBUTED BY HASH로 생성하면 시스템은 데이터 적재 시 해시 분산 키를 기준으로 데이터를 분산합니다. 두 테이블의 해시 분산 키가 JOIN 조건 컬럼과 일치하면, 두 테이블의 데이터가 이미 JOIN 요구 사항에 따라 분산되어 있다고 볼 수 있으므로 추가 Shuffle이 필요하지 않습니다. 따라서 실제 쿼리에서는 이 두 테이블에 대해 직접 JOIN을 계산할 수 있습니다.
데이터를 스캔한 직후 JOIN을 수행하는 시나리오에서는 테이블 생성 시 특정 조건을 충족해야 합니다. 자세한 내용은 뒤에서 설명하는 두 물리적 테이블의 Colocate Join 제한 사항을 참조하세요.
네 가지 Shuffle 방식 비교
다음 표는 네 가지 Shuffle 방식의 네트워크 오버헤드, 지원하는 물리적 연산자, 적용 시나리오를 요약합니다.
| Shuffle 방식 | 네트워크 오버헤드 | 물리적 연산자 | 적용 시나리오 |
|---|---|---|---|
| Broadcast | N * T(R) | Hash Join / Nest Loop Join | 일반적인 시나리오 |
| Shuffle | T(S) + T(R) | Hash Join | 일반적인 시나리오 |
| Bucket Shuffle | T(R) | Hash Join | JOIN 조건에 왼쪽 테이블의 버킷 컬럼이 포함되고, 왼쪽 테이블이 단일 파티션인 경우. |
| Colocate | 0 | Hash Join | JOIN 조건에 왼쪽 테이블의 버킷 컬럼이 포함되고, 두 테이블이 동일한 Colocate Group에 속하는 경우. |
- N: JOIN 계산에 참여하는 Instance의 수입니다.
- T(relation): 릴레이션의 튜플 수입니다.
위의 네 가지 Shuffle 방식은 나열된 순서대로 유연성이 낮아지고, 데이터 분포에 대한 요구 사항이 점차 엄격해집니다. 대부분의 시나리오에서는 데이터 분포 요구 사항이 높아질수록 JOIN 성능이 향상되는 경향이 있습니다. 다만 테이블의 버킷 수가 적으면 Bucket Shuffle Join이나 Colocate Join의 병렬성이 낮아져 성능이 저하될 수 있으며, Shuffle Join보다 성능이 떨어질 수도 있습니다. Shuffle 연산은 데이터 분포를 더 효과적으로 균등하게 만들어 후속 처리에 더 높은 병렬성을 제공할 수 있기 때문입니다.
Bucket Shuffle Join과 Colocate Join 실습 예제
앞서 설명했듯이 Bucket Shuffle Join과 Colocate Join은 JOIN에 참여하는 양쪽의 데이터 분포가 특정 조건을 충족하면 해당 JOIN을 수행할 수 있습니다. 여기서 "테이블"은 더 넓은 개념으로, SQL 쿼리 내 어떤 연산자의 출력도 "테이블"로 볼 수 있습니다.
다음으로 두 테이블 t1과 t2, 그리고 관련 SQL 예제를 사용하여 이러한 넓은 의미의 Bucket Shuffle Join과 Colocate Join을 설명합니다. 먼저 두 테이블의 CREATE TABLE 문은 다음과 같습니다.
create table t1
(
    c1 bigint,
    c2 bigint
)
DISTRIBUTED BY HASH(c1) BUCKETS 3
PROPERTIES ("replication_num" = "1");

create table t2
(
    c1 bigint,
    c2 bigint
)
DISTRIBUTED BY HASH(c1) BUCKETS 3
PROPERTIES ("replication_num" = "1");
Bucket Shuffle Join 예제
다음 예제에서는 t1과 t2가 모두 GROUP BY 연산자로 처리되어 새로운 테이블을 생성합니다. 이때 tx는 c1을 기준으로 해시 분산되고, ty는 c2를 기준으로 해시 분산됩니다. 이어지는 JOIN 조건은 tx.c1 = ty.c2로, Bucket Shuffle Join의 조건을 정확히 충족합니다.
explain select *
from
    (
        -- Table t1 is hash-distributed by c1, and after the group by operator, it remains hash-distributed by c1.
        select c1 as c1, sum(c2) as c2
        from t1
        group by c1
    ) tx
join
    (
        -- Table t2 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t2
        group by c2
    ) ty
on tx.c1 = ty.c2;
아래 Explain 출력에서 Hash Join 노드 7의 왼쪽 자식은 집계 노드 6이고, 오른쪽 자식은 Exchange 노드 4임을 확인할 수 있습니다. 이는 집계 후 왼쪽 자식의 데이터가 현재 위치에 유지되고, 오른쪽 자식의 데이터는 Bucket Shuffle을 통해 왼쪽 자식의 노드로 분산되어 후속 Hash Join을 수행할 수 있음을 나타냅니다.
+------------------------------------------------------------+
| Explain String(Nereids Planner)                            |
+------------------------------------------------------------+
| PLAN FRAGMENT 0                                            |
|   OUTPUT EXPRS:                                            |
|     c1[#18]                                                |
|     c2[#19]                                                |
|     c2[#20]                                                |
|     c1[#21]                                                |
|   PARTITION: HASH_PARTITIONED: c1[#8]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   VRESULT SINK                                             |
|      MYSQL_PROTOCAL                                        |
|                                                            |
|   7:VHASH JOIN(364)                                        |
|   |  join op: INNER JOIN(BUCKET_SHUFFLE)[]                 |
|   |  equal join conjunct: (c1[#12] = c2[#6])               |
|   |  cardinality=10                                        |
|   |  vec output tuple id: 8                                |
|   |  output tuple id: 8                                    |
|   |  vIntermediate tuple ids: 7                            |
|   |  hash output slot ids: 6 7 12 13                       |
|   |  final projections: c1[#14], c2[#15], c2[#16], c1[#17] |
|   |  final project output tuple id: 8                      |
|   |  distribute expr lists: c1[#12]                        |
|   |  distribute expr lists: c2[#6]                         |
|   |                                                        |
|   |----4:VEXCHANGE                                         |
|   |       offset: 0                                        |
|   |       distribute expr lists: c2[#6]                    |
|   |                                                        |
|   6:VAGGREGATE (update finalize)(342)                      |
|   |  output: sum(c2[#9])[#11]                              |
|   |  group by: c1[#8]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  final projections: c1[#10], c2[#11]                   |
|   |  final project output tuple id: 6                      |
|   |  distribute expr lists: c1[#8]                         |
|   |                                                        |
|   5:VOlapScanNode(339)                                     |
|      TABLE: tt.t1(t1), PREAGGREGATION: ON                  |
|      partitions=1/1 (t1)                                   |
|      tablets=1/1, tabletList=491188                        |
|      cardinality=21, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
| PLAN FRAGMENT 1                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c2[#2]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 04                                        |
|     BUCKET_SHFFULE_HASH_PARTITIONED: c2[#6]                |
|                                                            |
|   3:VAGGREGATE (merge finalize)(355)                       |
|   |  output: sum(partial_sum(c1)[#3])[#5]                  |
|   |  group by: c2[#2]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  final projections: c2[#4], c1[#5]                     |
|   |  final project output tuple id: 3                      |
|   |  distribute expr lists: c2[#2]                         |
|   |                                                        |
|   2:VEXCHANGE                                              |
|      offset: 0                                             |
|      distribute expr lists:                                |
|                                                            |
| PLAN FRAGMENT 2                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#0]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 02                                        |
|     HASH_PARTITIONED: c2[#2]                               |
|                                                            |
|   1:VAGGREGATE (update serialize)(349)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#0])[#3]                       |
|   |  group by: c2[#1]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  distribute expr lists: c1[#0]                         |
|   |                                                        |
|   0:VOlapScanNode(346)                                     |
|      TABLE: tt.t2(t2), PREAGGREGATION: ON                  |
|      partitions=1/1 (t2)                                   |
|      tablets=1/1, tabletList=491198                        |
|      cardinality=10, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
|                                                            |
| Statistics                                                 |
|  planed with unknown column statistics                     |
+------------------------------------------------------------+
97 rows in set (0.01 sec)
Colocate Join 예제
다음 예제에서는 t1과 t2가 모두 GROUP BY 연산자로 처리되어 새로운 테이블을 생성합니다. 이때 tx와 ty는 모두 c2를 기준으로 해시 분산됩니다. 이어지는 JOIN 조건은 tx.c2 = ty.c2로, Colocate Join의 조건을 정확히 충족합니다.
explain select *
from
    (
        -- Table t1 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t1
        group by c2
    ) tx
join
    (
        -- Table t2 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t2
        group by c2
    ) ty
on tx.c2 = ty.c2;
아래 Explain 출력에서 Hash Join 노드 8의 왼쪽 자식은 집계 노드 7이고, 오른쪽 자식은 집계 노드 3이며, 그 사이에 Exchange 노드가 없음을 확인할 수 있습니다. 이는 집계 후 왼쪽과 오른쪽 자식의 데이터가 모두 현재 위치에 유지되어 데이터 이동이 필요하지 않으며, 후속 Hash Join을 로컬에서 수행할 수 있음을 나타냅니다.
+------------------------------------------------------------+
| Explain String(Nereids Planner)                            |
+------------------------------------------------------------+
| PLAN FRAGMENT 0                                            |
|   OUTPUT EXPRS:                                            |
|     c2[#20]                                                |
|     c1[#21]                                                |
|     c2[#22]                                                |
|     c1[#23]                                                |
|   PARTITION: HASH_PARTITIONED: c2[#10]                     |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   VRESULT SINK                                             |
|      MYSQL_PROTOCAL                                        |
|                                                            |
|   8:VHASH JOIN(373)                                        |
|   |  join op: INNER JOIN(PARTITIONED)[]                    |
|   |  equal join conjunct: (c2[#14] = c2[#6])               |
|   |  cardinality=10                                        |
|   |  vec output tuple id: 9                                |
|   |  output tuple id: 9                                    |
|   |  vIntermediate tuple ids: 8                            |
|   |  hash output slot ids: 6 7 14 15                       |
|   |  final projections: c2[#16], c1[#17], c2[#18], c1[#19] |
|   |  final project output tuple id: 9                      |
|   |  distribute expr lists: c2[#14]                        |
|   |  distribute expr lists: c2[#6]                         |
|   |                                                        |
|   |----3:VAGGREGATE (merge finalize)(367)                  |
|   |    |  output: sum(partial_sum(c1)[#3])[#5]             |
|   |    |  group by: c2[#2]                                 |
|   |    |  sortByGroupKey:false                             |
|   |    |  cardinality=5                                    |
|   |    |  final projections: c2[#4], c1[#5]                |
|   |    |  final project output tuple id: 3                 |
|   |    |  distribute expr lists: c2[#2]                    |
|   |    |                                                   |
|   |    2:VEXCHANGE                                         |
|   |       offset: 0                                        |
|   |       distribute expr lists:                           |
|   |                                                        |
|   7:VAGGREGATE (merge finalize)(354)                       |
|   |  output: sum(partial_sum(c1)[#11])[#13]                |
|   |  group by: c2[#10]                                     |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  final projections: c2[#12], c1[#13]                   |
|   |  final project output tuple id: 7                      |
|   |  distribute expr lists: c2[#10]                        |
|   |                                                        |
|   6:VEXCHANGE                                              |
|      offset: 0                                             |
|      distribute expr lists:                                |
|                                                            |
| PLAN FRAGMENT 1                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#8]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 06                                        |
|     HASH_PARTITIONED: c2[#10]                              |
|                                                            |
|   5:VAGGREGATE (update serialize)(348)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#8])[#11]                      |
|   |  group by: c2[#9]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  distribute expr lists: c1[#8]                         |
|   |                                                        |
|   4:VOlapScanNode(345)                                     |
|      TABLE: tt.t1(t1), PREAGGREGATION: ON                  |
|      partitions=1/1 (t1)                                   |
|      tablets=1/1, tabletList=491188                        |
|      cardinality=21, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
| PLAN FRAGMENT 2                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#0]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 02                                        |
|     HASH_PARTITIONED: c2[#2]                               |
|                                                            |
|   1:VAGGREGATE (update serialize)(361)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#0])[#3]                       |
|   |  group by: c2[#1]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  distribute expr lists: c1[#0]                         |
|   |                                                        |
|   0:VOlapScanNode(358)                                     |
|      TABLE: tt.t2(t2), PREAGGREGATION: ON                  |
|      partitions=1/1 (t2)                                   |
|      tablets=1/1, tabletList=491198                        |
|      cardinality=10, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
|                                                            |
| Statistics                                                 |
|  planed with unknown column statistics                     |
+------------------------------------------------------------+
105 rows in set (0.06 sec)
자주 묻는 질문
Bucket Shuffle Join과 Colocate Join에는 데이터 분포와 JOIN 조건에 관한 제약이 있습니다. 다음 절에서는 각 방식의 구체적인 제한 사항을 설명합니다.
Bucket Shuffle Join 제한 사항
두 물리적 테이블을 직접 스캔하여 Bucket Shuffle Join을 수행하려면 다음 조건을 충족해야 합니다.
- 동등 JOIN 조건: Bucket Shuffle Join은 해시 계산으로 데이터 분포를 결정하므로 동등 JOIN 조건이 있는 시나리오에만 적용됩니다.
- 버킷 컬럼을 포함하는 동등 조건: 동등 JOIN 조건에는 두 테이블의 버킷 컬럼이 포함되어야 합니다. 왼쪽 테이블의 버킷 컬럼이 동등 JOIN 조건에 포함되면 쿼리가 Bucket Shuffle Join으로 계획될 가능성이 높아집니다.
- 테이블 유형 제한: Bucket Shuffle Join은 Doris 네이티브 OLAP 테이블에만 적용됩니다. ODBC, MySQL, ES와 같은 외부 테이블을 왼쪽 테이블로 사용하면 Bucket Shuffle Join이 적용되지 않습니다.
- 단일 파티션 요구 사항: 파티션이 있는 테이블은 파티션마다 데이터 분포가 다를 수 있으므로, 왼쪽 테이블이 단일 파티션인 경우에만 Bucket Shuffle Join의 동작이 보장됩니다. 따라서 SQL 실행 시 가능하면
WHERE조건을 사용하여 파티션 프루닝 전략이 적용되도록 하세요.
Colocate Join 제한 사항
두 물리적 테이블을 직접 스캔하는 경우 Colocate Join에는 Bucket Shuffle Join보다 엄격한 제약이 적용됩니다. Bucket Shuffle Join의 모든 조건 외에도 다음 요구 사항을 충족해야 합니다.
- 일관된 버킷 컬럼: 데이터 분포의 일관성을 보장하려면 버킷 컬럼의 유형과 개수가 일치해야 합니다.
- 동일한 Colocation Group: Colocation Group을 명시적으로 지정해야 하며, 동일한 Colocation Group에 속하는 테이블끼리만 Colocate Join을 수행할 수 있습니다.
- 안정적인 Group 상태: 복제본 복구나 복제본 균형 조정 등의 작업 중에는 Colocation Group이 Unstable 상태일 수 있습니다. 이 경우 Colocate Join은 일반 JOIN 연산으로 대체됩니다.