벡터 검색
Apache Doris는 4.0 버전부터 ANN(Approximate Nearest Neighbor, 근사 최근접 이웃) 벡터 검색을 기본 지원합니다. Faiss 기반의 HNSW 및 IVF 인덱스를 통해 수십억 개의 벡터에서 밀리초 수준의 TopN 검색과 범위 검색을 제공합니다.
활용 시나리오
벡터 검색은 RAG(Retrieval-Augmented Generation, 검색 증강 생성)와 멀티모달 검색의 핵심 기능입니다. 대표적인 활용 사례는 다음과 같습니다.
- RAG 검색: 대규모 지식 베이스에서 사용자 쿼리와 가장 관련성이 높은 Top-K 텍스트 조각을 검색하고, 이를 LLM 생성의 근거로 사용합니다. 이를 통해 환각 현상과 오래된 지식으로 인한 문제를 완화합니다.
- 멀티모달 검색: 이미지, 오디오, 비디오 등의 데이터를 벡터로 인코딩하여 의미적 유사도 쿼리를 수행합니다. 예를 들어 의료 질의응답에서는 진료 기록과 문헌을 검색하여 진단 제안을 돕습니다.
- 추천 시스템: 범위 검색을 사용하여 "유사하지만 동일하지는 않은" 후보 콘텐츠를 검색함으로써 추천의 다양성을 높입니다.
- 이상 탐지: 정상 패턴에서 벗어나는 데이터 포인트를 찾습니다.
벡터 검색의 핵심은 동일한 방식으로 쿼리와 문서를 의미 벡터로 인코딩한 다음, 대규모 벡터 집합에서 쿼리와 가장 유사한 K개의 벡터를 찾는 것입니다.
빠른 탐색
| 시나리오 | 섹션 |
|---|---|
| 벡터 인덱스 생성 방법 알아보기 | 근사 최근접 이웃 검색 |
| 코사인 유사도 검색 구현하기 | 코사인 유사도 사용 |
| 거리 임계값으로 필터링하기 | 근사 범위 검색 |
| TopN과 범위 조건 결합하기 | 복합 검색 |
| ANN 검색 전에 다른 컬럼으로 필터링하기 | 필터를 적용한 ANN 검색 |
| 쿼리 동작 매개변수 조정하기 | 쿼리 매개변수 |
| 메모리 절약 및 인덱스 크기 줄이기 | 벡터 양자화 |
| QPS 향상 및 지연 시간 줄이기 | 성능 튜닝 |
| Python SDK 사용하기 | Python SDK |
| 사용 제한 사항 알아보기 | 사용 제한 사항 |
근사 최근접 이웃 검색
Doris는 새로운 데이터 타입을 도입하지 않습니다. 벡터는 고정 길이의 Array<Float>로 저장되며, 거리 기반 검색을 위한 Faiss 기반 ANN 인덱스 타입을 제공합니다.
테이블 생성 예제
널리 사용되는 SIFT 데이터셋을 예로 들어 보겠습니다.
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="flat"
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
각 핵심 매개변수의 의미는 다음과 같습니다.
index_type: 인덱스 알고리즘입니다.hnsw(Hierarchical Navigable Small World),ivf(역파일 인덱스),ivf_on_disk(역색인 목록을 디스크에 저장하고 캐시를 통해 제공하는 IVF 변형) 중에서 선택할 수 있습니다.metric_type: 거리 척도입니다.l2_distance는 거리 함수로 L2 거리를 사용한다는 의미입니다.dim: 벡터 차원입니다.128은 이 컬럼에 있는 각 벡터의 길이가 128이라는 의미입니다.quantizer: 인코딩 방식입니다.flat은 각 차원의 값을 원본 float32 값으로 저장한다는 의미입니다.
전체 인덱스 매개변수
| 매개변수 | 필수 여부 | 지원 값 / 선택 가능한 값 | 기본값 | 설명 |
|---|---|---|---|---|
index_type | 예 | hnsw, ivf, ivf_on_disk | (없음) | ANN 인덱스 알고리즘을 지정합니다. 현재 HNSW, 메모리 내 IVF, IVF On-Disk를 지원합니다. |
metric_type | 예 | l2_distance, inner_product | (없음) | 벡터 유사도 / 거리 척도를 지정합니다. l2_distance는 유클리드 거리입니다. inner_product는 코사인 유사도 시나리오에 사용할 수 있지만, 먼저 벡터를 정규화해야 합니다. |
dim | 예 | 양의 정수 (> 0) | (없음) | 벡터 차원을 지정합니다. 이후 적재되는 모든 벡터의 차원이 같아야 하며, 그렇지 않으면 오류가 발생합니다. |
nlist | 아니요 | 양의 정수 | 1024 | IVF의 역색인 버킷 수입니다. index_type=ivf 또는 ivf_on_disk일 때 적용됩니다. 값이 클수록 일반적으로 재현율과 속도 사이의 균형을 개선할 수 있지만, 빌드 비용이 증가합니다. |
max_degree | 아니요 | 양의 정수 | 32 | HNSW 그래프에서 노드당 최대 이웃 수(M)입니다. 인덱스 메모리 사용량과 검색 성능에 영향을 줍니다. |
ef_construction | 아니요 | 양의 정수 | 40 | HNSW 구축 중 후보 큐의 크기(efConstruction)입니다. 값이 클수록 그래프 품질이 높아지지만 빌드 속도가 느려집니다. |
quantizer | 아니요 | flat, sq8, sq4, pq | flat | 벡터 인코딩 / 양자화 방식입니다. flat: 원본 저장. sq8 / sq4: 스칼라 양자화(8 / 4비트). pq: 곱 양자화. |
pq_m | quantizer=pq일 때 필수 | 양의 정수 | (없음) | 원본 고차원 벡터를 분할할 하위 벡터의 수입니다. dim은 pq_m으로 나누어떨어져야 합니다. |
pq_nbits | quantizer=pq일 때 필수 | 양의 정수 | (없음) | 각 하위 벡터를 양자화하는 데 사용하는 비트 수로, 부분 공간의 코드북 크기(k = 2 ^ pq_nbits)를 결정합니다. Faiss에서는 일반적으로 이 값이 24 이하여야 합니다. |
데이터 적재
S3 TVF를 통해 SIFT 데이터셋을 적재합니다.
INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");

select count(*) from sift_1M
--------------

+----------+
| count(*) |
+----------+
|  1000000 |
+----------+
쿼리 예제
l2_distance_approximate / inner_product_approximate를 호출하면 ANN 인덱스 경로가 활성화됩니다.
호출 규칙:
- 함수 이름은 인덱스의
metric_type과 정확히 일치해야 합니다.metric_type=l2_distance→l2_distance_approximate사용metric_type=inner_product→inner_product_approximate사용
- 정렬 순서:
- L2 거리는 오름차순을 사용합니다(
ORDER BY dist ASC, 작을수록 더 가깝습니다). - 내적은 내림차순을 사용합니다(
ORDER BY dist DESC, 클수록 더 가깝습니다).
- L2 거리는 오름차순을 사용합니다(
SELECT id,
       l2_distance_approximate(
        embedding,
        [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]
       ) AS distance
FROM sift_1M
ORDER BY distance
LIMIT 10;
--------------

+--------+----------+
| id     | distance |
+--------+----------+
| 178811 | 210.1595 |
| 177646 | 217.0161 |
| 181997 | 218.5406 |
| 181605 | 219.2989 |
| 821938 | 221.7228 |
| 807785 | 226.7135 |
| 716433 | 227.3148 |
| 358802 | 230.7314 |
| 803100 | 230.9112 |
| 866737 | 231.6441 |
+--------+----------+
10 rows in set (0.02 sec)
정확한 검색 결과와 비교하려면 l2_distance / inner_product를 사용합니다(_approximate 접미사 제외). 이 예제에서 정확 검색에는 약 290 ms가 걸립니다. ANN 인덱스를 사용하면 쿼리 지연 시간이 약 290 ms에서 약 20 ms로 줄어듭니다.
10 rows in set (0.29 sec)
실행 방식
ANN 인덱스는 세그먼트 단위로 구축됩니다. 분산 테이블에서는 다음과 같이 동작합니다.
- 각 세그먼트가 로컬 TopN 결과를 반환합니다.
- TopN 연산자가 여러 태블릿과 세그먼트의 결과를 병합하여 전역 TopN을 생성합니다.
코사인 유사도 사용
Doris ANN 인덱스의 metric_type은 현재 l2_distance와 inner_product만 지원하며, cosine을 직접 지원하지 않습니다. 비즈니스에서 사용하는 척도가 코사인 유사도라면, 정규화를 통해 동등한 내적 계산으로 변환할 수 있습니다.
절차
- 쓰기 전: 벡터를 L2 정규화합니다(단위 길이로 정규화).
- 인덱스 생성 시:
metric_type="inner_product"를 사용합니다. - 쿼리 시:
inner_product_approximate(...)를 사용하고ORDER BY ... DESC로 정렬합니다.
예제:
CREATE INDEX idx_emb_cosine ON your_table (embedding) USING ANN PROPERTIES (
  "index_type"="hnsw",
  "metric_type"="inner_product",
  "dim"="768"
);
동등성이 성립하는 원리
- 코사인 유사도 공식:
cos(x, y) = (x · y) / (||x|| ||y||) - 벡터를 L2 정규화하면(
||x|| = ||y|| = 1):cos(x, y) = x · y
따라서 단위 벡터 공간에서는 코사인 유사도를 최대화하는 것이 내적을 최대화하는 것과 같습니다. 정규화하지 않으면 내적과 코사인 유사도는 더 이상 동등하지 않습니다.
근사 범위 검색
벡터 검색에는 TopN 최근접 이웃 검색 외에도 거리 임계값을 기준으로 하는 범위 검색이라는 일반적인 쿼리 유형이 있습니다. 이 쿼리는 고정된 수의 행을 반환하지 않고, 대상 벡터와의 거리가 조건을 만족하는 모든 데이터 포인트를 찾습니다.
대표적인 활용 사례:
- 추천 시스템에서 다양성을 높이기 위해 "가깝지만 동일하지는 않은" 콘텐츠를 검색합니다.
- 이상 탐지에서 정상 패턴에서 벗어나는 데이터 포인트를 찾습니다.
예제: 대상 벡터와의 L2 거리가 300보다 큰 행의 수를 계산합니다.
SELECT count(*)
FROM   sift_1M
WHERE  l2_distance_approximate(
        embedding,
        [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2])
        > 300
--------------

+----------+
| count(*) |
+----------+
|   999271 |
+----------+
1 row in set (0.19 sec)
범위 검색도 ANN 인덱스로 가속됩니다. 시스템은 먼저 후보 벡터 집합을 빠르게 추린 다음, 정밀한 근사 거리를 계산하여 오버헤드를 크게 줄입니다. 현재 지원되는 범위 조건은 다음과 같습니다: >, >=, <, <=.
복합 검색
복합 검색은 동일한 SQL 문에서 ANN TopN과 범위 필터링을 함께 수행하여 범위 제약 조건을 만족하는 TopN을 반환하는 방식입니다.
SELECT id,
       l2_distance_approximate(
        embedding, [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]) as dist
FROM sift_1M
WHERE l2_distance_approximate(
        embedding, [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2])
        > 300
ORDER BY dist limit 10
--------------

+--------+----------+
| id     | dist     |
+--------+----------+
| 243590 |  300.005 |
| 549298 | 300.0317 |
| 429685 | 300.0533 |
| 690172 | 300.0916 |
| 123410 | 300.1333 |
| 232540 | 300.1649 |
| 547696 | 300.2066 |
| 855437 | 300.2782 |
| 589017 | 300.3048 |
| 930696 | 300.3381 |
+--------+----------+
10 rows in set (0.12 sec)
사전 필터링과 사후 필터링 비교
| 전략 | 의미 | 장점 | 단점 |
|---|---|---|---|
| 사전 필터링(Doris에서 사용) | 먼저 술어를 적용한 다음 남은 집합에서 TopN을 선택 | 높은 재현율 | 상대적으로 느림 |
| 사후 필터링 | 먼저 TopN을 선택한 다음 필터링 | 빠름 | 재현율이 크게 떨어질 수 있음 |
Doris에서는 복합 검색의 두 단계 모두 인덱스로 가속할 수 있습니다. 하지만 일부 시나리오에서는(예: 첫 번째 단계의 범위 필터 선택도가 매우 높은 경우) 두 단계 모두에 인덱스를 사용하면 재현율이 떨어질 수 있습니다. Doris는 술어 선택도와 인덱스 타입에 따라 두 단계 모두에 인덱스를 사용할지 상황에 맞게 결정합니다.
필터를 적용한 ANN 검색
필터를 적용한 ANN 검색은 ANN TopN을 수행하기 전에 다른 술어를 적용하고, 조건을 만족하는 TopN을 반환하는 방식입니다.
다음 8차원 예제는 하이브리드 검색의 처리 과정을 보여 줍니다.
CREATE TABLE ann_with_fulltext (
  id int NOT NULL,
  embedding array<float> NOT NULL,
  comment String NOT NULL,
  value int NULL,
  INDEX idx_comment(`comment`) USING INVERTED PROPERTIES("parser" = "english") COMMENT 'inverted index for comment',
  INDEX ann_embedding(`embedding`) USING ANN PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY (`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES("replication_num"="1");

INSERT INTO ann_with_fulltext VALUES
(1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music', 10),
(2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today',   20),
(3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend',  30),
(4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update',40)
사용자 쿼리 벡터 [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]가 주어지면, 가장 유사한 문서 상위 2개를 comment에 "music"이 포함된 문서 중에서만 검색합니다.
SELECT id, comment,
       l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
FROM ann_with_fulltext
WHERE comment MATCH_ANY 'music'       -- Filter using the inverted index first
ORDER BY dist ASC                     -- Then perform ANN TopN over the filtered result set
LIMIT 2;

+------+---------------------+----------+
| id   | comment             | dist     |
+------+---------------------+----------+
|    1 | this is about music | 0.663325 |
|    3 | latest music trend  | 1.280625 |
+------+---------------------+----------+
2 rows in set (0.04 sec)
필터를 적용한 ANN 검색에서 벡터 인덱스로 TopN을 가속하려면, 필터링에 사용되는 컬럼에 역색인과 같은 보조 인덱스가 있어야 합니다.
쿼리 매개변수
HNSW 인덱스 구축 시 지정하는 매개변수 외에도, 쿼리 단계에서 세션 변수를 통해 동작을 조정할 수 있습니다.
| 세션 변수 | 기본값 | 설명 |
|---|---|---|
hnsw_ef_search | 32 | HNSW 인덱스의 EF 검색 매개변수입니다. 검색 중 후보 큐의 최대 길이를 제어합니다. 값이 클수록 정확도가 높아지지만 지연 시간도 늘어납니다. |
hnsw_check_relative_distance | true | HNSW 검색 정확도를 높이기 위한 상대 거리 검사 메커니즘을 활성화할지 여부입니다. |
hnsw_bounded_queue | true | HNSW 검색 성능을 최적화하기 위해 크기가 제한된 우선순위 큐를 사용할지 여부입니다. |
벡터 양자화
FLAT 인코딩을 사용하면 HNSW 인덱스(원본 벡터와 그래프 구조)가 많은 메모리를 사용할 수 있습니다. HNSW가 동작하려면 전체가 메모리에 상주해야 하므로, 매우 큰 데이터셋에서는 쉽게 병목이 됩니다.
Doris는 두 가지 유형의 양자화 방식을 제공합니다.
| 양자화 | 원리 | Doris 지원 |
|---|---|---|
| 스칼라 양자화(SQ) | 각 FLOAT32 차원을 압축하여 메모리 오버헤드 감소 | sq8 (INT8), sq4 (INT4) |
| 곱 양자화(PQ) | 고차원 벡터를 분해하고 각 하위 벡터를 개별적으로 양자화 | pq |
스칼라 양자화(SQ) 예제
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="sq8"    -- Use INT8 for quantization
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
768차원의 Cohere-MEDIUM-1M 및 Cohere-LARGE-10M 데이터셋으로 수행한 테스트에서 SQ8은 인덱스 크기를 FLAT의 약 1/3로 압축합니다.
양자화 비교
| 데이터셋 | 벡터 차원 | 저장 / 인덱스 방식 | 총 디스크 사용량 | 데이터 부분 | 인덱스 부분 | 참고 |
|---|---|---|---|---|---|---|
| Cohere-MEDIUM-1M | 768D | Doris (FLAT) | 5.647 GB (2.533 + 3.114) | 2.533 GB | 3.114 GB | 1M 벡터, 원본 + HNSW FLAT 인덱스 |
| Cohere-MEDIUM-1M | 768D | Doris SQ INT8 | 3.501 GB (2.533 + 0.992) | 2.533 GB | 0.992 GB | INT8 대칭 양자화 |
| Cohere-MEDIUM-1M | 768D | Doris PQ (pq_m=384, pq_nbits=8) | 3.149 GB (2.535 + 0.614) | 2.535 GB | 0.614 GB | 곱 양자화 |
| Cohere-LARGE-10M | 768D | Doris (FLAT) | 56.472 GB (25.328 + 31.145) | 25.328 GB | 31.145 GB | 10M 벡터 |
| Cohere-LARGE-10M | 768D | Doris SQ INT8 | 35.016 GB (25.329 + 9.687) | 25.329 GB | 9.687 GB | INT8 양자화, 인덱스 크기가 크게 감소 |
곱 양자화(PQ)
Doris는 곱 양자화도 지원하지만, PQ를 사용하려면 추가 매개변수가 필요합니다.
pq_m: 원본 고차원 벡터를 분할할 하위 벡터의 수입니다. 벡터 차원dim은pq_m으로 나누어떨어져야 합니다.pq_nbits: 각 하위 벡터를 양자화하는 데 사용하는 비트 수로, 부분 공간의 코드북 크기를 결정합니다. Faiss에서는 일반적으로 이 값이 24 이하여야 합니다.
PQ 양자화는 학습 단계에서 학습 데이터에 대한 요구 사항이 있습니다. 데이터 포인트 수가 최소한 클러스터 중심의 수 이상이어야 합니다. 즉, 학습 데이터 포인트 수 n >= 2 ^ pq_nbits여야 합니다.
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="pq",    -- Use PQ for quantization
      "pq_m"="2",          -- Required when using PQ. Number of low-dim sub-vectors the high-dim vector is split into
      "pq_nbits"="2"       -- Required when using PQ. Number of bits per subspace codebook
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
양자화 비용
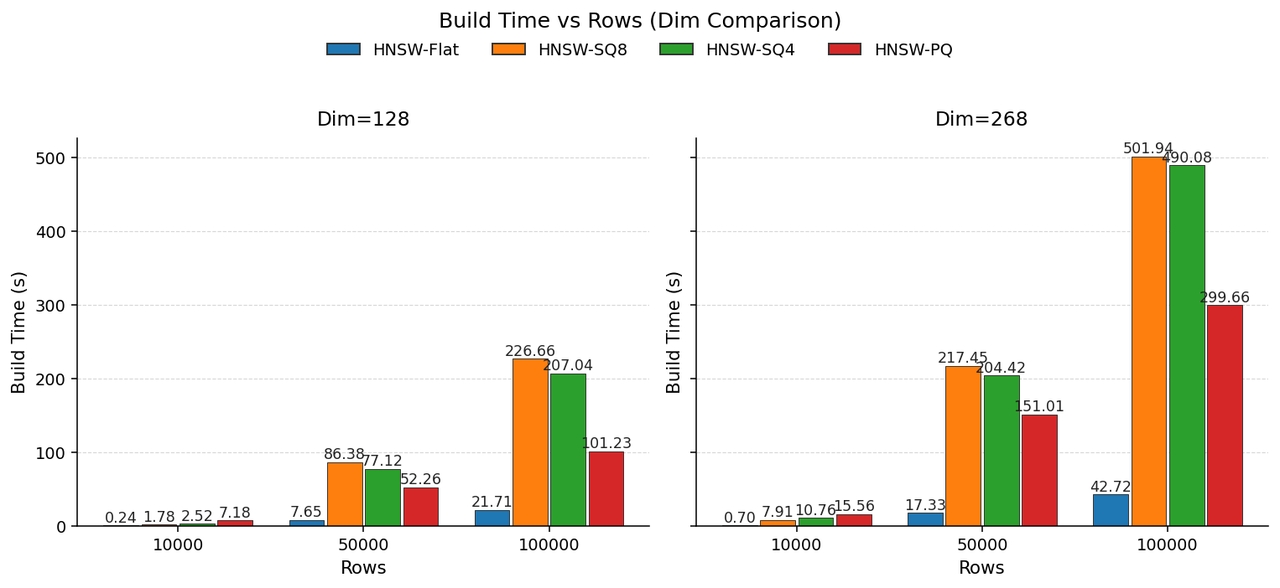
양자화는 추가 빌드 오버헤드를 유발합니다. 빌드 단계에서는 많은 거리 계산이 필요하며, 각 계산에서 양자화된 값을 디코딩해야 합니다. 128차원 벡터의 경우 행 수가 늘어날수록 빌드 시간이 증가하며, SQ는 FLAT 대비 약 10배의 빌드 비용을 유발할 수 있습니다.
성능 튜닝
벡터 검색은 보조 인덱스를 사용하는 전형적인 포인트 쿼리 시나리오입니다. 높은 QPS와 낮은 지연 시간이 필요하다면 아래 권장 사항을 참고하세요. 튜닝 후 FE 32C 64GB + BE 32C 64GB 사양의 머신에서 Doris는 3000+ QPS를 달성할 수 있습니다(데이터셋: Cohere-MEDIUM-1M).
쿼리 성능 벤치마크
| 동시 실행 수 | 방식 | QPS | 평균 지연 시간 (s) | P99 지연 시간 (s) | CPU 사용률 | 재현율 |
|---|---|---|---|---|---|---|
| 240 | Doris | 3340.4399 | 0.071368168 | 0.163399825 | 40% | 91.00% |
| 240 | Doris SQ INT8 | 3188.6359 | 0.074728852 | 0.160370195 | 40% | 88.26% |
| 240 | Doris SQ INT4 | 2818.2291 | 0.084663868 | 0.174826815 | 43% | 80.38% |
| 240 | Doris 전수 검색 | 3.6787 | 25.554878826 | 29.363227973 | 100% | 100.00% |
| 480 | Doris | 4155.7220 | 0.113387271 | 0.261086075 | 60% | 91.00% |
| 480 | Doris SQ INT8 | 3833.1130 | 0.123040214 | 0.276912867 | 50% | 88.26% |
| 480 | Doris SQ INT4 | 3431.0538 | 0.137636995 | 0.281631249 | 57% | 80.38% |
| 480 | Doris 전수 검색 | 3.6787 | 25.554878826 | 29.363227973 | 100% | 100.00% |
준비된 문 사용
일반적인 임베딩 모델의 출력은 대개 768차원 이상입니다. 이러한 벡터를 SQL에 리터럴로 직접 넣으면 파싱 시간이 실제 실행 시간을 초과할 수 있습니다. 따라서 준비된 문 사용을 권장합니다. 현재 Doris는 mysql 클라이언트에서 이러한 명령을 직접 실행하는 것을 지원하지 않으므로 JDBC가 필요합니다.
-
JDBC URL에서 서버 측 준비된 문을 활성화합니다.
url = jdbc:mysql://127.0.0.1:9030/demo?useServerPrepStmts=true -
준비된 문을 사용합니다.
// use `?` for placement holders, readStatement should be reused
PreparedStatement readStatement = conn.prepareStatement("SELECT id, l2_distance_approximate(embedding, cast (? as ARRAY<FLOAT>)) AS distance
    FROM sift_1M
    ORDER BY distance
    LIMIT 10");

...

readStatement.setString("[0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]");

ResultSet resultSet = readStatement.executeQuery();
세그먼트 수 줄이기
Doris ANN 인덱스는 세그먼트 단위로 구축됩니다. 세그먼트가 너무 많으면 추가 오버헤드가 발생합니다.
- 권장 사항: ANN 인덱스가 있는 테이블에서는 태블릿당 세그먼트 수가 5를 넘지 않도록 합니다.
- 방법:
write_buffer_size와vertical_compaction_max_segment_size를be.conf에서 조정하여 개별 세그먼트의 크기를 늘리고 개수를 줄입니다. 두 값 모두10737418240(10 GB)으로 설정하는 것을 권장합니다.
rowset 수 줄이기
각 데이터 적재는 하나의 rowset을 생성하며, rowset이 너무 많으면 스케줄링 오버헤드도 증가합니다. 일괄 데이터 적재에는 Stream Load 또는 **INSERT INTO SELECT**를 사용합니다.
ANN 인덱스를 메모리에 상주시키기
현재 ANN 인덱스 알고리즘은 메모리 기반입니다. 쿼리 대상 세그먼트의 인덱스가 메모리에 상주하지 않으면 디스크 I/O가 발생합니다. 성능을 위해 be.conf에 다음을 설정하여 인덱스를 메모리에 상주시킵니다.
enable_segment_cache_prune=false
parallel_pipeline_task_num = 1
ANN TopN 쿼리는 반환하는 행 수가 매우 적으므로 높은 병렬성이 필요하지 않습니다. 다음을 사용합니다.
SET parallel_pipeline_task_num = 1;
enable_profile = false
지연 시간에 매우 민감한 경우 쿼리 프로파일을 비활성화합니다.
SET enable_profile = false;
Python SDK
AI 시대에 Python은 데이터 처리와 지능형 애플리케이션 개발의 주류 언어가 되었습니다. 개발자가 Python에서 Doris 벡터 검색을 더 쉽게 사용할 수 있도록 커뮤니티에서 Python SDK를 기여했습니다.
- doris_vector_search: 벡터 거리 기반 검색에 최적화되어 있습니다. 현재 Doris 벡터 검색용 Python SDK 중 성능이 가장 뛰어납니다.
사용 제한 사항
Doris 벡터 인덱스를 사용할 때는 다음 제한 사항에 유의하세요.
-
데이터 타입 제한: ANN 인덱스를 구축하는 컬럼은
NOT NULLABLE인Array<Float>여야 합니다. 데이터 적재 중 이 컬럼에 있는 모든 벡터의 길이는 인덱스 속성에 지정한 차원(dim)과 같아야 하며, 그렇지 않으면 오류가 발생합니다. -
테이블 모델 제한: ANN 인덱스는 Duplicate Key 테이블 모델 또는 merge-on-write가 활성화된 Unique Key 테이블에서만 사용할 수 있습니다(
enable_unique_key_merge_on_write = true). Unique Key 테이블 지원은 4.1.4 버전에서 추가되었습니다. merge-on-read Unique Key 테이블과 Aggregate Key 테이블은 여전히 지원하지 않으며, 이러한 테이블에 인덱스를 생성하면 다음 오류가 발생합니다:ANN index can only be used in DUP_KEYS table or UNIQUE_KEYS table with merge-on-write enabled. -
술어 컬럼에는 보조 인덱스가 있어야 함: Doris는 사전 필터링 의미 체계를 사용합니다(AnnTopN 전에 술어 평가). SQL의 술어가 참조하는 컬럼에 보조 인덱스가 없으면, Doris는 정확성을 보장하기 위해 전수 계산으로 전환합니다. 예를 들면 다음과 같습니다.
SELECT id, l2_distance_approximate(embedding, [xxx]) AS distance
    FROM sift_1M
    WHERE round(id) > 100
ORDER BY distance limit 10;id는 기본 키이지만, 이 컬럼에는 행 번호를 정확하게 찾을 수 있는 보조 인덱스(예: 역색인)가 구축되어 있지 않습니다. 이러한 술어는 인덱스 분석 후에 평가됩니다. ANN TopN의 사전 필터링 의미 체계를 유지하기 위해 시스템은 전수 계산으로 전환합니다. -
거리 함수는 척도 타입과 일치해야 함: SQL에서 사용하는 거리 함수가 DDL에 정의한 인덱스의
metric_type과 일치하지 않으면, Doris는 TopN 계산에 ANN 인덱스를 사용할 수 없습니다(l2_distance_approximate/inner_product_approximate를 사용하더라도 마찬가지입니다). -
inner_product는 DESC 정렬을 사용해야 함:metric_type이inner_product일 때는ORDER BY inner_product_approximate() DESC LIMIT N만 ANN 인덱스로 가속할 수 있습니다(DESC는 생략할 수 없음). -
함수 인자 순서:
xxx_approximate()함수는 첫 번째 인자가ColumnArray이고 두 번째 인자가CAST또는ArrayLiteral일 때만 인덱스 분석을 수행합니다. 순서를 바꾸면 전수 검색으로 전환됩니다.
자주 묻는 질문
Q1: Doris ANN 인덱스는 어떤 거리 척도를 지원하나요?
현재 l2_distance(유클리드 거리)와 inner_product를 지원합니다. 코사인 유사도는 코사인 유사도 사용 섹션을 참고하세요.
Q2: ANN 쿼리가 인덱스를 사용하지 않는 이유는 무엇인가요?
가능한 원인은 다음과 같습니다.
- 거리 함수가
metric_type과 일치하지 않습니다. inner_product를 사용할 때ORDER BY ... DESC를 사용하지 않았습니다.- 함수 인자 순서가 뒤바뀌었습니다(
ColumnArray가 첫 번째 인자여야 함). - 필터 컬럼에 역색인과 같은 보조 인덱스가 없어 전수 검색으로 전환됩니다.
Q3: HNSW, IVF, IVF On-Disk 중에서 어떻게 선택하나요?
| 인덱스 | 메모리 사용량 | 쿼리 성능 | 활용 시나리오 |
|---|---|---|---|
| HNSW | 높음(전체가 메모리에 상주해야 함) | 높음 | 중소 규모, 낮은 지연 시간이 매우 중요한 경우 |
| IVF | 중간 | 중간 | 대규모 데이터 |
| IVF On-Disk | 낮음(디스크 + 캐시) | 중간 | 초대규모 데이터, 메모리가 제한된 환경 |
Q4: 메모리가 부족하면 어떻게 하나요?
양자화를 통해 메모리 사용량을 줄입니다.
- 먼저
sq8(INT8 스칼라 양자화)을 시도하세요. 일반적으로 재현율에 미치는 영향을 제한하면서 인덱스를 원본 크기의 약 1/3로 압축합니다. - 메모리가 매우 부족하면
sq4또는pq를 사용하세요. 다만 재현율은 다소 떨어집니다.
Q5: 키워드 필터링과 벡터 검색을 어떻게 결합하나요?
필터 컬럼에 역색인을 구축한 다음 WHERE 절이 있는 ANN 쿼리를 사용합니다. 필터를 적용한 ANN 검색을 참고하세요.
Q6: QPS를 어떻게 높이나요?
성능 튜닝 섹션을 참고하세요. 핵심 사항은 다음과 같습니다.
- 준비된 문을 사용하여 SQL 파싱 오버헤드를 줄입니다.
- 세그먼트와 rowset의 수를 줄입니다.
- ANN 인덱스를 메모리에 상주시킵니다.
parallel_pipeline_task_num = 1.- 쿼리 프로파일을 비활성화합니다.