피어 캐시 읽기: 다른 BE 및 컴퓨트 그룹의 File Cache 읽기(컴퓨트-스토리지 분리)
피어 캐시 읽기는 컴퓨트-스토리지 분리 모드에서 File Cache 미스를 처리하는 방식입니다. BE의 로컬 File Cache에 블록이 없으면 먼저 같은 컴퓨트 그룹이나 다른 컴퓨트 그룹에 있는 BE의 File Cache에 요청하고, 피어에도 해당 블록이 없을 때만 오브젝트 스토리지에서 읽습니다. 이 기능은 콜드 읽기 경로에만 영향을 주며, 로컬 캐시에 적중하는 읽기 동작은 그대로 유지됩니다.
그룹 간 피어 캐시 읽기는 Doris 4.2.0부터 실험적 기능으로 제공되며, 기본적으로 비활성화되어 있습니다. 사용하려면 해당 BE에서 enable_cache_read_from_peer = true를 명시적으로 설정해야 합니다.
사용 사례
| 시나리오 | 피어 읽기의 동작 | 이점 |
|---|---|---|
| 컴퓨트 그룹 내 확장 | 스케일 아웃 또는 태블릿 리밸런싱 후 새 BE에서 처음 읽을 때, 오브젝트 스토리지에 접근하는 대신 이전에 해당 태블릿을 제공하던 BE에서 캐시된 블록을 가져옵니다 | 리밸런싱 후 성능 저하 기간이 짧아지고, 오브젝트 스토리지로 향하는 트래픽이 줄어듭니다 |
| 컴퓨트 그룹 간 콜드 읽기 | 현재 컴퓨트 그룹에는 캐시가 없지만 다른 그룹에서 이미 같은 데이터를 읽었다면, 해당 그룹의 BE에서 블록을 읽습니다 | 콜드 쿼리 지연 시간이 줄고, 오브젝트 스토리지 읽기 횟수가 감소합니다 |
| 그룹 간 캐시 채우기 | "캐시를 채울 컴퓨트 그룹"을 지정합니다. 해당 그룹의 BE에도 블록이 없으면 오브젝트 스토리지에서 블록을 가져와 자체 File Cache에 기록한 뒤 요청한 BE에 반환합니다 | 지정된 그룹이 오브젝트 스토리지 비용을 부담하고 캐시에 복사본을 유지합니다 |
성능 참고
TPC-H 1 TB 데이터셋을 사용한 콜드 읽기 테스트에서 피어 캐시 읽기는 오브젝트 스토리지에서 직접 읽는 것보다 약 두 배 빨랐습니다. 실제 성능 향상 폭은 다른 BE가 이미 데이터를 보유하고 있는지, 피어 네트워크 지연 시간이 오브젝트 스토리지 지연 시간과 비교해 어느 정도인지에 따라 달라집니다.
사전 요구 사항
- 컴퓨트-스토리지 분리 배포 환경이어야 합니다. 통합 모드에서는 피어 읽기가 작동하지 않습니다.
- 모든 BE에서 File Cache가 활성화되어 있어야 합니다(
enable_file_cache = true). enable_cache_read_from_peer = true를 명시적으로 설정해야 합니다(기본값false).- 그룹 간 캐시 채우기를 사용하려면 캐시를 채울 컴퓨트 그룹의 ID(
compute_group_id)가 필요합니다. 확인 방법은 캐시를 채울 컴퓨트 그룹 지정을 참조하세요.
제약 사항
- Doris 내부 테이블만 지원합니다. 외부 테이블(Hive, Iceberg 등)의 데이터 캐시는 피어 읽기를 사용하지 않습니다.
- 피어 읽기는 로컬 File Cache 미스가 발생할 때만 실행됩니다. 워밍업 작업에서 수행하는 읽기와 캐시 채우기 서버가 자체적으로 수행하는 오브젝트 스토리지 읽기는 피어 읽기를 다시 거치지 않습니다.
enable_cache_read_from_peer는 같은 그룹 내 피어 읽기와 그룹 간 피어 읽기를 모두 제어합니다. 현재는 같은 그룹 내 피어 읽기를 유지하면서 그룹 간 피어 읽기만 비활성화할 수 없습니다. 후보는 FE에서 제공하며, 다른 컴퓨트 그룹의 BE도 자연스럽게 포함됩니다.- 캐시 채우기 서버는 아직 작은 파일 병합으로 생성된 파일(Packed File)을 지원하지 않습니다. 이러한 요청은 평소처럼 오브젝트 스토리지로 폴백합니다.
- 다중 AZ 배포 환경에서는 그룹 간 피어 읽기로 AZ 간 네트워크 트래픽이 발생하며, 추가 비용이 들 수 있습니다.
- 피어 읽기는 최선 노력 방식으로 동작합니다. 피어에서 읽을지, 어느 BE에서 읽을지는 후보 목록, 타임아웃, 폴백 로직에 따라 결정됩니다.
작동 방식
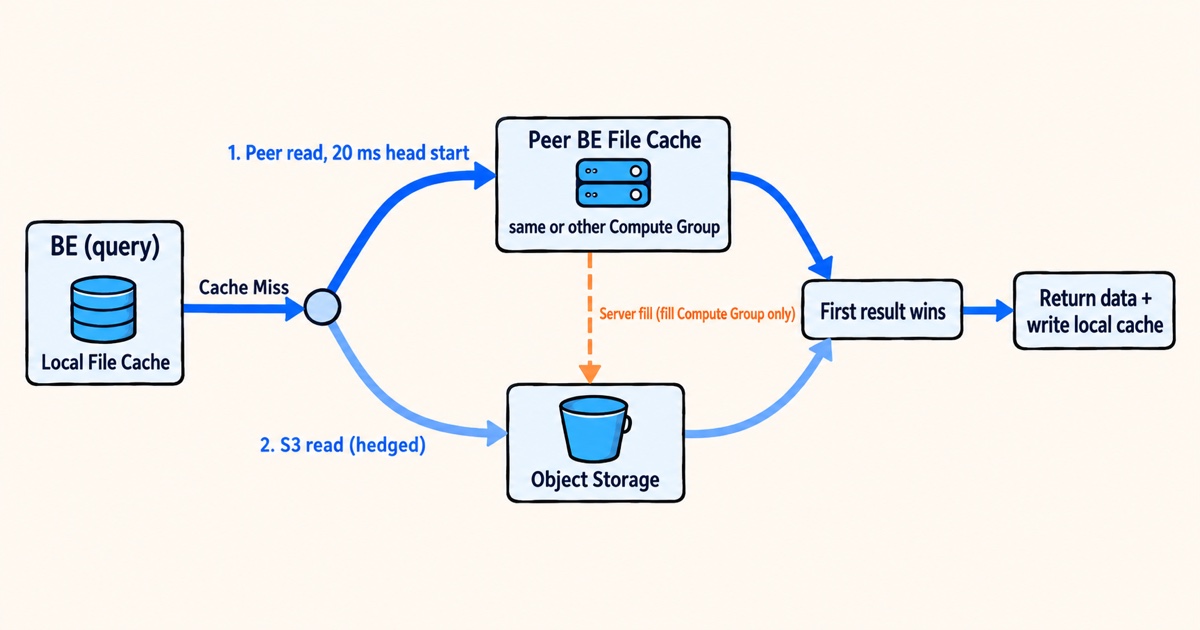
읽기 경로
- 블록을 읽는 쿼리는 먼저 로컬 File Cache를 확인하고, 캐시에 적중하면 결과를 반환합니다.
- 미스가 발생하면 BE는 해당 태블릿에 대한 피어 후보를 이미 보유하고 있는지 확인합니다. 후보가 없으면 이번 읽기는 바로 오브젝트 스토리지로 향하고, BE는 백그라운드에서 FE에 후보를 요청합니다. 현재 요청은 기다리지 않습니다.
- 후보가 있으면 피어 읽기와 오브젝트 스토리지 읽기가 경합합니다(
enable_peer_s3_race, 기본적으로 활성화). BE는 피어 읽기를 먼저 전송하고peer_race_hedge_delay_ms만큼의 선행 시간(기본값 20 ms)을 줍니다. 피어가 이 시간 안에 응답하면 오브젝트 스토리지 읽기는 전송하지 않습니다. - 먼저 반환된 결과를 사용합니다. 어느 쪽에서 읽든 데이터는 로컬 File Cache에 기록되므로, 이후 읽기는 로컬 캐시에 적중합니다.
- 피어 읽기에 실패하면 오브젝트 스토리지로 폴백하며, 쿼리 오류는 발생하지 않습니다. 후보에 블록이 없는 경우, RPC 오류, 동시 처리 슬롯 부족, 타임아웃 등이 실패에 해당합니다.
enable_peer_s3_race가 비활성화되어 있거나 동시 경합 수가 max_concurrent_peer_races(기본값 64)를 초과하면 BE는 순차적으로 읽습니다. 후보를 하나씩 시도하고, 모든 후보에서 실패한 후에만 오브젝트 스토리지에서 읽습니다.
콜드 쿼리는 대개 많은 읽기를 동시에 수행합니다. 세그먼트 푸터를 처음 읽을 때 이미 후보 조회가 시작되므로, 같은 쿼리 내에서 같은 태블릿을 이후에 읽을 때는 피어 읽기를 사용할 수 있습니다. 맨 처음 콜드 읽기가 오브젝트 스토리지로 향하는 것은 정상 동작입니다.
후보 정보의 출처
| 출처 | 설명 | 우선순위 |
|---|---|---|
| 리밸런싱의 원본 BE | 컴퓨트 그룹 스케일 아웃 또는 태블릿 리밸런싱 중 FE가 대상 BE에 보내는 워밍업 요청은 원본 BE를 후보로 기록합니다. balance_type이 without_warmup으로 설정되어 있으면 워밍업 요청을 보내지 않으며, 후보도 기록하지 않습니다 | 가장 높음 |
| FE가 반환하는 태블릿 분포 | 로컬 후보가 없으면 BE는 백그라운드에서 FE에 모든 컴퓨트 그룹에서 해당 태블릿을 보유한 BE를 요청하고, 이를 목록 끝에 추가합니다 | 낮음 |
| 수동 설정 | HTTP 인터페이스 /api/peer_cache?op=set을 통해 기록합니다(태블릿의 피어 정보 확인 및 조정 참조). 일반적으로 테스트와 문제 해결에만 사용합니다 | 기록된 순서 |
후보 선택 및 순환
- BE는 각 태블릿에 대해 마지막으로 데이터를 성공적으로 제공한 컴퓨트 그룹을 기억하고, 해당 그룹의 후보를 먼저 시도합니다.
- 블록을 보유하지 않은 후보는 목록 끝으로 이동하므로, 다음 읽기는 다른 후보를 시도합니다. RPC가
peer_rpc_failure_eviction_threshold회(기본값 3) 연속으로 실패한 후보는 제거됩니다. - 모든 후보에서 미스가 발생한 읽기가
peer_all_miss_cooldown_threshold회(기본값 5) 연속으로 이어지면, 해당 태블릿은peer_all_miss_cooldown_duration_s(기본값 300초) 동안 쿨다운 상태가 됩니다. 쿨다운 중에는 해당 태블릿의 읽기가 바로 오브젝트 스토리지로 향합니다. peer_candidate_expiry_s(기본값 3600초) 동안 사용하지 않은 후보 항목은 메모리에서 삭제됩니다. 다음 미스가 발생하면 FE에서 다시 조회합니다.
버전 4.2.0부터 피어 읽기는 여러 태블릿에 걸쳐 주소 단위의 서킷 브레이커를 공유합니다. 한 주소에서 연결 또는 RPC 실패가 cache_peer_read_failure_threshold회 연속으로 발생하면(기본값 3, 유효 최솟값 1), 해당 주소에 대한 읽기를 cache_peer_read_circuit_open_seconds초 동안 중단합니다(기본값 30, 음수는 0으로 처리). 이 기간이 지나면 복구 확인 요청을 하나만 허용합니다. 이 동작은 태블릿 후보 제거 및 모든 후보에서 미스가 발생한 후의 쿨다운과 독립적으로 작동합니다.
그룹 간 캐시 채우기
요청하는 BE에 peer_cache_fill_compute_group_id가 설정되어 있고 선택된 후보가 해당 컴퓨트 그룹에 속하면, 요청에 캐시 채우기 플래그가 포함됩니다. 요청을 받은 BE에 블록이 없고 enable_peer_server_cache_fill이 활성화되어 있으면(기본 동작), 오브젝트 스토리지에서 블록을 읽어 자체 File Cache에 기록한 뒤 반환합니다.
캐시 채우기는 max_concurrent_peer_server_fills(기본값 32)와 peer_server_cache_fill_timeout_ms(기본값 6000 ms)의 제한을 받습니다. 한도에 도달하거나 캐시 채우기 시간이 초과되면 요청한 BE는 오브젝트 스토리지로 폴백합니다.
설정
아래의 모든 매개변수는 BE 설정입니다. 스레드 풀 매개변수를 제외하면 런타임에 변경할 수 있습니다. 런타임에 매개변수 변경을 참조하세요.
피어 읽기 확인 또는 비활성화
피어 읽기는 기본적으로 비활성화되어 있습니다. 사용하려면 File Cache를 활성화하고 enable_cache_read_from_peer=true를 BE의 be.conf에 설정하거나, 아래의 동적 설정 엔드포인트를 사용하세요. 같은 그룹 내 읽기와 그룹 간 읽기가 함께 활성화되며, FE가 후보를 자동으로 제공합니다. MySQL 클라이언트에서 현재 값을 확인합니다.
SHOW BACKEND CONFIG LIKE 'enable_cache_read_from_peer';
비활성화하려면 모든 BE의 be.conf에 다음을 설정합니다.
enable_cache_read_from_peer = false
비활성화하면 로컬 미스는 바로 오브젝트 스토리지로 향하며, peer_read_async_warmup처럼 피어 읽기에 의존하는 균형 조정 전략은 효과가 없어집니다.
캐시를 채울 컴퓨트 그룹 지정
그룹 간 콜드 읽기 중 특정 컴퓨트 그룹이 오브젝트 스토리지에서 데이터를 가져와 자체 캐시를 채우도록 하려면, 다음 세 단계를 수행합니다.
-
대상 컴퓨트 그룹의 ID를 찾습니다.
compute_group_id는Tag열(SHOW BACKENDS출력)에 표시되는 컴퓨트 그룹 ID이며,compute_group_name과 다릅니다.SHOW BACKENDS\G*************************** 1. row ***************************
BackendId: 10001
Host: 10.0.0.1
...
Tag: {"cloud_unique_id" : "1:xxx:yyy", "compute_group_id" : "cg_write_01", "compute_group_name" : "write_group", "compute_group_status" : "NORMAL", "location" : "default"} -
쿼리를 실행하는 컴퓨트 그룹의 모든 BE에 다음을 설정합니다.
peer_cache_fill_compute_group_id = cg_write_01 -
캐시를 채울 컴퓨트 그룹의 BE에서
enable_peer_server_cache_fill이true(기본값)인지 확인합니다.
런타임에 매개변수 변경
스레드 풀 매개변수를 제외하면 이 페이지의 모든 매개변수를 런타임에 변경할 수 있습니다. 변경 사항을 persist=true로 영구 저장할 수 있으며, 저장 대상은 be_custom.conf입니다.
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?enable_cache_read_from_peer=false&persist=true"
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?peer_race_hedge_delay_ms=30"
매개변수
활성화 스위치 및 경합
| 매개변수 | 기본값 | 설명 |
|---|---|---|
enable_cache_read_from_peer | false | 피어 읽기의 전체 활성화 스위치입니다. 활성화하면 로컬 File Cache 미스가 발생할 때 같은 컴퓨트 그룹과 다른 컴퓨트 그룹의 BE를 먼저 시도합니다 |
enable_peer_s3_race | true | 피어 읽기와 오브젝트 스토리지 읽기를 경합시킬지 여부입니다. 비활성화하면 후보를 하나씩 시도하고, 모든 후보에서 실패한 후에만 오브젝트 스토리지에서 순차적으로 읽습니다 |
peer_race_hedge_delay_ms | 20 | 피어 읽기에 부여하는 선행 시간이며, 단위는 밀리초입니다. 피어가 이 시간 안에 응답하면 오브젝트 스토리지 읽기는 전송하지 않습니다. 0이면 둘 다 동시에 시작합니다 |
max_concurrent_peer_races | 64 | BE 하나에서 허용하는 최대 동시 경합 수입니다. 이 한도를 초과하는 미스는 순차적으로 처리합니다 |
캐시 채우기 설정
| 매개변수 | 기본값 | 설명 |
|---|---|---|
peer_cache_fill_compute_group_id | "" | 요청 측에 설정합니다. 캐시 채우기를 담당하는 컴퓨트 그룹의 ID입니다(이름이 아닌 compute_group_id). 선택된 후보가 이 그룹에 속하면 요청에 캐시 채우기 플래그가 포함됩니다 |
enable_peer_server_cache_fill | true | 제공 측에 설정합니다. 캐시 채우기 플래그가 있는 요청을 수락할지 여부입니다. 블록이 로컬에 캐시되어 있지 않으면 오브젝트 스토리지에서 읽어 로컬 File Cache에 기록한 뒤 반환합니다 |
peer_server_cache_fill_timeout_ms | 6000 | 제공 측에서 캐시 채우기 한 건을 기다리는 최대 시간이며, 단위는 밀리초입니다. 시간이 초과되면 요청 측은 오브젝트 스토리지로 폴백합니다 |
max_concurrent_peer_server_fills | 32 | 제공 측의 최대 동시 캐시 채우기 수입니다. 한도를 초과하는 요청은 거부되며, 요청 측은 오브젝트 스토리지로 폴백합니다 |
후보 관리
| 매개변수 | 기본값 | 설명 |
|---|---|---|
peer_rpc_failure_eviction_threshold | 3 | RPC가 이 횟수만큼 연속으로 실패하면 후보를 제거합니다 |
peer_all_miss_cooldown_threshold | 5 | 태블릿이 쿨다운에 들어가기 전까지 모든 후보에서 미스가 발생한 읽기가 연속으로 이어져야 하는 횟수입니다 |
peer_all_miss_cooldown_duration_s | 300 | 쿨다운 시간이며, 단위는 초입니다. 쿨다운 중에는 해당 태블릿의 읽기가 바로 오브젝트 스토리지로 향합니다 |
peer_candidate_expiry_s | 3600 | 마지막 사용 시점부터 측정한 후보 항목의 만료 시간이며, 단위는 초입니다. 만료된 항목은 삭제되고 다음 미스가 발생하면 FE에서 다시 조회합니다 |
peer_candidate_cleanup_interval_s | 3600 | 만료된 후보를 삭제하는 백그라운드 작업의 실행 간격이며, 단위는 초입니다 |
스레드 풀 및 큐
| 매개변수 | 기본값 | 설명 |
|---|---|---|
peer_fetch_queue_timeout_ms | 100 | 제공 측 설정입니다. 피어 읽기 요청이 처리 큐에서 이 시간(밀리초)보다 오래 기다리면 요청을 거부하여 요청 측이 빠르게 오브젝트 스토리지로 폴백하도록 합니다 |
brpc_peer_fetch_pool_threads | -1 | 제공 측 설정입니다. 피어 읽기 요청을 처리하는 스레드 수이며, 데이터 적재처럼 부하가 큰 RPC와 분리됩니다. -1은 max(64, 2 × CPU cores)를 의미합니다. 정적 매개변수이므로 변경하려면 BE를 재시작해야 합니다 |
brpc_peer_fetch_pool_max_queue_size | -1 | 해당 스레드 풀의 큐 길이입니다. -1은 max(4096, 128 × CPU cores)를 의미합니다. 정적 매개변수입니다 |
min_peer_race_s3_thread_num / max_peer_race_s3_thread_num | 0 / 32 | 요청 측 설정입니다. 경합 중 오브젝트 스토리지 읽기를 수행하는 스레드 풀의 크기입니다. 정적 매개변수입니다 |
부작용 및 주의 사항
그룹 간 피어 읽기는 컴퓨트 그룹 간 격리를 약화시킵니다. 한 그룹의 쿼리가 다른 그룹의 네트워크, 디스크, File Cache 읽기 용량을 사용하며, 캐시 채우기가 설정되어 있으면 다른 그룹이 대신 오브젝트 스토리지 대역폭도 사용하게 됩니다. 쿼리가 소비하는 리소스가 더 이상 자신의 컴퓨트 그룹 안에만 한정되지 않습니다.
캐시 채우기는 데이터를 제공하는 BE의 로컬 File Cache에 데이터를 기록하므로, 해당 BE가 자체적으로 사용하는 핫 데이터가 제거될 수 있습니다.
경합이 활성화되어 있으면 일부 미스에서 잠시 피어 RPC와 오브젝트 스토리지 읽기가 모두 발생합니다. 20 ms의 선행 시간이 이러한 중복을 줄여 주지만 완전히 없애지는 못합니다.
피어 적중은 보장되지 않습니다. 제공 측의 동시 처리 슬롯이나 캐시 채우기 슬롯이 가득 찬 경우, 블록이 없는 경우, 타임아웃이 발생한 경우에는 모두 오브젝트 스토리지로 폴백합니다. 경합이 활성화되어 있으면 콜드 쿼리는 대개 오브젝트 스토리지에서 직접 읽는 것보다 느리지 않지만, 반드시 더 빠른 것은 아닙니다.
다중 AZ 배포 환경에서 그룹 간 피어 읽기는 AZ 간 트래픽 요금을 발생시킵니다.
관측 및 문제 해결
쿼리 프로파일 카운터
피어 읽기 카운터는 프로파일의 SegmentIterator 노드 아래에 다른 File Cache 카운터와 함께 있습니다. 프로파일을 가져오고 읽는 방법은 쿼리 프로파일을 참조하세요.
| 카운터 | 의미 | 확인할 수 있는 내용 |
|---|---|---|
NumPeerIOTotal | 피어에서 처리한 읽기 횟수 | 쿼리가 피어 읽기를 사용했는지 여부 |
PeerIOUseTimer | 피어 읽기 경로에서 소요된 총시간 | 피어 경로 자체가 느린지 여부 |
SameCGPeerIOTotal / SameCGPeerBytesRead / SameCGPeerIOTime | 같은 그룹 내 피어 읽기의 횟수, 바이트 수, 소요 시간 | 피어 읽기가 주로 같은 컴퓨트 그룹 안에서 이루어지는지 여부 |
CrossCGPeerIOTotal / CrossCGPeerBytesRead / CrossCGPeerIOTime | 그룹 간 피어 읽기의 횟수, 바이트 수, 소요 시간 | 그룹 간 읽기가 발생했는지, 얼마나 많은 트래픽이 이동했는지 |
PeerRaceWin / S3RaceWin | 피어 / 오브젝트 스토리지가 경합에서 이긴 횟수. enable_peer_s3_race = true일 때만 의미가 있습니다 | S3RaceWin이 훨씬 높으면 이 환경에서 피어가 더 빠른 경로가 아니라는 뜻입니다 |
PeerLazyFetch / PeerLazyFetchTime | 태블릿에 후보가 없을 때 실행되는 FE 대상 백그라운드 후보 조회의 횟수와 소요 시간 | 첫 읽기가 피어로 향하지 않은 이유 |
PeerCacheNodes | 쿼리가 실제로 데이터를 읽은 피어 노드 | 데이터를 가져온 BE |
InvertedIndexNumPeerIOTotal / InvertedIndexPeerIOUseTimer와 SegmentFooterIndexNumPeerIOTotal / SegmentFooterIndexPeerIOUseTimer는 각각 역색인 파일과 세그먼트 푸터 및 내부 인덱스에 대한 피어 읽기 횟수와 소요 시간을 집계합니다. 인덱스 읽기도 피어에 적중했는지 확인할 수 있습니다.
BE bvar 메트릭
curl http://<be_host>:<brpc_port>/vars로 조회합니다(brpc_port의 기본값은 8060). 요청 측(읽기를 요청하는 BE)의 메트릭은 다음과 같습니다.
| 메트릭 | 의미 |
|---|---|
cached_remote_reader_peer_read | 피어 읽기 요청 횟수 |
cached_remote_reader_s3_read | 오브젝트 스토리지 읽기 요청 횟수 |
peer_race_peer_win / peer_race_s3_win | 피어 / 오브젝트 스토리지가 경합에서 이긴 횟수 |
peer_same_compute_group_read / peer_cross_compute_group_read | 같은 그룹 내 / 그룹 간 피어 읽기에 성공한 횟수 |
peer_lazy_fetch_triggered | FE 대상 백그라운드 후보 조회 횟수 |
peer_cache_reader_peer_latency | 피어 RPC 지연 시간 |
제공 측(캐시를 제공하는 BE)의 메트릭은 다음과 같습니다.
| 메트릭 | 의미 |
|---|---|
file_cache_get_by_peer_num / file_cache_get_by_peer_success_num / file_cache_get_by_peer_failed_num | 수신한 피어 읽기 요청 수와 성공 또는 실패한 요청 수 |
file_cache_get_by_peer_queue_timeout_num | 큐에서 peer_fetch_queue_timeout_ms보다 오래 기다려 거부된 요청 수 |
peer_server_fill_requested / peer_server_fill_success | 요청된 캐시 채우기 수와 완료된 캐시 채우기 수 |
peer_server_fill_timeout / peer_server_fill_rejected | 시간이 초과된 캐시 채우기 수와 빈 슬롯이 없어 거부된 캐시 채우기 수 |
해석 방법은 다음과 같습니다.
cached_remote_reader_peer_read가 높고cached_remote_reader_s3_read가 낮으면 피어 읽기가 전반적으로 잘 작동하고 있습니다.peer_race_s3_win이peer_race_peer_win보다 뚜렷하게 높으면 이 환경에서는 피어가 더 빠른 경로가 아닙니다.peer_race_hedge_delay_ms를 높이거나 피어 읽기를 비활성화하세요.peer_cross_compute_group_read가 높으면 그룹 간 트래픽이 발생하고 있으므로 격리 상태를 주시하세요.peer_server_fill_requested는 높지만peer_server_fill_success가 낮고peer_server_fill_timeout이 높으면 캐시를 채우는 컴퓨트 그룹에 과부하가 걸렸거나 설정이 잘못된 것입니다.
태블릿의 피어 정보 확인 및 조정
BE는 /api/peer_cache를 webserver_port(기본값 8040)에서 제공하며, 이를 통해 개별 태블릿의 후보를 조회하고 수정할 수 있습니다. 주로 문제 해결에 사용하는 도구입니다.
태블릿 하나의 후보, 마지막으로 읽기에 성공한 컴퓨트 그룹, 연속 미스 횟수, 쿨다운 상태를 표시합니다.
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show&tablet_id=<tablet_id>"
{
    "tablet_id": 10086,
    "candidates": [
        {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01", "last_access_time_ms": 1758441600000, "consecutive_rpc_failures": 0}
    ],
    "last_successful_compute_group_id": "cg_write_01",
    "fetching_from_fe": false,
    "consecutive_all_miss": 0,
    "cooldown_until_ms": 0
}
이 BE에서 후보를 보유한 모든 태블릿을 나열합니다. limit의 기본값은 1000입니다.
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show_all&limit=100"
태블릿의 후보를 강제로 지정합니다(JSON 요청 본문).
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=set&tablet_id=<tablet_id>" \
    -H "Content-Type: application/json" \
    -d '{
        "candidates": [
            {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01"}
        ],
        "last_successful_compute_group_id": "cg_write_01",
        "consecutive_all_miss": 0,
        "cooldown_until_ms": 0
    }'
태블릿의 후보를 제거하거나 쿨다운을 해제합니다.
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=remove&tablet_id=<tablet_id>"
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=reset_cooldown&tablet_id=<tablet_id>"
모범 사례
- 캐시 워밍업과 함께 사용하세요. 워밍업은 오브젝트 스토리지에서 데이터를 미리 가져오고, 피어 읽기는 쿼리 실행 시 다른 BE에서 데이터를 가져옵니다. 워밍업은 미리 파악한 핫 데이터를 처리하고, 피어 읽기는 워밍업에서 놓친 콜드 읽기를 처리합니다.
- 확장 전에 피어 읽기를 활성화해 두세요. 스케일 아웃 또는 태블릿 리밸런싱 후 피어 읽기를 통해 새 BE가 원본 BE의 캐시를 재사용할 수 있습니다.
balance_type = peer_read_async_warmup과 함께 사용하면 매핑이 즉시 전환되고 피어 읽기가 전환 과정의 성능 변동을 완화합니다. 컴퓨트 그룹 확장을 참조하세요. - 읽기/쓰기 분리 환경에서는 쓰기 컴퓨트 그룹을 캐시 채우기 그룹으로 지정하세요. 그러면 읽기 전용 그룹에서 콜드 읽기를 수행할 때 쓰기 그룹이 오브젝트 스토리지에서 데이터를 가져와 복사본을 유지합니다. 읽기/쓰기 분리를 위한 File Cache 최적화 모범 사례를 참조하세요.
- 컴퓨트 그룹 간 엄격한 격리가 필요하거나 클러스터가 여러 AZ에 걸쳐 있고 AZ 간 트래픽 요금이 중요한 경우 피어 읽기를 비활성화하세요(
enable_cache_read_from_peer = false). - 조정하기 전에 메트릭을 살펴보세요.
PeerRaceWin/S3RaceWin과 bvar로 피어가 경합에서 이기는지 확인한 뒤,peer_race_hedge_delay_ms를 조정할지 경합을 비활성화할지 결정하세요.
자주 묻는 질문
질문: 첫 콜드 읽기가 여전히 오브젝트 스토리지로 향하는 이유는 무엇인가요?
BE에 해당 태블릿의 후보가 아직 없으면 현재 요청은 FE를 기다리지 않습니다. 백그라운드에서 후보를 조회하는 동안 오브젝트 스토리지에서 읽습니다. 같은 쿼리에서 같은 태블릿을 이후에 읽을 때와 그 이후의 모든 쿼리는 피어 읽기를 사용합니다. 프로파일의 PeerLazyFetch 값이 0보다 크면 이 경우에 해당합니다.
질문: 쿼리가 피어 읽기를 사용했는지 어떻게 확인하나요?
프로파일에서 NumPeerIOTotal, SameCGPeerIOTotal, CrossCGPeerIOTotal, PeerCacheNodes를 확인하세요. BE에서도 cached_remote_reader_peer_read가 증가해야 합니다.
질문: 같은 컴퓨트 그룹 내 피어 읽기는 허용하고 컴퓨트 그룹 간 피어 읽기는 차단할 수 있나요?
현재는 불가능합니다. enable_cache_read_from_peer는 두 종류의 피어 읽기를 모두 제어하며, FE가 반환하는 후보에는 모든 컴퓨트 그룹의 BE가 포함됩니다.
질문: 피어 읽기를 어떻게 비활성화하나요?
모든 BE에 enable_cache_read_from_peer = false를 설정하세요. 런타임에 변경 사항을 적용할 수 있습니다. 이후 로컬 미스는 오브젝트 스토리지에서 직접 읽습니다.
질문: S3RaceWin이 PeerRaceWin보다 훨씬 높습니다. 어떻게 해야 하나요?
현재 환경에서는 피어에서 읽는 것이 오브젝트 스토리지에서 읽는 것보다 빠르지 않습니다. 일반적으로 피어 네트워크 지연 시간이나 피어 BE의 높은 부하가 원인입니다. peer_race_hedge_delay_ms를 높여 보고 카운터를 관찰하거나, 피어 읽기를 비활성화하세요.
질문: 특정 태블릿이 피어 읽기를 전혀 사용하지 않습니다.
/api/peer_cache?op=show&tablet_id=<tablet_id>를 실행하세요. candidates 목록이 비어 있으면 아직 후보를 조회하지 않았다는 뜻입니다. cooldown_until_ms 값이 영이 아니면 태블릿이 쿨다운 상태이며, op=reset_cooldown으로 해제할 수 있습니다.
질문: 그룹 간 캐시 채우기가 적용되지 않습니다.
요청 측의 peer_cache_fill_compute_group_id가 이름이 아닌 컴퓨트 그룹 ID인지, 선택된 후보가 실제로 해당 그룹에 속하는지(compute_group_id를 op=show 출력에서 확인), 캐시를 채우는 측의 enable_peer_server_cache_fill이 true인지, peer_server_fill_rejected 또는 peer_server_fill_timeout이 증가하는지 차례로 확인하세요.