BigQuery
이 문서에서는 Google BigQuery의 데이터를 Apache Doris로 마이그레이션하는 방법을 설명합니다. 전체 워크플로에서는 오브젝트 스토리지를 중간 매개체로 사용합니다.
- BigQuery의 Export 문을 사용하여 데이터를 GCS(Google Cloud Storage)로 내보냅니다.
- Doris에 이에 대응하는 대상 테이블을 생성합니다.
- Doris의 S3 Load 기능을 사용하여 GCS에서 데이터를 가져와 Doris에 적재합니다. 동작 방식에 대한 자세한 내용은 S3 Load를 참조하세요.
유의 사항
마이그레이션을 시작하기 전에 다음 사항을 확인하여 흔히 발생하는 문제를 예방하세요.
- 테이블 스키마 설계: BigQuery 테이블 스키마를 바탕으로 적절한 Doris 데이터 모델과 파티셔닝, 버킷팅 전략을 선택하세요. 테이블 생성 전략에 대한 자세한 내용은 데이터 적재 모범 사례를 참조하세요.
- JSON 타입 내보내기: BigQuery는 JSON 타입을 Parquet 형식으로 내보내는 기능을 지원하지 않습니다. 대신 JSON 형식으로 내보내세요.
- Time 타입 내보내기: BigQuery에서 Time 타입을 내보낼 때는 먼저 String으로 캐스팅하세요.
- 복합 타입 데이터 적재: 복합 타입(Struct/Array/Map)이 포함된 Parquet/ORC 파일은 현재 TVF Load를 사용해야 합니다.
데이터 타입 매핑
마이그레이션 전에 다음 규칙에 따라 BigQuery 필드에 대응하는 컬럼을 Doris에 생성하세요.
| BigQuery | Doris | 참고 |
|---|---|---|
| Array | Array | |
| BOOLEAN | BOOLEAN | |
| DATE | DATE | |
| DATETIME/TIMESTAMP | DATETIME | |
| JSON | JSON | |
| INT64 | BIGINT | |
| NUMERIC | DECIMAL | |
| FLOAT64 | DOUBLE | |
| STRING | VARCHAR/STRING | VARCHAR의 최대 길이는 65535 |
| STRUCT | STRUCT | |
| TIME | STRING | 내보내기 전에 String으로 캐스팅 |
| OTHER | UNSUPPORTED | 현재 지원하지 않는 타입 |
마이그레이션 단계
1단계: Doris에 대상 테이블 생성
BigQuery 테이블을 Doris로 마이그레이션하기 전에 먼저 동일한 스키마의 Doris 테이블을 생성하세요.
BigQuery에 다음 테이블과 샘플 데이터가 이미 있다고 가정합니다.
CREATE OR REPLACE TABLE test.sales_data (
    order_id      INT64,
    customer_name STRING,
    order_date    DATE,
    amount        NUMERIC(10,2),
    country       STRING
)
PARTITION BY  order_date;


INSERT INTO test.sales_data (order_id, customer_name, order_date, amount, country) VALUES
(1, 'Alice', '2025-04-08', 99.99, 'USA'),
(2, 'Bob', '2025-04-08', 149.50, 'Canada'),
(3, 'Charlie', '2025-04-09', 75.00, 'UK'),
(4, 'Diana', '2025-04-10', 200.00, 'Australia');
이 스키마를 바탕으로 Doris에 Unique Key 파티션 테이블을 생성할 수 있습니다. 파티션 컬럼은 BigQuery의 파티션 컬럼과 동일하며, 테이블은 일 단위로 파티셔닝됩니다.
CREATE TABLE `sales_data` (
  order_id      INT,
  order_date    DATE NOT NULL,
  customer_name VARCHAR(128),
  amount        DECIMAL(10,2),
  country       VARCHAR(48)
) ENGINE=OLAP
UNIQUE KEY(`order_id`,`order_date`)
PARTITION BY RANGE(`order_date`) (
PARTITION p20250408 VALUES [('2025-04-08'), ('2025-04-09')),
PARTITION p20250409 VALUES [('2025-04-09'), ('2025-04-10')),
PARTITION p20250410 VALUES [('2025-04-10'), ('2025-04-11'))
)
DISTRIBUTED BY HASH(`order_id`) BUCKETS 16
PROPERTIES (
 "dynamic_partition.enable" = "true",
 "dynamic_partition.time_unit" = "DAY",
 "dynamic_partition.end" = "5",
 "dynamic_partition.prefix" = "p",
 "dynamic_partition.buckets" = "16",
 "replication_num" = "1"
);
2단계: BigQuery 데이터를 GCS로 내보내기
2.1 Export 문으로 Parquet 파일 내보내기
BigQuery의 EXPORT DATA를 사용하여 대상 테이블을 GCS로 내보냅니다.
EXPORT DATA
  OPTIONS (
    uri = 'gs://mybucket/export/sales_data/*.parquet',
    format = 'PARQUET')
AS (
  SELECT *
  FROM test.sales_data
);
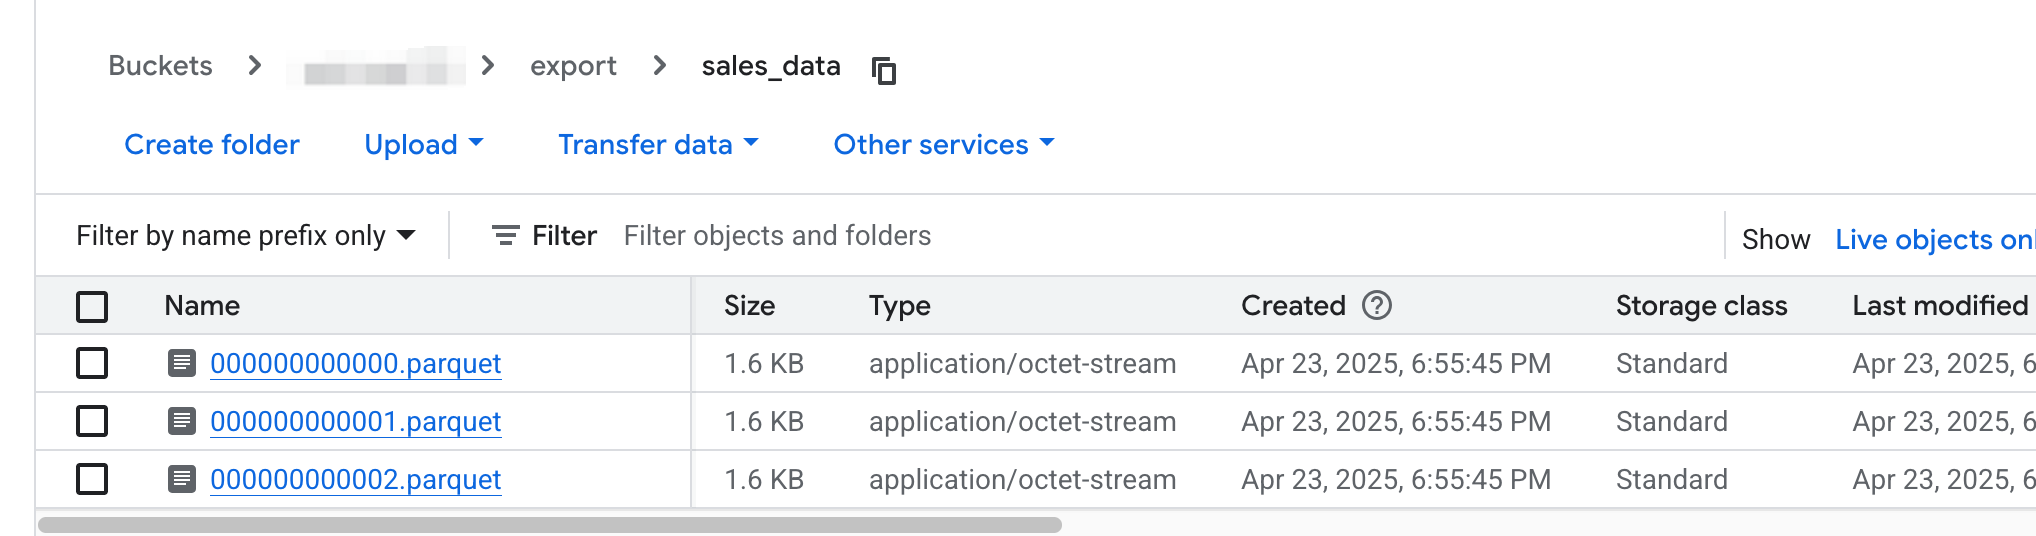
2.2 GCS로 내보낸 파일 확인
위 명령은 sales_data를 GCS로 내보냅니다. 각 파티션마다 파일 이름이 순차적으로 증가하는 하나 이상의 파일이 생성됩니다. 자세한 내용은 데이터 내보내기를 참조하세요.
3단계: S3 Load로 Doris에 데이터 적재
데이터 적재에는 S3 Load를 사용합니다. S3 Load는 비동기 데이터 적재 방식입니다. 작업이 제출되면 Doris가 데이터 소스에서 직접 데이터를 가져옵니다. 데이터 소스로는 AWS S3, GCS, Azure를 비롯한 S3 프로토콜 호환 오브젝트 스토리지를 지원합니다.
이 방식은 대량의 데이터를 백그라운드에서 비동기로 처리해야 하는 시나리오에 적합합니다. 동기 처리가 필요한 데이터 적재에 대해서는 TVF Load를 참조하세요.
참고: 복합 타입(Struct/Array/Map)이 포함된 Parquet/ORC 파일은 현재 TVF Load를 사용해야 합니다.
3.1 단일 파일에서 데이터 적재
다음 LOAD LABEL 문을 사용하여 GCS의 단일 Parquet 파일을 적재합니다.
LOAD LABEL sales_data_2025_04_08
(
    DATA INFILE("s3://mybucket/export/sales_data/000000000000.parquet")
    INTO TABLE sales_data
    FORMAT AS "parquet"
    (order_id, order_date, customer_name, amount, country)
)
WITH S3
(
    "provider" = "GCP",
    "s3.endpoint" = "storage.asia-southeast1.rep.googleapis.com",
    "s3.region" = "asia-southeast1",
    "s3.access_key" = "<ak>",
    "s3.secret_key" = "<sk>"
);
3.2 Show Load로 작업 상태 확인
S3 Load는 비동기로 제출되므로 SHOW LOAD를 사용하여 지정한 레이블의 데이터 적재 상태를 조회합니다.
mysql> show load where label = "sales_data_2025_04_08"\G
*************************** 1. row ***************************
        JobId: 17956078
        Label: sales_data_2025_04_08
        State: FINISHED
      Progress: 100.00% (1/1)
          Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=2
      TaskInfo: cluster:storage.asia-southeast1.rep.googleapis.com; timeout(s):3600; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: NULL
    CreateTime: 2025-04-10 17:50:53
  EtlStartTime: 2025-04-10 17:50:54
EtlFinishTime: 2025-04-10 17:50:54
LoadStartTime: 2025-04-10 17:50:54
LoadFinishTime: 2025-04-10 17:50:54
          URL: NULL
    JobDetails: {"Unfinished backends":{"5eec1be8612d4872-91040ff1e7208a4f":[]},"ScannedRows":2,"TaskNumber":1,"LoadBytes":91,"All backends":{"5eec1be8612d4872-91040ff1e7208a4f":[10022]},"FileNumber":1,"FileSize":1620}
TransactionId: 766228
  ErrorTablets: {}
          User: root
      Comment:
1 row in set (0.00 sec)
3.3 데이터 적재 중 발생하는 오류 처리
데이터 적재 작업이 여러 개 있는 경우 다음 문을 사용하여 실패한 데이터 적재 작업과 원인을 조회합니다.
mysql> show load where state='CANCELLED' and label like "label_test%"\G
*************************** 1. row ***************************
        JobId: 18312384
        Label: label_test123
        State: CANCELLED
      Progress: 100.00% (3/3)
          Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=4; dpp.norm.ALL=0
      TaskInfo: cluster:storage.asia-southeast1.rep.googleapis.com; timeout(s):14400; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: type:ETL_QUALITY_UNSATISFIED; msg:quality not good enough to cancel
    CreateTime: 2025-04-15 17:32:59
  EtlStartTime: 2025-04-15 17:33:02
EtlFinishTime: 2025-04-15 17:33:02
LoadStartTime: 2025-04-15 17:33:02
LoadFinishTime: 2025-04-15 17:33:02
          URL: http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342
    JobDetails: {"Unfinished backends":{"7602ccd7c3a4854-95307efca7bfe341":[]},"ScannedRows":4,"TaskNumber":1,"LoadBytes":188,"All backends":{"7602ccd7c3a4854-95307efca7bfe341":[10022]},"FileNumber":3,"FileSize":4839}
TransactionId: 769213
  ErrorTablets: {}
          User: root
      Comment:
위 예시는 데이터 품질 오류(ETL_QUALITY_UNSATISFIED)입니다. 구체적인 원인을 확인하려면 반환된 URL에 접속하세요. 예를 들어 아래 오류는 데이터가 테이블 스키마에 정의된 country 컬럼의 실제 길이를 초과했음을 나타냅니다.
[root@VM-10-6-centos ~]$ curl "http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342"
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [USA] schema length: 1; actual length: 3; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Canada] schema length: 1; actual length: 6; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [UK] schema length: 1; actual length: 2; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Australia] schema length: 1; actual length: 9; . src line [];
데이터 품질 오류가 발생했을 때 오류가 있는 일부 행을 건너뛰어도 된다면 S3 Load의 PROPERTIES에서 오류 허용 비율을 설정하세요. 매개변수에 대한 자세한 내용은 데이터 적재 설정 매개변수를 참조하세요.
3.4 여러 파일에서 데이터 적재
대량의 과거 데이터를 마이그레이션할 때는 배치 단위로 데이터를 적재하는 전략을 사용하세요.
- 배치 분할: 각 배치는 Doris 파티션 하나 또는 소수의 파티션에 대응하도록 구성합니다.
- 배치당 데이터양: 시스템 부하를 줄이고 데이터 적재 실패 후 재시도 비용을 낮추려면 배치당 100 GB 이하를 권장합니다.
- 배치 스크립트: s3_load_file_demo.sh를 참조하세요. 이 스크립트는 오브젝트 스토리지의 지정된 디렉터리에 있는 파일 목록을 나누고 여러 S3 Load 작업을 Doris에 배치 단위로 제출하여 배치 데이터 적재를 수행합니다.
자주 묻는 질문
Q1: BigQuery의 JSON 타입을 Parquet로 직접 내보낼 수 없는 이유는 무엇인가요?
BigQuery는 현재 JSON 타입을 Parquet 형식으로 내보내는 기능을 지원하지 않습니다. 내보낼 때 format을 JSON으로 설정하고, Doris에서 이에 대응하는 JSON 컬럼으로 데이터를 받으세요.
Q2: BigQuery의 Time 타입은 Doris에 어떻게 매핑하나요?
BigQuery의 Time 타입은 내보낼 때 String으로 캐스팅하고, Doris의 STRING 컬럼에 저장해야 합니다.
Q3: 데이터 적재가 ETL_QUALITY_UNSATISFIED 오류로 실패하면 어떻게 해야 하나요?
이 오류는 데이터가 품질 요구 사항을 충족하지 못함을 나타냅니다. 다음과 같이 처리하세요.
URL필드를SHOW LOAD결과에서 확인하고curl로 상세 오류 로그를 가져옵니다.- 로그에서 원인을 파악합니다. 흔한 원인으로는 컬럼 길이 초과와 타입 불일치가 있습니다.
- 대상 테이블 스키마를 조정하거나,
max_filter_ratio를 S3 Load의PROPERTIES에 설정하여 오류가 있는 일부 행을 건너뜁니다.
Q4: Struct/Array/Map이 포함된 Parquet/ORC 파일을 S3 Load로 적재할 수 있나요?
아니요. 이러한 복합 타입이 포함된 파일은 현재 TVF Load로 적재해야 합니다.
Q5: 대량의 과거 데이터를 마이그레이션할 때 개별 작업 실패로 인한 재시도 비용을 어떻게 줄일 수 있나요?
파티션별로 배치를 나누어 배치당 100 GB 이하로 데이터를 적재하고, s3_load_file_demo.sh 스크립트를 사용하여 배치를 분할하고 제출하세요.