제품 개념
이 문서는 Apache Doris의 핵심 제품 개념을 소개하며, 다른 문서를 이해하는 데 필요한 기초를 제공합니다. 이러한 개념은 데이터 구성, 스토리지 모델, 쿼리 실행, 쿼리 최적화 등 주요 영역을 다룹니다.
활용 상황: 개념 입문, 문서 읽기 준비, 기술 기초 학습
데이터 구성
Catalog / 데이터베이스 / 테이블
Apache Doris는 Catalog → 데이터베이스 → 테이블로 구성된 세 단계 계층 구조를 사용하여 데이터를 관리합니다.
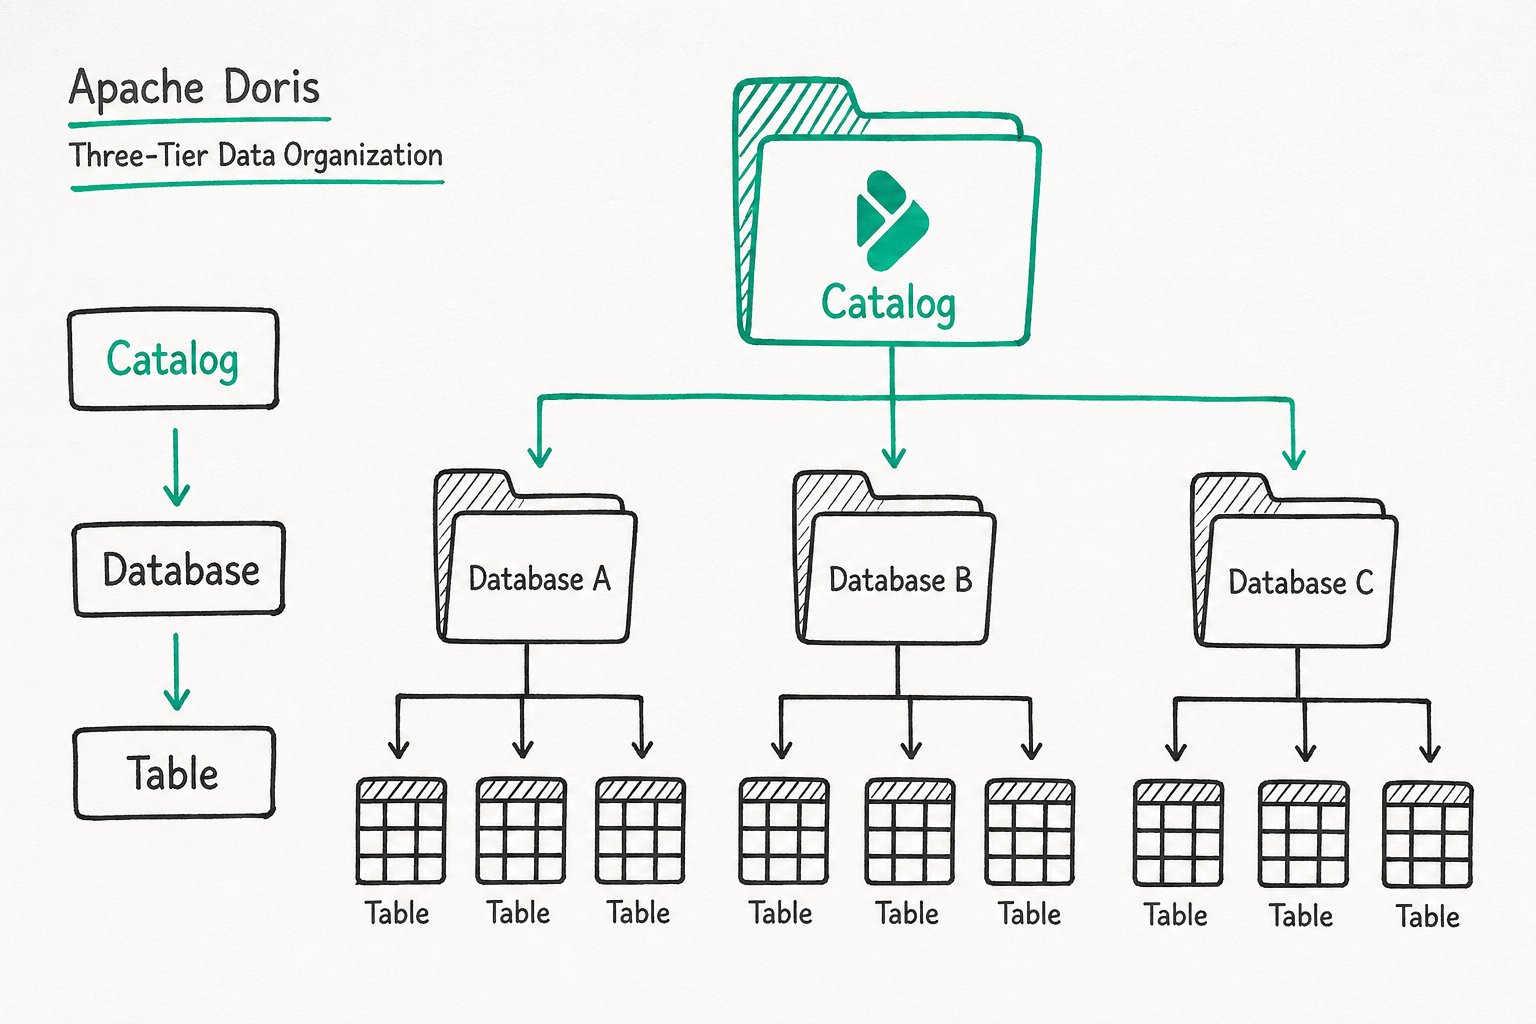
| 계층 | 설명 |
|---|---|
| Catalog | 서로 다른 데이터 소스를 구분하는 논리적 네임스페이스입니다. Doris의 기본 internal Catalog는 내부 스토리지를 나타내며, 사용자가 생성한 데이터베이스와 테이블을 보관합니다. 외부 Catalog는 Hive, Iceberg, MySQL 등의 데이터 소스에 연결하여 데이터 마이그레이션 없이 여러 소스에 걸친 쿼리를 실행할 수 있도록 합니다. |
| 데이터베이스 | 서로 다른 업무나 프로젝트에 속한 데이터를 격리하는 데이터베이스 단위입니다. 문자 집합, 정렬 규칙 등의 속성을 설정할 수 있습니다. |
| 테이블 | 컬럼 구조(Schema)와 테이블 속성(버킷 분할 규칙, 수명 주기 등)을 정의하는 이차원 관계형 테이블입니다. 데이터 저장과 쿼리의 기본 단위입니다. Doris에서 쿼리할 수 있는 모든 객체는 테이블 형태로 제공됩니다. |
세 단계 구조를 사용하는 이유는 무엇인가요?
이 계층 구조는 논리적 격리와 여러 소스에 대한 통합 접근을 균형 있게 제공합니다. 업무 팀은 독립적인 데이터베이스를 소유하고, 플랫폼 팀은 외부 Catalog를 통해 다른 데이터 소스의 데이터를 직접 쿼리할 수 있습니다.
내부 Catalog
내부 Catalog는 Doris에 기본으로 내장된 Catalog입니다. 이름은 internal로 고정되어 있으며, Doris 내부 형식으로 저장된 테이블과 데이터를 관리합니다.
주요 역할:
- 사용자가 생성한 모든 데이터베이스를 저장합니다(
CREATE DATABASE). - 사용자가 생성한 모든 테이블을 저장합니다(
CREATE TABLE). - 내부 데이터의 가져오기, 압축, 버전 병합(Compaction)을 관리합니다.
사용자가 SHOW DATABASES 또는 USE my_db를 실행하면 기본적으로 내부 Catalog 컨텍스트에서 작업이 수행됩니다.
외부 Catalog
외부 Catalog는 외부 데이터 소스에 연결하는 논리적 구성 요소로, 데이터 마이그레이션 없이 외부 데이터를 직접 쿼리할 수 있도록 합니다.
| 외부 데이터 소스 | 설명 |
|---|---|
| Hive | Hive Metastore 또는 HMS 호환 데이터 레이크에 연결합니다. |
| Iceberg | Iceberg 테이블에 연결합니다. |
| Paimon | Paimon 테이블에 연결합니다. |
| JDBC | MySQL, PostgreSQL, OceanBase 등의 관계형 데이터베이스에 연결합니다. |
Iceberg와 Paimon에 대한 참고 사항:
이 두 데이터 소스는 쿼리뿐 아니라 DDL 작업(CREATE/DROP/ALTER TABLE)과 DML 작업(INSERT/UPDATE/DELETE)을 포함한 전체 데이터 관리 기능을 지원합니다. Doris에서 Iceberg/Paimon 테이블 스키마를 직접 관리하고 데이터를 쓸 수 있습니다.
사용 사례:
- 데이터 레이크 분석: ETL 없이 Hive/Iceberg/Paimon 데이터를 직접 분석합니다.
- 여러 소스에 걸친 쿼리: 하나의 SQL 문에서 Iceberg 데이터 소스와 Doris 데이터를 함께 쿼리합니다.
사용 방법: 외부 Catalog를 생성한 후 SELECT * FROM catalog.database.table로 직접 쿼리할 수 있습니다. SWITCH catalog를 사용하여 해당 Catalog로 전환할 수도 있습니다.
내부 Catalog와 외부 Catalog 비교
| 비교 항목 | 내부 Catalog | 외부 Catalog |
|---|---|---|
| 이름 | internal로 고정 | 사용자 정의 |
| 데이터 형식 | Doris 내부 형식(컬럼 지향 스토리지) | 외부 데이터 소스 형식(Parquet, ORC 등) |
| 데이터 저장 위치 | BE 노드의 로컬 디스크 또는 객체 스토리지 | 외부 시스템(HDFS, S3, Hive Metastore 등) |
| 생성 방법 | CREATE DATABASE / CREATE TABLE | CREATE EXTERNAL CATALOG |
| 쿼리 성능 | 높음(데이터가 로컬에 있음) | 외부 데이터 소스에 따라 달라집니다. Doris는 여러 내장 가속 메커니즘도 제공합니다. |
| DDL/DML 지원 | 완전 지원 | Iceberg/Paimon은 완전 지원, Hive/JDBC는 쿼리만 지원 |
| 데이터 쓰기 | 지원(Stream Load 등) | Iceberg/Paimon만 지원 |
파티션과 버킷
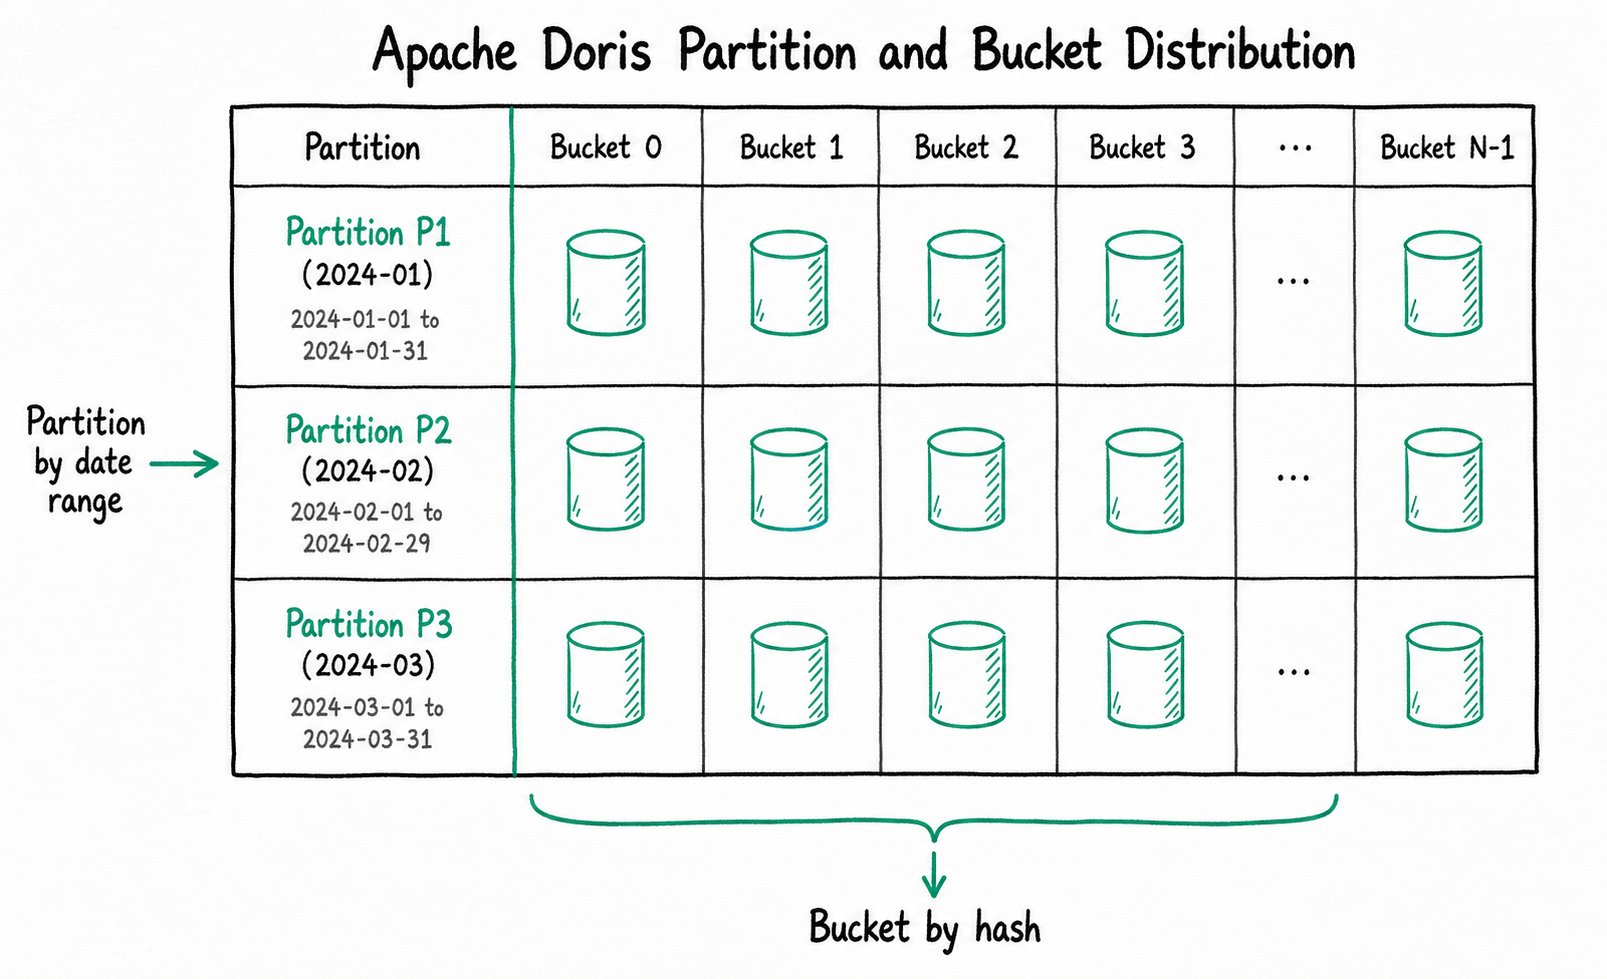
파티션은 특정 컬럼의 값 범위에 따라 테이블의 데이터를 수평으로 분할합니다. 테이블에는 하나 이상의 파티션이 있을 수 있으며, 각 파티션은 연속된 데이터 범위에 대응합니다.
일반적인 용도:
- 시간 기준 파티션 분할(일/월/년 단위): 파티션 프루닝과 과거 데이터 관리를 지원합니다.
- 지역 또는 사업 부문 기준 파티션 분할: 데이터를 격리합니다.
예시: 로그 테이블을 date 컬럼 기준으로 일별 파티션으로 분할합니다.
Partition p20240101: data where date = '2024-01-01'
Partition p20240102: data where date = '2024-01-02'
Partition p20240103: data where date = '2024-01-03'
WHERE date = '2024-01-02'를 실행하면 Doris는 p20240102 파티션만 스캔하고 나머지는 건너뛰므로 I/O를 크게 줄일 수 있습니다.
버킷은 특정 컬럼의 해시값이나 버킷 수를 기준으로 테이블의 데이터를 수평으로 분할하며, 클러스터 전체에서 데이터의 물리적 분포를 결정합니다.
버킷에 대응하는 물리적 스토리지를 Tablet이라고 하며, 이는 스토리지의 최소 논리 단위입니다.
| 개념 | 설명 |
|---|---|
| 분산 키 | 행이 속할 버킷을 계산하는 데 사용하는 컬럼입니다. 기본 키 ID와 같이 카디널리티가 높은 컬럼을 선택합니다. |
| 버킷 수 | 파티션에 있는 물리적 버킷의 수입니다. 데이터 처리의 병렬도를 결정합니다. |
버킷과 파티션의 차이:
| 구분 | 파티션 | 버킷 |
|---|---|---|
| 분할 기준 | 컬럼의 값 범위 | 해시 계산 |
| 목적 | 데이터 수명 주기 관리, 파티션 프루닝 | 데이터의 병렬 분산, JOIN 최적화 |
| 계층 관계 | 파티션은 버킷을 포함함 | 버킷은 파티션에 속함 |
파티션은 데이터의 논리적 경계(예: 시간 범위)를 정의하고, 버킷은 데이터의 물리적 분포(예: 클러스터 노드에 데이터를 분산하는 방식)를 정의합니다.
스토리지 모델
컬럼 지향 스토리지
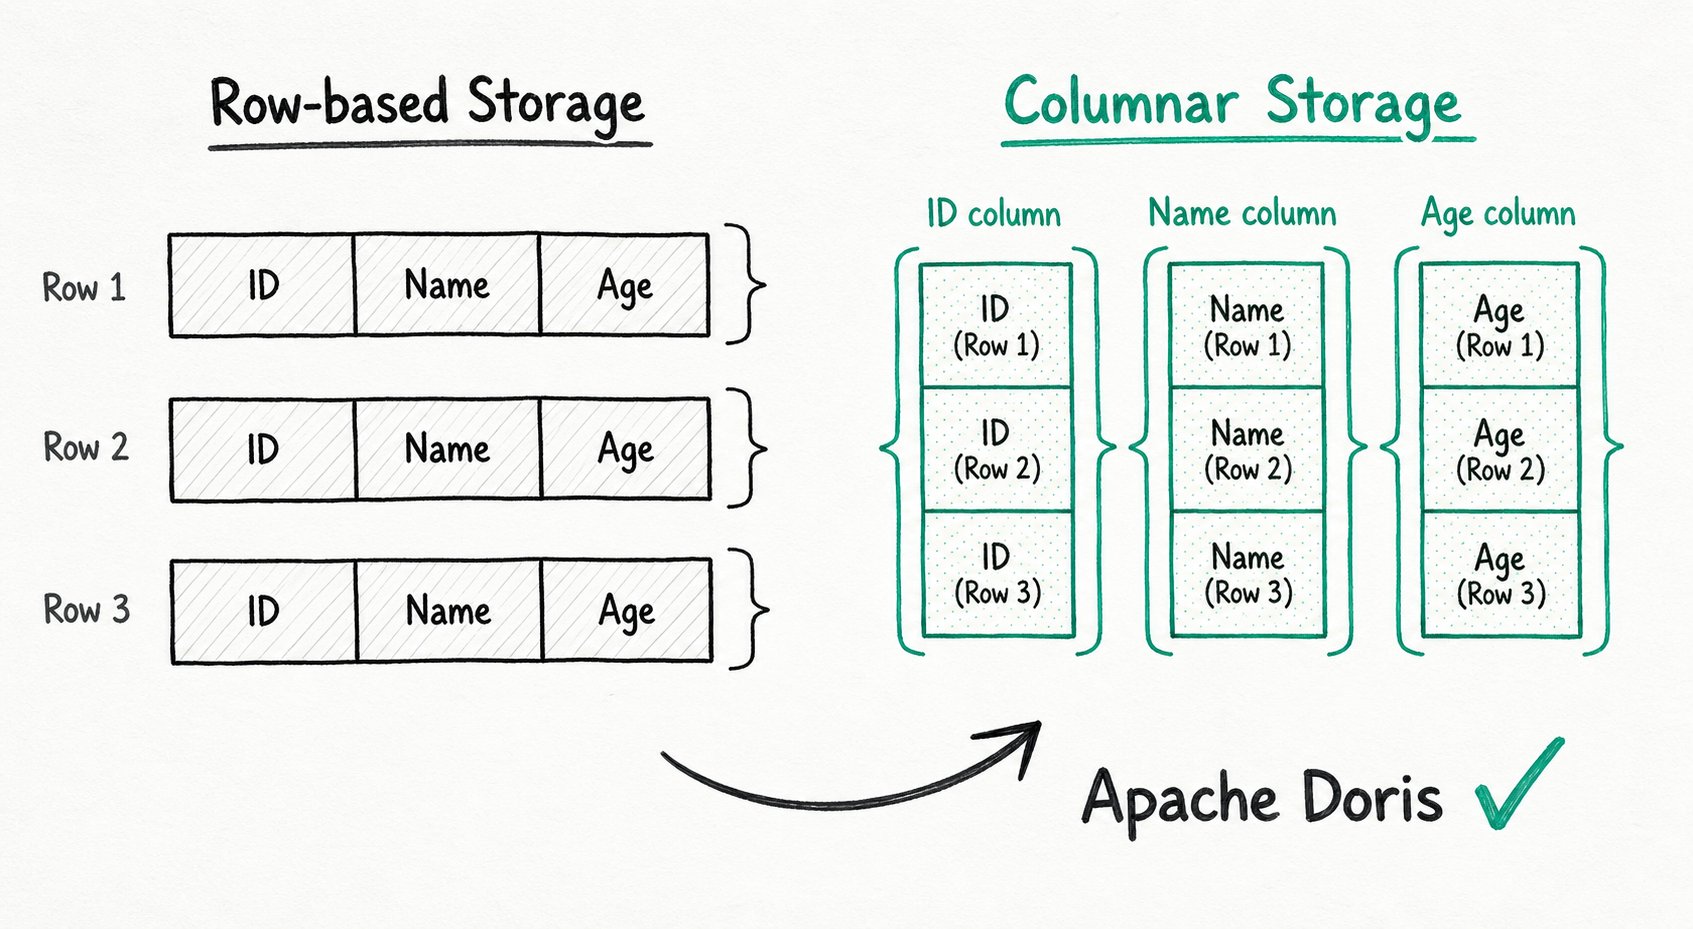
컬럼 지향 스토리지는 데이터를 행이 아닌 컬럼 단위로 구성하는 형식입니다.
행 기반 스토리지와 컬럼 지향 스토리지 비교:
Row-based storage (each row is stored contiguously):
[row1: id=1, name=alice, age=30] [row2: id=2, name=bob, age=25] ...

Columnar storage (each column is stored contiguously):
[id column: 1, 2, 3, ...] [name column: alice, bob, carol, ...] [age column: 30, 25, 28, ...]
컬럼 지향 스토리지의 장점:
| 장점 | 설명 |
|---|---|
| 높은 I/O 효율 | 쿼리에 필요한 컬럼만 읽으므로 전체 테이블 스캔을 피할 수 있습니다. 소수의 컬럼만 사용하는 보고서 쿼리에서는 I/O가 수십 배 줄어들 수 있습니다. |
| 높은 압축률 | 같은 컬럼의 데이터는 자료형이 같으므로 사전 인코딩, 비트맵 압축, RLE 등의 알고리즘에 적합하며, 저장 공간을 크게 줄일 수 있습니다. |
| 벡터화에 적합 | 같은 컬럼의 데이터가 메모리에 연속적으로 저장되어 CPU 캐시 적중률이 높고, SIMD 명령어를 활용한 고속 연산이 가능합니다. |
데이터 모델
Doris는 다양한 업무 시나리오의 데이터 병합 요구 사항을 처리하는 세 가지 데이터 모델을 지원합니다.
| 모델 | 설명 | 사용 사례 |
|---|---|---|
| Duplicate | 모든 원본 데이터를 유지하며, 키가 같은 여러 레코드도 모두 보존합니다. | 팩트 테이블의 상세 데이터 저장, 로그 분석 |
| Aggregate | 키가 같은 레코드를 집계 함수(SUM, MAX, MIN 등)에 따라 병합합니다. | 지표 통계, 보고서 사전 집계 |
| Primary Key | 키가 고유하며, 키가 같은 레코드는 이전 레코드를 덮어씁니다(행 단위 업데이트 지원). | 실시간 업데이트, CDC 데이터 수집 |
예시:
다음과 같은 원본 데이터가 있다고 가정합니다(기본 키는 user_id).
| user_id | visit_date | pv |
|---|---|---|
| 1 | 2024-01-01 | 5 |
| 1 | 2024-01-01 | 3 |
| 2 | 2024-01-01 | 10 |
- Duplicate 모델: 레코드 3개를 모두 유지합니다.
- Aggregate 모델(SUM 집계 사용): 키가 같은
pv값을 병합하므로 user_id=1은 pv=8, user_id=2는 pv=10이 됩니다. - Primary Key 모델: 키가 같은 레코드는 타임스탬프에 따라 덮어써서 최신 레코드만 남깁니다(예:
pv=3이pv=5를 덮어씁니다).
쿼리 실행
MPP (대규모 병렬 처리)
MPP는 복잡한 쿼리를 실행하는 데 사용하는 대규모 병렬 처리 아키텍처입니다.
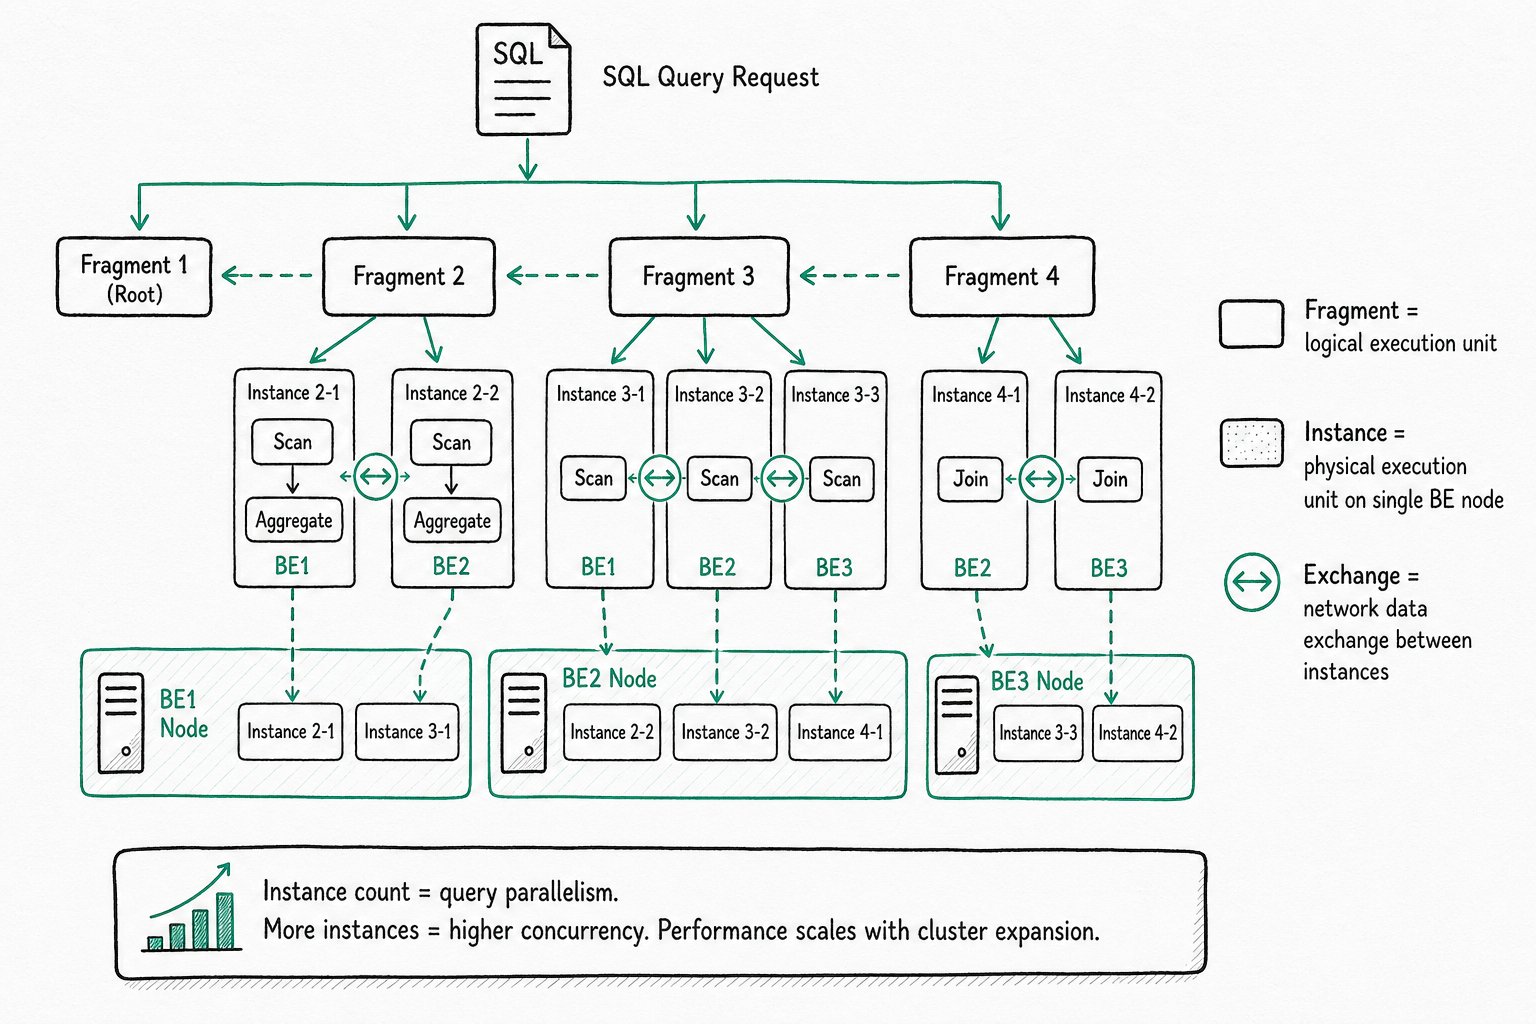
핵심 개념:
| 개념 | 설명 |
|---|---|
| Fragment | 논리적 실행 단위입니다. 쿼리 계획은 여러 Fragment로 구성됩니다. |
| Instance | 단일 BE 노드에서 실행할 수 있는 연산자 그룹(Scan, Agg, Join 등)으로 구성된 물리적 실행 단위입니다. |
| Exchange | Instance 간 네트워크 데이터 교환을 수행하는 연산자입니다. |
작동 방식:
- FE가 SQL을 파싱하여 논리적 실행 계획을 생성합니다.
- 계획을 여러 Fragment(논리적 실행 단위)로 분할합니다.
- 각 Fragment를 하나 이상의 Instance로 인스턴스화하고 여러 BE 노드에 배포하여 병렬로 실행합니다.
- 서로 다른 Instance는 Exchange 연산자를 통해 네트워크로 데이터를 교환합니다.
- 각 노드의 실행이 완료되면 FE에서 결과를 집계합니다.
Instance와 병렬도:
Instance는 쿼리의 물리적 실행 단위로, 단일 BE 노드에서 실행되며 연산자 그룹(Scan → Agg → Join 등)을 포함합니다. Instance 수는 쿼리의 병렬도와 같습니다. Instance가 많을수록 동시성이 높아집니다. 각 실행 노드는 전용 리소스(CPU 및 메모리)를 보유하며, 단일 쿼리 요청이 모든 실행 노드의 리소스를 충분히 활용할 수 있습니다. 따라서 클러스터를 수평 확장하면 쿼리 성능도 함께 향상됩니다.
사용 사례: 대형 테이블 JOIN, GROUP BY, ORDER BY 등 노드 간 데이터 교환이 필요한 작업에 사용합니다.
벡터화 실행 엔진
벡터화 실행은 데이터를 컬럼 단위 배치로 처리하고 SIMD 명령어를 사용하여 연산을 가속하는 실행 방식입니다.
기존 행 기반 실행과 벡터화 실행 비교:
| 구분 | 행 기반 실행 | 벡터화 실행 |
|---|---|---|
| 처리 단위 | 한 번에 한 행 | 한 번에 한 컬럼(배치) |
| CPU 캐시 | 임의 접근, 낮은 캐시 적중률 | 순차 접근, 높은 캐시 적중률 |
| SIMD 명령어 | 활용하기 어려움 | 충분히 활용 |
| 집계 성능 | 기준 성능 | 5-10배 향상 |
핵심 아이디어: 연산자의 내부 루프를 "한 행 처리"에서 "한 컬럼(데이터 배치) 처리"로 바꾸어 함수 호출 오버헤드를 줄이고 CPU 활용률을 높입니다.
Pipeline 실행 엔진
Pipeline은 파이프라인 병렬 처리를 통해 멀티코어 리소스 활용을 극대화하는 멀티코어 병렬 실행 모델입니다.
해결하는 문제:
- 스레드 수 폭증: 기존 모델은 쿼리마다 고정된 수의 스레드를 할당하므로 쿼리가 급증하면 스레드 수가 통제하기 어려울 정도로 늘어납니다.
- 리소스 경합: 크기가 고정된 스레드 풀에서는 쿼리 간 리소스 경합이 발생합니다.
Pipeline의 특징:
| 특징 | 설명 |
|---|---|
| 스레드 수 제한 | 병렬도는 쿼리 수가 아닌 CPU 코어 수에 의해 제한됩니다. |
| 연산자 체인 스케줄링 | 상위 및 하위 연산자가 파이프라인을 형성하고, 데이터가 그 안에서 연속적으로 흐릅니다. |
| 블로킹 감소 | 스레드 전환과 잠금 경합을 줄여 처리량을 높입니다. |
단일 쿼리 내에서는 여러 연산자가 병렬 파이프라인을 형성합니다. 클러스터 수준에서는 여러 쿼리가 CPU 리소스를 공유하여 효율적인 멀티테넌트 스케줄링을 구현합니다.
쿼리 최적화
구체화된 뷰
구체화된 뷰는 쿼리 결과를 물리적 테이블로 저장하고 데이터 적재 시 자동으로 갱신하는 사전 연산 기법입니다.
핵심 가치:
| 기능 | 설명 |
|---|---|
| 쿼리 재작성 | 사용자가 원본 테이블을 쿼리하면 옵티마이저가 구체화된 뷰에서 읽도록 쿼리를 투명하게 재작성할 수 있는지 자동으로 판단합니다. 사용자는 SQL을 변경할 필요가 없습니다. |
| 자동 동기화 | 원본 테이블이 변경되면 구체화된 뷰가 자동으로 갱신되므로 수동 유지 관리가 필요하지 않습니다. |
| ETL 대체 | 기존의 예약된 ETL 파이프라인을 대체하고 실시간 가속을 제공할 수 있습니다. |
사용 사례:
- 대형 테이블의 집계 쿼리(예: 보고서 롤업)
- 데이터 웨어하우스의 계층형 모델링(팩트 테이블 → 요약 테이블)
- 복잡한 JOIN 결과의 사전 연산
CBO (비용 기반 옵티마이저)
CBO는 비용 기반 쿼리 옵티마이저입니다. 각 후보 실행 계획의 리소스 소비량(I/O, CPU, 네트워크)을 추정하고 비용이 가장 낮은 계획을 선택합니다.
CBO가 최적화하는 일반적인 시나리오:
| 최적화 항목 | 설명 |
|---|---|
| 조인 순서 | 여러 테이블을 JOIN할 때 CBO는 다양한 순서의 비용을 평가하고 가장 적합한 순서를 선택합니다. |
| 조인 알고리즘 | 데이터 양에 따라 CBO가 Hash Join, Nest Loop Join, Broadcast Join 중 하나를 선택합니다. |
| 분산 실행 | CBO가 실행할 노드와 Shuffle 필요 여부를 결정합니다. |
CBO가 필요한 이유는 무엇인가요? SQL은 "무엇을 할지"만 기술하며 "어떻게 할지"는 기술하지 않습니다. 같은 쿼리라도 데이터 양에 따라 최적의 실행 경로가 완전히 달라질 수 있습니다. CBO는 통계(행 수, 컬럼 카디널리티, NDV 등)를 사용하여 비용을 추정하고 가장 효율적인 실행 경로를 선택합니다.
RBO (규칙 기반 옵티마이저)
RBO는 규칙 기반 옵티마이저입니다. 실제 데이터 특성을 고려하지 않고 미리 정의된 규칙에 따라 논리 계획을 재작성합니다.
일반적인 최적화 규칙:
| 규칙 | 설명 |
|---|---|
| 상수 폴딩 | 1 + 2 → 3 |
| 조건절 푸시다운 | JOIN 전에 필터 조건을 실행하여 중간 결과를 줄입니다. |
| 서브쿼리 재작성 | 중첩된 서브쿼리를 JOIN으로 펼칩니다. |
| 공통 표현식 재사용 | 여러 번 나타나는 표현식을 한 번만 계산합니다. |
CBO와 RBO 비교: RBO는 결정적이며 규칙에 따라 동작하므로 규칙이 고정된 시나리오에 적합합니다. CBO는 더 지능적이고 데이터 특성에 따라 최적화할 수 있지만, 정확한 통계가 필요합니다. Doris는 두 방식을 함께 사용합니다. RBO는 결정적인 최적화를 담당하고, CBO는 복잡한 계획 선택을 담당합니다.
Runtime Filter
Runtime Filter는 쿼리 실행 중 동적으로 생성되어 스캔 노드로 푸시다운되는 필터 조건으로, 데이터를 읽는 단계에서 필터링이 이루어지도록 합니다.
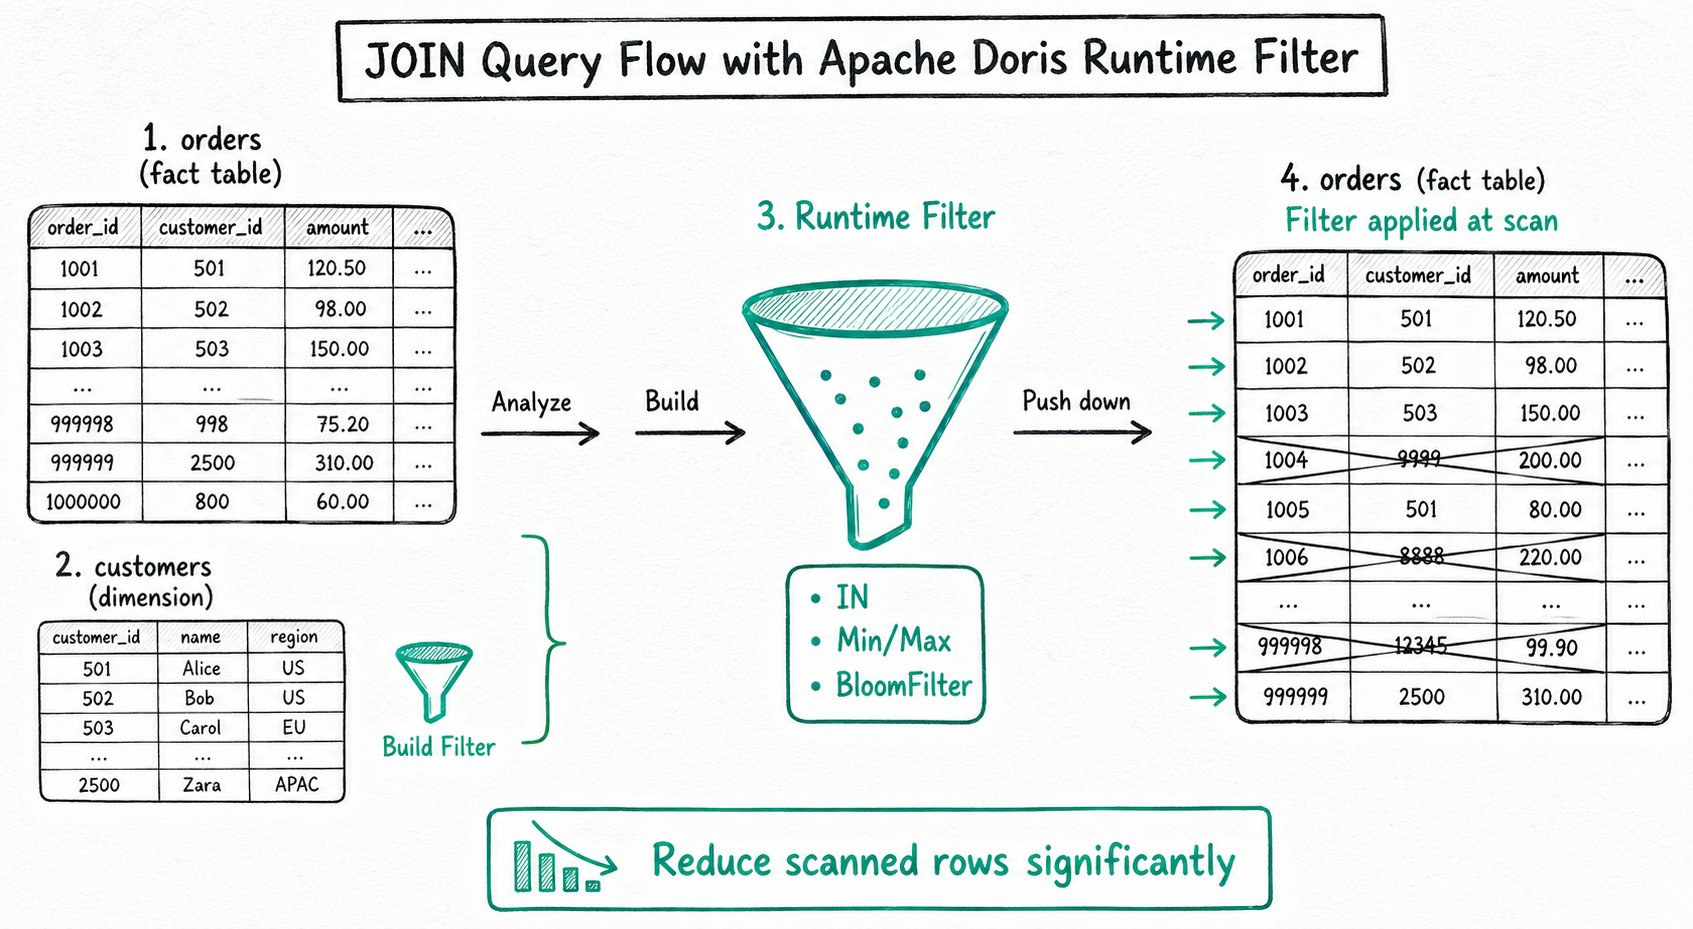
작동 방식:
Suppose a JOIN is performed between the large table orders and the small table customers on customer_id:

1. The FE analyzes the small table and builds a Filter (such as customer_id IN {1, 5, 9}).
2. The Filter is pushed down to the nodes that scan the large table.
3. While the large table is being read, rows that do not match are filtered out immediately and skipped.
4. This reduces I/O and the workload of subsequent operators.
Runtime Filter 유형:
| 유형 | 사용 사례 |
|---|---|
| IN | 작은 테이블과 큰 테이블의 조인, 동등 JOIN |
| Min/Max | 범위 JOIN, 연속적인 데이터 분포 |
| BloomFilter | 카디널리티가 높은 컬럼, 동등 JOIN |
효과: 스타 스키마에서 큰 fact 테이블과 작은 dimension 테이블을 조인할 때 Runtime Filter를 사용하면 큰 테이블의 스캔 양을 몇 배에서 수십 배까지 줄일 수 있습니다.
자주 묻는 질문
질문: 파티션과 버킷의 차이는 무엇인가요?
파티션은 컬럼의 값 범위에 따라 데이터를 나눕니다. 데이터 수명 주기 관리(예: 일별 파티션 단위로 과거 데이터 삭제)와 파티션 프루닝(쿼리에 관련된 파티션만 스캔)에 사용합니다. 버킷은 해시를 기준으로 데이터를 분산하여 병렬 처리와 JOIN 최적화를 지원합니다. 파티션은 논리적 개념이고, 버킷은 물리적 개념입니다(데이터를 어느 BE 노드에 분산할지 결정합니다).
질문: Duplicate 모델 대신 Primary Key 모델을 선택해야 하는 경우는 언제인가요?
행 단위 업데이트가 필요하거나(예: 실시간 데이터 수집 또는 CDC 동기화), 키가 같은 레코드를 병합하려는 경우 Primary Key 모델을 선택합니다. Duplicate 모델은 모든 원본 데이터를 유지하며 로그 분석과 전체 상세 데이터 쿼리 시나리오에 적합합니다.
질문: MPP와 Pipeline은 어떤 관계인가요?
서로 다른 두 차원의 병렬 처리 메커니즘입니다. MPP는 노드 간 병렬 연산을 담당하는 분산 병렬 처리입니다. Pipeline은 멀티코어 리소스 활용을 담당하는 노드 내부 병렬 처리입니다. 두 메커니즘을 함께 사용하면 "노드 간 병렬 처리와 노드 내부 파이프라인 처리"를 통해 전체 과정에서 병렬 처리를 구현할 수 있습니다.
질문: CBO와 RBO의 통계는 어디에서 얻나요?
Doris는 ANALYZE 명령으로 테이블 행 수, 컬럼 카디널리티(NDV), NULL 비율 등의 테이블 및 컬럼 통계를 수집합니다. CBO는 이러한 통계를 기반으로 비용을 추정합니다. 통계가 정확할수록 최적화 결과가 좋아집니다. 데이터 양이 크게 변경된 후에는 ANALYZE를 다시 실행합니다.
질문: 외부 Catalog와 일반 데이터베이스의 차이는 무엇인가요?
일반 데이터베이스는 Doris 내부에 데이터를 저장하지만, 외부 Catalog는 논리적 매핑만 제공하며 실제 데이터는 외부 데이터 소스에 그대로 저장됩니다. Doris는 외부 Catalog를 통해 외부 데이터를 직접 읽으므로 ETL 마이그레이션이 필요하지 않습니다. 일반적인 사용 사례로는 데이터 레이크(Hive/Iceberg/Hudi) 쿼리와 여러 소스에 걸친 쿼리(MySQL, PostgreSQL 등)가 있습니다.
질문: 구체화된 뷰와 일반 뷰의 차이는 무엇인가요?
일반 뷰는 SQL 쿼리 로직만 저장하고 쿼리할 때마다 결과를 계산하므로 성능상의 이점이 없습니다. 구체화된 뷰는 쿼리 결과를 물리적으로 저장하고 데이터를 동기화하며 사용자 쿼리를 투명하게 가속합니다. 구체화된 뷰는 패턴이 일정한 집계 보고서 시나리오에 적합합니다.
추가 읽기 자료
- [TODO] - 스토리지와 컴퓨팅의 통합형 및 분리형 아키텍처 알아보기
- [TODO] - CBO와 실행 계획 자세히 알아보기