Prometheus 및 Grafana 배포
이 문서에서는 Helm을 사용하여 Kubernetes에 Prometheus와 Grafana를 배포하고, Apache Doris 컴퓨팅-스토리지 분리형 클러스터에 연결하여 메트릭 수집, 시각화, 알림을 구성하는 방법을 설명합니다. Prometheus는 FE, BE, Meta Service가 노출하는 HTTP 및 bRPC 메트릭을 수집합니다. Grafana는 대시보드를 통해 클러스터 상태를 보여 줍니다.
참고: 이 문서는 Kubernetes에서 Helm + ServiceMonitor를 구성하는 절차를 중심으로 설명합니다. 이 가이드에서 다운로드하는 클라우드 대시보드 템플릿은 Kubernetes를 사용하지 않는 컴퓨팅-스토리지 분리형 클러스터 배포 환경에도 적용할 수 있습니다. Doris 모니터링 아키텍처, 메트릭 형식, 대시보드 패널 설명, 전체 템플릿 Catalog는 모니터링 및 알림을 참조하세요.
사용 사례
| 시나리오 | 설명 |
|---|---|
| 신규 클러스터 도입 | Doris 컴퓨팅-스토리지 분리형 클러스터를 운영 환경에 투입하기 전에 모니터링을 구성하여 이상 징후를 제때 감지합니다. |
| 일상 운영 | FE, BE, Meta Service의 주요 메트릭과 노드 리소스 사용량을 지속적으로 관찰합니다. |
| 문제 해결 | 과거 메트릭, 대시보드 화면, 알림을 활용하여 성능 또는 가용성 문제의 원인을 빠르게 파악합니다. |
| 용량 계획 | 노드 및 구성 요소 메트릭의 추세를 바탕으로 확장 시점을 판단합니다. |
사전 요구 사항
- 사용 가능한 Kubernetes 클러스터가 있고
kubectl이 구성되어 있어야 합니다. - Doris Operator를 통해
default네임스페이스에 컴퓨팅-스토리지 분리형 클러스터가 배포되어 있고, 세 가지 구성 요소 유형(FE, BE/Compute Group, Meta Service)이 모두 준비되어 있어야 합니다. - 노드에서 공용 네트워크에 접근할 수 있어야 하며, Helm 설치 스크립트, Prometheus Community Charts, Grafana 대시보드 JSON 파일을 다운로드할 수 있어야 합니다.
- Kubernetes에서 네임스페이스, Helm Release, ServiceMonitor 및 기타 리소스를 생성할 권한이 있어야 합니다.
배포 개요
- Helm을 설치하고
kube-prometheus-stack을 통해 Prometheus, Grafana, Alertmanager를 한 번에 배포합니다. - Prometheus
ServiceMonitor를 구성하여 Prometheus가 Doris 클러스터를 자동으로 검색하고 HTTP 및 bRPC 메트릭을 수집하도록 합니다. - Grafana에 로그인하고 공식 Doris 대시보드를 가져온 다음, 필요에 따라 노드 모니터링 패널을 추가합니다.
1단계: Helm, Prometheus, Grafana 배포
1.1 Helm 설치
목적: 로컬 컴퓨터 또는 운영 노드에 Helm 3을 설치하여 Kubernetes에서 모니터링 구성 요소를 설치하고 관리합니다.
curl https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 | bash
1.2 Prometheus Community Helm 저장소 추가
목적: kube-prometheus-stack Chart가 있는 저장소를 등록하고 로컬 캐시를 갱신합니다.
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
1.3 kube-prometheus-stack 배포
목적: 전용 monitoring 네임스페이스에 Prometheus, Grafana, Alertmanager 및 관련 Operator를 배포합니다.
# Create the namespace
kubectl create namespace monitoring

# Deploy kube-prometheus-stack
helm install prometheus prometheus-community/kube-prometheus-stack -n monitoring
1.4 Pod 상태 확인
목적: 다음 단계로 진행하기 전에 모니터링 스택의 모든 Pod가 Running 상태인지 확인합니다.
kubectl get pods -n monitoring
정상적인 출력은 다음과 같습니다.
NAME                                                     READY   STATUS    RESTARTS         AGE
alertmanager-prometheus-kube-prometheus-alertmanager-0   2/2     Running   8 (5h28m ago)    4d23h
prometheus-grafana-7994c77c7-8nk7j                       3/3     Running   12 (5h28m ago)   5d
prometheus-kube-prometheus-operator-5576477887-dgp8h     1/1     Running   4 (5h28m ago)    5d
prometheus-kube-state-metrics-77885ddddc-hldlw           1/1     Running   4 (5h28m ago)    4d23h
prometheus-prometheus-kube-prometheus-prometheus-0       2/2     Running   0                4h11m
prometheus-prometheus-node-exporter-2tl9s                1/1     Running   4 (5h28m ago)    4d23h
prometheus-prometheus-node-exporter-b58rd                1/1     Running   4 (5h28m ago)    4d23h
prometheus-prometheus-node-exporter-fqp6v                1/1     Running   4 (5h28m ago)    4d23h
2단계: Doris 메트릭을 수집하도록 Prometheus 구성
ServiceMonitor를 생성하여 Prometheus Operator가 default 네임스페이스에서 app.doris.disaggregated.cluster=test-disaggregated-cluster 레이블이 있는 Doris Service를 자동으로 검색하고, FE, BE, Meta Service의 세 가지 구성 요소 유형별로 메트릭을 수집하도록 합니다.
2.1 ServiceMonitor YAML 준비
목적: 수집 대상, 엔드포인트 경로, 수집 주기를 선언하고, relabelings를 사용하여 각 서비스에 역할별로 통일된 group 레이블을 지정해 대시보드에서 필터링할 수 있도록 합니다.
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: doris-disaggregated-monitor
  namespace: monitoring
  labels:
    release: prometheus
spec:
  namespaceSelector:
    matchNames:
    - default
  selector:
    matchLabels:
      app.doris.disaggregated.cluster: test-disaggregated-cluster
  endpoints:
  - port: http
    path: /metrics
    interval: 15s
    relabelings:
    # 1. Unify the job name
    - action: replace
      targetLabel: job
      replacement: doris-cluster
    # 2. Map Service name suffix to component group: -cg1 -> be, -fe -> fe, -ms -> meta_service
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-cg1
      replacement: be
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-fe
      replacement: fe
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-ms
      replacement: meta_service
      targetLabel: group

  - port: brpc-port
    path: /brpc_metrics
    interval: 15s
    relabelings:
    # 1. Unify the job name
    - action: replace
      targetLabel: job
      replacement: doris-cluster
    # 2. Map Service name suffix to component group: -cg1 -> be, -fe -> fe, -ms -> meta_service
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-cg1
      replacement: be
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-fe
      replacement: fe
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-ms
      replacement: meta_service
      targetLabel: group
2.2 ServiceMonitor의 주요 필드
| 필드 | 값 | 설명 |
|---|---|---|
metadata.namespace | monitoring | ServiceMonitor는 Prometheus 인스턴스와 동일한 네임스페이스에 있어야 합니다. |
metadata.labels.release | prometheus | Helm Release 이름과 일치해야 합니다. Prometheus Operator는 이 레이블을 사용하여 ServiceMonitor를 검색합니다. |
spec.namespaceSelector.matchNames | default | Doris 클러스터가 실행되는 네임스페이스입니다. 환경에 맞게 조정하세요. |
spec.selector.matchLabels | app.doris.disaggregated.cluster: test-disaggregated-cluster | Doris 컴퓨팅-스토리지 분리형 클러스터의 Service를 선택합니다. 필요에 따라 클러스터 이름을 변경하세요. |
endpoints[0].port | http | FE, BE, Meta Service가 /metrics를 노출하는 HTTP 포트 이름입니다. |
endpoints[1].port | brpc-port | BE가 /brpc_metrics를 노출하는 bRPC 포트 이름입니다. |
endpoints[*].interval | 15s | 수집 주기입니다. 데이터 양과 정밀도 요구 사항에 따라 조정하세요. |
group 레이블(relabelings에서 설정) | be / fe / meta_service | Service 이름 접미사를 기준으로 메트릭을 세 가지 구성 요소 범주로 나누어 대시보드 변수로 필터링할 수 있도록 합니다. |
2.3 YAML 적용 및 확인
목적: Prometheus Operator가 새 ServiceMonitor를 감지하고 수집 대상을 갱신하도록 합니다.
kubectl apply -f doris-monitor.yaml
브라우저에서 Prometheus를 열고(기본 포트: 9090, 예: http://your_ip:9090), 상태 → 대상으로 이동하여 doris-cluster 아래의 FE, BE, Meta Service 대상이 모두 UP 상태인지 확인합니다.
3단계: Grafana 및 대시보드 구성
3.1 Grafana에 로그인
목적: kube-prometheus-stack에 포함된 Grafana에 접속하여 최초 로그인을 완료합니다.
-
브라우저에서 Grafana를 엽니다(기본 포트:
3000, 예:http://your_ip:3000). -
사용자 이름은
admin입니다. 다음 명령으로 초기 비밀번호를 조회합니다.kubectl get secret --namespace monitoring prometheus-grafana -o jsonpath="{.data.admin-password}" | base64 --decode ; echo
3.2 Doris 대시보드 가져오기
목적: 공식 대시보드 JSON 파일을 사용하여 Doris 클러스터 메트릭을 시각화합니다.
-
공식 대시보드 파일을 다운로드합니다. Doris-Dashboard-Cloud.json
-
Grafana에서 대시보드 → 새로 만들기 → 가져오기로 이동하여 JSON 파일을 가져오고, 함께 배포된 Prometheus를 데이터 소스로 선택합니다.
-
대시보드 URL에
&var-cluster_id=doris-cluster를 추가하여 ServiceMonitor에 설정한job이름과 일치시킵니다. 예:http://your_ip:3000/d/3fFiWJ4mz456/doris-cloud-dashboard-overview?orgId=1&var-cluster_id=doris-cluster&refresh=5s
3.3 노드 모니터링 추가(선택 사항)
목적: 예제 JSON 파일에는 호스트 노드 모니터링 패널이 포함되어 있지 않습니다. Grafana 공식 템플릿 1860을 사용하여 node-exporter 메트릭을 바로 표시합니다.
-
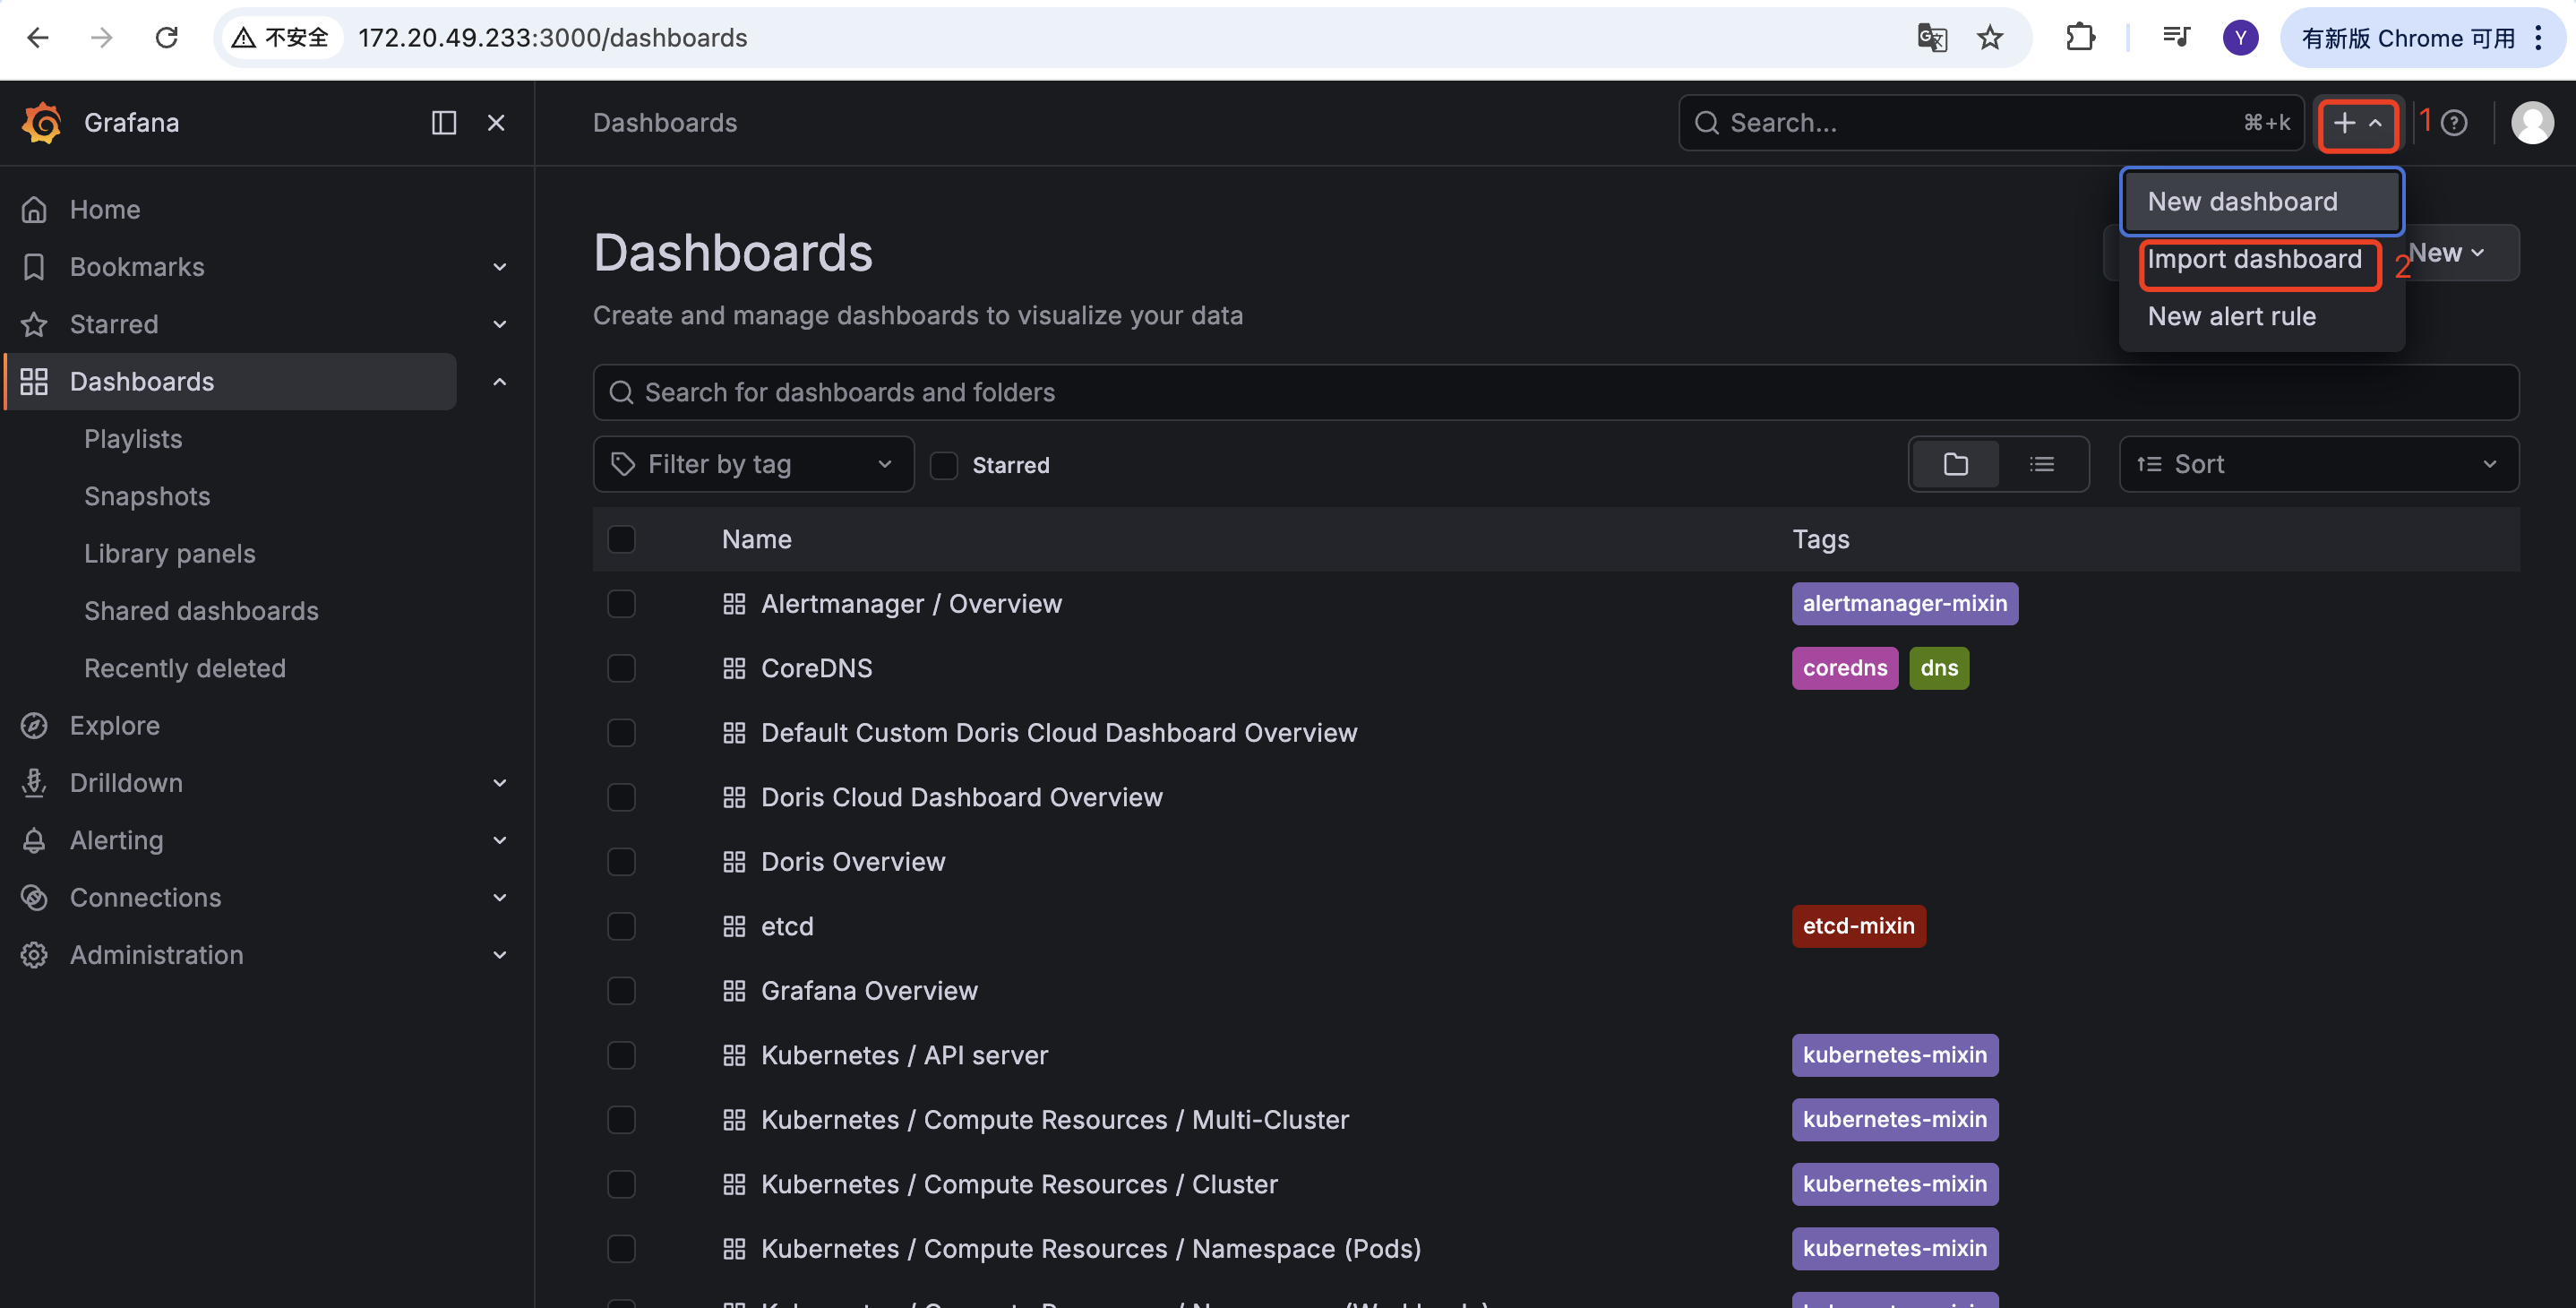
Grafana에서 대시보드를 가져옵니다.
-
공식 템플릿 번호
1860을 선택합니다.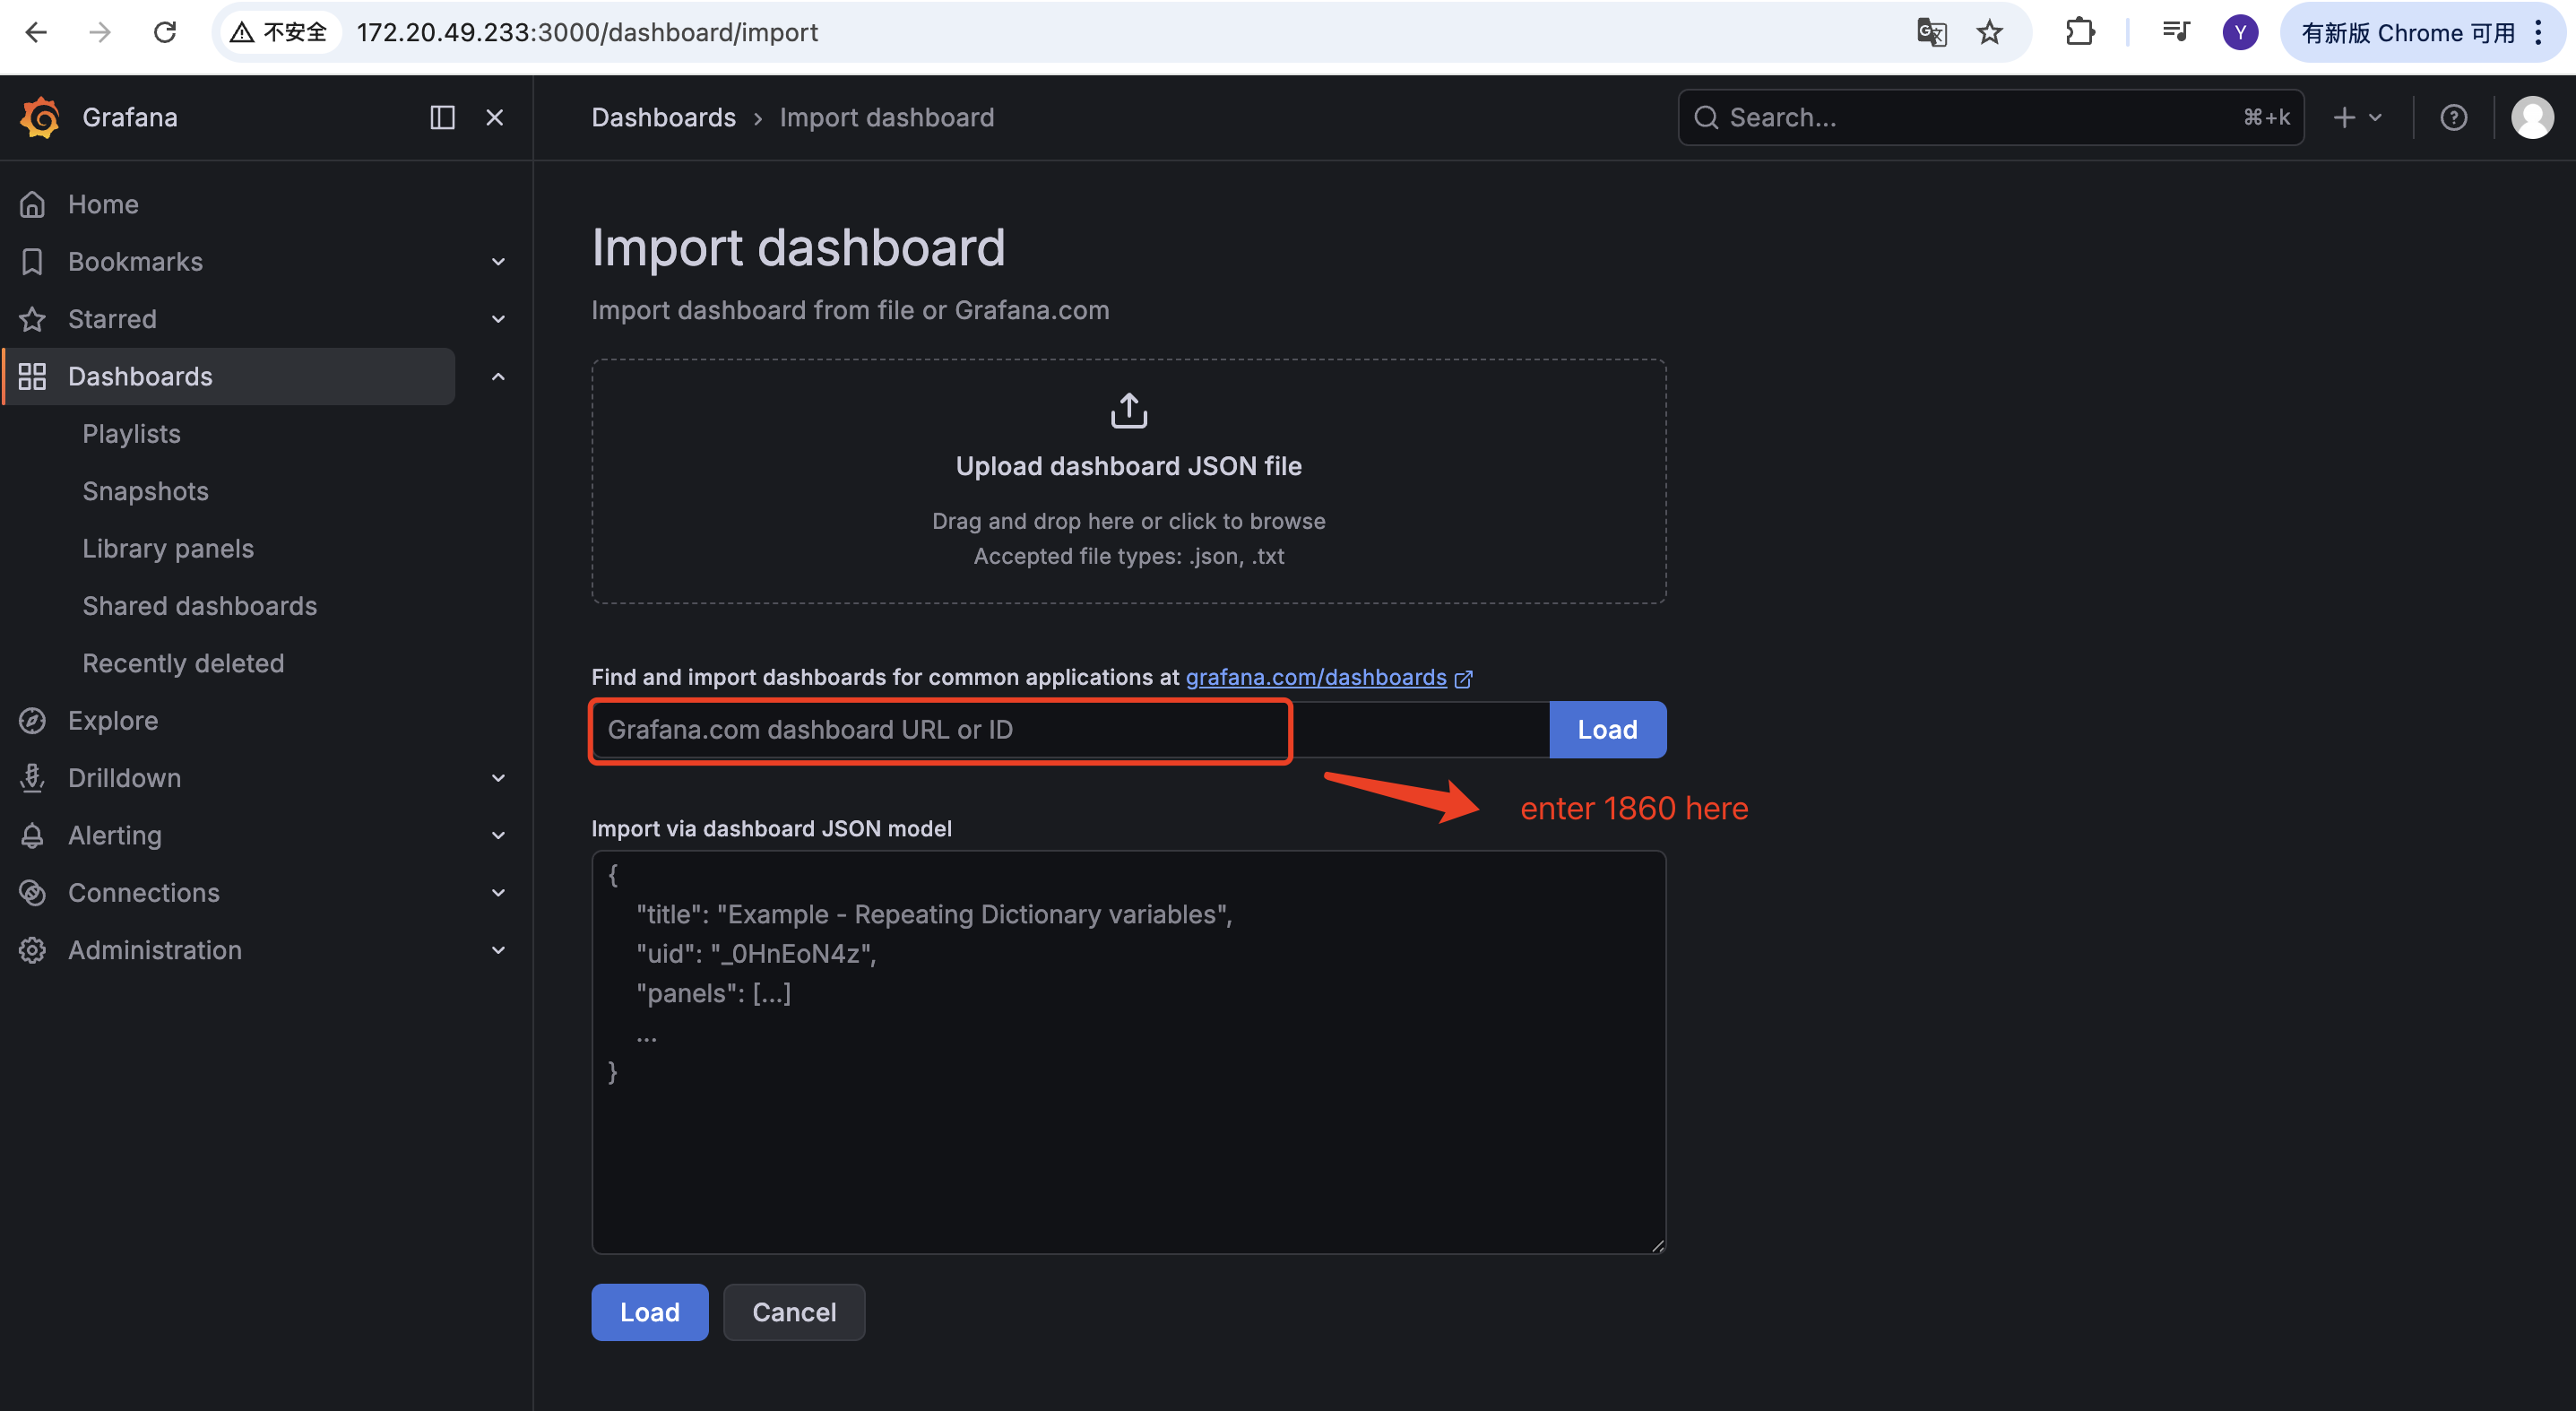
-
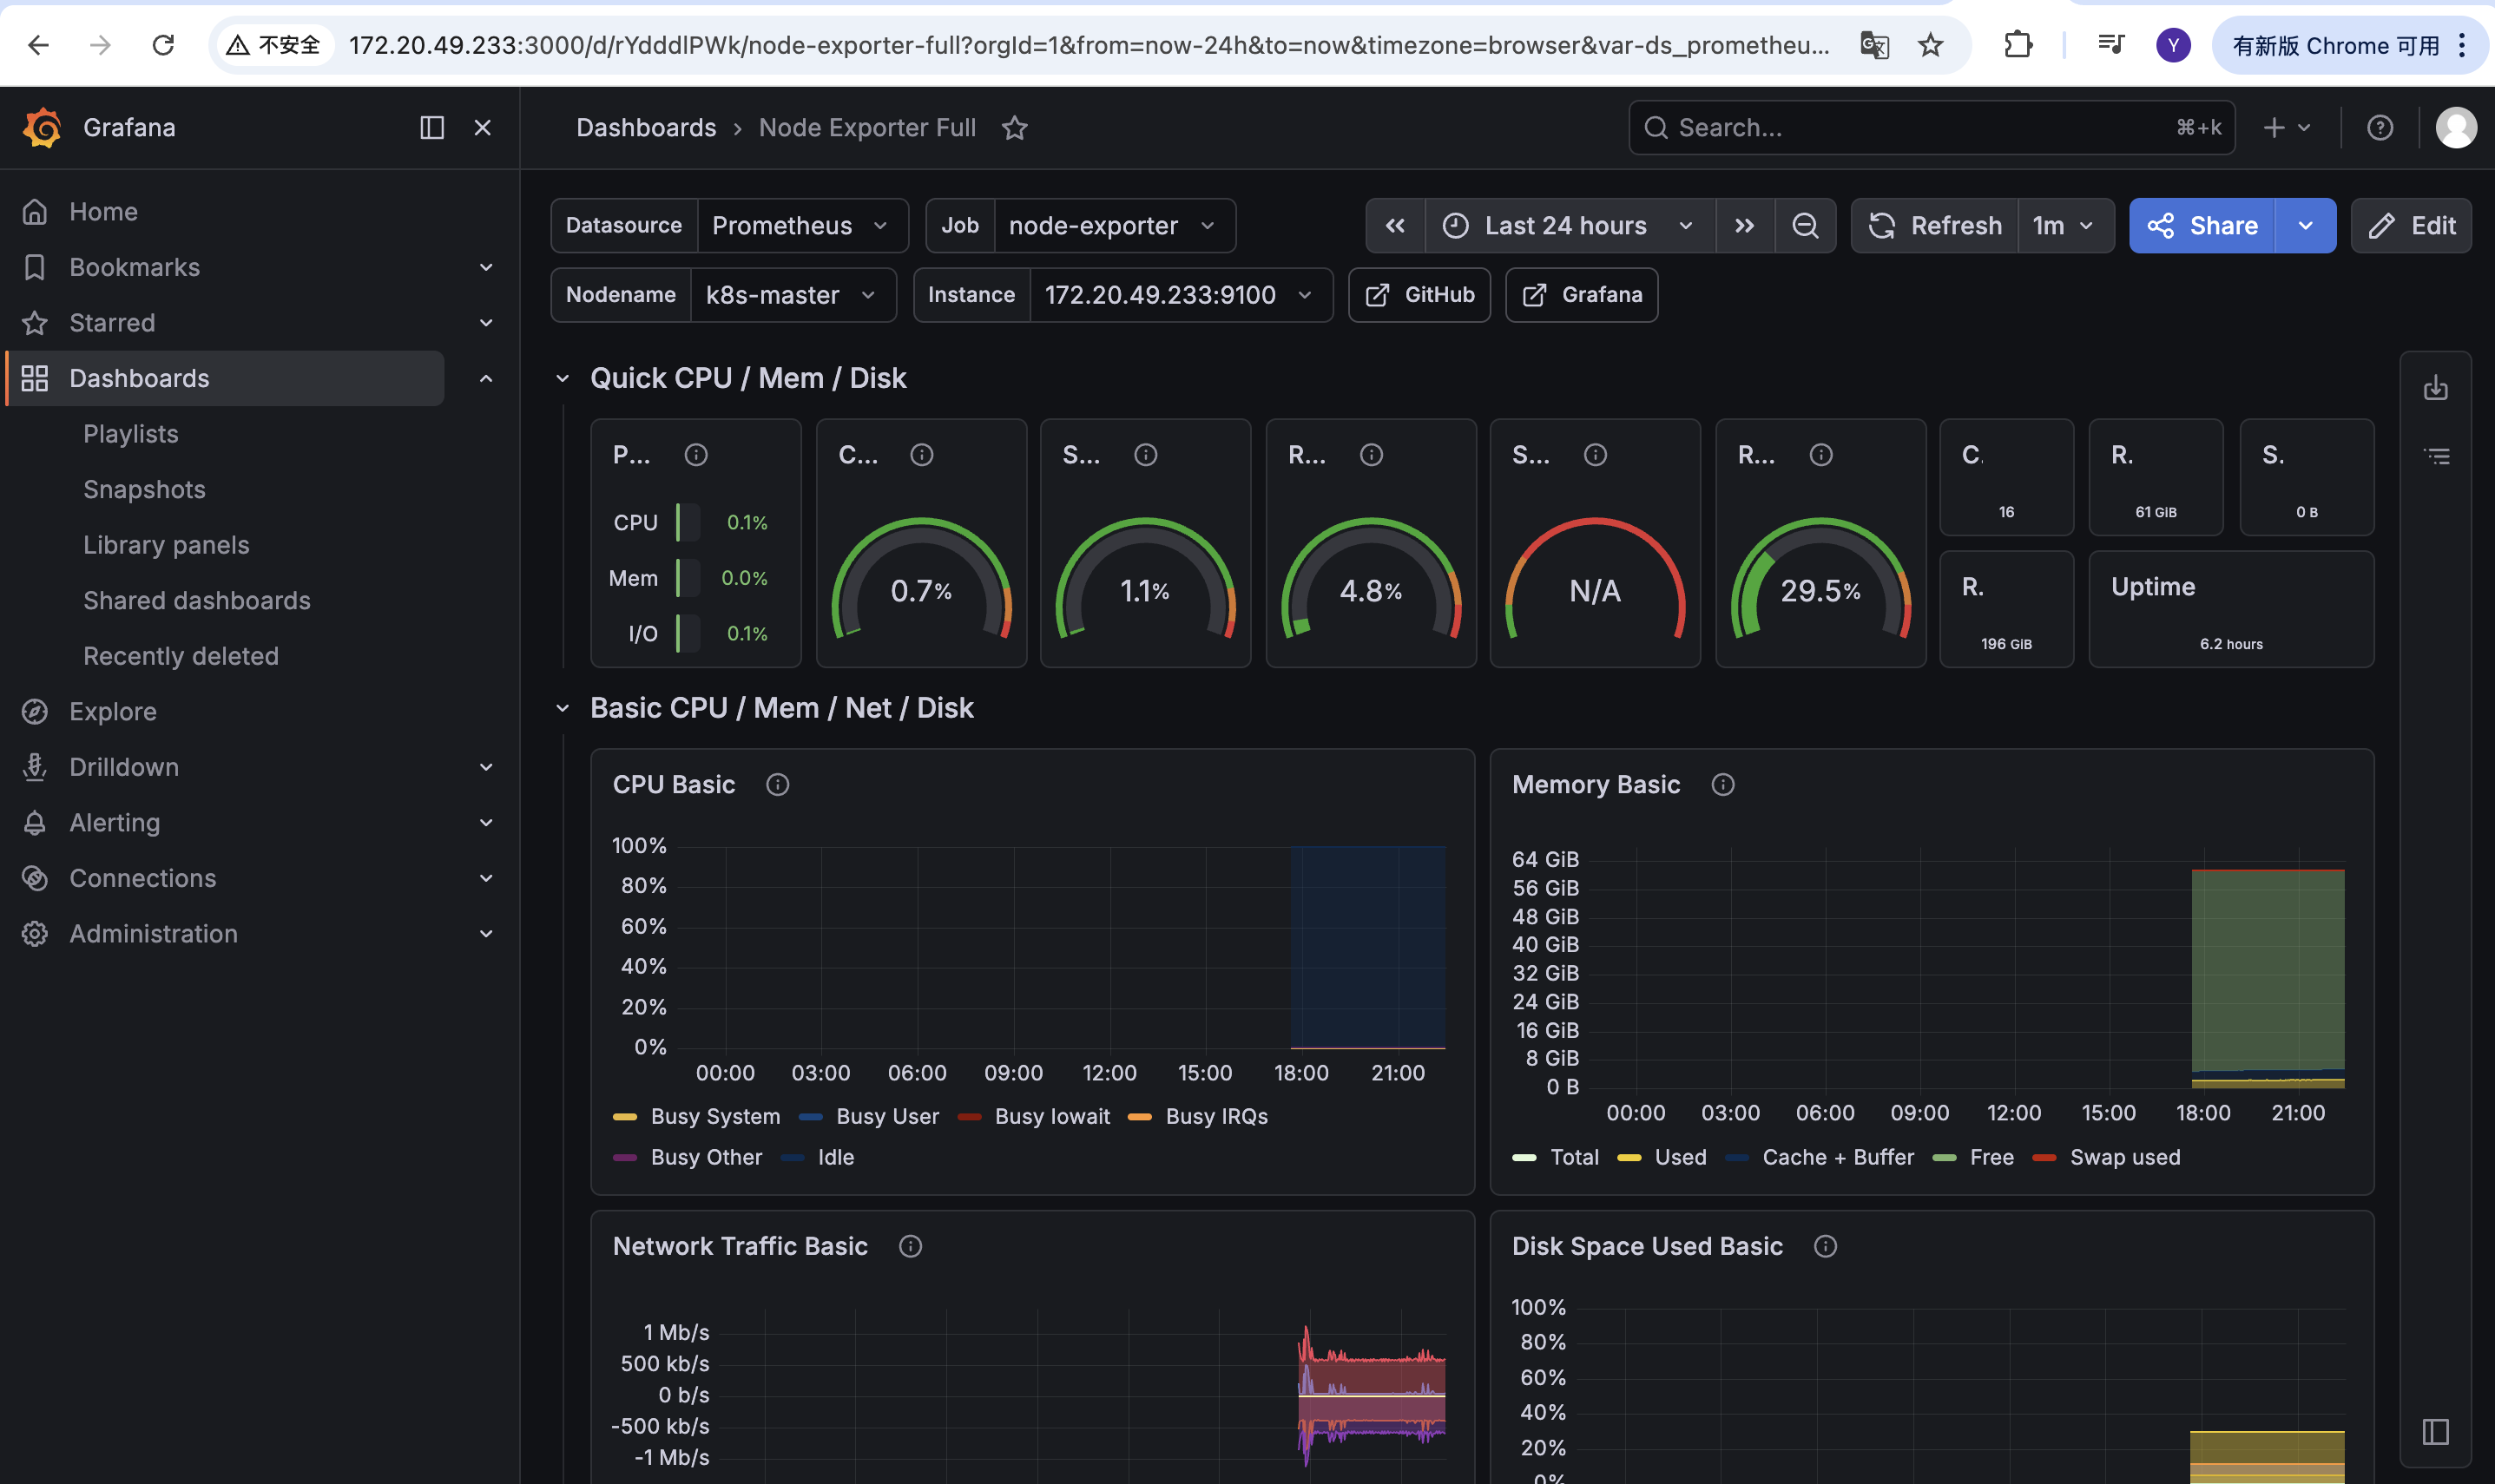
가져오기가 완료되면 노드 메트릭을 확인할 수 있습니다.
일반적인 문제
| 문제 | 가능한 원인 | 해결 방법 |
|---|---|---|
| Prometheus의 대상에 Doris 대상이 표시되지 않음 | ServiceMonitor의 namespaceSelector 또는 matchLabels가 실제 Doris 클러스터와 일치하지 않거나, release 레이블이 Helm Release 이름과 일치하지 않습니다. | 클러스터 네임스페이스와 Service의 app.doris.disaggregated.cluster 레이블을 확인하고, release 레이블이 ServiceMonitor에서 prometheus로 설정되어 있는지 확인합니다. |
대상이 목록에 표시되지만 DOWN 상태임 | Pod가 준비되지 않았거나, http / brpc-port 포트 이름이 실제로 노출된 포트 이름과 일치하지 않습니다. | kubectl get svc -n default와 kubectl describe pod를 사용하여 포트 이름과 준비 상태를 확인하고, 컨테이너 내부에서 /metrics와 /brpc_metrics에 접근할 수 있는지 확인합니다. |
| Grafana 대시보드 패널이 비어 있음 | URL에 var-cluster_id=doris-cluster가 없거나, ServiceMonitor의 job 이름이 변경되었습니다. | 대시보드 URL의 var-cluster_id와 job 레이블이 ServiceMonitor에서 모두 doris-cluster로 설정되어 있는지 확인합니다. |
| 포트 9090의 Prometheus 또는 포트 3000의 Grafana에 접근할 수 없음 | Service 유형의 기본값은 ClusterIP이므로 클러스터 외부에서 접근할 수 없습니다. | kubectl port-forward로 포트를 전달하거나, 해당 Service 유형을 NodePort 또는 LoadBalancer로 변경합니다. |
Grafana 비밀번호 조회 명령이 NotFound를 반환함 | Helm Release 이름이 prometheus가 아니므로 Secret 이름이 다릅니다. | kubectl get secret -n monitoring으로 실제 Grafana Secret 이름을 찾은 다음, 명령의 prometheus-grafana를 해당 이름으로 바꿉니다. |