대시보드
개요
이 문서에서는 Grafana에서 DOG Stack의 관측 가능성 데이터를 활용하는 방법을 설명합니다.
DOG Stack은 Doris를 통합 스토리지 백엔드로 사용합니다. Doris는 MySQL 프로토콜과 호환되므로, Grafana의 MySQL 데이터 소스 하나로 모든 로그, 트레이스, 메트릭을 쿼리할 수 있습니다. 데이터 흐름은 다음과 같습니다.
Apps / Infrastructure → OpenTelemetry Collector → Doris Exporter → Doris → Grafana (MySQL DataSource)
이 문서에서 다루는 내용은 다음과 같습니다.
- 미리 구성된 대시보드 가져오기: 제공되는 대시보드를 바로 사용합니다.
- 데이터 모델 이해: OTel 데이터가 Doris에 저장되는 방식을 알아봅니다.
- 사용자 정의 대시보드 만들기: 패널, 쿼리, 변수를 처음부터 구성합니다.
- 참고 자료: 스키마와 구문 요약을 확인합니다.
사전 요구 사항
시작하기 전에 다음 사항을 확인하세요.
- DOG Stack이 배포되어 있고 Grafana와 Doris가 모두 실행 중이어야 합니다.
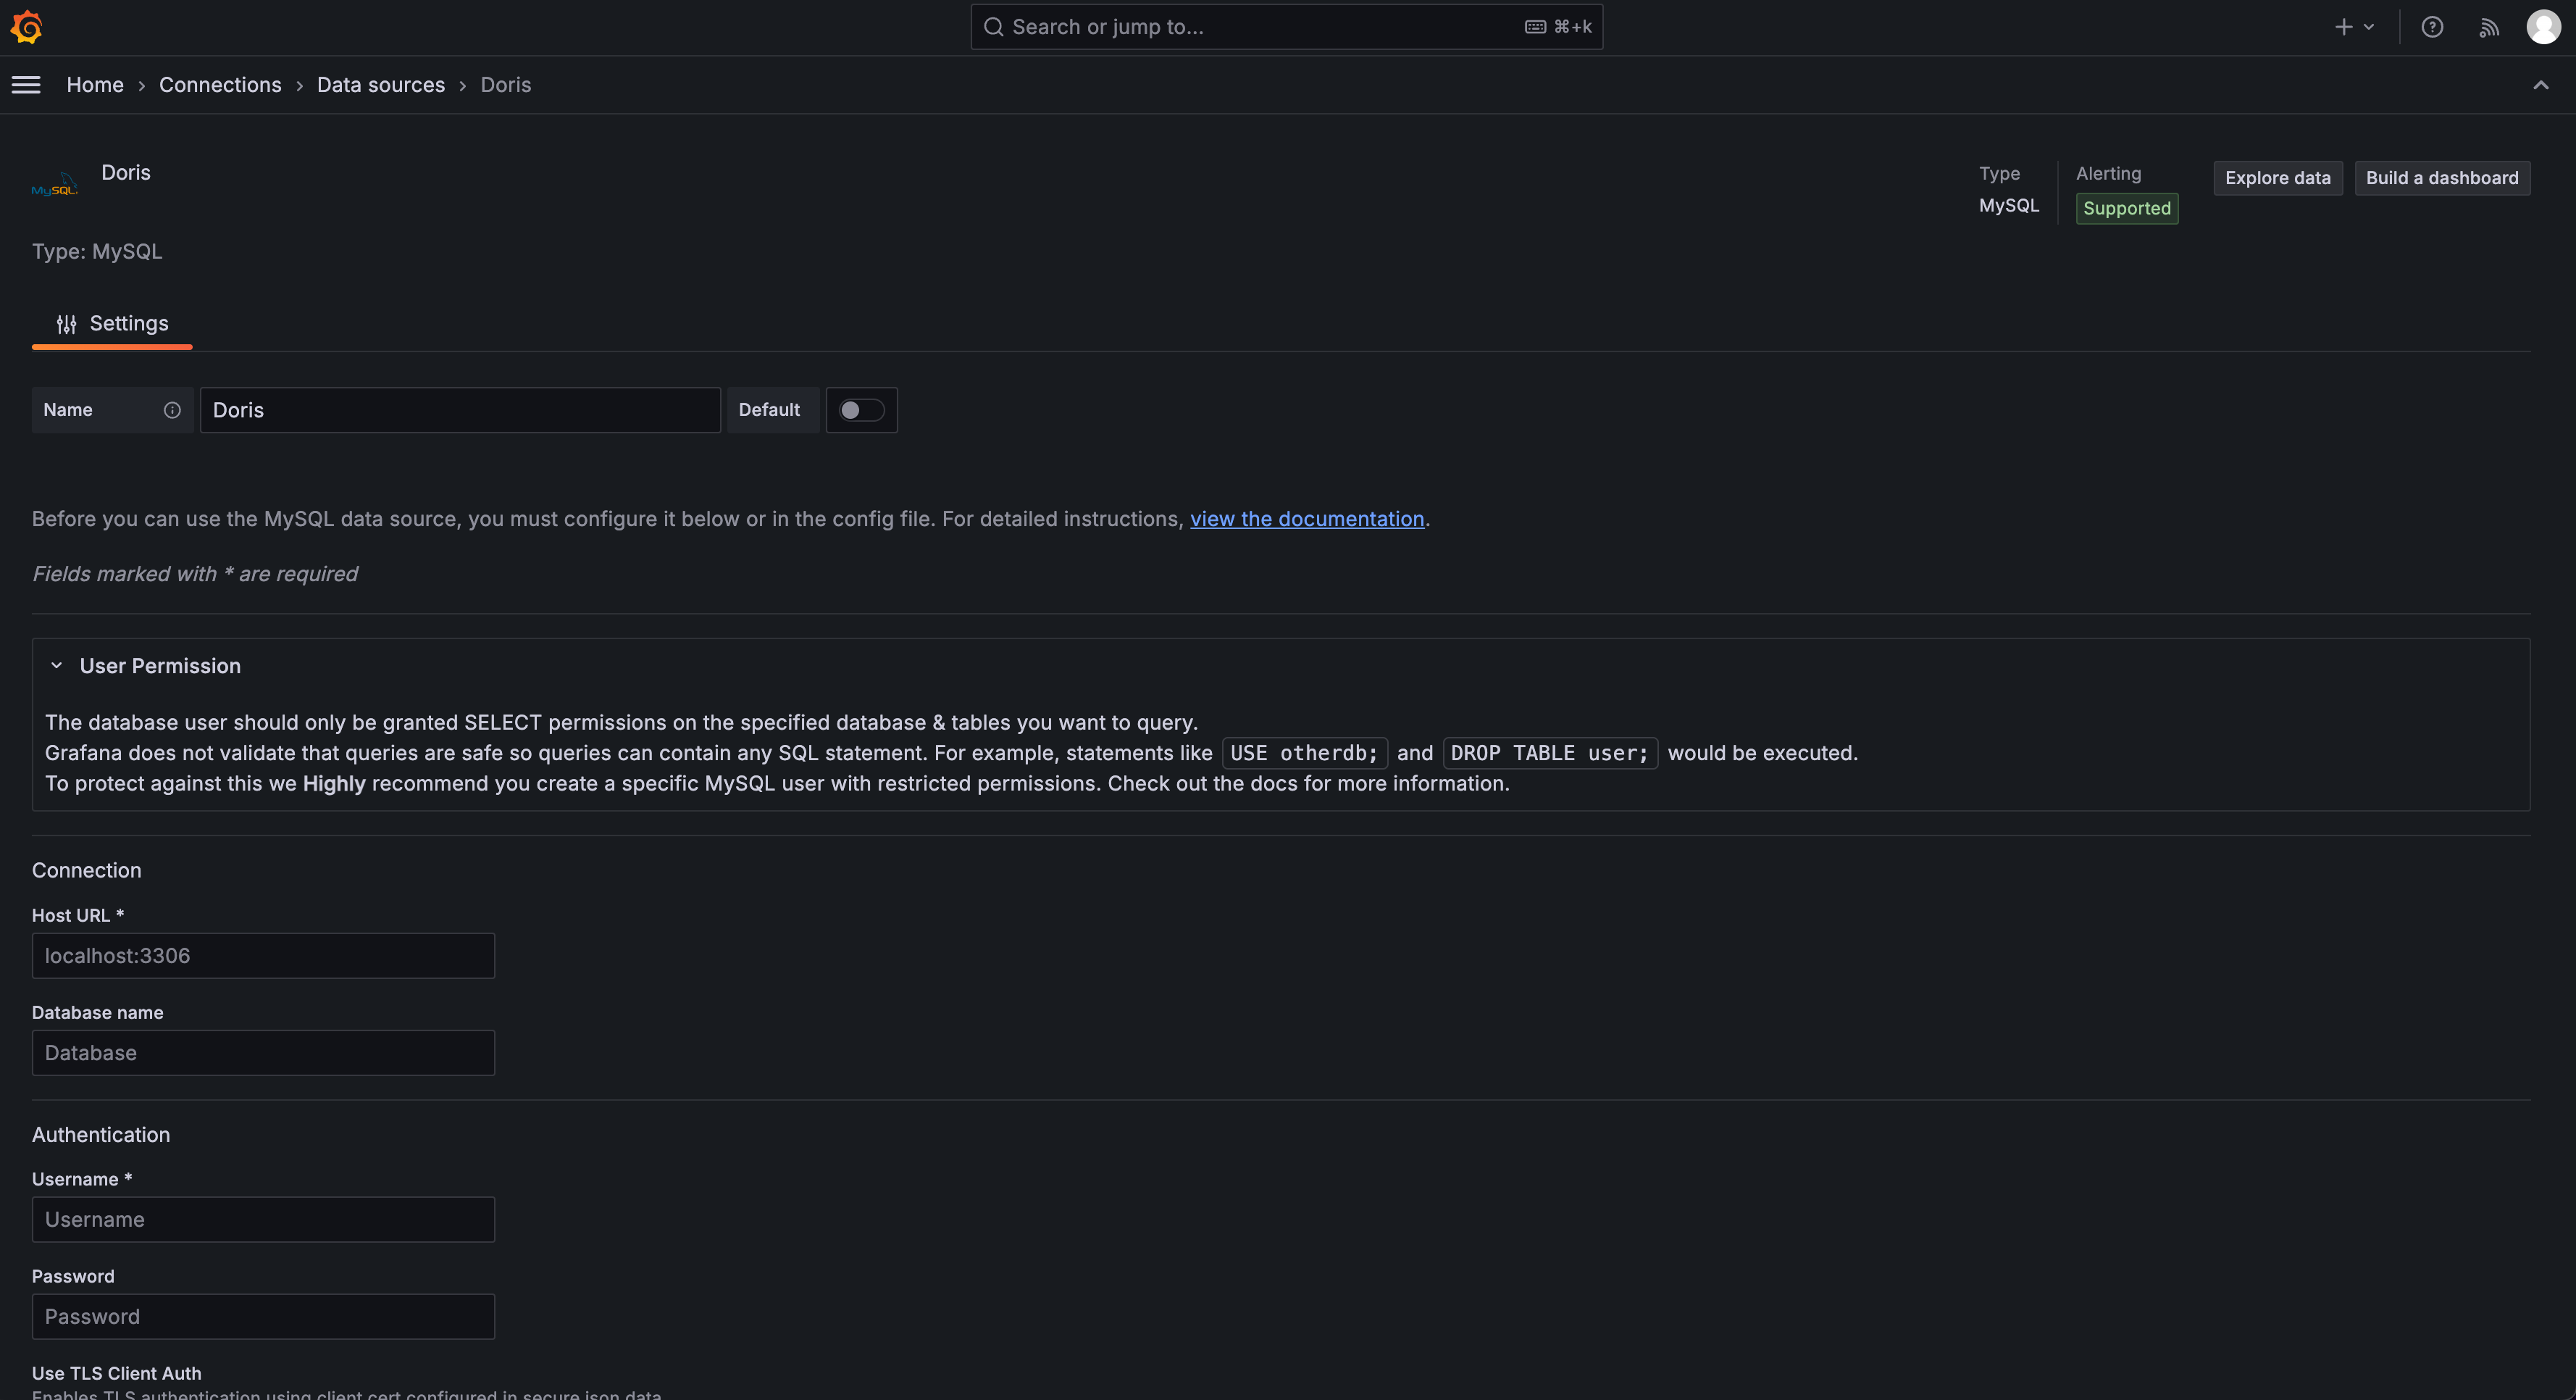
- Grafana에 Doris와 연결되는 MySQL 유형의 데이터 소스가 구성되어 있어야 합니다(DOG Stack에 포함된 Grafana에는 Doris 데이터 소스가 미리 구성되어 있습니다).
아직 데이터 소스를 구성하지 않았다면 다음 단계를 따르세요.
-
Grafana 왼쪽 메뉴에서 연결 > 데이터 소스 > 데이터 소스 추가를 클릭합니다.
-
MySQL을 선택합니다.
-
연결 정보를 입력합니다.
- 호스트:
<Doris-fe-host>:9030- 데이터베이스:
otel- 사용자:
root(또는 직접 구성한 사용자)- 비밀번호: 비워 둡니다(비밀번호를 설정하지 않은 경우).
-
저장 및 테스트를 클릭하여 연결이 정상적으로 작동하는지 확인합니다.
미리 구성된 대시보드 가져오기
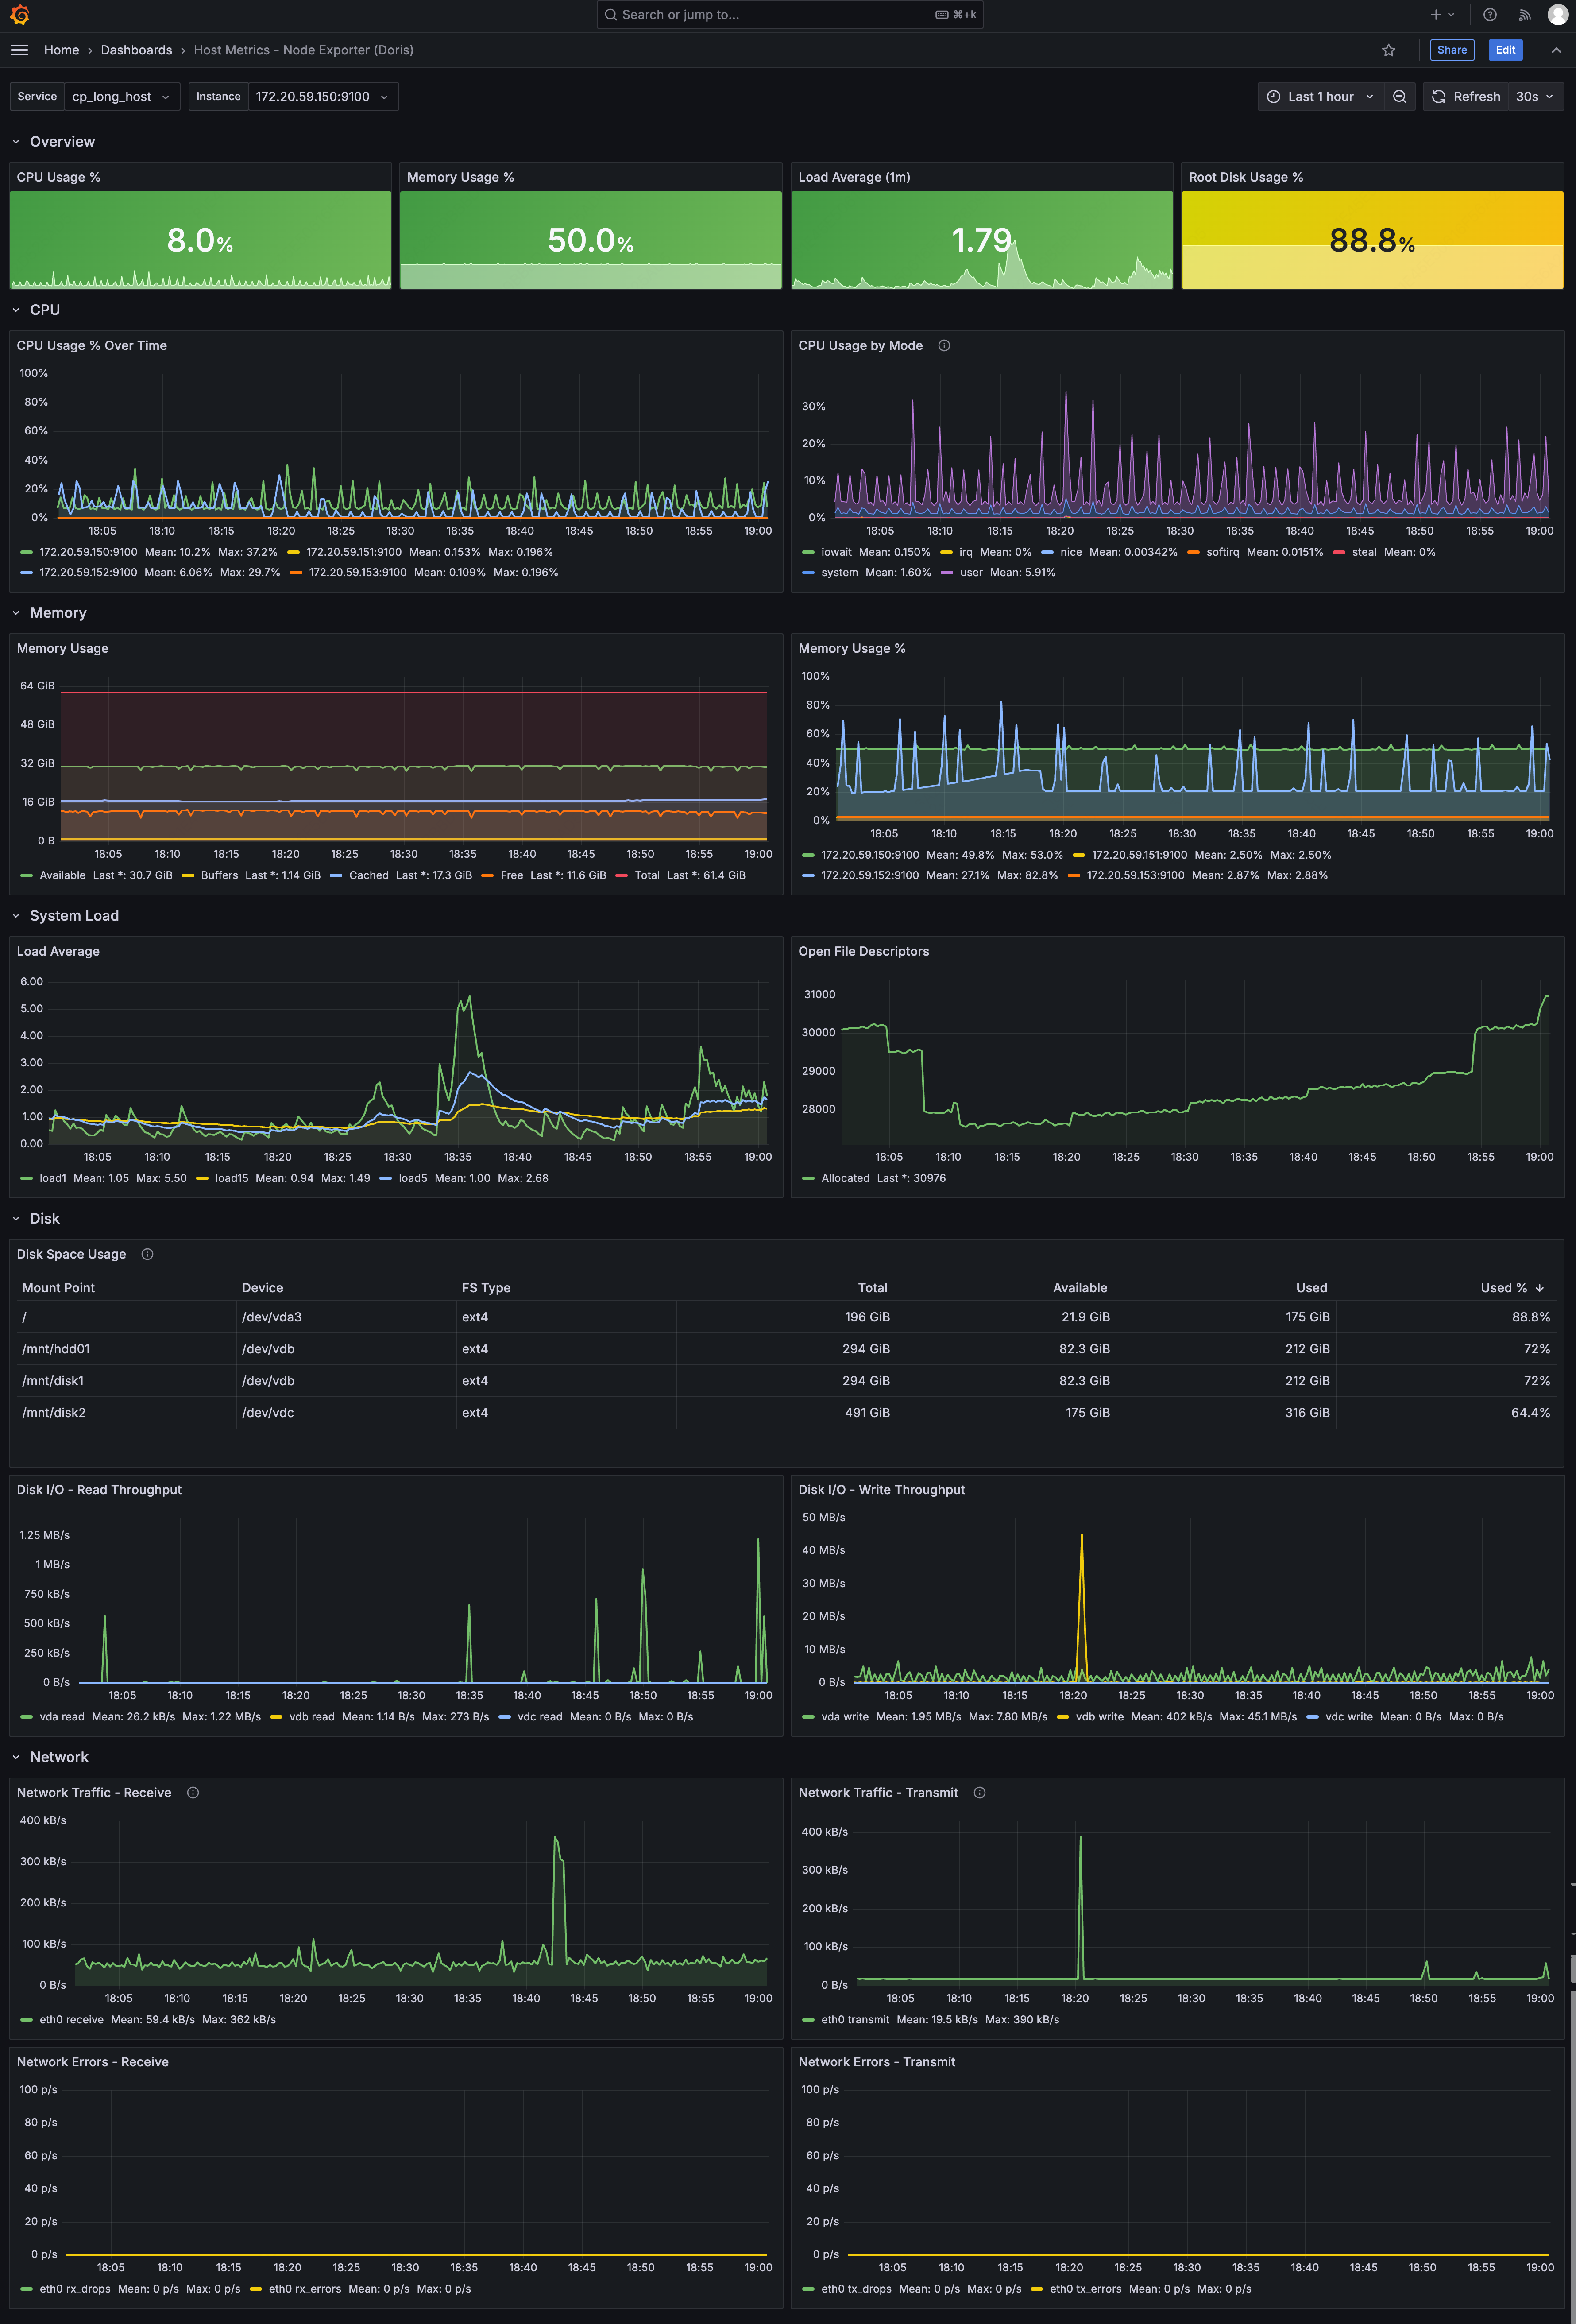
일반적인 관측 가능성 시나리오를 다루는 4개의 미리 구성된 대시보드를 제공합니다.
| 대시보드 | 파일 | 모니터링 대상 |
|---|---|---|
| 호스트 메트릭 | host_metrics_dashboard.json | CPU, 메모리, 디스크, 네트워크, 시스템 부하 |
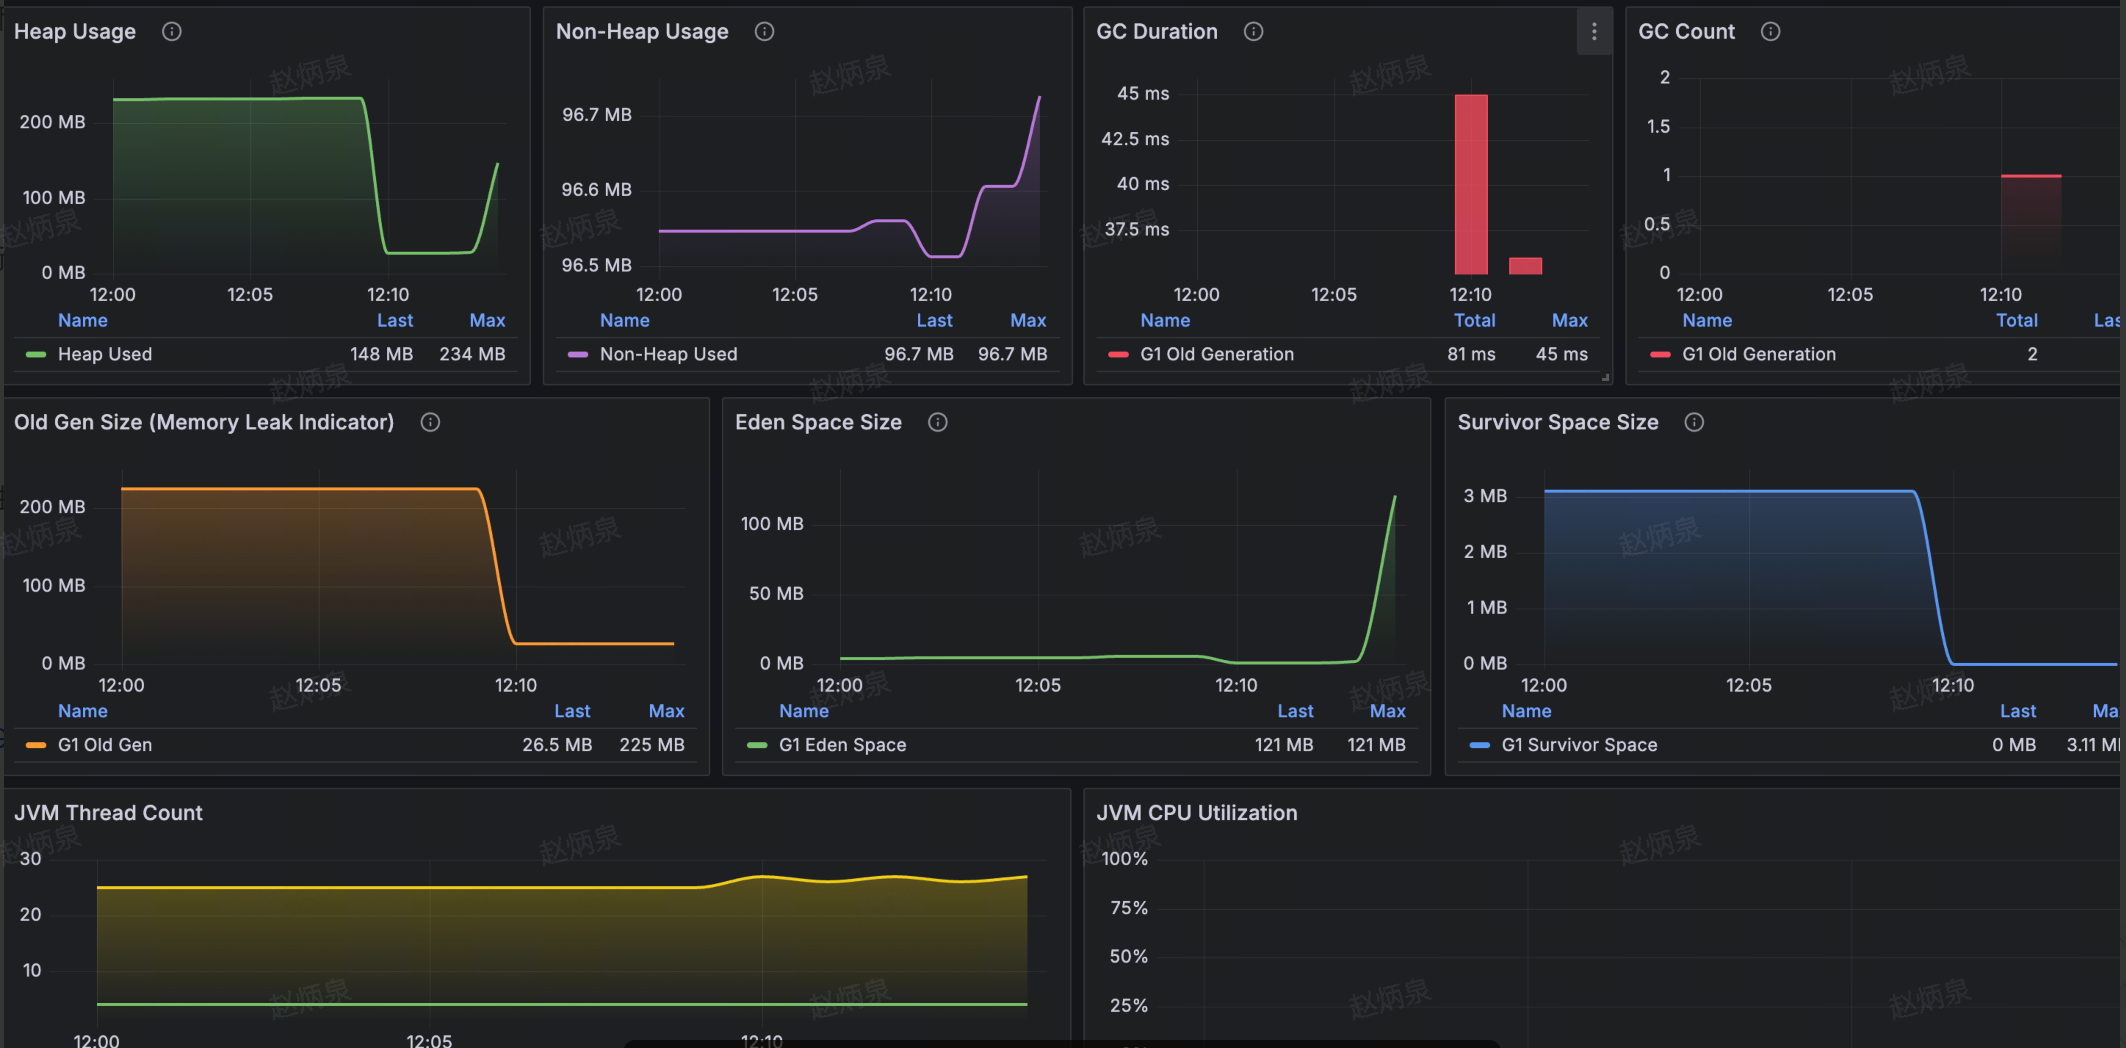
| JVM 모니터링 | jvm_metrics_dashboard.json | 힙 메모리, GC, 스레드, CPU 사용률 |
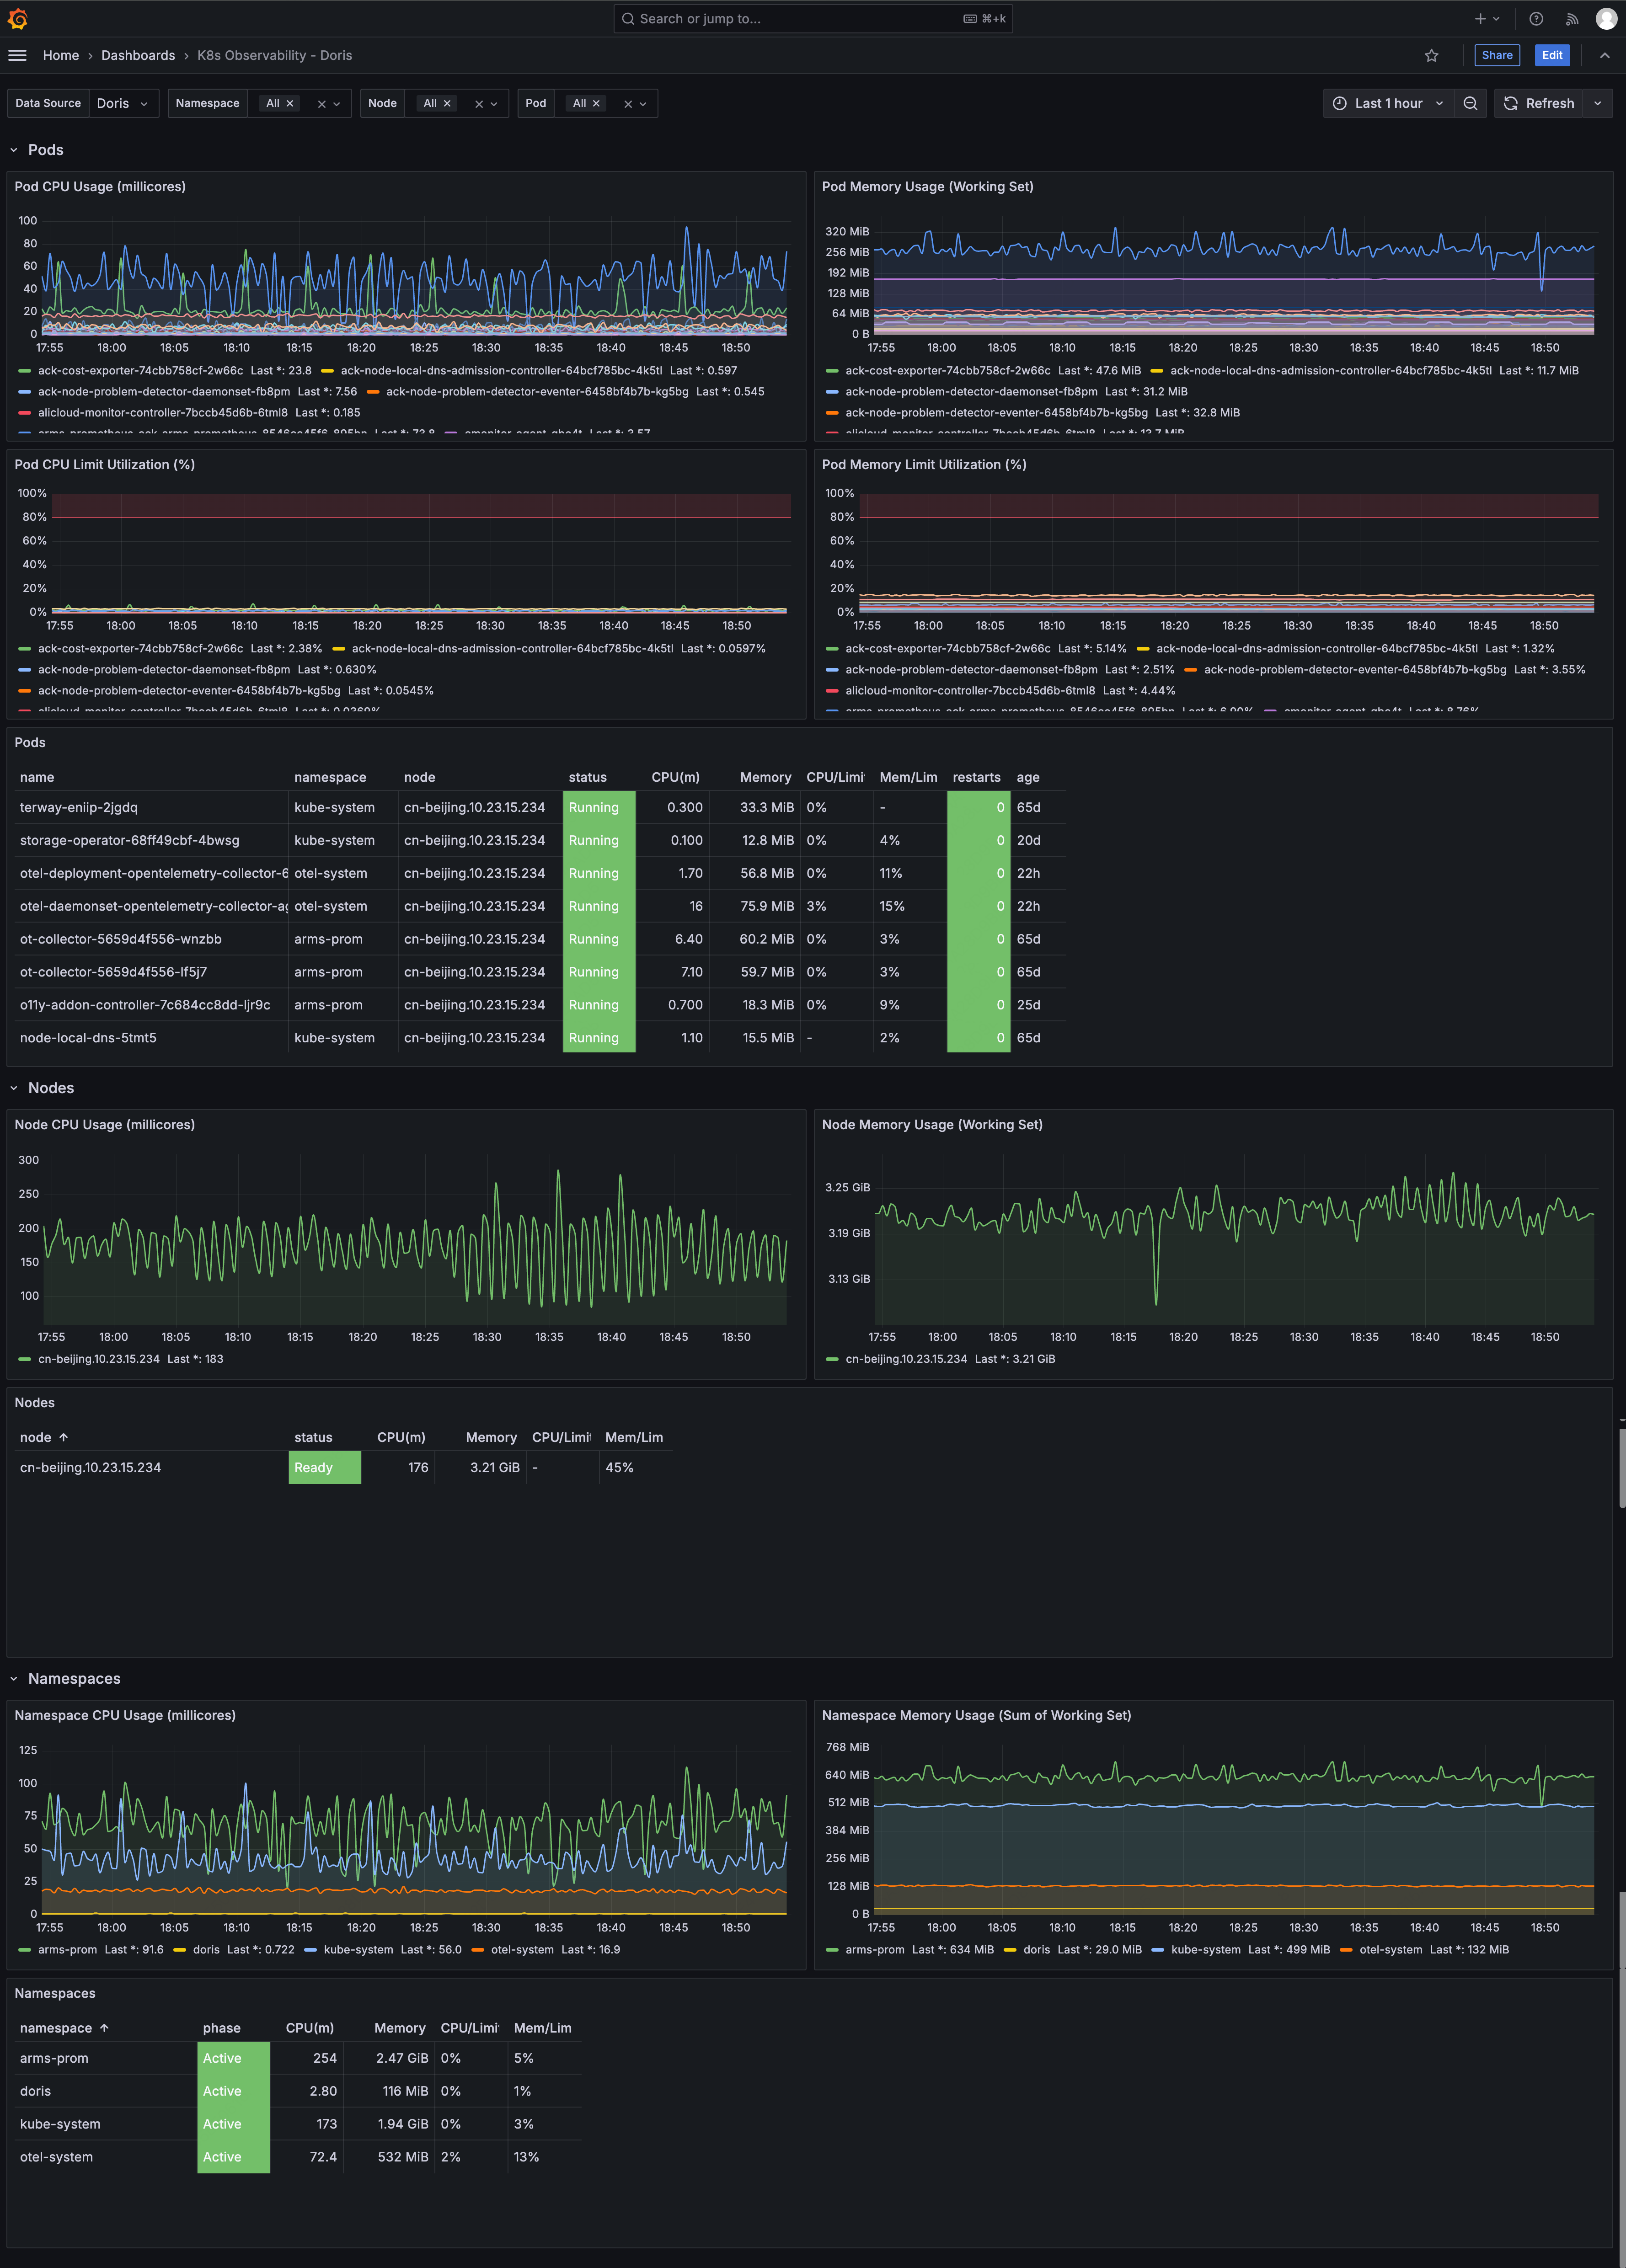
| K8s 관측 가능성 | k8s_kubelet_dashboard.json | Pod / Node / Namespace 리소스 사용량 |
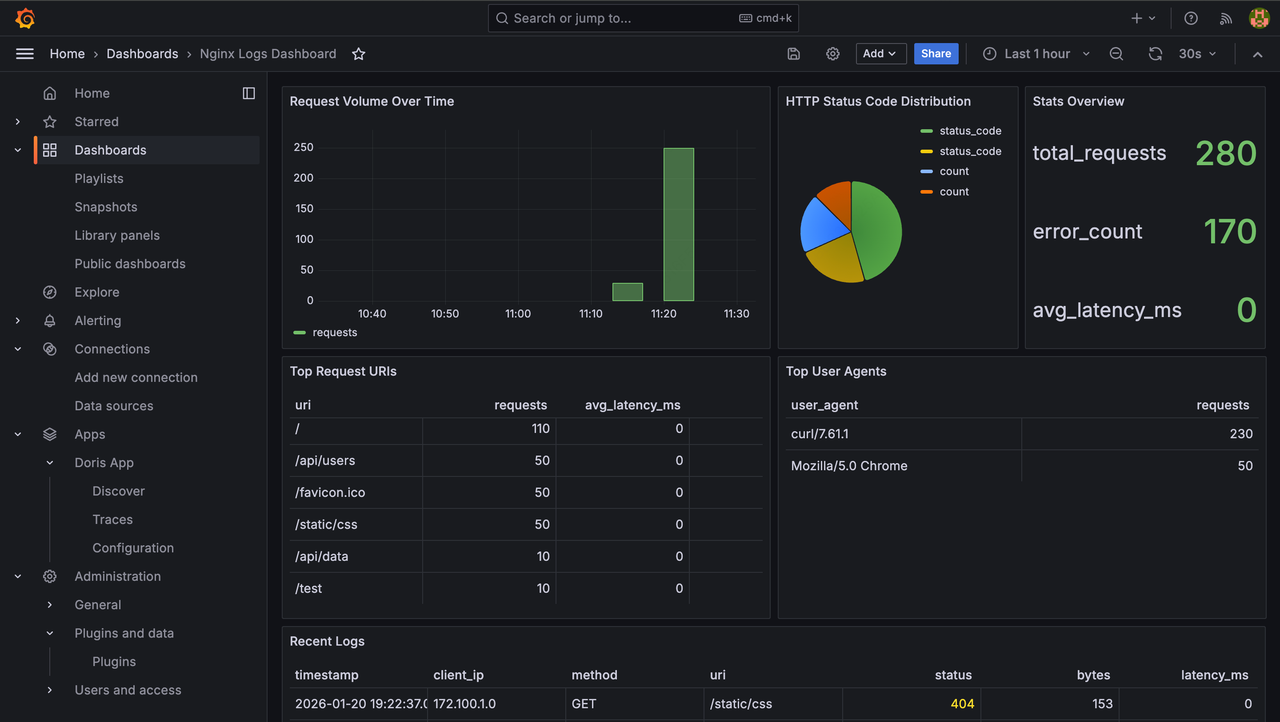
| Nginx 로그 | nginx_logs_dashboard.json | 요청, 상태 코드, 상위 URL, 오류 로그 |
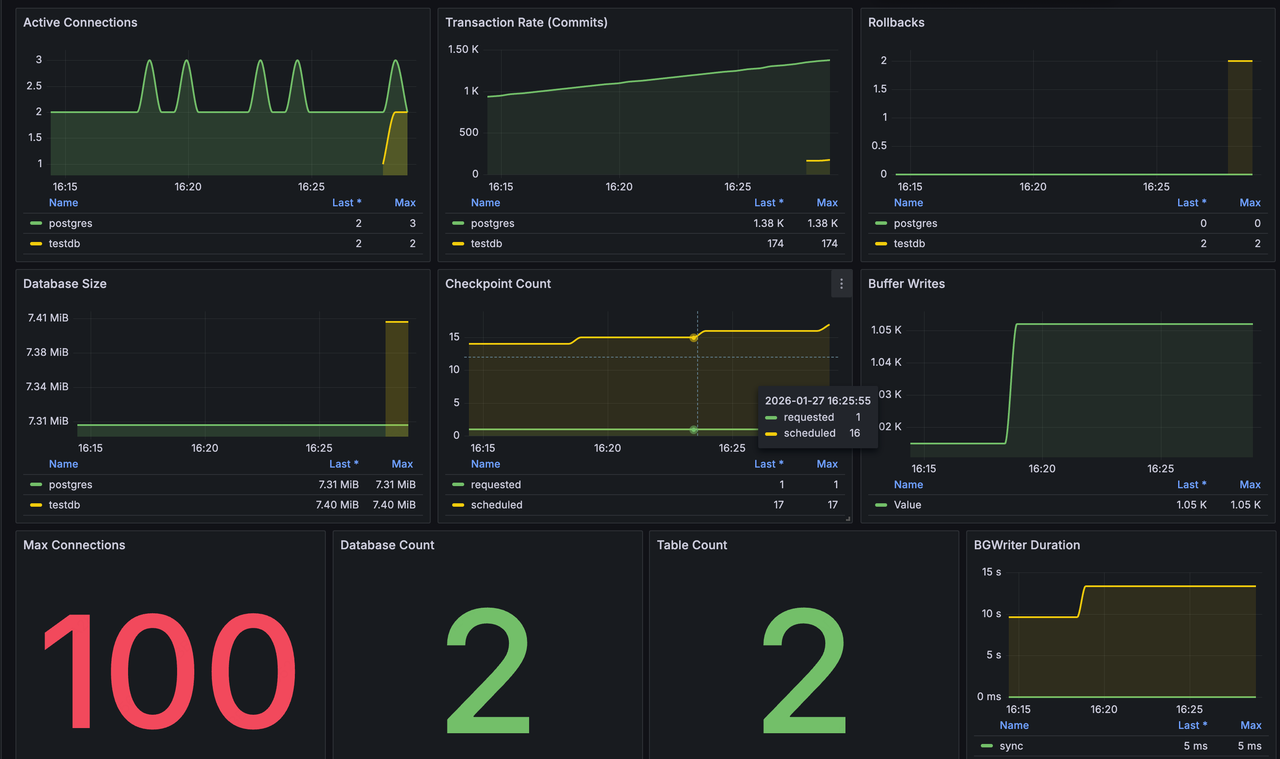
| PostgreSQL 메트릭 | postgresql-metrics-dashboard.json | 연결, 트랜잭션, DB 크기, Checkpoint, BGWriter |
미리 구성된 대시보드를 가져오려면 다음 단계를 따르세요.
-
Grafana 왼쪽 메뉴에서 대시보드 > 새로 만들기 > 가져오기를 클릭합니다.
-
대시보드 JSON 파일 업로드를 클릭하고
grafana-dashboard/아래의 JSON 파일을 선택합니다. -
가져오기 페이지에서 데이터 소스를 미리 구성한 Doris(MySQL) 데이터 소스로 설정합니다.
-
가져오기를 클릭합니다.
-
나머지 JSON 파일에도 위 단계를 반복합니다.
가져오기가 완료되면 대시보드 상단의 변수 선택기(예: Service, Namespace)가 Doris에서 선택 가능한 값을 자동으로 쿼리합니다.
대시보드별 패널 세부 정보
호스트 메트릭 대시보드
- 개요: CPU 사용률, 메모리 사용률, 1분 부하, 루트 디스크 사용률
- CPU: 사용률 추이, 모드별 사용률
- 메모리: 메모리 세부 정보(전체 / 사용 가능 / 여유 / 캐시 / 버퍼), 사용률 추이
- 시스템 부하: 1 / 5 / 15분 부하, 열린 파일 디스크립터 수
- 디스크: 디스크 공간 사용량 테이블, 읽기/쓰기 처리량
- 네트워크: 유입/유출 트래픽, 오류 및 패킷 손실
JVM 모니터링 대시보드
- 개요: 힙 사용량, Full GC 횟수, CPU 사용률, 스레드 수
- 메모리: 힙 / 비힙 추이, Old Gen / Eden / Survivor 풀 세부 정보
- GC: 소요 시간(Young / Old) 및 횟수
- 스레드 및 CPU: 스레드 수 추이, CPU 사용률
K8s 관측 가능성 대시보드
- Pod: CPU(밀리코어), 메모리, Limit 대비 사용률, 상태 테이블(재시작 횟수 및 가동 시간 포함)
- Node: CPU / 메모리 추이, 상태 테이블
- Namespace: CPU / 메모리 집계, 상태 테이블
Nginx 로그 대시보드
- 개요: 요청, 오류, 5xx / 4xx 통계, 상태 코드 원형 차트
- 추이: 요청량 / 오류 로그 추이
- 분석: 상위 URL, 상위 IP, HTTP 메서드 분포, 주요 오류 메시지
- 최근 로그: 액세스 / 오류 로그 세부 정보
PostgreSQL 메트릭 대시보드
- 연결: 활성 연결 수(데이터베이스별), 최대 연결 수
- 트랜잭션: 커밋 속도, 롤백 횟수
- 스토리지: 데이터베이스 크기(데이터베이스별), 데이터베이스 수, 테이블 수
- BGWriter: 체크포인트 횟수(예약 / 요청), 버퍼 쓰기, BGWriter 소요 시간
데이터 모델 이해
사용자 정의 대시보드를 만들기 전에 OTel 데이터가 Doris에 저장되는 방식을 알아야 합니다.
테이블
Prometheus와 달리 Doris에서는 메트릭 이름만으로 쿼리할 수 없으며, 어느 테이블을 쿼리해야 하는지도 알아야 합니다. OTel 데이터는 신호 유형과 메트릭 유형에 따라 여러 테이블에 나누어 저장됩니다.
| 테이블 | 내용 | 값 필드 | 쿼리 방식 |
|---|---|---|---|
otel_metrics_gauge | 순간값 메트릭 | value | 직접 집계(예: AVG(value)) |
otel_metrics_sum | 누적 카운터 | value(단조 증가) | LAG()로 변화율 계산 |
otel_metrics_histogram | 히스토그램 | count, sum, bucket_counts | LAG()로 차이 계산 |
otel_logs | 로그 | body, severity_text | COUNT 집계 또는 상세 쿼리 |
otel_traces | 트레이스 | duration, span_name | 소요 시간으로 정렬 또는 집계 |
특정 메트릭이 어느 테이블에 저장되어 있는지 확인하려면 다음을 실행합니다.
SELECT 'gauge' AS type, metric_name FROM otel.otel_metrics_gauge WHERE metric_name = 'your_metric_name' LIMIT 1
UNION ALL
SELECT 'sum', metric_name FROM otel.otel_metrics_sum WHERE metric_name = 'your_metric_name' LIMIT 1
UNION ALL
SELECT 'histogram', metric_name FROM otel.otel_metrics_histogram WHERE metric_name = 'your_metric_name' LIMIT 1;
사용 가능한 모든 메트릭을 살펴보려면 각 테이블에 대해 다음을 실행합니다.
SELECT DISTINCT metric_name FROM otel.otel_metrics_gauge ORDER BY metric_name;
속성 필드
Prometheus에서는 모든 레이블에 {key="value"} 형식으로 동일하게 접근합니다. Doris에서는 속성이 여러 variant(JSON) 컬럼에 나누어 저장되며, 대괄호 구문으로 접근합니다.
| 테이블 | 필드 | 내용 | 예시 |
|---|---|---|---|
| 메트릭 | attributes | 메트릭 차원(Prometheus 레이블) | attributes['mode'] |
| 메트릭 | resource_attributes | 리소스 정보(K8s Pod/Node 등) | resource_attributes['k8s.pod.name'] |
| 로그 | log_attributes | 로그 필드 | log_attributes['status'] |
| 트레이스 | span_attributes | 스팬 필드 | span_attributes['http.method'] |
참고: service_name과 service_instance_id는 최상위 컬럼이며, attributes에 속하지 않습니다. 예를 들어 WHERE service_name = '...'처럼 직접 사용합니다.
SELECT, GROUP BY, PARTITION BY 또는 LIKE를 사용할 때는 CAST로 타입을 변환해야 합니다.
-- Extract a value in SELECT
CAST(attributes['device'] AS VARCHAR) AS device

-- Pattern match in WHERE
CAST(attributes['device'] AS VARCHAR) NOT LIKE 'veth%'

-- Numeric comparison in WHERE
CAST(log_attributes['status'] AS INT) >= 500

-- Use in GROUP BY
GROUP BY CAST(resource_attributes['k8s.pod.name'] AS VARCHAR)
WHERE의 단순 동등 비교에는 대개 CAST가 필요하지 않습니다.
WHERE attributes['mode'] = 'idle'
주의: 잘못된 속성 필드 이름을 사용해도(예: 메트릭 테이블에서 log_attributes 사용) 오류가 발생하지 않습니다. 대신 NULL이 반환되어 쿼리 결과가 비어 있게 됩니다.
Counter 메트릭과 변화율 계산
Gauge 메트릭에서는 value가 현재 값을 직접 나타내므로 AVG 또는 MAX로 집계할 수 있습니다.
Counter / Sum 메트릭에서는 value가 단조 증가하는 누적값입니다(예: 총 CPU 사용 시간(초) 또는 총 네트워크 바이트 수). 변화율을 구하려면 인접한 데이터 포인트 간의 차이가 필요합니다. Prometheus의 rate()는 Doris에서 LAG() 윈도우 함수로 구현합니다.
다음은 범용 변화율 계산 템플릿입니다.
SELECT
  t.timestamp AS time,
  t.<dimension_field> AS metric,
  CASE
    WHEN UNIX_TIMESTAMP(t.timestamp) > UNIX_TIMESTAMP(t.prev_ts)
         AND t.value >= t.prev_value
    THEN (t.value - t.prev_value) / (UNIX_TIMESTAMP(t.timestamp) - UNIX_TIMESTAMP(t.prev_ts))
    ELSE NULL
  END AS value
FROM (
  SELECT timestamp, value, <dimension_field>,
    LAG(value) OVER (PARTITION BY <dimension_field> ORDER BY timestamp) AS prev_value,
    LAG(timestamp) OVER (PARTITION BY <dimension_field> ORDER BY timestamp) AS prev_ts
  FROM otel.otel_metrics_sum
  WHERE metric_name = '<metric_name>'
    AND $__timeFilter(timestamp)
) t
WHERE t.prev_ts IS NOT NULL
ORDER BY time
이 템플릿을 사용하려면 다음 자리 표시자를 바꿉니다.
<dimension_field>: 시리즈를 구분하는 필드입니다. 예:CAST(attributes['device'] AS VARCHAR).<metric_name>: 메트릭 이름입니다. 예:node_network_receive_bytes_total.
이 템플릿에는 세 가지 보호 장치가 포함되어 있습니다.
| 조건 | 목적 |
|---|---|
WHERE t.prev_ts IS NOT NULL | 각 파티션의 첫 번째 행을 건너뜁니다(LAG가 NULL을 반환). |
UNIX_TIMESTAMP(t.timestamp) > UNIX_TIMESTAMP(t.prev_ts) | 중복 타임스탬프로 인해 영으로 나누는 것을 방지합니다. |
t.value >= t.prev_value | 카운터 초기화로 인해 차이가 음수가 되는 것을 방지합니다. |
PARTITION BY의 선택은 변화율의 정확성을 직접 결정합니다. 잘못 선택하면 서로 다른 차원의 데이터가 섞입니다. 미리 구성된 대시보드에서는 다음과 같이 선택합니다.
| 시나리오 | PARTITION BY |
|---|---|
| CPU 사용률(멀티코어 집계) | service_instance_id, CAST(attributes['cpu'] AS VARCHAR) |
| 디스크 I/O | CAST(attributes['device'] AS VARCHAR) |
| 네트워크 트래픽 | CAST(attributes['device'] AS VARCHAR) |
| GC 소요 시간 | CAST(attributes['jvm.gc.name'] AS VARCHAR) |
사용자 정의 대시보드 만들기
이 섹션에서는 여러 패널과 변수가 있는 대시보드를 처음부터 만드는 과정을 실습합니다.
대시보드 및 Time Series 패널 만들기
K8s Pod의 CPU 사용률 추이를 보여 주는 Time Series 패널을 만들어 보겠습니다. 이 예제에서는 Gauge 메트릭을 사용하며, SQL을 작성할 때의 전체 사고 과정을 설명합니다.
-
Grafana 왼쪽 메뉴에서 대시보드 > 새로 만들기 > 새 대시보드를 클릭합니다.
-
시각화 추가를 클릭합니다.
-
데이터 소스 드롭다운에서 미리 구성한 MySQL(Doris) 데이터 소스를 선택합니다.
-
쿼리 편집기 오른쪽 상단에서 코드 모드로 전환합니다.
이제 SQL 쿼리를 작성합니다. 다음과 같이 단계별로 구성합니다.
기본 쿼리 작성. 목표는 Pod의 CPU를 모니터링하는 것이며, 메트릭 이름은 k8s.pod.cpu.usage입니다. 이 메트릭은 otel_metrics_gauge에 저장되는 Gauge 메트릭이므로 value를 직접 집계할 수 있습니다.
SELECT timestamp, value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.cpu.usage'
시간 필터 추가. Grafana의 MySQL 데이터 소스는 시간 필터링을 위한 두 가지 방법을 제공합니다.
-- Option A: use the $__timeFilter macro (recommended)
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND $__timeFilter(timestamp)

-- Option B: use $__from and $__to (more flexible inside subqueries or JOINs)
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND timestamp >= FROM_UNIXTIME($__from/1000)
  AND timestamp < FROM_UNIXTIME($__to/1000)
참고: $__from과 $__to는 밀리초 단위 타임스탬프입니다. 1000으로 나눈 후 FROM_UNIXTIME()에서 사용해야 합니다.
시간 버킷 추가. 원시 데이터 포인트는 너무 촘촘하므로 고정된 간격으로 집계합니다. FLOOR(UNIX_TIMESTAMP(timestamp) / N) * N을 사용하여 시간을 N초 단위 버킷으로 내림합니다.
SELECT
  FLOOR(UNIX_TIMESTAMP(timestamp) / 20) * 20 AS time,
  AVG(value) AS value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND timestamp >= FROM_UNIXTIME($__from/1000)
  AND timestamp < FROM_UNIXTIME($__to/1000)
GROUP BY time
ORDER BY time
차원별로 여러 시리즈로 나누기. Time Series 형식에서 Grafana의 MySQL 데이터 소스는 세 개의 컬럼을 요구합니다.
| 컬럼 | 목적 |
|---|---|
time 또는 time_sec | X축 시간입니다. datetime 값 또는 초 단위 UNIX 타임스탬프를 사용합니다. |
metric | 시리즈 이름입니다. Grafana는 이 컬럼의 서로 다른 값에 따라 여러 선으로 나눕니다. |
value | Y축 값입니다. |
Pod 이름을 metric 컬럼으로 추가하면 완성된 쿼리는 다음과 같습니다.
SELECT
  FLOOR(UNIX_TIMESTAMP(timestamp) / 20) * 20 AS time,
  CAST(resource_attributes['k8s.pod.name'] AS VARCHAR) AS metric,
  AVG(value) AS value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.cpu.usage'
  AND timestamp >= FROM_UNIXTIME($__from/1000)
  AND timestamp < FROM_UNIXTIME($__to/1000)
GROUP BY time, metric
ORDER BY time
다른 Gauge 메트릭을 모니터링하려면 다음을 변경합니다.
metric_name: 대상 메트릭 이름입니다.metric컬럼: 시리즈를 구분하는 차원으로,attributes또는resource_attributes에서 선택합니다.
-
완성된 SQL을 쿼리 편집기에 붙여 넣습니다.
-
편집기 아래에서 형식을 시계열(Time series)로 설정합니다.
-
패널 제목을 클릭하여 이름을 설정합니다.
-
오른쪽 패널 설정에서 표준 옵션 > 단위를 찾아 적절한 단위를 선택합니다.
-
오른쪽 상단에서 적용을 클릭합니다.
Counter 메트릭 패널 추가
이 섹션에서는 Counter 메트릭의 변화율을 보여 주는 Time Series 패널을 만듭니다. Counter의 value는 단조 증가하는 누적값이므로, 범용 변화율 계산 템플릿으로 변화율을 계산합니다.
- 대시보드에서 추가 > 시각화를 클릭합니다.
- 데이터 소스를 선택하고 코드 모드로 전환합니다.
변화율 계산 템플릿의 자리 표시자를 실제 값으로 바꿉니다. 아래 예제는 네트워크 장치별로 수신 바이트 변화율을 계산합니다.
SELECT
  t.timestamp AS time,
  t.device AS metric,
  CASE
    WHEN UNIX_TIMESTAMP(t.timestamp) > UNIX_TIMESTAMP(t.prev_ts)
         AND t.value >= t.prev_value
    THEN (t.value - t.prev_value) / (UNIX_TIMESTAMP(t.timestamp) - UNIX_TIMESTAMP(t.prev_ts))
    ELSE NULL
  END AS value
FROM (
  SELECT timestamp, CAST(attributes['device'] AS VARCHAR) AS device, value,
    LAG(value) OVER (PARTITION BY CAST(attributes['device'] AS VARCHAR) ORDER BY timestamp) AS prev_value,
    LAG(timestamp) OVER (PARTITION BY CAST(attributes['device'] AS VARCHAR) ORDER BY timestamp) AS prev_ts
  FROM otel.otel_metrics_sum
  WHERE metric_name = 'node_network_receive_bytes_total'
    AND $__timeFilter(timestamp)
) t
WHERE t.prev_ts IS NOT NULL
ORDER BY time
다른 Counter 메트릭을 사용하려면 다음 두 가지를 변경합니다.
metric_name: 대상 메트릭 이름입니다.PARTITION BY와SELECT의 차원 필드: 해당 메트릭을 구분하는 차원입니다(예:attributes['cpu'],attributes['gc_name']등).- SQL을 붙여 넣고 형식을 시계열(Time series)로 설정합니다.
- 표준 옵션 > 단위에서 적절한 단위를 선택합니다.
- 적용을 클릭합니다.
Stat 패널 추가
Stat 패널은 현재 사용률이나 최신 개수처럼 단일 값을 표시합니다. SQL은 값 하나만 반환하면 됩니다.
- 추가 > 시각화를 클릭하고 코드 모드로 전환합니다.
다음 쿼리는 지정된 시간 범위 내에서 가장 최근의 메트릭 값을 가져옵니다.
SELECT value
FROM otel.otel_metrics_gauge
WHERE metric_name = 'node_memory_MemAvailable_bytes'
  AND $__timeFilter(timestamp)
ORDER BY timestamp DESC
LIMIT 1
여러 메트릭으로 계산해야 하는 경우(예: 비율) 최적화 팁의 "하나의 SQL로 여러 메트릭 쿼리하기"를 참고하세요.
- SQL을 붙여 넣고 형식을 테이블(Table)로 설정합니다(Stat 패널은 Table 형식을 사용합니다).
- 오른쪽 패널 설정에서 패널 유형을 통계(Stat)로 변경합니다.
- 표준 옵션 > 단위에서 적절한 단위를 선택합니다.
- 적용을 클릭합니다.
Table 패널 추가
Table 패널은 여러 행과 컬럼으로 구성된 데이터에 적합합니다. SQL의 각 컬럼 별칭이 컬럼 헤더가 됩니다.
- 추가 > 시각화를 클릭하고 코드 모드로 전환합니다.
다음 쿼리는 최근 로그의 세부 정보를 표시합니다.
SELECT
  timestamp,
  service_name,
  severity_text,
  body,
  CAST(log_attributes['your_key'] AS VARCHAR) AS your_key
FROM otel.otel_logs
WHERE $__timeFilter(timestamp)
ORDER BY timestamp DESC
LIMIT 100
your_key를 실제 로그 속성 필드 이름으로 바꿉니다. 사용 가능한 속성을 확인하려면 다음을 실행합니다.
SELECT log_attributes FROM otel.otel_logs LIMIT 1;
- SQL을 붙여 넣고 형식을 테이블(Table)로 설정합니다.
- 적용을 클릭합니다.
템플릿 변수 추가
템플릿 변수는 대시보드에 대화형 드롭다운 필터를 추가하여, 사용자가 SQL을 수정하지 않고 데이터를 필터링할 수 있게 합니다.
단일 선택 변수:
-
대시보드 오른쪽 상단의 톱니바퀴 아이콘을 클릭한 다음 설정 > 변수 > 새 변수로 이동합니다.
-
다음 설정을 입력합니다.
- 이름:
service_name- 유형: 쿼리
- 데이터 소스: Doris 데이터 소스를 선택합니다.
- 쿼리:
sql SELECT DISTINCT service_name FROM otel.otel_metrics_gauge WHERE service_name != '' AND service_name IS NOT NULL AND $__timeFilter(timestamp) ORDER BY service_name
- 적용을 클릭합니다.
패널의 SQL에서는 $variable 구문으로 단일 선택 변수를 참조합니다.
AND service_name = '$service_name'
다중 선택 변수:
-
다음 설정으로 새 변수를 만듭니다.
- 이름:
namespace- 유형: 쿼리
- 다중 값: 선택
- 전체 옵션 포함: 선택
- 쿼리:
sql SELECT DISTINCT CAST(resource_attributes['k8s.namespace.name'] AS VARCHAR) AS __text FROM otel.otel_metrics_gauge WHERE metric_name = 'k8s.pod.phase' AND timestamp >= NOW() - INTERVAL 1 HOUR ORDER BY 1
- 적용을 클릭합니다.
참고: 컬럼 별칭 __text는 드롭다운에 표시되는 텍스트를 제어하는 Grafana 규칙입니다.
패널의 SQL에서는 ${variable:sqlstring} 구문을 IN()과 함께 사용하여 다중 선택 변수를 참조합니다.
AND CAST(resource_attributes['k8s.namespace.name'] AS VARCHAR) IN (${namespace:sqlstring})
주의: 다중 선택 변수에서 :sqlstring을 생략하면 SQL 구문 오류가 발생합니다.
연쇄 변수:
한 변수의 선택 가능한 값이 다른 변수에 따라 달라질 수 있습니다. 예를 들어 다음 Pod 변수는 현재 선택된 Namespace에 따라 선택 가능한 값을 필터링합니다.
SELECT DISTINCT CAST(resource_attributes['k8s.pod.name'] AS VARCHAR) AS __text
FROM otel.otel_metrics_gauge
WHERE metric_name = 'k8s.pod.phase'
  AND timestamp >= NOW() - INTERVAL 1 HOUR
  AND CAST(resource_attributes['k8s.namespace.name'] AS VARCHAR) IN (${namespace:sqlstring})
ORDER BY 1
최적화 팁
다음은 미리 구성된 대시보드에서 사용하는 일반적인 최적화 기법입니다.
시간 버킷 간격 조정. 시간 범위에 맞는 버킷 크기를 선택합니다. FLOOR(UNIX_TIMESTAMP(timestamp) / N) * N의 N을 수정합니다.
- 20초: 짧은 시간 범위의 실시간 모니터링에 적합합니다.
- 60초: 시간 단위의 개요를 파악하는 데 적합합니다.
- 300초: 일 단위의 추이를 파악하는 데 적합합니다.
의미 있는 시리즈 이름 설정. CONCAT()으로 여러 필드를 결합합니다.
CONCAT(device, ' read') AS metric
CASE WHEN으로 숫자 값을 읽기 쉬운 텍스트에 매핑합니다.
CASE WHEN value = 2 THEN 'Running'
     WHEN value = 1 THEN 'Pending'
     WHEN value = 3 THEN 'Succeeded'
     WHEN value = 4 THEN 'Failed'
     ELSE 'Unknown'
END AS status
영으로 나누기와 NULL 처리. NULLIF로 영으로 나누는 것을 방지하고, COALESCE로 기본값을 제공합니다.
/ NULLIF(SUM(...), 0)
COALESCE(restarts, 0)
하나의 SQL로 여러 메트릭 쿼리하기. JOIN 대신 CASE WHEN metric_name을 사용합니다.
SELECT timestamp AS time,
  SUM(CASE WHEN metric_name = 'node_memory_MemAvailable_bytes' THEN value END) AS available,
  SUM(CASE WHEN metric_name = 'node_memory_MemTotal_bytes' THEN value END) AS total
FROM otel.otel_metrics_gauge
WHERE metric_name IN ('node_memory_MemTotal_bytes', 'node_memory_MemAvailable_bytes')
GROUP BY timestamp
노이즈 데이터 제외. 가상 네트워크 인터페이스를 제외합니다.
AND CAST(attributes['device'] AS VARCHAR) NOT LIKE 'veth%'
AND CAST(attributes['device'] AS VARCHAR) NOT LIKE 'br-%'
AND CAST(attributes['device'] AS VARCHAR) != 'lo'
실제 파일 시스템만 유지합니다.
AND CAST(attributes['fstype'] AS VARCHAR) IN ('ext4', 'xfs', 'btrfs')
참고 자료
OTel 테이블 스키마
메트릭 테이블(gauge / sum / histogram 공통 필드)
| 필드 | 타입 | 설명 |
|---|---|---|
service_name | varchar(200) | 서비스 이름 |
timestamp | datetime(6) | 데이터 타임스탬프 |
service_instance_id | varchar(200) | 서비스 인스턴스 ID |
metric_name | varchar(200) | 메트릭 이름 |
metric_description | text | 메트릭 설명 |
metric_unit | text | 메트릭 단위 |
attributes | variant (JSON) | 메트릭 차원 |
resource_attributes | variant (JSON) | 리소스 속성 |
scope_name | text | Collector 이름 |
gauge 전용 필드: value (double)
sum 추가 필드: value (double), aggregation_temporality (text), is_monotonic (boolean)
histogram 추가 필드: count (bigint), sum (double), bucket_counts (array<bigint>), explicit_bounds (array<double>), min (double), max (double)
로그 테이블
| 필드 | 타입 | 설명 |
|---|---|---|
timestamp | datetime(6) | 로그 타임스탬프 |
service_name | varchar(200) | 서비스 이름 |
service_instance_id | varchar(200) | 서비스 인스턴스 ID |
trace_id | varchar(200) | 연결된 트레이스 ID |
span_id | text | 연결된 스팬 ID |
severity_number | int | 심각도 번호 |
severity_text | text | 심각도 텍스트(INFO / WARN / ERROR) |
body | text | 로그 본문 |
resource_attributes | variant (JSON) | 리소스 속성 |
log_attributes | variant (JSON) | 로그 속성 |
트레이스 테이블
| 필드 | 타입 | 설명 |
|---|---|---|
timestamp | datetime(6) | 스팬 시작 시간 |
service_name | varchar(200) | 서비스 이름 |
trace_id | varchar(200) | 트레이스 ID |
span_id | text | 스팬 ID |
parent_span_id | text | 부모 스팬 ID |
span_name | text | 스팬 이름 |
span_kind | text | 스팬 종류(CLIENT / SERVER / INTERNAL) |
end_time | datetime(6) | 스팬 종료 시간 |
duration | bigint | 소요 시간(나노초) |
span_attributes | variant (JSON) | 스팬 속성 |
events | array | 스팬 이벤트 |
links | array | 스팬 링크 |
status_code | text | 상태 코드(OK / ERROR / UNSET) |
status_message | text | 상태 메시지 |
resource_attributes | variant (JSON) | 리소스 속성 |
구문 요약
| 용도 | 구문 |
|---|---|
| 시간 필터(매크로) | $__timeFilter(timestamp) |
| 시간 필터(수동) | timestamp >= FROM_UNIXTIME($__from/1000) |
| 시간 버킷(20초) | FLOOR(UNIX_TIMESTAMP(timestamp) / 20) * 20 AS time |
| 시간 버킷(1분) | UNIX_TIMESTAMP(DATE_FORMAT(timestamp, '%Y-%m-%d %H:%i:00')) * 1000 AS time |
| 속성 접근 | attributes['key'] |
| 속성 CAST | CAST(attributes['key'] AS VARCHAR) |
| 단일 선택 변수 | service_name = '$service_name' |
| 다중 선택 변수 | IN (${namespace:sqlstring}) |
| 영으로 나누기 방지 | / NULLIF(..., 0) |
| 기본값 | COALESCE(..., 0) |
| 시리즈 이름 지정 | CONCAT(device, ' read') AS metric |
| 상태 매핑 | CASE WHEN value = 2 THEN 'Running' ... END |
| URL에서 쿼리 문자열 제거 | SUBSTRING_INDEX(url, '?', 1) |
| 가상 네트워크 카드 제외 | NOT LIKE 'veth%' + NOT LIKE 'br-%' + != 'lo' |