Pipeline 실행 엔진
한 문장 정의
Pipeline 실행 엔진은 Doris 3.0부터 volcano 모델을 대체한 병렬 실행 모델입니다. Hyper 논문에 설명된 Pipeline 구현을 참고하여 쿼리를 병렬로 실행할 수 있는 Pipeline과 PipelineTask로 분할합니다. 이를 통해 멀티코어 CPU의 성능을 최대한 활용하고 쿼리 스레드 수를 제한하여 스레드 수 폭증 문제를 해결합니다.
개요 체크리스트
이 문서를 읽기 전에 다음 사항을 알아두세요.
- Pipeline 실행 엔진은 Doris 3.0부터 기존 volcano 모델을 완전히 대체했습니다.
- Doris는 Pipeline 모델을 기반으로 쿼리, DDL, DML 문을 병렬로 처리합니다.
- 상세 설계, 구현 및 효과는 다음 두 DSIP를 참고하세요.
물리 실행 계획
Pipeline 실행 모델을 이해하려면 먼저 물리 쿼리 계획의 두 가지 핵심 개념인 PlanFragment와 PlanNode를 이해해야 합니다. 다음 SQL을 예로 들어 설명합니다.
SELECT k1, SUM(v1) FROM A,B WHERE A.k2 = B.k2 GROUP BY k1 ORDER BY SUM(v1);
논리 실행 계획
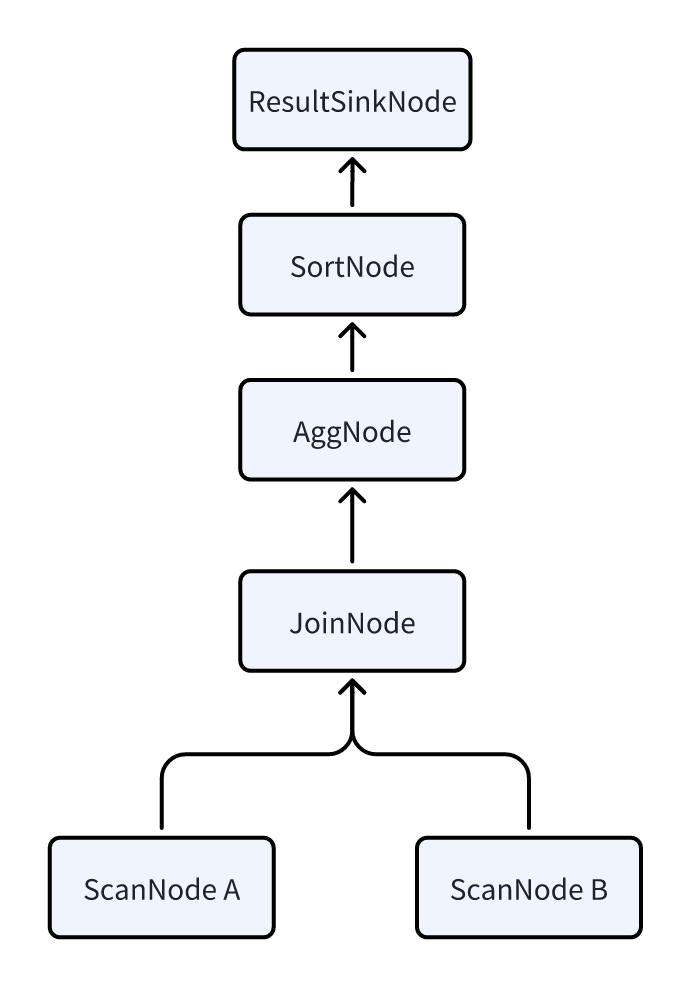
FE는 먼저 이 SQL을 다음 논리 실행 계획으로 변환합니다. 계획의 각 노드는 PlanNode입니다. 각 Node 유형의 의미는 물리 실행 계획 조회에 관한 소개를 참고하세요.
물리 실행 계획
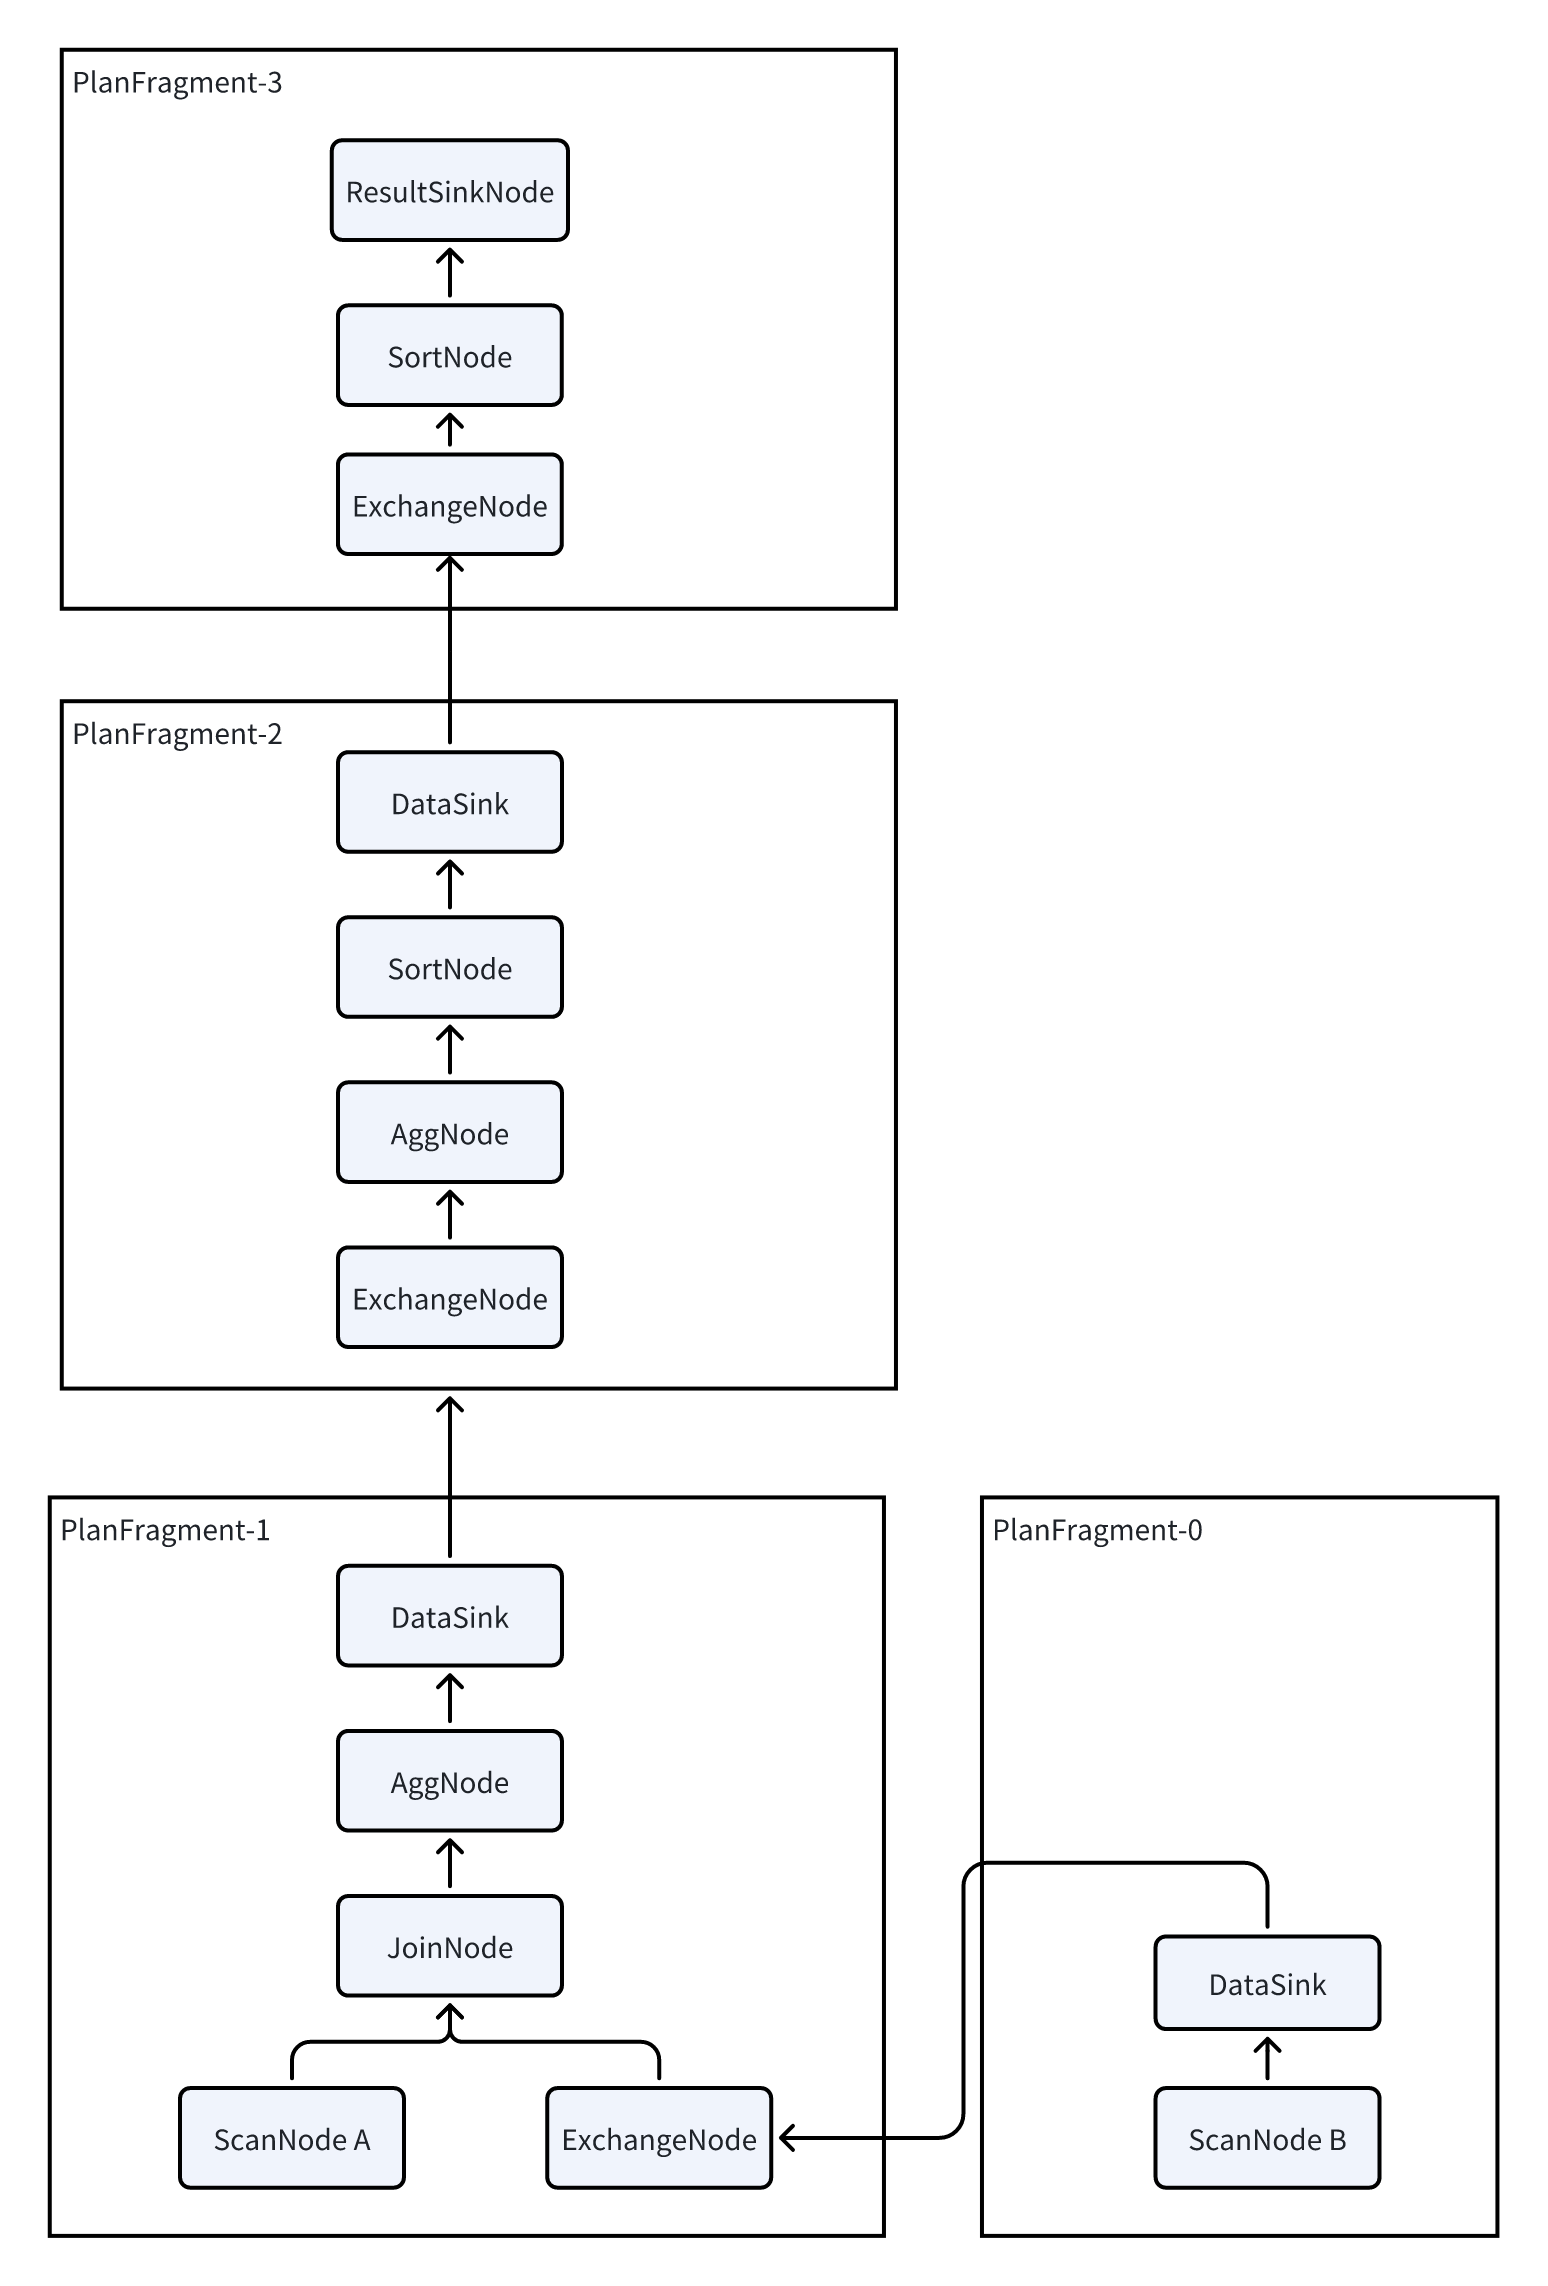
Doris는 MPP 아키텍처를 사용하므로 각 쿼리는 쿼리 지연 시간을 줄이기 위해 모든 BE가 병렬 실행에 참여하도록 합니다. 따라서 논리 실행 계획을 물리 실행 계획으로 분할해야 합니다.
- 논리 실행 계획에
DataSink와ExchangeNode를 삽입합니다. 이 두 Node가 여러 BE 사이의 데이터 Shuffle을 수행합니다. - 분할된 각 PlanFragment는 PlanNode의 일부를 포함하며, 독립적인 작업으로 BE에 전송될 수 있습니다.
- BE는 PlanFragment 내부의 PlanNode 계산을 마친 후
DataSink와ExchangeNode를 통해 데이터를 다른 BE로 Shuffle하여 계산을 이어갑니다.
세 계층 계획 구조
Doris의 계획 수립 구조는 다음 3개 계층으로 나뉩니다.
| 계층 | 이름 | 설명 |
|---|---|---|
| 1 | PLAN (실행 계획) | 실행 계획기가 SQL 문을 실행 계획으로 변환하고, 실행 엔진이 이 계획을 실행합니다. |
| 2 | FRAGMENT (실행 조각) | Doris는 분산 실행 엔진입니다. 전체 실행 계획은 단일 머신에서 실행되는 여러 실행 조각으로 분할됩니다. FRAGMENT는 단일 머신에서 실행되는 하나의 완전한 실행 조각을 나타내며, 여러 FRAGMENT가 모여 하나의 완전한 PLAN을 구성합니다. |
| 3 | PLAN NODE (연산자) | 실행 계획의 최소 단위입니다. FRAGMENT는 여러 연산자로 구성되며, 각 연산자는 집계나 조인과 같은 특정 실행 로직을 담당합니다. |
Pipeline 실행 모델
PlanFragment는 FE가 BE로 전송하는 실행 작업의 최소 단위입니다. BE는 동일한 쿼리에 속하는 서로 다른 PlanFragment를 여러 개 받을 수 있으며, 각 PlanFragment는 독립적으로 처리됩니다.
BE는 PlanFragment를 받은 후 다음과 같이 처리합니다.
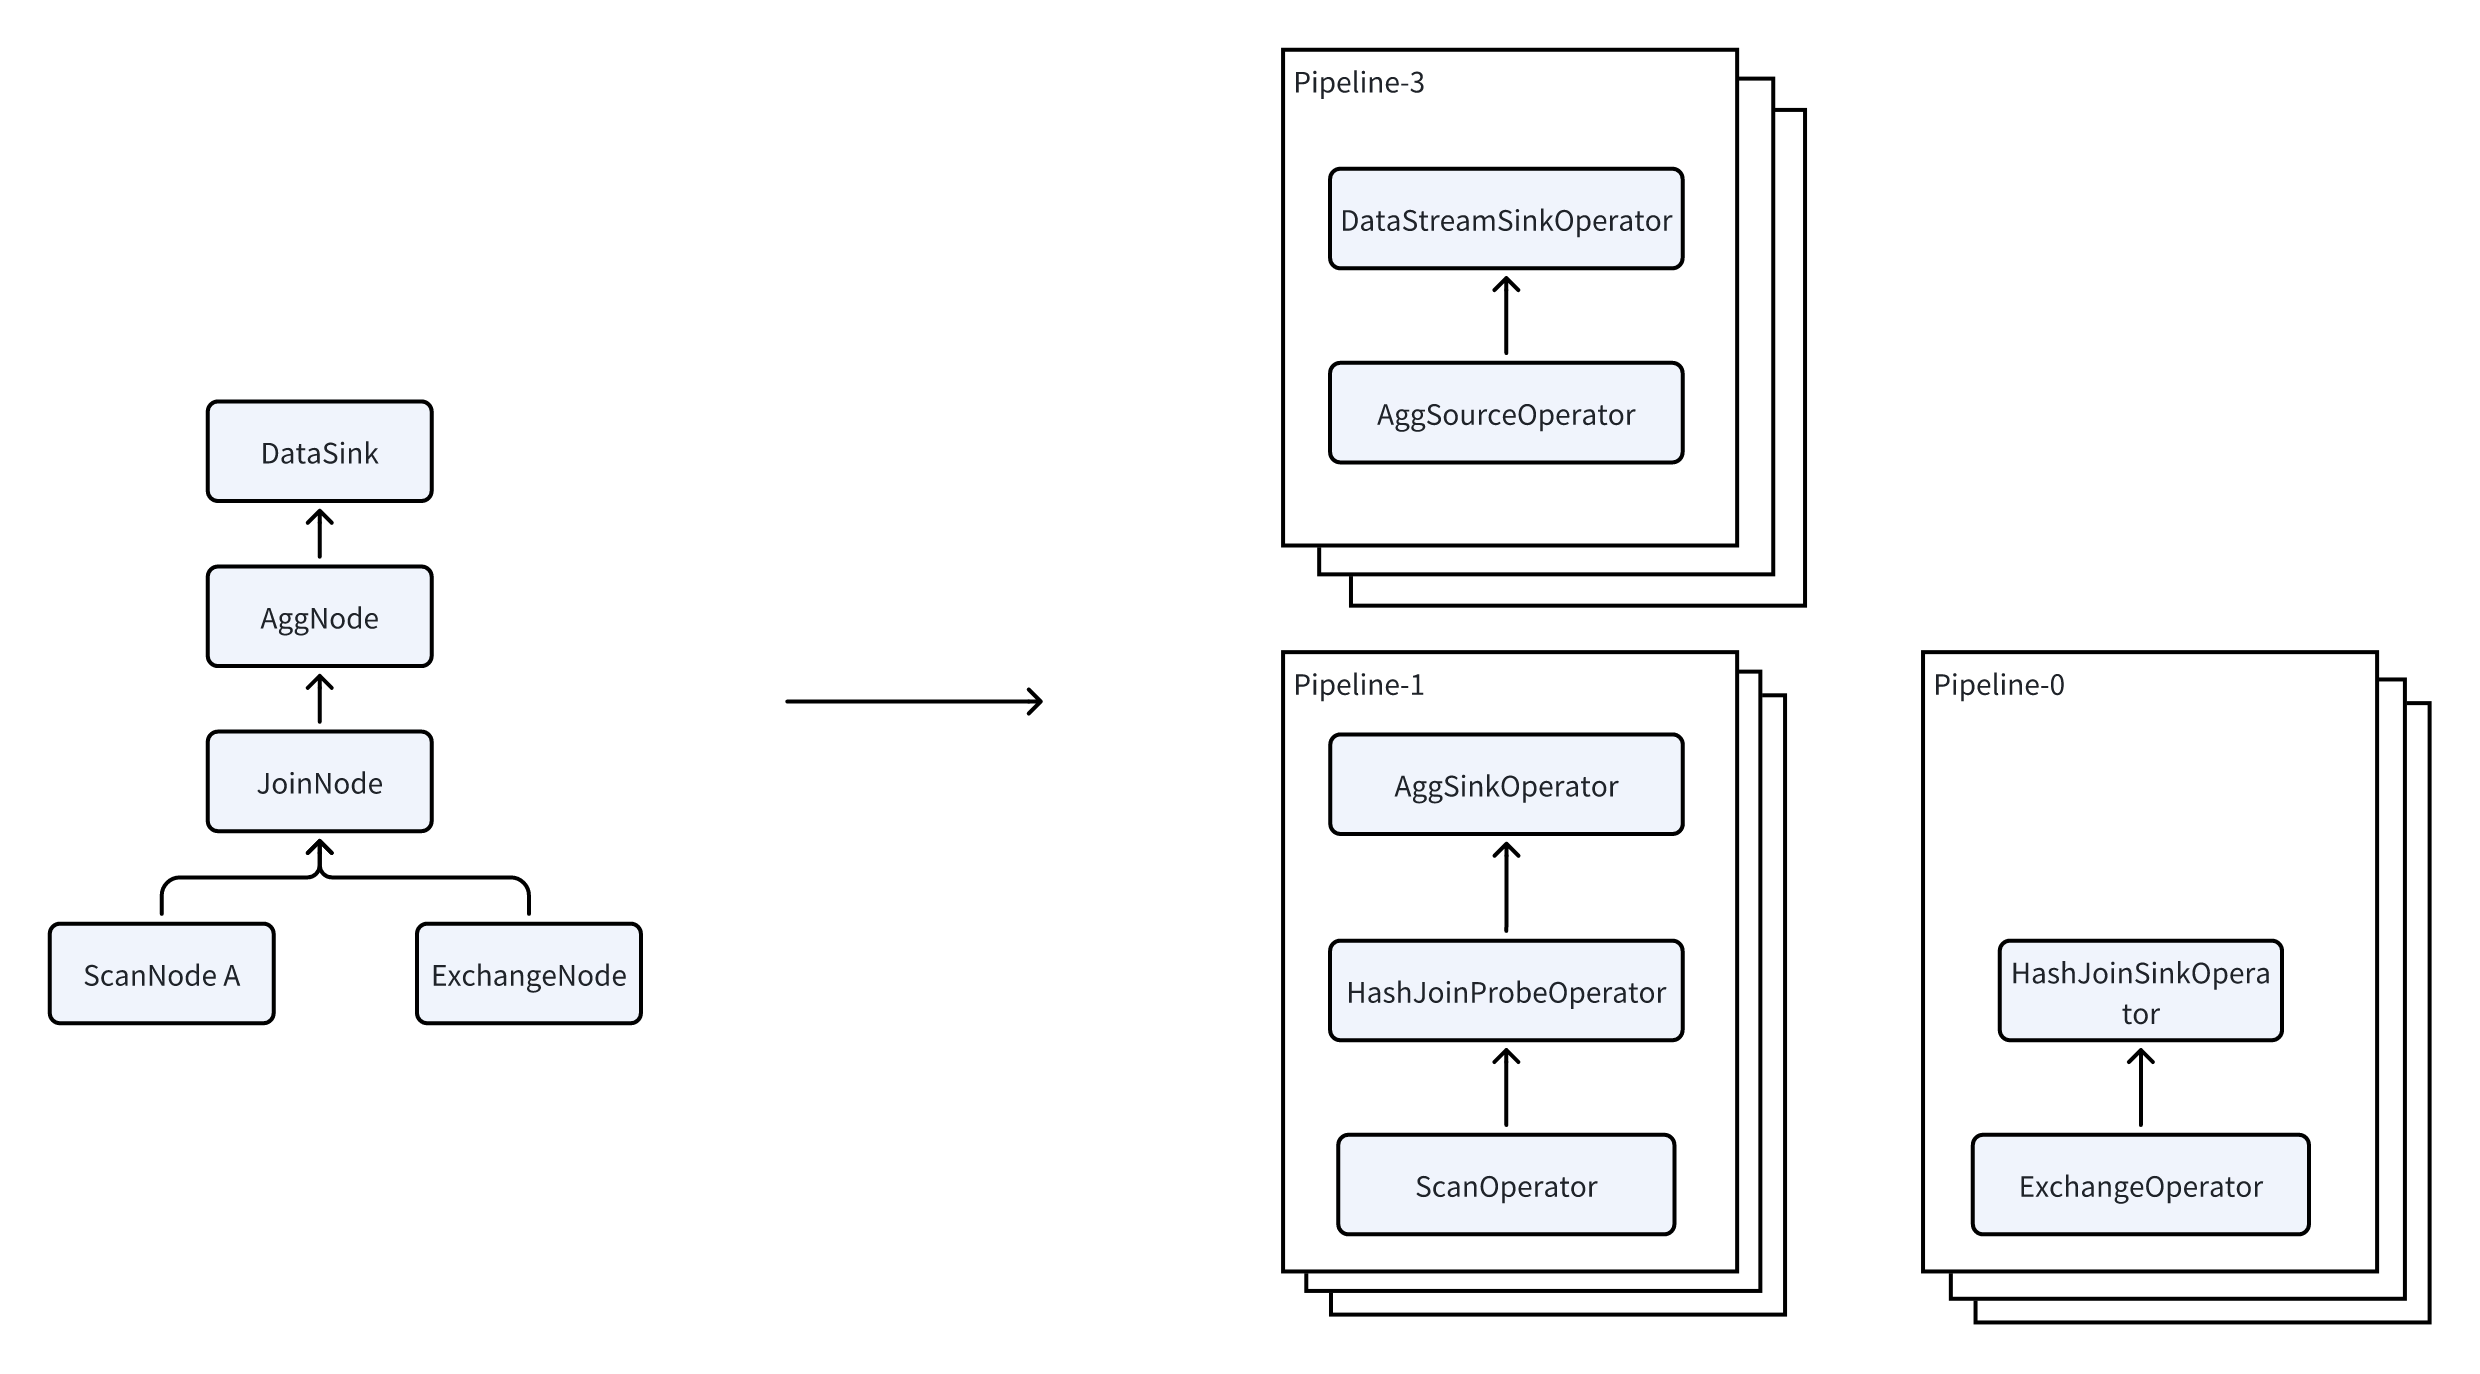
- PlanFragment를 여러 Pipeline으로 분할합니다.
- 여러 PipelineTask를 시작하여 병렬 실행을 수행합니다.
- 쿼리 효율을 높입니다.
Pipeline
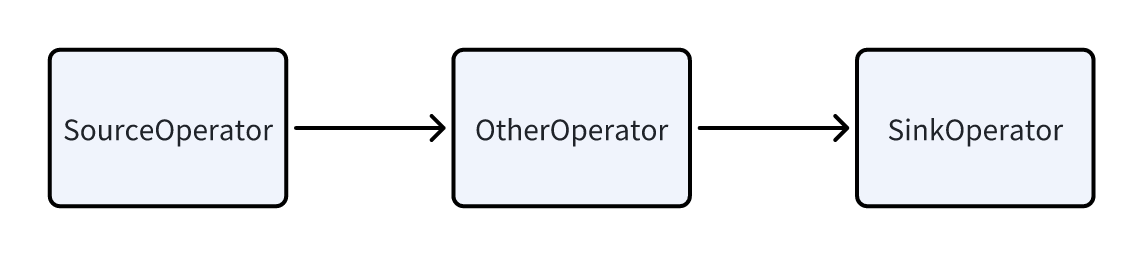
Pipeline은 다음 요소로 구성됩니다.
- SourceOperator 하나: 외부에서 데이터를 읽는 역할을 합니다. 테이블(OlapTable)이나 Buffer(Exchange)가 될 수 있습니다.
- 중간에 위치하는 여러 Operator.
- SinkOperator 하나: 데이터를 출력하는 역할을 합니다. 네트워크를 통해 다른 노드로 데이터를 Shuffle하거나(예:
DataStreamSinkOperator), HashTable로 출력할 수 있습니다(예: Agg Operator의JoinBuildHashTable).
Pipeline 간 의존 관계(Dependency)
여러 Pipeline은 서로 의존 관계를 가집니다. JoinNode를 예로 들면, 실제로 다음 2개의 Pipeline으로 분할됩니다.
- Pipeline-0: Exchange에서 데이터를 읽어 HashTable을 구성합니다.
- Pipeline-1: 테이블에서 데이터를 읽어 Probe를 수행합니다.
이 두 Pipeline의 관계는 다음과 같습니다.
- Pipeline-1은 Pipeline-0의 실행이 완료되어야 실행할 수 있습니다.
- 이러한 의존 관계를 Dependency라고 합니다.
- Pipeline-0은 실행을 마치면 Dependency의
set_ready메서드를 호출하여 Pipeline-1에 실행할 수 있음을 알립니다.
PipelineTask
Pipeline은 아직 실행 가능한 실체가 아닌 논리적 개념입니다. 실제로 실행하려면 Pipeline을 여러 PipelineTask로 인스턴스화해야 합니다.
- 읽을 데이터를 서로 다른 PipelineTask에 할당하여 최종적으로 병렬 처리를 가능하게 합니다.
- 동일한 Pipeline의 여러 PipelineTask는 완전히 동일한 Operator로 구성됩니다. 차이는 Operator의 상태에 있습니다. 예를 들어 읽는 데이터나 구성하는 HashTable이 서로 다릅니다. 이러한 서로 다른 상태를 LocalState라고 합니다.
- 각 PipelineTask는 최종적으로 스레드 풀에 제출되어 독립적인 작업으로 실행됩니다.
이러한 Dependency 기반 메커니즘을 통해 멀티코어 CPU를 더욱 효과적으로 활용하여 병렬성을 최대한 확보할 수 있습니다.
Operator
대부분의 경우 Pipeline의 각 Operator는 하나의 PlanNode에 대응하지만, 일부 특수한 연산자는 예외입니다.
| 원래 PlanNode | 분할 후 Operator |
|---|---|
| JoinNode | JoinBuildOperator + JoinProbeOperator |
| AggNode | AggSinkOperator + AggSourceOperator |
| SortNode | SortSinkOperator + SortSourceOperator |
분할 원칙: 일부 breaking Operator(계산을 수행하기 전에 모든 데이터를 수집해야 하는 연산자)는 데이터를 받아들이는 부분을 Sink로 분리하고, 이 연산자에서 데이터를 가져오는 부분을 Source라고 합니다.
스캔 병렬화
데이터 스캔은 IO 부하가 매우 큰 작업입니다. 로컬 디스크에서 대량의 데이터를 읽어야 합니다. 데이터 레이크 시나리오에서는 지연 시간이 더 긴 HDFS나 S3에서 데이터를 읽어야 합니다. Doris는 스캔 효율을 높이기 위해 ScanOperator에 병렬 스캔 기법을 도입했습니다.
- ScanOperator는 여러 Scanner를 동적으로 생성합니다.
- 각 Scanner는 약 1백만~2백만 행의 데이터를 스캔합니다.
- 각 Scanner는 데이터를 스캔하면서 해당 데이터의 압축 해제, 필터링 및 기타 계산 작업을 수행합니다.
- Scanner는 ScanOperator가 읽을 수 있도록 데이터를 DataQueue로 보냅니다.
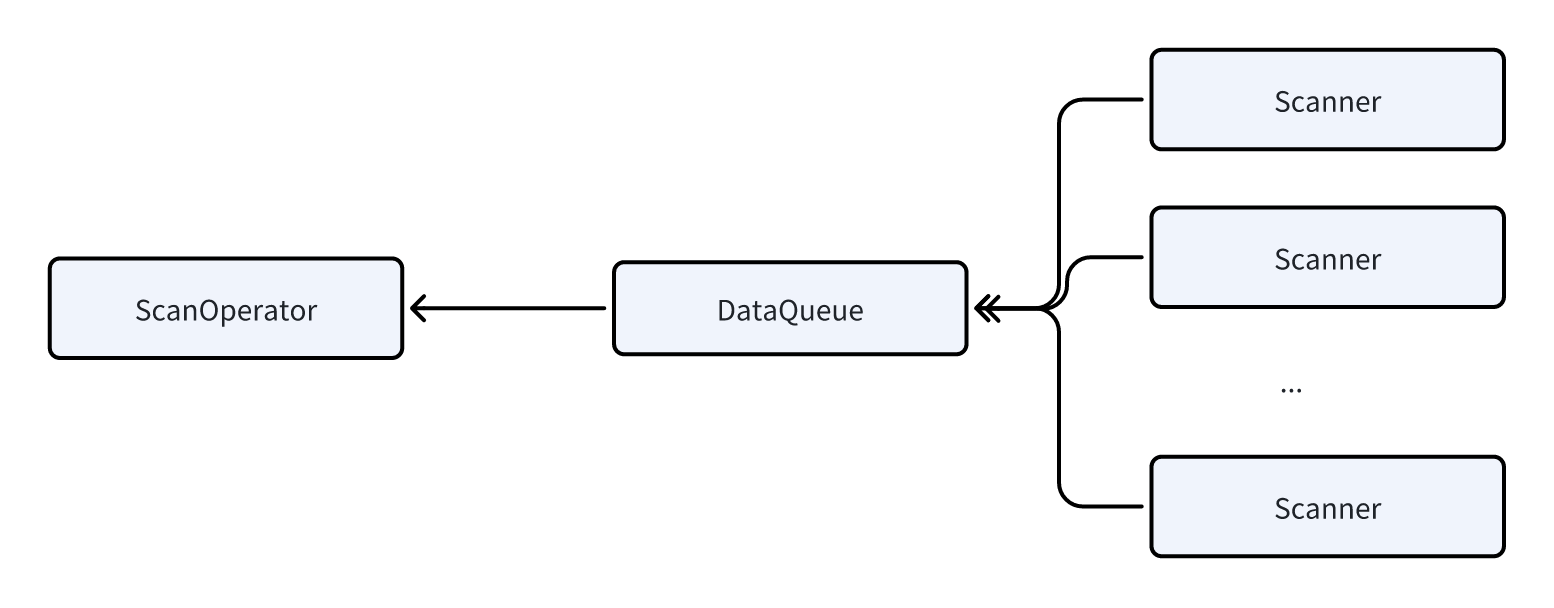
효과: 병렬 스캔은 부적절한 버킷 구성이나 데이터 편향으로 인해 일부 ScanOperator의 실행 시간이 지나치게 길어져 전체 쿼리 지연 시간이 늘어나는 문제를 효과적으로 방지합니다.
Local Shuffle
Pipeline 실행 모델에서 Local Exchange는 Pipeline Breaker 역할을 합니다. 이는 로컬에서 각 실행 작업으로 데이터를 재분배하는 기법입니다.
다음과 같은 역할을 합니다.
- 특정 방식(HASH 또는 Round Robin)을 사용하여 상위 Pipeline이 출력한 모든 데이터를 하위 Pipeline의 모든 Task에 균등하게 분배합니다.
- 실행 중 발생하는 데이터 편향 문제를 해결합니다.
- 실행 모델이 데이터 저장 방식과 실행 계획의 제약에서 벗어나도록 합니다.
동작 예시
앞선 예시의 Pipeline-1을 사용하여 Local Exchange가 데이터 편향을 어떻게 방지하는지 설명합니다.
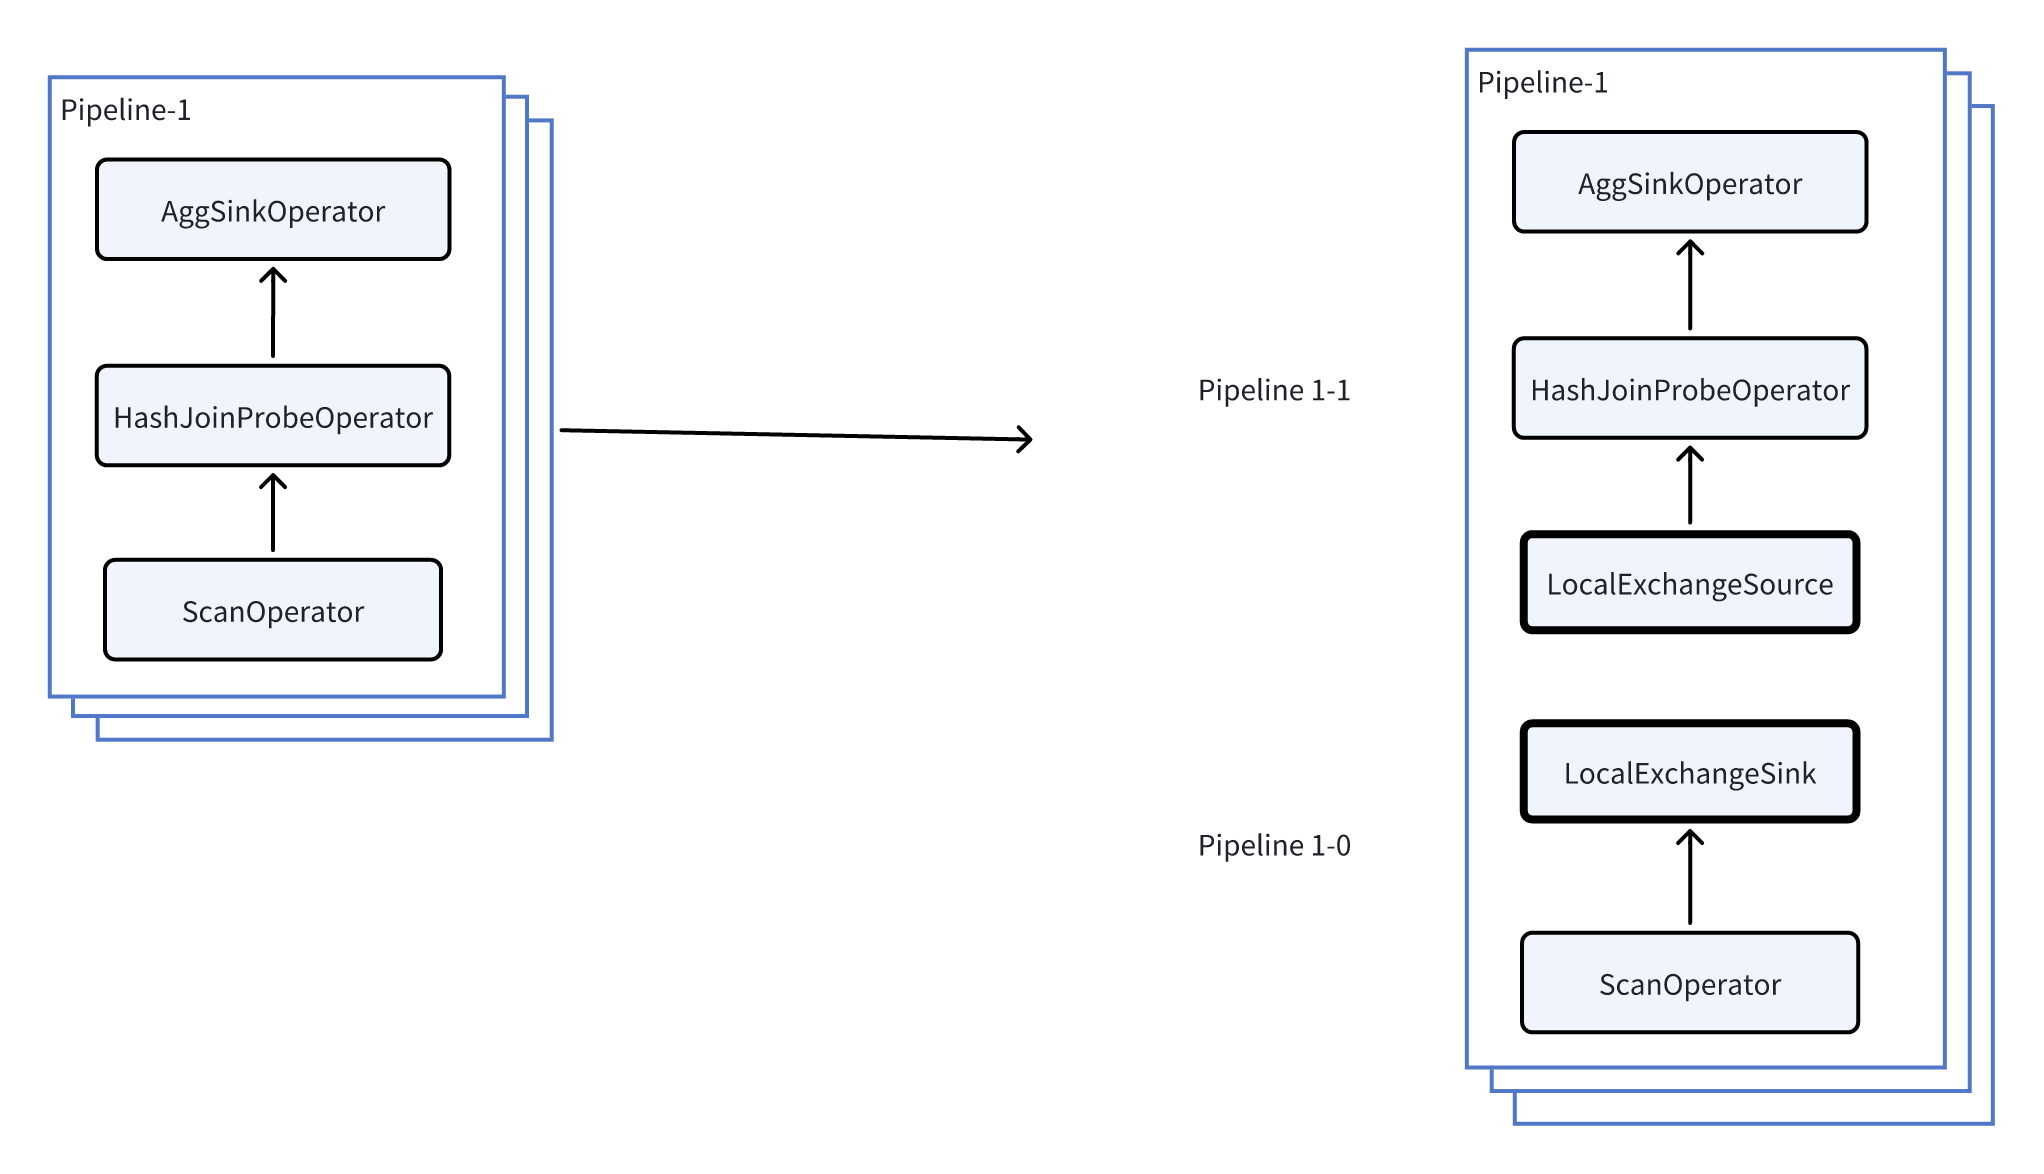
위 그림처럼 Pipeline 1에 Local Exchange를 삽입하면 Pipeline 1이 다음과 같이 추가로 분할됩니다.
- Pipeline 1-0
- Pipeline 1-1
현재 동시 실행 수가 3이고(각 Pipeline에 Task가 3개), 각 Task가 스토리지 계층에서 버킷 하나를 읽으며, 버킷 3개의 행 수가 각각 1, 1, 7이라고 가정해 보겠습니다. Local Exchange를 삽입하기 전과 후의 실행 변화는 다음과 같습니다.
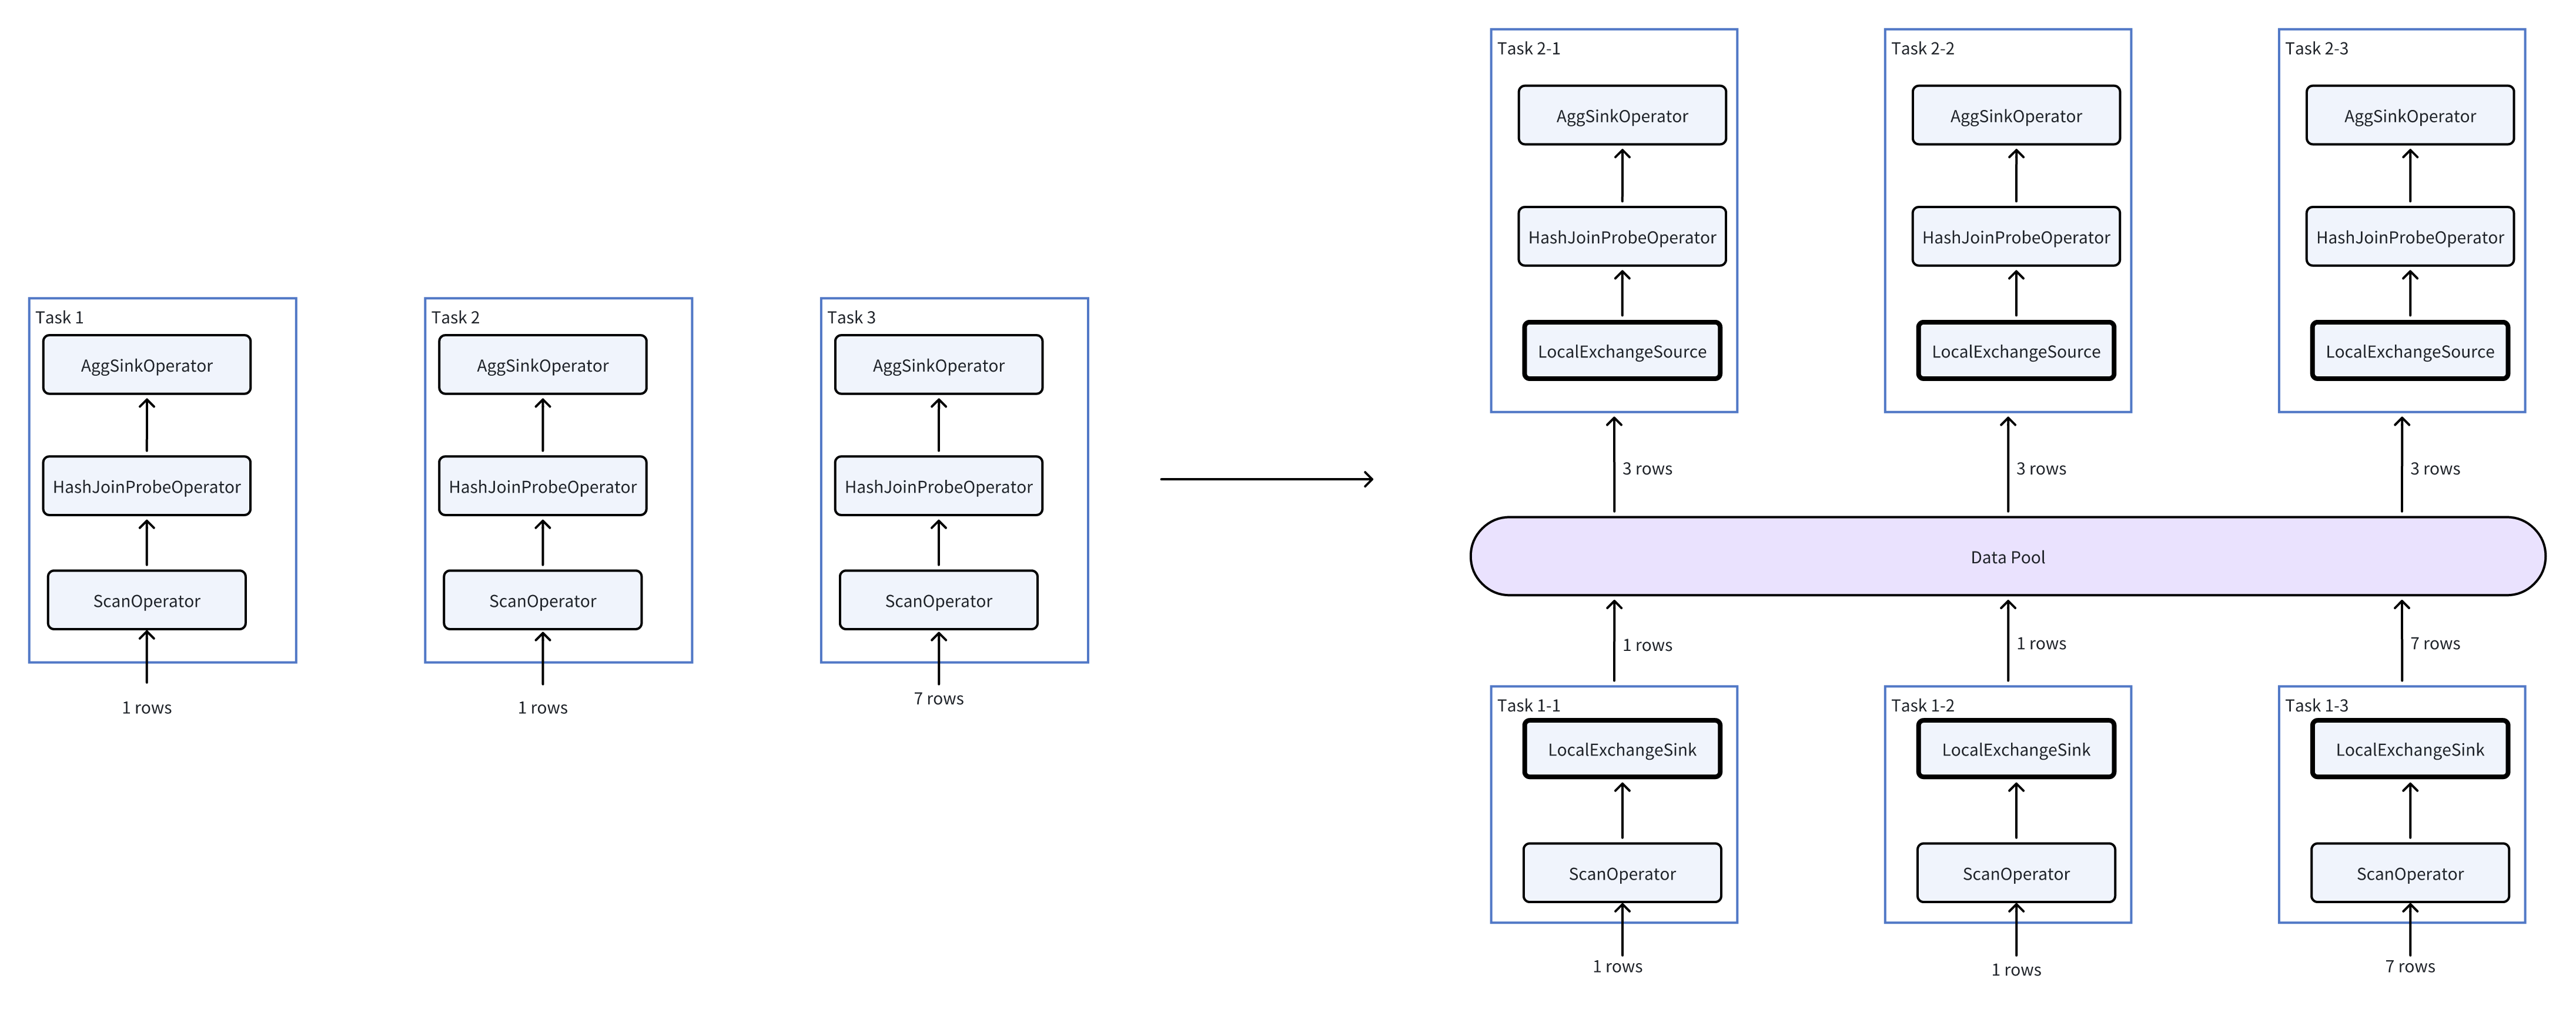
그림의 오른쪽에서 볼 수 있듯이 HashJoin과 Agg 연산자가 처리해야 하는 데이터양이 (1, 1, 7)에서 (3, 3, 3)으로 바뀌어 데이터 편향을 방지합니다.
계획 수립 규칙
Doris는 일련의 규칙에 따라 실행 계획에 Local Exchange를 포함할지 결정합니다. 예를 들어 쿼리에 Join, 집계, 윈도우 함수처럼 시간이 오래 걸리는 연산자가 포함된 경우, Local Exchange를 사용하여 데이터 편향을 최대한 방지합니다.