Runtime Filter의 작동 원리와 튜닝
Runtime Filter는 쿼리 실행 중 Doris가 런타임 데이터를 바탕으로 동적으로 생성하는 필터 조건으로, 스캔하는 데이터의 양과 네트워크 전송량을 줄이는 데 사용됩니다. Doris는 Join Runtime Filter(JRF)와 TopN Runtime Filter라는 두 가지 유형의 Runtime Filter를 지원합니다.
읽기 전 확인 사항
- Doris의 Join 실행 흐름과 Scan 노드를 이해하고 있는지 확인합니다.
- Hash Join과 Shuffle Join의 실행 방식을 구분할 수 있는지 확인합니다.
EXPLAIN,EXPLAIN SHAPE PLAN, Profile을 확인하는 방법을 알고 있는지 확인합니다.- 대상 시나리오가 Join 필터링과 TopN 조기 가지치기 중 어디에 해당하는지 알고 있는지 확인합니다.
Join Runtime Filter
Join Runtime Filter(이하 JRF)는 런타임 최적화 기법입니다. Doris는 Join 노드에서 오른쪽 테이블의 데이터를 바탕으로 필터를 동적으로 생성하고 이를 왼쪽 테이블의 Scan으로 푸시다운하여 Probe 크기, IO, 네트워크 전송량을 줄입니다.
작동 원리
다음은 TPC-H와 유사한 스키마의 Join을 통해 JRF의 작동 방식을 설명합니다.
데이터베이스에 다음 두 테이블이 있다고 가정합니다.
- 주문 테이블(orders): 행 수는 100백만 개이며, 주문 번호
o_orderkey, 고객 IDo_custkey등을 포함합니다. - 고객 테이블(customer): 행 수는 100,000개이며, 고객 ID
c_custkey, 고객 국적c_nation등을 포함합니다. 국가는 총 25개이며, 국가별 고객 수는 약 4,000명입니다.
중국 고객의 주문 수를 계산합니다.
select count(*)
from orders join customer on o_custkey = c_custkey
where c_nation = "china"
실행 계획은 기본적으로 Join입니다.
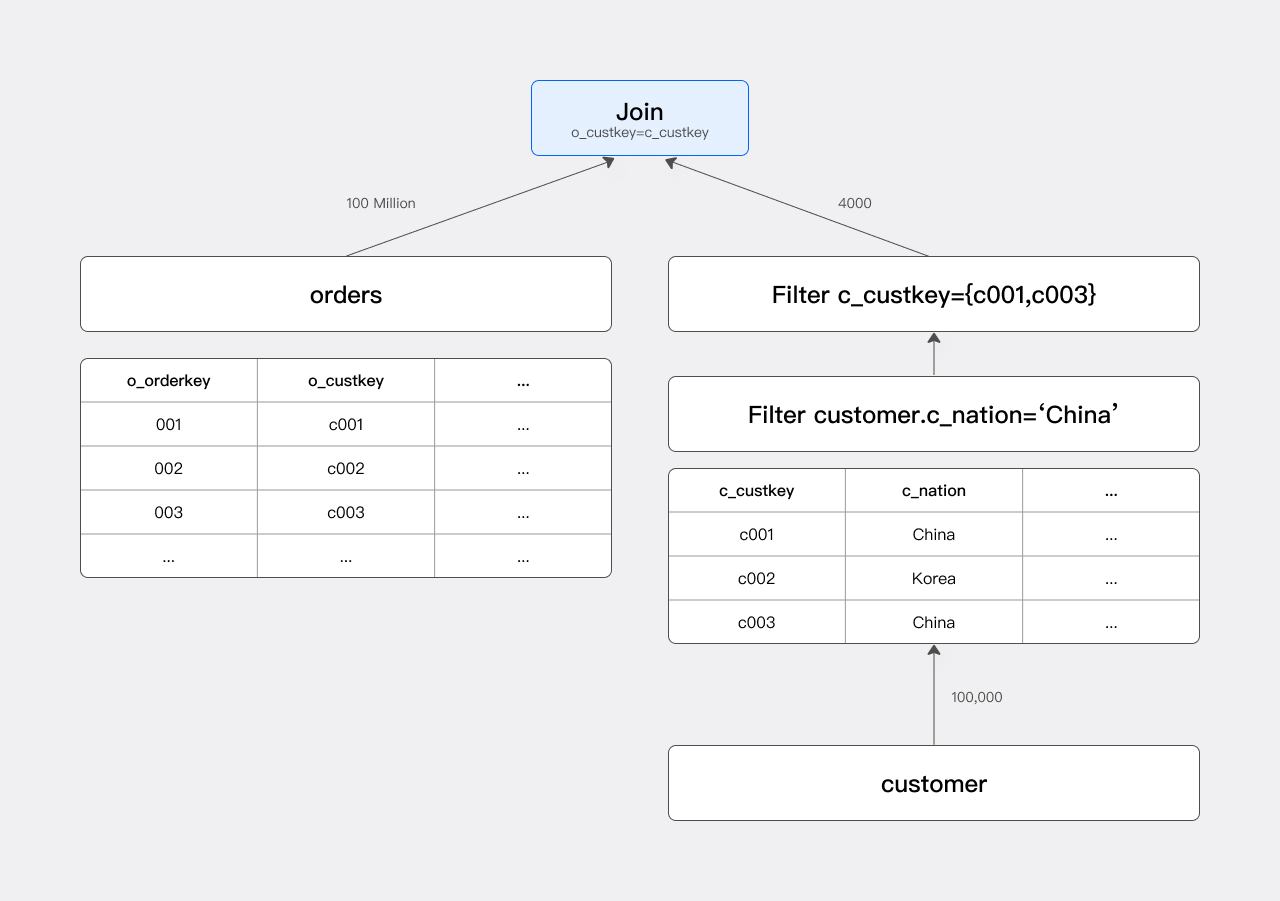
JRF가 없으면 Scan 노드는 orders 테이블의 100백만 개 행을 모두 스캔하고, Join 노드는 이 행들에 대해 Hash Probe를 수행하여 결과를 생성합니다.
1. 최적화 아이디어
필터 조건 c_nation = "china"는 중국 국적이 아닌 고객을 모두 걸러내므로, Join에 참여하는 고객은 customer 테이블의 일부(약 1/25)뿐입니다. Join 조건은 o_custkey = c_custkey이므로 필터를 통과한 c_custkey 값의 집합만 고려하면 됩니다. 이 집합을 집합 A라고 하겠습니다.
집합 A는 구체적으로 Join에 참여하는
c_custkey값의 집합을 가리킵니다.
집합 A를 IN 조건으로 orders 테이블에 푸시다운하면 Scan 노드에서 주문을 미리 필터링할 수 있습니다. 이는 c_custkey in (c001, c003)을 추가하는 것과 같습니다.
select count(*)
from orders join customer on o_custkey = c_custkey
where c_nation = "china" and o_custkey in (c001, c003)
최적화된 실행 계획은 다음과 같습니다.
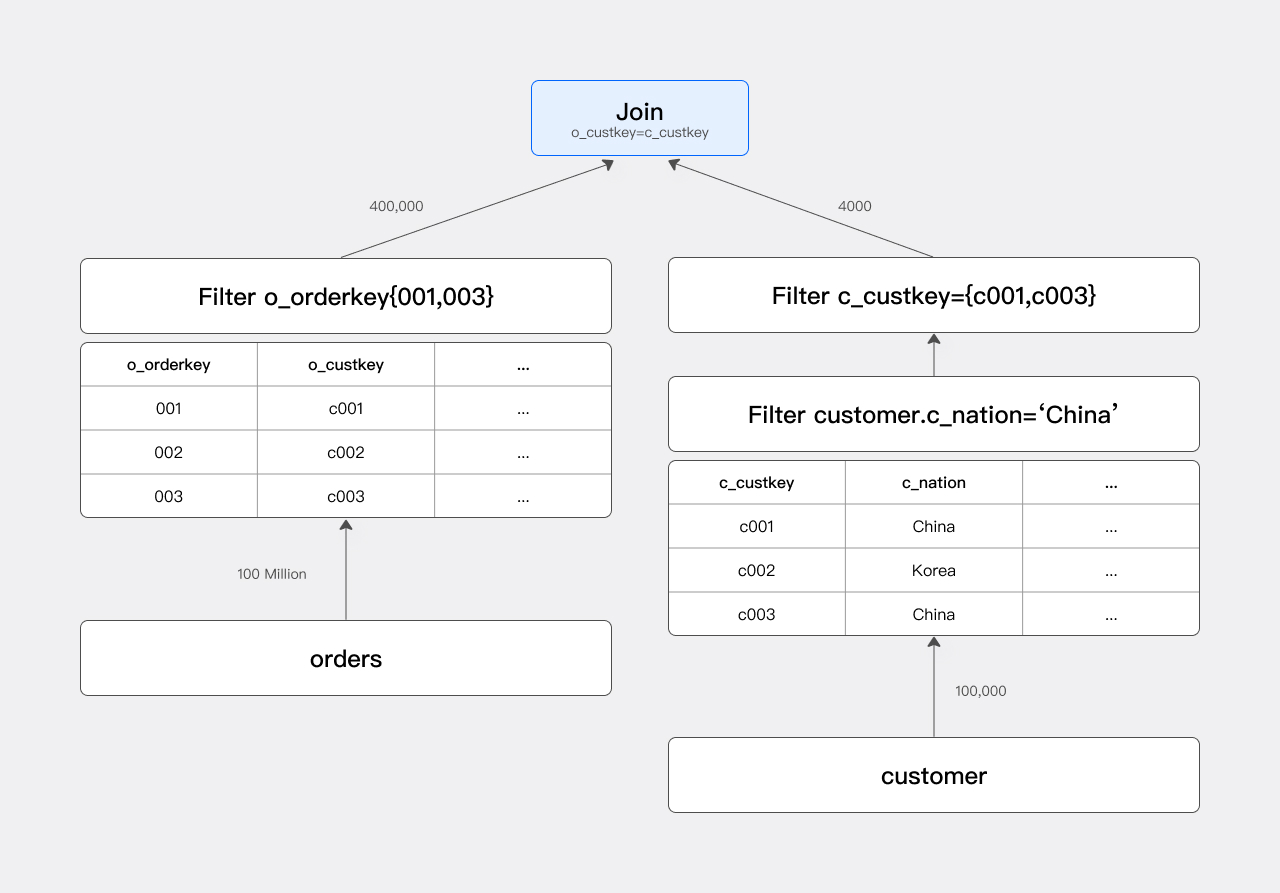
Join에 참여하는 orders 행 수가 100백만 개에서 400,000개로 줄어들어 쿼리 속도가 크게 향상됩니다.
2. 구현 방식
옵티마이저는 정적 분석 단계에서 집합 A의 내용을 알 수 없습니다. 따라서 Doris는 Join 노드에서 오른쪽 데이터를 수집한 후 런타임에 집합 A를 생성하여 orders 테이블의 Scan 노드로 푸시다운합니다. 이 JRF는 일반적으로 RF(c_custkey -> [o_custkey])로 표기합니다.
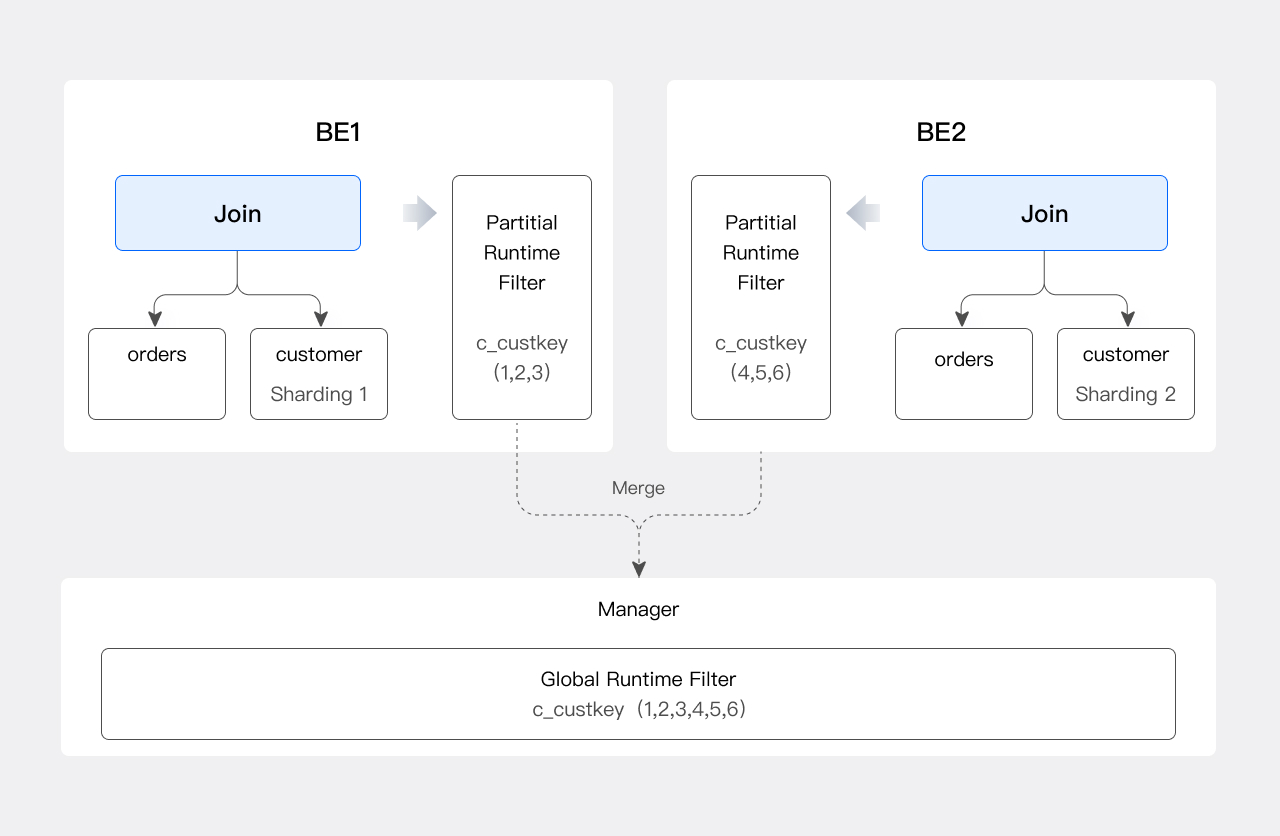
Doris는 분산 데이터베이스이므로 JRF에도 병합 단계가 필요합니다.
| 단계 | 역할 | 동작 |
|---|---|---|
| 1 | 각 Join Instance | 로컬 샤드의 c_custkey를 바탕으로 Partial JRF 생성 |
| 2 | Runtime Filter Manager(선택된 노드) | 모든 Partial JRF 수집 |
| 3 | Manager | 수집한 필터를 Global JRF로 병합 |
| 4 | Manager | Global JRF를 orders의 Scan Instance에 배포 |
Global JRF를 생성하는 흐름은 다음과 같습니다.
필터 유형
JRF에는 여러 구현 방식이 있으며, 생성, 병합, 전송, 적용 비용이 각각 다릅니다.
| 유형 | 적용 시나리오 | 필터 정밀도 | 비용 |
|---|---|---|---|
| In Filter | 집합 A의 원소 수가 적은 동등 Join | 정확함 | 원소가 많으면 중복 제거, 전송, Probe 비용이 높음 |
| Bloom Filter | 집합 A의 원소 수가 많은 동등 Join | 근사적(해시 충돌 존재) | 중간 수준이며 버킷 수의 영향을 받음 |
| Min-Max Filter | 정렬된 데이터 또는 비동등 Join | 근사적 | 가장 낮음 |
1. In Filter
가장 단순한 JRF 구현 방식입니다. 앞의 예에서 실행 엔진은 왼쪽 테이블에 o_custkey in (...list of elements in A...) 조건자를 생성하여 필터링합니다. 집합 A가 작을 때 효율적입니다.
집합 A가 크면 In Filter에 다음과 같은 성능 문제가 발생합니다.
- 높은 생성 비용: 병합할 때 각 샤드에서 수집한
c_custkey값의 중복을 제거해야 합니다.c_custkey가 기본 키가 아니면 중복 값이 많아지므로 시간이 오래 걸립니다. - 높은 전송 비용: Join 노드와 Scan 노드 사이에서 많은 원소를 전송하는 데 비용이 많이 듭니다.
- 높은 실행 비용: Scan 노드에서 IN 조건자를 실행하는 작업 자체에도 시간이 오래 걸립니다.
이를 해결하기 위해 Doris는 Bloom Filter를 도입했습니다.
2. Bloom Filter
Bloom Filter는 여러 해시 테이블을 겹쳐 놓은 구조로 이해할 수 있습니다. 다음 성질을 이용하여 필터링합니다.
- 집합 A로부터 해시 테이블 T를 생성합니다. 어떤 원소가 T에 없으면, A에도 반드시 없습니다. 그 역은 성립하지 않습니다.
- 따라서 Bloom Filter가 걸러낸
o_orderkey에는 Join의 오른쪽에 같은 값의c_custkey가 반드시 없습니다. 다만 해시 충돌로 인해 일치하지 않는 일부o_custkey값도 필터를 통과할 수 있습니다. - 해시 버킷 수가 필터의 정확도를 결정합니다. 버킷이 많을수록 정확도가 높아지지만 생성, 전송, 계산 비용도 증가합니다.
Bloom Filter 크기는 필터링 효과와 비용 사이에서 균형을 맞춰야 합니다. 다음 매개변수로 최솟값과 최댓값을 제한할 수 있습니다.
| 매개변수 | 설명 |
|---|---|
RUNTIME_BLOOM_FILTER_MIN_SIZE | Bloom Filter의 최소 바이트 수 |
RUNTIME_BLOOM_FILTER_MAX_SIZE | Bloom Filter의 최대 바이트 수 |
3. Min/Max Filter
Min-Max Filter도 근사 필터링에 사용됩니다. 데이터 열이 정렬되어 있을 때 효과적이며, 생성, 병합, 적용 비용이 In Filter나 Bloom Filter보다 훨씬 낮습니다.
비동등 Join에서는 In Filter와 Bloom Filter를 사용할 수 없지만 Min-Max Filter는 여전히 효과적입니다.
select count(*)
from orders join customer on o_custkey > c_custkey
where c_name = "China"
필터링 후 c_custkey의 최댓값을 찾아 n으로 두고 orders의 Scan 노드에 전달할 수 있습니다. Scan 노드는 o_custkey > n인 행만 출력합니다.
Join Runtime Filter 확인
다음 세 가지 방법으로 JRF를 확인할 수 있습니다.
| 방법 | 명령 | 설명 |
|---|---|---|
| 텍스트 실행 계획 | EXPLAIN | Join 측의 생성 정보와 Scan 측의 적용 정보 확인 |
| Shape 실행 계획 | EXPLAIN SHAPE PLAN | Nereids Planner가 계획한 RF 확인 |
| 실제 실행 Profile | SET enable_profile=true 실행 후 쿼리 실행 | 실제 필터링된 행 수와 상태 확인 |
다음 예는 TPC-H 스키마를 기반으로 합니다.
select count(*) from orders join customer on o_custkey=c_custkey;
1. EXPLAIN
JRF 정보는 Join 노드와 Scan 노드에 나뉘어 표시됩니다.
4: VHASH JOIN(258)
| join op: INNER JOIN(PARTITIONED)[]
|  equal join conjunct: (o_custkey[#10] = c_custkey[#0])
|  runtime filters: RF000[bloom] <- c_custkey[#0] (150000000/134217728/16777216)
|  cardinality=1,500,000,000
|  vec output tuple id: 3
|  output tuple id: 3
|  vIntermediate tuple ids: 2
|  hash output slot ids: 10
|  final projections: o_custkey[#17]
|  final project output tuple id: 3
|  distribute expr lists: o_custkey[#10]
|  distribute expr lists: c_custkey[#0]
|
|---1: VEXCHANGE
|      offset: 0
|      distribute expr lists: c_custkey[#0]
3: VEXCHANGE
|  offset: 0
|  distribute expr lists:

PLAN FRAGMENT 2
| PARTITION: HASH_PARTITIONED: o_orderkey[#8]
| HAS_COLO_PLAN_NODE: false
| STREAM DATA SINK
|   EXCHANGE ID: 03
|   HASH_PARTITIONED: o_custkey[#10]

2: VOlapScanNode(242)
|  TABLE: regression_test_nereids_tpch_shape_sf1000_p0.orders(orders)
|  PREAGGREGATION: ON
|  runtime filters: RF000[bloom] -> o_custkey[#10]
|  partitions=1/1 (orders)
|  tablets=96/96, tabletList=54990,54992,54994 ...
|  cardinality=0, avgRowSize=0.0, numNodes=1
|  pushAggOp=NONE
주요 필드 설명은 다음과 같습니다.
- Join 측:
runtime filters: RF000[bloom] <- c_custkey[#0] (150000000/134217728/16777216)번호가 000인 Bloom Filter를 생성하며,c_custkey필드를 입력으로 사용한다는 뜻입니다. 괄호 안의 세 숫자는 Bloom Filter 크기 계산과 관련이 있으며, 지금은 무시해도 됩니다. - Scan 측:
runtime filters: RF000[bloom] -> o_custkey[#10]RF000을 orders 테이블의 Scan 노드에 적용하여o_custkey필드를 기준으로 필터링한다는 뜻입니다.
2. EXPLAIN SHAPE PLAN
mysql> explain shape plan select count(*) from orders join customer on o_custkey=c_custkey where c_nationkey=5;
+--------------------------------------------------------------------------------------------------------------------------+
Explain String(Nereids Planner)                                                                                            |
+--------------------------------------------------------------------------------------------------------------------------+
PhysicalResultSink                                                                                                         |
--hashAgg[GLOBAL]                                                                                                          |
----PhysicalDistribute[DistributionSpecGather]                                                                             |
------hashAgg[LOCAL]                                                                                                       |
--------PhysicalProject                                                                                                    |
----------hashJoin[INNER_JOIN shuffle]                                                                                     |
------------hashCondition=((orders.o_custkey=customer.c_custkey)) otherCondition=() buildRFs:RF0 c_custkey->[o_custkey]    |
--------------PhysicalProject                                                                                              |
----------------Physical0lapScan[orders] apply RFs: RF0                                                                    |
--------------PhysicalProject                                                                                              |
----------------filter((customer.c_nationkey=5))                                                                           |
------------------Physical0lapScan[customer]                                                                               |
+--------------------------------------------------------------------------------------------------------------------------+
11 rows in set (0.02 sec)
주요 필드는 다음과 같습니다.
- Join 측:
buildRFs: RF0 c_custkey -> [o_custkey]는 번호가 0인 JRF를 생성하며,c_custkey를 입력으로 사용하여o_custkey에 적용한다는 뜻입니다. - Scan 측:
PhysicalOlapScan[orders] apply RFs: RF0는 orders 테이블이 RF0으로 필터링된다는 뜻입니다.
3. Profile
실행 중 BE는 JRF 사용 정보를 Profile에 출력합니다(set enable_profile=true 필요).
Join 측 Profile:
HASH_JOIN_SINK_OPERATOR  (id=3  ,  nereids_id=367):(ExecTime:  703.905us)
    -  JoinType:  INNER_JOIN
    ...
    -  BuildRows:  617
    ...
    -  RuntimeFilterComputeTime:  70.741us
    -  RuntimeFilterInitTime:  10.882us
이 예에서는 JRF 생성에 70.741us가 걸리며 입력 행 수는 617개입니다. JRF 크기와 유형은 Scan 측에 표시됩니다.
Scan 측 Profile:
OLAP_SCAN_OPERATOR  (id=2.  nereids_id=351.  table  name  =  orders(orders)):(ExecTime:  13.32ms)
              -  RuntimeFilters:  :  RuntimeFilter:  (id  =  0,  type  =  bloomfilter,  need_local_merge:  false,  is_broadcast:  true,  build_bf_cardinality:  false,
              ...
              -  RuntimeFilterInfo:
                  -  filter  id  =  0  filtered:  714.761K  (714761)
                  -  filter  id  =  0  input:  747.862K  (747862)
              ...
              -  WaitForRuntimeFilter:  6.317ms
            RuntimeFilter:  (id  =  0,  type  =  bloomfilter):
                  -  Info:  [IsPushDown  =  true,  RuntimeFilterState  =  READY,  HasRemoteTarget  =  false,  HasLocalTarget  =  true,  Ignored  =  false]
                  -  RealRuntimeFilterType:  bloomfilter
                  -  BloomFilterSize:  1024
다음 정보를 주의 깊게 확인합니다.
| 확인 항목 | 필드 | 의미 |
|---|---|---|
| 필터 효과 | filter id = 0 filtered / input | Filtered 값이 클수록 필터링 효과가 좋음 |
| 스토리지 계층으로의 푸시다운 여부 | IsPushDown = true | 푸시다운 후 지연 구체화를 트리거하여 IO를 줄일 수 있음 |
| 적용 여부 | RuntimeFilterState = READY | READY가 아닌 상태는 Scan이 JRF를 기다리지 못했음을 의미 |
| 필터 크기 | BloomFilterSize: 1024 | Bloom Filter의 바이트 수 |
튜닝
대부분의 경우 JRF는 적응형으로 동작하므로 수동 튜닝이 필요하지 않습니다. 조정이 꼭 필요한 경우 다음 세션 변수를 사용할 수 있습니다.
| 변수 | 기본값 | 기능 |
|---|---|---|
runtime_filter_mode | GLOBAL | JRF 활성화 여부(GLOBAL은 활성화 / OFF는 비활성화) |
runtime_filter_type | 버전 2.1의 기본값은 12 | JRF 유형 열거 값의 합을 제어 |
runtime_filter_wait_time_ms | 1000 | Scan이 JRF를 기다리는 최대 시간(밀리초) |
enable_runtime_filter_prune | true | 선택도가 낮은 JRF의 가지치기 여부 |
runtime_filter_broadcast_join_producer_num | 3 | Broadcast Join에서 각 JRF를 생성하는 BE의 최대 수. 값이 0 이하이면 제한이 없습니다. 버전 4.1.4부터 지원 |
runtime_filter_tree_publish_max_send_bytes | 268435456 (256 MB) | 전역 JRF를 배포할 때 단일 RPC로 전송하는 최대 바이트 수. 이 임계값을 초과하면 트리 형태(다단계)의 배포를 사용하여 병합 노드가 모든 Scan 노드에 큰 필터를 반복해서 전송하지 않도록 합니다. 값이 0이면 트리 형태의 배포를 비활성화하고 직접 배포 방식으로 돌아갑니다. 값은 0 이상이어야 합니다. 버전 4.1.4부터 지원 |
runtime_filter_broadcast_join_producer_num: Broadcast Join의 JRF는 Build 측의 모든 BE에서 동일한 내용으로 생성되어 전송됩니다. 이 변수는 실제로 JRF를 생성하는 BE 수를 제한하며(기본값 3), 대규모 클러스터에서 RPC 오버헤드를 크게 줄입니다. Nereids 분산 플래너 경로에서만 적용되며, 기존 Coordinator 경로는 원래 동작을 유지합니다.runtime_filter_tree_publish_max_send_bytes: 이전에는 큰 전역 JRF를 병합 노드에서 모든 Scan 노드로 직접 배포하여 큰 RPC 첨부 데이터가 반복해서 전송되었습니다. 트리 형태의 배포에서는 필터를 단계별로 전달하므로 단일 노드의 대역폭 부담이 줄어듭니다.
1. JRF 활성화 및 비활성화
- 활성화:
set runtime_filter_mode = GLOBAL - 비활성화:
set runtime_filter_mode = OFF
2. JRF 유형 설정
runtime_filter_type은 JRF 유형의 열거 값을 제어합니다. 이 값들을 조합(합산)하면 여러 유형을 동시에 생성할 수 있습니다.
| 유형 | 열거 값 |
|---|---|
IN | 1 |
BLOOM | 2 |
MIN_MAX | 4 |
IN_OR_BLOOM | 8 |
IN_OR_BLOOM을 사용하면 BE가 실제 행 수에 따라 IN 또는 BLOOM을 적응형으로 선택합니다. 예를 들면 다음과 같습니다.
set runtime_filter_type = 6: BLOOM과 MIN_MAX를 동시에 생성합니다.- 버전 2.1의 기본값인 12 (4 + 8): MIN_MAX와 IN_OR_BLOOM을 동시에 생성합니다.
3. 대기 시간 설정
JRF는 Try-best 메커니즘을 사용합니다. Scan은 시작하기 전에 JRF를 기다리며, Doris가 대기 시간을 자동으로 추정합니다. 일부 상황에서는 대기 시간이 부족하여 JRF가 적용되지 않고 Scan의 출력 행 수가 예상보다 많아질 수 있습니다.
판단 방법: Profile에서 Scan 노드에 RuntimeFilterState = NOT_READY가 표시됩니다.
설정 방법:
- 목적: Scan이 JRF를 기다리는 시간을 늘립니다.
- 명령:
set runtime_filter_wait_time_ms = <milliseconds> - 설명: 기본값은 1000밀리초입니다.
4. JRF 가지치기
일부 시나리오에서는 JRF의 선택도가 낮습니다. 예를 들어 orders와 customer가 기본 키-외래 키 관계이고 customer에 필터 조건이 없으면, JRF의 입력은 모든 custkey 값이 되므로 orders를 필터링할 수 없습니다. 옵티마이저는 열 통계를 바탕으로 효과를 판단하고 그에 따라 가지치기를 수행합니다.
- 목적: JRF 가지치기를 활성화하거나 비활성화합니다.
- 명령:
set enable_runtime_filter_prune = true|false - 설명: 기본값은
true입니다.
TopN Runtime Filter
TopN Runtime Filter는 topN 연산자가 실행될 때 현재 힙 최상단 값을 바탕으로 필터를 동적으로 생성하여 Scan 데이터를 미리 가지치기합니다.
작동 원리
Doris는 데이터를 청크 단위의 스트리밍 방식으로 처리합니다. SQL에 topN이 포함되어 있으면 Doris는 모든 결과를 계산하는 대신 동적 필터를 생성하여 데이터를 미리 필터링합니다.
예:
select o_orderkey from orders order by o_orderdate limit 5;
실행 계획은 다음과 같습니다.
mysql> explain select o_orderkey from orders order by o_orderdate limit 5;
+-----------------------------------------------------+
| Explain String(Nereids Planner)                     |
+-----------------------------------------------------+
| PLAN FRAGMENT 0                                     |
|   OUTPUT EXPRS:                                     |
|     o_orderkey[#11]                                 |
|   PARTITION: UNPARTITIONED                          |
|                                                     |
|   HAS_COLO_PLAN_NODE: false                         |
|                                                     |
|   VRESULT SINK                                      |
|      MYSQL_PROTOCAL                                 |
|                                                     |
|   2:VMERGING-EXCHANGE                               |
|      offset: 0                                      |
|      limit: 5                                       |
|      final projections: o_orderkey[#9]              |
|      final project output tuple id: 2               |
|      distribute expr lists:                         |
|                                                     |
| PLAN FRAGMENT 1                                     |
|                                                     |
|   PARTITION: HASH_PARTITIONED: O_ORDERKEY[#0]       |
|                                                     |
|   HAS_COLO_PLAN_NODE: false                         |
|                                                     |
|   STREAM DATA SINK                                  |
|     EXCHANGE ID: 02                                 |
|     UNPARTITIONED                                   |
|                                                     |
|   1:VTOP-N(119)                                     |
|   |  order by: o_orderdate[#10] ASC                 |
|   |  TOPN OPT                                       |
|   |  offset: 0                                      |
|   |  limit: 5                                       |
|   |  distribute expr lists: O_ORDERKEY[#0]          |
|   |                                                 |
|   0:VOlapScanNode(113)                              |
|      TABLE: tpch.orders(orders), PREAGGREGATION: ON |
|      TOPN OPT:1                                     |
|      partitions=1/1 (orders)                        |
|      tablets=3/3, tabletList=135112,135114,135116   |
|      cardinality=150000, avgRowSize=0.0, numNodes=1 |
|      pushAggOp=NONE                                 |
+-----------------------------------------------------+
41 rows in set (0.06 sec)
실행 흐름은 다음과 같습니다.
- TopN Filter가 없으면 Scan은 데이터 블록을 하나씩 읽어 TopN에 전달하고, TopN은 힙 정렬로 현재 상위 5개를 유지합니다.
- 데이터 Block 하나에는 약 1024개의 행이 들어 있습니다. 첫 번째 Block을 처리하면 해당 Block에서 5번째에 해당하는 값을 알 수 있습니다.
- 이 값이
1995-01-01이라고 가정합니다. Scan이 두 번째 Block을 출력할 때는o_orderdate > 1995-01-01인 행을 더 이상 TopN에 보낼 필요가 없습니다. - 임계값은 동적으로 갱신됩니다. 이후 Block에 더 작은
o_orderdate가 있으면 TopN이 임계값을 갱신합니다.
TopN Runtime Filter 확인
EXPLAIN을 사용하여 옵티마이저가 계획한 TopN Runtime Filter를 확인합니다.
1:VTOP-N(119)
| order by: o_orderdate[#10] ASC
| TOPN OPT
| offset: 0
| limit: 5
| distribute expr lists: O_ORDERKEY[#0]
|

0:VLapScanNode[113]
    TABLE: regression_test_nereids_tpch_p0.(orders), PREAGGREGATION: ON
    TOPN OPT: 1
    partitions=1/1 (orders)
    tablets=3/3, tabletList=135112,135114,135116
    cardinality=150000, avgRowSize=0.0, numNodes=1
    pushAggOp: NONE
주요 필드는 다음과 같습니다.
- TopN 노드:
TOPN OPT가 표시되면 이 TopN 노드가 TopN Runtime Filter를 생성한다는 뜻입니다. - Scan 노드: 사용 중인 TopN Runtime Filter를 어느 TopN 노드에서 생성했는지 나타냅니다. 예를 들어
TOPN OPT: 1은 orders의 Scan이 번호가 1인 TopN 노드에서 생성한 Runtime Filter를 사용한다는 뜻입니다.
Doris는 분산 데이터베이스이므로 TopN과 Scan의 물리적 위치도 고려합니다. BE 간 통신은 비용이 높으므로 BE가 필터 활성화 여부와 적용 범위를 적응형으로 결정합니다. 현재 구현은 BE 수준의 TopN Runtime Filter로, TopN과 Scan이 동일한 BE 내에 있으며 비용이 낮은 스레드 간 통신만 사용합니다.
튜닝
limit이 작을수록 TopN Runtime Filter의 필터링 효과가 강해집니다. 기본적으로 시스템은 limit이 테이블 데이터의 절반보다 작을 때만 이를 활성화합니다.
| 변수 | 기능 |
|---|---|
topn_filter_ratio | TopN Runtime Filter 생성 여부를 제어 |
예를 들어 set topn_filter_ratio=0으로 설정하면 다음 쿼리는 TopN Runtime Filter를 생성하지 않습니다.
select o_orderkey from orders order by o_orderdate limit 20;
Runtime Filter 유형 비교
| 비교 항목 | Join Runtime Filter | TopN Runtime Filter |
|---|---|---|
| 적용 시나리오 | Join 쿼리 | ORDER BY ... LIMIT 쿼리 |
| 생성 위치 | Join 노드 | TopN 노드 |
| 푸시다운 대상 | 왼쪽 테이블의 Scan | 동일한 BE 내의 Scan |
| BE 간 적용 | 지원(Global JRF 병합) | 지원하지 않음(BE 내부에서만 적용) |
| 적응형 동작 | 예 | 예 |
FAQ / 문제 해결
Q1: JRF가 적용되지 않고 Scan의 출력 행 수가 예상보다 훨씬 많습니다. 어떻게 해야 하나요?
Profile에서 RuntimeFilterState를 확인합니다. 값이 READY가 아니면 Scan의 대기 시간이 초과된 것입니다. runtime_filter_wait_time_ms를 늘릴 수 있습니다.
Q2: JRF가 생성되었지만 Filtered 행 수가 적습니다. 이유가 무엇인가요?
JRF 입력의 선택도가 낮을 수 있습니다. 예를 들어 오른쪽 테이블에 필터 조건이 없는 기본 키-외래 키 Join이 이에 해당합니다. enable_runtime_filter_prune = true를 유지하여 옵티마이저가 자동으로 가지치기하도록 하거나, 오른쪽 테이블에 필터 조건이 빠져 있는지 확인할 수 있습니다.
Q3: 여러 JRF 유형을 동시에 생성하려면 어떻게 하나요?
runtime_filter_type을 해당 열거 값의 합으로 설정합니다. 예를 들어 set runtime_filter_type = 6은 BLOOM과 MIN_MAX를 동시에 생성합니다.
Q4: 비동등 Join에서도 JRF를 사용할 수 있나요? Min-Max Filter를 사용할 수 있습니다. In Filter와 Bloom Filter는 동등 Join만 지원합니다.
Q5: TopN Runtime Filter가 생성되지 않습니다. 이유가 무엇인가요?
topn_filter_ratio를 확인합니다. 값이 0이면 필터가 생성되지 않습니다. 기본적으로 시스템은 limit이 테이블 데이터의 절반보다 작을 때만 필터를 생성합니다. limit 조건을 완화하거나 topn_filter_ratio를 늘리면 필터 생성을 트리거할 수 있습니다.
Q6: Bloom Filter 크기는 어떻게 제어하나요?
RUNTIME_BLOOM_FILTER_MIN_SIZE와 RUNTIME_BLOOM_FILTER_MAX_SIZE를 사용하여 최소 및 최대 바이트 수를 제한합니다. 필터 정밀도와 비용 사이에서 균형을 맞춰야 합니다.