최종 수정: 에
Duplicate Key 모델
Duplicate Key 모델은 Doris의 기본 테이블 모델입니다. 중복 제거나 집계 없이 모든 원본 데이터 레코드를 저장합니다. 테이블을 생성할 때 DUPLICATE KEY 키워드로 데이터 저장에 사용할 정렬 열을 지정하고 자주 사용하는 쿼리를 최적화할 수 있습니다. 일반적으로 정렬 키에는 세 개 이하의 열을 선택하는 것이 좋습니다. 정렬 열을 선택하는 방법은 정렬 키를 참조하세요.
적용 시나리오
Duplicate Key 모델의 데이터는 일반적으로 추가 전용이며, 기존 데이터는 업데이트하지 않습니다. 모든 원본 데이터를 저장해야 하는 시나리오에 적합합니다.
- 로그 저장: 액세스 로그, 오류 로그 등 다양한 프로그램 운영 로그를 저장하는 데 사용합니다. 이후 감사와 분석을 원활하게 수행할 수 있도록 모든 레코드를 상세히 보존해야 합니다.
- 사용자 행동 데이터: 클릭 데이터나 사용자 방문 경로 등 사용자 행동을 분석할 때, 이후 사용자 프로필을 구축하고 행동 경로를 세밀하게 분석할 수 있도록 상세한 사용자 행동을 보존해야 합니다.
- 트랜잭션 데이터: 트랜잭션 활동이나 주문 데이터를 저장할 때는 일반적으로 트랜잭션이 종료된 후 데이터를 수정하지 않습니다. Duplicate Key 모델은 이러한 트랜잭션 정보를 레코드 누락 없이 보존하는 데 적합하므로, 정확한 트랜잭션 대사 작업을 편리하게 수행할 수 있습니다.
핵심 특징
Duplicate Key 모델에는 다음과 같은 세 가지 주요 특징이 있습니다.
| 특징 | 설명 |
|---|---|
| 원본 데이터 보존 | 모든 원본 데이터를 보존하므로 원시 데이터를 저장하고 쿼리하는 데 적합합니다. 상세 데이터 분석이 필요한 애플리케이션 시나리오에서 Duplicate Key 모델은 데이터 손실 위험을 방지합니다. |
| 중복 제거 및 집계 없음 | Aggregate Key 모델 및 Unique Key 모델과 달리, Duplicate Key 모델은 데이터를 중복 제거하거나 집계하지 않습니다. 두 행이 동일하더라도 삽입할 때마다 두 행 모두 온전히 보존됩니다. |
| 유연한 데이터 쿼리 | 모든 원본 데이터를 보존하므로 전체 데이터에서 상세 정보를 추출하고 전체 데이터셋을 기반으로 원하는 차원에서 집계 연산을 수행할 수 있습니다. 이를 통해 메타데이터 감사와 세밀한 분석이 가능합니다. |
테이블 생성 구문
테이블을 생성할 때 DUPLICATE KEY 키워드로 Duplicate Key 모델을 지정하고 Key 열을 설정합니다. Duplicate Key 모델에서 Key 열은 정렬에만 사용되며, 고유할 필요는 없습니다.
다음 예제는 로그 정보를 저장하는 Duplicate Key 테이블을 생성하며, 세 개의 열 log_time, log_type, error_code를 기준으로 정렬합니다.
CREATE TABLE IF NOT EXISTS example_tbl_duplicate
(
    log_time        DATETIME       NOT NULL,
    log_type        INT            NOT NULL,
    error_code      INT,
    error_msg       VARCHAR(1024),
    op_id           BIGINT,
    op_time         DATETIME
)
DUPLICATE KEY(log_time, log_type, error_code)
DISTRIBUTED BY HASH(log_type) BUCKETS 10;
데이터 쓰기 및 저장
Duplicate Key 테이블에서는 데이터를 중복 제거하거나 집계하지 않습니다. 삽입된 데이터는 그대로 저장되며, Key 열은 정렬 키로만 사용됩니다.
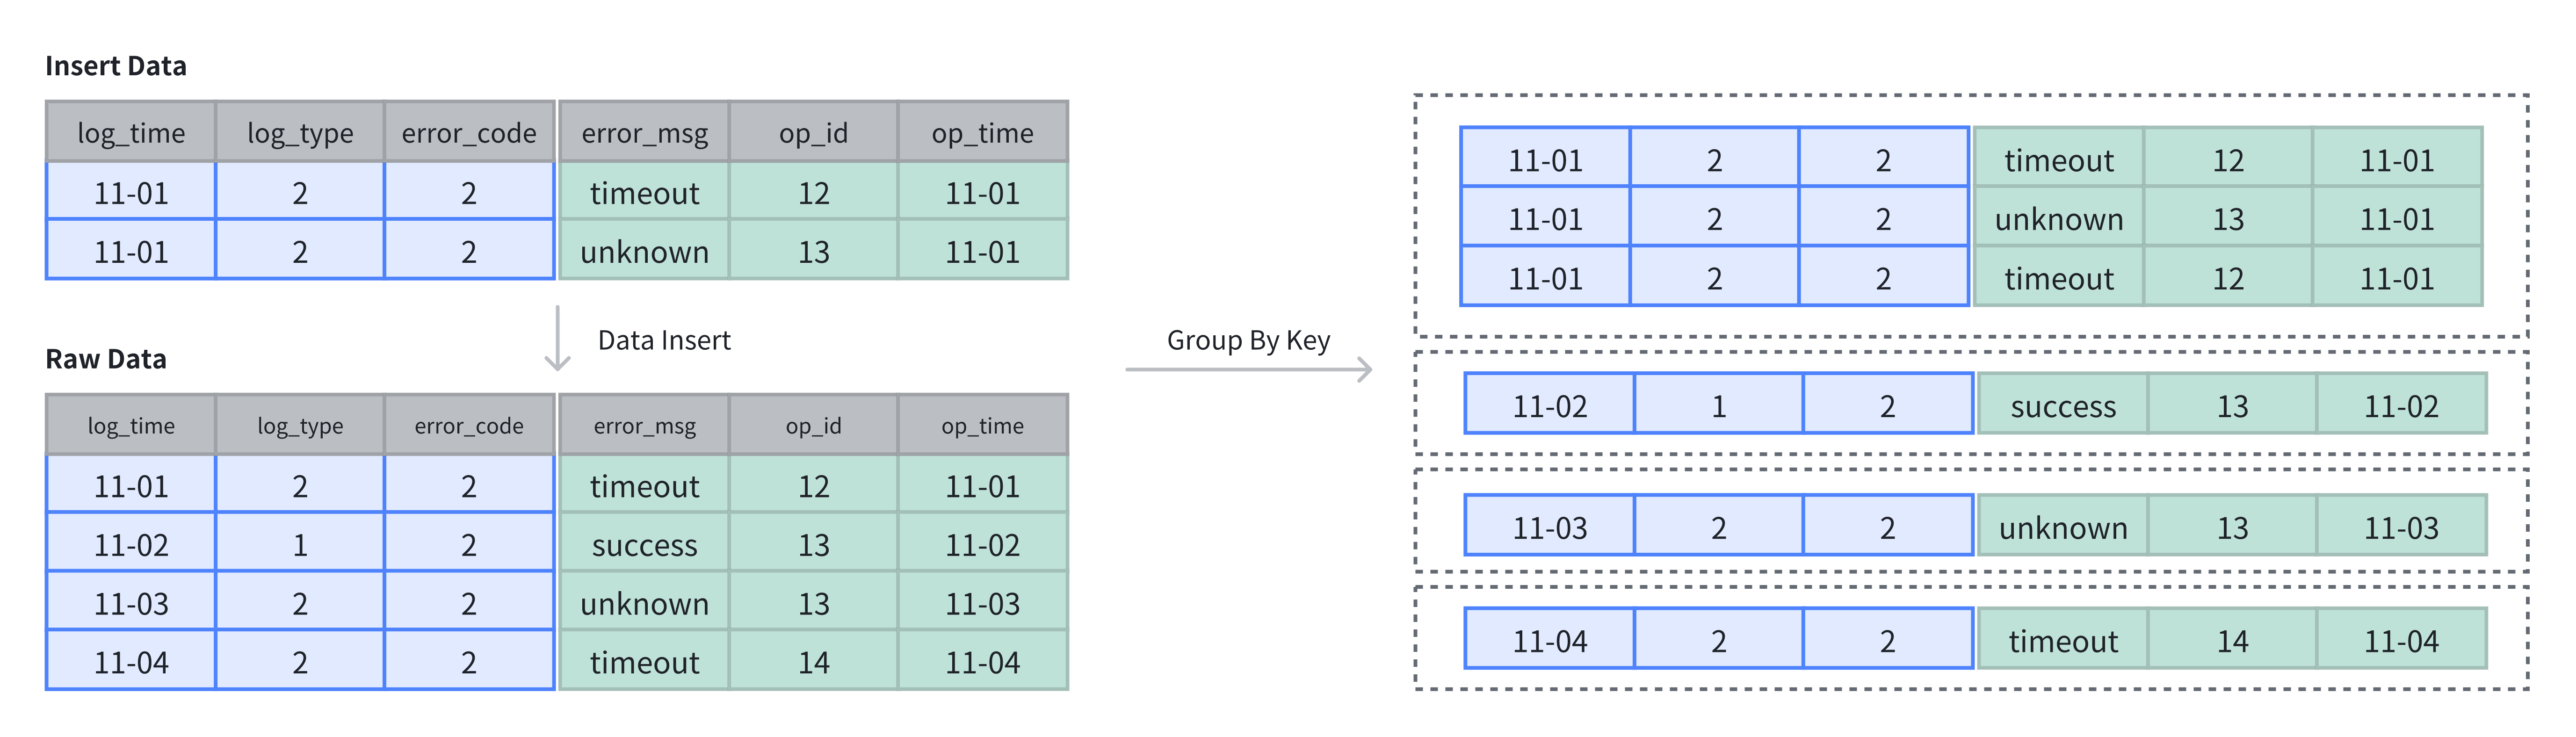
위 그림과 같이 테이블에는 원래 4개의 행이 있습니다. 2개의 행을 추가로 삽입하면 모든 데이터가 APPEND 모드로 저장되어 최종적으로 6개의 행이 보존됩니다.
-- Write 4 rows of original data
INSERT INTO example_tbl_duplicate VALUES
('2024-11-01 00:00:00', 2, 2, 'timeout', 12, '2024-11-01 01:00:00'),
('2024-11-02 00:00:00', 1, 2, 'success', 13, '2024-11-02 01:00:00'),
('2024-11-03 00:00:00', 2, 2, 'unknown', 13, '2024-11-03 01:00:00'),
('2024-11-04 00:00:00', 2, 2, 'unknown', 12, '2024-11-04 01:00:00');

-- Append 2 more rows
INSERT INTO example_tbl_duplicate VALUES
('2024-11-01 00:00:00', 2, 2, 'timeout', 12, '2024-11-01 01:00:00'),
('2024-11-01 00:00:00', 2, 2, 'unknown', 13, '2024-11-01 01:00:00');

-- The query result shows that all 6 rows are retained
SELECT * FROM example_tbl_duplicate;
+---------------------+----------+------------+-----------+-------+---------------------+
| log_time            | log_type | error_code | error_msg | op_id | op_time             |
+---------------------+----------+------------+-----------+-------+---------------------+
| 2024-11-02 00:00:00 |        1 |          2 | success   |    13 | 2024-11-02 01:00:00 |
| 2024-11-01 00:00:00 |        2 |          2 | timeout   |    12 | 2024-11-01 01:00:00 |
| 2024-11-03 00:00:00 |        2 |          2 | unknown   |    13 | 2024-11-03 01:00:00 |
| 2024-11-04 00:00:00 |        2 |          2 | unknown   |    12 | 2024-11-04 01:00:00 |
| 2024-11-01 00:00:00 |        2 |          2 | unknown   |    13 | 2024-11-01 01:00:00 |
| 2024-11-01 00:00:00 |        2 |          2 | timeout   |    12 | 2024-11-01 01:00:00 |
+---------------------+----------+------------+-----------+-------+---------------------+