BloomFilter 인덱스
BloomFilter 인덱스는 BloomFilter 알고리즘을 기반으로 하는 스킵 인덱스입니다. 쿼리 값이 데이터 블록에 존재할 가능성을 빠르게 판단하고, 동등 조건을 충족하지 않는 데이터 블록을 건너뛰어 I/O 오버헤드를 줄이고 쿼리를 가속합니다.
BloomFilter 알고리즘 원리
BloomFilter는 Bloom이 1970년에 제안한, 여러 해시 함수의 매핑을 기반으로 하는 빠른 조회 알고리즘입니다. 핵심 특징은 다음과 같습니다.
- 높은 공간 효율성: 긴 이진 비트 배열과 해시 함수 집합으로 하나의 집합을 표현할 수 있습니다.
- 쿼리 결과: 집합에 특정 원소가 존재하는지 조회하면 BloomFilter는 다음 두 가지 결과 중 하나만 반환합니다.
- 존재할 가능성 있음(해시 충돌이 발생할 수 있으므로 거짓 양성일 수 있음)
- 확실히 존재하지 않음(신뢰할 수 있는 결과)
동작 과정은 다음과 같습니다.
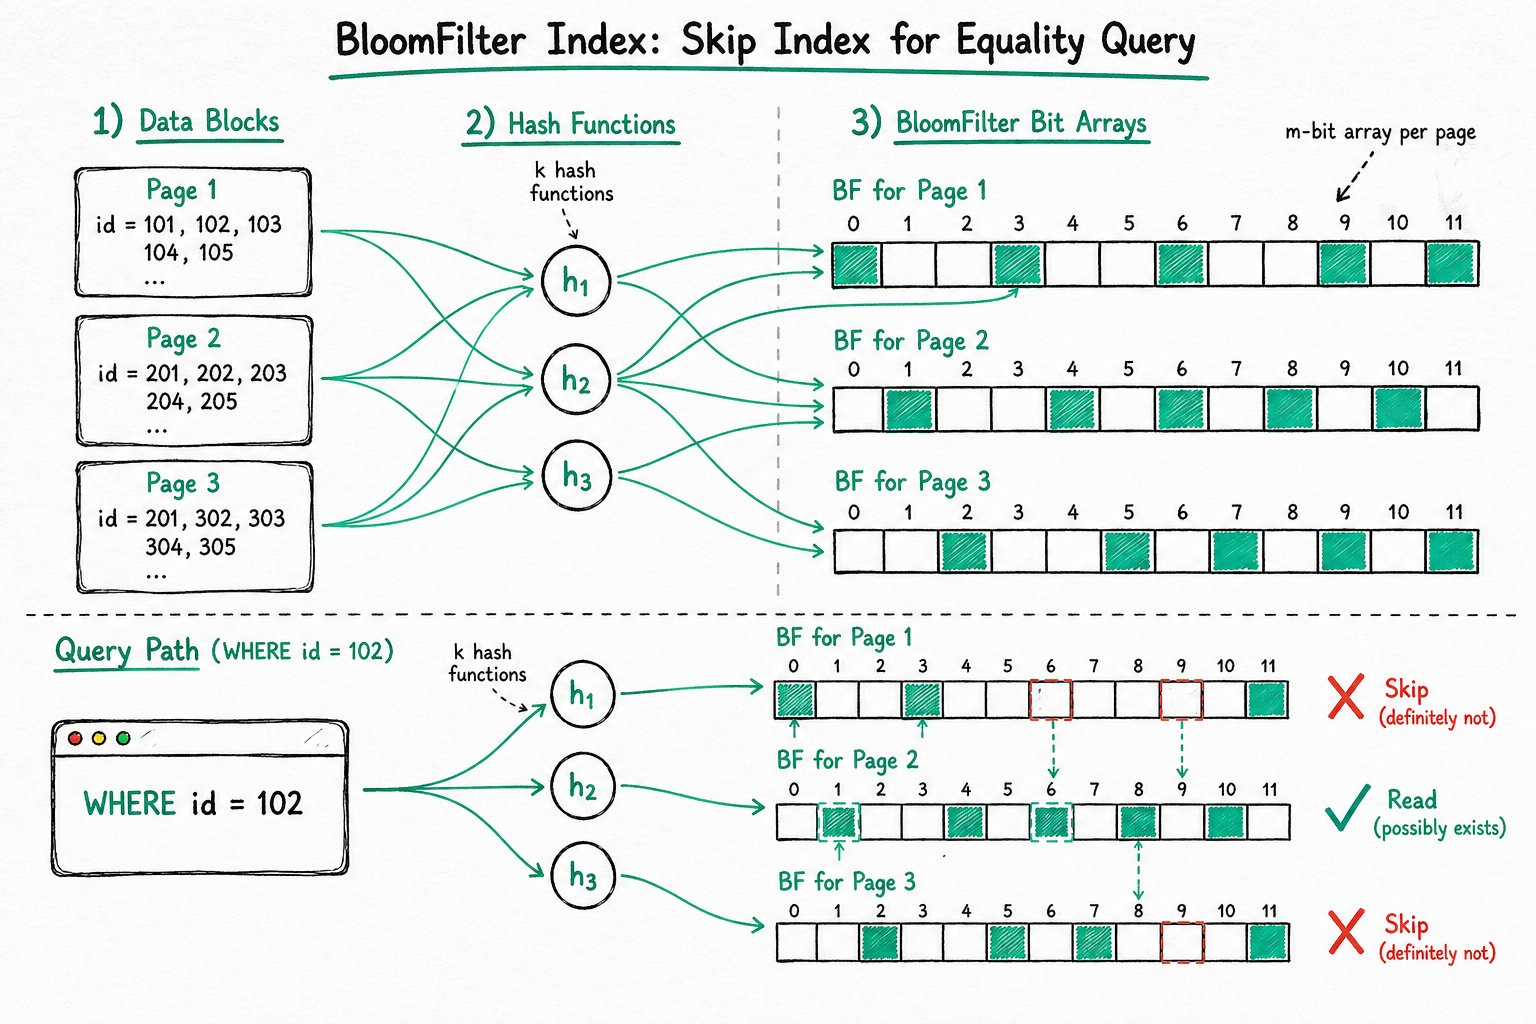
- 이진 비트 배열의 모든 비트를 영으로 초기화합니다.
- 원소를 삽입할 때는 여러 해시 함수로 원소를 해싱하여 여러 오프셋을 계산하고, 비트 배열의 해당 위치를 1로 설정합니다.
- 원소를 조회할 때도 같은 방식으로 오프셋을 계산합니다. 해당 위치 중 하나라도 0이면 원소는 확실히 존재하지 않습니다. 모든 위치가 1이면 원소가 존재할 가능성이 있습니다.
다음 그림은 m=18, k=3인 BloomFilter 예제입니다(m은 비트 배열의 크기, k는 해시 함수의 수). 집합에 있는 세 원소 x, y, z는 서로 다른 3개의 해시 함수를 통해 비트 배열에 매핑됩니다. 원소 w를 조회할 때, 대응하는 비트 중 적어도 하나가 0이므로 w는 확실히 집합에 없습니다.
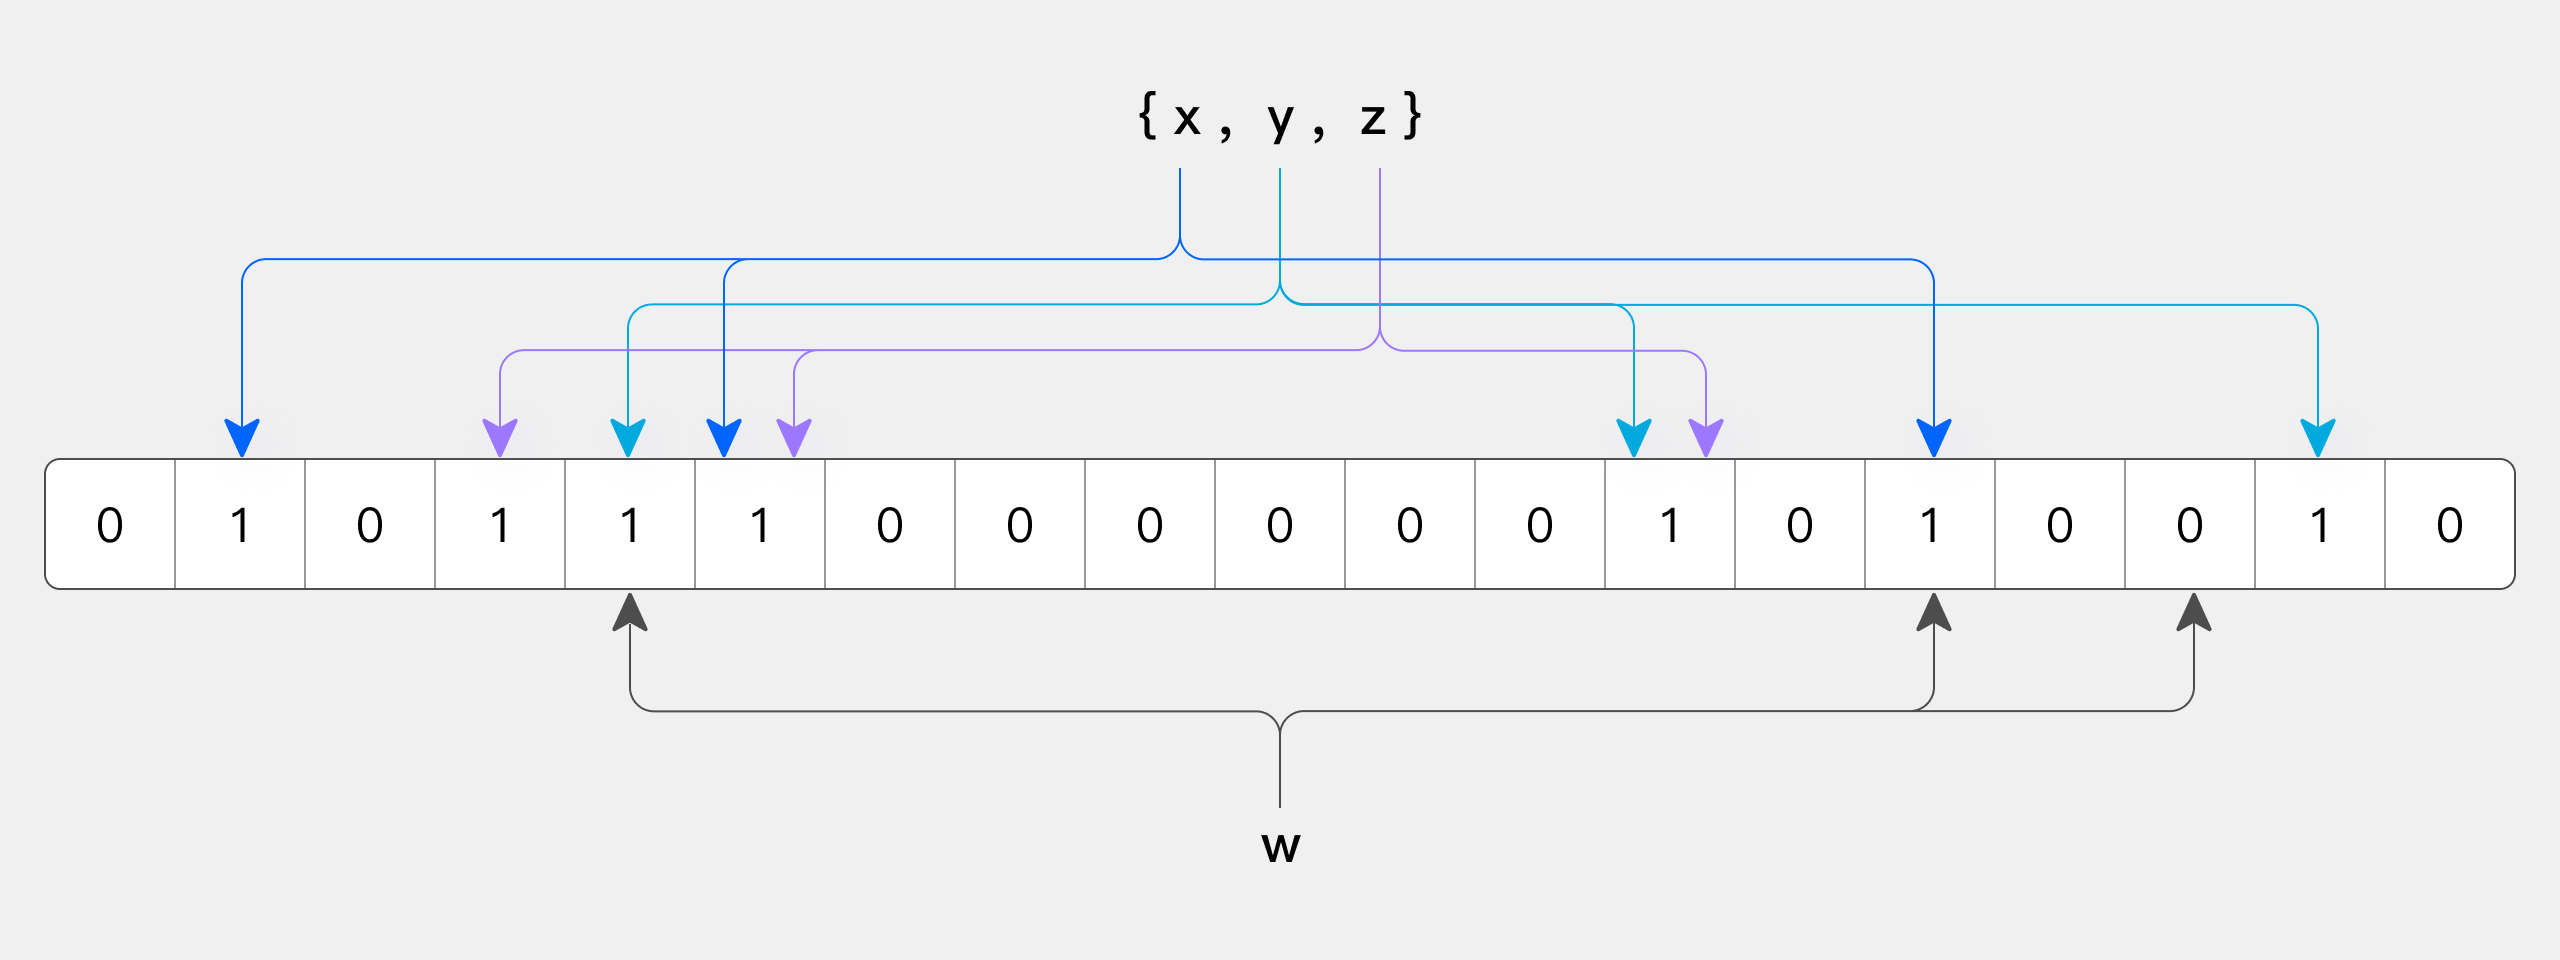
해시 충돌이 발생할 수 있으므로 BloomFilter에는 "거짓 양성" 문제가 있습니다. 따라서 BloomFilter 기반 인덱스는 조건을 충족하지 않는 것이 확실한 데이터만 건너뛸 수 있으며, 조건을 충족하는 데이터의 위치를 정확하게 찾을 수는 없습니다.
Doris에서의 구현
Doris의 BloomFilter 인덱스는 데이터 블록(페이지) 단위로 생성되며, 각 데이터 블록마다 하나의 BloomFilter가 있습니다.
- 쓰기 시: 데이터 블록의 각 값을 해싱하여 해당 데이터 블록의 BloomFilter에 저장합니다.
- 쿼리 시: 동등 조건의 값을 기준으로 각 데이터 블록의 BloomFilter에 해당 값이 포함되어 있는지 확인합니다. 포함되어 있지 않으면 해당 데이터 블록을 건너뛰어 I/O를 줄이고 쿼리를 가속합니다.
사용 사례
BloomFilter 인덱스는 동등 조건 쿼리(= 및 IN 포함)를 가속할 수 있으며, 카디널리티가 높은 열(예: userid와 같이 고유한 ID를 저장하는 열)에 특히 적합합니다.
적용 시나리오
| 시나리오 | 설명 |
|---|---|
| 동등 조건 쿼리 | WHERE column = value |
| IN 쿼리 | WHERE column IN (v1, v2, ...) |
| 카디널리티가 높은 열 | 사용자 ID나 주문 번호처럼 서로 다른 값이 많고 중복률이 낮은 열 |
제한 사항
- 쿼리 유형 제한:
=및IN쿼리에만 효과가 있습니다.!=,NOT IN,>,<등의 쿼리에는 효과가 없습니다. - 데이터 타입 제한:
Tinyint,Float,Double타입의 열에는 BloomFilter 인덱스를 생성할 수 없습니다. - 카디널리티 제한: 카디널리티가 낮은 열에서는 쿼리 가속 효과가 제한적입니다. 예를 들어, "성별" 열에는 값이 두 가지뿐이므로 거의 모든 데이터 블록에 모든 값이 포함됩니다. 이 경우 BloomFilter가 데이터를 걸러낼 수 없어 인덱스의 의미가 없어집니다.
- 버전 제한: 4.1.2 버전부터
CHAR타입 열의 BloomFilter 인덱스는 더 이상 적용되지 않습니다.
인덱스 관리
테이블 생성 시 BloomFilter 인덱스 생성
과거의 설계 방식으로 인해 BloomFilter 인덱스를 정의하는 구문은 역색인 등의 인덱스에 사용하는 일반적인 INDEX 구문과 다릅니다. BloomFilter 인덱스는 테이블의 PROPERTIES 속성에 있는 bloom_filter_columns로 지정하며, 하나 이상의 열을 한 번에 지정할 수 있습니다.
PROPERTIES (
    "bloom_filter_columns" = "column_name1,column_name2"
);
BloomFilter 인덱스 조회
SHOW CREATE TABLE을 사용하여 테이블에 생성된 BloomFilter 인덱스를 조회합니다.
SHOW CREATE TABLE table_name;
BloomFilter 인덱스 수정
ALTER TABLE을 사용하여 테이블의 bloom_filter_columns 속성을 수정하면 BloomFilter 인덱스 열을 추가하거나 제거할 수 있습니다.
column_name3에 BloomFilter 인덱스 추가:
ALTER TABLE table_name SET ("bloom_filter_columns" = "column_name1,column_name2,column_name3");
column_name1의 BloomFilter 인덱스 제거:
ALTER TABLE table_name SET ("bloom_filter_columns" = "column_name2,column_name3");
인덱스 사용
BloomFilter 인덱스는 WHERE 조건의 동등 조건 쿼리를 가속하는 데 사용됩니다. 별도의 구문 없이 조건이 충족되면 자동으로 적용됩니다.
Query Profile로 인덱스 효과 분석
Query Profile의 다음 지표를 사용하여 BloomFilter 인덱스의 쿼리 가속 효과를 분석할 수 있습니다.
| 지표 | 의미 |
|---|---|
RowsBloomFilterFiltered | BloomFilter 인덱스가 걸러낸 행 수입니다. 다른 Rows 지표와 비교하여 필터링 효과를 분석할 수 있습니다. |
BlockConditionsFilteredBloomFilterTime | BloomFilter 인덱스 필터링에 소요된 시간입니다. |
사용 예제
다음 예제는 Doris에서 BloomFilter 인덱스를 생성하는 방법을 보여줍니다.
CREATE TABLE 문의 PROPERTIES에서 "bloom_filter_columns" = "k1,k2,k3"로 BloomFilter 인덱스를 생성할 열 이름을 지정합니다. 예를 들어, 다음 예제에서는 saler_id와 category_id 열에 BloomFilter 인덱스를 생성합니다.
CREATE TABLE IF NOT EXISTS sale_detail_bloom (
    sale_date date NOT NULL COMMENT "Sale time",
    customer_id int NOT NULL COMMENT "Customer ID",
    saler_id int NOT NULL COMMENT "Salesperson",
    sku_id int NOT NULL COMMENT "Product ID",
    category_id int NOT NULL COMMENT "Product category",
    sale_count int NOT NULL COMMENT "Sales quantity",
    sale_price DECIMAL(12,2) NOT NULL COMMENT "Unit price",
    sale_amt DECIMAL(20,2) COMMENT "Total sales amount"
)
DUPLICATE KEY(sale_date, customer_id, saler_id, sku_id, category_id)
DISTRIBUTED BY HASH(saler_id) BUCKETS 10
PROPERTIES (
    "replication_num" = "1",
    "bloom_filter_columns" = "saler_id,category_id"
);