NGram BloomFilter 인덱스
NGram BloomFilter 인덱스는 문자열 컬럼의 LIKE '%pattern%' 퍼지 쿼리를 가속하도록 설계된 Skip Index입니다. BloomFilter 인덱스를 기반으로 N-Gram 토큰화를 도입하여, 텍스트를 인접한 문자로 구성된 여러 단어 그룹으로 나눈 후 BloomFilter에 기록합니다. 이를 통해 퍼지 매칭을 위한 빠른 필터링을 지원합니다.
주요 이점: 적합한 시나리오에서는 인덱스가 없는 전체 스캔에 비해 NGram BloomFilter 인덱스로 쿼리 속도를 몇 배에서 열 배까지 높일 수 있습니다(사용 예시의 8배 가속 사례 참조).
인덱스 동작 원리
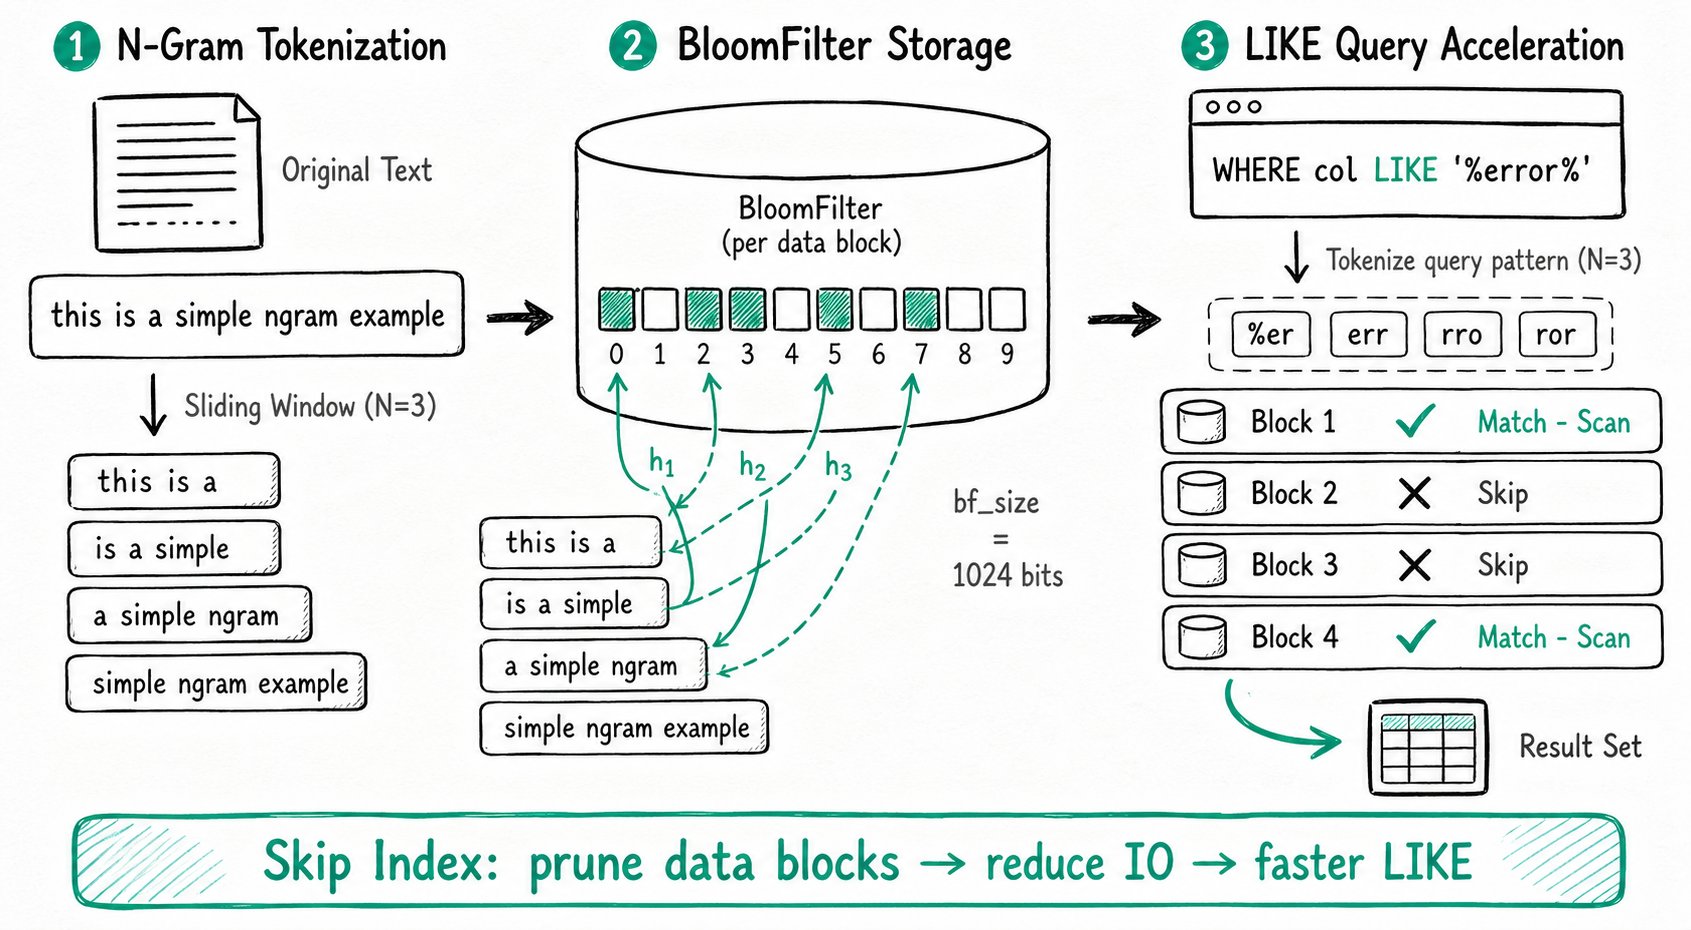
N-Gram 토큰화는 문장이나 텍스트를 인접한 문자로 구성된 여러 단어 그룹으로 나눕니다. 예를 들어, 문자열 'This is a simple ngram example'을 N = 3으로 토큰화하면 다음 4개의 단어가 생성됩니다.
'This is a''is a simple''a simple ngram''simple ngram example'
NGram BloomFilter 인덱스와 일반 BloomFilter 인덱스의 주요 차이점은 다음과 같습니다.
| 비교 항목 | BloomFilter 인덱스 | NGram BloomFilter 인덱스 |
|---|---|---|
| 기록 내용 | 원본 컬럼 값 | 원본 텍스트를 N-Gram으로 토큰화하여 얻은 각 단어 그룹 |
| 가속하는 쿼리 유형 | 동등 조건 쿼리(=, IN) | LIKE '%pattern%' 퍼지 쿼리 |
| 지원하는 컬럼 유형 | 여러 데이터 타입 | 문자열 컬럼만 지원 |
쿼리 가속 과정:
pattern에 N-Gram 토큰화를 적용합니다. 이 패턴은LIKE '%pattern%'에 지정된 값입니다.- 토큰화된 각 단어 그룹이 BloomFilter에 존재하는지 하나씩 확인합니다.
- 단어 그룹이 BloomFilter에 존재하지 않으면 해당 데이터 블록은 LIKE 조건을 충족할 수 없으므로 건너뛸 수 있습니다.
- 조건에 일치하지 않는 데이터 블록을 건너뛰어 IO를 줄이고 쿼리를 가속합니다.
사용 사례
NGram BloomFilter 인덱스는 다음 시나리오에 적합합니다.
- 문자열 컬럼의
LIKE '%pattern%'퍼지 쿼리 가속. LIKE패턴에서 연속된 문자의 수가 인덱스에 정의된gram_size이상인 경우.
- 문자열 컬럼만 지원하며,
LIKE쿼리만 가속할 수 있습니다. - NGram BloomFilter 인덱스와 일반 BloomFilter 인덱스는 상호 배타적입니다. 동일한 컬럼에는 둘 중 하나만 선택할 수 있습니다.
- 인덱스 효과를 분석하는 방법은 BloomFilter 인덱스와 동일합니다.
인덱스 관리
인덱스 생성
테이블 생성 시 인덱스 생성
테이블 생성 구문에서 COLUMN 정의 뒤에 인덱스 정의를 추가합니다.
INDEX `idx_column_name` (`column_name`) USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index'
구문 설명
| 매개변수 | 필수 여부 | 설명 |
|---|---|---|
idx_column_name (column_name) | 필수 | column_name은 인덱스를 생성할 컬럼의 이름으로, 앞에서 정의되어 있어야 합니다. idx_column_name은 인덱스 이름으로, 테이블 내에서 고유해야 합니다 |
USING NGRAM_BF | 필수 | 인덱스 유형을 NGram BloomFilter 인덱스로 지정합니다 |
PROPERTIES | 선택 | NGram BloomFilter 인덱스의 추가 속성을 지정합니다. 자세한 내용은 아래 표를 참조하세요 |
COMMENT | 선택 | 인덱스에 대한 설명을 지정합니다 |
인덱스 이름에는 idx_ 접두사를 사용하는 것이 좋습니다. 예: idx_review_body.
PROPERTIES 매개변수
| 속성 | 설명 |
|---|---|
gram_size | N-Gram의 N에 해당하며, 연속된 N개의 문자마다 하나의 단어 그룹을 구성하도록 지정합니다. 예를 들어, 'This is a simple ngram example'은 4개의 단어 그룹으로 나뉩니다. 이때 설정은 N = 3입니다. LIKE 쿼리 문자열의 최소 길이로 설정하는 것이 좋지만, 2보다 작게 설정해서는 안 됩니다. |
bf_size | BloomFilter의 크기로, 단위는 Bits입니다. 각 데이터 블록의 인덱스 크기를 결정합니다. 값이 클수록 더 많은 저장 공간을 사용하지만 해시 충돌 가능성은 줄어듭니다. |
권장 설정: 일반적으로 "gram_size"="3"과 "bf_size"="1024"로 시작한 후 Query Profile을 기반으로 조정하는 것이 좋습니다.
인덱스 조회
-- Method 1: In the INDEX section of the table schema, USING NGRAM_BF marks an NGram BloomFilter index
SHOW CREATE TABLE table_name;

-- Method 2: An IndexType of NGRAM_BF marks an NGram BloomFilter index
SHOW INDEX FROM table_name;
인덱스 삭제
ALTER TABLE table_ngrambf DROP INDEX idx_ngrambf;
인덱스 수정
기존 테이블에 NGram BloomFilter 인덱스를 추가하는 방법은 다음 두 가지입니다.
-- Method 1: Use CREATE INDEX
CREATE INDEX idx_column_name2(column_name2) ON table_ngrambf
USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index';

-- Method 2: Use ALTER TABLE ADD INDEX
ALTER TABLE table_ngrambf
ADD INDEX idx_column_name2(column_name2) USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index';
인덱스 사용
함수 푸시다운 활성화
NGram BloomFilter 인덱스를 사용하기 전에 함수 푸시다운을 활성화합니다(enable_function_pushdown의 기본값은 false).
SET enable_function_pushdown = true;
인덱스 가속 적용
NGram BloomFilter 인덱스는 LIKE 쿼리를 가속하는 데 자동으로 사용됩니다. 예를 들면 다음과 같습니다.
SELECT count() FROM table1 WHERE message LIKE '%error%';
인덱스 효과 분석
Query Profile의 다음 지표를 사용하여 BloomFilter 인덱스(NGram BloomFilter 포함)의 가속 효과를 분석할 수 있습니다.
| 지표 | 의미 |
|---|---|
RowsBloomFilterFiltered | BloomFilter 인덱스가 걸러낸 행 수입니다. 다른 Rows 지표와 비교하여 필터링 효과를 분석할 수 있습니다 |
BlockConditionsFilteredBloomFilterTime | BloomFilter 인덱스가 소요한 시간 |
사용 예시
다음은 Amazon 상품 사용자 리뷰 데이터 세트인 amazon_reviews를 예로 들어 NGram BloomFilter 인덱스의 사용 방법과 가속 효과를 보여줍니다.
1단계: 테이블 생성
CREATE TABLE `amazon_reviews` (
    `review_date` int(11) NULL,
    `marketplace` varchar(20) NULL,
    `customer_id` bigint(20) NULL,
    `review_id` varchar(40) NULL,
    `product_id` varchar(10) NULL,
    `product_parent` bigint(20) NULL,
    `product_title` varchar(500) NULL,
    `product_category` varchar(50) NULL,
    `star_rating` smallint(6) NULL,
    `helpful_votes` int(11) NULL,
    `total_votes` int(11) NULL,
    `vine` boolean NULL,
    `verified_purchase` boolean NULL,
    `review_headline` varchar(500) NULL,
    `review_body` string NULL
) ENGINE=OLAP
DUPLICATE KEY(`review_date`)
COMMENT 'OLAP'
DISTRIBUTED BY HASH(`review_date`) BUCKETS 16
PROPERTIES (
    "replication_allocation" = "tag.location.default: 1",
    "compression" = "ZSTD"
);
2단계: 데이터 적재
1. 데이터 세트 다운로드
wget이나 다른 도구를 사용하여 다음 URL에서 데이터 세트를 다운로드합니다.
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2010.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2011.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2012.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2013.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2014.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet
2. Stream Load를 통한 데이터 적재
curl --location-trusted -u root: -T amazon_reviews_2010.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2011.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2012.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2013.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2014.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2015.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
위 파일은 크기가 10 GB를 초과할 수 있습니다. streaming_load_max_mb 설정을 be.conf에서 조정하여 Stream Load 파일 업로드 크기 제한을 초과하지 않도록 하세요. 다음 명령은 변경 사항을 동적으로 적용합니다(모든 BE에서 실행하세요).
curl -X POST http://{be_ip}:{be_http_port}/api/update_config?streaming_load_max_mb=32768
3. 데이터 적재 확인
SQL로 count()를 실행하여 데이터가 정상적으로 적재되었는지 확인합니다.
mysql> SELECT COUNT() FROM amazon_reviews;
+-----------+
| count(*)  |
+-----------+
| 135589433 |
+-----------+
3단계: 성능 비교
시나리오 1: 인덱스 없이 쿼리 실행(7.60초 소요)
SELECT
    product_id,
    any_value(product_title),
    AVG(star_rating) AS rating,
    COUNT() AS count
FROM
    amazon_reviews
WHERE
    review_body LIKE '%is super awesome%'
GROUP BY
    product_id
ORDER BY
    count DESC,
    rating DESC,
    product_id
LIMIT 5;
쿼리 결과:
+------------+------------------------------------------+--------------------+-------+
| product_id | any_value(product_title)                 | rating             | count |
+------------+------------------------------------------+--------------------+-------+
| B00992CF6W | Minecraft                                | 4.8235294117647056 |    17 |
| B009UX2YAC | Subway Surfers                           | 4.7777777777777777 |     9 |
| B00DJFIMW6 | Minion Rush: Despicable Me Official Game |              4.875 |     8 |
| B0086700CM | Temple Run                               |                  5 |     6 |
| B00KWVZ750 | Angry Birds Epic RPG                     |                  5 |     6 |
+------------+------------------------------------------+--------------------+-------+
5 rows in set (7.60 sec)
시나리오 2: NGram BloomFilter 인덱스 추가 후 쿼리 실행(0.93초 소요)
인덱스를 추가합니다.
ALTER TABLE amazon_reviews
ADD INDEX review_body_ngram_idx(review_body) USING NGRAM_BF
PROPERTIES("gram_size"="10", "bf_size"="10240");
동일한 쿼리를 다시 실행합니다.
+------------+------------------------------------------+--------------------+-------+
| product_id | any_value(product_title)                 | rating             | count |
+------------+------------------------------------------+--------------------+-------+
| B00992CF6W | Minecraft                                | 4.8235294117647056 |    17 |
| B009UX2YAC | Subway Surfers                           | 4.7777777777777777 |     9 |
| B00DJFIMW6 | Minion Rush: Despicable Me Official Game |              4.875 |     8 |
| B0086700CM | Temple Run                               |                  5 |     6 |
| B00KWVZ750 | Angry Birds Epic RPG                     |                  5 |     6 |
+------------+------------------------------------------+--------------------+-------+
5 rows in set (0.93 sec)
성능 비교:
| 시나리오 | 소요 시간 | 성능 향상 |
|---|---|---|
| 인덱스 없음 | 7.60 s | 기준 |
| NGram BloomFilter 인덱스 추가 | 0.93 s | 약 8배 |
이스케이프된 LIKE 패턴의 인덱스 제한 사항
4.1.5부터 사용자 지정 ESCAPE를 사용하거나 패턴에 백슬래시가 포함된 LIKE 쿼리는 잘못된 필터링을 방지하기 위해 NGRAM Bloom Filter를 프루닝에 사용하지 않습니다. 이러한 쿼리는 일반 스캔을 통해 계속 지원됩니다. 이스케이프가 없는 LIKE 패턴은 기존 조건을 충족하면 계속 인덱스를 사용할 수 있습니다.