HNSW
HNSW(Hierarchical Navigable Small World, Malkov & Yashunin, 2016)는 운영 환경에서 비교적 적은 리소스로 높은 재현율과 낮은 지연 시간을 제공하여, 온라인 고성능 벡터 검색의 사실상 표준으로 자리 잡았습니다. Apache Doris는 4.0 버전부터 HNSW 기반 ANN(Approximate Nearest Neighbor) 인덱스를 지원합니다. 이 문서에서는 알고리즘 원리부터 시작하여 파라미터와 실제 운영 사례를 함께 살펴보고, Apache Doris 운영 클러스터에서 HNSW 인덱스를 사용하고 튜닝하는 방법을 설명합니다.
빠른 탐색
- HNSW가 처음이라면 HNSW 이전과 계층적 탐색 가능 스몰 월드에서 알고리즘의 발전 과정을 살펴보세요.
- 바로 실습하고 싶다면 Apache Doris의 HNSW에서 테이블 생성, 인덱스 구축, 쿼리 예제를 확인하세요.
- 검색 품질이 중요하다면 재현율 최적화와 벤치마크를 참조하세요.
- 리소스 비용이 중요하다면 메모리 사용량과 성능을 참조하세요.
HNSW 이전
HNSW 알고리즘은 논문 Hierarchical Navigable Small World 그래프를 이용한 효율적이고 견고한 근사 최근접 이웃 검색에서 제안되었습니다. HNSW 이전에도 업계에는 다양한 근사 KNN 검색 알고리즘이 있었지만, 각각 문제가 있었습니다.
근접 그래프
근접 그래프 알고리즘의 기본 흐름은 다음과 같습니다.
- 그래프의 진입점(임의의 정점 또는 특정 전략에 따라 선택한 정점)에서 시작하여 그래프를 반복적으로 탐색합니다.
- 각 단계에서 쿼리 벡터와 현재 기준 노드의 모든 이웃 사이의 거리를 계산하고, 거리가 가장 가까운 이웃을 다음 기준 노드로 선택합니다.
- 지금까지 찾은 최상의 후보 이웃 집합을 유지합니다.
- 종료 조건이 충족되면(예: 한 번의 반복에서 더 가까운 노드를 찾지 못한 경우) 탐색을 중단하고, 후보 집합에서 Top K를 최종 결과로 선택합니다.
근접 그래프 알고리즘은 본질적으로 Delaunay Graph의 근사 방식입니다. Delaunay Graph에는 탐욕 검색으로 항상 최근접 이웃을 찾을 수 있다는 중요한 특성이 있기 때문입니다.
하지만 이러한 알고리즘에는 두 가지 뚜렷한 단점이 있습니다.
| 단점 | 영향 |
|---|---|
| 쿼리 라우팅 단계의 반복 횟수가 데이터 규모에 따라 다항식으로 증가함 | 대규모 데이터에서 쿼리 비용이 급격히 증가함 |
| 고품질 근접 그래프를 구축하기 어렵고 국소적인 군집이 형성되기 쉬움 | 그래프의 전역 연결성이 부족해 일부 노드에 도달하기 어려움 |
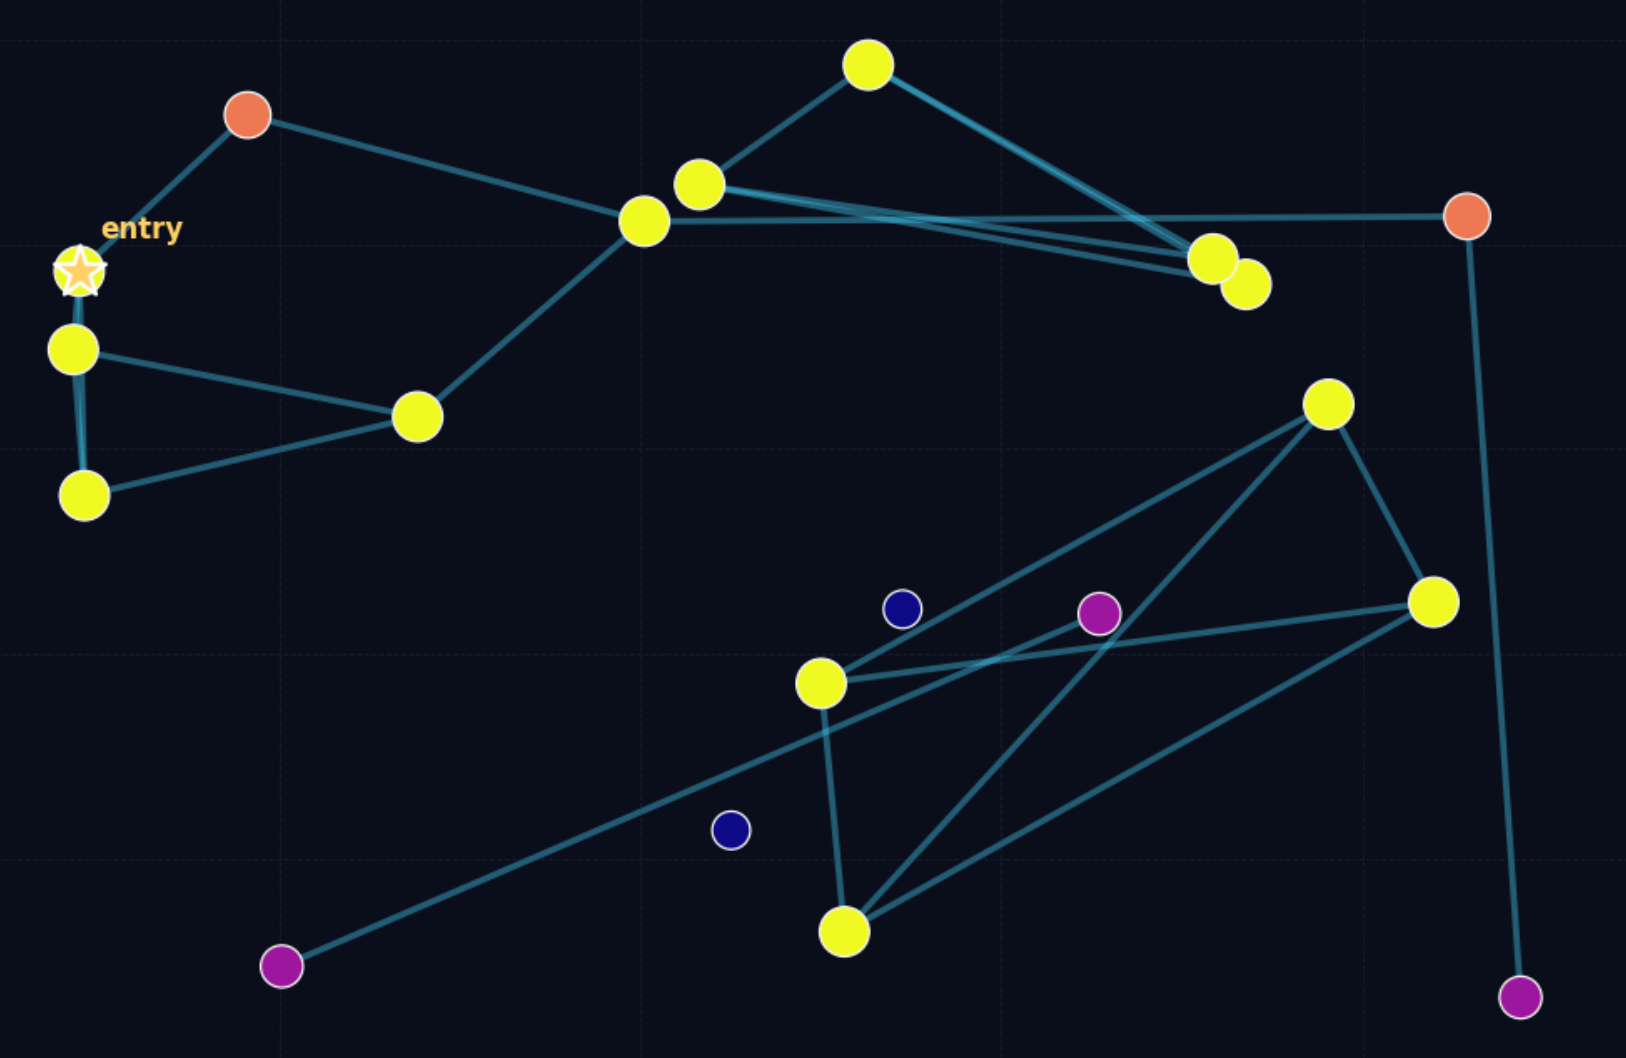
위 그림은 품질이 낮은 근접 그래프를 보여 줍니다. 점의 색이 진할수록 연결성이 떨어집니다. 일부 점은 자신의 이웃조차 거의 찾지 못하므로, 검색 단계에서 이러한 점에 도달하기 어렵습니다.
탐색 가능 스몰 월드(Navigable Small World)
위 문제를 해결하기 위해 업계에서는 두 가지 접근법을 제시했습니다.
- 하이브리드 알고리즘: 인접 그래프를 검색하기 전에 대략적인 순위 산정을 통해 더 적합한 진입점을 찾은 다음, 탐욕 검색을 수행합니다.
- 탐색 가능 스몰 월드 구조: 우수한 연결성을 확보하고 노드별 최대 이웃 수에 상한을 두어 검색 복잡도를 제어합니다.
NSW(Navigable Small World)는 두 번째 접근법을 사용합니다.
NSW 모델은 J. Kleinberg가 사회 실험에서 처음 제안했습니다. 이 모델은 사회 구성원 간의 연결 관계를 연구하는 데 사용되었으며, 유명한 여섯 단계 분리 이론과 관련이 있습니다.
K-NN 그래프 알고리즘에서는 검색 시 로그 또는 다중 로그 복잡도를 갖는 모든 스몰 월드 네트워크를 Navigable Small World Network라고 합니다. 구현 방식은 다양하며, 여기서는 다루지 않습니다.
NSW는 당시 일부 데이터셋에서 최고 수준의 검색 성능을 보였지만, 복잡도가 엄밀한 로그 복잡도는 아니므로 저차원 벡터 공간 등의 테스트 데이터셋에서는 성능이 떨어집니다.
계층적 탐색 가능 스몰 월드(Hierarchical Navigable Small World)
NSW 알고리즘의 검색 과정은 두 단계로 나뉩니다.
| 단계 | 동작 |
|---|---|
| zoom-out | 차수가 낮은 정점을 무작위로 골라 진입점으로 사용합니다. 검색 중에는 차수가 높은 노드를 우선 탐색하며, 노드에서 이웃까지의 평균 거리가 해당 노드에서 쿼리 벡터까지의 거리보다 커질 때까지 계속합니다 |
| zoom-in | 적합한 고차수 노드를 찾은 후, 최상의 TopN을 찾을 때까지 탐욕 검색을 수행합니다 |
NSW가 다중 로그 복잡도를 갖는 이유는 총 거리 계산 횟수가 대략 "홉 수 x 거쳐 간 정점의 평균 차수"에 비례하기 때문입니다. 평균 홉 수와 평균 차수 모두 데이터 규모에 따라 로그 형태로 증가하므로, 전체 복잡도는 다중 로그가 됩니다.
HNSW는 zoom-out 과정을 가속하여 쿼리 시간 복잡도를 로그 시간으로 줄입니다.
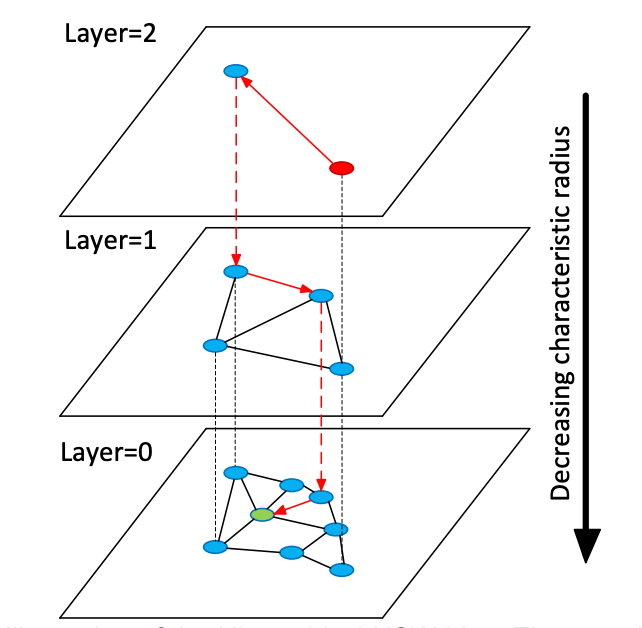
HNSW에서 "계층"은 NSW 그래프의 정점을 간선의 특성 반경에 따라 여러 계층으로 나누는 것을 의미합니다. 검색 흐름은 다음과 같습니다.
- 최상위 계층의 진입점에서 시작합니다.
- 현재 계층에서 탐욕 검색을 수행하여 해당 계층에서 가장 가까운 점을 찾습니다.
- 한 계층 아래로 이동하여 탐욕 검색을 반복합니다.
- 최하위 계층에 도달할 때까지 계속하여 최종 결과를 얻습니다.
각 계층에서 노드별 최대 연결 수에 상한이 있으므로, 전체 로그 시간 복잡도가 유지됩니다.
계층을 구성하기 위해 HNSW는 각 노드가 삽입될 때 기하 분포에 따라 해당 노드의 계층 l을 계산하여, 전체 계층 수가 지나치게 많아지지 않도록 합니다. HNSW는 데이터 적재 전에 데이터를 섞을 필요가 없습니다(NSW에서는 데이터를 반드시 섞어야 하며, 그렇지 않으면 그래프 품질이 떨어집니다). 인덱싱 중 무작위로 계층을 할당하는 과정 자체가 무작위화 단계이기 때문입니다. 이 때문에 HNSW는 진정한 증분 업데이트도 지원합니다.
Apache Doris의 HNSW
Doris는 4.0 버전부터 HNSW 알고리즘 기반 ANN 인덱스 구축을 지원합니다.
인덱스 구축
ANN 인덱스를 생성하는 방법은 두 가지입니다.
| 방법 | 구축 시점 | 장점 | 단점 |
|---|---|---|---|
| 테이블 생성 시 지정 | 데이터 적재 중 세그먼트가 생성될 때 동기적으로 구축됨 | 데이터 적재가 완료되는 즉시 인덱스로 쿼리를 가속할 수 있음 | 동기식 구축으로 데이터 적재 속도가 느려지고, 컴팩션 시 인덱스가 반복적으로 재구축됨 |
CREATE/BUILD INDEX | 데이터 적재 후 비동기적으로 구축됨 | 데이터 적재 속도에 영향을 주지 않으며 파라미터 튜닝이 쉬움 | 인덱스를 구축하는 동안 ANN 가속을 사용할 수 없음 |
방법 1: 테이블 생성 시 인덱스 지정
인덱스 파라미터가 정해져 있고 자주 튜닝할 필요가 없는 안정적인 환경에 적합합니다.
CREATE TABLE sift_1M (
    id int NOT NULL,
    embedding array<float>  NOT NULL  COMMENT "",
    INDEX ann_index (embedding) USING ANN PROPERTIES(
        "index_type"="hnsw",
        "metric_type"="l2_distance",
        "dim"="128"
    )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
    "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
    "format" = "csv");
방법 2: CREATE / BUILD INDEX
유연한 튜닝이 필요하고 데이터 적재 성능에 민감한 환경에 적합합니다.
1단계: 인덱스 없이 테이블을 생성하고 데이터를 적재합니다.
CREATE TABLE sift_1M (
    id int NOT NULL,
    embedding array<float>  NOT NULL  COMMENT ""
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
    "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
    "format" = "csv");
2단계: CREATE INDEX로 인덱스 정의를 추가합니다. 이 시점에는 인덱스 정의만 존재하며, 기존 데이터에 대한 인덱스는 아직 구축되지 않았습니다.
CREATE INDEX idx_test_ann ON sift_1M (`embedding`) USING ANN PROPERTIES (
    "index_type"="hnsw",
    "metric_type"="l2_distance",
    "dim"="128"
);

SHOW DATA ALL FROM sift_1M;
출력 예시:
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 1            | 1000000  | 170.001 MB     | 170.001 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
|           | Total     | 1            |          | 170.001 MB     | 170.001 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
2 rows in set (0.01 sec)
3단계: BUILD INDEX로 실제 구축을 시작합니다.
BUILD INDEX idx_test_ann ON sift_1M;
BUILD INDEX는 비동기적으로 실행됩니다. SHOW BUILD INDEX로 작업 상태를 확인할 수 있습니다.
SHOW BUILD INDEX WHERE TableName = "sift_1M";
출력 예시:
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| JobId         | TableName | PartitionName | AlterInvertedIndexes                                                                                                               | CreateTime              | FinishTime              | TransactionId | State    | Msg  | Progress |
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| 1763603913428 | sift_1M   | sift_1M       | [ADD INDEX idx_test_ann (`embedding`) USING ANN PROPERTIES("dim" = "128", "index_type" = "hnsw", "metric_type" = "l2_distance")],  | 2025-11-20 11:14:55.253 | 2025-11-20 11:15:10.622 | 126128        | FINISHED |      | NULL     |
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
DROP INDEX
튜닝 단계에서는 다양한 파라미터 조합을 테스트해야 할 수 있습니다. DROP INDEX로 인덱스를 유연하게 관리할 수 있습니다.
ALTER TABLE sift_1M DROP INDEX idx_test_ann;
쿼리 실행
ANN 인덱스는 TopN 검색과 범위 검색을 모두 가속할 수 있습니다.
벡터 열의 차원이 높으면 쿼리 벡터 자체를 표현하는 문자열로 인해 추가적인 파싱 오버헤드가 발생합니다. 운영 환경, 특히 동시성이 높은 환경에서는 원시 SQL을 직접 사용하여 벡터 검색을 실행하지 마세요. 대신 준비된 문을 사용하여 SQL 파싱을 미리 수행하세요.
Doris는 벡터 검색용 Python 라이브러리를 공식적으로 제공합니다. 이 라이브러리는 준비된 문을 사용하는 데 필요한 작업을 캡슐화하고, 쿼리 결과를 pandas DataFrame으로 바로 변환하는 데이터 변환 파이프라인을 통합하여 Doris 기반 AI 애플리케이션 개발을 편리하게 해 줍니다.
from doris_vector_search import DorisVectorClient, AuthOptions

auth = AuthOptions(
    host="localhost",
    query_port=9030,
    user="root",
    password="",
)

client = DorisVectorClient(database="demo", auth_options=auth)

tbl = client.open_table("sift_1M")

query = [0.1] * 128  # Example 128-dimensional vector

# SELECT id FROM sift_1M ORDER BY l2_distance_approximate(embedding, query) LIMIT 10;
result = tbl.search(query, metric_type="l2_distance").limit(10).select(["id"]).to_pandas()

print(result)
실행 결과 예시:
       id
0  123911
1   11743
2  108584
3  123739
4   73311
5  124746
6  620941
7  124493
8  177392
9  153178
재현율 최적화
벡터 검색에서 가장 중요한 지표는 재현율입니다. 성능 수치는 일정 수준의 재현율을 충족할 때만 의미가 있습니다. 재현율에 영향을 미치는 주요 요인은 다음과 같습니다.
- HNSW 인덱싱 단계 파라미터(
max_degree,ef_construction)와 쿼리 단계 파라미터(ef_search) - 인덱스 벡터 양자화
- 세그먼트의 크기와 개수
이 절에서는 항목 1과 3을 다룹니다. 벡터 양자화는 다른 문서에서 설명합니다.
인덱스 하이퍼파라미터
HNSW 인덱스는 벡터를 계층적 그래프로 구성합니다. 구축 단계는 크게 세 단계로 이루어집니다.
- 여러 계층에 무작위 할당: 각 벡터를 여러 계층에 무작위로 할당합니다. 상위 계층일수록 더 희소하며, 빠른 탐색에 사용됩니다.
ef_construction을 사용한 후보 이웃 검색: 각 계층에서 HNSW는 최대 길이가ef_construction인 후보 큐를 사용하여 너비 우선 국소 검색을 수행합니다. 값이 클수록 더 정확한 이웃과 더 나은 그래프 구조를 얻지만, 구축 시간이 길어집니다.max_degree를 사용한 연결 수 제한: 노드별 이웃 수를max_degree로 제한하여 그래프가 지나치게 조밀해지는 것을 방지합니다.
쿼리 단계는 두 단계로 이루어집니다.
- 상위 계층 탐욕 검색(Coarse search): 진입점에서 시작하여 상위 계층에서 위에서 아래로 탐욕 검색을 수행하고, 목표 영역에 빠르게 접근합니다.
- 최하위 계층 너비 우선 검색(Fine search): 계층 0에서 최대 길이가
ef_search인 후보 큐를 사용하여 이웃 영역을 더 철저하게 확장합니다.
핵심 파라미터 세 가지의 역할과 상충 관계는 다음과 같습니다.
| 파라미터 | 역할 | 기본값 | 값을 늘렸을 때의 영향 |
|---|---|---|---|
max_degree | 그래프의 노드별로 저장되는 양방향 간선 수 | 32 | 재현율 증가, 메모리 사용량 증가, 쿼리 성능 저하 |
ef_construction | 인덱싱 단계에서 후보 큐의 최대 길이 | 40 | 그래프 품질 향상, 재현율 증가, 구축 시간 증가 |
ef_search | 쿼리 단계에서 후보 큐의 최대 길이 | 32 | 재현율 증가, 거리 계산 횟수 증가, 쿼리 지연 시간 및 CPU 비용 증가 |
아래 표는 SIFT_1M 데이터셋의 측정 결과입니다.
| max_degree | ef_construction | ef_search | recall@1 | recall@100 |
|---|---|---|---|---|
| 32 | 80 | 32 | 0.955 | 0.75335 |
| 32 | 80 | 64 | 0.98 | 0.88015 |
| 32 | 80 | 96 | 0.995 | 0.9328 |
| 32 | 120 | 32 | 0.96 | 0.7736 |
| 32 | 120 | 64 | 0.975 | 0.89865 |
| 32 | 120 | 96 | 0.99 | 0.94575 |
| 32 | 160 | 32 | 0.955 | 0.78745 |
| 32 | 160 | 64 | 0.98 | 0.9097 |
| 32 | 160 | 96 | 0.995 | 0.95485 |
| 48 | 80 | 32 | 0.985 | 0.85895 |
| 48 | 80 | 64 | 0.99 | 0.9453 |
| 48 | 80 | 96 | 1 | 0.97325 |
| 48 | 120 | 32 | 0.97 | 0.78335 |
| 48 | 120 | 64 | 1 | 0.9089 |
| 48 | 120 | 96 | 1 | 0.95325 |
| 48 | 160 | 32 | 0.975 | 0.79745 |
| 48 | 160 | 64 | 0.995 | 0.9192 |
| 48 | 160 | 96 | 0.995 | 0.9601 |
| 64 | 80 | 32 | 1 | 0.9026 |
| 64 | 80 | 64 | 1 | 0.97025 |
| 64 | 80 | 96 | 1 | 0.9862 |
| 64 | 120 | 32 | 0.985 | 0.8548 |
| 64 | 120 | 64 | 0.99 | 0.94755 |
| 64 | 120 | 96 | 0.995 | 0.97645 |
| 64 | 160 | 32 | 0.97 | 0.80585 |
| 64 | 160 | 64 | 0.99 | 0.91925 |
| 64 | 160 | 96 | 0.995 | 0.96165 |
표에서 볼 수 있듯이 여러 파라미터 조합으로 동일한 수준의 재현율을 달성할 수 있습니다. 예를 들어 recall@100 > 95%를 목표로 할 때, 조건을 충족하는 조합은 다음과 같습니다.
| max_degree | ef_construction | ef_search | recall@1 | recall@100 |
|---|---|---|---|---|
| 32 | 160 | 96 | 0.995 | 0.95485 |
| 48 | 80 | 96 | 1 | 0.97325 |
| 48 | 120 | 96 | 1 | 0.95325 |
| 48 | 160 | 96 | 0.995 | 0.9601 |
| 64 | 80 | 64 | 1 | 0.97025 |
| 64 | 80 | 96 | 1 | 0.9862 |
| 64 | 120 | 96 | 0.995 | 0.97645 |
| 64 | 160 | 96 | 0.995 | 0.96165 |
하이퍼파라미터를 선택하는 실용적인 방법:
- 인덱스가 없고 여러 벡터 열(벡터 열 2~3개)을 포함하는 테이블
table_multi_index를 생성합니다. - Stream Load 등의 방법으로 이 테이블에 데이터를 적재합니다.
CREATE INDEX와BUILD INDEX로 모든 벡터 열에 인덱스를 구축하되, 열마다 서로 다른 파라미터 조합을 사용합니다.- 인덱스 구축이 완료되면 각 열의 재현율을 별도로 계산하고 가장 적합한 하이퍼파라미터 조합을 선택합니다.
인덱스가 처리할 수 있는 행 수
Doris 내부 테이블의 데이터는 계층적으로 구성됩니다.
| 계층 | 의미 |
|---|---|
| 테이블 | 최상위 개념 |
| 태블릿(Tablet) | 데이터 마이그레이션과 리밸런싱의 기본 단위. 테이블 데이터는 버킷 키에 따라 N개의 태블릿에 고르게 분산됨 |
| Rowset | 버전 관리의 기본 단위. 데이터 적재 또는 컴팩션이 수행될 때마다 태블릿 아래에 새로운 rowset이 추가됨 |
| 세그먼트(Segment) | 데이터를 저장하는 실제 파일 |
역색인과 마찬가지로 벡터 인덱스도 세그먼트 단위로 동작합니다. 세그먼트 크기는 BE 설정인 write_buffer_size와 vertical_compaction_max_segment_size에 따라 결정됩니다. 데이터 적재 및 컴팩션 중 memtable이 일정 크기에 도달하면 세그먼트 파일로 플러시되며, 해당 세그먼트에 대한 벡터 인덱스가 구축됩니다(인덱스 열마다 인덱스 하나씩).
HNSW의 검색 및 구축 메커니즘에 따르면, 주어진 인덱스 파라미터 조합으로 효과적으로 처리할 수 있는 데이터 범위에는 한계가 있습니다. 데이터 규모가 임계값을 넘으면 재현율이 더 이상 요구 수준을 충족하지 못합니다.
다음은 일부 하이퍼파라미터 조합과 해당 조합으로 처리할 수 있는 세그먼트별 행 수의 경험적 수치입니다.
| max_degree | ef_construction | ef_search | num_segment | recall@100 |
|---|---|---|---|---|
| 32 | 160 | 96 | 1M | 0.95485 |
| 48 | 80 | 96 | 1M | 0.97325 |
| 32 | 160 | 32 | 3M | 0.66983 |
| 128 | 512 | 128 | 3M | 0.9931 |
SHOW TABLETS FROM <table>을 실행하여 테이블의 컴팩션 상태를 확인하세요. 해당 URL을 클릭하면 세그먼트 수를 확인할 수 있습니다.
컴팩션이 재현율에 미치는 영향
컴팩션으로 더 큰 세그먼트가 생성되면, 기존 인덱스 하이퍼파라미터로는 새로 커진 세그먼트를 충분히 처리하지 못할 수 있습니다.
권장 방법: FULL COMPACTION을 수행한 다음 BUILD INDEX를 실행하세요. 컴팩션을 완전히 마친 세그먼트에 인덱스를 구축하면 다음 두 가지 이점이 있습니다.
- 안정적인 재현율
- 인덱스 구축으로 발생하는 쓰기 증폭 감소
쿼리 성능
인덱스 파일의 콜드 로딩
Doris ANN 인덱스는 Meta의 오픈 소스 faiss를 기반으로 구현되었습니다. HNSW 인덱스는 전체 그래프 구조를 메모리에 로딩한 후에만 쿼리를 가속할 수 있습니다.
동시성이 높은 쿼리를 실행하기 전에 콜드 쿼리를 먼저 실행하여 관련 세그먼트의 인덱스 파일을 메모리에 미리 로딩하세요. 그렇지 않으면 쿼리 성능이 크게 떨어집니다.
메모리 사용량과 성능
양자화 압축을 적용하지 않은 HNSW 인덱스는 인덱싱 대상 벡터 메모리의 약 1.3배를 차지합니다.
예를 들어 128차원, 1M 데이터셋의 경우 HNSW FLAT 인덱스에는 약 128 x 4 x 1,000,000 x 1.3 ~= 650 MB가 필요합니다.
데이터 규모별 예상 메모리 사용량은 다음과 같습니다.
| dim | rows | 예상 메모리 |
|---|---|---|
| 128 | 1M | 650 MB |
| 768 | 10M | 48 GB |
| 768 | 100M | 110 GB |
쿼리 성능을 보장하려면 BE 노드에 충분한 메모리를 구성해야 합니다. 그렇지 않으면 빈번한 인덱스 I/O로 인해 쿼리 성능이 크게 저하됩니다.
벤치마크
테스트 하드웨어: 16C 64GB 머신. 테스트 프레임워크: VectorDBBench. 부하 클라이언트: 별도의 16C 머신.
Doris 운영 클러스터의 일반적인 배포 방식은 FE와 BE를 분리 배포하는 것입니다(16C 64GB 머신 두 대 필요). 아래 표에는 일반적인 배포 방식과 함께 FE와 BE를 혼합 배포한 테스트 결과도 나와 있습니다.
Performance768D1M
테스트 명령어:
NUM_PER_BATCH=1000000 python3.11 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --search-concurrent --search-serial --num-concurrency 10,40,80 --stream-load-rows-per-batch 500000 --index-prop max_degree=128,ef_construction=512 --session-var hnsw_ef_search=128
테스트 결과 비교:
| Doris (FE/BE 분리) | Doris (FE/BE 혼합) | |
|---|---|---|
| 인덱스 속성 | max_degree=128, ef_construction=512, hnsw_ef_search=128 | max_degree=128, ef_construction=512, hnsw_ef_search=156 |
| Recall@100 | 0.9931 | 0.9929 |
| 동시성(클라이언트) | 10, 40, 80 | 10, 40, 80 |
| 결과 QPS | 163.1567 (10) 606.6832 (40) 859.3842 (80) | 162.3002 (10) 542.3488 (40) 607.7951 (80) |
| 평균 지연 시간(s) | 0.06123 (10) 0.06579 (40) 0.09281 (80) | 0.06154 (10) 0.07351 (40) 0.13093 (80) |
| P95 지연 시간(s) | 0.06560 (10) 0.07747 (40) 0.12967 (80) | 0.06726 (10) 0.08789 (40) 0.18719 (80) |
| P99 지연 시간(s) | 0.06889 (10) 0.08618 (40) 0.14605 (80) | 0.06154 (10) 0.07351 (40) 0.13093 (80) |