대규모 성능 벤치마크
이 문서는 중대규모 및 억 단위 데이터셋에서 Doris ANN Index의 실제 데이터 적재 및 쿼리 성능 벤치마크를 제시합니다. 데이터 규모별 쿼리 성능을 평가하고, 단일 노드 배포에서 분산 배포로 원활하게 확장하는 방법을 이해하는 데 도움이 됩니다.
빠른 탐색
이 문서를 읽으면 다음 질문에 답할 수 있습니다.
- 수천만 개의 벡터를 처리할 때 단일 BE 노드로 온라인 검색을 수행할 수 있나요? 어느 정도의 QPS와 지연 시간을 기대할 수 있나요?
- 수억 개의 벡터를 처리하다가 단일 노드의 메모리가 부족해지면, 여러 BE를 배포하여 벡터 쿼리를 계속 제공하려면 어떻게 해야 하나요?
- 벡터 차원(768/1536)과 거리 메트릭(
inner_product/l2_distance)에 따라 성능이 어떻게 달라지나요? - 이 테스트 결과를 어떻게 재현할 수 있나요?
테스트 환경 및 데이터셋
배포 토폴로지
| 배포 모드 | BE 노드 수 | 노드별 사양 | 적합한 데이터 규모 |
|---|---|---|---|
| 단일 노드 | 1 | 16C64GB | 수천만 단위 |
| 분산 | 3 | 16C64GB | 수억 단위 |
FE와 BE는 별도로 배포합니다. 모든 테스트는 VectorDBBench 도구를 사용합니다.
데이터셋 개요
| 데이터셋 | 데이터량 | 벡터 차원 | 거리 메트릭 | 배포 토폴로지 |
|---|---|---|---|---|
| Performance768D10M | 10M | 768 | inner_product | 단일 노드 |
| Performance1536D5M | 5M | 1536 | inner_product | 단일 노드 |
| Performance768D100M | 100M | 768 | l2_distance | 분산 |
단일 노드 벤치마크 (16C64GB)
단일 노드 결과는 중대규모 데이터셋의 ANN 쿼리 성능을 평가하는 기준을 제공합니다.
데이터 적재 성능
두 데이터셋의 데이터 적재 지표는 다음과 같습니다.
| 항목 | Performance768D10M | Performance1536D5M |
|---|---|---|
| 벡터 차원 | 768 | 1536 |
metric_type | inner_product | inner_product |
| 데이터량 | 10M행 | 5M행 |
| 데이터 적재 배치 매개변수 | NUM_PER_BATCH=500000--stream-load-rows-per-batch 500000 | NUM_PER_BATCH=250000--stream-load-rows-per-batch 250000 |
| 데이터 적재 시간 | 76m41s | 41m |
show data all | 56.498 GB (25.354 GB + 31.145 GB) | 55.223 GB (25.346 GB + 29.878 GB) |
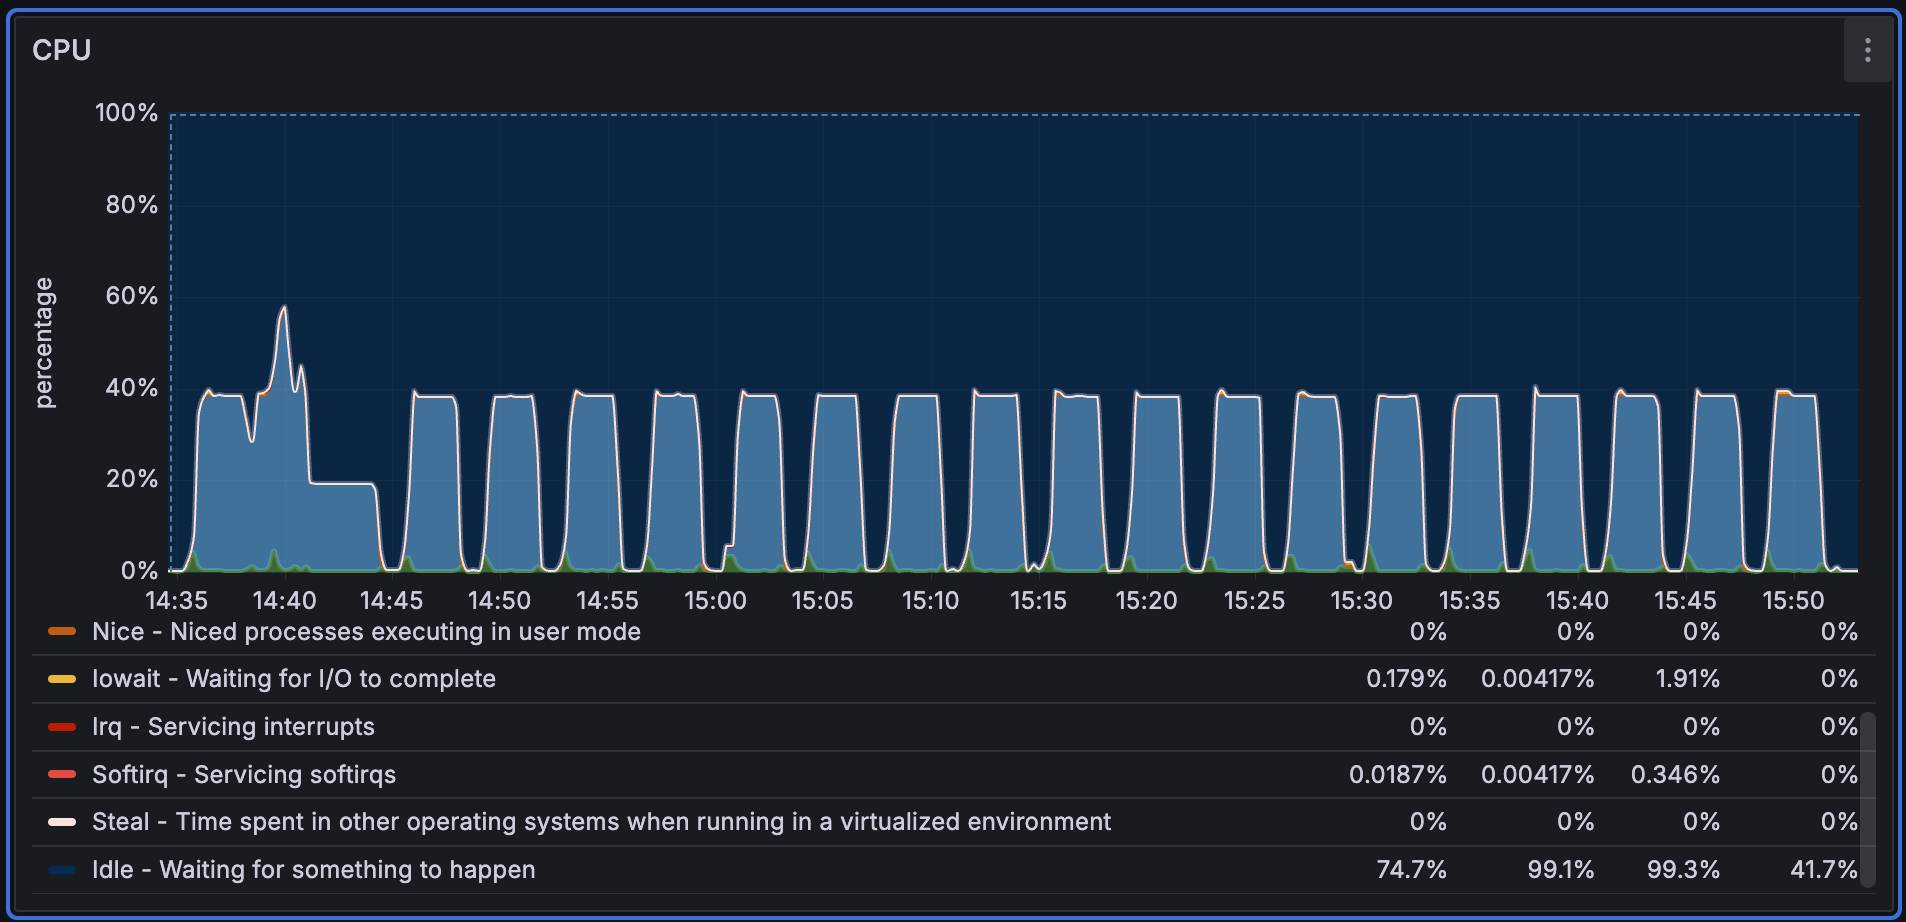
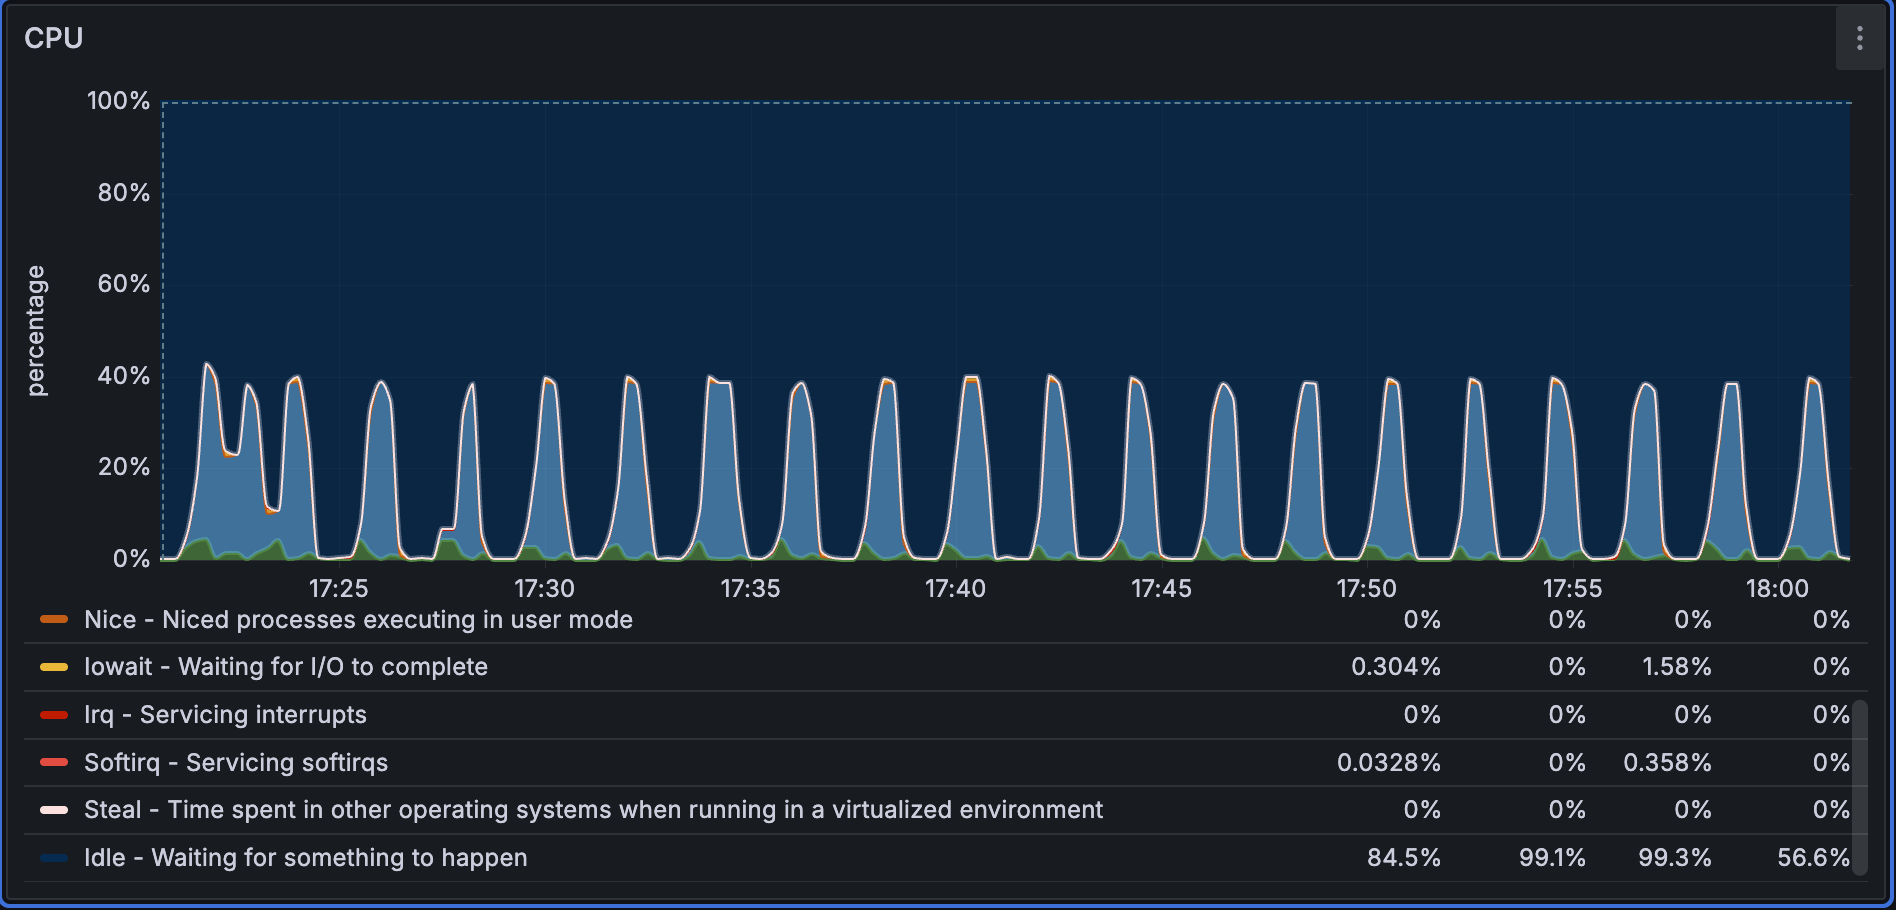
CPU 사용률:
-
Performance768D10M의 데이터 적재 중 CPU 사용률은 전반적으로 비교적 안정적이었습니다.
-
Performance1536D5M은 데이터량과 배치 크기가 더 작아 데이터 적재 단계에서 CPU 사용률이 더 자주 변동합니다.
쿼리 성능
단일 노드 배포는 높은 재현율을 유지하면서 수백 QPS에 도달하고 쿼리 지연 시간을 낮게 유지할 수 있습니다.
요약 지표
| 데이터셋 | BestQPS | Recall@100 |
|---|---|---|
| Performance768D10M | 481.9356 | 0.9207 |
| Performance1536D5M | 414.7342 | 0.9677 |
Performance768D10M 상세 결과 (inner_product, 10M행)
| 동시 실행 수 | QPS | P95 지연 시간 | P99 지연 시간 | 평균 지연 시간 |
|---|---|---|---|---|
| 10 | 116.2000 | 0.0932 | 0.0933 | 0.0861 |
| 40 | 455.9485 | 0.1102 | 0.1225 | 0.0877 |
| 80 | 481.9356 | 0.2331 | 0.2674 | 0.1658 |
Performance1536D5M 상세 결과 (inner_product, 5M행)
| 동시 실행 수 | QPS | P95 지연 시간 | P99 지연 시간 | 평균 지연 시간 |
|---|---|---|---|---|
| 10 | 144.3221 | 0.0764 | 0.0800 | 0.0693 |
| 40 | 401.9732 | 0.1271 | 0.1404 | 0.0994 |
| 80 | 414.7342 | 0.2772 | 0.3222 | 0.1925 |
CPU 모니터링
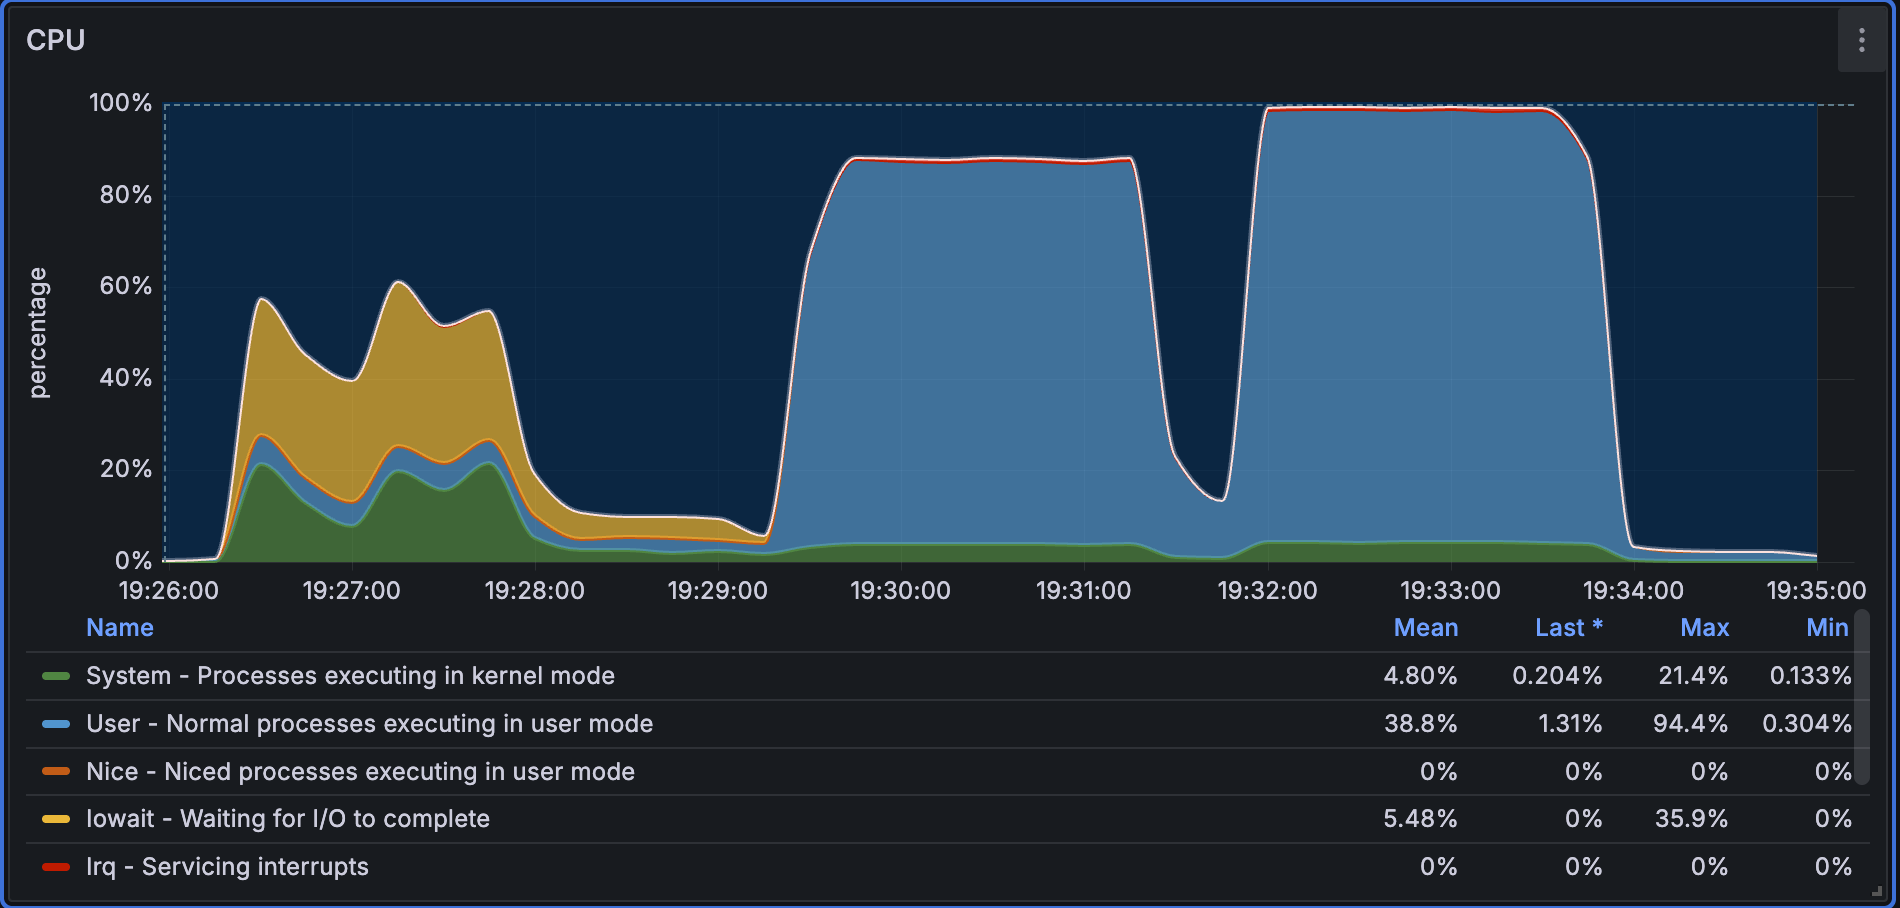
콜드 쿼리 단계에서는 인덱스를 메모리에 불러와야 하므로 CPU 사용률이 비교적 낮고, 시스템은 주로 IO를 기다립니다. 핫 쿼리 단계에 진입하면 CPU 사용률이 크게 상승하여 100%에 가까워집니다.
분산 벤치마크 (3 x 16C64GB)
데이터 규모가 단일 16C64GB 노드의 적정 메모리 용량을 초과하면 여러 BE를 배포하여 수평 확장할 수 있습니다. 이 절에서는 Performance768D100M 데이터셋(100M행, 768차원)을 사용하여 Doris가 100M 규모에서도 온라인 벡터 쿼리 기능을 제공할 수 있음을 보여 줍니다.
이 테스트는 소규모 단일 노드 테스트와 절대 수치를 일대일로 비교하기 위한 것이 아닙니다. 데이터 크기에 따라 성능이 어떻게 달라지는지 살펴보는 데 더 적합합니다.
데이터 적재 및 인덱스 구축
노드당 메모리 한도가 64GB이므로 이 테스트에서는 벡터 양자화 압축을 사용하여 메모리 사용량을 줄입니다.
| 항목 | 값 |
|---|---|
| 데이터셋 | Performance768D100M |
| 데이터량 | 100M행 |
| 벡터 차원 | 768 |
| 배치 매개변수 | NUM_PER_BATCH=500000--stream-load-rows-per-batch 500000 |
| 인덱스 매개변수 | "dim"="768", "index_type"="hnsw", "metric_type"="l2_distance", "pq_m"="384", "pq_nbits"="8", "quantizer"="pq" |
| 인덱스 구축 시간 | 4h5min |
show data all | 198.809 GB (137.259 GB + 61.550 GB) |
인덱스 구축 후 데이터 분포:
- 총 3개의 버킷
- 각 버킷에는 34개의 rowset이 있으며, 각 rowset의 크기는 약 1.99 GB
- 각 rowset에는 6개의 segment가 포함됨
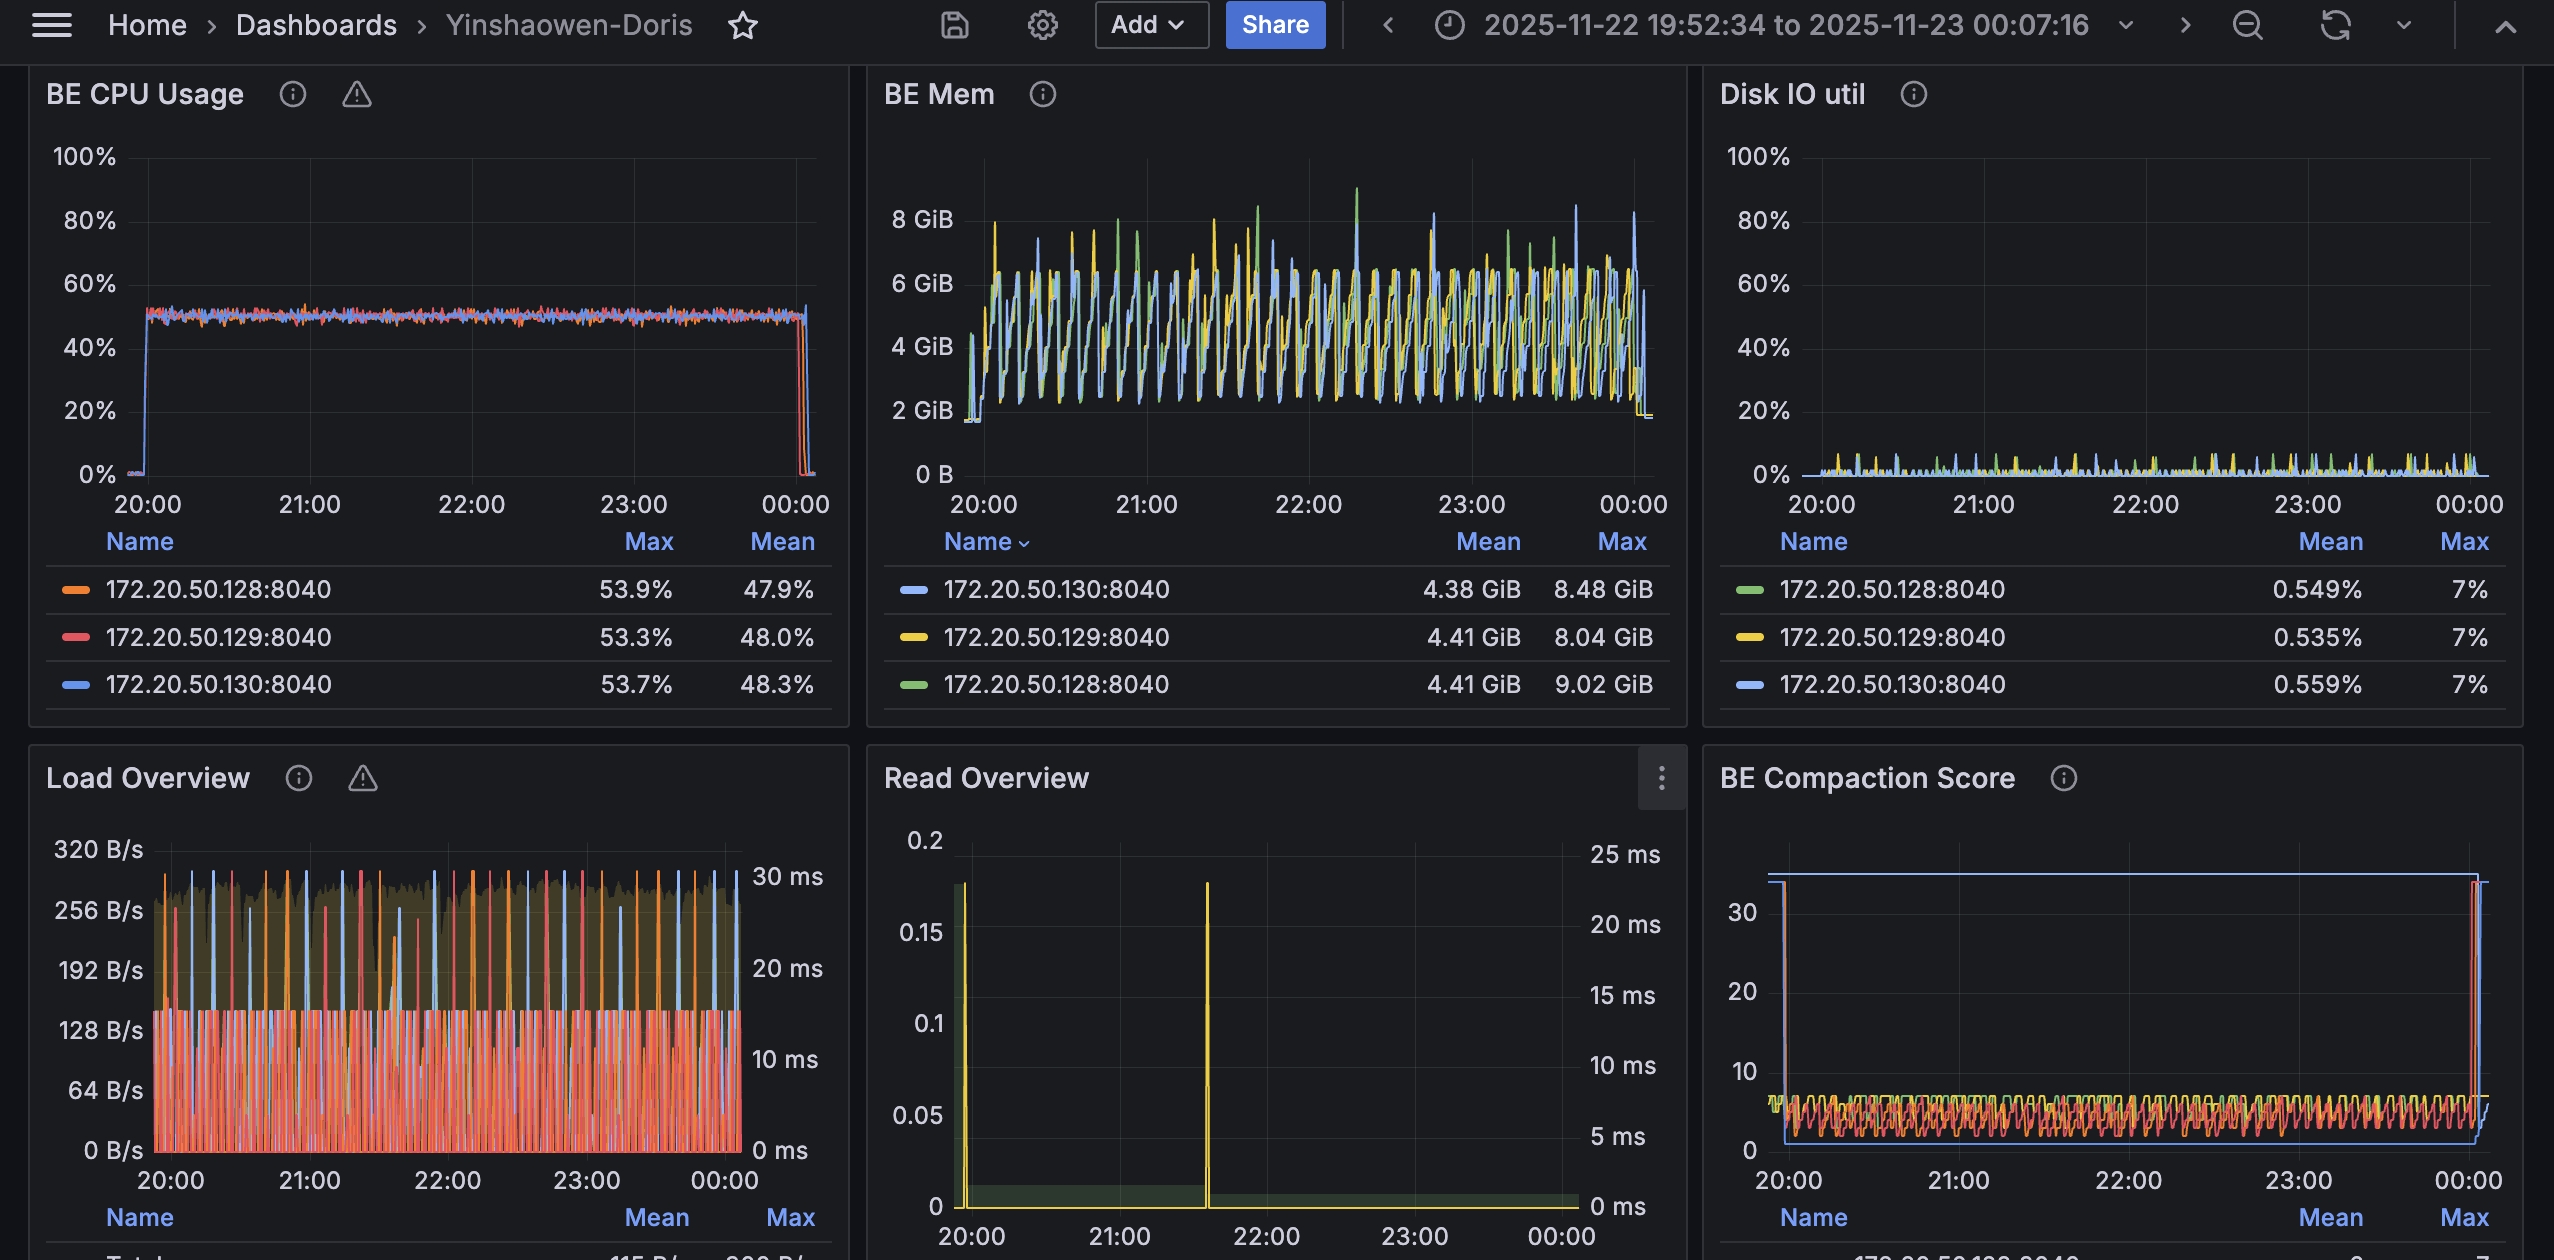
CPU 사용률: 인덱스 구축 중 CPU 사용률은 전반적으로 50% 내외에서 안정적으로 유지되었습니다. CPU가 장시간 최대 부하 상태로 동작하지 않아 리소스에 어느 정도 여유가 있었습니다.
쿼리 성능
요약 지표
| 지표 | 값 |
|---|---|
| BestQPS | 77.6247 |
| Recall@100 | 0.9294 |
상세 결과 (l2_distance, 100M행)
| 동시 실행 수 | QPS | P95 지연 시간 | P99 지연 시간 | 평균 지연 시간 |
|---|---|---|---|---|
| 10 | 46.5836 | 0.2628 | 0.2791 | 0.2145 |
| 20 | 75.3579 | 0.3251 | 0.3541 | 0.2651 |
| 30 | 77.6247 | 0.5222 | 0.5766 | 0.3860 |
| 40 | 76.6313 | 0.7089 | 0.7854 | 0.5212 |
CPU 모니터링
쿼리 단계에서는 각 노드의 CPU 사용률이 높은 수준으로 유지됩니다. 이는 쿼리 워크로드가 분산 컴퓨팅 리소스를 효과적으로 활용하고 있음을 보여 줍니다.
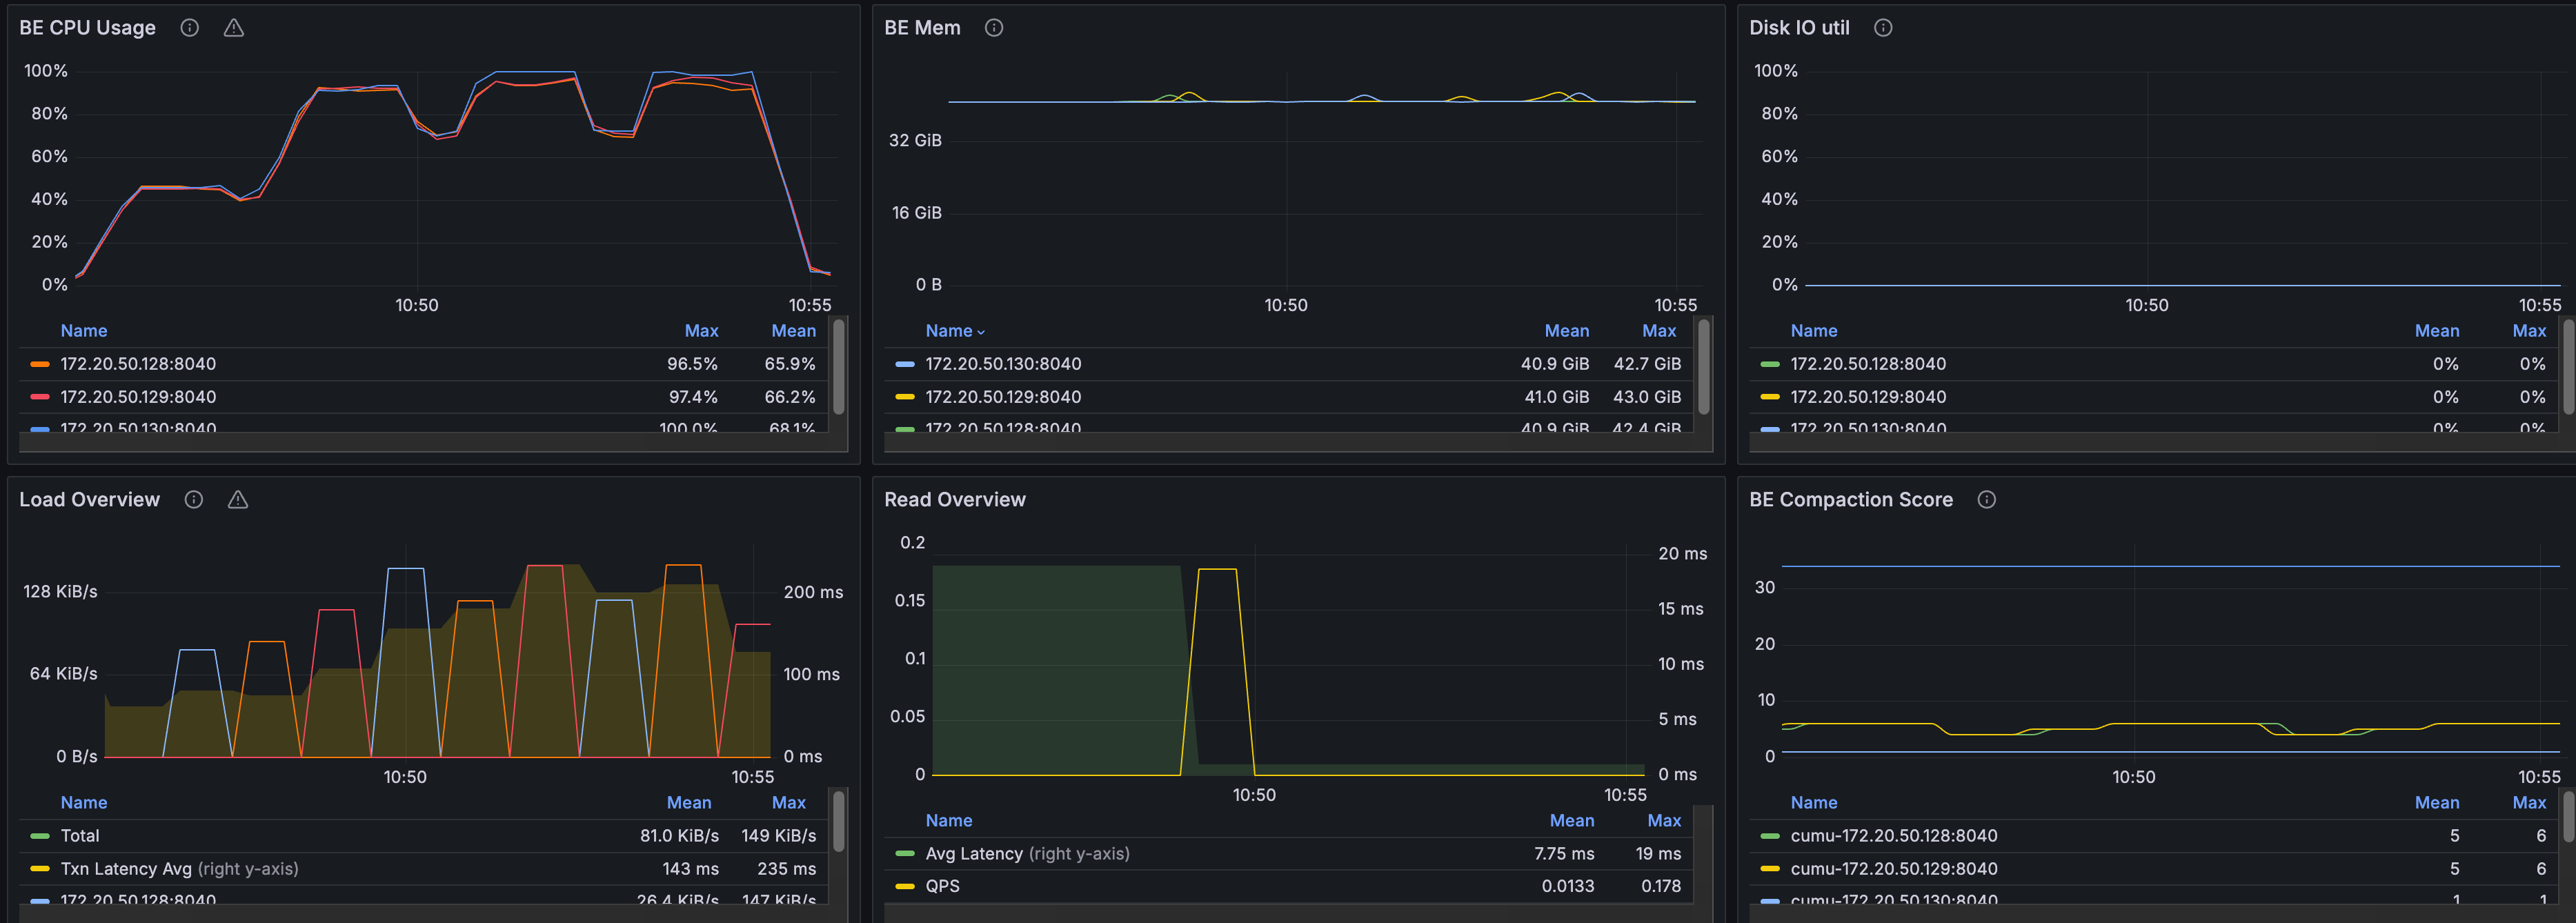
주요 결론
- 단일 노드에서 수천만 단위 처리: 수천만 개의 벡터 데이터 규모에서 Doris 단일 노드 배포는 높은 재현율(>=0.92)을 유지하면서 ANN 쿼리에 수백 QPS를 제공할 수 있습니다.
- 분산 환경에서 수억 단위 처리: 100M 벡터 데이터셋에서는 여러 BE를 배포하고 벡터 양자화 압축을 함께 사용하여 온라인 벡터 쿼리 기능을 계속 제공할 수 있습니다(BestQPS 약 77, Recall@100 약 0.93).
- 수평 확장성: 데이터 규모가 단일 노드의 메모리 용량을 초과하면, 분산 배포를 통해 온라인 검색 기능을 유지할 수 있습니다.
테스트 참고 사항
이 결과를 살펴볼 때는 다음 사항을 고려하세요.
- 거리 메트릭의 차이: 단일 노드 테스트는
inner_product를 사용하고, 분산 테스트는l2_distance를 사용합니다. 절대 수치를 나란히 놓고 직접 비교하는 것은 권장하지 않습니다. - 데이터 규모 및 인덱스 매개변수의 차이: 테스트 그룹마다 데이터 규모와 인덱스 매개변수(예: 양자화 사용 여부)가 다릅니다. 이 결과는 데이터 크기에 따라 성능이 어떻게 달라지는지 살펴보는 데 더 적합합니다.
- 콜드 쿼리 영향 보정: 단일 노드
Performance768D10M테스트에서는 콜드 쿼리의 영향을 제거한 후 동시 실행 수 10의 결과를 보정했습니다.
재현 방법
테스트는 VectorDBBench 도구로 실행합니다.
단일 노드 환경에서 재현
# Performance768D10M
export NUM_PER_BATCH=500000
vectordbbench doris ... --case-type Performance768D10M --stream-load-rows-per-batch 500000

# Performance1536D5M
export NUM_PER_BATCH=250000
vectordbbench doris ... --case-type Performance1536D5M --stream-load-rows-per-batch 250000
분산 3BE 환경에서 재현
export NUM_PER_BATCH=500000
vectordbbench doris ... --case-type Performance768D100M --stream-load-rows-per-batch 500000
자주 묻는 질문
Q1: 단일 16C64GB 노드는 벡터를 최대 몇 개까지 저장할 수 있나요?
벡터 차원, 양자화 사용 여부, 인덱스 매개변수에 따라 달라집니다. 이 문서에서는 768차원 10M행(약 56 GB)을 단일 16C64GB 노드에서 안정적으로 처리합니다. 데이터 규모가 더 커지거나 차원이 더 높아지면 벡터 양자화를 사용하거나 여러 BE로 구성된 분산 배포를 사용하세요.
Q2: 분산 테스트의 QPS가 단일 노드 테스트보다 낮은 이유는 무엇인가요?
두 테스트 그룹은 거리 메트릭, 데이터 규모, 인덱스 매개변수가 다르므로(분산 테스트에서는 PQ 양자화 사용) 절대 수치를 직접 비교할 수 없습니다. 분산 테스트의 목적은 QPS를 극대화하는 것이 아니라 대규모 데이터에서의 확장성을 검증하는 것입니다.
Q3: 100M 데이터셋에서 양자화가 필요한 이유는 무엇인가요?
노드당 메모리 한도는 64GB이며, 100M개의 768차원 벡터는 원본 크기만으로도 이 용량을 초과합니다. PQ 양자화(pq_m=384, pq_nbits=8)는 메모리 사용량을 크게 줄여 대규모 온라인 검색을 가능하게 합니다.
Q4: 데이터 적재 시간에 인덱스 구축 시간이 포함되나요?
단일 노드 테스트에서 "데이터 적재 시간"은 전체 쓰기 시간을 의미합니다. 인덱스는 쓰기 중 또는 백그라운드 compaction 단계에서 구축됩니다. 분산 테스트에서는 대규모 환경의 인덱스 구축 비용을 평가할 수 있도록 build index time을 별도로 표시합니다.