벡터 양자화 알고리즘 비교 및 선택
이 문서는 교육 및 엔지니어링 관점에서 일반적인 벡터 양자화 알고리즘을 소개하고, Apache Doris ANN 사용 사례에 맞는 선택 지침을 제공합니다. Apache Doris는 현재 최적화된 Faiss 버전을 ANN 벡터 인덱싱 및 검색의 핵심 구현으로 사용하므로, 아래에서 설명하는 SQ/PQ 메커니즘은 실제 Doris 동작에 직접 대응합니다.
빠른 탐색
독자가 해결하려는 문제에 따라 다음 섹션을 참고하세요.
| 해결하려는 문제 | 바로 가기 |
|---|---|
| 양자화가 왜 필요한지 모르겠음 | 벡터 양자화가 필요한 이유 |
| 양자화 방식을 빠르게 선택하고 싶음 | Doris 선택 지침 |
| SQ8/SQ4의 동작 방식을 이해하고 싶음 | 스칼라 양자화(SQ) |
| PQ의 원리와 장점을 이해하고 싶음 | 곱 양자화(PQ) |
| 공정한 벤치마크 비교를 수행하고 싶음 | 벤치마크 고려 사항 |
| 자주 묻는 질문 | 자주 묻는 질문 |
한 문장으로 보는 정의
- 벡터 양자화: float32와 같은 고정밀 벡터를 저정밀 표현으로 인코딩하여, 허용 가능한 수준의 재현율 저하를 감수하는 대신 메모리 사용량을 줄이고 검색 속도를 높입니다.
- SQ(스칼라 양자화): 각 차원의 정밀도를 독립적으로 낮춥니다.
- PQ(곱 양자화): 벡터를 여러 하위 벡터로 나누고 각 하위 공간에서 클러스터링 기반 인코딩을 수행합니다.
벡터 양자화가 필요한 이유
ANN 시나리오, 특히 HNSW에서는 인덱스가 메모리 제약을 받는 경우가 많습니다. 양자화의 핵심 아이디어는 float32와 같은 고정밀 벡터를 저정밀 표현으로 인코딩하여, 허용 가능한 수준의 재현율 저하를 감수하는 대신 메모리 사용량을 줄이는 것입니다.
Doris에서는 ANN 인덱스의 quantizer로 양자화 방식을 제어합니다.
| quantizer | 의미 | float32 대비 압축률 |
|---|---|---|
flat | 양자화하지 않음(품질과 메모리 사용량이 가장 높음) | 1배 |
sq8 | 8비트 스칼라 양자화 | 약 4배 |
sq4 | 4비트 스칼라 양자화 | 약 8배 |
pq | 곱 양자화 | pq_m과 pq_nbits에 따라 달라짐 |
최소 예제(HNSW + 양자화 방식):
CREATE TABLE vector_tbl (
    id BIGINT,
    embedding ARRAY<FLOAT>,
    INDEX ann_idx (embedding) USING ANN PROPERTIES (
        "index_type" = "hnsw",
        "metric_type" = "l2_distance",
        "dim" = "768",
        "quantizer" = "sq8"
    )
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 8
PROPERTIES ("replication_num" = "3");
알고리즘 개요
| 방식 | 핵심 아이디어 | 일반적인 이점 | 주요 비용 |
|---|---|---|---|
| SQ(스칼라 양자화) | 각 차원을 독립적으로 양자화 | 메모리 사용량을 크게 줄이고 구현이 간단함 | FLAT보다 빌드 비용이 높으며, 압축을 강화할수록 재현율이 낮아지는 경향이 있음 |
| PQ(곱 양자화) | 하위 벡터로 나누어 그룹별로 양자화 | 일반적인 시나리오에서 압축률과 쿼리 속도의 균형이 더 좋음 | 학습/인코딩 비용이 높고 매개변수 튜닝이 필요함 |
스칼라 양자화(SQ)
원리
SQ는 벡터의 차원 수를 바꾸지 않습니다. 각 차원의 수치 정밀도만 낮춥니다.
일반적인 min-max 양자화 매핑은 다음과 같습니다.
max_code = (1 << b) - 1scale = (max_val - min_val) / max_codecode = round((x - min_val) / scale)
Faiss의 SQ에는 두 가지 주요 유형이 있습니다.
| 유형 | 범위 통계 산출 방식 | 적합한 시나리오 |
|---|---|---|
| 균일 | 모든 차원이 하나의 최솟값/최댓값 쌍을 공유 | 차원별 값의 크기가 비슷한 경우 |
| 비균일 | 각 차원을 별도로 통계 분석 | 차원별 값의 크기가 뚜렷하게 다른 경우에 재구성 오차가 더 작음 |
특징
장점:
- 구현이 직관적이고 동작이 안정적입니다.
- 압축률을 예측할 수 있습니다(float32 값 대비
sq8은 약 4배,sq4는 약 8배).
한계:
- 근본적으로는 고정 간격으로 구간을 나누는 방식입니다.
- 단일 차원의 분포가 뚜렷하게 비균일한 경우(예: 롱테일 분포) 오차가 커집니다.
Faiss 소스 코드 핵심(SQ)
Doris가 사용하는 최적화된 Faiss 구현 경로에서 SQ 학습은 먼저 최솟값과 최댓값을 계산한 다음, 필요에 따라 범위를 약간 넓혀 이후 추가 단계에서 값이 범위를 벗어날 위험을 줄입니다. 단순화한 형태는 다음과 같습니다.
void train_Uniform(..., const float* x, std::vector<float>& trained) {
    trained.resize(2);
    float& vmin = trained[0];
    float& vmax = trained[1];
    // Scan samples to obtain min/max
    // Then expand the range based on rs_arg
}
비균일 SQ의 경우 Faiss는 하나의 전역 범위를 사용하는 대신 차원별로 통계를 계산합니다. 이 방식은 일반적으로 차원별 값의 크기가 뚜렷하게 다른 데이터에서 더 좋은 결과를 냅니다.
실제 관찰 결과
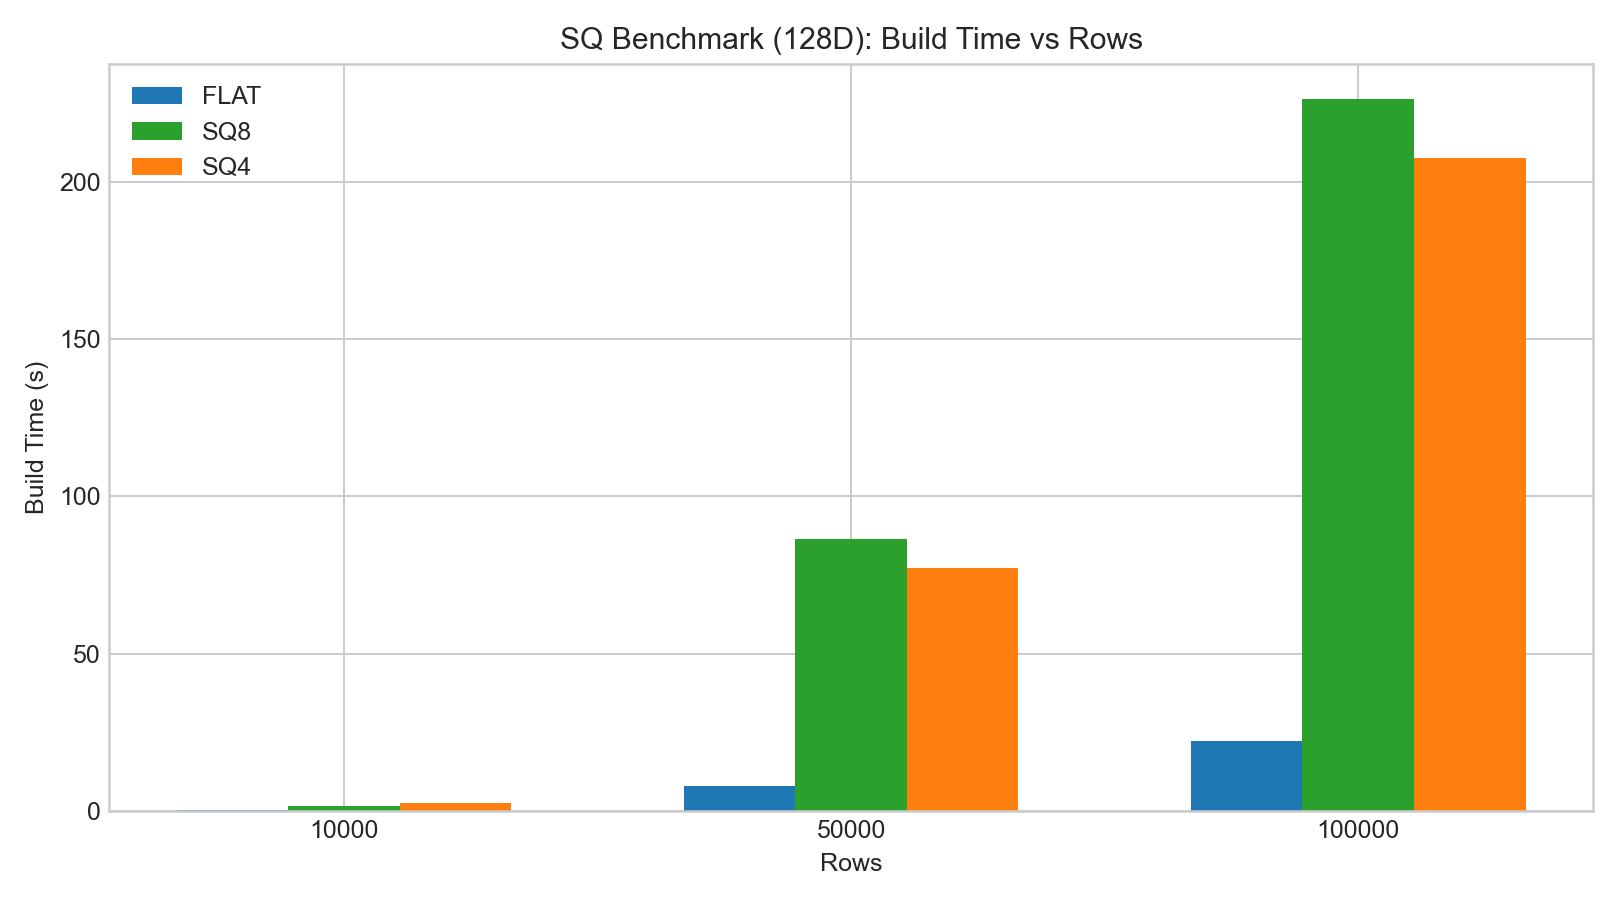
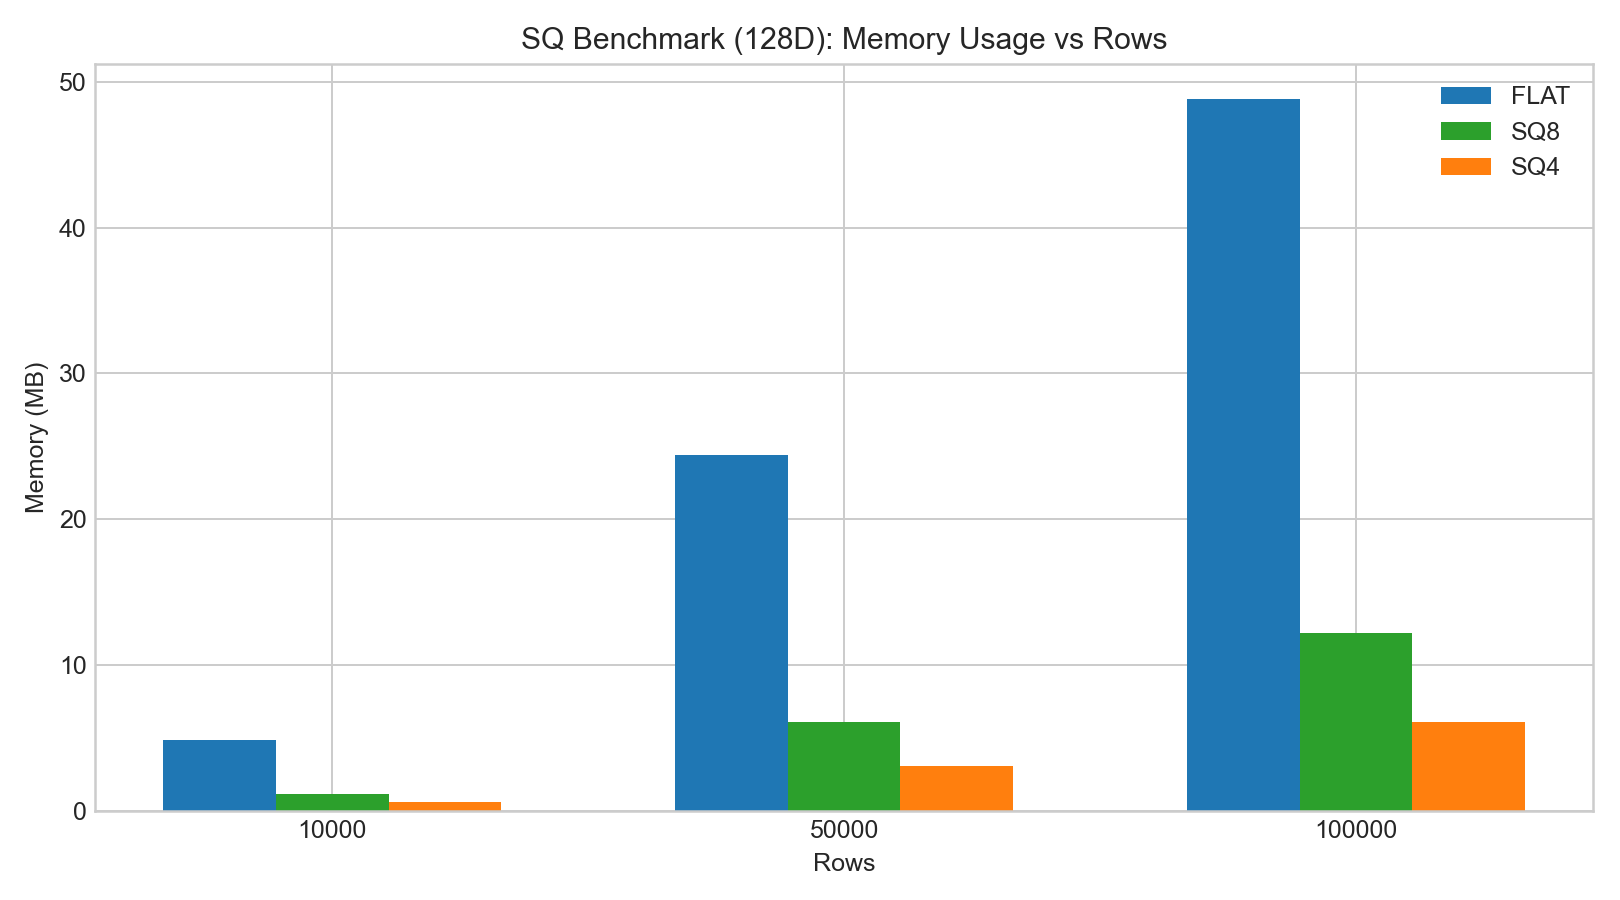
내부 128D/256D HNSW 테스트에서 다음과 같은 결과를 관찰했습니다.
sq8의 재현율은 대체로sq4보다 뚜렷하게 높습니다.- SQ의 빌드/인코딩 시간은 FLAT보다 훨씬 깁니다.
sq8의 쿼리 지연 시간은 대체로 크게 달라지지 않지만,sq4에서는 재현율 저하가 더 뚜렷하게 나타납니다.
아래 막대 차트는 예시 벤치마크 데이터를 기반으로 합니다.
곱 양자화(PQ)
원리
PQ는 D차원 벡터를 M개의 하위 벡터로 나누고(각 하위 벡터는 D/M차원), 각 하위 공간에서 k-means 양자화를 적용합니다.
주요 매개변수:
| 매개변수 | 의미 | 튜닝 방향 |
|---|---|---|
pq_m | 하위 양자화기의 수 | 값이 클수록 정밀도가 높아지지만 학습 및 인코딩 비용이 증가함 |
pq_nbits | 하위 벡터당 인코딩 비트 수 | 각 하위 공간의 코드북 크기(2^pq_nbits)를 결정함 |
PQ 쿼리가 더 빠를 수 있는 이유
PQ는 LUT(룩업 테이블)를 사용하여 거리를 근사할 수 있습니다.
- 각 쿼리 하위 벡터에서 각 하위 공간의 중심점까지의 거리를 미리 계산합니다.
- 쿼리 시 테이블 조회와 누적 합산으로 전체 거리를 추정합니다.
이렇게 하면 전체 벡터를 재구성할 필요가 없어, 많은 시나리오에서 검색 단계의 CPU 비용을 줄일 수 있습니다.
Faiss 소스 코드 핵심(PQ)
동일한 구현 경로에서 Faiss의 ProductQuantizer는 각 하위 공간의 코드북을 학습하고 중심점을 연속된 메모리에 저장합니다. 단순화한 형태는 다음과 같습니다.
void ProductQuantizer::train(size_t n, const float* x) {
    Clustering clus(dsub, ksub, cp);
    IndexFlatL2 index(dsub);
    clus.train(n * M, x, index);
    for (int m = 0; m < M; m++) {
        set_params(clus.centroids.data(), m);
    }
}
중심점의 배치는 (M, ksub, dsub) 형태로 이해할 수 있습니다.
M: 하위 양자화기의 수.ksub: 각 하위 공간의 코드북 크기(2^pq_nbits).dsub: 하위 벡터의 차원 수(D / M).
실제 관찰 결과
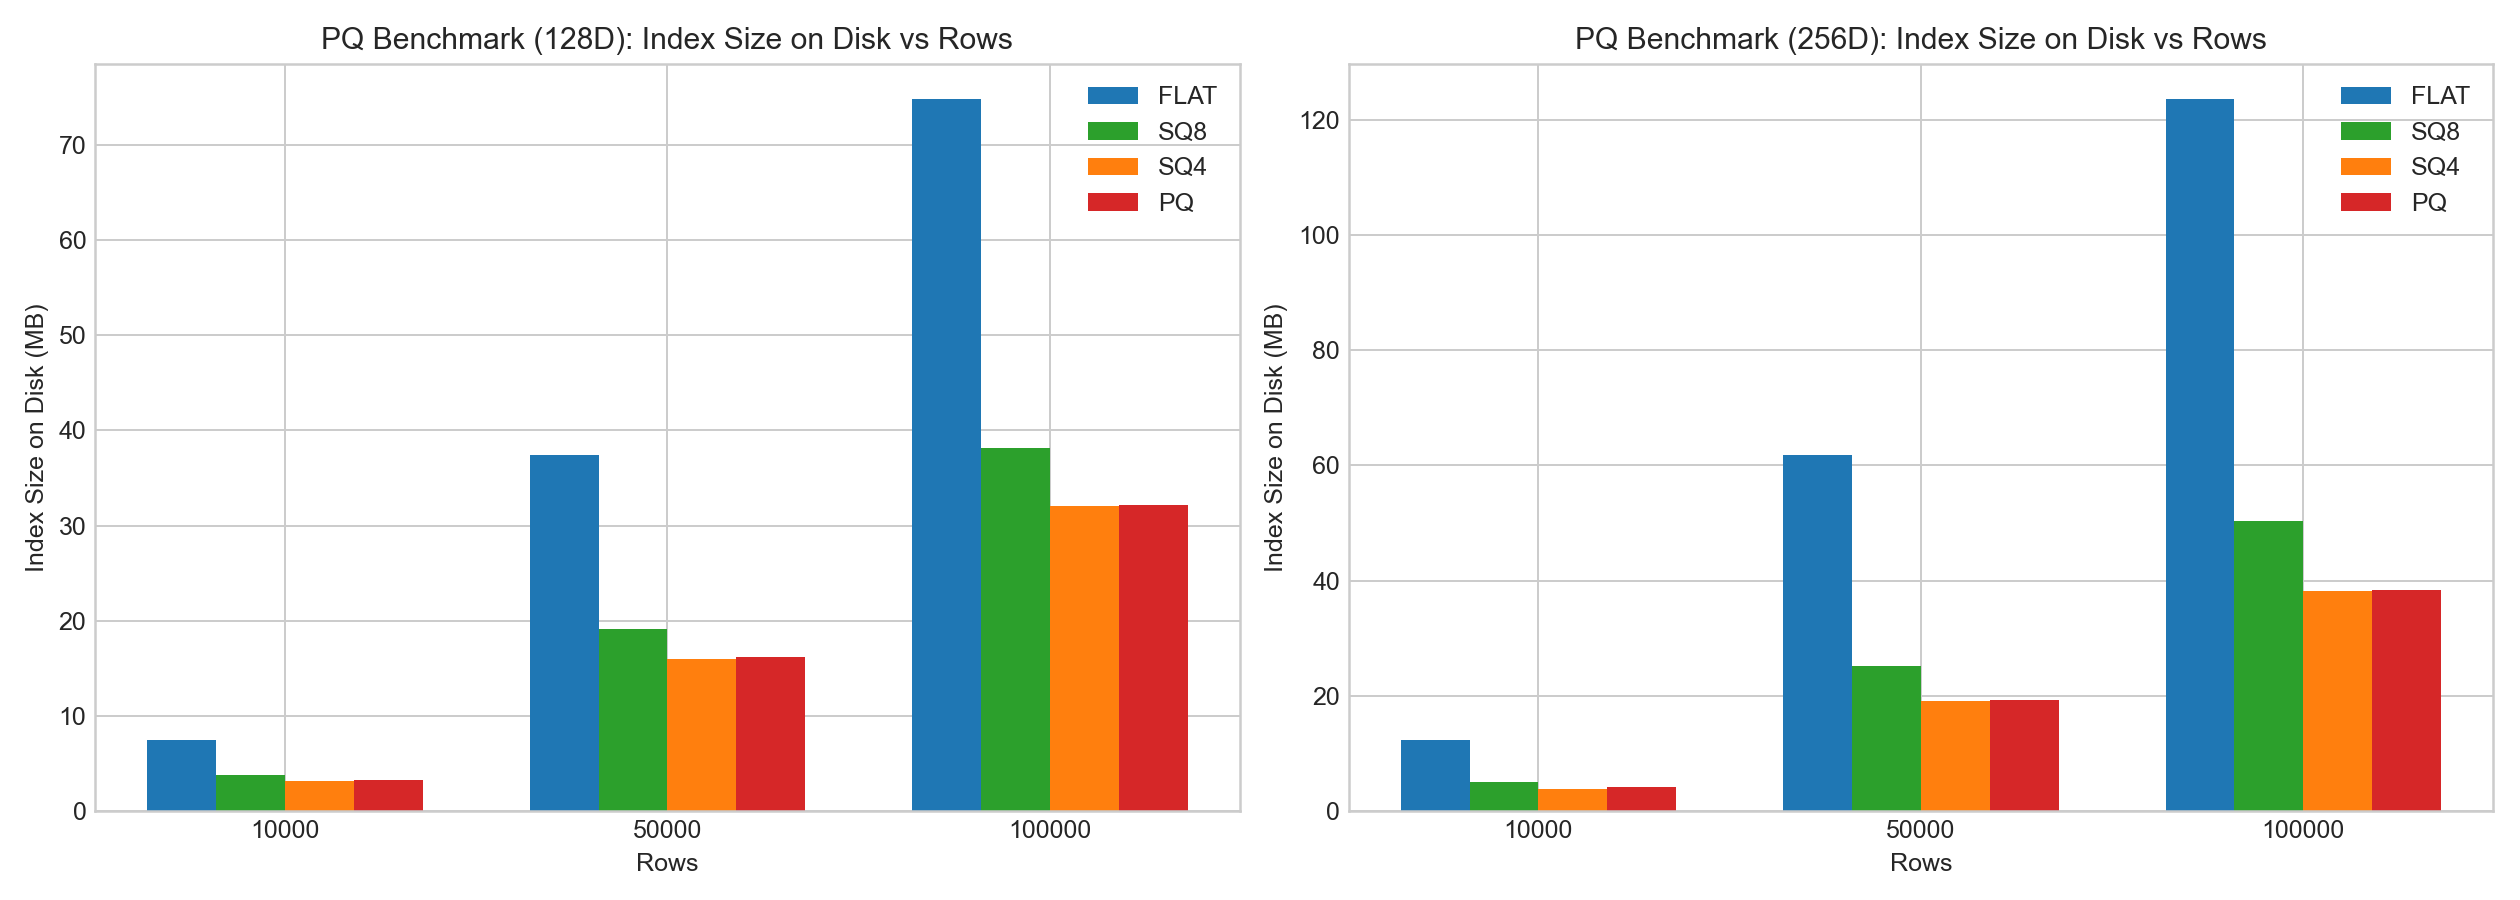
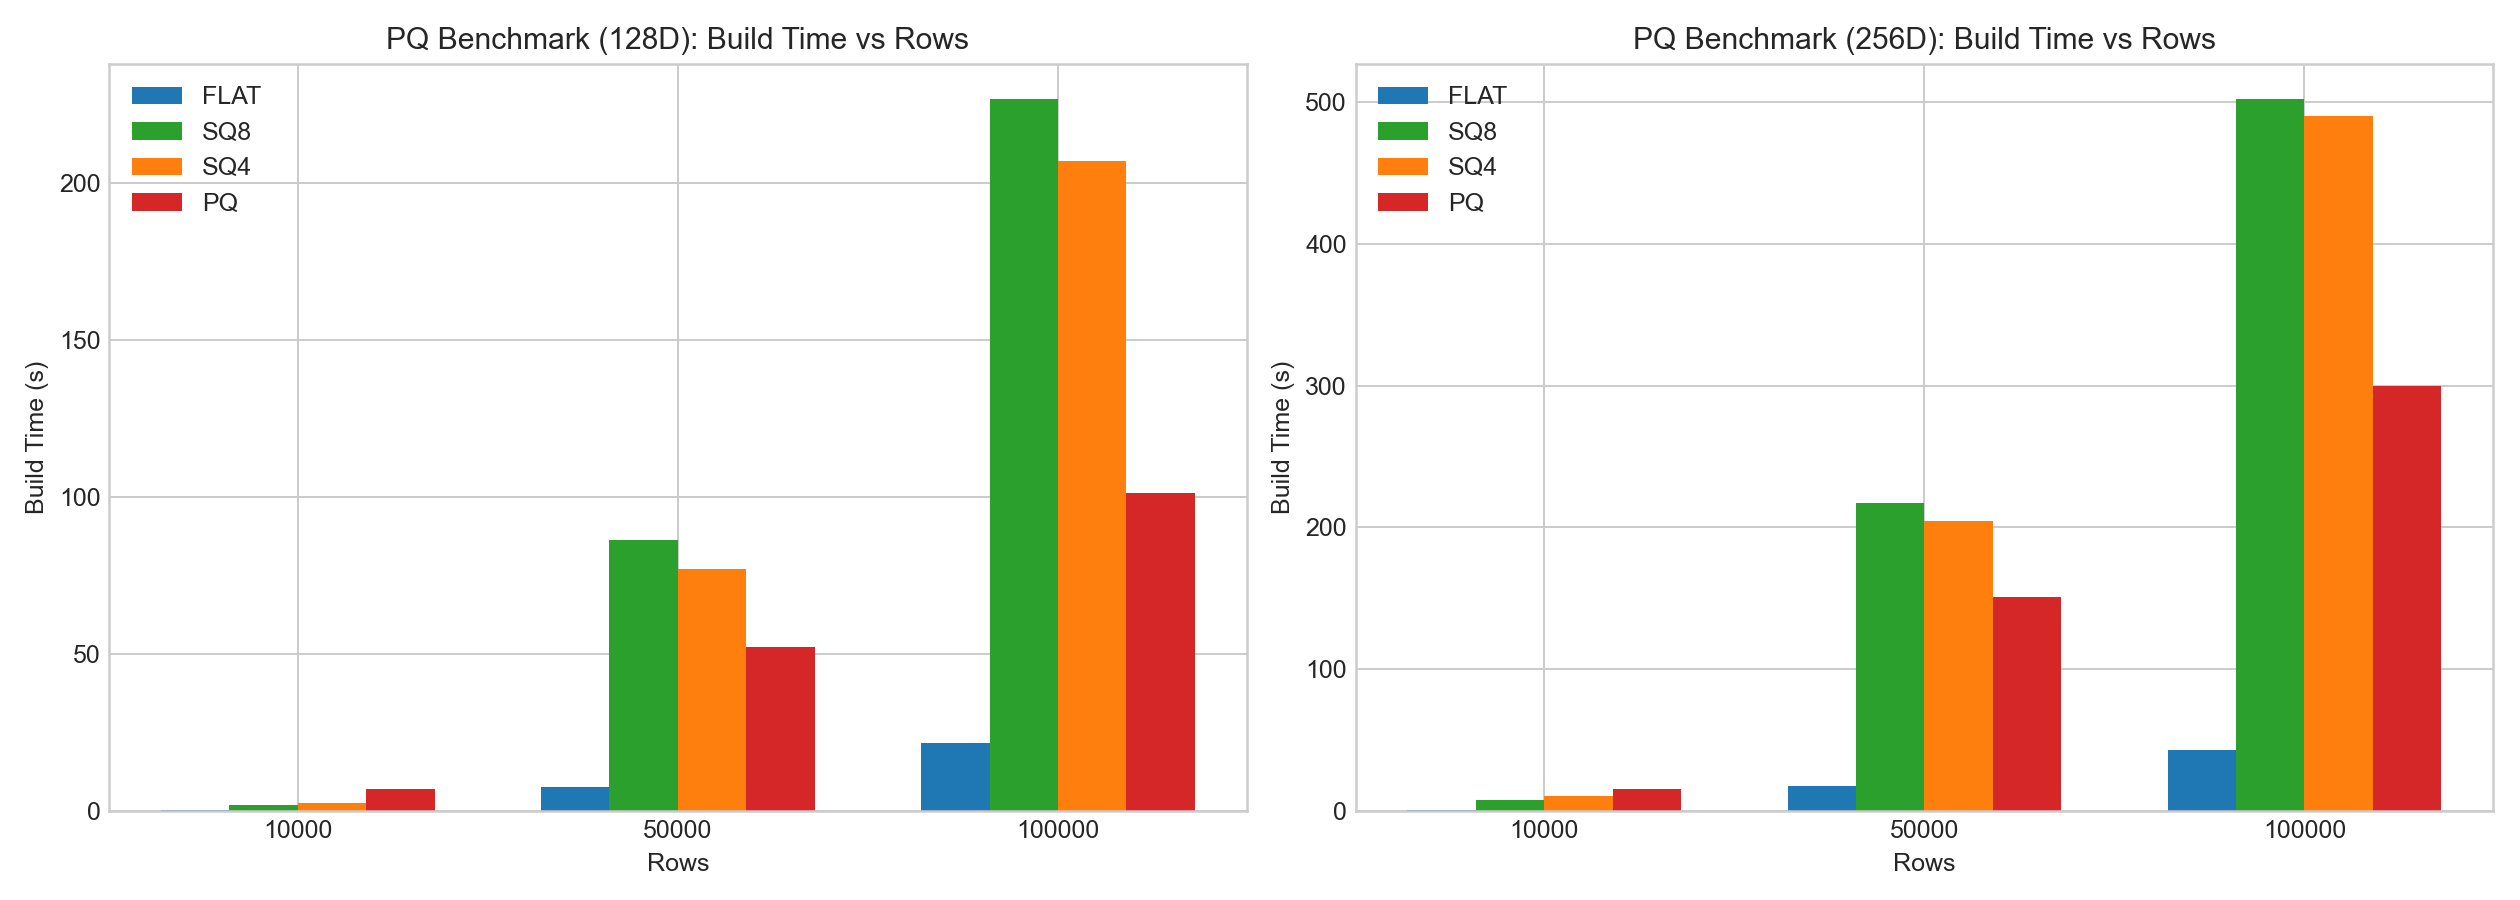
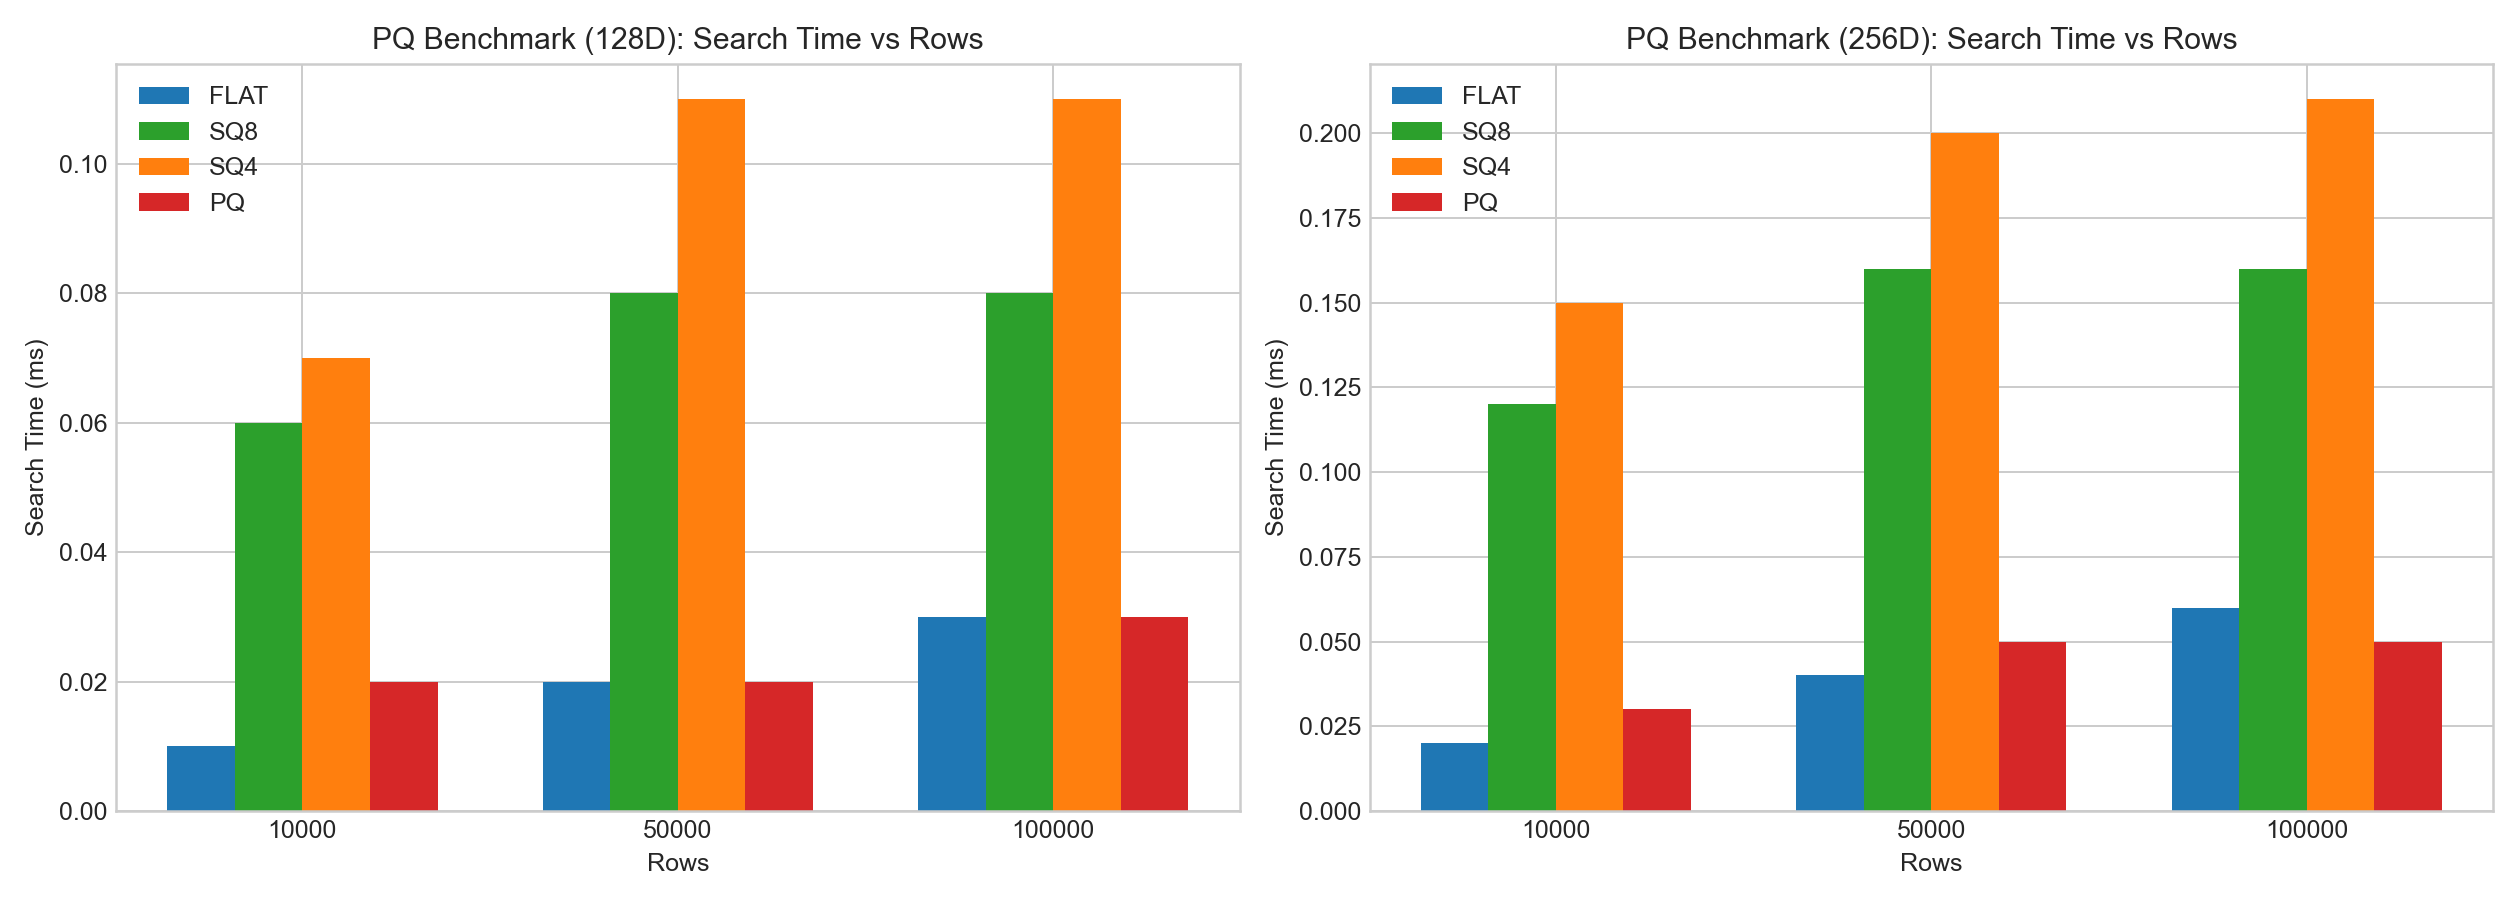
동일한 내부 테스트에서 다음과 같은 결과를 관찰했습니다.
- PQ의 압축 효과는 뚜렷합니다.
- PQ는 학습/인코딩 비용이 더 높습니다.
- SQ와 비교하면 PQ는 LUT를 활용하여 쿼리 단계에서 더 빠른 속도를 내는 경우가 많지만, 재현율과 빌드 비용은 여전히 데이터 분포와 매개변수 조합에 따라 달라집니다.
아래 막대 차트는 예시 벤치마크 데이터를 기반으로 합니다.
Doris 선택 지침
시나리오별 선택
| 시나리오 | 권장 양자화 방식 | 이유 |
|---|---|---|
| 메모리가 충분하고 재현율이 최우선인 경우 | flat | 정밀도 손실이 없고 도달 가능한 품질이 가장 높음 |
| 품질을 더 안정적으로 유지하면서 위험을 낮추고 메모리 사용량을 줄이려는 경우 | sq8 | 약 4배 압축하며 재현율 저하를 관리할 수 있음 |
| 메모리 제약이 심하고 재현율 저하를 허용할 수 있는 경우 | sq4 | 약 8배 압축하지만 재현율 저하가 더 뚜렷함 |
| 압축률과 성능의 균형을 추구하며 튜닝을 감수할 수 있는 경우 | pq | LUT가 쿼리를 가속하지만 매개변수 튜닝이 필요함 |
권장 검증 절차
- 먼저
flat으로 기준선을 설정하고 Recall@K와 쿼리 지연 시간을 기록합니다. sq8을 먼저 테스트하고 재현율과 P95/P99 지연 시간을 함께 비교합니다.- 메모리가 여전히 부족하면
pq를 테스트합니다(pq_m = D/2부터 시작할 수 있습니다). - 메모리가 재현율보다 우선인 경우에만
sq4를 고려합니다.
벤치마크 고려 사항
절대적인 지연 시간은 하드웨어, 스레드 수, 데이터셋과 밀접한 관련이 있습니다. 비교 결과를 동일한 기준에서 판단할 수 있도록, 나란히 비교할 때는 다음 변수를 고정하세요.
| 범주 | 고정할 변수 |
|---|---|
| 데이터 | 벡터 차원 수, 데이터셋 분포, 행 수 |
| 인덱스 | 인덱스 매개변수, 세그먼트 크기 |
| 쿼리 | 쿼리 집합과 정답 집합 |
평가 지표에는 다음 항목을 모두 포함해야 합니다.
- Recall@K
- 인덱스 크기
- 빌드 시간
- 쿼리 지연 시간(P50/P95/P99)
자주 묻는 질문
Q1: sq8과 sq4 중 무엇을 선택해야 하나요?
sq8을 우선 선택하세요. sq8은 약 4배 압축하면서 재현율 저하를 관리할 수 있습니다. sq4는 약 8배 압축하지만 재현율 저하가 더 뚜렷하므로, 메모리가 극도로 부족한 경우에만 사용하세요.
Q2: SQ 대신 PQ를 선택해야 하는 경우는 언제인가요?
더 높은 압축률이 필요하거나 LUT를 사용해 쿼리 단계의 속도를 높이고 싶을 때 PQ를 선택하세요. 대신 학습/인코딩 비용이 높아지며, 데이터 분포에 맞춰 pq_m과 pq_nbits를 튜닝해야 합니다.
Q3: 양자화가 빌드 시간에 영향을 주나요?
네. 모든 양자화 방식의 빌드/인코딩 시간은 flat보다 훨씬 길며, PQ의 학습 단계에서 비용이 가장 많이 듭니다. 평가할 때 빌드 시간을 별도로 기록하세요.
Q4: 비균일 SQ가 항상 균일 SQ보다 좋은가요?
반드시 그렇지는 않습니다. 차원별 값의 크기가 뚜렷하게 다른 경우(예: 일부 차원의 값이 본질적으로 더 큰 경우)에는 비균일 SQ의 재구성 오차가 더 작습니다. 차원별 값의 크기가 비슷하다면 두 방식의 차이는 크지 않습니다.
Q5: pq_m의 초기값은 어떻게 설정하나요?
pq_m = D/2부터 시작한 다음 Recall@K와 쿼리 지연 시간을 기준으로 값을 높이거나 낮출 수 있습니다. pq_m이 클수록 정밀도가 높아지지만 학습 및 인코딩 비용이 증가합니다.