Принципы Compaction
1. Роль Compaction
Apache Doris использует механизм хранения на основе LSM-Tree, в котором при записи данные последовательно добавляются в новые файлы данных, а существующие файлы напрямую не обновляются. Такая архитектура обеспечивает высокую производительность записи, но со временем накапливаются файлы данных разных версий и размеров, что приводит к следующим проблемам:
- Снижение производительности запросов: для выполнения запросов требуется многопутевая сортировка слиянием данных из нескольких файлов
- Неэффективное использование дискового пространства: хранятся данные, помеченные для удаления, и дубликаты
Compaction (сжатие и упорядочивание данных) — основной механизм решения этих проблем. Он автоматически объединяет и перезаписывает файлы данных в фоновом режиме, собирая данные с одинаковым первичным ключом или из соседних диапазонов в меньшее число более упорядоченных файлов, а также очищает удалённые данные и данные с истёкшим сроком хранения. Это позволяет поддерживать высокую производительность запросов и оптимизировать использование дискового пространства.
В Doris Compaction выполняется непрерывно и автоматически, без ручного запуска. Однако понимание принципов и текущего состояния этого процесса помогает настраивать производительность при большом числе одновременных запросов и работе с большими объёмами данных.
1.1 Повышение производительности запросов
Механизм импорта данных в Doris: каждый импорт создаёт rowset для каждого tablet в целевом разделе.
- Каждый rowset содержит от 0 до n segment
- Каждый segment соответствует упорядоченному файлу на диске
При выполнении запросов уровень хранения должен возвращать агрегированные результаты или результаты без дубликатов, поэтому он выполняет многопутевую сортировку слиянием данных из нескольких rowset/segment. С увеличением числа rowset растёт и число потоков слияния, что снижает эффективность запросов.
Роль Compaction:
- Узлы BE непрерывно объединяют эти rowset в фоновом режиме, сокращая число потоков слияния и тем самым повышая эффективность запросов
- Compaction выполняется на уровне tablet
1.2 Очистка данных
Помимо повышения производительности, Compaction отвечает за очистку данных:
- Очистка данных, помеченных для удаления
- Операции DELETE в Doris не удаляют данные сразу, а создают delete rowset, содержащий только предикаты удаления, без самих данных. Во время Compaction данные, соответствующие этим предикатам, отфильтровываются и фактически удаляются
- Для таблиц типа Merge-on-Write данные с метками удаления также очищаются на этапе Compaction
- Удаление дубликатов
- Модель Aggregate: агрегирует строки с одинаковым ключом
- Модель Unique: сохраняет только последние данные для одного и того же ключа
Это обеспечивает корректность данных и сокращает использование дискового пространства.
2. Основные понятия
2.1 Compaction Score
Compaction Score — показатель степени неупорядоченности данных в tablet, который также служит основой для определения приоритета Compaction. Он равен числу потоков слияния, в которых tablet должен участвовать при выполнении запроса.
- Чем выше Score, тем больше накладные расходы при выполнении запросов
- Поэтому Compaction в первую очередь обрабатывает tablet с более высоким Score
Пример:
"rowsets": [
    "[0-100] 3 DATA NONOVERLAPPING 0200000000001c30804822f519cf378fbe6f162b7de393a6 500.32 MB",
    "[101-101] 2 DATA OVERLAPPING 02000000000021d0804822f519cf378fbe6f162b7de393a6 180.46 MB",
    "[102-102] 1 DATA NONOVERLAPPING 0200000000002211804822f519cf378fbe6f162b7de393a6 50.59 MB"
]
- Rowset [0-100] содержит 3 segment без перекрытия → занимает 1 поток
- Rowset [101-101] содержит 2 segment с перекрытием → занимает 2 потока
- Rowset [102-102] занимает 1 поток Таким образом, Compaction Score этого tablet = 4.
2.2 Типы Compaction
- Cumulative Compaction: объединяет небольшие инкрементальные rowset для повышения эффективности слияния
- Base Compaction: объединяет все rowset, предшествующие определённому rowset, в новый rowset
- Full Compaction: объединяет все rowset
- Cumulative Point: граничная точка, разделяющая Base и Cumulative Compaction
Оптимальная стратегия: сначала объединять небольшие rowset с помощью Cumulative Compaction, а после накопления определённого объёма данных выполнять Base Compaction.
3. Стратегия Compaction
3.1 Стратегия выбора tablet
Поскольку цель Compaction — повысить производительность запросов, приоритет отдаётся tablet с наибольшим Compaction Score.
3.2 Стратегия выбора rowset
После определения целевого tablet необходимо выбрать подходящие rowset для Compaction. Основные принципы:
- Максимально снижать Compaction Score при минимальной вычислительной нагрузке
- Контролировать коэффициент усиления записи
- Избегать чрезмерного использования системных ресурсов
Основные факторы:
- Соотношение затрат и результата
- Cumulative Compaction: размеры участвующих в слиянии rowset не должны сильно различаться; размер самого большого rowset ≤ половины общего объёма
- Base Compaction: запускается только тогда, когда отношение размера Base rowset к размеру остальных rowset-кандидатов ≥ 0.3
- Контроль усиления записи
- Cumulative Compaction:
- Запускается только тогда, когда Score rowset-кандидатов > 5
- Запускается только тогда, когда объём данных превышает promotion size
- Base Compaction: запускается только тогда, когда Score rowset-кандидатов > 5
- Cumulative Compaction:
- Контроль системных ресурсов
- Число rowset в одной операции Cumulative Compaction ≤ 1000
- Число rowset в одной операции Base Compaction ≤ 20
4. Процесс Compaction
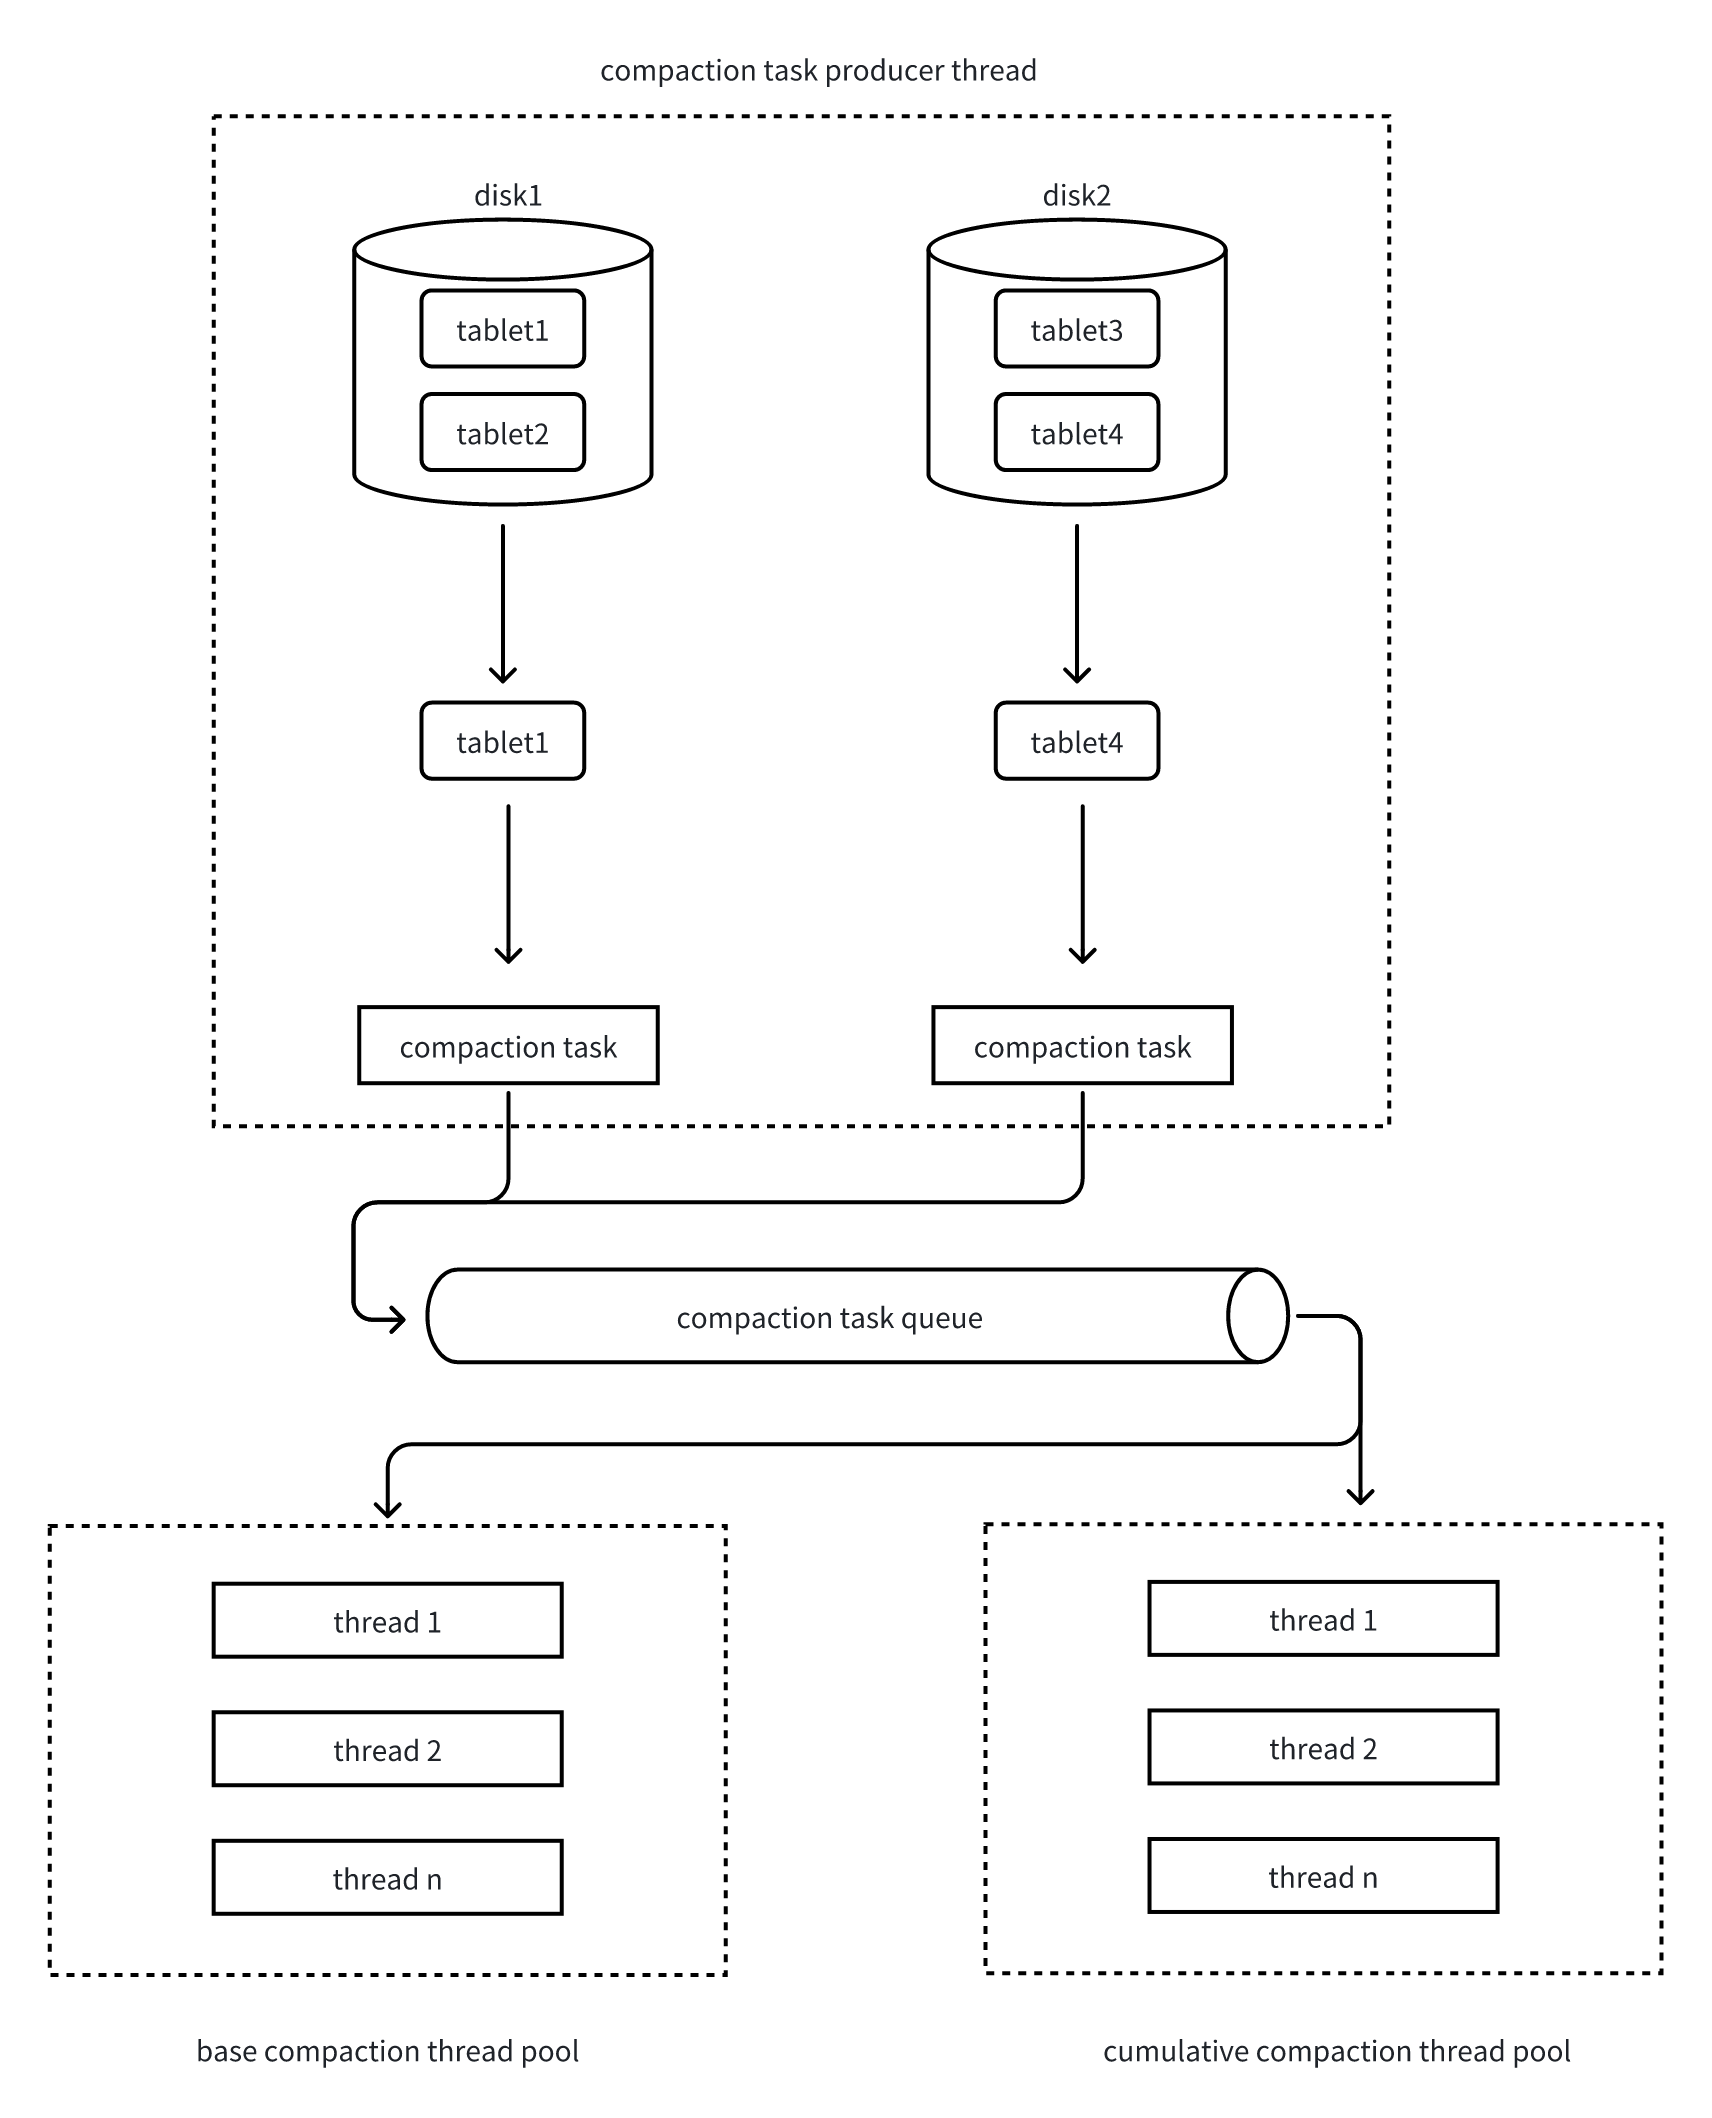
Compaction выполняется по модели «производитель — потребитель»:
- Сканирование tablet и создание задач
- Потоки, создающие задачи Compaction, периодически сканируют все tablet и вычисляют их Compaction Score
- В каждом раунде на каждом диске выбирается tablet с наибольшим Score
- Base Compaction выбирается каждые 10 раундов, а в остальные 9 раундов выбирается Cumulative Compaction
- Контроль параллельного выполнения
- Проверяется, превышает ли число задач Compaction на текущем диске заданный предел
- Если предел не превышен, tablet допускается к Compaction
- Выбор rowset
- В качестве входных данных выбираются последовательные rowset близких размеров
- Это позволяет избежать неэффективного многопутевого слияния при значительных различиях в объёме данных
- Отправка задачи
- Tablet и rowset-кандидаты объединяются в задачу Compaction Task
- Задача отправляется в очередь соответствующего пула потоков в зависимости от её типа (Base/Cumulative)
- Выполнение задачи
- Пул потоков Compaction извлекает задачи из очереди
- Выполняется многопутевая сортировка слиянием, объединяющая несколько rowset в новый rowset
5. Основные параметры Compaction
| Имя параметра | Описание | Значение по умолчанию |
|---|---|---|
| tive_compaction_rounds_for_each_base_compaction_round | Число раундов создания задач cumulative compaction перед созданием одной задачи base compaction. Этот параметр позволяет управлять соотношением задач cumulative и base compaction | 9 |
| compaction_task_num_per_fast_disk | Максимальное число одновременно выполняемых задач compaction на одном диске SSD | 8 |
| compaction_task_num_per_disk | Максимальное число одновременно выполняемых задач compaction на одном диске HDD | 4 |
| max_base_compaction_threads | Число рабочих потоков в пуле потоков Base compaction | 4 |
| max_cumu_compaction_threads | Число рабочих потоков в пуле потоков Cumulative compaction. Значение -1 означает, что размер пула определяется числом дисков: по одному потоку на диск | -1 |
| base_compaction_min_rowset_num | Условие запуска base compaction. При запуске по числу rowset задаёт минимальное число rowset, необходимое для base compaction | 5 |
| base_compaction_max_compaction_score | Максимальный compaction score для rowset, участвующих в base compaction | 20 |
| cumulative_compaction_min_deltas | Минимальный compaction score для rowset, участвующих в cumulative compaction | 5 |
| cumulative_compaction_max_deltas | Максимальный compaction score для rowset, участвующих в cumulative compaction | 1000 |