Обзор обновления данных
В этой статье описаны возможности Apache Doris по обновлению и удалению данных. Она поможет ответить на следующие вопросы:
- Какую модель таблицы выбрать для вашего сценария?
- Когда следует использовать обновление при загрузке данных (UPSERT, частичное обновление столбцов), а когда следует обновлять данные с помощью DML (
UPDATE,INSERT INTO SELECT)? - Как устроена модель Unique Key? (Merge-on-Write, столбец Sequence, метка удаления, частичное обновление столбцов)
- Как реализуются типичные сценарии, такие как синхронизация CDC и формирование широких таблиц в реальном времени?
Рекомендации по чтению:
- Чтобы быстро выбрать подходящий способ, перейдите к разделу 1. Выбор способа обновления.
- Чтобы разобраться в принципах работы или устранить проблемы с производительностью, см. 2. Механизм реализации модели Unique Key.
- Примеры применения см. в разделе 3. Типичные бизнес-сценарии.
- Рекомендации и ограничения описаны в разделе 4. Рекомендации по использованию.
1. Выбор способа обновления
1.1 Сравнение моделей таблиц и возможностей обновления
Doris предоставляет три модели таблиц, которые существенно различаются поддержкой обновления и удаления данных. Прежде чем выбрать модель, определите, нужны ли в вашем сценарии обновления на уровне строк или частичные обновления столбцов.
| Модель таблицы | Организация данных | Поддерживаемые способы обновления и удаления | Типичные сценарии использования |
|---|---|---|---|
| Модель Unique Key | Каждая строка определяется уникальным первичным ключом; дедупликация выполняется при записи | UPSERT, частичное обновление столбцов, UPDATE, пометка на удаление, DELETE | Изменение статусов заказов, обновление пользовательских тегов, синхронизация CDC |
| Модель Aggregate Key | Значения столбцов Value для одинакового Key объединяются функцией агрегации (SUM/MAX/MIN/REPLACE) | Обновление через загрузку данных в соответствии с семантикой агрегации; DELETE поддерживает только условия по столбцам Key | Отчёты в реальном времени, подсчёт кликов и другие сценарии агрегации |
| Модель Duplicate Key | Запись только с добавлением данных, без дедупликации и агрегации | Поддерживается только DELETE | Журналы, отслеживание поведения и другие сценарии, в которых данные только добавляются |
Вывод для выбора модели: если нужны обновления на уровне строк или частичные обновления столбцов, выбирайте модель Unique Key.
1.2 Выбор способа обновления
Модель Unique Key поддерживает два способа обновления. Выбор зависит от объёма данных и частоты операций:
| Способ | Подходящие сценарии | Рекомендуемый метод записи |
|---|---|---|
| Обновление при загрузке данных (UPSERT) | Частые обновления большими пакетами; синхронизация CDC; формирование широких таблиц из нескольких источников | Stream Load, Routine Load, Broker Load, INSERT INTO |
Обновление с помощью DML (UPDATE) | Нечастые пакетные обновления; обновление данных по условию; обновления с использованием связанных таблиц | UPDATE, INSERT INTO ... SELECT ... |
1.2.1 Обновление при загрузке данных (UPSERT)
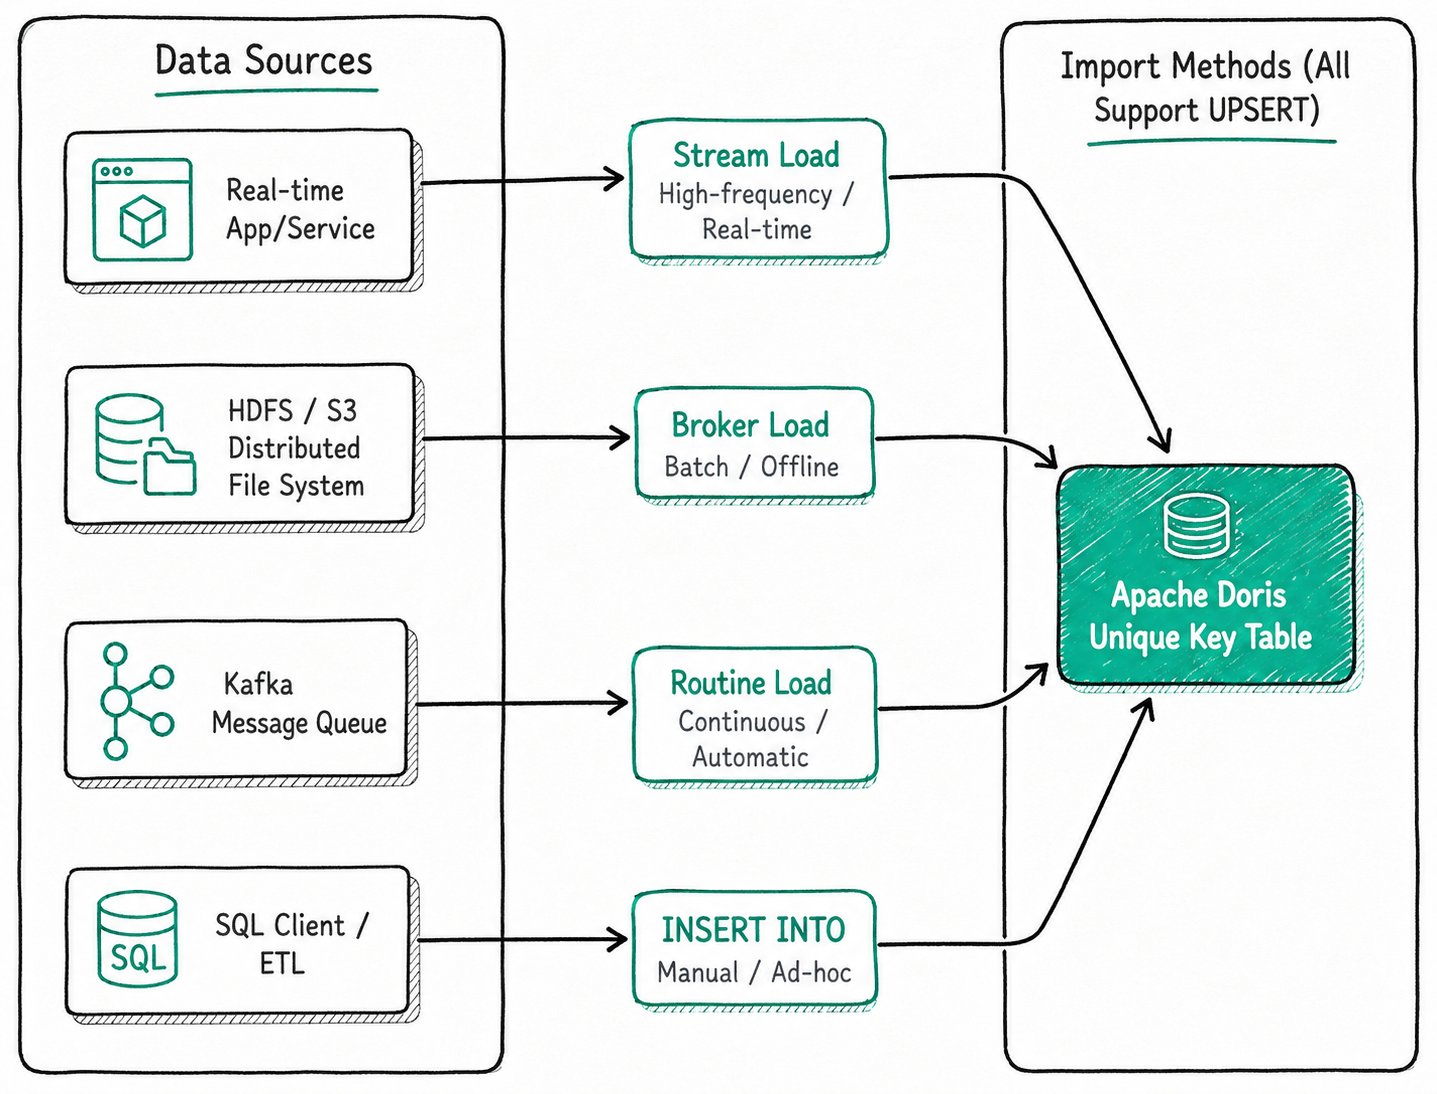
Все методы загрузки (Stream Load, Broker Load, Routine Load, INSERT INTO) по умолчанию обрабатывают данные в модели Unique Key с семантикой UPSERT:
- Если первичный ключ уже существует, новая строка перезаписывает старую.
- Если первичный ключ не существует, вставляется новая строка.
Поведение обновлений при загрузке данных зависит от модели таблицы. Подробнее см.:
- Обновление при загрузке данных в модели Unique Key: реализация Upsert для всей строки и частичного обновления столбцов через Stream Load, Routine Load и другие методы.
- Обновление при загрузке данных в модели Aggregate: семантика записи и доступные способы обновления в модели Aggregate.
1.2.2 Обновление с помощью оператора UPDATE
Doris поддерживает стандартный оператор SQL UPDATE, который позволяет обновлять данные в таблицах модели Unique Key по условиям WHERE, а также выполнять обновления с использованием связанных таблиц.
-- Simple update
UPDATE user_profiles SET age = age + 1 WHERE user_id = 1;

-- Cross-table associated update
UPDATE sales_records t1
SET t1.user_name = t2.name
FROM user_profiles t2
WHERE t1.user_id = t2.user_id;
При выполнении UPDATE сначала сканируются данные, соответствующие условиям, а затем обновлённые строки записываются обратно. Этот способ подходит для нечастых пакетных обновлений.
Не рекомендуется выполнять операции UPDATE с высокой параллельностью для данных с одним и тем же первичным ключом. Параллельные операции UPDATE не гарантируют изоляцию данных, если затрагивают один и тот же первичный ключ.
Синтаксис, типичные примеры использования и ограничения оператора UPDATE описаны в разделе Обновление данных с помощью команды UPDATE.
1.2.3 Обновление с помощью INSERT INTO SELECT
Поскольку модель Unique Key по умолчанию использует семантику UPSERT, с помощью INSERT INTO ... SELECT ... можно получить тот же эффект, что и при UPDATE. Этот способ подходит для пакетной записи данных из других таблиц.
1.3 Способы удаления данных
Doris предоставляет два способа удаления данных, механизмы реализации которых различаются в зависимости от модели таблицы:
| Способ удаления | Поддерживаемые модели таблиц | Описание |
|---|---|---|
| Пометка на удаление при загрузке данных | Модель Unique Key | Записывается метка __DORIS_DELETE_SIGN__ = 1, а физическую очистку выполняет фоновая Compaction |
Удаление с помощью DML (DELETE / TRUNCATE) | Все модели | Удаление данных по условию или полная очистка таблицы/раздела |
Полную информацию см. в разделе Удаление данных.
2. Механизм реализации модели Unique Key
2.1 Merge-on-Write и Merge-on-Read
У модели Unique Key есть две стратегии слияния данных. Начиная с Doris 2.1, по умолчанию используется Merge-on-Write.
| Аспект | Merge-on-Write (MoW) | Merge-on-Read (MoR, устаревший вариант) |
|---|---|---|
| Поведение при записи | Дедупликация и слияние выполняются при записи; в хранилище для каждого первичного ключа остаётся только одна, самая новая запись | При записи сохраняются несколько версий |
| Производительность запросов | Близка к производительности таблицы Duplicate Key без обновлений | Слияние выполняется в реальном времени при запросах; время выполнения примерно в 3-10 раз больше, чем при MoW |
| Производительность записи | Есть накладные расходы на слияние; немного ниже, чем у MoR (примерно на 10-20% для небольших пакетов и на 30-50% для больших) | Близка к производительности таблицы Duplicate Key |
| Потребление ресурсов | Запись и фоновая Compaction потребляют больше ресурсов CPU и памяти | Запросы потребляют больше ресурсов CPU и памяти |
| Подходящие сценарии | Преобладание чтений при редких записях (рекомендуется) | Преобладание записей при редких чтениях (больше не рекомендуется) |
Новые таблицы по умолчанию используют MoW. Дополнительная настройка не требуется.
2.2 Столбец Sequence и данные, поступающие не по порядку
В распределённой системе данные могут поступать не по порядку. Например, статус заказа последовательно меняется на «Оплачен» и «Отправлен», но из-за сетевой задержки сообщение «Отправлен» может поступить в Doris раньше сообщения «Оплачен».
Механизм столбца Sequence решает эту проблему: при создании таблицы укажите столбец (обычно с временной меткой или номером версии) в качестве столбца Sequence. При записи данных с одним и тем же первичным ключом Doris всегда сохраняет строку с наибольшим значением Sequence.
CREATE TABLE order_status (
    order_id BIGINT,
    status_name STRING,
    update_time DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id)
PROPERTIES (
    "function_column.sequence_col" = "update_time" -- Specify update_time as the Sequence column
);

-- 1. Write the "Shipped" record (larger update_time)
-- {"order_id": 1001, "status_name": "Shipped", "update_time": "2023-10-26 12:00:00"}

-- 2. Write the "Paid" record (smaller update_time, arrives later)
-- {"order_id": 1001, "status_name": "Paid", "update_time": "2023-10-26 11:00:00"}

-- Final result: the record with the largest update_time is retained
-- order_id: 1001, status_name: "Shipped", update_time: "2023-10-26 12:00:00"
Дополнительная информация:
- О возможностях управления параллельным доступом, таких как столбец Sequence, управление версиями MVCC и параметры параллельного выполнения
UPDATE, см. Управление параллельными обновлениями в модели Unique Key. - Если несколько потоков данных одновременно обновляют разные столбцы одной широкой таблицы, можно использовать Sequence Mapping для независимого управления порядком версий каждого столбца. Подробнее см. Многопоточные обновления в модели Unique Key.
2.3 Механизм работы метки удаления
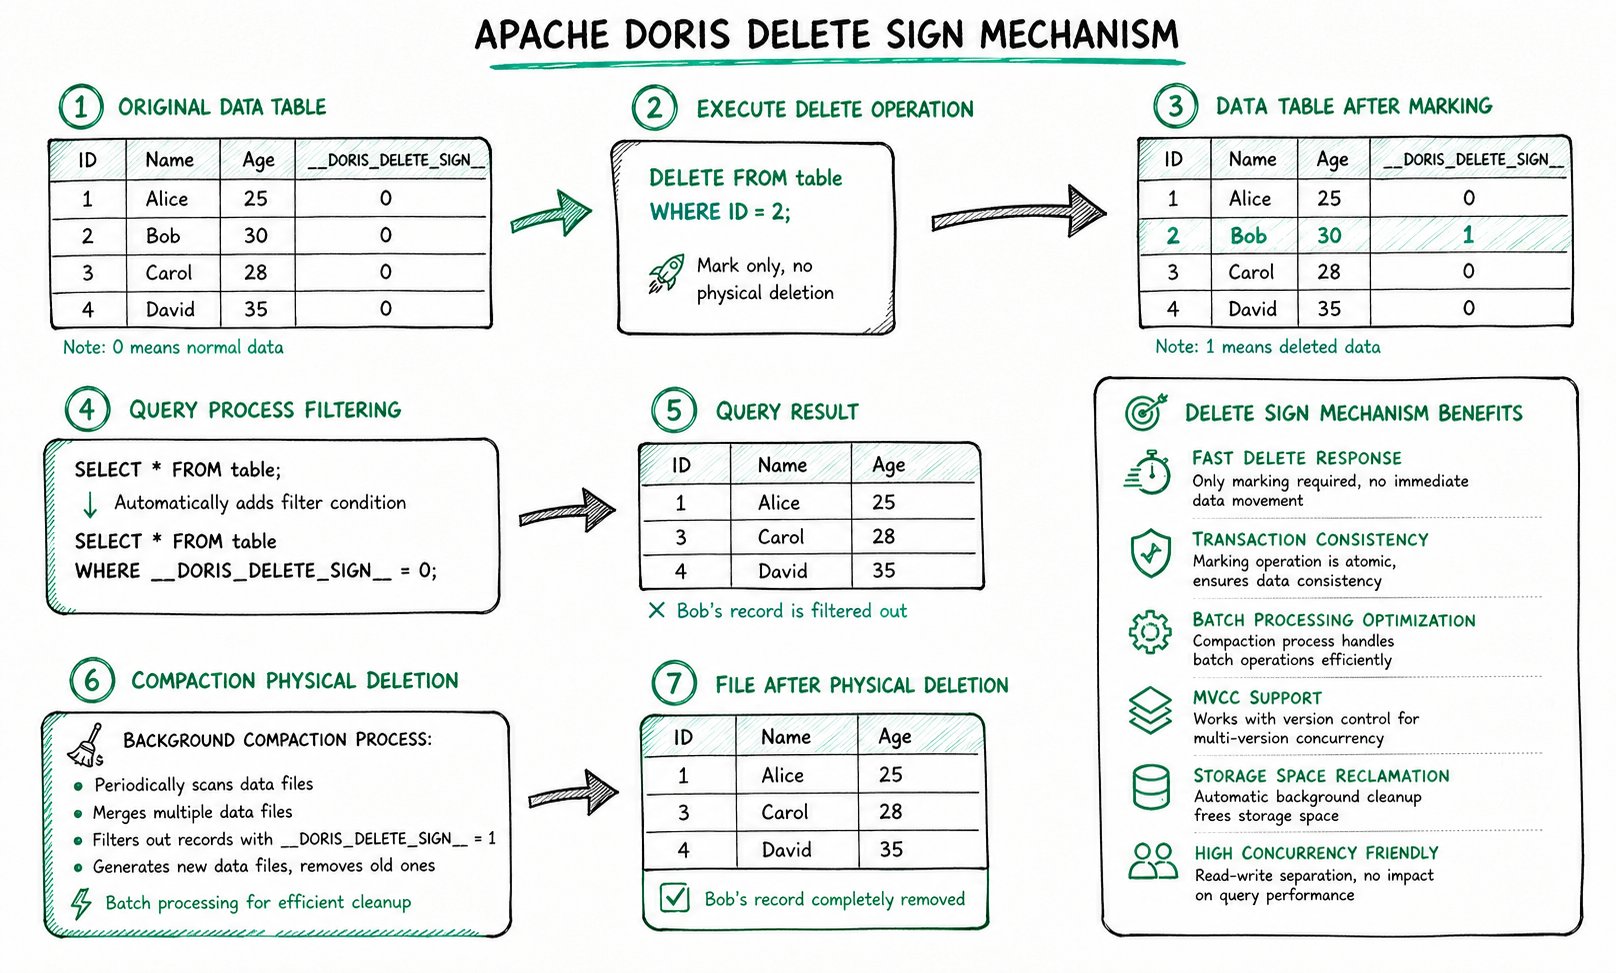
Для __DORIS_DELETE_SIGN__ используется подход «логическая пометка с фоновой очисткой», который включает три этапа:
- Выполнение удаления: при удалении данных через загрузку или оператор
DELETEDoris не удаляет данные из физических файлов сразу. Вместо этого записывается новая запись, у которой__DORIS_DELETE_SIGN__имеет значение1. - Фильтрация при запросе: при выполнении запросов Doris автоматически добавляет условие фильтрации
WHERE __DORIS_DELETE_SIGN__ = 0, чтобы исключить из результатов строки, помеченные на удаление. - Фоновая Compaction: когда процесс Compaction обнаруживает для первичного ключа и обычную запись, и запись с меткой удаления, при слиянии он физически удаляет обе записи, освобождая место в хранилище.
2.4 Частичное обновление столбцов
Начиная с версии 2.0, модель Unique Key (MoW) поддерживает частичное обновление столбцов: при загрузке достаточно передать первичный ключ и столбцы, которые нужно обновить. Столбцы, которые не были переданы, сохраняют исходные значения.
Как включить:
| Метод загрузки | Настройка для включения |
|---|---|
INSERT INTO | Установите переменную сеанса enable_unique_key_partial_update = true |
| Stream Load и другие методы загрузки | Установите для параметра partial_columns значение true |
При создании таблицы необходимо включить Merge-on-Write:
CREATE TABLE user_profiles (
    user_id BIGINT,
    name STRING,
    age INT,
    last_login DATETIME
)
UNIQUE KEY(user_id)
DISTRIBUTED BY HASH(user_id)
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true"
);

-- Initial data
-- user_id: 1, name: 'Alice', age: 30, last_login: '2023-10-01 10:00:00'

-- Partial update via Stream Load, writing only age and last_login
-- {"user_id": 1, "age": 31, "last_login": "2023-10-26 18:00:00"}

-- Data after update
-- user_id: 1, name: 'Alice', age: 31, last_login: '2023-10-26 18:00:00'
С точки зрения реализации частичное обновление столбцов в модели Unique Key не выполняется на месте. При загрузке считываются существующие столбцы, заполняются недостающие поля, а затем вся строка перезаписывается. Это приводит к увеличению объёма чтения и записи: например, при обновлении 10 полей широкой таблицы из 100 столбцов с полями примерно одинакового размера обновление с полезным объёмом 1 MB вызывает чтение примерно 9 MB данных и запись 10 MB данных.
Рекомендации по производительности:
| Рекомендация | Описание |
|---|---|
| Используйте SSD | Частичное обновление столбцов создаёт большое количество случайных операций IO. На механических дисках это становится серьёзным узким местом, поэтому рекомендуется использовать SSD (предпочтительно NVMe) |
| Включите строковое хранение для широких таблиц | Для очень широких таблиц рекомендуется включить строковое хранение, чтобы за одну операцию IO можно было прочитать всю строку. При столбцовом хранении для каждого недостающего поля требуется отдельная операция IO |
Полные инструкции по использованию (Stream Load, INSERT INTO, Flink Connector и т. д.) см. в разделе Обновление столбцов.
3. Типичные бизнес-сценарии
3.1 Синхронизация CDC в реальном времени
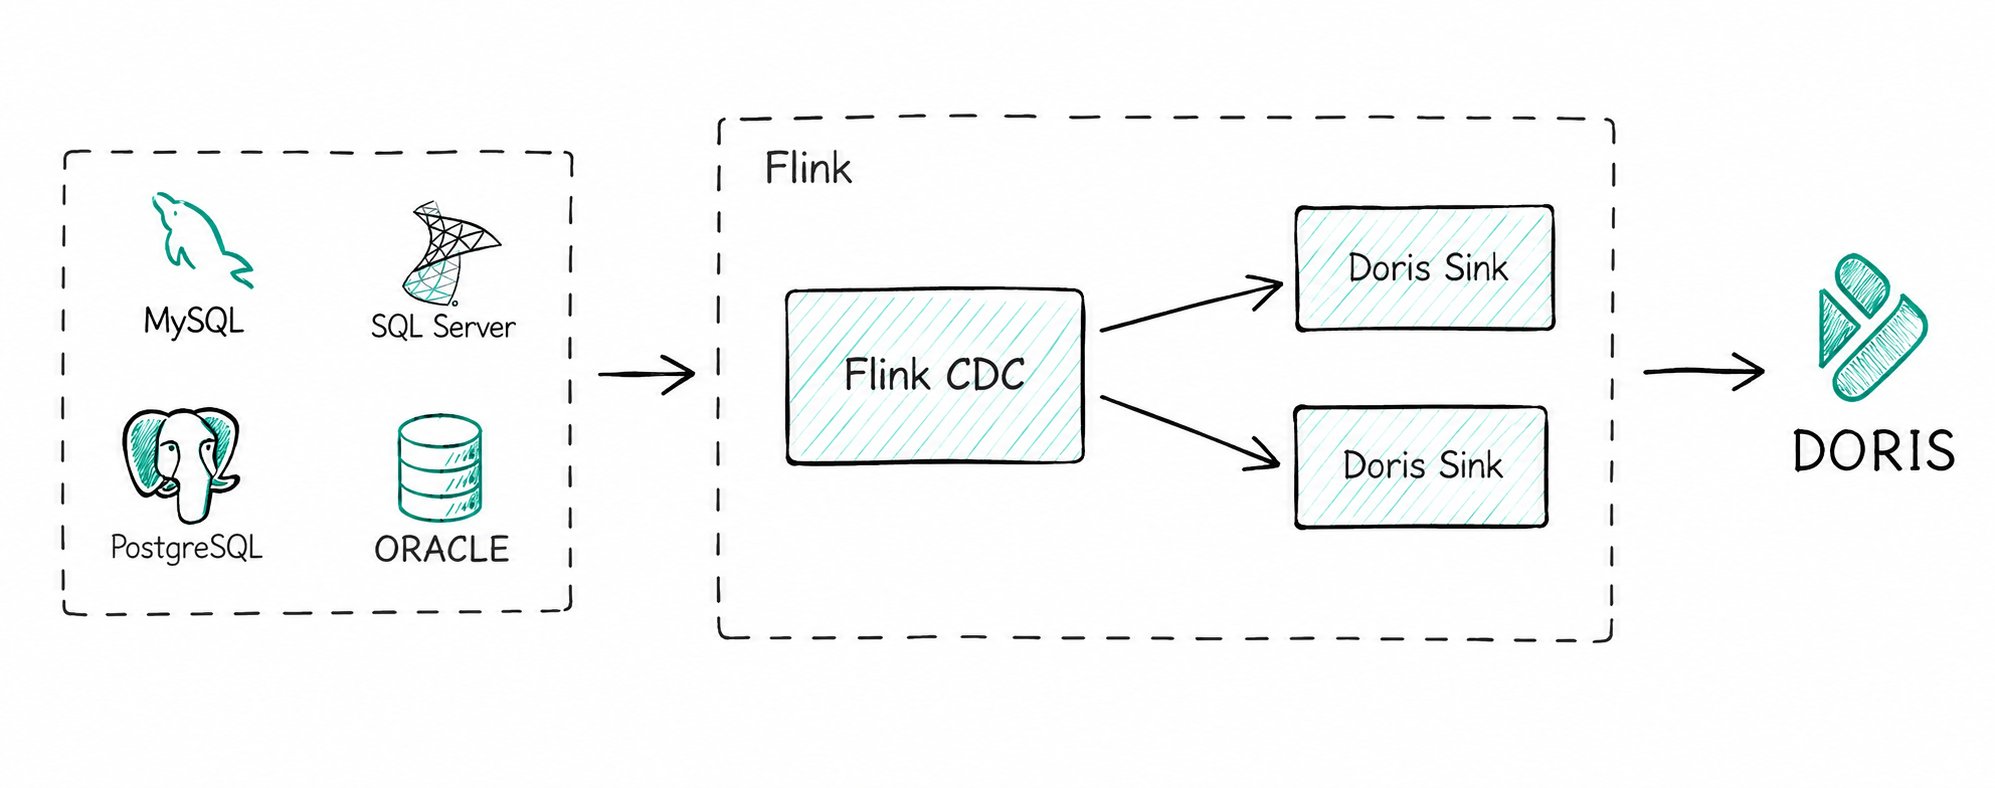
Такие инструменты, как Flink CDC, отслеживают Binlog исходных баз данных (MySQL, PostgreSQL, Oracle и др.) и записывают его в таблицы Doris с моделью Unique Key.
Ключевые возможности:
- Синхронизация всей базы данных: Flink Doris Connector включает Flink CDC, обеспечивая сквозную синхронизацию всей базы данных без ручного создания таблиц или сопоставления полей.
- Гарантия согласованности: следующие возможности используются совместно, чтобы данные соответствовали состоянию исходной базы данных:
- UPSERT в модели Unique Key отвечает за обработку
INSERT/UPDATE. __DORIS_DELETE_SIGN__отвечает за обработкуDELETE.- Столбец Sequence (например, с временной меткой Binlog) позволяет обрабатывать данные, поступающие не по порядку.
- UPSERT в модели Unique Key отвечает за обработку
3.2 Формирование широких таблиц в реальном времени
Частичное обновление столбцов позволяет формировать широкие таблицы из нескольких источников непосредственно в Doris, не выполняя соединения в реальном времени во Flink:
- Создайте широкую таблицу с моделью Unique Key.
- Разные источники данных (основная информация, журналы поведения, данные транзакций и т. д.) записывают в неё данные в реальном времени через Stream Load / Routine Load.
- Каждый поток данных записывает только те столбцы, за которые отвечает, например:
- Поток пользовательского поведения обновляет
page_view_countиlast_login_time. - Поток транзакций обновляет
total_ordersиtotal_amount.
- Поток пользовательского поведения обновляет
Каждый поток записывает только изменённые столбцы, что снижает накладные расходы на IO и позволяет избежать затрат ресурсов на соединения в реальном времени. Об управлении версиями при одновременной работе нескольких потоков см. Многопоточные обновления в модели Unique Key.
4. Рекомендации по использованию
4.1 Общие рекомендации
| № | Рекомендация | Описание |
|---|---|---|
| 1 | Отдавайте предпочтение обновлениям при загрузке данных | Для частых обновлений большого объёма данных предпочтительнее использовать Stream Load и Routine Load вместо DML-операции UPDATE |
| 2 | Записывайте данные пакетами | Избегайте частых операций INSERT, записывающих по одной строке (> 100 TPS), поскольку каждый INSERT создаёт накладные расходы на транзакцию. Можно включить Group Commit для объединения фиксаций небольших пакетов |
| 3 | Осторожно используйте частые операции DELETE в моделях Duplicate/Aggregate | Накопление предикатов влияет на производительность последующих запросов |
| 4 | Используйте TRUNCATE PARTITION для удаления целого раздела | При удалении целого раздела TRUNCATE PARTITION значительно эффективнее, чем DELETE |
| 5 | Выполняйте UPDATE последовательно | Избегайте параллельного выполнения задач UPDATE, которые могут затрагивать один и тот же первичный ключ |
4.2 Модель Unique Key в архитектуре с разделением вычислений и хранения
В Doris 3.0 появилась архитектура с разделением вычислений и хранения. В этой архитектуре BE не хранит состояние, а Merge-on-Write должен поддерживать глобальное состояние через Meta Service, чтобы разрешать конфликты записи между загрузкой данных, Compaction и Schema Change. MoW модели Unique Key использует распределённую блокировку таблицы на основе Meta Service для обеспечения согласованности записи.
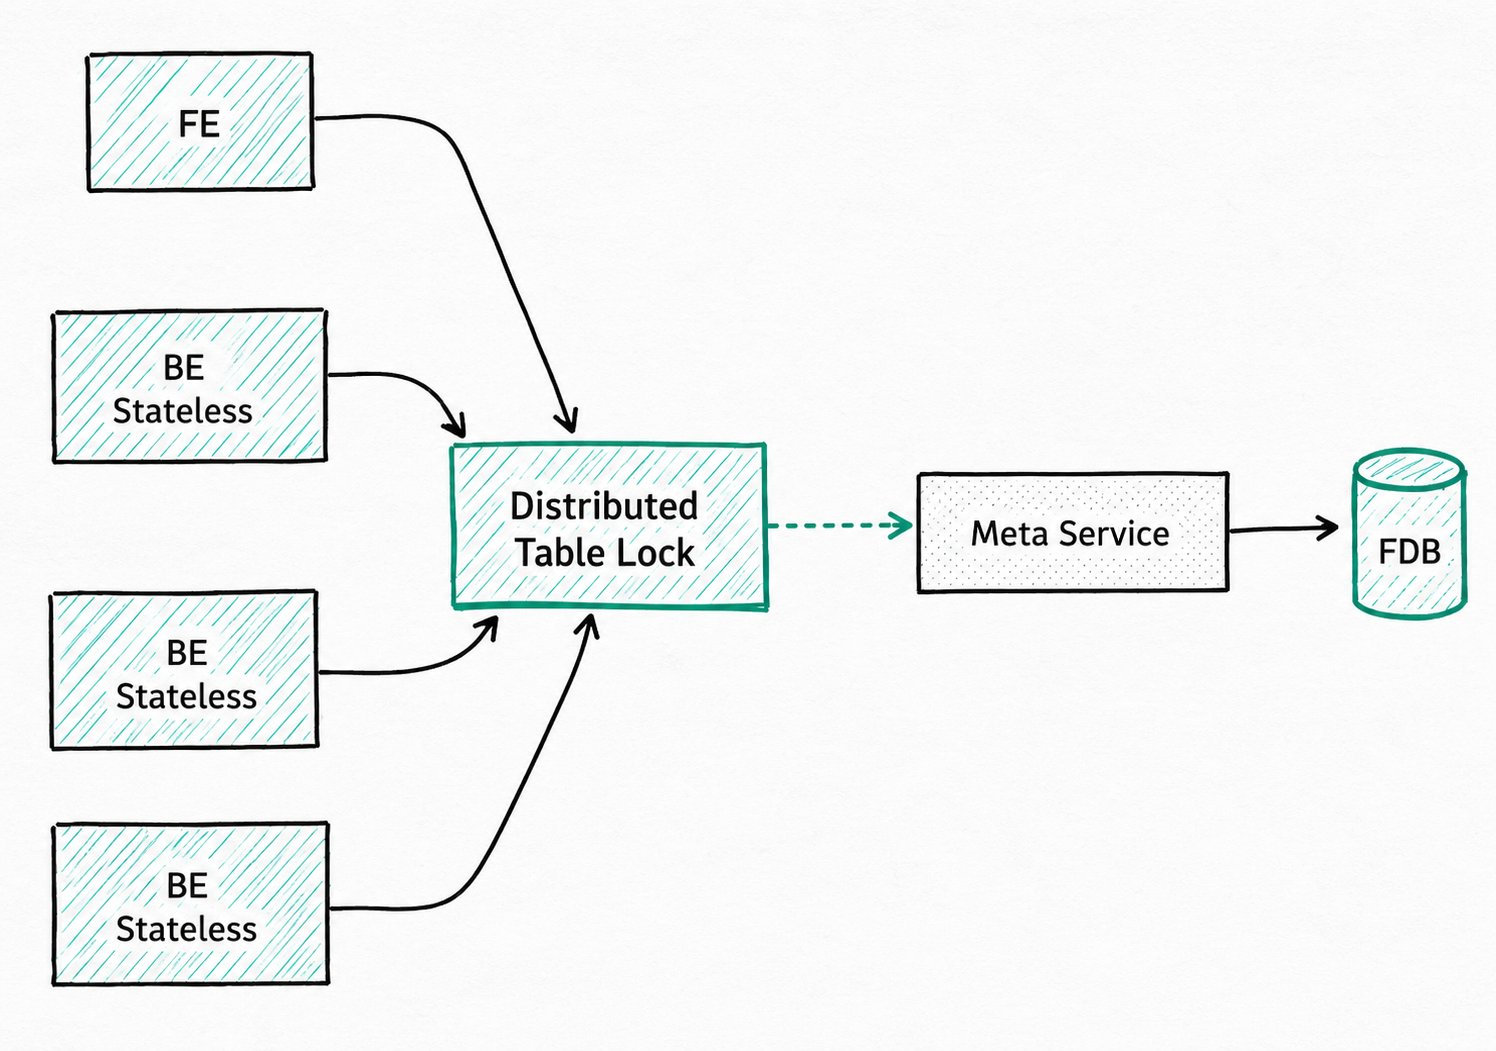
Частая загрузка данных и Compaction могут приводить к конкуренции за блокировку таблицы. При использовании этой архитектуры рекомендуется:
- Контролируйте частоту загрузки в отдельную таблицу: рекомендуется загружать данные в отдельную таблицу Unique Key не чаще 60 раз в секунду. Снизить частоту можно за счёт пакетирования или настройки параллелизма.
- Разумно выбирайте разделы и бакеты:
- Разделы: используйте разбиение по времени (по дням или часам), чтобы при каждой загрузке обновлялось лишь небольшое количество разделов.
- Бакеты: количество бакетов (количество Tablets) должно соответствовать объёму данных и обычно составлять от 8 до 64. Слишком большое количество Tablets усиливает конкуренцию за блокировки.
- Настройте стратегию Compaction: при высокой нагрузке на запись снизьте частоту Compaction, чтобы уменьшить конфликты блокировок с задачами загрузки.
- Используйте актуальную версию: в версии 3.1 реализация распределённой блокировки таблицы была значительно оптимизирована. Рекомендуется использовать последнюю стабильную версию.