Основные понятия продукта
В этом документе представлены основные понятия Apache Doris, необходимые для понимания остальной документации. Они охватывают такие ключевые аспекты, как организация данных, модели хранения, выполнение и оптимизация запросов.
Когда пригодится: знакомство с понятиями, подготовка к чтению документации, изучение технических основ
Организация данных
Catalog / База данных / Таблица
Для управления данными Apache Doris использует трёхуровневую иерархию Catalog → База данных → Таблица.
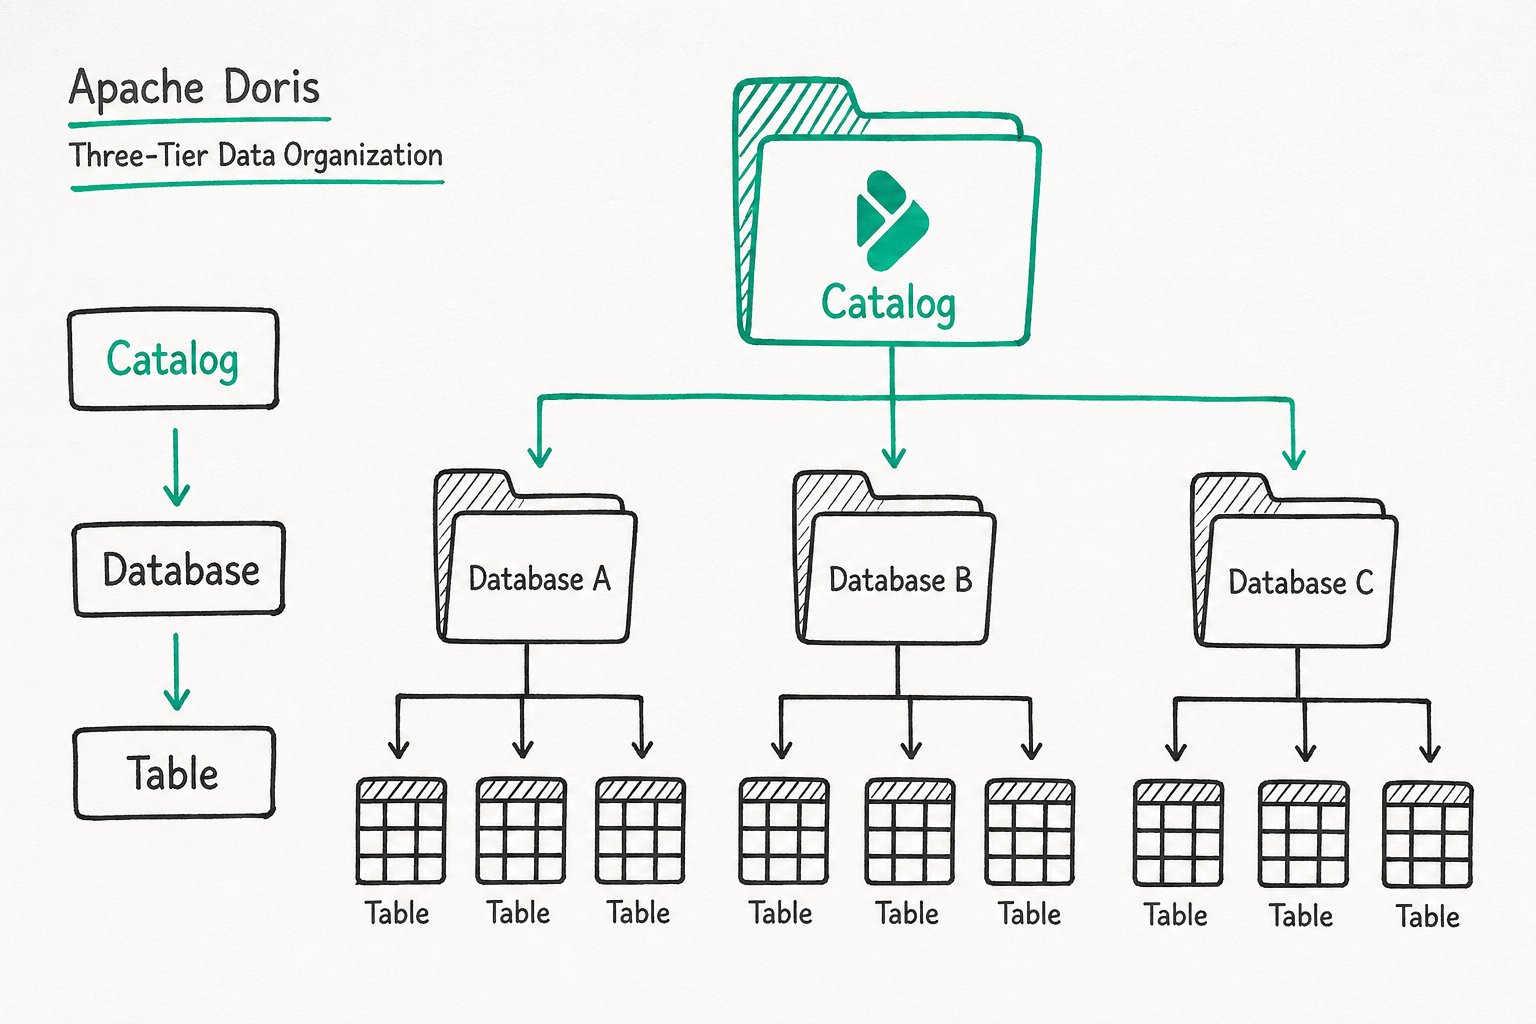
| Уровень | Описание |
|---|---|
| Catalog | Логическое пространство имён для разграничения различных источников данных. Catalog internal, используемый в Doris по умолчанию, представляет внутреннее хранилище и содержит базы данных и таблицы, созданные пользователями. Внешние Catalog позволяют подключаться к таким источникам данных, как Hive, Iceberg и MySQL, и выполнять запросы к разным источникам без переноса данных. |
| База данных | Единица организации баз данных, позволяющая изолировать данные разных направлений бизнеса или проектов. Можно настроить такие атрибуты, как набор символов и правила сортировки. |
| Таблица | Двумерная реляционная таблица, определяющая структуру столбцов (Schema) и свойства таблицы: правила распределения по бакетам, жизненный цикл и т. д. Это основная единица хранения данных и выполнения запросов. Все объекты Doris, к которым можно выполнять запросы, представлены в виде таблиц. |
Зачем нужна трёхуровневая структура?
Многоуровневая структура сочетает логическую изоляцию с единым доступом к разным источникам данных. Команды бизнес-подразделений управляют независимыми базами данных, а команды платформы могут напрямую запрашивать данные из других источников через внешние Catalog.
Внутренний Catalog
Внутренний Catalog встроен в Doris и используется по умолчанию. Он имеет фиксированное имя internal и управляет таблицами и данными, хранящимися во внутреннем формате Doris.
Функции:
- Хранение всех баз данных, созданных пользователями (
CREATE DATABASE) - Хранение всех таблиц, созданных пользователями (
CREATE TABLE) - Управление импортом, сжатием и слиянием версий (Compaction) внутренних данных
Когда пользователь выполняет SHOW DATABASES или USE my_db, операция по умолчанию выполняется в контексте внутреннего Catalog.
Внешний Catalog
Внешний Catalog представляет собой логический компонент для подключения к внешним источникам данных. Он позволяет выполнять запросы непосредственно к внешним данным без их переноса.
| Внешний источник данных | Описание |
|---|---|
| Hive | Подключение к Hive Metastore или озёрам данных, совместимым с HMS |
| Iceberg | Подключение к таблицам Iceberg |
| Paimon | Подключение к таблицам Paimon |
| JDBC | Подключение к реляционным базам данных, таким как MySQL, PostgreSQL и OceanBase |
Особенности Iceberg и Paimon:
Эти два источника данных поддерживают полноценное управление данными, включая операции DDL (CREATE/DROP/ALTER TABLE) и DML (INSERT/UPDATE/DELETE), а не только запросы. Вы можете управлять схемами таблиц Iceberg/Paimon непосредственно в Doris и записывать в них данные.
Сценарии использования:
- Аналитика озёр данных: анализ данных Hive/Iceberg/Paimon напрямую, без ETL
- Запросы к разным источникам: обращение к источнику данных Iceberg и данным Doris в одном SQL-запросе
Как использовать: после создания внешнего Catalog можно напрямую запрашивать его данные с помощью SELECT * FROM catalog.database.table. Также можно переключиться на соответствующий Catalog командой SWITCH catalog.
Сравнение внутреннего и внешнего Catalog
| Критерий | Внутренний Catalog | Внешний Catalog |
|---|---|---|
| Имя | Фиксированное: internal | Задаётся пользователем |
| Формат данных | Внутренний формат Doris (столбцовое хранение) | Формат внешнего источника данных (Parquet, ORC и т. д.) |
| Расположение данных | Локальные диски узлов BE или объектное хранилище | Внешние системы (HDFS, S3, Hive Metastore и т. д.) |
| Способ создания | CREATE DATABASE / CREATE TABLE | CREATE EXTERNAL CATALOG |
| Производительность запросов | Высокая (данные хранятся локально) | Зависит от внешнего источника данных. Doris также предоставляет несколько встроенных механизмов ускорения |
| Поддержка DDL/DML | Полная поддержка | Для Iceberg/Paimon полная поддержка; для Hive/JDBC поддерживаются только запросы |
| Запись данных | Поддерживается (Stream Load и т. д.) | Поддерживается только для Iceberg/Paimon |
Партиции и бакеты
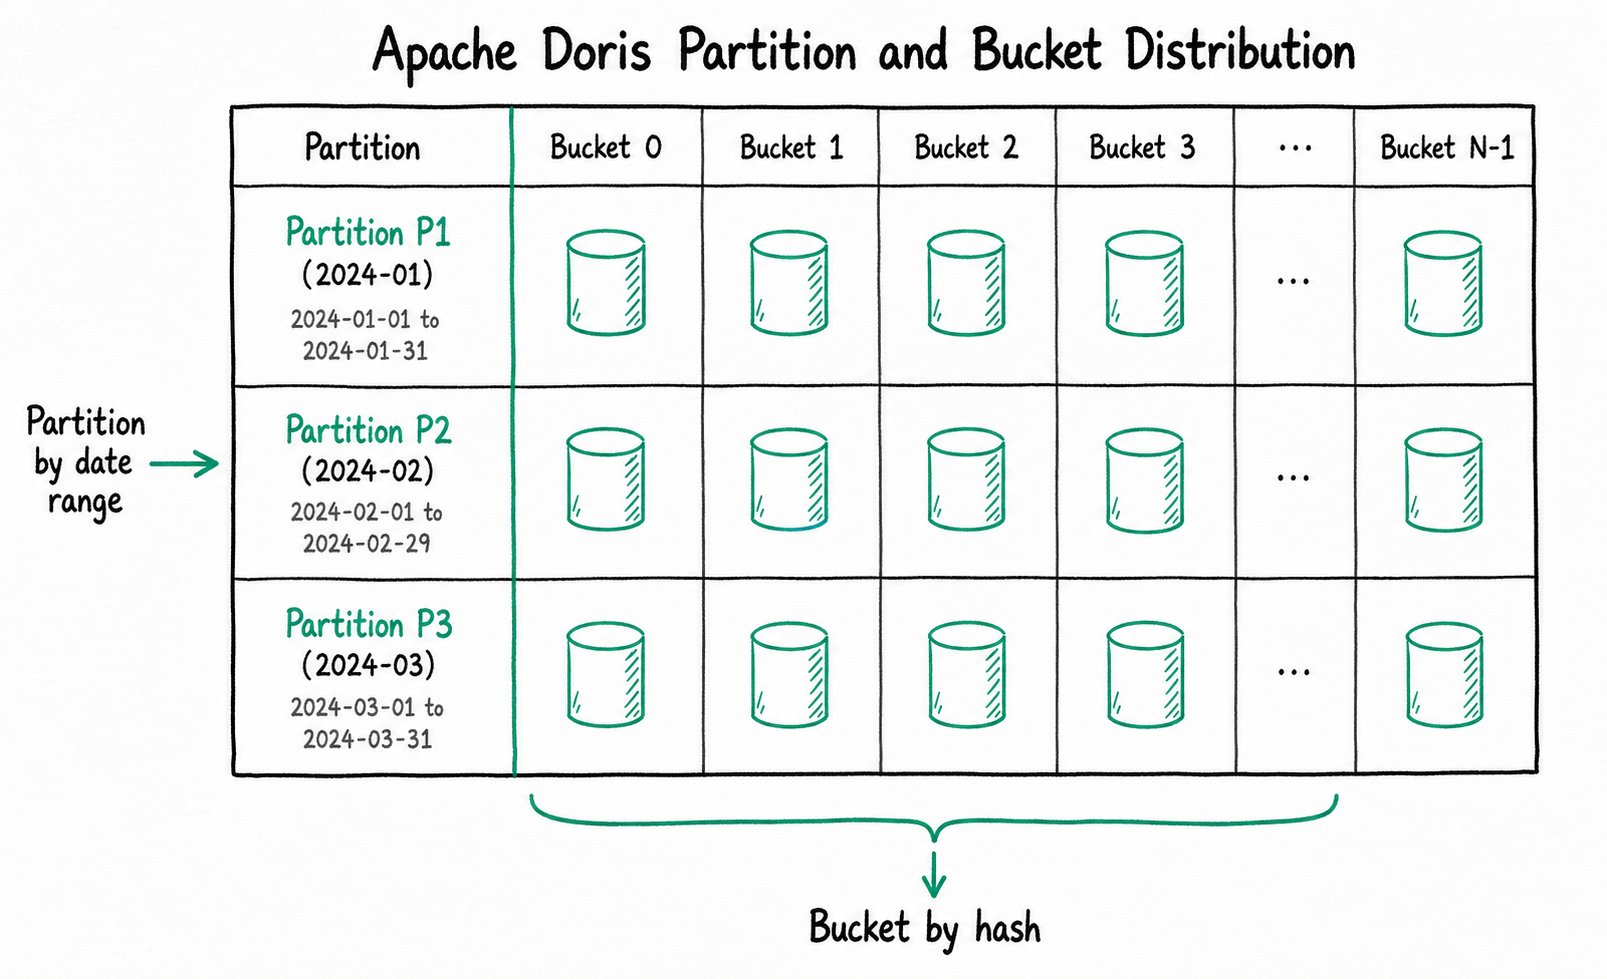
Партиция разделяет данные таблицы по горизонтали на основе диапазона значений определённого столбца. Таблица может содержать одну или несколько партиций, каждая из которых соответствует непрерывному диапазону данных.
Типичные сценарии использования:
- Партиционирование по времени (по дням/месяцам/годам) для отсечения партиций и управления историческими данными
- Партиционирование по регионам или направлениям бизнеса для изоляции данных
Пример: таблица журналов партиционирована по дням на основе столбца date.
Partition p20240101: data where date = '2024-01-01'
Partition p20240102: data where date = '2024-01-02'
Partition p20240103: data where date = '2024-01-03'
При выполнении WHERE date = '2024-01-02' Doris сканирует только партицию p20240102, пропуская остальные, что значительно сокращает I/O.
Бакет разделяет данные таблицы по горизонтали на основе хеш-значения определённого столбца или заданного количества бакетов и определяет физическое распределение данных в кластере.
Физическая единица хранения, соответствующая бакету, называется Tablet. Это минимальная логическая единица хранения.
| Понятие | Описание |
|---|---|
| Ключ распределения | Столбец, используемый для определения бакета, к которому относится строка. Выбирайте столбец с высокой кардинальностью, например ID первичного ключа. |
| Количество бакетов | Число физических бакетов в партиции. Определяет степень параллелизма обработки данных. |
Различия между бакетами и партициями:
| Аспект | Партиция | Бакет |
|---|---|---|
| Основа разделения | Диапазон значений столбца | Вычисление хеша |
| Назначение | Управление жизненным циклом данных, отсечение партиций | Параллельное распределение данных, оптимизация JOIN |
| Иерархия | Партиция содержит бакеты | Бакет принадлежит партиции |
Партиция определяет логические границы данных, например временной диапазон, а бакет определяет физическое распределение данных, например их размещение по узлам кластера.
Модель хранения
Столбцовое хранение
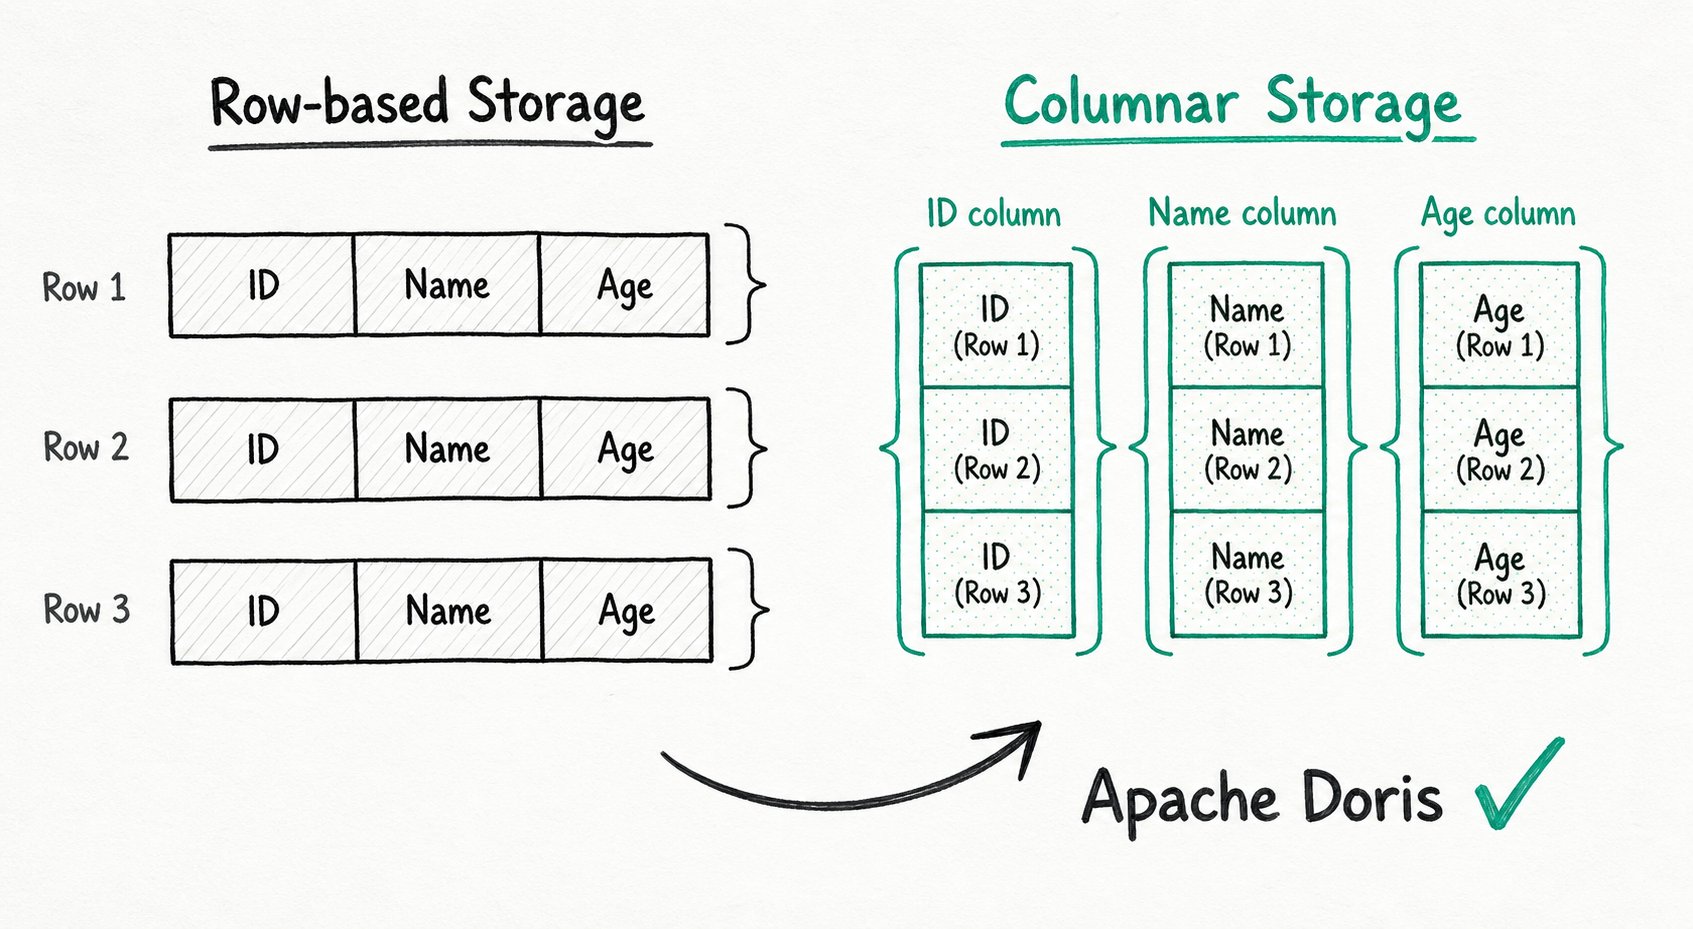
Столбцовое хранение представляет собой формат, в котором данные организованы по столбцам, а не по строкам.
Сравнение строкового и столбцового хранения:
Row-based storage (each row is stored contiguously):
[row1: id=1, name=alice, age=30] [row2: id=2, name=bob, age=25] ...

Columnar storage (each column is stored contiguously):
[id column: 1, 2, 3, ...] [name column: alice, bob, carol, ...] [age column: 30, 25, 28, ...]
Преимущества столбцового хранения:
| Преимущество | Описание |
|---|---|
| Высокая эффективность I/O | Запрос читает только необходимые столбцы, избегая полного сканирования таблицы. Для отчётных запросов, обращающихся лишь к нескольким столбцам, объём I/O может сократиться в десятки раз. |
| Высокая степень сжатия | Данные одного столбца имеют одинаковый тип, что хорошо подходит для таких алгоритмов, как словарное кодирование, сжатие битовых карт и RLE, и значительно сокращает занимаемое место. |
| Удобство векторизации | Данные одного столбца располагаются в памяти последовательно, что обеспечивает высокую частоту попаданий в кеш CPU и позволяет ускорять вычисления с помощью инструкций SIMD. |
Модели данных
Doris поддерживает три модели данных для разных требований к объединению данных в бизнес-сценариях.
| Модель | Описание | Сценарии использования |
|---|---|---|
| Duplicate | Сохраняет все исходные данные, включая несколько записей с одинаковым ключом. | Хранение детальных данных таблиц фактов, анализ журналов |
| Aggregate | Записи с одинаковым ключом объединяются с помощью агрегатных функций, таких как SUM, MAX и MIN. | Расчёт метрик, предварительная агрегация для отчётов |
| Primary Key | Ключи уникальны; записи с одинаковым ключом заменяют предыдущие (поддерживаются обновления на уровне строк). | Обновления в реальном времени, приём данных CDC |
Пример:
Предположим, имеются следующие исходные данные (первичный ключ: user_id):
| user_id | visit_date | pv |
|---|---|---|
| 1 | 2024-01-01 | 5 |
| 1 | 2024-01-01 | 3 |
| 2 | 2024-01-01 | 10 |
- Модель Duplicate: сохраняются все 3 записи.
- Модель Aggregate (с агрегацией SUM): значения
pvдля одинаковых ключей объединяются, поэтому для user_id=1 получаем pv=8, а для user_id=2 получаем pv=10. - Модель Primary Key: записи с одинаковым ключом перезаписываются с учётом временной метки, и остаётся только последняя (например,
pv=3заменяетpv=5).
Выполнение запросов
MPP (массовая параллельная обработка)
MPP представляет собой архитектуру массовой параллельной обработки для выполнения сложных запросов.
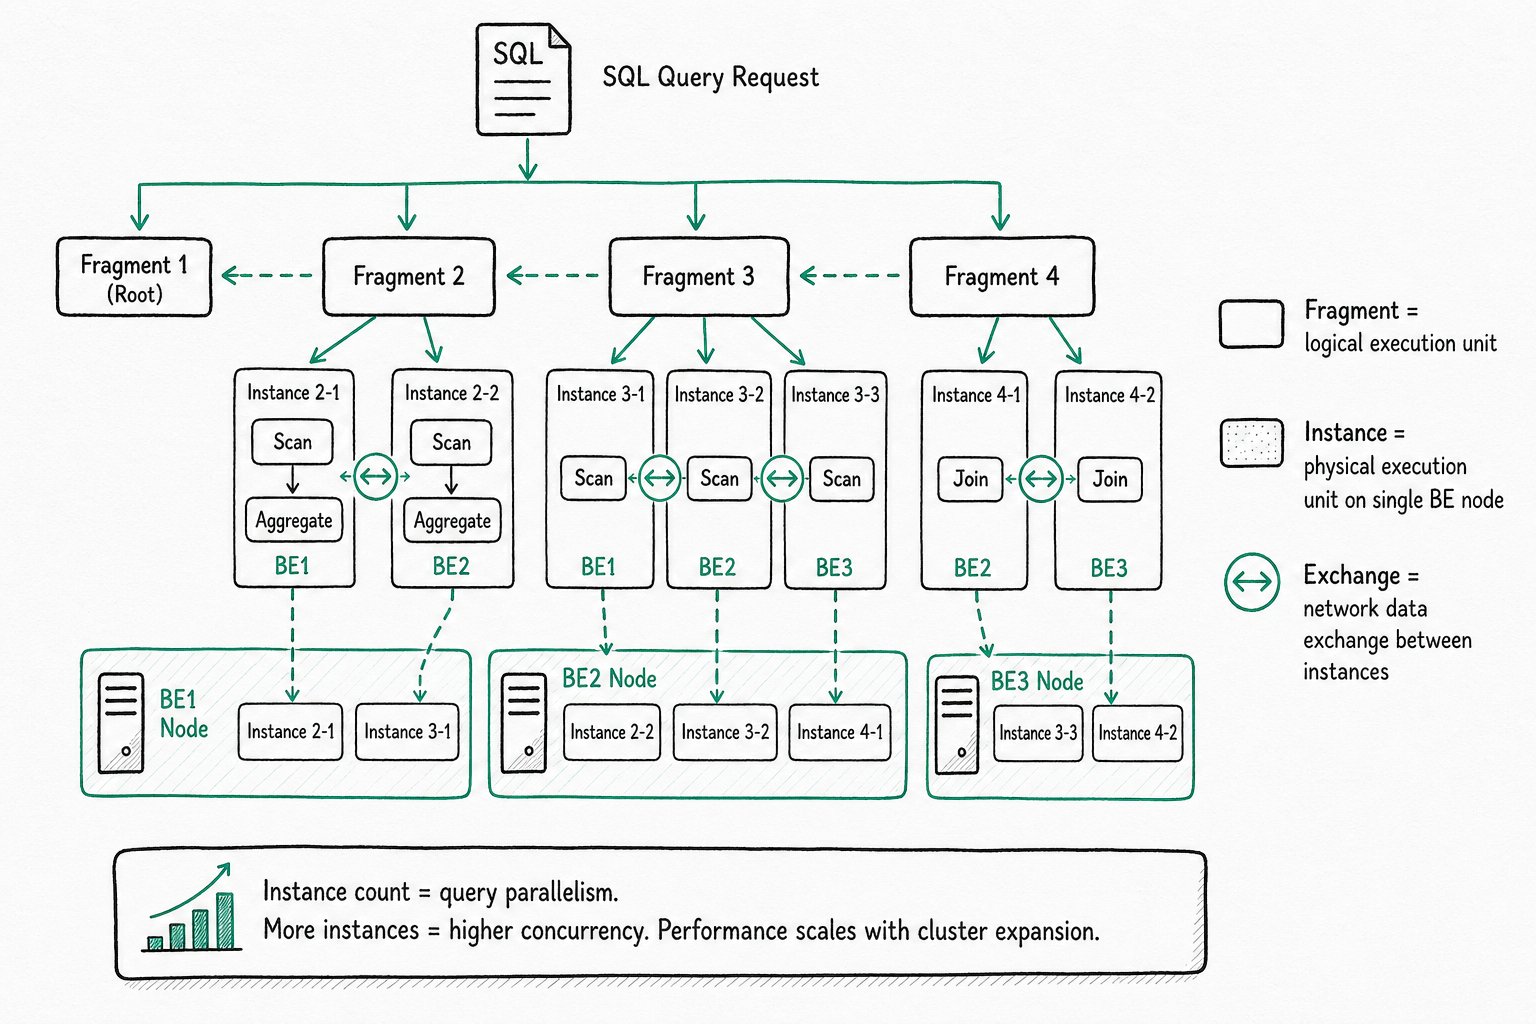
Основные понятия:
| Понятие | Описание |
|---|---|
| Fragment | Логическая единица выполнения. План запроса состоит из нескольких Fragment. |
| Instance | Физическая единица выполнения, состоящая из группы операторов, таких как Scan, Agg и Join, которые могут выполняться на одном узле BE. |
| Exchange | Оператор, обеспечивающий обмен данными между Instance по сети. |
Как это работает:
- FE разбирает SQL и формирует логический план выполнения.
- План разбивается на несколько Fragment (логических единиц выполнения).
- Для каждого Fragment создаётся один или несколько Instance, которые направляются на несколько узлов BE для параллельного выполнения.
- Разные Instance обмениваются данными по сети через оператор Exchange.
- После завершения выполнения на каждом узле результаты агрегируются на FE.
Instance и параллелизм:
Instance является физической единицей выполнения запроса, работает на одном узле BE и содержит группу операторов (Scan → Agg → Join и т. д.). Количество Instance определяет степень параллелизма запроса: чем больше Instance, тем выше параллелизм. Каждый узел выполнения располагает выделенными ресурсами (CPU и памятью), а отдельный запрос может полностью задействовать ресурсы всех узлов выполнения. В результате производительность запросов растёт по мере горизонтального масштабирования кластера.
Сценарии использования: операции, требующие обмена данными между узлами, например JOIN больших таблиц, GROUP BY и ORDER BY.
Векторизованный механизм выполнения
Векторизованное выполнение обрабатывает данные пакетами по столбцам и использует инструкции SIMD для ускорения вычислений.
Сравнение традиционного построчного и векторизованного выполнения:
| Аспект | Построчное выполнение | Векторизованное выполнение |
|---|---|---|
| Единица обработки | Одна строка за раз | Один столбец (пакет) за раз |
| Кеш CPU | Произвольный доступ, низкая частота попаданий в кеш | Последовательный доступ, высокая частота попаданий в кеш |
| Инструкции SIMD | Сложно задействовать | Используются в полной мере |
| Производительность агрегации | Базовый уровень | Ускорение в 5-10 раз |
Основная идея: заменить внутренний цикл оператора «обработать одну строку» на «обработать один столбец (пакет данных)», чтобы сократить накладные расходы на вызовы функций и эффективнее использовать CPU.
Механизм выполнения Pipeline
Pipeline представляет собой модель параллельного выполнения на нескольких ядрах, которая максимально задействует многоядерные ресурсы за счёт конвейерного параллелизма.
Какие проблемы решает:
- Резкий рост числа потоков: традиционные модели выделяют фиксированное количество потоков на каждый запрос, поэтому при резком увеличении числа запросов количество потоков становится неконтролируемым.
- Конкуренция за ресурсы: пул потоков фиксированного размера приводит к конкуренции запросов за ресурсы.
Характеристики Pipeline:
| Особенность | Описание |
|---|---|
| Ограничение числа потоков | Параллелизм ограничивается количеством ядер CPU, а не числом запросов. |
| Планирование цепочек операторов | Предшествующие и последующие операторы образуют конвейер с непрерывным потоком данных. |
| Сокращение блокировок | Уменьшается число переключений потоков и конкуренция за блокировки, что повышает пропускную способность. |
В рамках одного запроса несколько операторов образуют параллельный конвейер. На уровне кластера несколько запросов совместно используют ресурсы CPU, обеспечивая эффективное планирование в многопользовательской среде.
Оптимизация запросов
Материализованное представление
Материализованное представление использует предварительные вычисления: результаты запроса сохраняются в физической таблице и автоматически обновляются по мере загрузки данных.
Основные преимущества:
| Возможность | Описание |
|---|---|
| Переписывание запросов | Когда пользователь запрашивает исходную таблицу, оптимизатор автоматически определяет, можно ли прозрачно переписать запрос для чтения из материализованного представления. Пользователю не нужно менять SQL. |
| Автоматическая синхронизация | Материализованное представление автоматически обновляется при изменении исходной таблицы и не требует ручного обслуживания. |
| Замена ETL | Может заменить традиционные конвейеры ETL, запускаемые по расписанию, и обеспечить ускорение в реальном времени. |
Сценарии использования:
- Агрегатные запросы к большим таблицам, например сводные отчёты
- Многоуровневое моделирование в хранилищах данных (таблицы фактов → сводные таблицы)
- Предварительное вычисление результатов сложных JOIN
CBO (оптимизатор на основе стоимости)
CBO представляет собой оптимизатор запросов на основе стоимости. Он оценивает потребление ресурсов (I/O, CPU, сеть) для каждого возможного плана выполнения и выбирает план с наименьшей стоимостью.
Типичные задачи оптимизации CBO:
| Оптимизация | Описание |
|---|---|
| Порядок соединений | Для JOIN нескольких таблиц CBO оценивает стоимость разных порядков соединения и выбирает лучший. |
| Алгоритм соединения | CBO выбирает Hash Join, Nest Loop Join или Broadcast Join в зависимости от объёма данных. |
| Распределённое выполнение | CBO определяет, какие узлы будут выполнять запрос и нужен ли Shuffle. |
Зачем нужен CBO? SQL описывает только «что сделать», но не «как это сделать». Для одного и того же запроса оптимальный путь выполнения может полностью различаться в зависимости от объёма данных. CBO использует статистику (количество строк, кардинальность столбцов, NDV и т. д.), чтобы оценить стоимость и выбрать наиболее эффективный путь выполнения.
RBO (оптимизатор на основе правил)
RBO представляет собой оптимизатор на основе правил. Он переписывает логический план по заранее заданным правилам, не учитывая фактические характеристики данных.
Типичные правила оптимизации:
| Правило | Описание |
|---|---|
| Свёртка констант | 1 + 2 → 3 |
| Проталкивание предикатов | Условия фильтрации применяются до JOIN, чтобы уменьшить объём промежуточных результатов. |
| Переписывание подзапросов | Преобразование вложенных подзапросов в JOIN. |
| Повторное использование общих выражений | Выражение, которое встречается несколько раз, вычисляется только один раз. |
Сравнение CBO и RBO: RBO детерминирован и работает по правилам, поэтому подходит для сценариев с фиксированными правилами. CBO выполняет более сложную оптимизацию с учётом характеристик данных, но зависит от точности статистики. Doris использует оба подхода: RBO отвечает за детерминированные оптимизации, а CBO за выбор сложных планов выполнения.
Runtime Filter
Runtime Filter представляет собой условие фильтрации, которое динамически создаётся при выполнении запроса и передаётся на узел сканирования, чтобы отбирать данные уже на этапе чтения.
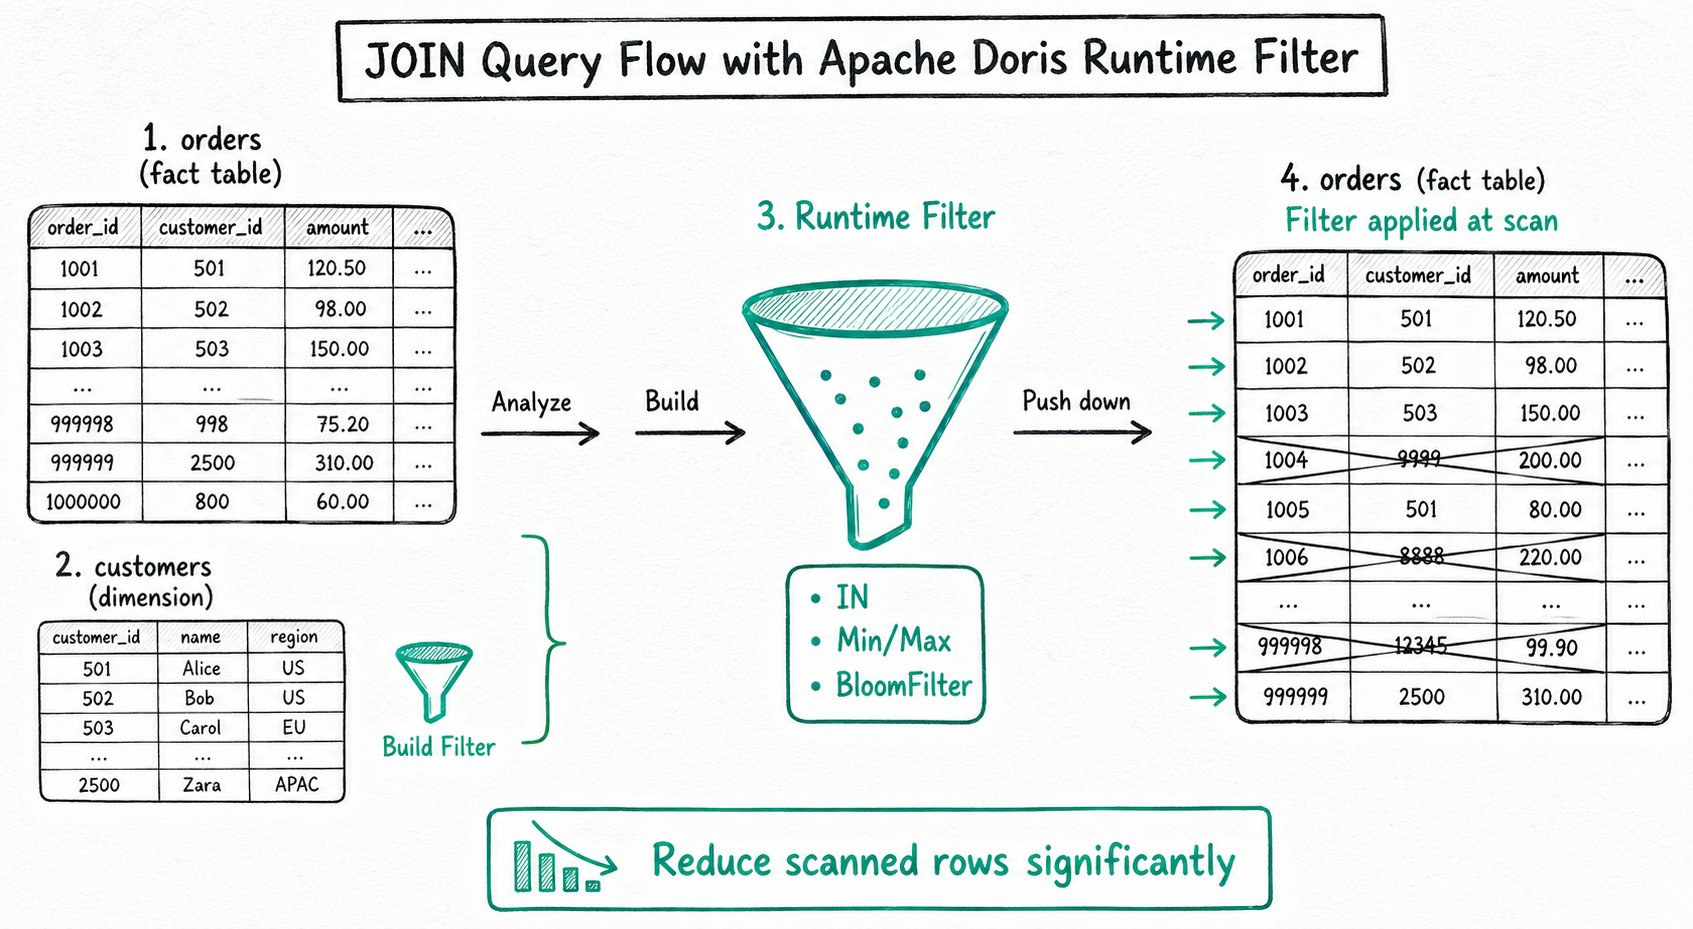
Как это работает:
Suppose a JOIN is performed between the large table orders and the small table customers on customer_id:

1. The FE analyzes the small table and builds a Filter (such as customer_id IN {1, 5, 9}).
2. The Filter is pushed down to the nodes that scan the large table.
3. While the large table is being read, rows that do not match are filtered out immediately and skipped.
4. This reduces I/O and the workload of subsequent operators.
Типы Runtime Filter:
| Тип | Сценарии использования |
|---|---|
| IN | Соединение небольшой таблицы с большой, JOIN по равенству |
| Min/Max | JOIN по диапазону, непрерывное распределение данных |
| BloomFilter | Столбец с высокой кардинальностью, JOIN по равенству |
Эффект: в схеме «звезда», когда большая таблица fact соединяется с небольшой таблицей dimension, Runtime Filter может сократить объём сканирования большой таблицы от нескольких до десятков раз.
Часто задаваемые вопросы
Вопрос: Чем отличаются партиции и бакеты?
Партиция разделяет данные по диапазону значений столбца. Она используется для управления жизненным циклом данных (например, удаления исторических данных по дневным партициям) и отсечения партиций (сканирования только тех партиций, которые нужны запросу). Бакет распределяет данные по хешу для параллельной обработки и оптимизации JOIN. Партиция является логическим понятием, а бакет физическим: он определяет, на какой узел BE попадёт конкретная часть данных.
Вопрос: Когда следует выбирать модель Primary Key вместо Duplicate?
Выбирайте модель Primary Key, когда нужны обновления на уровне строк, например при приёме данных в реальном времени или синхронизации CDC, либо объединение записей с одинаковым ключом. Модель Duplicate сохраняет все исходные данные и подходит для анализа журналов и запросов ко всем детальным данным.
Вопрос: Как связаны MPP и Pipeline?
Эти механизмы обеспечивают параллелизм в двух разных измерениях. MPP отвечает за распределённый параллелизм, то есть параллельные вычисления на разных узлах. Pipeline отвечает за параллелизм внутри узла, то есть использование многоядерных ресурсов. Вместе они обеспечивают сквозной параллелизм: «параллелизм между узлами плюс конвейерная обработка внутри узла».
Вопрос: Откуда берётся статистика для CBO и RBO?
Doris собирает статистику таблиц и столбцов командой ANALYZE, включая количество строк таблицы, кардинальность столбцов (NDV), долю NULL и т. д. CBO использует эту статистику для оценки стоимости. Чем точнее статистика, тем лучше результаты оптимизации. После значительного изменения объёма данных выполните ANALYZE повторно.
Вопрос: Чем внешний Catalog отличается от обычной базы данных?
Обычная база данных хранит данные внутри Doris, а внешний Catalog представляет собой только логическое отображение: сами данные остаются во внешнем источнике. Doris читает внешние данные напрямую через внешний Catalog, без переноса с помощью ETL. Типичные сценарии включают запросы к озёрам данных (Hive/Iceberg/Hudi) и запросы к разным источникам (MySQL, PostgreSQL и т. д.).
Вопрос: Чем материализованное представление отличается от обычного?
Обычное представление только хранит логику SQL-запроса и вычисляет результат при каждом обращении, не давая выигрыша в производительности. Материализованное представление физически хранит результат запроса, поддерживает данные в актуальном состоянии и прозрачно ускоряет пользовательские запросы. Материализованные представления подходят для агрегатных отчётов с устойчивой структурой запросов.
Дополнительные материалы
- [TODO] - Подробнее об архитектурах с совмещёнными и раздельными хранением и вычислениями
- [TODO] - Подробное изучение CBO и планов выполнения