Гибридный поиск
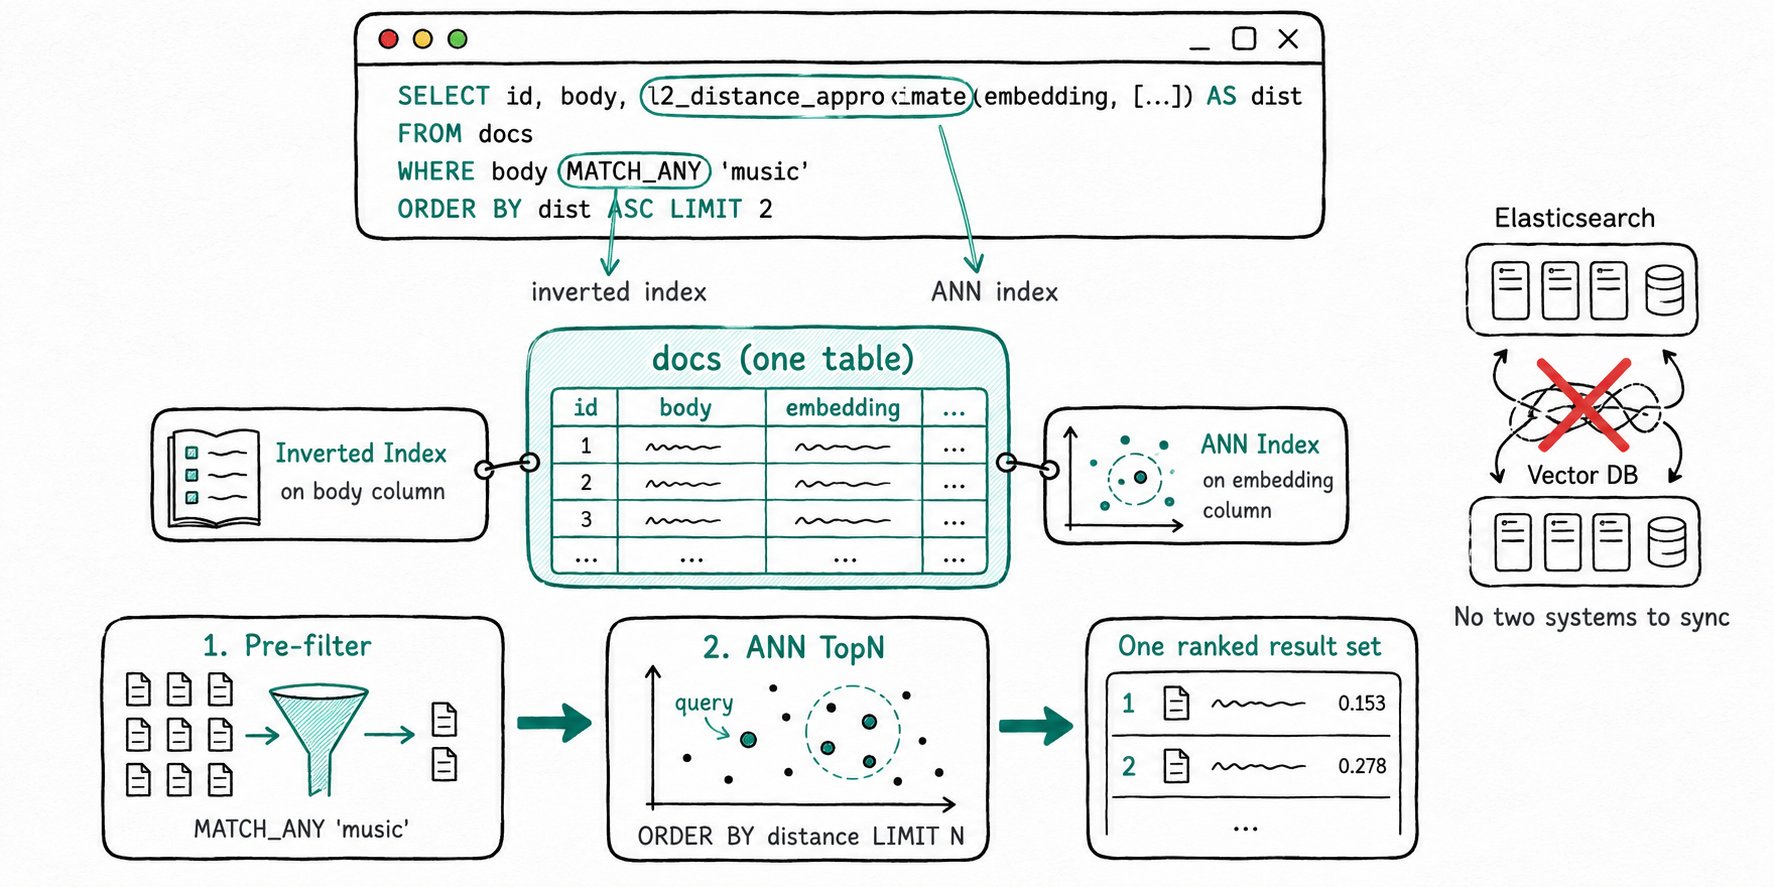
Кратко Гибридный поиск в Apache Doris объединяет полнотекстовое сопоставление и векторное сходство в одном SQL-запросе к одной таблице. Таблица содержит и инвертированный индекс, и ANN-индекс по столбцам, которые обычно распределяют между Elasticsearch и векторной базой данных. Одна секция
WHEREсочетаетMATCH_ANYсl2_distance_approximate, позволяя выполнить фильтрацию и ранжирование за один проход.
Зачем использовать гибридный поиск в Apache Doris?
Гибридный поиск в Apache Doris объединяет два режима поиска в одном SQL-запросе, поэтому вам не нужно поддерживать отдельный поисковый кластер рядом с хранилищем данных. Поисковые задачи редко ограничиваются одним режимом. Пользователь, который ищет «лёгкие беговые кроссовки для трейла», ожидает точных совпадений по словам «беговые» и «трейл», а также семантических совпадений с описаниями, где говорится о «бездорожье» или «пересечённой местности». Обычное решение, распределение работы между двумя системами, влечёт за собой привычные издержки:
- Два конвейера загрузки данных, которые нужно поддерживать синхронными, иначе полнота поиска становится нестабильной.
- Два языка запросов, связанные вручную написанной логикой объединения результатов.
- Два кластера, для которых нужно подбирать ресурсы, вести мониторинг и оплачивать эксплуатацию.
Apache Doris сводит всё это к одной таблице и одному SQL-запросу, который выполняет тот же движок MPP, что и остальные ваши запросы.
Что такое гибридный поиск в Apache Doris?
Гибридный поиск в Apache Doris представляет собой шаблон запроса, а не отдельный движок. Одна таблица может содержать и инвертированный индекс (обеспечивающий работу операторов MATCH_* и оценку релевантности BM25 через score()), и ANN-индекс (обеспечивающий работу функций приближённого вычисления векторного расстояния, таких как l2_distance_approximate и inner_product_approximate). Планировщик Apache Doris обращается к обоим индексам в одном запросе и возвращает единый ранжированный набор результатов.
Основные термины
- Инвертированный индекс: полнотекстовый индекс по столбцу типа
STRING. Доступны токенизаторыenglish,standardи токенизаторы для китайского языка. - ANN-индекс: индекс приближённого поиска ближайших соседей по столбцу типа
ARRAY<FLOAT>. Доступные реализации: HNSW, IVF и IVF on-disk. - Предварительная фильтрация: стратегия, используемая в Apache Doris по умолчанию. Сначала применяются скалярные и текстовые предикаты, затем среди оставшихся строк выбираются TopN по векторному расстоянию.
Как работает гибридный поиск в Apache Doris?
При гибридном поиске Apache Doris строит оба индекса во время загрузки данных, а затем использует их в едином плане MPP: инвертированный индекс выполняет фильтрацию, а ANN-индекс обеспечивает ранжирование.
- Построение индексов при загрузке данных. При загрузке данных инвертированный индекс разбивает содержимое каждого текстового столбца на токены; ANN-индекс строит граф HNSW или кодовую книгу IVF на основе векторов. Оба индекса хранятся рядом с базовой таблицей на том же уровне хранения.
- Единое планирование. Когда запрос сочетает операторы
MATCH_*и функцию векторного расстояния, планировщик направляет текстовый предикат к инвертированному индексу, а функцию расстояния к ANN-индексу. Второй запрос и соединение на стороне клиента не требуются. - Сначала фильтрация, затем ранжирование. Apache Doris сначала выполняет предварительную фильтрацию с помощью инвертированного индекса, затем запускает ANN TopN по оставшимся строкам. Такой порядок обратен распространённой схеме «сначала ANN, затем фильтрация» и позволяет сохранять высокую полноту поиска при селективных фильтрах.
- Адаптивный переход к полному перебору. Если фильтр настолько селективен, что обход ANN пропускал бы слишком много кандидатов, Apache Doris переходит к вычислению векторных оценок полным перебором отфильтрованного набора. Тот же SQL продолжает работать; меняется только путь выполнения.
- Возврат результата. Один отсортированный набор результатов с ограничением количества строк. Без внешнего сервиса объединения результатов и дополнительной логики ранжирования на стороне приложения.
Быстрый старт
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  body STRING NOT NULL,
  INDEX idx_body(body) USING INVERTED PROPERTIES("parser"="english"),
  INDEX idx_vec(embedding) USING ANN
    PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music'),
  (2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today'),
  (3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend'),
  (4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update');

SELECT id, body,
       l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
FROM docs
WHERE body MATCH_ANY 'music'   -- inverted index pre-filter
ORDER BY dist ASC              -- ANN TopN over the filtered rows
LIMIT 2;
Ожидаемый результат
+------+---------------------+----------+
| id   | body                | dist     |
+------+---------------------+----------+
|    1 | this is about music | 0.663325 |
|    3 | latest music trend  | 1.280625 |
+------+---------------------+----------+
MATCH_ANY 'music' сокращает набор кандидатов до строк, в которых body содержит «music»; затем ANN-индекс ранжирует эти строки по расстоянию до вектора запроса и возвращает две ближайшие.
Когда стоит использовать гибридный поиск в Apache Doris?
Используйте гибридный поиск в Apache Doris, когда вам нужны фильтрация по ключевым словам и поиск по векторному сходству на одних и тех же данных в одном SQL-запросе без отдельной векторной базы данных.
Подходящие сценарии
- Поиск для RAG, когда фильтры по ключевым словам (тенант, тип документа, диапазон дат) должны сузить корпус документов перед семантическим ранжированием.
- Поиск товаров или поиск по Catalog, сочетающий структурированные фильтры (бренд, цена, наличие) со сходством эмбеддингов названия и описания.
- Поиск по журналам и документам, где пользователи регулярно сочетают условия «должно содержать X» и «похоже на Y».
- Нагрузки, при которых данные уже хранятся в Doris для SQL-аналитики и не хочется отправлять их копию в векторную базу данных.
Неподходящие сценарии
- Только ANN-поиск в масштабе миллиардов записей, без фильтров и аналитики. Специализированная векторная база данных может потреблять меньше памяти и обходиться дешевле в расчёте на запрос.
- Таблицы, которым требуется
AGGREGATE KEYилиUNIQUE KEYбез merge-on-write. В настоящее время ANN-индексы требуют таблицDUPLICATE KEYили MoW-таблицUNIQUE KEY. - Векторные столбцы, допускающие NULL. Векторный столбец должен иметь тип
NOT NULL ARRAY<FLOAT>с фиксированной размерностью, совпадающей с размерностью индекса. - Нагрузки, которым требуется Reciprocal Rank Fusion для объединения результатов двух функций оценки. Шаблон с одним проходом ранжирует строки по векторному расстоянию после предварительной фильтрации по ключевым словам; для объединения ранжирования BM25 и векторного ранжирования используйте SQL-шаблон с двумя списками из раздела Reciprocal Rank Fusion.
Сравнение с другими подходами
| Аспект | Гибридный поиск в Doris | Elasticsearch + векторная база данных | Только векторная база данных |
|---|---|---|---|
| Конвейеры загрузки данных | один | два, с поддержанием синхронизации | один |
| Выполнение запроса | один SQL-запрос | объединение результатов на стороне приложения | один API |
| Выразительность фильтров | все возможности SQL (соединения, диапазоны, агрегации) | DSL, ограниченная поддержка соединений | только теги и метаданные |
| Аналитика на тех же данных | все возможности MPP SQL | ограниченная | отсутствует |
Гибридный поиск в Doris оправдывает себя, когда вам также нужны соединения или агрегации на тех же данных. Для исключительно векторного поиска в особо больших масштабах специализированная векторная база данных обычно проще в эксплуатации.
Дополнительные материалы
- Векторный индекс: ANN-индекс, обеспечивающий векторную составляющую гибридного поиска.
- Полнотекстовый поиск: работа с инвертированным индексом, включая токенизаторы и семейство операторов
MATCH_*. - Оценка релевантности BM25: как
score()ранжирует текстовые совпадения; сочетайте эту оценку с векторным расстоянием в шаблоне с двумя функциями оценки. - Reciprocal Rank Fusion: SQL-шаблон объединения ранжирования BM25 и векторного ранжирования, когда объединения за один проход недостаточно.
- Embedding:
EMBED()создаёт векторы, которые использует ANN-индекс. - Обзор векторного индекса: полный справочник по свойствам индекса и шаблонам запросов.
- Обзор инвертированного индекса: токенизаторы, операторы MATCH и выбор анализаторов.
- Практическое руководство по векторному поиску: пошаговое руководство от подготовки данных до настройки.
- AI в Doris: как гибридный поиск сочетается с остальными возможностями AI в Doris.