Векторный индекс
Кратко В Apache Doris 4.0 появился нативный индекс ANN для столбцов
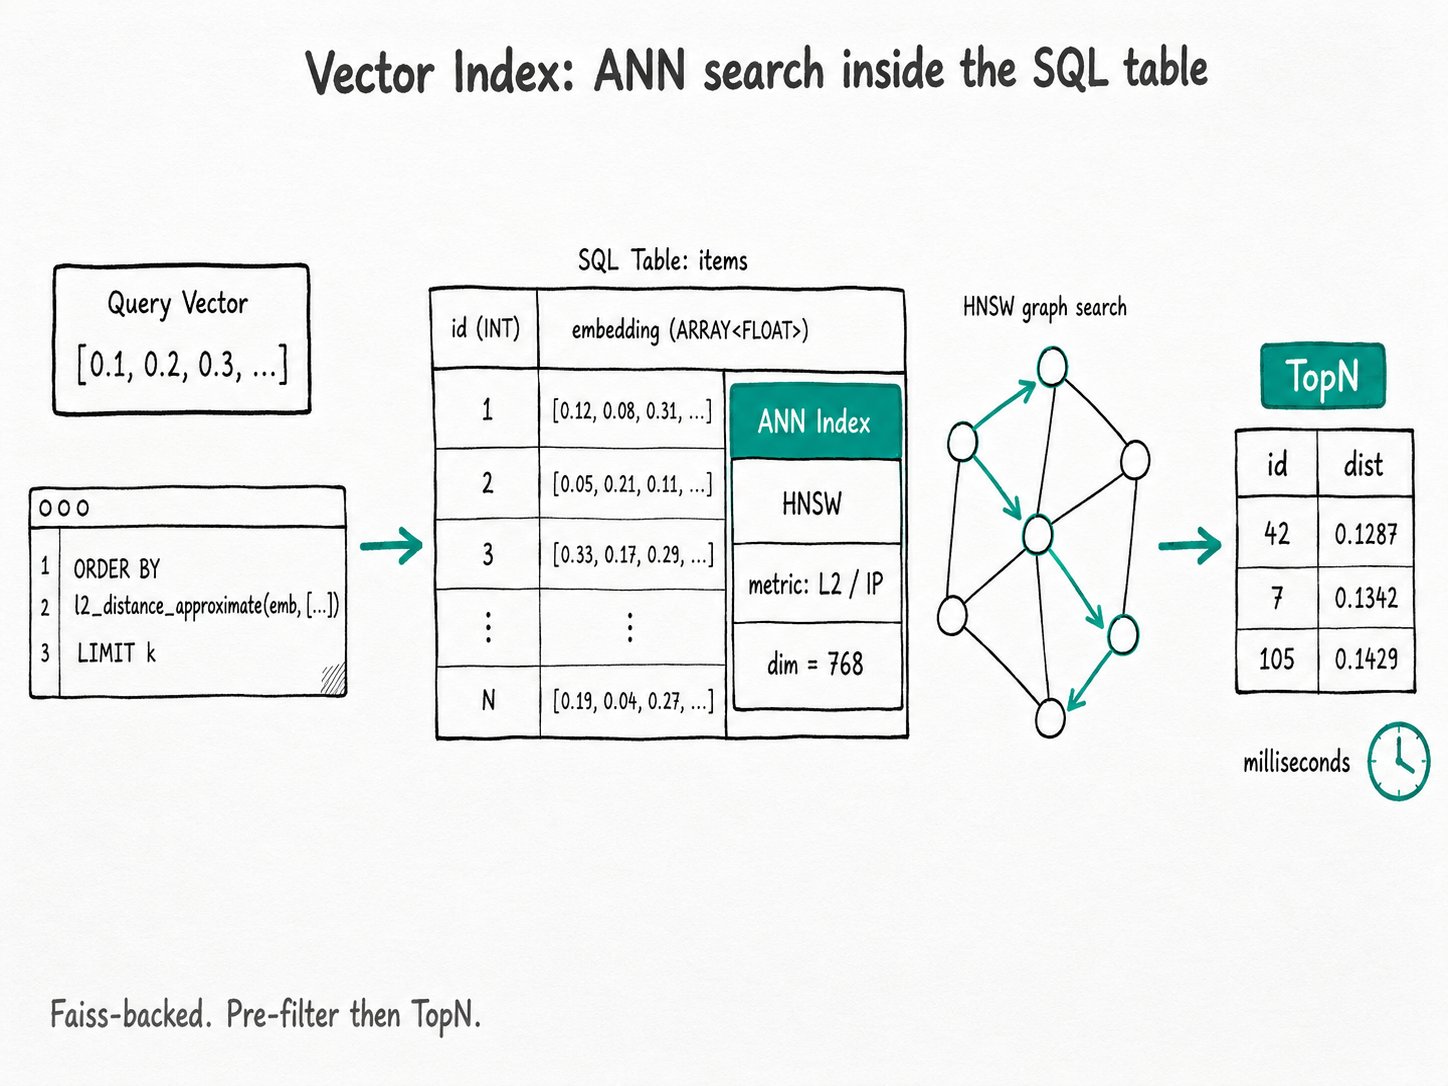
ARRAY<FLOAT>. Индекс объявляется непосредственно вCREATE TABLE(или с помощьюCREATE INDEX ... USING ANN); выберите HNSW или IVF, метрику L2 или скалярное произведение, а затем вызывайтеl2_distance_approximateилиinner_product_approximateвORDER BY ... LIMIT k. Векторный индекс построен на Faiss и выполняет предварительную фильтрацию перед TopN, поэтому условияWHEREприменяются корректно.
Зачем использовать векторный индекс в Apache Doris?
Векторный индекс Apache Doris избавляет от необходимости использовать отдельную векторную базу данных рядом с аналитическим хранилищем. Обычно, когда требуется векторный поиск, добавляют второй кластер. Это работает, но платить приходится дважды: деньгами и затратами на эксплуатацию двух систем, в которых фильтры по ключевым словам находятся по одну сторону, а эмбеддинги — по другую.
- Отдельный кластер, для которого нужно подбирать ресурсы, настраивать мониторинг и оплачивать его работу, лишь чтобы ответить на запрос «найти 10 ближайших векторов».
- Расхождения между аналитической таблицей и векторным хранилищем, когда строка обновляется в одной системе, но не в другой.
- Связующий код в приложении, который отправляет запрос в обе системы и объединяет результаты, поскольку движок SQL не видит векторы.
Apache Doris помещает векторный индекс в ту же таблицу, где находятся остальные данные. Один конвейер загрузки на входе, один SQL-запрос на выходе.
Что такое векторный индекс Apache Doris?
Векторный индекс Apache Doris — это вторичный индекс ANN (Approximate Nearest Neighbor, приближённый поиск ближайших соседей) для столбца с векторами. Новый тип столбца не требуется: векторы хранятся как ARRAY<FLOAT> фиксированной размерности. Индекс располагается рядом с данными, строится на уровне сегментов и используется, когда планировщик обнаруживает функцию приближённого расстояния в ORDER BY.
Основные термины
ARRAY<FLOAT>: способ хранения вектора в Apache Doris. Столбец должен бытьNOT NULL, а длина массива в каждой строке должна совпадать со значениемdimиндекса.USING ANN: предложение для объявления индекса. Свойства задают алгоритм (hnsw,ivf,ivf_on_disk), метрику (l2_distanceилиinner_product) и размерность.- HNSW: алгоритм на основе графа, используемый по умолчанию. Обеспечивает высокую скорость и полноту поиска; индекс должен находиться в памяти.
- IVF / IVF on-disk: алгоритмы на основе инвертированных файлов для больших наборов данных при ограниченном объёме памяти.
l2_distance_approximate/inner_product_approximate: SQL-функции, которые задействуют индекс. Версии без суффикса_approximateтоже существуют, но для них используется сканирование с полным перебором.
Как работает векторный индекс Apache Doris?
Жизненный цикл векторного индекса Apache Doris состоит из пяти этапов: построение при загрузке, распознавание шаблона запроса, предварительная фильтрация, объединение результатов TopN по сегментам и настройка полноты поиска с помощью переменных сеанса.
- Построение при загрузке. При записи сегмента Apache Doris передаёт столбец в Faiss и создаёт файл индекса рядом с данными. На каждый сегмент приходится один индекс; отдельное задание для построения не требуется.
- Распознавание шаблона при планировании. Запрос с
ORDER BY l2_distance_approximate(col, [...]) LIMIT kпреобразуется в операторAnnTopNна стороне хранения. Вектор, заданный литералом, передаётся на уровень хранения вместе с LIMIT. - Сначала предварительная фильтрация, затем TopN. Если есть предложение
WHERE, Apache Doris сначала вычисляет условие, а затем выполняет ANN TopN по оставшимся строкам. Это позволяет сохранять полноту поиска при селективных фильтрах. Столбцы, используемые в условиях, должны иметь собственный вторичный индекс (например, инвертированный), иначе движок выполняет полный перебор этих строк, чтобы обеспечить корректность результатов. - Локальный TopN по сегментам, затем объединение. Каждый сегмент возвращает свои k ближайших векторов. Оператор TopN объединяет результаты по сегментам и планшетам, формируя глобальные k ближайших векторов.
- Настройка во время выполнения запроса. Переменные сеанса, такие как
hnsw_ef_search, расширяют очередь кандидатов для повышения полноты поиска ценой увеличения задержки. По умолчанию заданы консервативные значения; увеличивайте их, если требуется достичь определённой полноты поиска.
Быстрый старт
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  INDEX idx_emb (embedding) USING ANN PROPERTIES(
    "index_type" = "hnsw",
    "metric_type" = "l2_distance",
    "dim" = "3"
  )
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [1.0, 2.0, 3.0]),
  (2, [0.5, 2.1, 2.9]),
  (3, [10.0, 10.0, 10.0]);

SELECT id, l2_distance_approximate(embedding, [1.0, 2.0, 3.0]) AS dist
FROM docs ORDER BY dist LIMIT 3;
Ожидаемый результат
+------+-----------+
| id   | dist      |
+------+-----------+
|    1 |         0 |
|    2 | 0.5196152 |
|    3 |  13.92839 |
+------+-----------+
Для id=1 запрос даёт точный результат (расстояние 0). Индекс ANN ставит двух близких соседей первыми, а выброс — последним. Запрос такой же формы к набору данных SIFT-1M (1 миллион векторов размерности 128) выполняется примерно за 20 мс с индексом и примерно за 290 мс без него; оба значения приведены в обзоре векторного поиска.
Когда стоит использовать векторный индекс Apache Doris?
Векторный индекс Apache Doris подходит для любой нагрузки, при которой эмбеддинги находятся в той же таблице, что и структурированные столбцы, по которым вы уже выполняете фильтрацию и агрегацию.
Подходящие сценарии
- Поиск для RAG, когда в той же таблице хранятся идентификатор тенанта, тип документа, время и другие столбцы для фильтрации. Фильтрацию и векторный поиск можно выполнить одним запросом.
- Отбор кандидатов для рекомендаций и функции «найти похожее», когда эмбеддинги хранятся рядом с метаданными товаров или контента, которые уже используются в остальных ваших дашбордах.
- Обнаружение аномалий или задачи вида «найти всё в пределах расстояния X» с помощью приближённого поиска по диапазону (
WHERE l2_distance_approximate(...) > 300). - Гибридный поиск, сочетающий текстовые условия
MATCH_*с ранжированием по векторам. Инвертированный индекс выполняет предварительную фильтрацию, а индекс ANN — ранжирование. См. Гибридный поиск.
Неподходящие сценарии
- Только ANN-поиск по миллиардам векторов, без фильтров и SQL-аналитики. Специализированная векторная база данных может быть дешевле в эксплуатации и потреблять меньше памяти на единицу QPS.
- Таблицы
AGGREGATE KEYилиUNIQUE KEYбез merge-on-write. В настоящее время индексы ANN требуютDUPLICATE KEYили MoWUNIQUE KEY. - Векторные столбцы, допускающие NULL, или строки с несовпадающей длиной массива. Столбец должен быть
NOT NULL ARRAY<FLOAT>, а длина массива в каждой строке должна точно соответствовать объявленномуdim. Загрузка данных неверной формы завершается ошибкой. score()вместе с функцией расстояния в одномORDER BY. Передача TopN на уровень хранения поддерживает одно выражение сортировки; если нужно объединить оценки BM25 и ANN, выполняйте это объединение над уровнем SQL.- Косинусное сходство через вызов
cosine_distance. В Apache Doris нет косинусной метрики; нормализуйте векторы перед вставкой и используйтеinner_product. Для векторов единичной длины косинусное сходство равно скалярному произведению.
Производительность / показатели
Приведённые ниже показатели взяты из опубликованного проектом теста производительности на Cohere-MEDIUM-1M (размерность 768, 1M векторов, FE 32C 64GB + BE 32C 64GB).
| Число параллельных запросов | Схема | QPS | Средняя задержка | Задержка P99 | Полнота поиска |
|---|---|---|---|---|---|
| 240 | HNSW (FLAT) | 3,340 | 71 мс | 163 мс | 91.0% |
| 240 | HNSW + SQ INT8 | 3,189 | 75 мс | 160 мс | 88.3% |
| 240 | Полный перебор (без индекса) | 3.7 | 25.6 с | 29.4 с | 100% |
Источник: Производительность векторного индекса. Рассматривайте эти показатели как ориентир, а не как гарантию для вашей нагрузки. На той же странице указано, что квантование SQ8 уменьшает индекс примерно до трети размера FLAT с небольшим снижением полноты поиска, которое видно выше.
Дополнительные материалы
- Гибридный поиск: как объединить индекс ANN с инвертированным индексом в одном SQL-выражении.
- Обзор векторного поиска: полный справочник по свойствам индекса, шаблонам запросов и ограничениям.
- Подробный разбор HNSW: как
max_degree,ef_constructionиef_searchпозволяют находить баланс между полнотой поиска и задержкой. - IVF on-disk: вариант для случаев, когда набор векторов больше не помещается в памяти BE.
- Практическое руководство: пошаговое описание всего процесса, включая подготовку данных, загрузку и настройку.
- Эмбеддинги: SQL-функция
EMBED(), которая преобразует текст и медиа в векторыARRAY<FLOAT>, с которыми работает этот индекс. - Обзор AI: как векторный поиск сочетается с другими возможностями AI в Doris.